从修 bug 到查资料,AI 让我把精力聚焦在真正的难点上
原创
从修 bug 到查资料,AI 让我把精力聚焦在真正的难点上
原创
大盘鸡拌面
发布于 2026-09-10 18:32:33
发布于 2026-09-10 18:32:33
说出来你可能不信,作为一个写了七八年后端的老程序员,我以前每天最讨厌的事情不是"难",是"烦"。比如改一个没人写得清的祖传 bug、比如在二十个文档站里找一个配置项的默认值、再比如看一份新人写的、风格完全和别人不一样的"业务代码"。这些活单独拎出来,都不难,但它们有个共同点——极其费你,但又不产生任何业务价值。
我以前以为这就是程序员的日常,后来用 AI 把这些"脏活"一点一点接出去之后才发现:我以前的不少时间,其实是被浪费在不该我干的事情上了。 程序员真正值钱的是判断、抽象、拆解,不是机械地"找答案"。这篇文章想聊聊,这半年我是怎么让 AI 把我从"修 bug 的体力活"和"查资料的体力活"里解放出来的,包括我用的真实案例、提示词怎么写,以及哪些地方我死活不敢让 AI 替我决定。
一、修 bug 这事,AI 不是替你修,是替你定位
我以前是怎么修 bug 的
讲个让我印象深刻的真实场景。我们有个支付回调接口,线上偶尔会报 IllegalStateException: Incomplete response,频率不高,一天几十次。光是定位这个问题,我前前后后花了两天——
第一天翻代码,把整条链路从 controller 到 service 到三方 SDK 全部走读一遍。没发现明显问题。
第二天开始翻日志。一行一行看,看了几百行之后眼睛都花了,最后总算定位到是某个并发场景下回调被中断了。
问题找到之后,修复其实就两行代码。但你算算成本:两天,就为了一个"两行代码的修复"。
当时我就想,这种"定位 bug"的过程,本质上是什么?本质上是在大量信息里找可疑点。这个活 AI 干得比我快得多,因为我看得再仔细,也会有视觉盲区。
我现在的修 bug 流程
现在的流程是这样——我拿到 bug,先不急着翻代码。我把异常堆栈、相关日志、相关代码片段一起喂给 AI,让它先给我一份"嫌疑分析"。我用的提示词大概长这样:
你是一个 Java 后端工程师,帮我定位下面这个 bug 的根因。
1. 异常的堆栈如下(贴出来)
2. 出问题时间段的日志如下(贴出来)
3. 相关代码如下(贴出来)
请按"现象 → 可能的根因 → 验证思路 → 修复建议"四段输出,
只列最可能的 3 个方向,不要列"可能也可能"这种模糊答案。
注意第三行——"只列最可能的 3 个方向",这是我反复调整后加上的。不加这个限制,AI 真的会给你列十几个可能性,每一个都"有道理",但你看完反而更迷茫。
我那次"回调被中断"的 bug,喂给 AI 之后,它不到一分钟就给了我三个方向,其中第一个就是"并发回调未做幂等处理,第二次回调覆盖了第一次的状态"。我顺着这个方向去查日志,15 分钟就锁定了问题。
为了让你看清楚"以前 vs 现在"的区别,我画了个流程图:
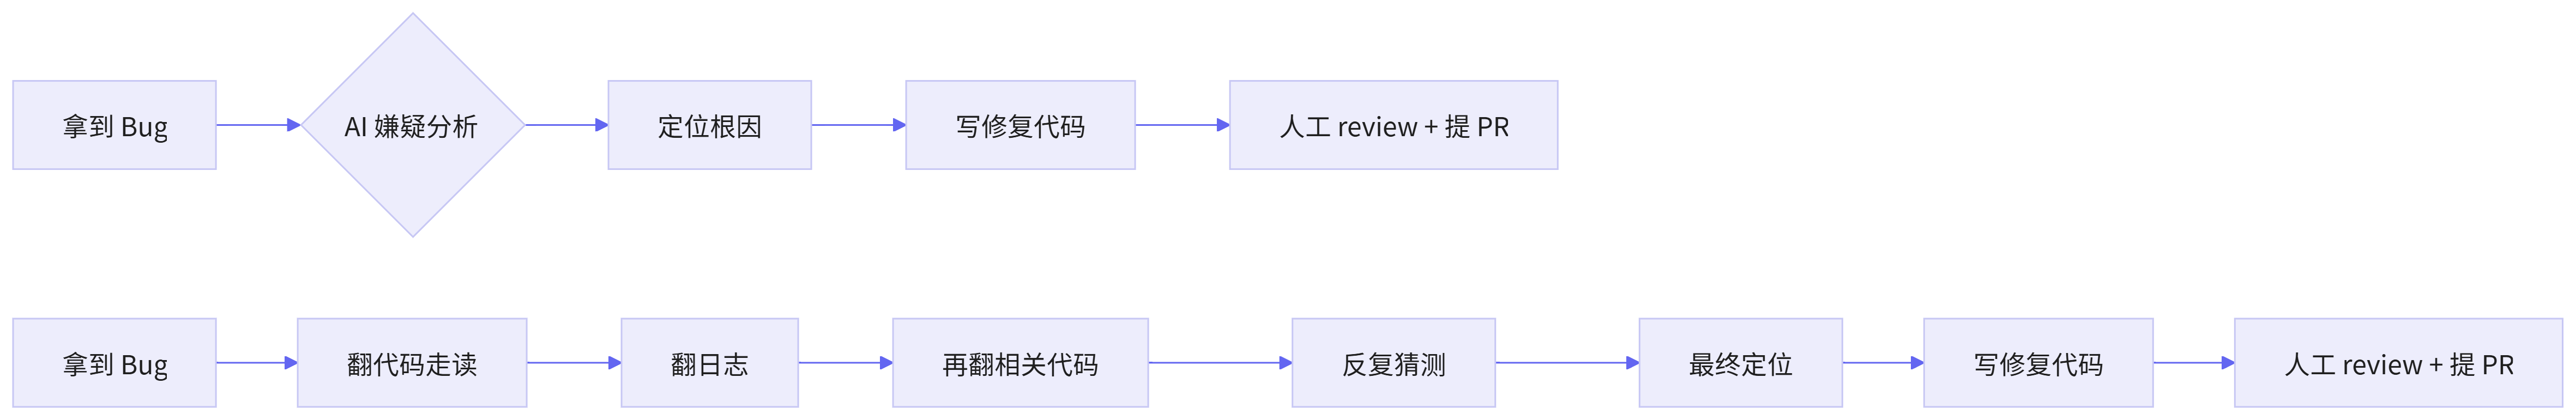
上半部分是我现在的流程,下半部分是我以前的流程。区别在哪?我现在有 AI 帮我做"信息压缩"这个最费脑子的活,我能直接进入"判断和决策"。以前我是在信息海里游,现在我是站在信息海的入口,让 AI 给我画一张地图,我再决定往哪走。
修 bug 这块 AI 也有搞不定的时候
我得说点实在的,AI 定位 bug 不是万能的,有这么几种情况我现在还是不敢全信它:
- 跨多个服务的链路问题。 它只看到你贴给它的代码和日志,看不到全局。所以一定要把"前置调用链"明确告诉它,不然它给的建议是断章取义的。
- 时序/并发类的诡异 bug。 这些 bug 经常是"特定时间窗口、特定数据、特定线程顺序"下才复现的。AI 推理是静态的,它抓不到这种动态行为。这种我得自己上 jstack、arthas 一类工具去抓现场。
- 业务逻辑"对不对"的判断。 比如某个字段该不该这么传、某个状态该不该这么流转——这是业务规则,不是技术问题,AI 不知道你公司的业务。
所以我的原则是:AI 帮我定位根因,我自己判断这个根因是不是真的。这两步都不能省。
二、查资料这事,我让 AI 给我当"知识秘书"
程序员查资料到底有多烦
再说查资料。我以前查一个框架的某个配置项,大概是这么个流程:
- 先打开 Google,搜"XX 配置"
- 搜到一堆结果,但很多是过时的、或者跟你用的版本对不上的
- 挣扎着打开官方文档
- 官方文档写得跟论文一样,看三遍不知所云
- 去 Stack Overflow 找答案
- SO 里的答案和官方说法有时候还互相矛盾
- 折腾半天,关了五六个 tab,得出一个结论:"这个配置好像是这样的,又好像不是"
整个过程短则十分钟,长则半小时。而且最让人抓狂的是——你下次还要重新来一遍。我后来意识到,我做的是一件"AI 最擅长的事情":在大量文档里抓取、整合、回答一个具体问题。
我让 AI 给我当"知识秘书"的具体做法
我现在的做法是,给我常用的几个中间件、框架、SDK,每个都建一个"知识库"。所谓知识库就是一份 Markdown 文档,里面是这个工具我常用到的高频配置、常见坑、最佳实践。每次我查完资料、踩完坑,就把内容沉淀进去。
但这还不够。沉淀完之后,我把这个知识库喂给 AI,让它带着这份知识库给我回答问题。
举一个 Redis 集群的例子。我以前配 Redis Cluster 的 cluster-node-timeout 参数,每次都得现翻文档,因为不同版本的默认值不一样,而且这个参数跟故障转移时间直接相关,不能拍脑袋设。
以前我大概要花 20 分钟查资料:
1. 打开 redis.io,找 cluster-node-timeout
2. 发现文档只说"默认值 15000ms",没说为什么
3. 搜博客,有的说生产环境要调到 30000-60000
4. 又搜到一篇文章说调到 5000 也能用
5. 陷入纠结
现在我直接问 AI,而且因为我之前已经在知识库里沉淀过相关的实战笔记,AI 给我的答案是有"上下文"的:
【我的提问】
我用的是 Redis 7.0 集群,节点之间是跨机房的,网络 RTT 大概 5ms。
cluster-node-timeout 我该设多少?【AI 的回答】
跨机房场景下,建议把这个值调到 30000-60000ms 之间。
理由:
1. 跨机房 RTT 高,节点间心跳容易被误判为"失联"
2. 默认 15000ms 在跨机房场景下太短,容易触发不必要的故障转移
3. 你的 RTT 5ms 属于中等水平,给 30 秒的窗口比较稳
4. 顺便检查一下 cluster-replica-validity-factor,这个参数配合着用注意我标了"顺便检查一下"——这种附带的相关参数提醒,是我自己查资料时几乎不会主动去想的,但 AI 经常能给我提一句。这一句经常救命。
为了让你看清"查资料"在我工作流里的位置,我画了张时序图:
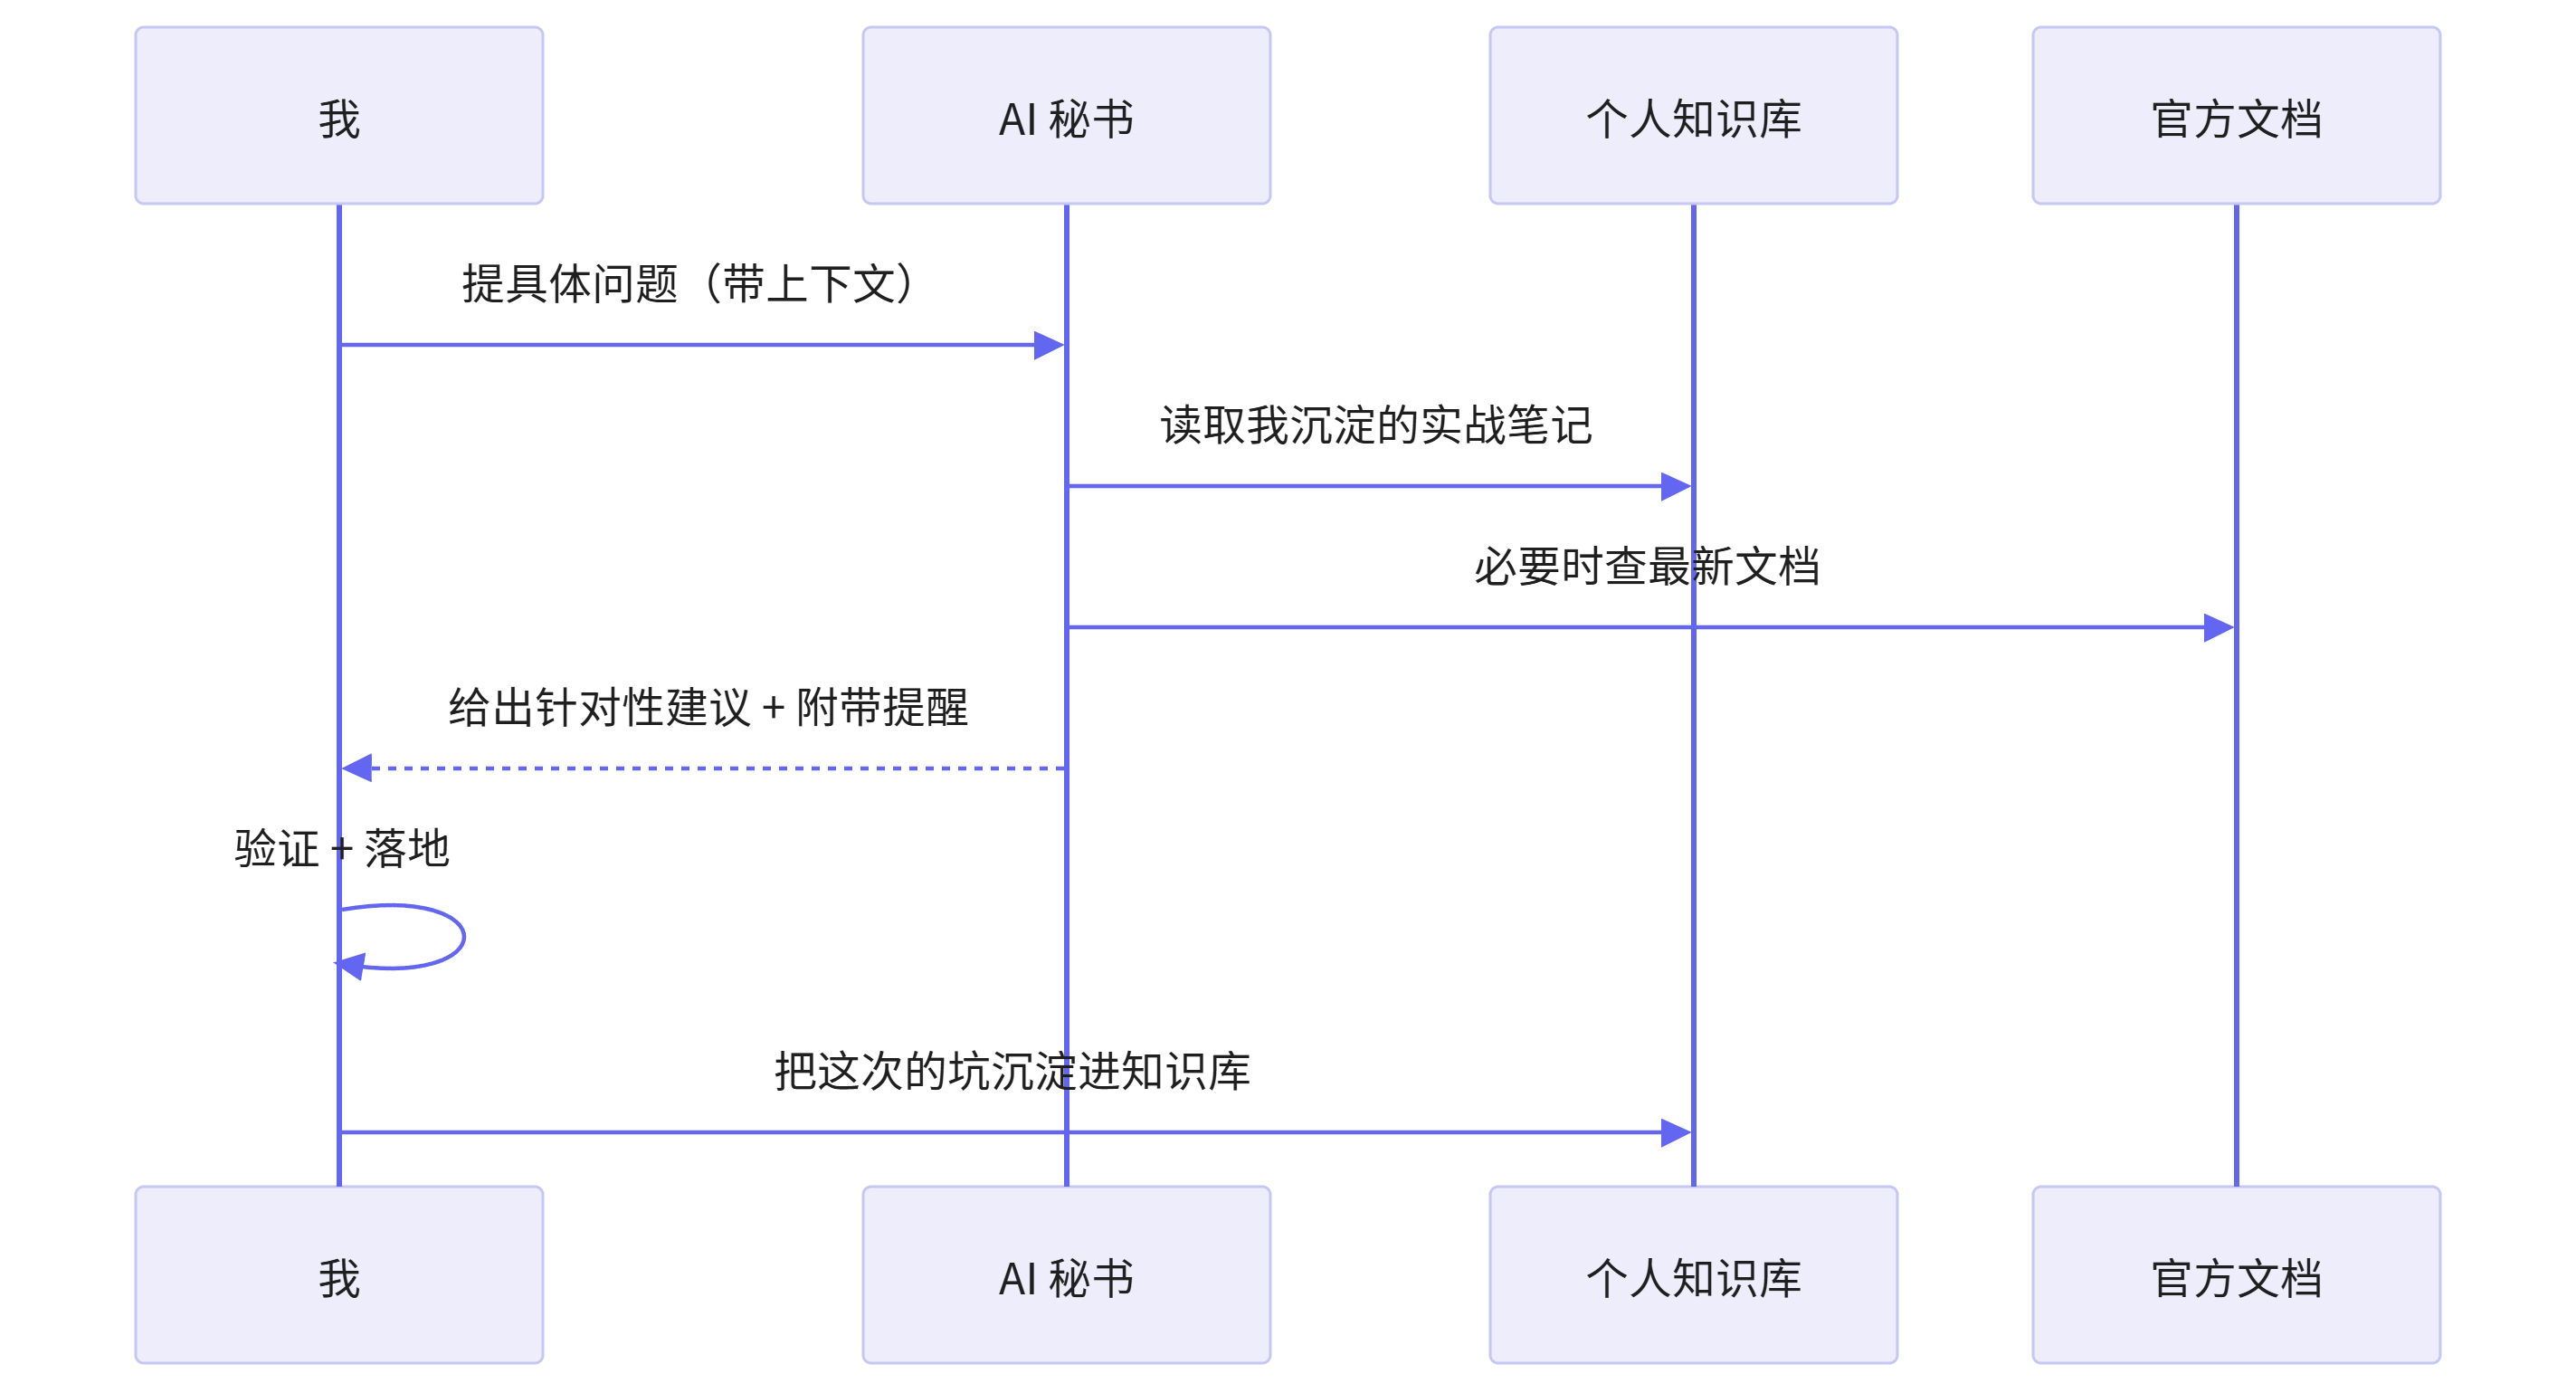
你看到最后那一步了——我把这次的坑沉淀进知识库。这一步是闭环的关键。我每解决一个问题、每踩一个坑,都顺手写进知识库。这样下次再问,AI 就能带着"我自己的历史经验"来回答我,答案比纯靠 AI 通用知识更贴我团队的实际情况。
查资料这块我踩过的坑
这块也有坑,给你们提个醒:
- 别让 AI 直接读最新代码生成配置。 比如你想知道某个 SDK 最新版本的某个 API,AI 可能会给你"幻觉"出一个看起来很像的 API 名,实际上不存在。所以关键配置一定要回官方文档再确认一遍,AI 只能给你方向,不能给你"最后那一锤"。
- 给 AI 提供版本号、场景约束。 不给它上下文,它就会给你"通用答案",通用答案等于没答案。我每次提问都会明确说"我用的 XX 版本、网络是 XX、QPS 大概 XX"。
- 知识库要自己维护,不要全靠 AI 总结。 我试过让 AI 给我总结我的历史笔记,结果它会"润色"掉一些我踩过的、很具体的细节。所以沉淀这一步必须自己写。
三、这套玩法让我"省下来"的时间和精力到底用在哪了
我跟你算一笔账。我以前的工作时间大概是这样分配的:
工作内容 | 占比 | AI 接出去后 |
|---|---|---|
机械定位 bug | 25% | 降到 8% |
翻文档查资料 | 20% | 降到 5% |
写重复的胶水代码 | 15% | 降到 4% |
架构设计、方案讨论 | 15% | 提到 30% |
写核心业务代码 | 15% | 提到 35% |
沟通、协调、code review | 10% | 提到 18% |
数字是大概估的,但趋势是真实的:AI 把我从"信息处理"这个底层环节里拔了出来,让我能腾出手做"判断"和"创造"。
举个具体例子。以前一周我大概能"想清楚一个架构问题",现在一周能"想清楚两个甚至三个"。不是因为我的脑子变聪明了,是因为我没有被"修一个破 bug 修两天"这种低价值的事情占满时间。
四、说几个我这半年最大的实操感悟
写到这里收个尾,给你们几条真心话:
第一,AI 不是替你干活,是替你把"不值得人干的活"干了。 找资料、定位 bug、写模板代码,这些事 AI 干得又快又稳,人干纯属浪费。人就该留在"判断对错"和"设计方案"上。
第二,提示词比模型重要。 同样的 AI,提示词写得清楚,输出就干净能直接用;写得含糊,输出就是一堆正确的废话。我这块的提示词前前后后改了七八版,每一版都是在实际使用中被打磨出来的。
第三,闭环比单点工具重要。 不是说"我今天用了 AI 查了一个资料"就叫"用 AI 了"。真正的用法是:让 AI 干它擅长的事 → 验证 → 把结果沉淀进你自己的体系 → 下次再用同样的体系。这个闭环跑起来之后,你的工作流会越来越顺。
第四,一定要留"人工兜底"。 AI 是筛子,不是法官。关键路径、安全、设计决策,这些地方你撒手了,迟早出事。我上面举的例子,每一个最后那一下拍板,都是我自己做的。
第五,别指望一步到位。 我是先从"查资料"开始试,因为这块风险最小;跑顺了才敢让 AI 帮我"定位 bug";再后来才到"生成代码模板"。步子迈太大,反而容易翻车。
最后说句掏心窝的话:程序员这个职业挺矛盾的,我们天天和机器打交道,但最该被机器解放的,其实是我们自己。我以前以为"加班"是程序员的常态,后来发现,那是因为我们把太多时间花在了"本该由 AI 干"的事情上。
把这部分时间抢回来之后,你会发现,写代码这件事其实没那么累。累的是那些本不该你干的活。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号