【论文解读】Deep attention SMOTE:面向燃气轮机不平衡异常检测的可学习插值过采样方法
原创
【论文解读】Deep attention SMOTE:面向燃气轮机不平衡异常检测的可学习插值过采样方法
原创
用户6831054
发布于 2026-09-13 15:09:39
发布于 2026-09-13 15:09:39
在燃气轮机等大型装备的运行监测中,由于正常工况数据远多于故障数据,且早期微弱故障与正常状态高度相似,导致异常检测面临严重的数据不平衡与类别重叠问题。针对这些实际工程挑战,论文《Deep attention SMOTE: Data augmentation with a learnable interpolation factor for imbalanced anomaly detection of gas turbines》提出了一种基于注意力机制的混合重采样异常检测框架。该框架将聚类欠采样与带有编码器-解码器结构的深度注意力过采样算法相结合,多维时间序列特征空间中生成高质量的合成异常样本,从而改善下游分类器的决策边界。
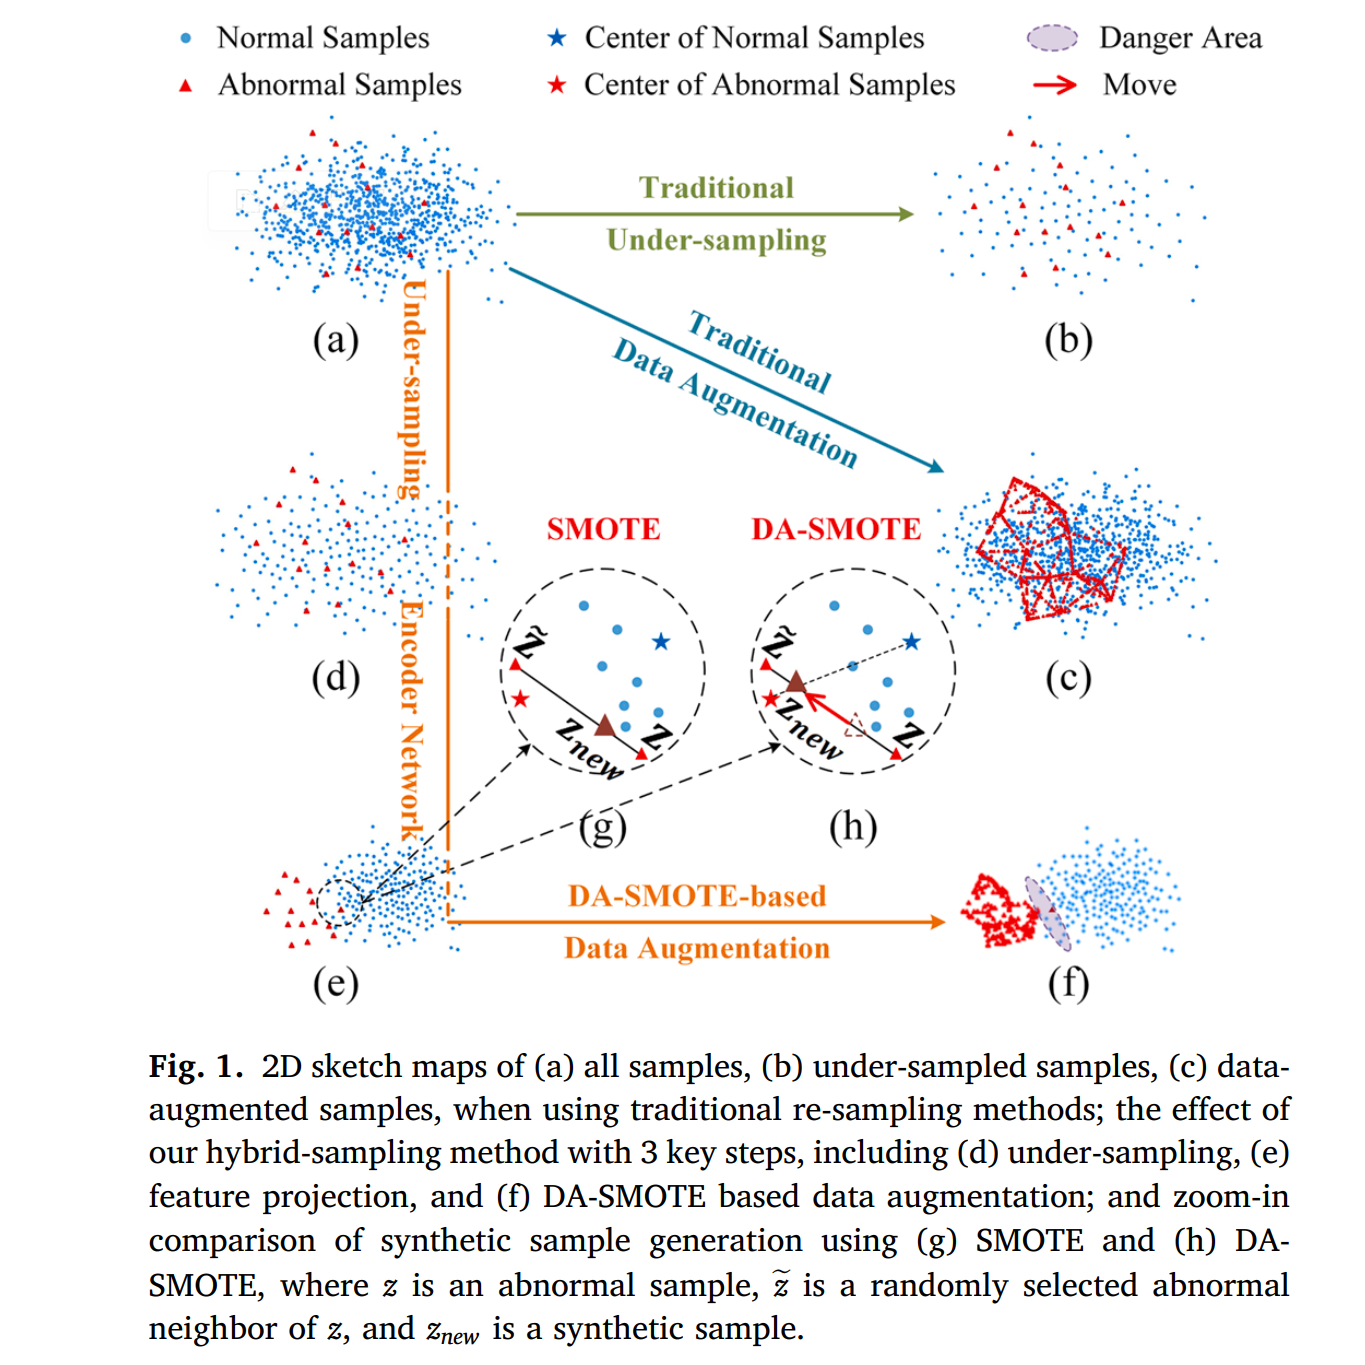
图1:整体异常检测框架流程图
为了兼顾信息保留与类别平衡,该方案首先在原始数据空间进行基于聚类的欠采样处理。传统欠采样方法通常直接随机剔除大量正常样本,容易造成重要背景工况信息的丢失;而该方法采用聚类算法将正常样本划分为多个簇群,提取簇中心作为代表性的多数类样本,再与全部真实异常样本组合构成欠采样数据集。这种处理方式在缩小正常与异常样本数量差异的同时,最大程度保留了正常数据的全局分布特征。
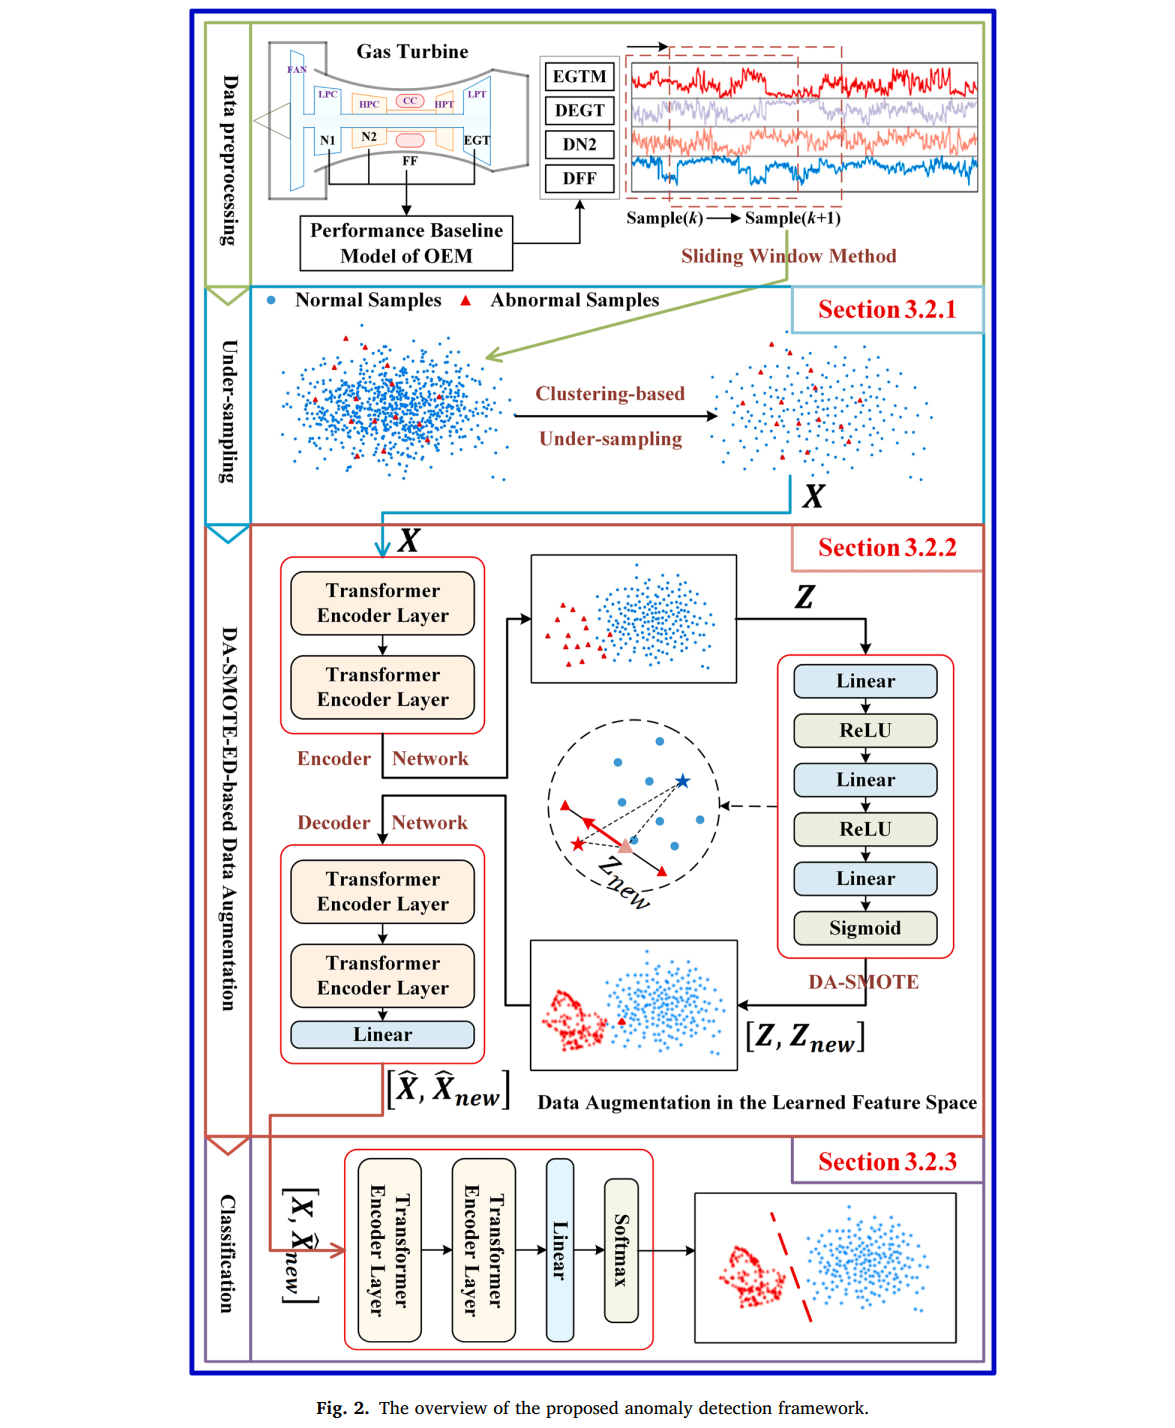
图2:传统重采样与所提混合重采样原理对比
针对原始监测空间中正常与异常样本重叠严重的现象,框架引入了基于多头自注意力机制的编码器模块,将欠采样数据映射至具有良好可分性的隐层特征空间。在模型训练过程中,网络联合优化重构损失与三元组中心损失,在保证原始多维时序关键信息可逆重构的前提下,驱使同类样本向各自的类别中心聚合,并拉大异类中心之间的距离。这种分布约束有效收缩了类别交界处的危险模糊区域,为后续的样本插值提供了清晰的特征空间。
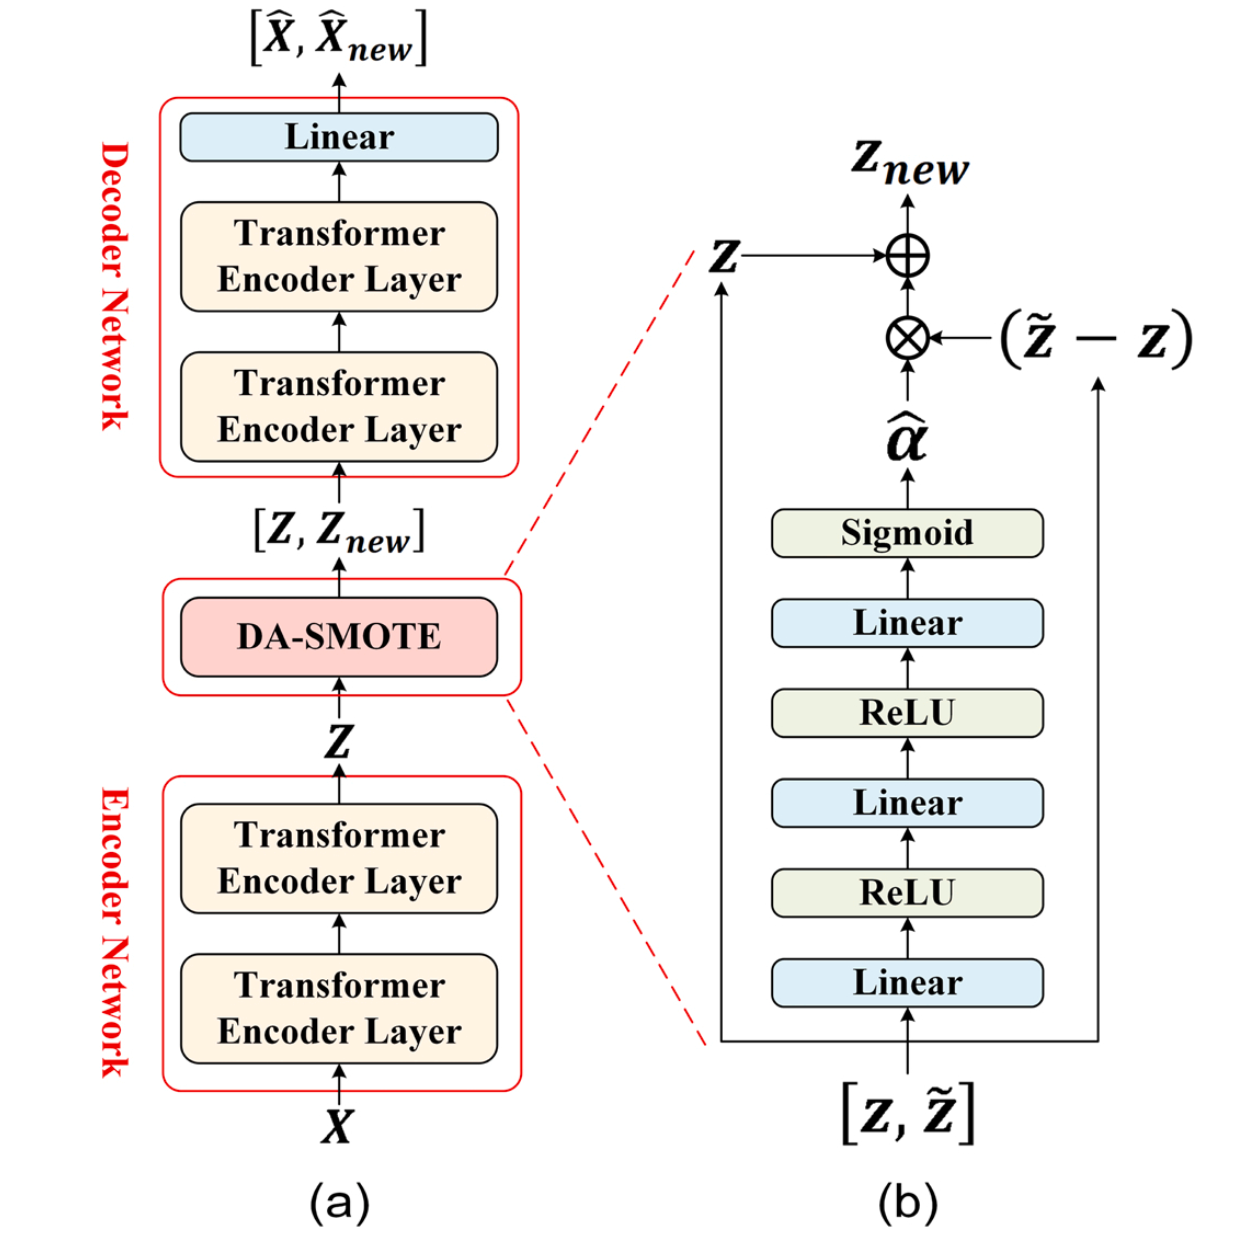
图3:深度注意力过采样网络架构与插值单元
在隐层特征空间中,论文设计了深度注意力过采样算法以生成少数类样本。传统算法通常在近邻样本连线上采用完全随机的权重进行线性插值,合成样本容易误入多数类区域;该方法则构建了一个轻量级的注意力映射子网络,根据相邻样本对的分布特征自适应计算插值因子。该因子使新生成的合成样本在向异常类中心靠拢的同时主动远离正常类聚集区,最后通过训练好的解码器将合成特征映射回原始输入空间,与欠采样样本共同组成平衡训练集。
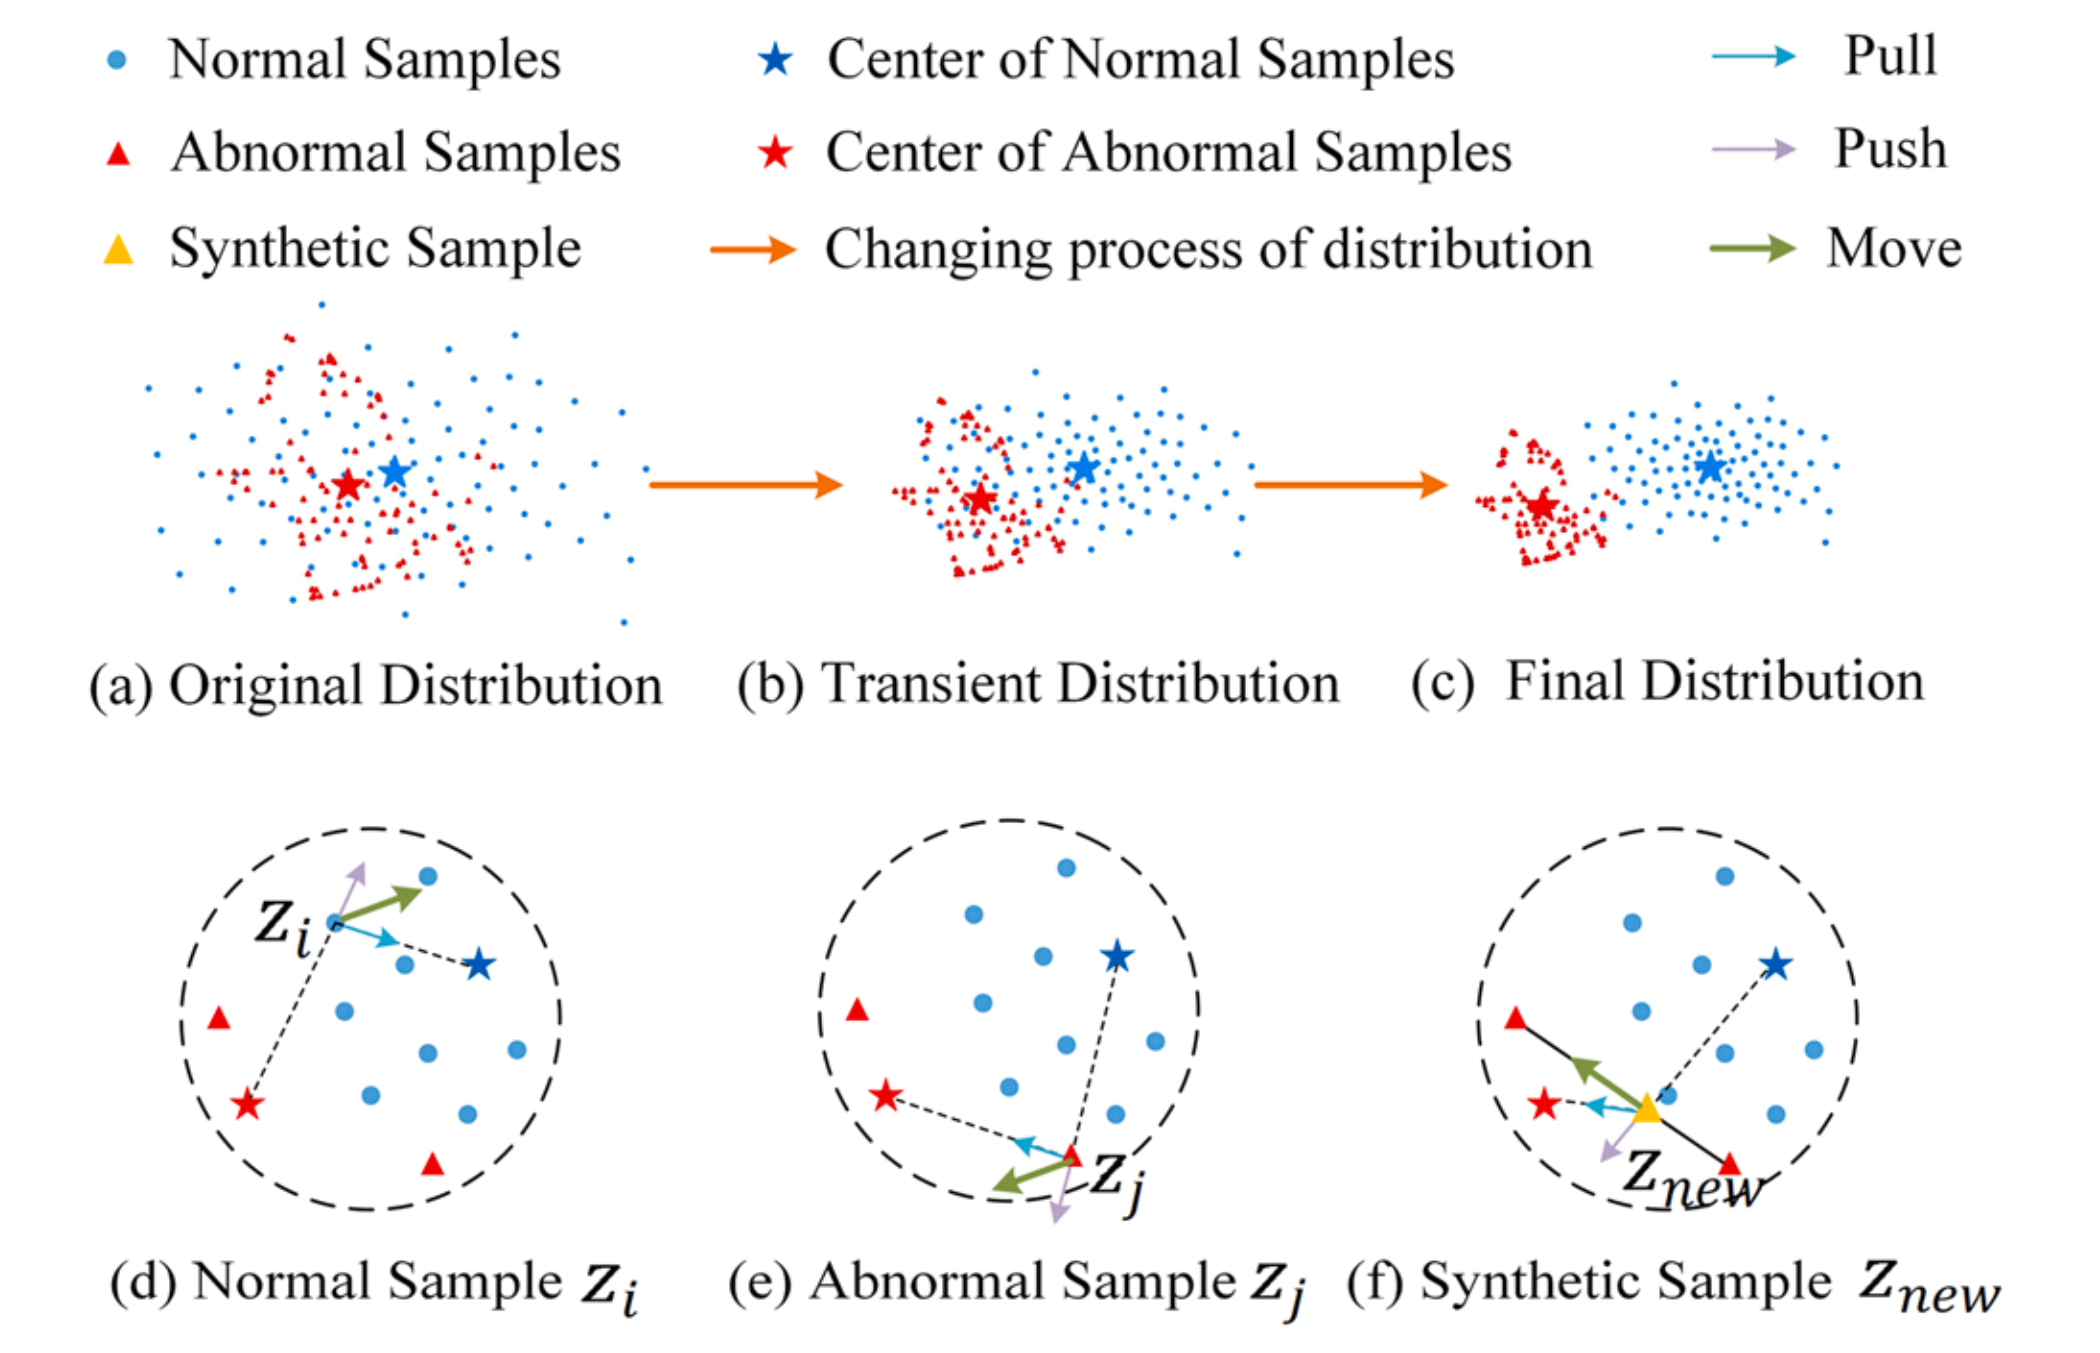
图4:样本特征空间分布演化过程
在完成数据重采样平衡后,系统采用自注意力网络作为端到端分类模型,充分利用多头自注意力对多维时间序列复杂动态特性的建模能力,直接完成对监测信号的异常判定。该框架不仅适用于二分类的设备异常检测场景,其特征对齐损失与插值机制也可直接推广至多分类的故障定位任务中,为工业多维时序信号在小样本及非平衡条件下的特征学习与数据增强提供了一种的解决思路。
参考文献:
Deep attention SMOTE: Data augmentation with a learnable interpolation factor for imbalanced anomaly detection of gas turbines[J]. Computers in Industry, 2023, 151: 103972.
https://www.sciencedirect.com/science/article/abs/pii/S0166361523001227
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号