【论文解读】深度同心孪生网络:聚焦小样本船舶主机故障诊断中的难样本挖掘
原创
【论文解读】深度同心孪生网络:聚焦小样本船舶主机故障诊断中的难样本挖掘
原创
用户6831054
发布于 2026-09-13 16:03:58
发布于 2026-09-13 16:03:58
针对船舶主机在实际运行中故障样本稀缺、各部件关联性强导致不同故障间特征差异微弱(即存在难分类样本)的问题,发表于《Measurement》的论文《DCSN: Focusing on hard samples mining in small-sample fault diagnosis of marine engine》提出了一种名为深度同心孪生网络(DCSN)的度量学习方法。该方法通过构建样本对度量学习框架与同心损失函数,在小样本工况下引导模型重点关注难样本的特征分布,提升故障辨识的可靠性。
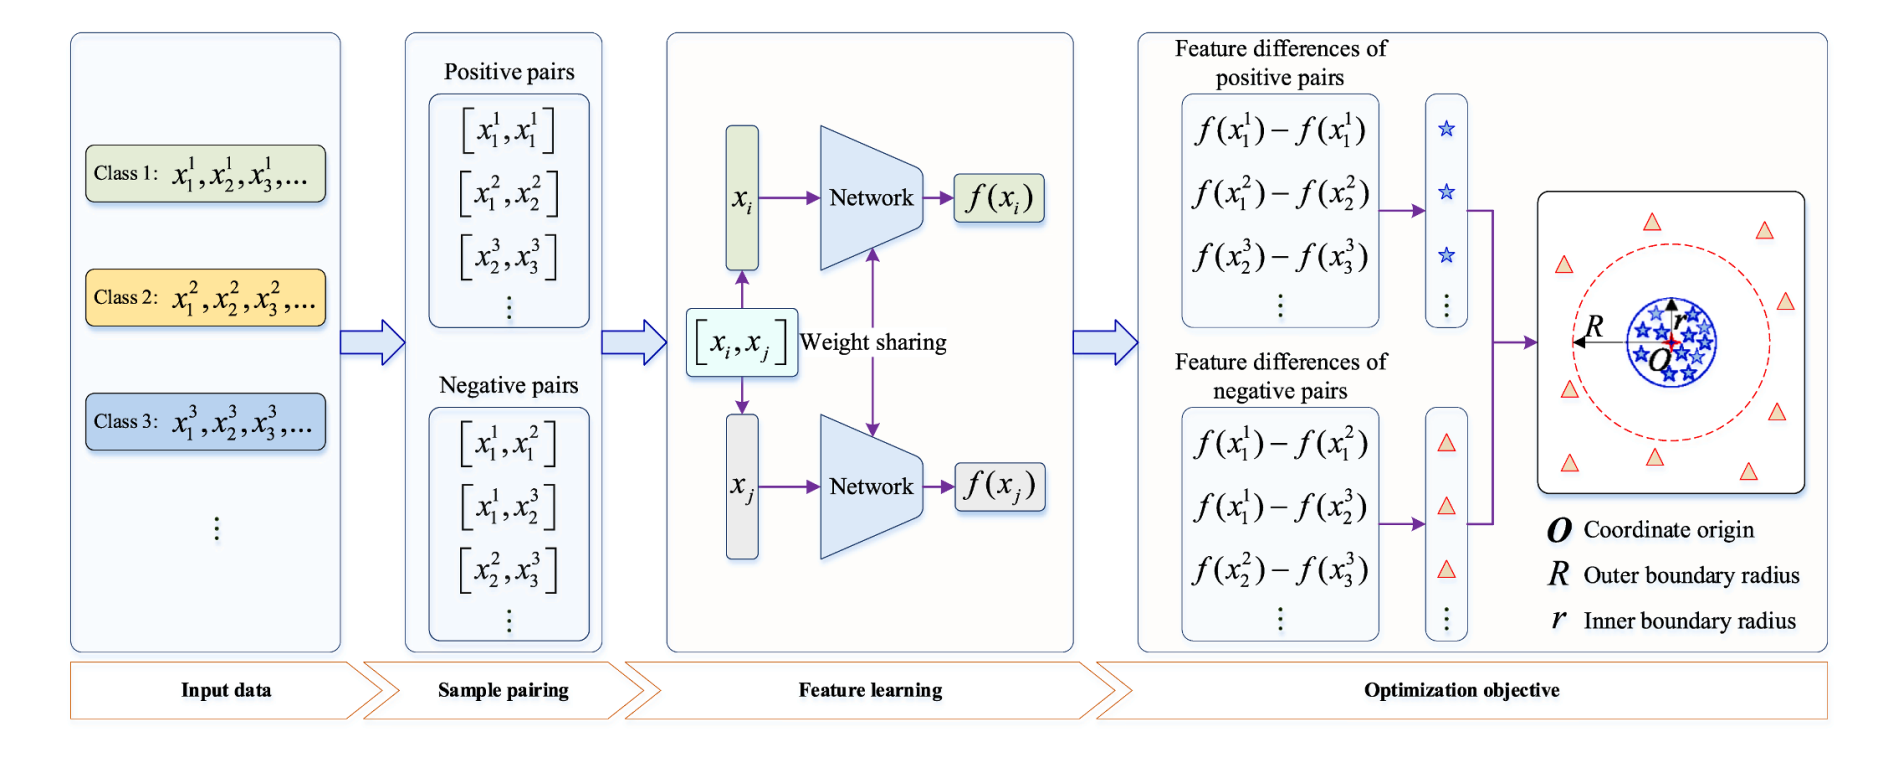
图1 深度同心孪生网络(DCSN)总体架构与流程图
在数据构建与特征提取阶段,DCSN将多分类问题转化为样本对的二分类度量任务。模型通过交叉组合策略将故障样本和正常样本分别构建为正样本对(同类)与负样本对(异类),并控制正负样本对的数量平衡,以缓解小样本下的过拟合及类别不均衡问题。然后,成对样本被输入至具有权重共享机制的深度残差网络分支中,提取出一维特征向量并映射至统一的度量特征空间中,计算样本对之间的特征差异距离。
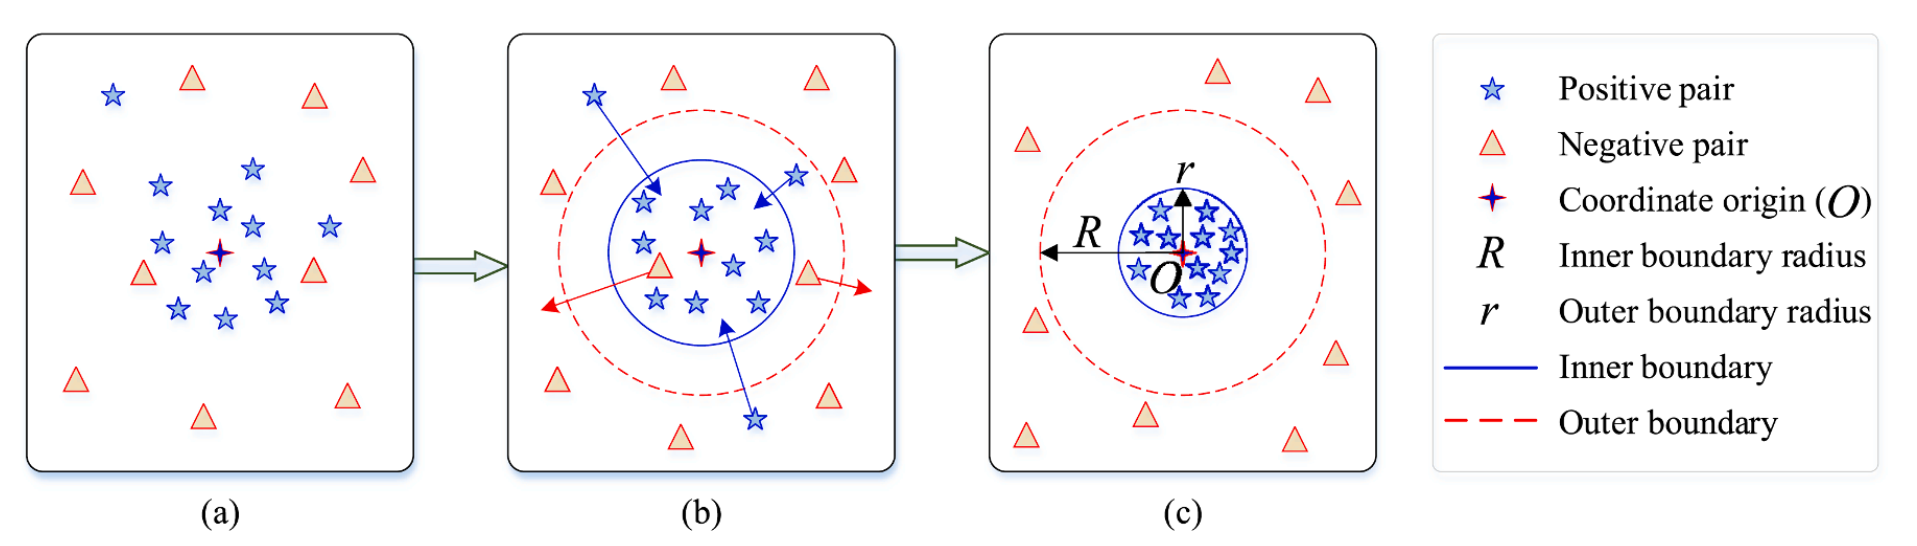
图2 同心损失在度量空间中的样本分布约束原理图
针对传统孪生网络容易被大量简单样本主导而忽视难样本的问题,论文设计了同心损失作为优化目标。该损失在度量空间中设立以内外边界为约束的同心圆区域:已经正确分类的简单正样本对(位于内边界以内)与简单负样本对(位于外边界以外)其损失被置为零,不产生回传梯度;而位于内边界之外的难正样本对与位于外边界之内的难负样本对则产生显著惩罚,从而促使模型在反向传播时将优化重点聚焦于难样本的特征修正。
为了进一步增强类内紧凑性与类间分离度,DCSN在迭代训练过程中引入了内边界自适应收缩机制。外边界半径设为固定基准,随着网络权重的更新,算法根据训练集中正样本对距离分布的统计变化动态减小内边界半径。这种渐进式收缩强制同类样本对映射到更小的空间范围内,扩大了正负样本对之间的几何间隔,使类间差异更易于区分。
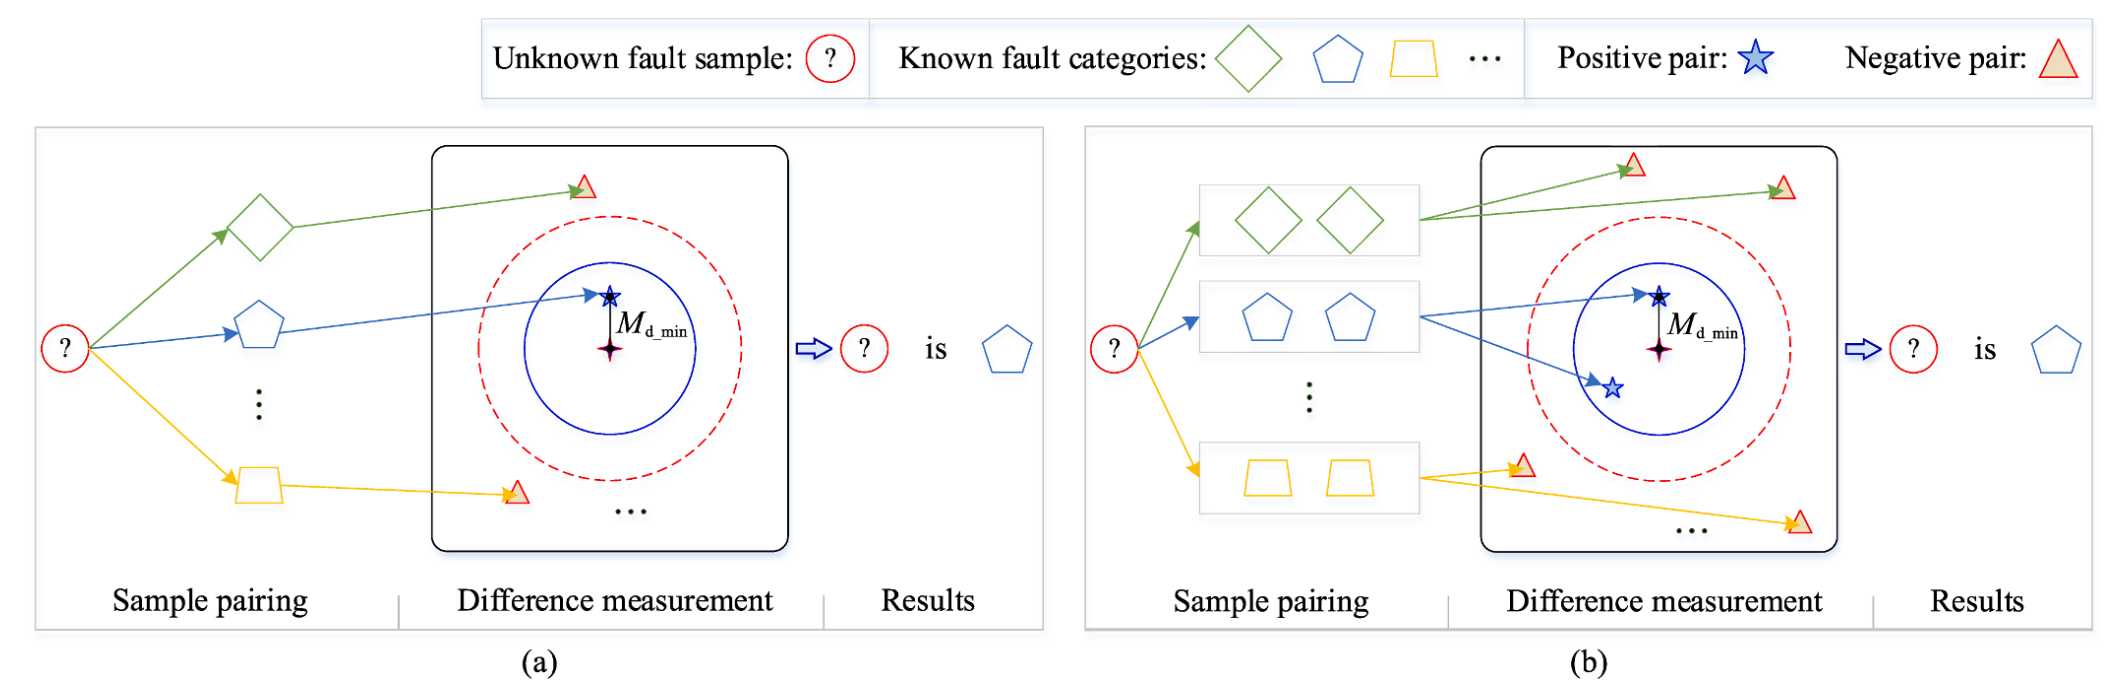
图3 小样本故障诊断中的单样本与少样本测试策略示意图
在故障推理诊断阶段,DCSN采用少样本测试策略。待测样本与已知类别的参考样本分别组合成测试样本对并输入网络,计算其特征差异距离,最后将待测样本判定为与其特征差异最小的已知样本所属类别。该方法为工业复杂装备在有限标注数据与难样本干扰条件下的状态监测与故障诊断提供了一个较为规范的度量学习技术流程。
参考文献:
DCSN: Focusing on hard samples mining in small-sample fault diagnosis of marine engine[J]. Measurement, 2024, 235: 114929.
https://www.sciencedirect.com/science/article/abs/pii/S0263224124008145
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号