把一堆格式混乱的Excel自动变成标准报表
原创
一、背景:为什么我需要它
我每周都要处理一批结构一致的 Excel:几十个分公司的表单,列顺序时而一样时而不一样,表头有的在第 1 行有的在第 3 行,还夹着合并单元格和空行。手工整理一次要两三个小时,而且一定会出错。
用 WorkBuddy 之后,我把这件事变成了「一句话 + 一个脚本」。现在同样的工作量,准备 5 分钟、执行 30 秒。
这篇文章把完整流程写下来,包括我踩过的坑,照着做就能复现。
二、环境准备
项目 | 版本 |
|---|---|
WorkBuddy | 客户端最新版(Windows) |
Python | 3.13(WorkBuddy 自带托管运行时,无需自己装) |
依赖 | openpyxl、pandas |
不需要单独配置环境,直接让 WorkBuddy 在托管环境里跑脚本即可。它会在隔离目录里建虚拟环境,不会污染你本机的 Python。
三、实操步骤
步骤 1:把需求一次说清楚
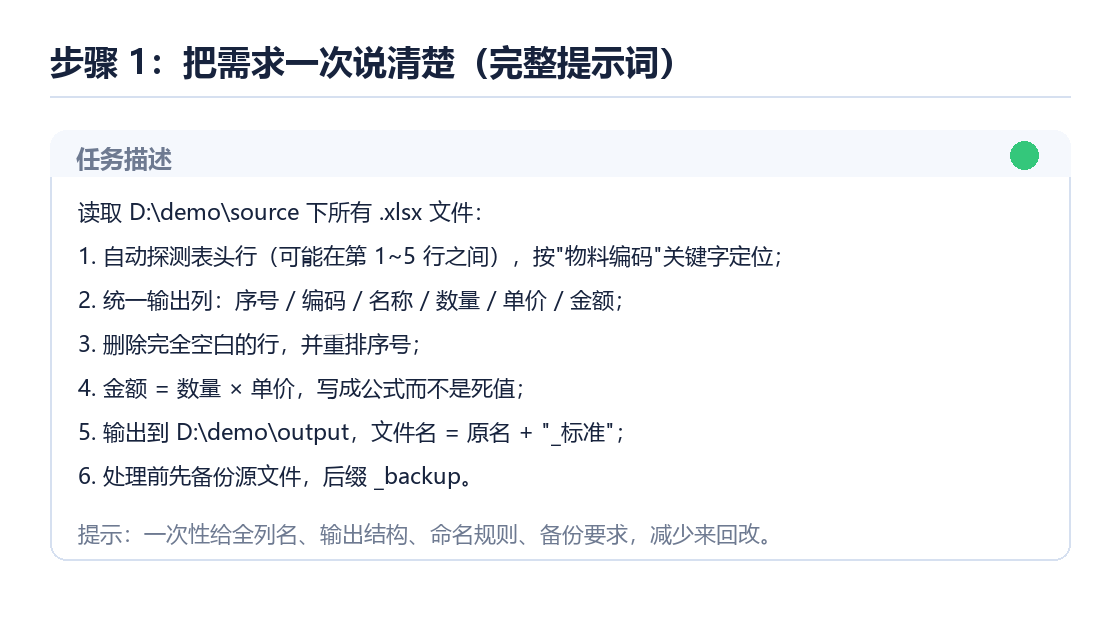
这是最省积分、也最省时间的一步。我用的提示词模板:
读取 D:\demo\source 下所有 .xlsx 文件:
1. 自动探测表头行(可能在第 1~5 行之间),按"物料编码"关键字定位;
2. 统一输出列:序号 / 编码 / 名称 / 数量 / 单价 / 金额;
3. 删除完全空白的行,并重排序号;
4. 金额 = 数量 × 单价,写成公式而不是死值;
5. 输出到 D:\demo\output,文件名 = 原名 + "_标准";
6. 处理前先备份源文件,后缀 _backup。要点:列名、输出结构、文件命名规则、备份要求,全部一次性给全。来回改一轮就多烧一轮积分。
步骤 2:让它先"看"一眼再动手
我习惯加一句「先只做探测,把每个文件识别到的表头行号打印出来,不要写文件」。
这一步能提前发现 80% 的问题——比如某个文件根本没有「物料编码」列。WorkBuddy 会回一份探测报告,确认无误再让它写。
步骤 3:正式执行
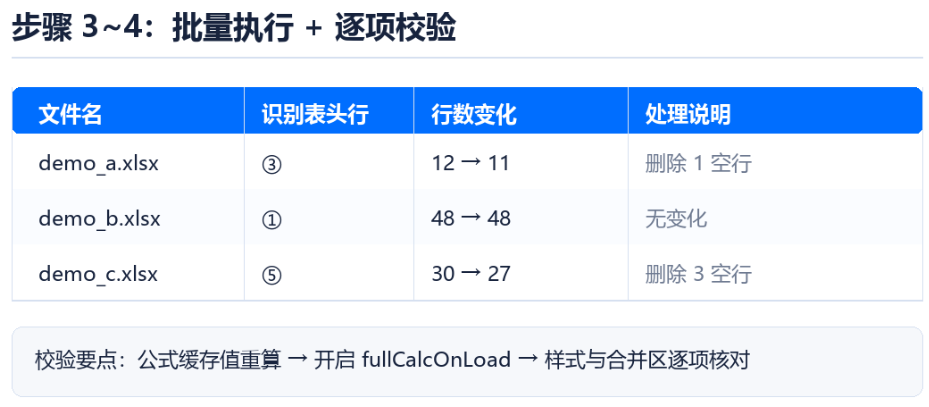
确认后回一句「按上面的规则执行」,它就会批量跑完,并告诉你每个文件的行数变化。
处理完成:
demo_a.xlsx   表头行 ③  12 → 11 行(删除 1 空行)
demo_b.xlsx   表头行 ①  48 → 48 行
demo_c.xlsx   表头行 ⑤  30 → 27 行(删除 3 空行)
步骤 4:校验公式,不要只看有没有报错
关键坑:openpyxl 写出公式后,缓存值是空的,直接打开可能是 0 或空白。
正确做法是让 WorkBuddy:
重新计算所有公式列,把结果写入缓存值,并在 workbook 里开启 fullCalcOnLoad。带这一步,文件双击打开就是算好的数字。
步骤 5:沉淀成技能,下次一句话复用
跑通一次之后,让它把流程存成技能。下次只需要说:「用上次那个表格标准化技能处理这个目录」。自动化任务也是一样的逻辑——一次性投入几十积分开发,之后每次运行只花几个积分。
四、踩坑记录
坑 1:不要用 openpyxl 的 save() 去改带图片/样式的模板 会把图片和条件格式丢掉。我的做法是直接操作 xlsx 内部的 XML(zip 手术),或者用流式写入方式,保证样式原样保留。
坑 2:合并单元格 + 删除行 = 格式错乱 删行之后合并区域不会自动跟着走,需要重新写一遍合并区,并重排公式引用。
坑 3:不要用办公软件的在线预览面板去编辑保存 有的预览器保存时会重写 styles.xml,底纹、边框全部跑偏。最终文件一律用本地 Excel/WPS 打开。
坑 4:一次性需求不要拆成多轮对话 积分是按轮次和模型消耗的。简单查询切 Ask 模式,规模化处理再切执行模式。
五、省积分技巧(亲测)
- 简单问答用 Ask 模式,别一上来就开重模式,能省 1/3 到 1/2 积分
- 轻量模型日常够用,复杂分析再换强模型
- 需求一次说清楚,减少来回修改
- 重复性工作优先做成自动化任务或技能
六、总结
这套流程的核心不是脚本本身,而是**"先探测、再执行、后校验、最后沉淀"**四步法。任何批量文件处理都能套:
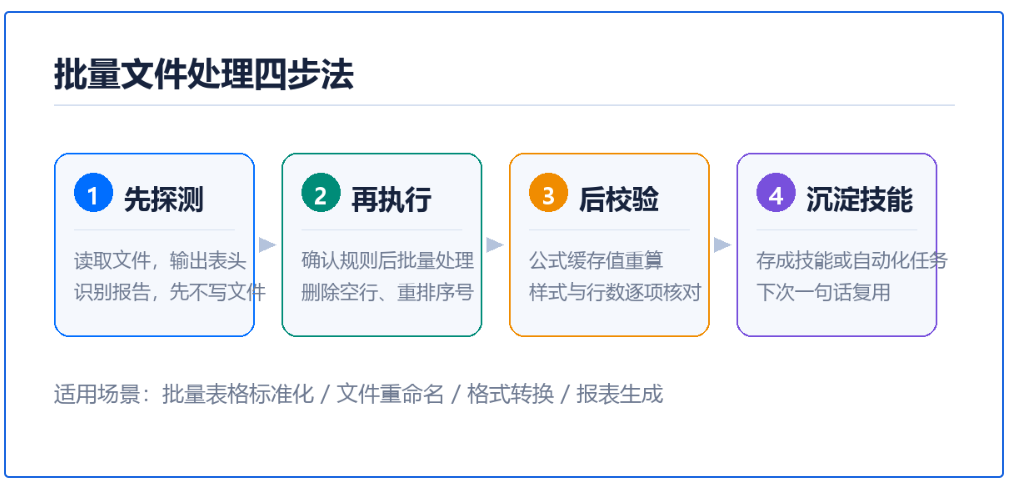
- 探测:先看数据结构,输出报告
- 执行:确认规则后批量跑
- 校验:公式缓存、样式、行数逐项核对
- 沉淀:存成技能或自动化任务,下次一句话复用
从两小时到五分钟,这就是我把 WorkBuddy 用起来之后最直观的变化。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号