A2A 的难点从来不是通信,而是上下文
原创
A2A 的难点从来不是通信,而是上下文
原创
OneCode
发布于 2026-09-14 17:42:38
发布于 2026-09-14 17:42:38
一次关于「多节点 / 多轮对话 / 强流程」三重复杂度下 上下文治理的深度复盘
结论先行为什么是上下文问题A2A 四层底座多节点多轮对话强流程八个根因解题:上下文契约可验证的工程方法三条反常识附录
零、先给一个反直觉的结论
如果你问一个工程师「A2A(Agent-to-Agent)难在哪」,绝大多数人的第一反应是协议:消息格式、寻址、握手、鉴权、重试。
这个答案只对了三分之一。
真实情况是:A2A 的消息能发出去,从来不是最难的部分。最难的是消息到达之后,接收端凭什么知道「现在是什么状态」。
而「现在是什么状态」这件事,就是上下文。
我们在 ooderAgent 仓库里做过一次横跨 scene-engine / ooder-pro / agent-sdk / aiserver / ooder-common 五个模块的只读上下文审计,最终结论是:
这不是 8 个独立 bug,而是同一件事的 8 个投影——缺少一个「带层归属 + 合并算子 + 版本指纹 + 责任主体」的上下文增量契约。
先看三个真实片段,感受一下「上下文问题」长什么样。
片段一:一次失败被吃掉了
父流程调用子流程,子流程执行失败。但父流程最终状态是
COMPLETED,一路推进到 END 归档。日志里甚至打印了子流程的真实状态,只是没人据此改变判定。 审计原文(缺口 F2,P0):「失败静默—— 子流程 FAILED/CANCELLED 计入 COMPLETED,父流程按成功推进。」
片段二:每一轮的上下文快照,写了,但没人读
系统很勤快:每轮对话结束都把上下文快照写进 VFS(convround/{convId}/{roundId}/context.json),目录事件也正常创建。审计原文(缺口 D3,P0):「rounds/{roundId}/context.json
只写不读
loadRoundContext在 ooder-pro 侧无任何调用点,每轮快照是死数据,会话恢复 / 换机续聊未接线。」
片段三:一个 8000 字的「防呆上限」
跨节点委托要传递上下文。实现方式是整段字符串透传,能力工具入口有 8000 字防呆上限;接收端回执时把 snippet 截到 2000 字预览 / 160 字 head。 审计原文(缺口 A3,P0):「超长上下文只能截断丢弃,无引用传递;且截断只在一条入口生效,另一条入口(直连 HTTP)无限透传。」全仓 A2A 侧refs/resourceUri/contextVfsRef零命中。这三个片段分别落在强流程、多轮对话、多节点三个场景里,但它们的病根是同一个:没有人回答过「这段上下文属于谁、谁可以写、写完怎么合并、冲突了算谁的」。
一、为什么 A2A 必然退化成「上下文问题」
1.1 单 Agent 时代的幸运
在只有一个模型、一个进程、一轮请求的时代,上下文管理几乎是自动的:
- 空间上:只有一个地址,不存在「发给谁」。
- 时间上:只有一轮,不存在「上一轮说过什么」。
- 结构上:只有一个扁平 prompt,不存在「哪一层该被继承」。
- 载体上:只有内存,不存在「内存与持久化谁为准」。
一个 StringBuilder 拼出来的 prompt 就够用了。所以那个时代,上下文是实现细节。
1.2 A2A 让四个维度同时爆炸
维度 | 单 Agent | A2A |
|---|---|---|
空间(多节点) | 1 个进程 | N 个节点、N 个实例、每个都有自己的内存与目录 |
时间(多轮) | 1 轮 | 多轮、跨会话、跨场景切换、跨设备续聊 |
结构(强流程) | 平铺 | 父子流程、阶段、泳道、分支/汇聚、暂停/恢复 |
载体(多存储) | 内存 | 内存 + VFS + SQLite + MQTT + person 镜像 + registry |
此时的「上下文」不再是一段文本,而是一个分布式的、有生命周期的、有归属的状态集合。
1.3 上下文管理的四个必答问题
任何一段上下文,只要它跨越了「进程边界」「轮次边界」「实例边界」中的任意一个,就必须能回答四个问题:
# | 问题 | 答不上来会怎样 |
|---|---|---|
Q1 | 归属:这段值属于哪一层?(身份 / 规则 / 场景 / 工作 / 记忆 / 知识) | 不同代码各写各的,同名不同层、同层不同名 |
Q2 | 算子:这次写入怎么合并?(替换 / 只补空 / 增量 / 追加 / 引用合并 / 删除) | 覆盖行为不可推导,同一个值今天被覆盖、明天不 |
Q3 | 版本:这份内容对应哪个版本?(指纹 / 序号 / 幂等键) | 幂等、缓存失效、重放全部失真 |
Q4 | 责任:谁写的、为什么写?(owner / reason / correlationId) | 出了事无法追溯,只能看现象猜原因 |
A2A 的所有「疑难杂症」,本质都是这四个问题在某个场景下无人回答。
1.4 一个残酷的推论
因为 A2A 的协作面就是上下文的边界,所以:
协议标准(比如 A2A v1.0.0 的 Agent Card / Task 生命周期)解决的是「怎么找到对方、怎么表达任务」;它不解决、也无法解决「对方的上下文与本方上下文如何统一口径」。
这就是为什么我们在实现完四层底座之后,发现真正的工作量落在了上下文契约上。
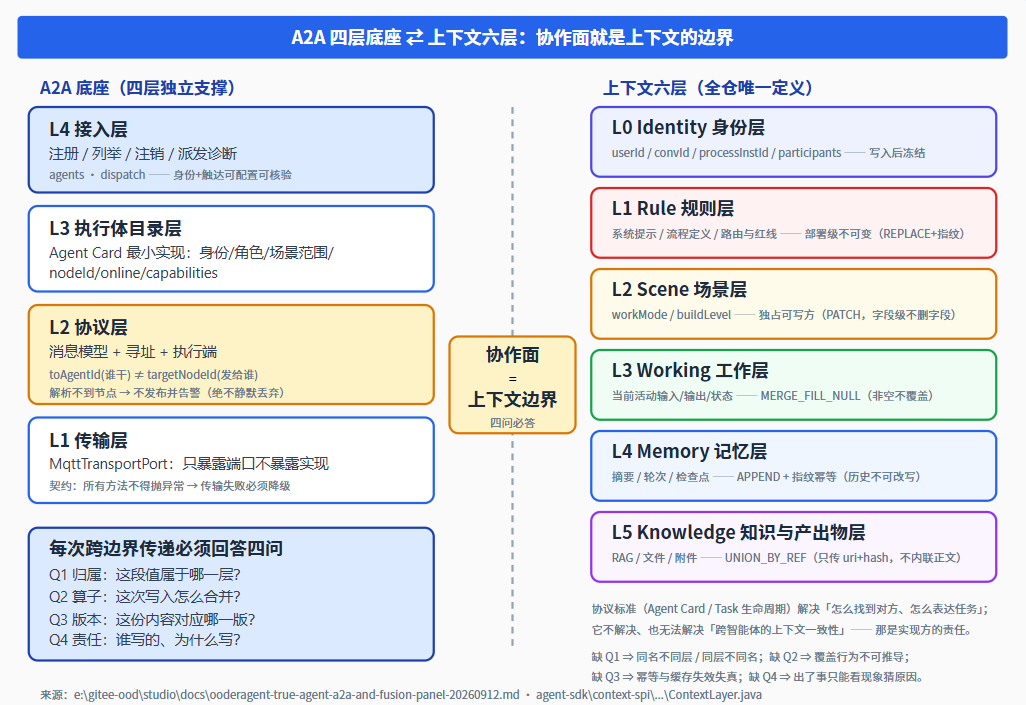
图 1 A2A 四层底座 ⇄ 上下文六层:协作面就是上下文的边界
二、先把底座讲清楚:A2A 的四层
在讨论上下文之前,必须先把「上下文要穿过什么」讲清楚。ooderAgent 的 A2A 底座刻意做成四层独立支撑,不寄生于任何业务模块。
2.1 L1 传输层:只暴露端口,不暴露实现
/** L1 传输端口:所有方法不得抛异常,失败一律返回 false 或记日志,由上层决定降级 */
public interface MqttTransportPort {
    boolean connect(String brokerUrl, String clientId, String user, String pwd);
    boolean publish(String topic, String payload);
    boolean subscribe(String topicFilter);
    void addHandler(BiConsumer<String, String> handler);
    void disconnect();
}契约里那句「不得抛异常」不是随手写的注释,而是设计的一部分:传输不可用时,协议栈应当降级,而不能雪崩。
这条约束在后面会反复出现——它是「失败显式化」原则在下层的第一次落地。
2.2 L2 协议层:把「谁干」和「发给谁」彻底分开
public class A2AMessage {
    private String messageId;        // 幂等键
    private String conversationId;   // 归属会话
    private String sceneGroupId;     // 组播分组
    private String fromAgentId;
    private String toAgentId;        // 执行体:谁干
    private String targetNodeId;     // 目标节点:发给谁(与 toAgentId 语义分离)
    private A2AMessageType messageType;  // TASK_REQUEST / TASK_RESPONSE / DATA_REQUEST ...
    private Object payload;
    private Map<String, Object> headers; // headers.requestId 用于请求-响应关联
}
为什么这条拆分是救命的设计?
因为我们真的踩过坑:早期把toAgentId当nodeId用,消息被发布到ooder/node/{agentId}/inbox,而没有任何节点订阅这个主题——消息静默丢失,没有任何报错。
String targetNodeId = resolveTargetNodeId(message);   // 显式 targetNodeId → 目录 nodeId
if (targetNodeId == null || targetNodeId.isEmpty()) {
    log.warn("[A2A-MQTT] 定向投递跳过:无法解析目标节点(agent={})", message.getToAgentId());
    return false;                                      // 语义上等于"绝不静默丢弃"
}
2.3 L3 执行体目录层:Agent Card 的最小实现
public class AgentDescriptor {
    private String agentId;      // 身份(Agent Card: identity)
    private String name;
    private String role;         // 角色路由
    private String sceneGroupId; // 场景范围(组织归属)
    private String nodeId;       // 触达地址(Agent Card: endpoint 的最小形态)
    private boolean online;      // 生命周期/在线
    private List<String> capabilities;  // Agent Card: skills/capabilities
}public interface AgentDirectoryPort {
List<AgentDescriptor> listAgents();
AgentDescriptor find(String agentId);
boolean isOnline(String agentId);
}这个「目录」在后文会变成多节点场景的主角——因为「目录为空」这件事,会让一个节点在协议上活着、在协作上死掉。
2.4 L4 接入层:把能力变成可操作的面
POST   /api/studio/a2a/agents        // 注册执行体:agentId + 场景 + 角色 + 能力 + nodeId
GET    /api/studio/a2a/agents        // 列举:同时返回协议层视角与场景目录计数
DELETE /api/studio/a2a/agents/{id}   // 注销:目录 + 协议栈 handler + 名册三者同步
POST /api/studio/a2a/dispatch // 派发:toAgentId / targetNodeId / messageType / payloadacm.unregisterAgent(agentId);
a2aProtocolService.unregisterHandler(agentId); // 停止消费
rosterStore.remove(agentId); // 移出持久化名册2.5 三条触发通道与四类语义
通道 | 入口 | 触发者 |
|---|---|---|
①LLM 工具 | 执行体的函数调用工具面 | 模型自主判断 |
②交互面板 | HUMAN 节点操作栏 | 场景内参与者(人) |
③预定义埋线 | 流程定义(operations/timeoutPolicy/a2aRules/ 事件订阅) | 设计期埋点,运行期自动 |
语义收敛为四类:委派/指定、中断/等待、结束转交、请求-响应回数。
public enum HumanOperation {
    DELEGATE_H2H("DELEGATE_H2H", "委托他人", true,  "ri-user-shared-line"),
    DELEGATE_H2A("DELEGATE_H2A", "委托Agent", true, "ri-robot-line"),
    DELEGATE_H2T("DELEGATE_H2T", "委托Task",  true, "ri-task-line"),
    INTERVENE_EXCEPTION("INTERVENE_EXCEPTION", "例外介入", false, "ri-error-warning-line");
    // 第三个参数 = 是否要求 DESIGNER 定义(不在 operations 白名单内即拒绝执行)
}
2.6 融合交互面板:一个面板承载四象限
象限 | 发起 → 执行 | 是否 A2A | 面板形态 |
|---|---|---|---|
P2P | 人 → 人 | 否 | 委托弹窗(选人)+ 委托回执 |
P2A | 人 → Agent | 是(②通道特例) | 执行体选择器(人/Agent 分栏)+ 派发回执 |
A2P | Agent → 人 | 否(执行体内部确认) | 确认卡(红线原因 + 超时策略说明 + 决策留痕) |
A2A | Agent → Agent | 是 | 消息流(from→to、类型、状态、失败原因) |
面板的三条实现契约:
- 操作按象限分组渲染——面板只订阅节点声明的 operations 白名单,再按「人际 / 人-Agent / Agent-人 / Agent-Agent」归组;
- 执行体选择器与目录同源——「选谁」直接读执行体目录,人/Agent 只是目录条目的两种类型,不需要第二套数据源;
- 回执必须结构化——派发不是「提交即结束」,h2aDispatch / todoId / remoteTaskId / 失败原因都要回流到面板。
注意一个规律
四层里每一层都在做同一件事——把「隐式」变成「显式」。传输契约显式(不得抛异常)、寻址语义显式(节点 vs 执行体)、身份触达显式(Agent Card)、责任边界显式(operations 白名单)。 这个规律,将在上下文层被推到极致。
三、复杂度之一:多节点(空间维度)
多节点下,上下文要解决「地址」和「归属」两件事。缺任何一个,故障都表现为静默。
3.1 寻址:订阅前缀与发布前缀不匹配
审计原文(缺口 A6):「MQTT 命名三处漂移:代码订阅 ooder/user/+/inbox、定向发布 ooder/node/{id}/inbox、遗留通配 ooder/p2p/+/inbox —— A2A#2 定向消息可能无人订阅而静默丢失。」
// ★ C22(2026-09-10) 修复: 定向消息发布在 ooder/node/{id}/inbox(publishTargeted → targetedTopic),
//   原先此处订阅 ooder/user/+/inbox → 订阅前缀与发布前缀不匹配,
// 定向 A2A 消息无人接收(静默丢失)。targetedTopic(targetNodeId) → "ooder/node/" + targetNodeId + "/inbox"
allNodeInboxTopicFilter() → "ooder/node/+/inbox" // C22 修复
allP2pTopicFilter() → "ooder/p2p/+/inbox" // @Deprecated,全仓已无订阅方教训:MQTT 的主题是「字符串约定」,编译器不检查它。任何一处的拼写差异都会变成运行期的静默丢包。
3.2 多实例双订阅:一次委托被执行两次
多节点环境里,一个进程内往往并存多个 MQTT 连接:
- E4-1 消费者:ooder/event/#(clientId = applicationName-port-sse)
- E4-2 消费者:ooder/event/A2A/#
- 协调器 publisher:localAgentId() + "-par"
- 记录发布者:-pub
审计原文(缺口 A9,P0):「原去重是 60s 内存短窗……对以下两类真实重投无效,且重启即清空:① EMQX qos1 延迟重投;② 多实例双订阅双投递。后果是 TASK_REQUEST 被执行两次、PARALLEL_AGGREGATED 被聚合两次。」
// A2aInboundLedger:落盘台账 a2a-inbound-ledger.json
// dedupKey = (type | messageId)
// 默认 TTL 24h、上限 20000 条、5s 定时 flush
为什么这个修复属于「上下文治理」而不是「消息治理」?
因为幂等键messageId是上下文的一部分:它是这段状态变化的身份标识。幂等窗口寿命 = 上下文身份的寿命。窗口过期,身份就失效,副作用就会被重放。
3.3 目录为空:协议活着,协作死了
这是最有教育意义的一次故障。
现场表现:A2A 端点正常、MQTT 连接正常、消息发布成功(published: true),但没有任何执行端消费 TASK_REQUEST。
[A2A] 目录为空,未注册任何执行端 handler
[A2A] ApplicationReady: 目录为空,路由索引未填充
根因链条:
- studio 的 application.properties 显式配置了 scene.agent.enabled=false;
- scene-engine 的目录 @Bean 带 @ConditionalOnProperty(scene.agent.enabled=true, matchIfMissing=true);
- 条件不满足 → 目录 Bean 被排除;
- 而「按目录批量注册执行端」这个动作,依赖目录非空:
// A2AAutoConfiguration
return evt -> {
    A2AProtocolService svc = ps.getIfAvailable();
    if (svc != null) svc.refreshHandlersFromDirectory();        // 注册执行端
    AgentDirectoryPort d = dir.getIfAvailable();
    if (d != null) d.listAgents().forEach(router::registerAgent); // 填充索引
};
5. 目录为空 → 一个 handler 都不注册 → 接收端变成哑端。
更隐蔽的是 AgentDirectoryAdapter 的注记:
「原构造器注入在启动期解析为 null……一旦为 null,目录永久为空,导致『按执行体注册 TASK_REQUEST 消费者』与『路由 capability/role 索引填充』静默不发生。」
// A2aAgentRosterSeeder(@Order(0),必须早于 L2 协议栈的 a2aBootstrap)
if (list == null || list.isEmpty()) {
    // ★ C3 修复:名单为空时也必须保证目录非空 ——
    //   否则 A2AAutoConfiguration 在 ApplicationReady 的「按目录刷新执行端」会因
    //   目录为空而不注册任何 TASK_REQUEST 消费者 → 接收端哑端。
    agentContextManager.registerVirtualAgent(VirtualAgentConfig.builder()
            .agentId("a2a-local-executor")
            .role("executor")
            .build());
}
修复后日志(真机取证):
[A2A-Roster] 持久化名单为空,无需恢复(已兜底注册默认执行体)
Agent descriptor registered: agentId=a2a-local-executor, role=executor
A2A handler registered: agentId=a2a-local-executor教训:「注册」这个动作的触发源如果是「另一个可能为空的集合」,那么这套装配就是条件性的沉默故障。基础设施的「非空」必须被显式保证,而不是指望上游总会有数据。
3.4 装配时序:目录驱动的注册必须在所有 Runner 之后
// A2aAgentRosterSeeder 用 @Order(0),必须早于 A2AProtocolServiceImpl 的 a2aBootstrap
// (后者无 @Order,取默认 LOWEST_PRECEDENCE)
「这样启动期『按目录批量注册执行端 + 填充 capability/role 路由索引』才能真正看到执行体。」
多节点系统的启动顺序,是上下文可用性的一部分:名册没恢复完就注册,等于注册了一个空集合。
3.5 跨实例的上下文「看不见」
审计原文(缺口 A13,P0):「A2A 消息无法让接收端定位到父流程实例或子流程实例,无法据此重建/推进 processInst。」
- A2A 消息与 A2A 服务全链路不读写 parentProcessInstId / processInstId(parentProcessInstId 的命中全在流程引擎侧,A2A 文件中零命中);
- 会话关联靠 conversationId 字符串;
- 本地 ↔ 远端实例 ID 映射是单 JVM 内存 ConcurrentHashMap(进程重启即失);
- 唯一「碰 pid」的跨实例链路是「事件可视桥」,是「事件可视」不是「远端执行」。
推荐落地形态在审计里写得很直接:
让流程实例 = 协同容器:一次 A2A 委托 = 在远端实例化一个子流程(复用 SkillFlowEngine + RemotePersistenceDelegator 已有能力),而不是「回显字符串」。
3.6 多节点小结
# | 缺口 | 表面现象 | 上下文层面的本质 |
|---|---|---|---|
A6 | 订阅/发布前缀不匹配 | 消息静默丢失 | 上下文的地址不一致 |
A9 | 去重仅 60s 内存窗口 | 副作用执行两次 | 上下文的身份寿命不足 |
C3 | 目录为空 | 接收端哑端 | 上下文的接收方归属缺失 |
A13 | 消息无 pid | 接收端无法重建状态 | 上下文的锚点缺失 |
F13 | 本地↔远端映射无持久化 | 重启后无法续跑 | 上下文跨进程不可恢复 |
一句总结:多节点场景下,最危险的不是「消息丢了」,而是「消息到了,但没人知道它属于哪段状态」。
四、复杂度之二:多轮对话(时间维度)
多轮下,上下文要解决「哪一轮」和「谁的上下文」两件事。
4.1 三链历史:同一个用户、同一轮,三个不同答案
链 | 入口 | 历史来源 | 上限 | 裁剪方式 |
|---|---|---|---|---|
A 通用 / Router | StudioChatRouter.routeStream→LLMEngine | ChatContext.messageHistory(内存) | 20 条 | 入队即removeFirst(),无摘要、不落盘 |
B RAD FC-Loop | RadFunctionCallingHandler.streamWithFunctionCallingLoop | SceneConversationManager(另一份内存记忆) | 10 条 | 取尾部 N 条 |
C SG 聚合预热线 | StudioChatSseController.preheatChatContext | ChatContext → SG 记忆 → DB 三级回退 | 8 轮 / ≤16 轮 / ≤60% token | 轮次上限 → token 从最旧丢 → 压缩为 ≤2048 字符摘要 |
缺口 D1(P0):同一用户同一轮,Router 兜底路径与 FC-Loop 路径看到的历史完全不同(来源、上限、裁剪规则三处不一致),且二者互不同步。
更糟的是链 A 的裁剪方式——while (messageHistory.size() > MAX_HISTORY_SIZE) messageHistory.removeFirst();——丢弃即永久消失,没有任何摘要兜底(缺口 D8,P0)。
4.2 历史里只有role和content
map.put("role", ...);
map.put("content", ...);
ChatMessage.reasoningContent 字段存在但从未装配进 history;thinking / toolCalls / flowData / artifactSummary 只落库不喂模型。
缺口 D2(P0):跨轮的「上一轮调了哪些工具、生成了什么文件」不进入下轮 LLM 上下文 → 多轮归因断裂,reasoningContent 属于「存了不喂」。
4.3 一个真实的「读错位置」缺陷
现象
SSE 实时流里明明有event:tool_call/tool_result/thinking,但刷新页面重读历史,4 条消息全部reasoning=no / artifacts=no / toolCalls=no。
第一步:先排除误判。读取侧的字段映射其实是齐全的(thinking|reasoning → reasoning、toolCalls|toolCallsJson → toolCalls、artifacts|artifactSummary → artifacts)。用「会触发工具」的一轮重测后仍无 toolCalls → 确认为真缺陷。
第二步:解析 SSE complete 载荷,定位到写入侧抽取器「读了错的位置」:
数据 | complete里的实际位置 | 抽取器读取位置 | 结果 |
|---|---|---|---|
工具链 | metadata.toolExecutions(顶层为空) | response.getToolExecutions()(顶层) | ✗ 完全丢失 |
产出物 | metadata.artifactType+metadata.artifactVfsPath | metadata.artifactSummary | ✗ 整段丢弃 |
思考链 | 该路径不产thinking(SSE 的thinking只是进度阶段标签) | metadata.thinking | 本就没有(非缺陷) |
第三步:修复(1 文件 3 处)
改动 | 说明 |
|---|---|
extractToolCallsJson | 顶层为空时回退metadata.toolExecutions(对象/字符串皆可) |
新增extractArtifactSummary | 优先metadata.artifactSummary;缺失时用artifactType + artifactVfsPath合成JSON |
extractThinking | 键名兜底:thinking→reasoning→reasoningContent(各场景命名不一致) |
第四步:复验(真机)
CONV=conv_1bf8f3fac42242c8   (SSE: tool_call×3 / tool_result×1)
  role=user      keys=[content,id,processInstId,role,senderName,senderUserId,status,timestamp,tokenCount]
  role=assistant keys=[artifacts,content,...,toolCalls]
      toolCalls (len=2187): [{"toolName":"list_scene_groups","arguments":{},"result":"...
      artifacts (len=91):   {"type":"bpm-design-md","vfsPath":"process-inst/bpm/artifacts/bpm_design_....md"}
RESULT= PASS
这个案例的启示
上下文「存了」不等于「读得到」。写入侧抽取路径与读取侧映射路径,是两个独立实现——它们的键名约定不一致,就会产生「数据在库里,但人看不见」的隐性丢失。 而这类缺陷不会报错,只会让用户体验变成「我明明记得它调用过工具」。
4.4 「轮」这个概念没有序号
标识 | 语义 | 问题 |
|---|---|---|
roundId | 每次请求生成:"round_" + Long.toHexString(now) | 无序号、不递增、不可按轮定位 |
turnCount | 归属SceneGroup,持久化到SceneGroup.config._conv | 与 conversation非 1:1 |
messageHistory.size() | 内存条数,≤20 | 与前二者无一致性约束 |
缺口 D3(P0):rounds/{roundId}/context.json 只写不读。
这里隐藏着一个深刻的设计问题
当「轮」没有序号,你就无法回答「第 3 轮的状态是什么」。而没有这个能力,快照就是不可寻址的;不可寻址的快照,写了也等于没写——因为它无法被任何恢复路径定位。 教训:可恢复的前提是可寻址。上下文要么有单调序号,要么有内容指纹,二者至少有一个,否则「历史」只是一堆碰巧同目录的文件。
4.5 附件跨轮:前后端语义相反
侧 | 生命周期 |
|---|---|
后端 | 挂在 30 分钟 TTL 的ChatContext,跨轮保留;上限 10 个 / 超 5 万字符降级为 summary-only |
前端 | _contextAttachments是宿主级全局数组,不按会话隔离;_clearMessages()才清 |
前端收尾 | SSEcomplete/error/watchdog每轮结束都调_clearRemoteAttachments(),但不重置本地 chip |
缺口 D4(P0):出现「服务端已清空、前端 chip 仍在」的分叉;残留 chip 会被 _getContextAttachmentsMd() 拼进本轮用户消息文本 → 上一轮附件的正文被当成本轮用户输入,即隐式串轮。
这就是上下文语义不一致的经典后果:两端各自都「正确」,但它们的生命周期假设相反,于是产生了一个谁都没写错、但用户会看到错误行为的系统。
4.6 附件状态机:一个设计正确的局部
public enum ContentState { FULL, SUMMARY_ONLY, UNLOADED }
// FULL(正文在内存)→ SUMMARY_ONLY(仅摘要)→ UNLOADED(仅引用)
// 由 unload() / reload(String) 驱动
// getEffectiveContent() 按 state 返回正文 / 摘要 / "[附件已卸载,ID: ...]"① 经真实 API 注册 5 个 600 字附件 → 全 200
② 回读 = 5 条、mdContent 长度均 600(正文零丢失)
③ 等 idle > 7.5min 后打一轮 → [AttachmentState] UNLOADED 附件1/附件2 : FULL -> SUMMARY_ONLY
(fullCount=5>3, size=600),attachment-stats unloads=2
④ 降级后回读正文仍为 600 字(T2-3:降级只改读取路径、不销毁正文)为什么这是范本?因为它做到了三件上下文治理最该做的事:
- 状态机显式(FULL/SUMMARY_ONLY/UNLOADED 三态可见);
- 降级不销毁(降级只改读取路径,正文仍在)——避免「为了省内存而丢数据」;
- 可回读(reload 可自任意状态回载正文)。
4.7 预算:只观测,不执行
ContextBudget.suggestCompression() → 只产出「建议」对象 → 全仓无消费点
超 5 万字符时只卸附件正文(mdContent=null),不裁 messageHistory
缺口 D10(P1):预算是「观测指标」而非「执行约束」。
审计里同类问题还有一批——「实现齐备、接线为零」:
- MessageHistorySummarizer:实现完整,仅被快照恢复路径消费,非每轮滚动;
- MemoryStore / MemoryBridge / PersistentMemoryContext:全仓零业务调用点,SQLite 无 memory 表;
- A2ABridgeService.transferContext / batchTransferContext:返回 "not yet implemented"。
教训:审计上下文时,不要只问「有没有实现」,要问「谁在调用」。grep 零调用点的「完备实现」,是技术债里最贵的一种——它让你以为问题已经解决。
4.8 多轮对话小结
# | 缺口 | 本质 |
|---|---|---|
D1 | 三链历史不统一 | 「历史」没有单一真源 |
D2 | reasoning/工具/产出不入 history | 上下文内容不完整 |
D3 | 轮次快照只写不读 | 快照不可寻址 + 无消费方 |
D4 | 附件前后端语义相反 | 生命周期假设冲突→ 隐式串轮 |
D8 | 链 A 裁剪无摘要 | 历史被丢弃而非被压缩 |
D10 | 预算无消费点 | 机制「看起来存在」 |
一句总结:多轮场景下,最危险的不是「记不住」,而是「记了多份,且不知道哪份算数」。
五、复杂度之三:强流程(结构维度)
强流程下,上下文要解决「合并语义」和「恢复可信」两件事。
5.1 五种合并语义并存
语义 | 代表位置 | 后果 |
|---|---|---|
无条件putAll | ScenarioContext.putStepResult、ActivityDispatcher、NlpPipeline | 同名字段后写覆盖前写,无冲突检测 |
无条件put(可被 null 覆盖) | ScenarioOrchestratorImpl、NlpSkillContextHelper、SplitMergeService | null 覆盖有效值 |
仅补 null | ScenarioOrchestratorImpl(D1 修复)、ScenarioContext | 安全 |
仅补缺失 key + 允许覆盖 null | ActivityDispatcher、ResumeService | 陈旧优先 |
显式remove | ScenarioContext.clearStepResults、PipelineStepAdapter | 多步骤共享 key 时误删 |
缺口 F1(P0):同一仓内 5 种合并语义,无统一契约。「这次写入会不会覆盖已有值」不可推导、不可审计、不可静态检查。
5.2 缺陷一:子流程失败被静默
审计原文(缺口 F2,P0):「失败静默 —— 子流程 FAILED/CANCELLED 计入 COMPLETED,父流程按成功推进。」
我们完整复盘并修复了这个缺陷(编号 B1),发现它其实是三处独立根因的叠加——这也是「失败静默」类问题的典型结构。
根因①:路由无匹配策略从未被咨询
// RoutingService.handleRouteResult → case NO_MATCH
// 原逻辑:NO_MATCH 时不做处理,让旧 routeToNext 逻辑处理
log.info("NO_MATCH from RouteToEngine, delegating to legacy routeToNext: activity={}", ...);
break;
而「旧逻辑」对无出边的活动直接返回 false:
if (outEdges.isEmpty()) {
    log.debug("No routes matched...");
    return false;   // ← 直接返回,noMatchPolicy 从未被读取
}
于是活动完成 → 队列耗尽 → 流程被置 COMPLETED。
这里必须澄清一个语义noMatchPolicy是路由无匹配策略(FAIL/SKIP/WAIT/ESCALATE_HUMAN),与「技能无执行器」无关。而 TASK 无执行器时,引擎仅 WARN 且无条件标 COMPLETED。 我们最初把noMatchPolicy=FAIL放在「引用不存在 skillId 的 TASK」上期望它失败,实测完全无效——因为那根本不在noMatchPolicy的语义范围内。这是语义误用造成的测试载体失真。
根因②:主循环不检查FAILED,且会用COMPLETED覆盖它
// 修复前
while (!activityQueue.isEmpty()) {
    if (instance.getStatus() == ProcessStatus.PAUSED
            || instance.getStatus() == ProcessStatus.CANCELLED) {   // ← 没有 FAILED
        return;
    }
    ...
}
// 队列空了
if (instance.getStatus() != ProcessStatus.ARCHIVED) {
    instance.setStatus(ProcessStatus.COMPLETED);   // ← 覆盖 FAILED
}
两处循环(executeProcess 主循环 + continueExecution)都有这个问题。也就是说:即便子流程被正确置为 FAILED,父流程也会「先继续推进、再被覆盖成 COMPLETED」。
根因③:子流程异常路径一律当「暂停」
// 修复前
} catch (Exception e) {
    // 子流程执行抛出异常(FAILED)— 当前活动也暂停等待恢复
    actInstance.setStatus(ActivityStatus.PAUSED);
    instance.setStatus(ProcessStatus.PAUSED);
    log.warn("SUBPROCESS paused (child exception): activity={}, error={}", ...);
}
修复后的三段式判定
// ① NO_MATCH 必须触发活动级 noMatchPolicy
case NO_MATCH:
    log.info("NO_MATCH from RouteToEngine, handling noMatchPolicy: activity={}, policy={}", ...);
    handleNoMatch(instance, actDef, null);   // FAIL→置 FAILED
    break;

// ② 主循环与续跑循环均短路 FAILED,且不再用 COMPLETED 覆盖
if (instance.getStatus() == ProcessStatus.PAUSED
        || instance.getStatus() == ProcessStatus.CANCELLED
        || instance.getStatus() == ProcessStatus.FAILED) {
    return;
}
...
if (instance.getStatus() != ProcessStatus.ARCHIVED
        && instance.getStatus() != ProcessStatus.FAILED
        && instance.getStatus() != ProcessStatus.CANCELLED) {
    instance.setStatus(ProcessStatus.COMPLETED);
}

// ③ SUB_PROCESS 分支:子流程 FAILED → 父活动 + 父流程同时置 FAILED
if (subInst != null && subInst.getStatus() == ProcessStatus.FAILED) {
    String errMsg = "子流程[" + subProcessDefId + "]执行失败: " + ...;
    actInstance.setStatus(ActivityStatus.FAILED);
    instance.setStatus(ProcessStatus.FAILED);
    instance.setLastError(errMsg);
    instance.getContext().put("_subProcessFailed", Boolean.TRUE);
    instance.getContext().put("_subProcessError", errMsg);
    eventPublisher.fireActivityFailed(instance, actInstance, actDef, parentDef, errMsg);
}一个工程细节值得记录:子流程失败的异常来自 startExecution().join(),而 _subProcessInstId 是在 join() 之后才写入上下文的——所以在 catch 分支里,我们拿不到子实例 ID。
// startExecution 失败异常格式: "流程执行失败: {instanceId} — {error}"
java.util.regex.Matcher m = java.util.regex.Pattern
        .compile("流程执行失败:\\s*([0-9a-fA-F-]{36})").matcher(e.getMessage());
if (m.find()) { childInstId = m.group(1); }这个细节的启示:当异常路径的写入顺序与正常路径不同时,异常处理代码需要显式的信息恢复手段,而不是想当然地读上下文。
复验证据(真机)
B1: b-test-parent-fail 启动后 25s
  PARENT status=FAILED            (修复前: ARCHIVED,失败静默)
  CHILD  status=FAILED            (noMatchPolicy=FAIL 生效)
  日志: [ActivityDispatcher] ★ SUBPROCESS FAILED propagated (exception path):
        activity=b-test-parent-fail__parent_fail_call_child, subInst=ebfcd8a2…,
        err=子流程[b-test-child-fail]执行失败: No route matched for activity
             b-test-child-fail__child_fail_task with FAIL policy
  链路: child_fail_task 完成 → RoutingService NO_MATCH → handleNoMatch(FAIL) → 子 FAILED
        → startExecution 抛"流程执行失败" → ActivityDispatcher catch 解析子 id
→ 父 SUB_PROCESS FAILED → executeProcess FAILED 短路 → 父终态 FAILED结论:从「父 ARCHIVED」到「父 FAILED」,中间隔了三处独立根因。这就是「失败静默」为什么难查——它不是一个 bug,而是一条链上每一环都在放行。
5.3 缺陷二:子 → 父回写从未发生
审计原文(缺口 F3,P0):「陈旧优先(staleness) —— 『父非 null 不覆盖』使子流程产出的新值无法更新父流程同 key 旧值。」
修复 B2 时发现了一个更根本的事实:回写根本没发生。
// 修复前:上下文合并只存在于 child COMPLETED 分支
} else if (subInst != null && subInst.getStatus() == ProcessStatus.COMPLETED) {
    ...
    Map<String, Object> subCtx = subInst.getContext();
    if (subCtx != null) {
        for (Map.Entry<String, Object> e : subCtx.entrySet()) {
            if (!e.getKey().startsWith("_")) {
                Object existingVal = instance.getContext().get(e.getKey());
                if (!instance.getContext().containsKey(e.getKey())
                    || (existingVal == null && e.getValue() != null)) {
                    instance.getContext().put(e.getKey(), e.getValue());
                }
            }
        }
    }
}问题在于:本引擎的子流程正常到达 END 后,终态是 ARCHIVED,不是 COMPLETED。
SUB_PROCESS → 子流程执行 → 到达 END → archiveProcess() → 状态 = ARCHIVED
                                              ↓
                          落入 "其他状态(FAILED/CANCELLED/ARCHIVED 等)" 分支
                                              ↓
只合并了 HISTORY(工具链/产出物),没有合并上下文 key修复:在 ARCHIVED 分支补齐上下文合并,与 COMPLETED 分支同口径。
B2: b-test-parent 启动后 18s
  PARENT status=ARCHIVED(成功路径正常终态)
  日志: [ActivityDispatcher] ★ SUBPROCESS merged (child ARCHIVED)
  父上下文 vfsSave dataSize 对比(SUB_PROCESS 活动上下文键数):
      修复前  parent_call_child dataSize=15(无子键合并)
      修复后  parent_call_child dataSize=19(+4 键 = 子流程 autoPass 写入的
              confirmed / userAction / confirmResult / confirmedIntent)
一个必须如实记录的发现
我们在测试载体里给子流程节点声明了producedOutputs=["childProbeValue"],期望它出现在父上下文。实测发现performHumanAutoPass写的是通用确认键(confirmed/userAction/confirmResult/confirmedIntent),并不写活动声明的producedOutputs。 也就是说:「声明产出物」和「实际写入上下文的键」在 HUMAN autoPass 路径上是两回事。这是定义层的语义缺口,我们把它如实记进了文档而不是掩盖。
这个案例的启示:终态枚举的取值,是上下文合并逻辑的分支条件。当「正常结束」有两种状态(COMPLETED / ARCHIVED)时,任何只处理其中一种的合并逻辑,都会在另一种上静默跳过。
5.4 缺陷三:浅拷贝污染
// 修复前
Map<String, Object> subContext = new HashMap<>(instance.getContext());
new HashMap<>(parent) 只复制顶层键。嵌套的 Map / List 仍与父流程共享同一实例。子流程技能只要对嵌套结构就地 put / add,父流程的原有结构就被静默污染。
启示:在上下文世界里,「拷贝」这个词必须带限定词——深拷贝还是浅拷贝,决定了隔离性是否存在。而 new HashMap<>(...) 这个写法看起来非常安全,它骗过了所有代码审查。
5.5 缺陷四:workMode 裁剪不可逆
_conv 快照内容按 workMode 三档精简:
  ARCHITECT 全量
  BUSINESS  仅 currentModuleName
            (显式移除 componentType / disclosureLevel / accumulatedFields / lastKnowledgeResult)
  CHAT      仅 turnCount + currentIntent
缺口 F6(P0):workMode 切换导致上下文不可逆丢失 —— BUSINESS/CHAT 档覆盖写 _conv 后,ARCHITECT 期数据无法恢复(回切也拿不回)。
启示:这是「用裁剪实现降级」的典型陷阱。如果裁剪是破坏性的,那么它就不是「降级」,而是数据销毁。正确的做法是 PATCH(字段级,不删字段)+ 快照可回切。
5.6 缺陷五:恢复只认内存(B5 完整复盘)
审计原文(缺口 F9,P0):
「暂停时向 VFS 写 flow/current-activity.json,但内容是活动定义元信息(activityId / type / config / requiredInputs / producedOutputs),不含运行态业务 context;恢复入口 resumeActivity 从内存实例获取 ProcessInstance,不读 snapshot、不从 VFS checkpoint 重建。」 「恢复上下文只来自内存 —— ProcessInstance.snapshot 在 resume 路径中从未被读取回填。」
# | 事实 |
|---|---|
1 | saveCheckpoint()只写内存ProcessInstance.snapshot,全仓无任何落盘点 |
2 | 恢复路径先要求实例已在内存,持久化内容只用于补 context 层,实例/泳道/令牌图从不回填 |
实现:新增 3 文件 + 3 处接线
文件 | 职责 |
|---|---|
FlowSnapshotStore(接口) | 快照写入契约:write/read/exists;文件名常量instance-snapshot.json唯一来源 |
VfsFlowSnapshotStore(@Component) | VFS 实现,落点process-inst/{instId}/instance-snapshot.json;读写 fail-soft |
ProcessInstanceSnapshotService(@Component) | saveSnapshot / loadSnapshot / hasSnapshot / rehydrate;显式双向映射 |
为什么必须手写「显式双向映射」而不是用对象自动绑定?因为有三处不可自动绑定:
- ActivityInstance.getEndTime() 返回 Date、setEndTime(long) 收 long —— 读写类型不对称;
- llmDelegate / activityDefinition / processDefinition 是 transient 运行时句柄,不该也不可持久化;
- context 中混有运行时对象(实测为 _llmDelegate),需按类型白名单剔除并留证。
contextDroppedKeys       // 丢了哪些 context 键
droppedRuntimeHandles // 剔除了几个运行时句柄「丢了什么」必须可审计,而不是静默蒸发。这正是「失败显式化」原则在持久化层的落地。
再水化的只读用途约束(三条):
- 再水化结果打标 _rehydrated / _rehydratedAt / _snapshotSavedAt / _snapshotReason / _snapshotAgeMs;
- 不自动注册到引擎(registerProcessInstance 默认返回 false,"没有显式实现就绝不静默接管");
- 引擎拒绝覆盖已有同名活跃实例。
验证一:单元测试 10 例
用例 | 锁定不变量 | 状态 |
|---|---|---|
B5-1 | 往返保真:实例核心字段 + 2 泳道 + 3 活动 + 令牌 +3 层嵌套 context全部原样重建 | PASS |
B5-2 | 时间戳对称:endTime走原始 long,round-trip 相等;未结束活动保持0 | PASS |
B5-3 | 句柄不落盘 + 留证:_llmDelegate/非白名单类型被剔除、键名进contextDroppedKeys | PASS |
B5-4 | 只读用途约束:再水化带_rehydrated*标记;原实例不被打标 | PASS |
B5-5 | 引擎回填约束:可注册 /拒绝覆盖活跃实例/ 同实例幂等 / 非法入参 false | PASS |
B5-6 | fail-soft:无快照 / 损坏 JSON / 缺instanceId→ 一律 null 且不抛 | PASS |
B5-7 | 未注入 Store →显式失败(不假装写入成功) | PASS |
B5-8 | 快照含版本/时间/原因/统计;高版本快照尽力解析而非直接丢弃 | PASS |
B5-9 | 再水化实例可再次快照(幂等、标记不膨胀) | PASS |
B5-10 | 空集合/空 context 边界安全 | PASS |
验证二:真机端到端(决定性证据)
=== [2] 阶段A证据 ===
[B5] 实例快照已落盘: instId=02ec90c2-…, reason=PAUSE, bytes=11848, lanes=1, tokens=1,
                     droppedKeys=[], droppedHandles=0
[SkillFlowEngine] Process paused at async node: activity=architect-pipeline__human_intent_confirm

=== [4] 新 JVM 内该实例痕迹 ===
occurrences_in_new_log=0                      ← ★ 重启后实例确实不在内存

=== [6] ★ B5 再水化证据 ===
[B5] ★ 实例已从持久化快照再水化: instId=02ec90c2-…, status=PAUSED, lanes=1, tokens=1
[B5] ★ 实例已回填引擎运行表: definitionId=architect-pipeline, status=PAUSED
[ResumeService] ★ B5 中断恢复:实例由持久化快照再水化并回填
[ResumeService] Resuming activity: activity=architect-pipeline__human_intent_confirm, type=HUMAN旁证(子流程实例):
instId=93d1e1d4-…, bytes=50774, lanes=1, tokens=1,
droppedKeys=[context._llmDelegate], droppedHandles=15——证明运行时句柄确实被识别并剔除(_llmDelegate 正是内核影子比对中曾不一致的那个键)。
# | 新发现(诚实记录) | 处置 |
|---|---|---|
17 | 快照落盘时机早于状态落定:原实现在setStatus(PAUSED)之前统一快照,持久化出的status恒为RUNNING(实测) | 已修复暂停分支内先置 PAUSED 再落盘;复验status=PAUSED |
16 | 远端实例生命周期未覆盖:再水化恢复了本地实例图,但远端要求已存在同名实例 → confirm 返回「远程实例不存在」 | 后续已处置见 5.7 |
这个案例最值得记住的一点
「快照写了」与「快照能被读回来」是两件事;而「能从快照重建」与「能在重启后重建」又是两件事。 真正的判据只有一个:把内存清空,看它还能不能活。
5.7 缺陷六:远端映射重启即失(#16 → #18 破案)
RemotePersistenceDelegator.localToRemoteInstId 是进程内内存表(ConcurrentHashMap),重启即失;B5 再水化只重建本地实例图 → 之后任何 delegate* 都命中:
远程实例不存在: … 请先调用 createRemoteProcessInstance为什么不能盲目补建?
远端实例在 startExecution 已由 newProcess 创建过(且形成自映射 remoteInstId → remoteInstId),补建会产生重复远端流程实例(用户待办两条、RT_* 表分叉)。
机制 | 行为 |
|---|---|
存在性探测 | 以「远端是否已知此实例」为证据:命中 → 恢复自映射(零远端写);未命中 → 拒绝补建 |
再水化时探测 | 早期尝试;当前活动为空时回退定义起始活动 |
惰性探测 | 映射缺失时在实际需要远端操作的那一刻再探一次 —— 修复「时点探测假阴性」(实测:再水化探测 11:31:36 未命中,而远端定义注册 11:31:54 才完成) |
非致命降级 | 仅对再水化实例,delegateVfsSave失败降级为 WARN 不中断本地恢复 |
#18 破案:探测仪器错了,不是远端没镜像
探测手段 | 依据 | 缺陷 |
|---|---|---|
getRemoteActivityInstId(活动级,旧) | 远端存在该活动的实例 | 要求活动级镜像已路由 + 用户有参与权限 → 对「远端已建实例、但活动级镜像未路由」的流程恒假阴性 |
★getProcessInstState(实例级,新) | getProcessInst(pid)仅 checkLogined +主键 loadByKey、无权限过滤 | 无 |
这个案例是我最想强调的一条
当你反复探测都得到「不存在」,先怀疑探测器,再怀疑被探测的对象。 一个假阴性的探针,比没有探针更危险——因为它会让你在「有证据」的自信下做出错误决策(比如去补建一个已经存在的远端实例,制造重复流程)。
5.8 强流程小结
# | 缺口 | 本质 | 处置 |
|---|---|---|---|
F1 | 5 种合并语义并存 | 无算子契约 | 收敛为 6 算子(见 §七) |
F2 | 子流程失败静默 | 三处根因叠加 | B1 已修复 |
F3 | 子→父回写(陈旧优先) | 终态枚举未覆盖 ARCHIVED | B2 已修复 |
F4 | 浅拷贝污染 | 隔离性缺失 | 容器深拷贝 + 回写侧同口径 |
F6 | workMode 裁剪不可逆 | 破坏式降级 | 收敛为 PATCH + 快照 |
F9 | 恢复只认内存 | 无持久化 + 无再水化 | B5 已修复 |
F12/F13 | 远端映射无持久化 | 跨进程不可恢复 | #16/#18 已修复 |
一句总结:强流程场景下,最危险的不是「状态错了」,而是「状态错了却没人知道」——失败被当成成功、新值被当成旧值、内存被当成持久化。
六、三重复杂度的交集:八个根因,一个本质
# | 共性根因 | 多轮对话 | 强流程 | 多节点 |
|---|---|---|---|---|
R1 | 合并算子未显式化:5 种语义 | 三条链各自裁剪 | putAll/put/补null/补key/remove并存 | parameters原样 Map 透传,接收端语义自定 |
R2 | null 覆盖有效值 | 附件超预算只卸正文不裁历史 | ScenarioOrchestratorImpl/NlpSkillContextHelper/SplitMergeService | payload 字段缺失时无占位语义 |
R3 | key 命名空间漂移 | _conversationId/_currentPage | _resolutionContextVfsPath/_waitingForResume/_conv/_remoteActivityInstMap | _delegateTargetUser_/_delegateConfig_ |
R4 | 静默降级 / fail-open | preheat 超时整体降级、预算超限只告警 | 子流程 FAILED→COMPLETED、阶段校验恒 true、远端映射缺失静默 return | canHandle=false丢弃、to.equals(local)不匹配静默 |
R5 | 快照不一致 + 浅拷贝 | rounds 只写不读;附件只存引用(但无人读) | new HashMap<>()浅拷贝;三处快照口径不同;恢复不读 snapshot | 无任何持久化 |
R6 | 无版本/无指纹/无幂等 | seq恒 0;roundId无序号 | ContextAuditLog.doFlush重复追加 | 60s 内存去重;无 requestId 空间统一 |
R7 | 无审计闭环 | 决策/附件变更无统一留痕 | 阶段推进不落审计 | A2A 全链路无留痕 |
R8 | 并发读改写无锁 | ChatContext.switchScene非同步 | ProcessInstance.context裸 HashMap + 暴露可变引用 | 多连接重连踢连接 |
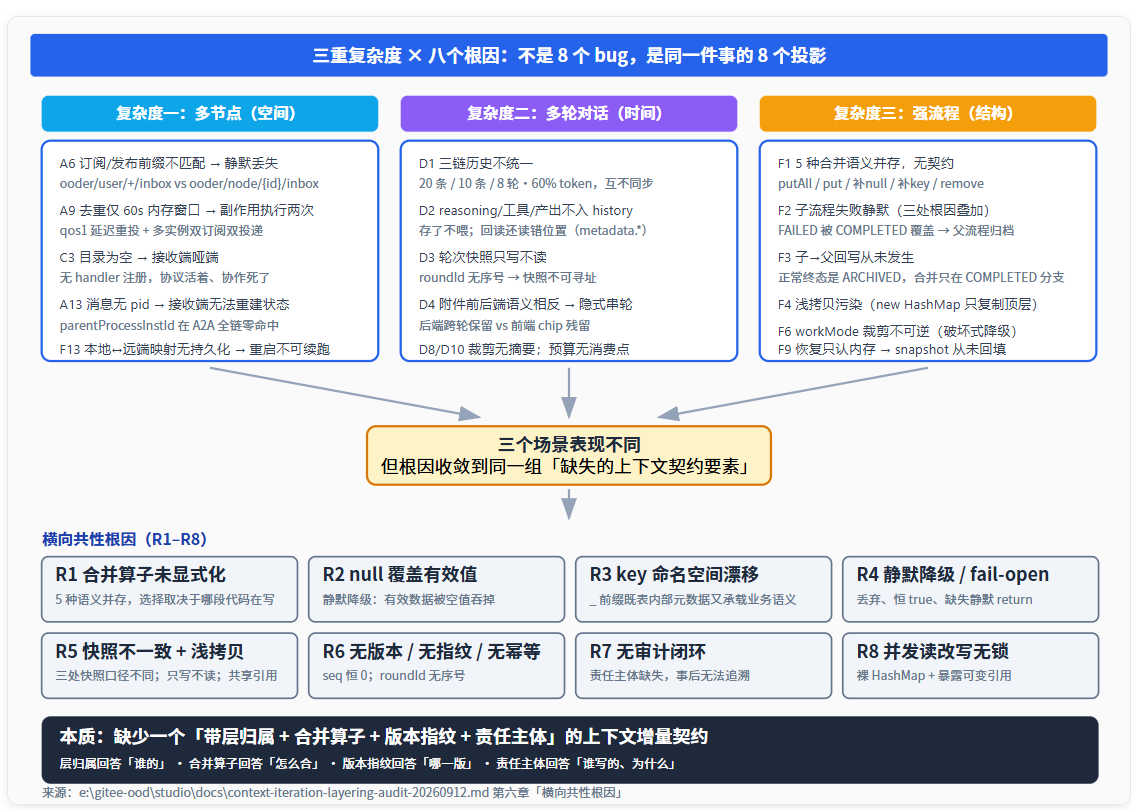
图 2 三重复杂度 × 八个根因:不是 8 个 bug,是同一件事的 8 个投影
为什么说「三重复杂度」是同一件事?因为它们破坏的是同一个东西——上下文的可判定性:
- 多节点破坏了地址与归属的可判定性(我不知道这段状态是谁的);
- 多轮破坏了时间与来源的可判定性(我不知道这是第几轮、谁说的);
- 强流程破坏了合并与恢复的可判定性(我不知道覆盖了没有、丢了没有)。
而一个「上下文增量契约」,恰好一次性给出这四样东西:层归属(谁的)+ 合并算子(怎么合)+ 版本指纹(哪一版)+ 责任主体(谁写的)。
七、解题:把上下文从「副作用」升级为「一等公民」
7.1 统一六层模型:每层回答「谁写、活多久、什么算子」
审计发现全仓同时存在 4 套互不对齐的分层模型:「同层不同名,同名不同层」,三层命名零交集,无映射表。
收敛方向不是推翻,而是归位。最终落地的六层模型(全仓唯一定义):
public enum ContextLayer {
    IDENTITY("identity", 0, false, false, MergeOp.REPLACE),
    RULE("rule", 1, true, false, MergeOp.REPLACE),
    SCENE("scene", 2, true, false, MergeOp.PATCH, MergeOp.REPLACE),
    WORKING("working", 3, true, true, MergeOp.MERGE_FILL_NULL, MergeOp.REPLACE, MergeOp.DROP),
    MEMORY("memory", 4, true, true, MergeOp.APPEND, MergeOp.DROP),
    KNOWLEDGE("knowledge", 5, true, true, MergeOp.UNION_BY_REF, MergeOp.MERGE_FILL_NULL,
              MergeOp.APPEND, MergeOp.DROP);
}
层 | 名称 | 内容 | 生命周期 | 唯一可写方 | 默认算子 |
|---|---|---|---|---|---|
L0 | Identity | userId / conversationId / processInstId / activityInstId / participants | 会话/实例级,不可变 | 网关/入口 | REPLACE(仅创建) |
L1 | Rule | 系统提示 / 流程定义 / 路由规则 / 红线 / 权限 | 部署级,不可变 | 定义发布器 | REPLACE+ 版本指纹 |
L2 | Scene | workMode / buildLevel / projectName / autoSave | 会话级,可切换 | SceneGroupContextSwitcher独占 | PATCH(字段级) |
L3 | Working | 当前活动的输入/输出/状态 | 活动级,结束即沉降 | 当前活动执行体独占 | MERGE_FILL_NULL |
L4 | Memory | 前 N 轮摘要 / 检查点 / 恢复锚点 | 会话级,append-only | 压缩器 + 恢复服务 | APPEND+ 指纹幂等 |
L5 | Knowledge/Artifact | RAG / 文件 / 产出物 / 附件 | 长期,引用式 | 知识/产出物服务 | UNION_BY_REF |
关键在于:层的定义不再是「分类」,而是「契约」——每层声明 persistent(是否落盘)、activityScoped(是否活动级私有)、allowedOps(允许的算子集合,唯一裁定矩阵)、defaultOp(默认算子)。
7.2 六个合并算子:无算子 = 拒绝
public enum MergeOp {
    /** 整体替换(需 reason)。允许写入 null —— 这是「非空不覆盖」原则的唯一例外。 */
    REPLACE("replace", "整体替换,允许显式置 null"),

    /** 仅当目标无该键或值为 null 时写入;入参为 null 时忽略。 */
    MERGE_FILL_NULL("mergeFillNull", "非空不覆盖,仅补缺失/null"),

    /** 字段级增量:只更新显式给出的非 null 键,其他键原样保留。 */
    PATCH("patch", "字段级增量,不删他字段"),

    /** 追加(append-only):键不存在则新增;已存在且值相同则跳过;值不同则拒绝。 */
    APPEND("append", "追加,冲突即拒(历史不可改写)"),

    /** 值与引用按引合并:值走 MERGE_FILL_NULL 语义,引用按内容哈希去重。 */
    UNION_BY_REF("unionByRef", "引用集合并(按 hash 去重)"),

    /** 显式删除(需 reason + 白名单)。 */
    DROP("drop", "显式删除,需 reason 与白名单");
}
三条关键性质:
- 不存在「默认算子」——每个写入必须显式声明 op,未声明即拒绝。这直接消除 R1;
- MERGE_FILL_NULL 成为 L3 唯一默认算子——「陈旧优先」从隐式规则变为显式契约;若确需覆盖,必须 REPLACE + reason,从而让 F3 从静默变为可审计;
- 所有 op 在写入前记录 reason 与 owner——一次性闭合 R7(无审计闭环)。
特别注意 REPLACE 的注释
「允许写入 null —— 这是『非空不覆盖』原则的唯一例外」。 也就是说,「非空不覆盖」不是靠代码习惯维持的,而是靠算子设计维持的:整个系统里,只有一种算子能写 null,而且它必须带 reason。
7.3 21 段全局扁平寻址:一级段即语义分类
public enum VfsSegment {
    DEF("def", WriteSemantics.CREATE_ONLY, 2, 2, "流程定义"),
    DEF_ACT("defact", WriteSemantics.CREATE_ONLY, 3, 3, "活动定义"),
    INST("inst", WriteSemantics.CAS, 1, 1, "流程实例元数据"),
    INST_CTX("instctx", WriteSemantics.MERGE, 3, 4, "流程分层上下文"),
    INST_SNAP("instsnap", WriteSemantics.APPEND_ONLY, 2, 2, "检查点"),
    INST_KNOW("instknow", WriteSemantics.MERGE, 1, -1, "实例知识"),
    INST_ART("instart", WriteSemantics.APPEND_ONLY, 1, -1, "产出物"),
    CONV("conv", WriteSemantics.CAS, 1, 1, "对话元数据(含 owner/participants/ACL)"),
    CONV_MSG("convmsg", WriteSemantics.APPEND_ONLY, 2, 2, "对话消息(append-only journal,唯一权威)"),
    CONV_ROUND("convround", WriteSemantics.APPEND_ONLY, 2, 2, "轮次快照"),
    CONV_ATT("convatt", WriteSemantics.APPEND_ONLY, 1, -1, "对话附件(引用式,正文不内联)"),
    REG("reg", WriteSemantics.CAS, 1, 1, "会话注册表(唯一权威)"),
    A2A("a2a", WriteSemantics.APPEND_ONLY, 1, -1, "A2A 委托记录"),
    SYS("sys", WriteSemantics.APPEND_ONLY, 1, -1, "系统/审计/索引"),
    TMP("tmp", WriteSemantics.TTL, 1, -1, "临时"),
    DISCOVERY("discovery", WriteSemantics.MERGE, 1, -1, "技能发现"),
    WORKFLOW_INST("wf-inst", WriteSemantics.APPEND_ONLY, 1, -1, "工作流执行实例"),
    // ===== T2-2/B1:为覆盖流程 VFS 而扩展的 4 段 =====
    ACT("act", WriteSemantics.MERGE, 2, -1, "活动实例工作区"),
    SG("sg", WriteSemantics.MERGE, 2, -1, "场景组生命周期"),
    ARCH("arch", WriteSemantics.APPEND_ONLY, 1, -1, "归档"),
    SHARED("shared", WriteSemantics.MERGE, 1, -1, "共享区域");
}
设计要点:
- 一级段即语义分类,不再出现「人 → 会话 → 消息」这类按主体嵌套的多级树;
- 每段声明自己的写入语义(CREATE_ONLY / CAS / MERGE / APPEND_ONLY / TTL)与键个数区间;
- 键个数用区间而非固定值,是为了支持两种合法扩展:源分区与追加序号;
- 段的物理落点由 ContextAddress.toPath(String) 单点决定;
- 未登记的段直接抛 ContextContractException("segment.unknown") —— fail-closed。
为什么「A2A 委托记录」值得独占一个段?因为「谁把什么上下文发给了谁」必须是可落盘、可回放、可审计的一等公民。这正是 A8(无持久化、无回放)的根治方案。
7.4 ContextDelta:唯一合法的写入单元
Ctx(n+1) = reduce( Ctx(n), Δ, op )字段 | 语义 | 用途 | 现状缺口 |
|---|---|---|---|
deltaId | 幂等键(scopeId + seq + fingerprint) | 去重、重放安全 | R6 |
correlationId | 三轴贯穿编号 | 跨轴反查 | A13 |
layer | 目标层(L0–L5) | 决定谁能写 | 层归属缺失 |
op | 六算子之一 | 消除 5 种隐式语义 | R1 |
scope | {conversationId, processInstId, activityInstId, taskId} | 作用域隔离 | 并发覆盖 |
owner | 写入主体 | 责任链 | R7 |
reason | 为什么写 | 审计与合规 | 零留痕 |
refs[] | {uri, hash, size} | 引用式传递 | A3 |
version | 乐观锁版本号 | 并发控制 | R8 |
at/ttl | 时间戳 / 存活期 | TTL 与过期 | 附件 TTL 语义不统一 |
traceId | 链路追踪 | 观测 | — |
用算子语言重述三场景的规则(这是本次审计最有价值的一张表):
场景 | 现状行为 | 升级后声明 |
|---|---|---|
对话:新消息入历史 | 入队即removeFirst()丢弃最旧(丢失) | APPEND(幂等键 = messageId)+ L4滚动压缩;禁止静默丢弃 |
对话:附件跨轮 | 服务端保留 30min、前端每轮清 → 语义相反 | L5UNION_BY_REF(前后端同一算子)+ttl显式声明 |
对话:会话切换 | clearMessageHistory()不落盘 | L4APPEND保留 + L3DROP(仅清 Working) |
流程:子流程回写 | 父非 null 不覆盖(陈旧优先) | L3MERGE_FILL_NULL;需覆盖时REPLACE + reason |
流程:子流程失败 | FAILED→COMPLETED(静默) | 失败显式传播 + 父活动状态同步 |
流程:workMode 切换 | 按档位裁剪_conv,不可逆 | L2PATCH(不删字段)+ L4 快照(可回切) |
流程:暂停恢复 | 只认内存,snapshot 不读 | L4APPEND(checkpoint)+ 恢复时LOAD(latest by correlationId) |
A2A:上下文传递 | 整段字符串 ≤8000 字 | L5UNION_BY_REF(传 uri+hash,不传正文) |
A2A:委托 | 无 pid、无参与者、无持久化 | ContextDelta带correlationId+scope+ L4APPEND落盘 |
A2A:接收执行 | 哑端回显 | 接收端LOAD(refs)→startExecution(subDefId, ctx)→APPEND新 pid |
7.5 三轴对齐:correlationId
correlationId (一次"上下文迭代"的全局唯一编号,贯穿三轴)

对话轮次轴           流程执行轴                协同轴
─────────────────────────────────────────────────────────
roundId ────────────── (始于) ──────────────── taskId/requestId
   │                        │                        │
conversationId         processInstId             fromAgentId/toAgentId
   │                        │                        │
userId activityInstId todos/remoteTaskId硬约束:任一跨轴的上下文传递(对话→流程启动、流程→A2A 委托、A2A→对话回执)必须携带 correlationId;接收端据此可反查三轴全景。
7.6 十二条原则与八条不变式
# | 原则 | 违反证据(现状) |
|---|---|---|
P1 | 单一真源 | buildLevel曾在 7 个 Map 出现;ProcessInstance.context/snapshot/extensions三 Map |
P2 | 显式合并:无算子不写入 | 5 种隐式语义(R1) |
P3 | 非空不覆盖 | put可被 null 覆盖的三处 |
P4 | 引用优先:大对象走{uri,hash} | A2AcontextSnippet8000 字截断;附件正文串轮 |
P5 | 版本化与指纹 | seq恒 0;roundId无序号 |
P6 | 全程可审计 | 阶段推进无审计;A2A 无留痕 |
P7 | 失败显式(Fail-Closed) | 子流程 FAILED→COMPLETED;远端映射缺失静默 return;canHandle=false丢弃 |
P8 | 层边界不可越 | ChatContext.variables混装多层 |
P9 | 幂等 | 60s 内存去重;审计日志重复追加 |
P10 | 预算即约束 | suggestCompression()无消费点 |
P11 | 不可变性优先 | 浅拷贝污染;getContext()暴露可变引用 |
P12 | 三轴可对齐 | A2A 无 pid;roundId 无序号 |
# | 不变式 | 校验方式 |
|---|---|---|
I1 | 任一上下文值可回答「属于哪层、谁写的、何时写的」 | 层归属 + owner + at 必填 |
I2 | 任一写入声明了算子;无算子 = 拒绝 | ContextDelta.op非空 |
I3 | 非 null 值永不被 null 覆盖(除显式REPLACE) | 合并算子单测 |
I4 | 同一deltaId重复提交不产生二次副作用 | 幂等回归 |
I5 | 三轴任一跨轴传递必带correlationId | 契约校验 |
I6 | L4 只追加;任何历史不「消失」,只「被压缩并保留摘要」 | 追加日志 + 摘要存在性 |
I7 | L5 只传引用;正文不进入消息体 | payload 体积上限校验 |
I8 | 每层只有一个可写方;跨层写经守门人 | 静态扫描(禁getContext().put) |
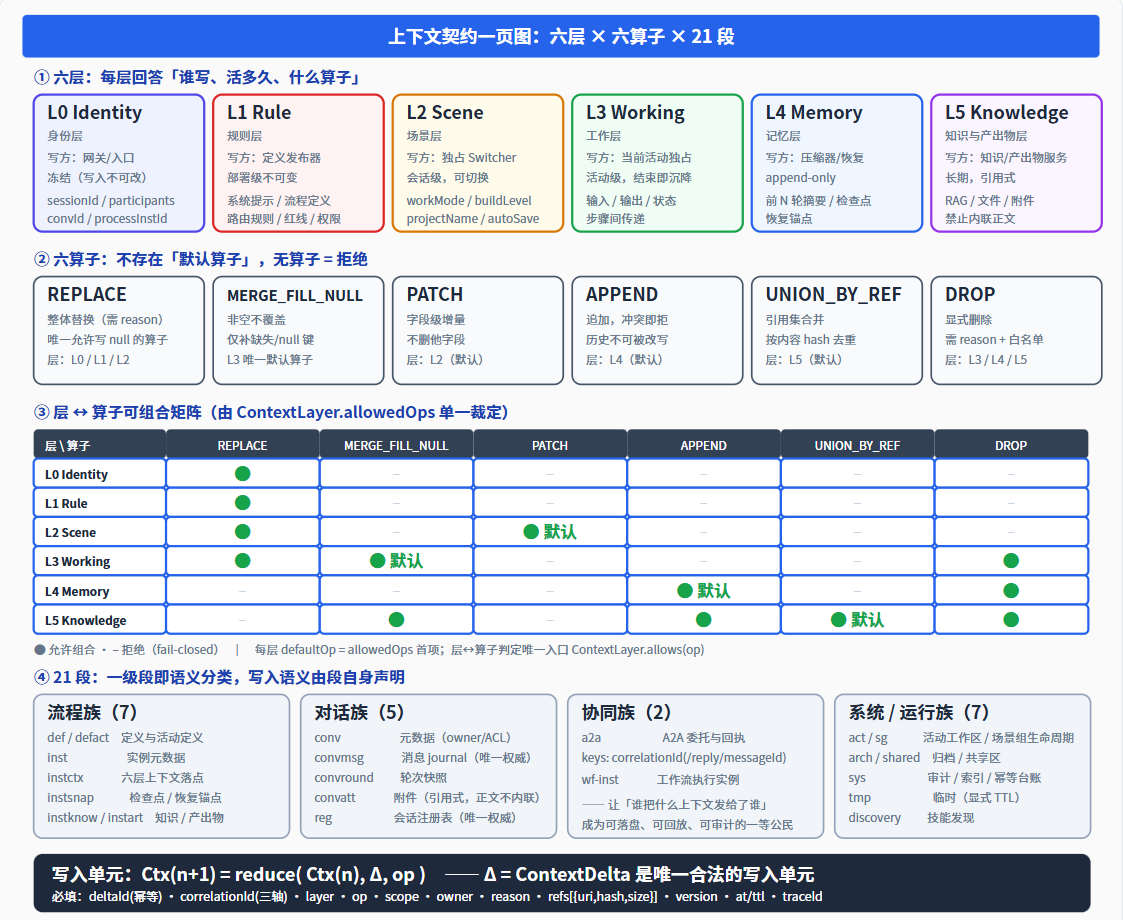
图 3 上下文契约一页图:六层 × 六算子 × 21 段
八、工程方法:怎么把「看不见的上下文」变成可验证的
这一节可能是本文最实用的部分。上下文问题最难的地方在于——它不报错。所以必须有一套「让隐形分歧显形」的方法。
8.1 影子比对(Shadow):同一写入,双跑,差异必须为 0
public enum ContextKernelMode {
    LEGACY,   // 默认:内核完全惰性,零行为变化
    SHADOW,   // 双跑:legacy 权威,差异只告警
    KERNEL;   // 内核权威(批 3 起启用)
    // 未知取值一律回落 LEGACY(fail-safe)
}影子模式的价值在于:它让「新实现与旧实现是否等价」变成一个可测量的数字。
轮次 | 结果 | 证据 |
|---|---|---|
R1 | FAILshadowed=8 / matched=7 /mismatched=1 | 内核缺失键=[confirmedIntent, executionPlan, pageId, sourceProcessInstId] |
R2 | FAILmismatched=1 | 键集合已一致,仅剩值不同键=_llmDelegate |
R3 | PASS | shadowed=8 / matched=8 / mismatched=0 / unsupported=0 / failed=0 |
R5(复跑) | PASS | shadowed=24 / matched=24 / mismatched=0;日志无任何「影子不一致」告警 |
8.2 影子比对暴露的三个「隐形分歧」
# | 缺陷 | 后果 |
|---|---|---|
1 | 幂等短路先于合并执行:deltaId由「内容指纹」派生,故「同一内容 → 中间被别的写入改写 → 再次提交同一内容」会命中同一deltaId并被当作重放跳过,丢掉一次真实的状态改写 | 内核与 legacy 分叉 |
2 | fastjson2 默认丢弃 null 值条目,而REPLACE是「唯一允许写入 null 的算子」→ 落盘内容比内存视图少键(实测25→21),文件内fingerprint却按完整视图计算 | 落盘与内存不一致 |
3 | 读回时沿用文件里的旧指纹。上下文含 JSON 往返有损的运行时对象(如_llmDelegate)时,指纹与内容不一致 | 重放/「内容未变」判定失真 |
// 修复 1:先合并、再判定重放
// 仅当 next.fingerprint() == cur.fingerprint()(结果已体现在当前状态)才判定 REPLAYED

// 修复 2:显式开启 null 保留
// 落盘改用 JSONWriter.Feature.WriteNulls(values 以 LinkedHashMap 承载)

// 修复 3:读回后按实际内容重算指纹
// 读回后按「实际内容」重算 MergeFunctions.fingerprint(values, refs)
8.3 一条必须写进门禁的纪律
「指纹 / 摘要」类字段必须由其描述的内容导出。 一旦允许它与内容脱钩(无论是序列化丢字段,还是直接沿用落盘副本),所有依赖它的幂等 / 免写判定都会静默失真。此类字段的读写两侧都要有「描述对象一致性」断言。
这条纪律还牵出一个更早的实证:数值表示差异会污染内容指纹——JSON 往返把 Double 0.75 变成 BigDecimal 0.75。修复前会导致 fingerprint 不同 → 「内容未变免写」失效 → 每次重载后 MERGE 都会误增版本并重写。
一个浮点数的表示形式,能让整个幂等机制失效。这就是上下文治理的真实颗粒度。
8.4 真机取证:把内存清空,看它还能不能活
① 起流程 → 等暂停 → 确认快照落盘(bytes / lanes / tokens / droppedKeys 全部打印)
② 真重启(pkill + 重起)→ 确认 occurrences_in_new_log=0(★ 关键:证明内存确实被清空)
③ 触发 resume → 观察再水化日志(实例图 / 状态 / 活动 全部重建)
④ 观察流程继续推进 → 确认恢复后仍能落新快照(流程真的活了)其中第②步是决定性的。没有「内存确实不在」这一步,第③步的「恢复成功」可能只是命中了内存里的老对象。这是上下文验证里最容易自欺的一环。
8.5 探针也会骗人(#18 的启示)
为什么假阴性比没有探针更危险?因为你会基于「有证据」的自信去做错误决策——比如补建一个已经存在的远端实例,制造出重复流程实例。
getProcessInstState(processInstId) → workflowClient.getProcessInst(pid)
仅 checkLogined + 主键 loadByKey、无权限过滤方法论:当连续多次探测得到「不存在」时,先验证探针本身是否具备「在目标确实存在时能够命中」的能力。可以设计一个已知存在的样本做对照。
8.6 三条可复用的工程准则
准则一:任何「状态判定」都必须能被「反例样本」证伪
影子比对(mismatched 必须为 0);探针需有对照样本(实例级 vs 活动级);失败传播需有可失败的载体(B1 的noMatchPolicy=FAIL+ 无出边转移)。
准则二:任何「丢弃」都必须留证
快照剔除运行时句柄 →contextDroppedKeys/droppedRuntimeHandles;操作不可达 → 显式 WARN + 状态置UNDELIVERABLE;历史被裁剪 → 必须有摘要(I6)。
准则三:验证必须越过「内存边界」
上下文恢复:真重启;跨节点传递:真双实例;幂等:真重投(含 qos1 延迟重投与双订阅双投递)。
九、结语:A2A 的三条反常识
反常识一:协议标准不解决上下文边界
A2A v1.0.0 给了 Agent Card、Task 生命周期、Artifact——它解决的是「怎么找到对方、怎么表达任务」。
但它明确要求「不共享内部状态、记忆与工具」。这意味着:跨智能体的上下文一致性,必须由实现方自己负责。
我们踩过的所有坑(寻址不匹配、目录为空、无 pid、整段截断、失败静默)没有一个是协议能替我们解决的。
反常识二:上下文管理不是「存储问题」,而是「契约问题」
我们最初也以为上下文的问题是「存哪里、存多少、存多久」。审计之后才发现:VFS、SQLite、内存都不缺,缺的是「谁可以写、写完怎么合并、冲突算谁的」这套契约。
- 5 种合并语义并存,不是「存储技术选型」问题,是「契约缺失」问题。
- 三链历史不统一,不是「缓存容量」问题,是「单一真源缺失」问题。
- 恢复只认内存,不是「持久化技术」问题,是「恢复锚点契约缺失」问题。
技术选型解决的是「能不能存」,契约解决的是「存了算不算数」。
反常识三:最难的不是让消息到达,而是让「状态一致」可证明
A2A 的通信层其实很容易做对——MQTT 一发一收,published: true。
难的是:接收端凭什么相信它看到的状态是真的?发起端凭什么相信对方执行的是同一份上下文?重启之后,系统凭什么相信自己接上了之前的状态?
对这三个问题的回答,构成了上下文治理的全部内容。而回答它们的方式,不是写更多代码,而是:
- 把隐式变成显式(层归属、合并算子、责任主体);
- 把静默变成可见(失败传播、丢弃留证、探针可证伪);
- 把观测变成约束(预算是约束、指纹是契约、快照是锚点)。
最后一句话总结全文:
关于本文
本文取材于 ooderAgent 仓库的真实代码、只读审计报告与真机测试记录,所有结论均可按附录中的绝对路径复查。
作者:Ooder Team | 发布日期:2026-09-13 标签:#A2A #上下文管理 #多Agent协作 #强流程 #VFS #分布式状态治理
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号