Milvus 3.0 升级不可怕,回滚才可怕
原创
🚩 2026 年「术哥无界」系列实战文档 X 篇原创计划 第 205 篇,Milvus 最佳实战「2026」系列第 31 篇
大家好,欢迎来到 术哥无界 | ShugeX | 运维有术。
我是术哥,一名专注于 AI 编程、AI 智能体、Agent Skills、MCP、云原生、AIOps、Milvus 向量数据库的技术实践者与开源布道者!
Talk is cheap, let's explore。无界探索,有术而行。
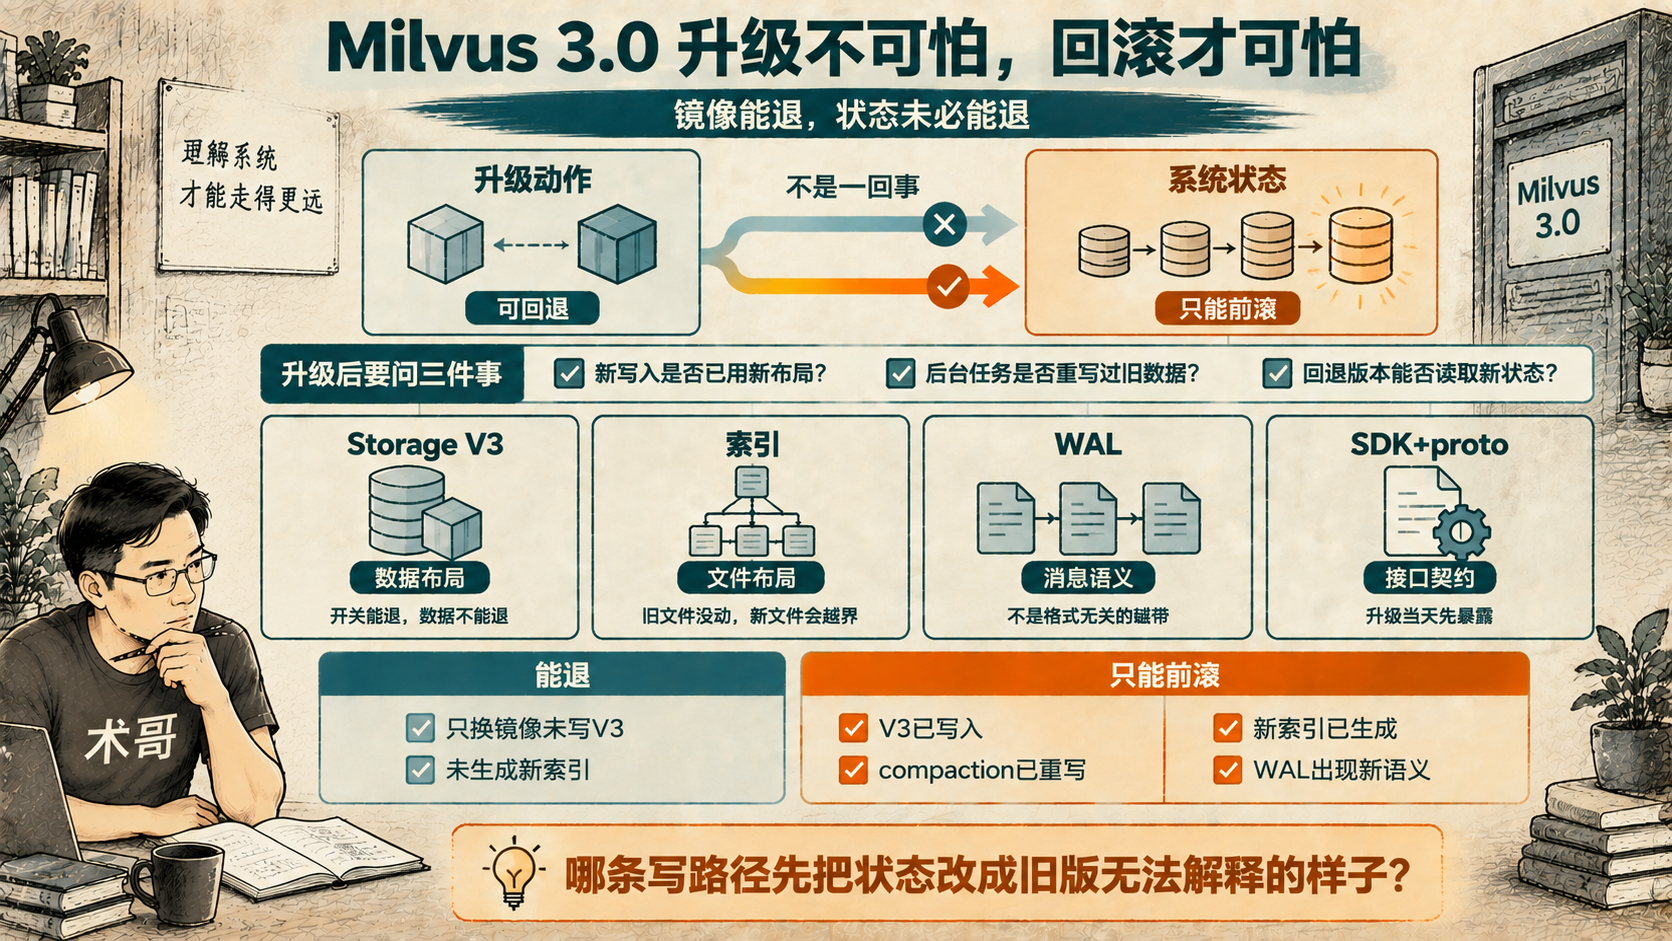
封面:镜像能退,状态未必能退
把 Helm 的镜像标签从 2.6.x 改成 v3.0.0,动作很轻。官方升级路径也确实把它描述成一次有兼容性和回滚承诺的升级。
但同一组官方文档又写着另一句更不轻的话:一旦 Milvus 将数据写入 Storage V3,就不支持降级到无法读取 Storage V3 的版本。
两句话并不矛盾。它们说的不是同一件事。
前一句说的是升级动作,后一句说的是升级后的系统状态。就 Storage V3 和索引文件而言,单纯启动 3.0 不会自动把既有布局全部重写;基于这些材料,我倾向于推断,回滚窗口主要会在升级后的新写入、后台 compaction 或索引重建中收窄。WAL 消息是否发生同样的状态变化,要按具体消息路径验证,不能从这句跨层归纳直接推出。
我倾向于把 Milvus 3.0 的升级风险压缩成一个问题:哪条写路径先把系统状态改成了旧版本无法解释的样子?
这比记住一个镜像 tag 更重要。
01 先别把“回滚”理解成换回镜像
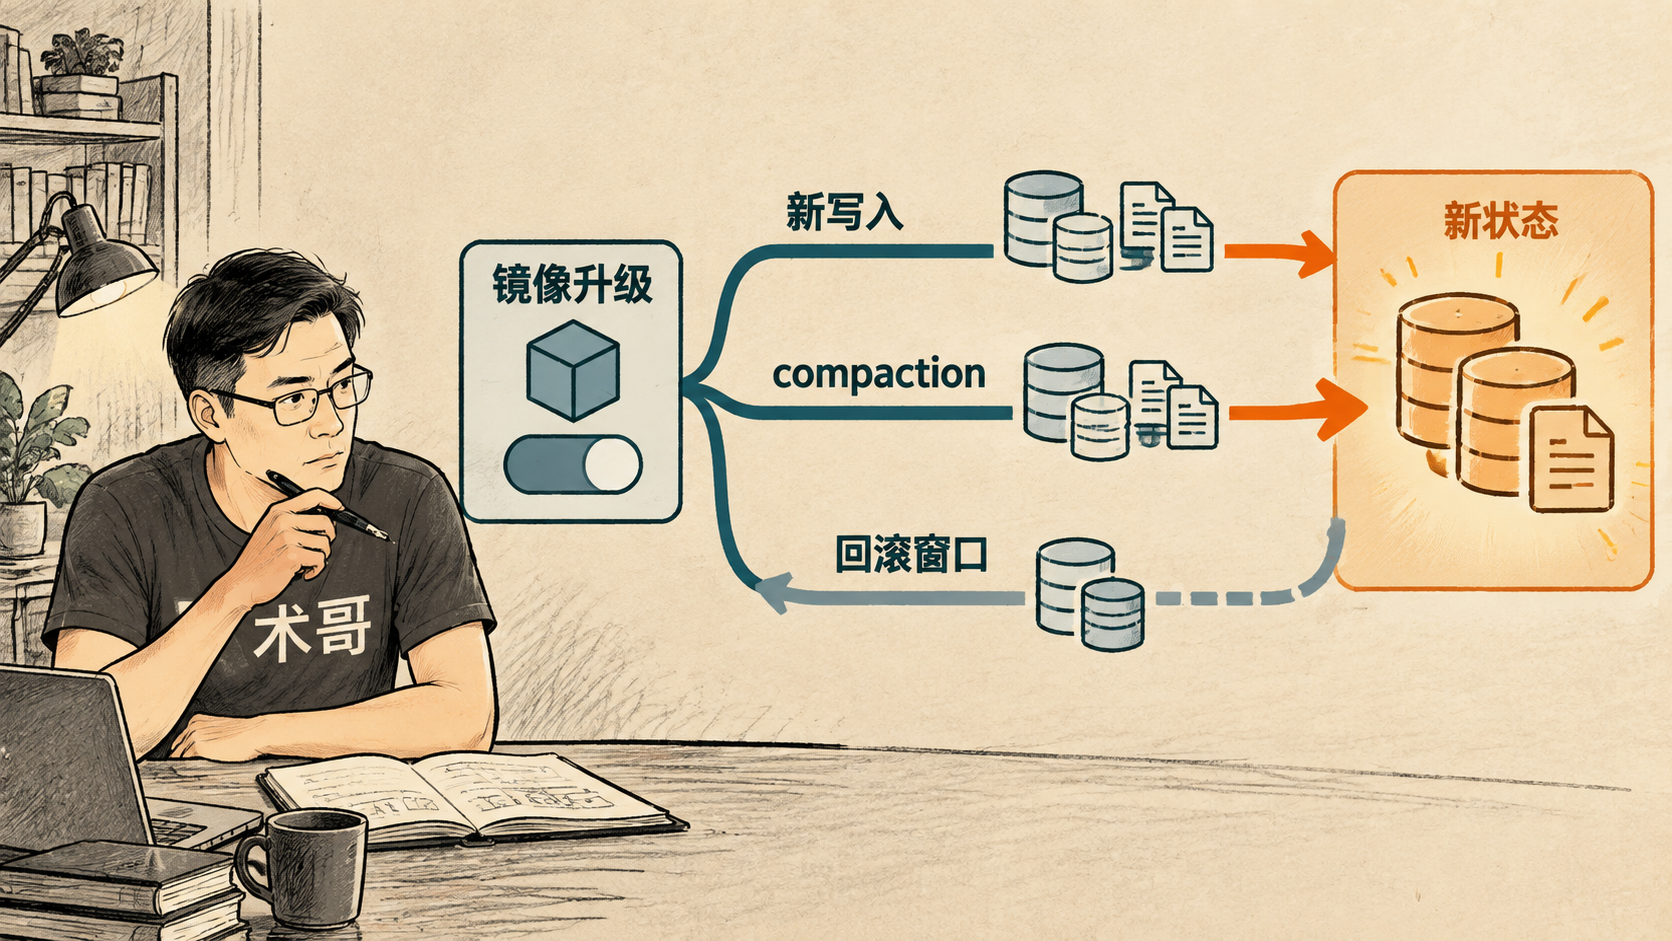
01 先别把“回滚”理解成换回镜像
“备份—升级—出问题—改回镜像”是很多 2.x 系统的直觉路径。但数据库能不能回滚,不由镜像 tag 单独决定,而由旧版本还能不能解释当前的数据、索引和 WAL 决定。
Milvus 3.0 的不可逆边界分散在几层:Storage V3 改变数据布局,索引版本改变派生文件布局,WAL 消息版本改变编解码路径,SDK 和 proto 则改变接入契约。它们形成边界的时刻不同。
就 Storage V3 和索引文件而言,升级当天可能只是潜伏状态:边界可能在第一次写入时出现,也可能要等后台 compaction 或索引重建才扩大范围。WAL 的边界取决于具体消息语义,SDK/proto 的边界则是契约变化,不能套用同一个发生时机。
所以,升级后的判断不能只问“服务是不是已经升到 3.0”,还要问三件事:
- 新写入是否已经采用了新存储布局?
- 后台任务是否把旧数据或旧索引重写过?
- 回退的旧版本是否能读取这些新状态?
前两问对应数据与派生文件,第三问则要回到消息语义和具体版本验证。
02 Storage V3:第一道门在第一次写入之后
Storage V3,也就是由 Loon FFI 支持的新存储布局,配置开关是 common.storage.useLoonFFI。源码中的默认值是 false,官方文档也说明 Storage V3 默认禁用。
打开它,并不等于系统立刻把所有存量数据做一次全量搬迁。官方文档写得很明确:新的写入操作和压缩输出使用 Storage V3,现有数据保留原来的布局;在过渡期间,系统可以读取两种布局。
这正是最容易误判的地方。
只完成镜像升级,旧 segment 可能仍然是旧布局。此时回滚窗口未必已经因为“升级”这个动作立刻消失。但一旦新写入落成 Storage V3 数据,无法读取 Storage V3 的旧版本就可能无法读取这部分状态。后台 compaction 再把符合条件的存量 segment 重写成 V3,受影响的数据范围继续扩大。
源码里的 targetVersion() 把这条路径写得很直接:useLoonFFI=true 时,compaction 的目标版本是 StorageV3;关闭时,目标回到 StorageV2。
注意“目标回到”这几个字。它不是把已经写成 V3 的数据转换回 V2。关闭开关只改变未来 compaction 的目标,不会自动把已有 V3 数据变回旧布局。官方文档也明确警告,禁用 Storage V3 不会立即转换已有 V3 数据,更不会恢复旧版本兼容性。
还有一个容易被忽略的 safety net:即使关闭 UseLoonFFI,含 TEXT 字段的 collection 仍须保持 V3,以避免数据丢失。也就是说,配置项看起来是一个开关,数据状态却不是一个可以随意拨回去的开关。
开关可以回退,已经提交的数据布局不能靠关开关回退。
后台 compaction 的迁移取决于调度、速率限制和 segment 是否满足条件,不能把“打开开关”直接写成“所有存量数据已经迁移”。但升级前必须把它当成持续发生的状态演化,而不是一次性动作。
03 索引:旧文件没动,不代表新文件不会越界
索引层的边界更安静。
Milvus 的 milvus.yaml 中,targetVecIndexVersion 默认是 10,targetScalarIndexVersion 默认是 -1;forceRebuildSegmentIndex 和 forceRebuildScalarSegmentIndex 默认关闭,autoUpgradeSegmentIndex 也默认关闭。发布说明则提示,新的索引版本需要手动启用,例如向量索引版本 10、标量索引版本 4。
这些配置告诉我们一件事:更换 3.0 镜像,不等于所有索引文件同时升级。
源码中的版本管理器会综合 target 版本和集群能力。QueryNode 上报自己支持的版本区间,集群取所有节点当前能力的最小值,滚动升级时才能保证不同节点都能加载相应索引。最终版本还会经过 clampVersion,被限制在集群实际支持的范围内。
旧索引不会因为镜像换了就自动全部重写。真正改变文件布局的动作,是新建索引、compaction 触发重建,或者显式 force rebuild。compaction_trigger.go 中就有“索引版本过旧,触发 compaction”和“标量索引版本不等于 target,触发 compaction”的路径。
这让索引的回滚风险呈现出一种不那么戏剧化、但更麻烦的形态:升级当天可能没事,运行一段时间后,后台任务才把某批旧索引重建成新版本。等你发现问题再改回镜像,旧引擎面对的已经不是原来的索引文件。
storePathVersion 的注释更加直白:Layout 1 无法被 2.6 读取,启用它会提交升级并放弃回滚到 2.6;已有索引文件仍保持原布局,切换只影响之后构建的索引文件。
因此,索引层至少要分开看两件事:
- 旧索引保持不动,镜像回退可能仍有空间;
- 新索引已经按新布局构建,或者旧索引已经被重建,回退就不能只靠换镜像。
索引版本是派生状态。它不一定在升级命令执行时越界,却可能在系统继续工作时越界。
04 WAL 不是一卷与版本无关的磁带
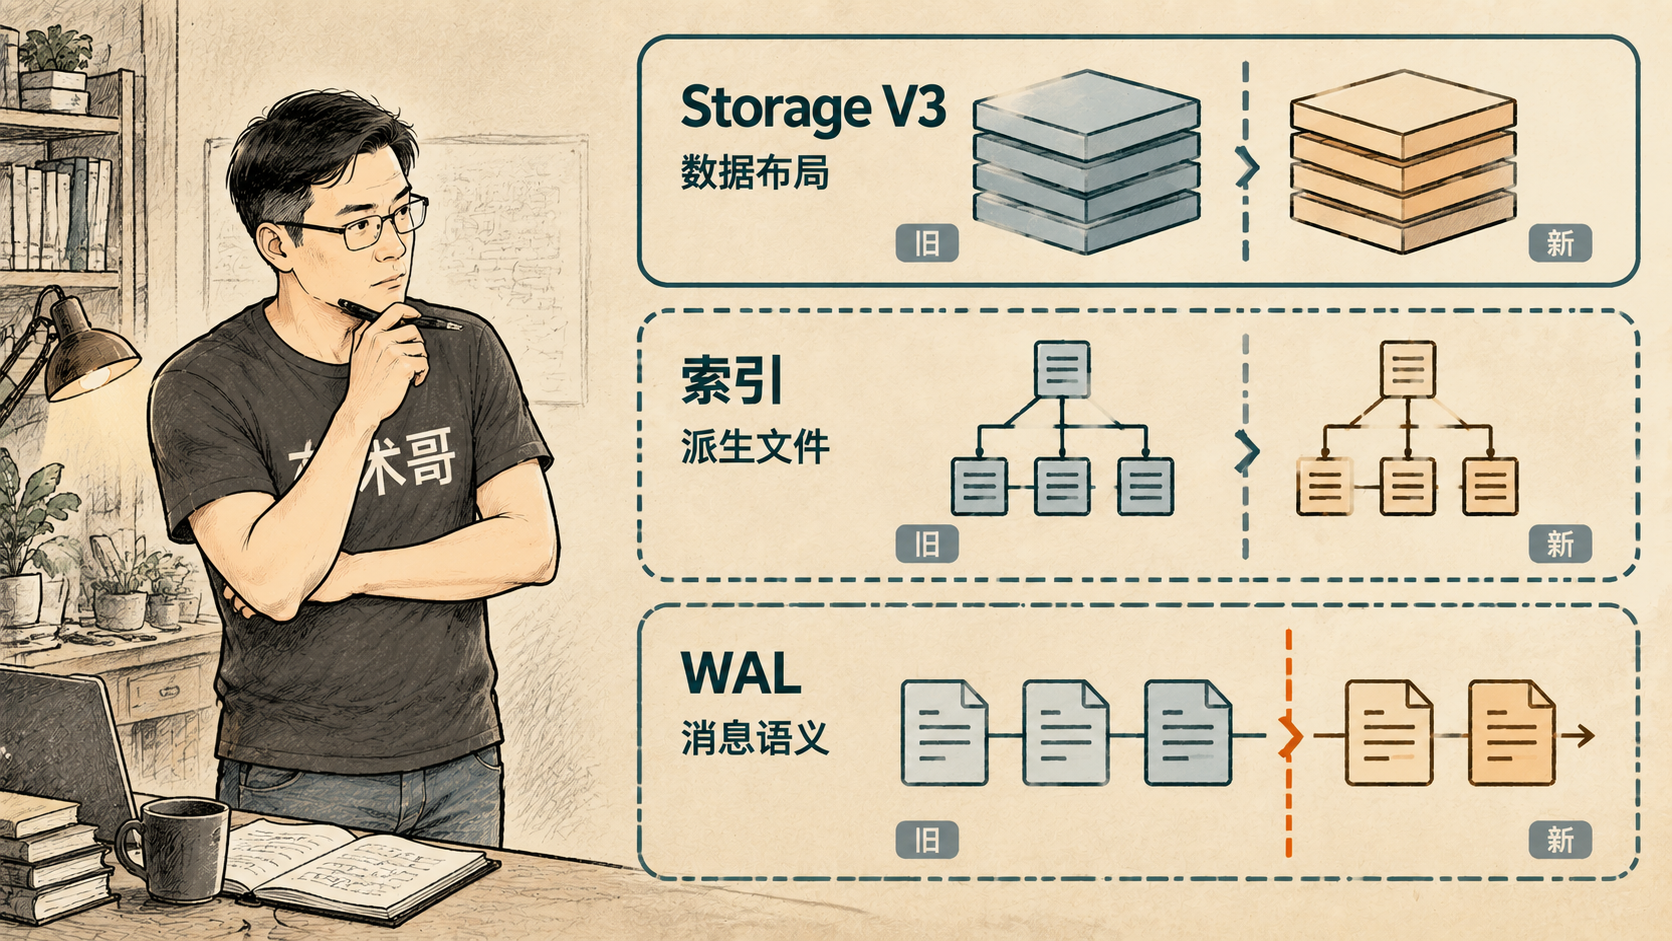
04 WAL 不是一卷与版本无关的磁带
如果说 Storage V3 改的是数据,索引改的是派生文件,那么 WAL 改的是消息如何被解释。
源码将消息版本区分为 VersionOld=0、VersionV1=1 和 VersionV2=2。旧版本消息来自 streamingnode 之前的 msgstream 架构;V1 的编解码仍使用 msgstream;V2 的编解码不再依赖 msgstream。解析路径也按版本区分,遇到未知消息版本会 panic。
3.0 对历史消息不是完全不管。WAL adaptor 中存在 V0 到 V1 的转换路径,供 streaming service 消费;源码注释同时承认,这种转换有性能损耗,只预期处理少量旧消息,并且未支持的消息类型会 panic。
这条兼容层很有价值,但不能把它理解成“所有版本的 WAL 都能互相重放”。消息头里还携带 storage_version,BatchUpdateManifest 相关消息携带或处理 manifest_version,以及 V2 column groups。消息描述的不是一件抽象的“有数据要写”,而是与存储版本和 Manifest 状态绑定的操作。
换句话说,WAL 不是一卷格式无关的磁带。它保存的是带语义的状态变更。
基于源码对 V2“不再依赖 msgstream”的定义,可以推断新旧消费语义不是简单互换。但 2.6 回滚后对所有 V2 WAL 消息的具体读取结果,目前只能标记为待验证,不能写成确定的报错或行为。
这也决定了一个操作边界:历史旧消息存在转换路径,不代表升级后产生的新消息都能被旧版本完整解释。是否关闭写入、是否清空或保留消息积压,必须结合实际消息路径和目标旧版本验证,不能用“WAL 还在”推导出“回滚一定可行”。
05 SDK 和 proto:不是数据回滚边界,却是升级当天的契约边界
接入层的风险又不同。
3.0 服务端依赖 github.com/milvus-io/milvus-proto/go-api/v3,Go client 的 module path 是 github.com/milvus-io/milvus/client/v3。3.0.0 发布说明给出的 SDK 版本是:Python 3.0.1、Node.js 3.0.3、Java 3.0.5、Go 3.0.0。
go-api/v3 和 client/v3 是主版本变化。它们首先影响的是调用方如何理解 API 和 proto,不等同于 Storage V3 那种数据格式不可逆边界。旧 SDK 与 3.0 server 的具体兼容矩阵,属于待验证事项。
但这不等于可以把客户端对齐推迟到出问题之后。服务端、客户端和 proto 之间的类型契约如果没有一起检查,升级可能先在接入层暴露,而不是等到数据读取阶段才暴露。此时回退的是调用契约,不是把已经写入的数据变回去。
这四层不能混成一个“版本兼容性”指标:Storage V3 关注数据布局,索引关注文件布局,WAL 关注消息语义,SDK/proto 关注接口契约。它们的失败时机和修复方式都不一样。
06 哪些动作能退,哪些动作只能前滚
把几种常见动作放在一起,边界会更清楚。
相对可回退的动作,通常是还没有触及新状态的动作:
- 只更换镜像,但没有发生新 Storage V3 写入,且没有新布局索引生成;
- 在 staging 环境验证配置,确认没有把生产数据推进到新布局;
- 在集群能力尚未形成新索引文件前,调整 target 版本;
- 发现 SDK/proto 契约不匹配时,先停止接入流量并按已验证的客户端版本组合调整。
这里的“相对”不能省略。具体数据、索引和 WAL 状态仍需核对。
一旦发生,原则上只能前滚或走备份恢复的动作,包括:
- 新写入已经产生 Storage V3 数据;
- compaction 已经把存量 segment 重写为 V3;
- 新索引已经按旧版本无法读取的布局生成;
- WAL 中出现旧版本没有验证过的新消息语义,且回退版本无法确认其读取路径。
官方升级文档给出的失败处理路径是停止写入,走备份恢复,而不是只把镜像 tag 改回去。这是一个很朴素的提醒:如果目标是恢复到旧版本能解释的完整状态,恢复点必须早于那些不可逆写路径。
我不买账的是“镜像能降级,所以系统就能回滚”这句话。镜像只是执行代码,系统状态还在对象存储、索引文件和消息流里。代码退回去了,状态不会自动陪你退回去。
07 升级前,先画出自己的回滚窗口
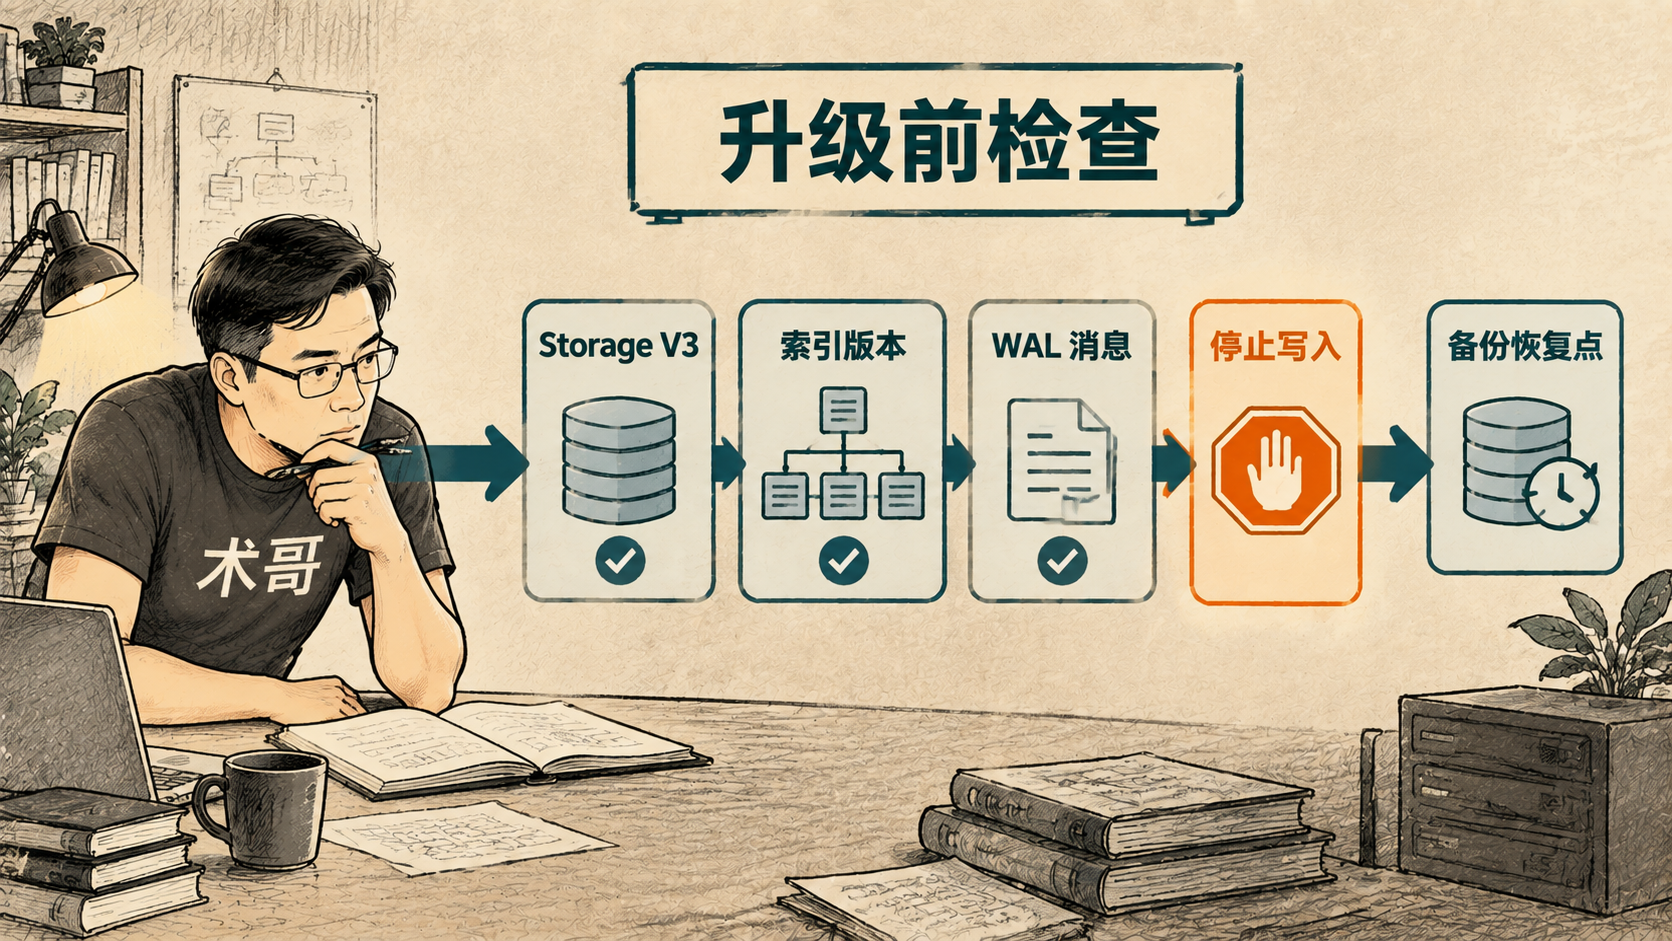
07 升级前,先画出自己的回滚窗口
在 staging 环境,建议不要只验证 Pod 能否启动。要围绕写路径做检查:
- 确认
common.storage.useLoonFFI当前值,以及升级后哪些写入和 compaction 会采用 Storage V3。 - 明确是否存在 TEXT collection。即使关闭 Loon FFI,相关数据仍可能受 V3 safety net 约束。
- 记录
targetVecIndexVersion、targetScalarIndexVersion、storePathVersion,并核对所有 QueryNode 支持的索引版本区间。 - 观察升级后是否发生 compaction、索引重建和新索引生成。迁移取决于实际调度条件,不要用固定时间窗口替代状态确认。
- 盘点 WAL 中的消息版本和积压,针对目标回退版本验证消息读取路径;V2 WAL 的 2.6 行为目前是待验证项。
- 对齐服务端、客户端和 proto 主版本,旧 SDK 与 3.0 server 的兼容矩阵也要在自己的部署组合中验证。
- 准备早于新写入的备份恢复点,并把“停止写入”作为失败路径的一部分,而不是最后才想到的操作。
真正适合升级的场景,是团队能接受升级后某些写路径只前滚,并且已经验证恢复路径;不适合直接升级的场景,是仍把回滚定义成改一次 Helm 镜像,或者无法确认后台 compaction 和索引重建已经把哪些数据推进了新状态。
Milvus 3.0 的问题不是升级命令太复杂,而是命令结束后系统还会继续写、继续压缩、继续重建索引。先回答你的数据被哪条路径改写过,再决定要不要升级。
好啦,谢谢你观看我的文章,如果喜欢可以点赞转发给需要的朋友,我们下一期再见!敬请期待!
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号