Next.js 之父和我都被震惊了:GLM-5.2 编程能力到底有多强?

Next.js 之父和我都被震惊了:GLM-5.2 编程能力到底有多强?

用户12724357
发布于 2026-09-15 19:02:24
发布于 2026-09-15 19:02:24
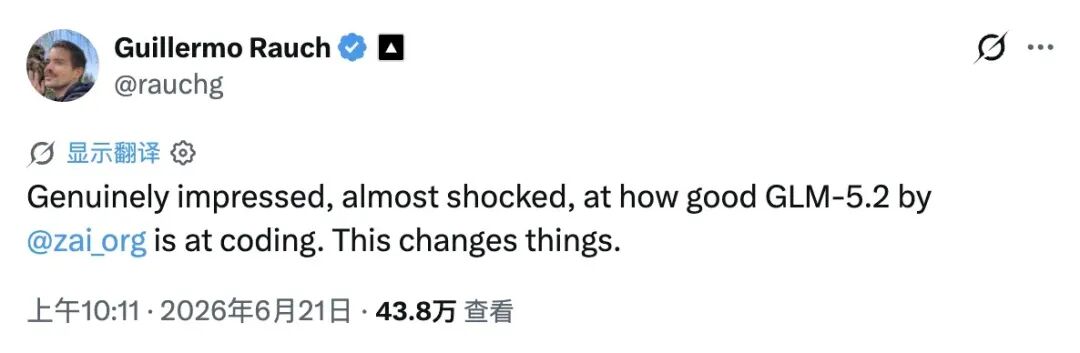
"Genuinely impressed, almost shocked, at how good GLM-5.2 by @Zai_org is at coding. This changes things."
2026年6月21日早上7点41分,Vercel CEO、Next.js 创建者 Guillermo Rauch 在 X 平台发了这条推文。24小时内,252K 阅读量,在 Reddit r/LocalLLaMA 引发大讨论。
一个中国模型的编程能力,让全球前端框架的掌门人说出"真的被震惊到"——GLM-5.2 凭什么?我用了一周,也有些话想说。
为什么是 Rauch

Guillermo Rauch 这个名字,在开发者圈子里份量不轻。
他是 Next.js 的创建者——全球最流行的 React 全栈框架,数百万网站跑在上面。他是 Socket.IO 的作者——Node.js 实时通信的里程碑项目。他是 Vercel 的 CEO——前端云部署的领军平台。
他每天都在和代码、框架、AI 编程工具打交道。这个圈子见过太多花里胡哨的演示,对真正的好东西反而很吝啬夸奖。能让 Rauch 说出"this changes things",不是随便一个模型就能做到的。
更有意思的是评论区的反应。有人说"如果你对中国模型的能力一无所知,那确实会 shocked"。但更多人直接问:怎么在 Claude Code 里用 GLM-5.2?

硬核数据
GLM-5.2 于 2026年6月13日发布,是智谱迄今能力最强的开源模型。它采用 MoE(混合专家)架构,总参数量 744B,激活参数约 40B,训练数据截止 2025年11月。目前仅支持纯文本与代码模态。
几个关键数据点:
第一,1M 上下文窗口——从 GLM-5.1 的 200K 直接拉到 100 万 token,能处理 74 万条服务器日志的根因分析,能单次会话完成跨四份合同文档的条款冲突识别。而且官方强调这是"真正可用"的 1M,不是参数表上的数字。
第二,编程能力——SWE-bench Verified 得分 82.8%,位列全球第四(仅次于 Claude Fable 5 的 95%、Claude Opus 4.8 的 88.6%、GPT 5.5 的 82.6%)。在 Coding Arena 上,GLM-5.2 以 1360 Elo 超越 Claude Fable 5,成为第一个登顶编程盲测的开源模型。
实测中,模型能一次性生成包含五大同心圆层、七颗齿轮的机械天文钟,产出 925 行无外部依赖的纯前端代码。处理 A*、Dijkstra 与 BFS 三种寻路算法可视化时能自主实现优先队列组件而非调用库函数。
第三,MIT 协议开源——下周正式开源,可自由商用、自由修改、自由分发。有开发者评论说:"从 GLM-5、5.1 到 5.2,智谱在 4 个月内迭代了 3 个版本,速度令人害怕。"
Claude Code 五分钟配好
要用 Claude Code 调用 GLM-5.2,只需在 ~/.claude/settings.json 中配置环境变量:
重要的是 ANTHROPIC_BASE_URL 指向智谱的 Anthropic 兼容接口,模型名加上 [1m] 后缀开启 1M 上下文。如果不加后缀,默认还是普通上下文长度,1M 等于是个隐藏技能。
参考如下:
ANTHROPIC_BASE_URL="https://open.bigmodel.cn/api/anthropic"
ANTHROPIC_AUTH_TOKEN="xxxxxx"
ANTHROPIC_DEFAULT_SONNET_MODEL="glm-5.2[1m]"
ANTHROPIC_DEFAULT_OPUS_MODEL="glm-5.2[1m]"
ANTHROPIC_DEFAULT_HAIKU_MODEL="glm-4.7"
CLAUDE_CODE_AUTO_COMPACT_WINDOW="1000000"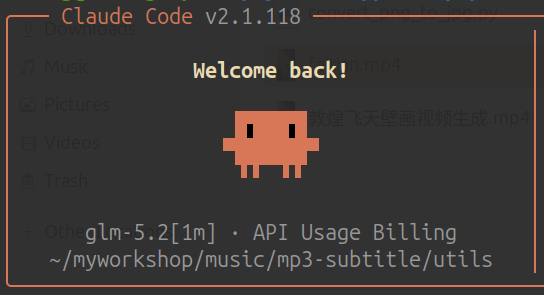
另外,智谱官方有个限时福利:GLM-5.2 作为高阶模型,按"高峰期 3 倍、非高峰期 2 倍"消耗额度,但非高峰期仅按 1 倍抵扣,持续到 9 月底。高峰期是每日 14:00~18:00(UTC+8),所以这几月尽量趁非高峰期用,性价比拉满。
亲身体验:一个谋士
回到我自己的体验。GLM-5.2 发布当天我就配好了 Claude Code,扔了一周的各种任务。说实话,最让我惊艳的不是它写长篇代码的能力——那个我预期到了——而是它处理问题的方式。
举个例子。我有一个视频文件,需要去除左上角和右下角的"豆包AI生成"水印。这不是什么新鲜需求,市面上工具一把。但 GLM-5.2 的处理流程让我印象深刻:
它先调用 superpowers skill 分析了我的需求,
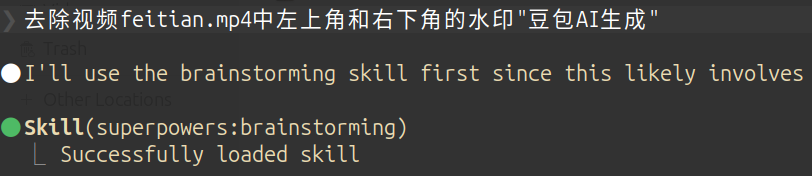
然后经过几轮对话,给我出了上中下三策:
上策是用 AI 逐帧修复,效果最好但耗时;中策用 FFmpeg 做模糊覆盖,平衡效果和效率;
下策直接裁剪画面,最简单粗暴。还列出了每种方案的优劣、适用场景、预期效果。
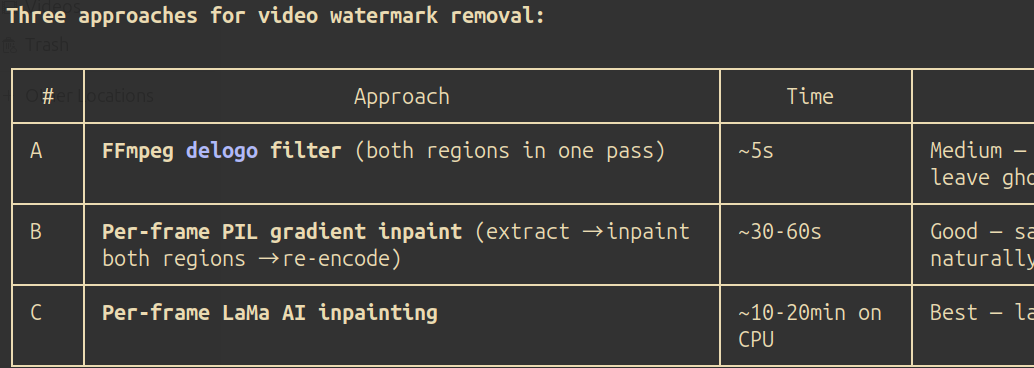
然后是给我推荐一个最佳方案:
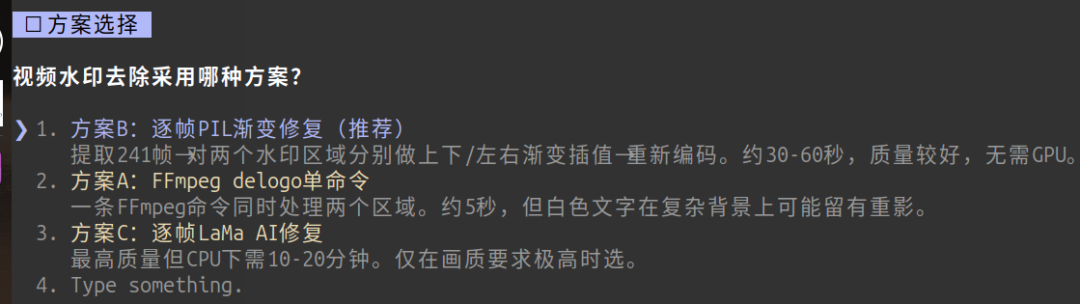
那一刻我脑子里蹦出一句话:"主公,某有上中下三策……" —— 妥妥一个中国古代谋士的风范。
不是机械地执行指令,而是先分析局势、评估选项、推荐最优路径。
这种"谋士感"就是 GLM-5.2 和之前模型最大的区别。以前的 AI 编程工具,你说 A 它就做 A,你说 B 它就做 B,像个听指令的下属。但 GLM-5.2 会主动帮你想问题——你的需求不一定是最优的,它会把上下游都顾虑到。
就是有点费tokens:
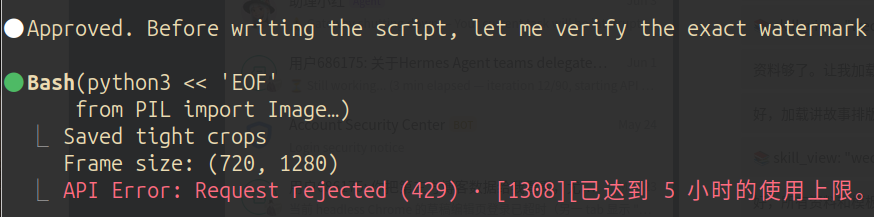
一周用下来,确实有一种"GLM 在手,天下我有"的感觉。
结语
GLM-5.2 不可能完美——它推理速度比 Claude Opus 4.8 慢了约 30%(45 分钟 vs 33 分钟),部分指令遵循场景偶尔缺失分隔符,复杂推理(HLE 等)与顶尖模型还有约 5% 的差距。但作为国产模型里第一个在编程能力上逼近国际顶尖的开源模型,它的意义不止于跑分。
认知层面:国产模型的编程能力已经不是"能不能用"的问题,而是"好不好用"的问题。GLM-5.2 的 SWE-bench 82.8% 和 Coding Arena 第一告诉开发者:该重新审视你的模型选择了。
能力层面:Claude Code 配 GLM-5.2 只需要 5 分钟改个配置文件。它支持 1M 上下文适配长程任务,限时福利下性价比极高。建议趁非高峰期使用,体验最佳。
判断层面:GLM-5.2 不是万能药。它慢,复杂场景下还不稳定,不适合对响应速度有严格要求的实时交互。但如果你手里有长程编程任务、代码迁移、跨文件分析,它值得一试。
当 Guillermo Rauch 在 X 平台上说出"this changes things"的时候,他不是在夸一个演示——他是在说,编程这件事,又往前走了一步。
喜欢就点击关注我哦~
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-06-21,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号