阿里禁了Claude Code:国产大模型的快速迭代周期到来了

阿里禁了Claude Code:国产大模型的快速迭代周期到来了

用户12724357
发布于 2026-09-15 19:07:29
发布于 2026-09-15 19:07:29
为什么到现在还有人抱着不放

为什么到现在还有大批公司和人死抱着 Claude Code 不放?
不是因为业务真的需要那个能力——是人性的问题。人都想用最好的,管你什么场景,用了再说。
哪怕 80% 的需求国产模型完全能搞定,剩下 20% 的不确定性也足以让人花几百刀买个安心。宁可用贵的,也不愿用错的,就这么简单。

缺的那块拼图
但反过来想,这恰恰是国产模型生态一直缺的那块拼图。
大家嘴上都说支持国产,采购清单上可诚实着呢, Claude Code赫然在列。没有高强度真实业务场景喂进去,迭代就是闭门造车。
做过工程开发的人都知道,真实客户场景的反馈数据最重要。阿里这一刀砍下去,几万工程师被迫切过来,每天几十万次真实请求砸进去,哪里弱、哪里卡,数据马上告诉你。有了这个反馈闭环,迭代速度会比现在快得多。
导火索攒了一阵子
Anthropic 6 月 10 日给美国参议院银行委员会写信,说阿里搞了两万五千个假号刷了两千八百万次交互,定性叫"工业级蒸馏攻击",直接上升到国家安全。阿里对此予以否认。这套词儿他们之前拿去怼过 DeepSeek、月之暗面、MiniMax,剧本都快背熟了。
更离谱的是 Claude Code 被扒出偷偷加了检测机制——看你时区是不是中国的,对照 147 个中国实体(AI 实验室、域名转售商等)清单,用隐写术把结果塞进系统提示词里,每次请求都带着走。事后承认是"实验性"措施,回滚了。但信任碎了就是碎了。
再加上封号潮,大量付费账号无预警禁用不退钱。时间线全赶一块儿了,阿里砍 Claude Code 几乎是必然的。
四个月亲测,差距没你想的那么大
说说我自己的体验,四月中旬之前工作中天天用 Claude Code的大模型,之后切到国产模型。说实话,差距有,但不像很多人想象的那么大。另外,其实我也挺烦Anthropic, 各种的封,禁,作为用户最怕不确定性。
四月中旬到现在,我自己做了好几个项目,Qwen3、DeepSeek、GLM、Minimax 我都用过,还有一些刚起步的弱模型,Sensenova, Agnes的免费模型,我主要用在Hermes Agnet的个人智能助理场景,完全够用,在中文场景甚至更顺手。
当然得说句实话:国产大模型算力还是不够,H100 还是 H200 在那摆着,这是硬约束。高峰期用主流大模型限流确实烦,而且还翻倍计算,我经常只能晚上干活。具体到场景:CRUD、脚本、文档、前端页面,国产模型没问题;复杂多步推理和大型重构,长时间自主运行,还有差距。但大部分人的日常开发任务,国产模型已经够用了。
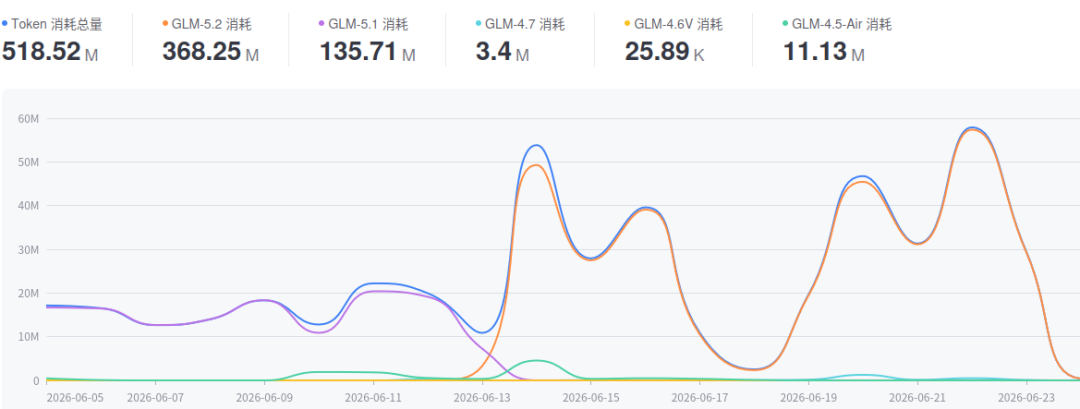
下面是我上个月大致GLM 5.2的使用量,5个多亿的词元,只是做了一些个人的开发,如果这 5 亿 Token 的消耗量完全转移到 Claude Code(以 Sonnet 5 为例),在不使用缓存的极端情况下,花费大约在 1,000 到 5,100 之间;而在真实开发场景下,得益于缓存机制,实际花费大概率会落在 2,600 到 3,100 左右,那可是美元啊。如果使用 Anthropic 官方的 Claude Code 订阅,需要用到最高档的 Max 20x 计划。
造不如买,该醒了
阿里禁了之后推自家的 Qoder 接替。当然,阿里自己有 Qwen 和 Qoder,这个决定也不是没有商业算盘。能不能顶住几万工程师的日常开发,马上见分晓。
一直以来我们都遵循一个规律:国外禁掉国内什么,国内就能快速自主创新。大国重器,各行各业,反复验证过。
软件和硬件不一样——AI 模型迭代周期是月级别的,开源权重(Qwen、DeepSeek 权重公开)让追赶速度远快于硬件制造。"造不如买"是普遍的惰性思维,软件领域,禁的效果确实来得更快。
以前是演习,现在是实战。打仗才知道差距在哪,打起来进步才快。"造不如买"是最舒服的路,也是最危险的路——我们已经被卡无数次脖子了。
国外禁什么,我们就能造什么。从芯片到模型,这条路已经被反复验证过了。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-07-04,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号