从零到一:用ChatGPT+Notion打造你的智能知识库
原创
从零到一:用ChatGPT+Notion打造你的智能知识库
原创
华东子
发布于 2026-09-16 07:30:15
发布于 2026-09-16 07:30:15
引言:为什么需要智能知识库?
你是否曾经历过这样的场景:浏览器里收藏了上百篇“稍后阅读”的文章,却从未再打开过;笔记软件里散落着无数碎片化的想法,需要时却怎么也搜不到;面对海量信息,明明感觉学到很多,真正调用时却一片空白?
信息过载已成为现代知识工作者的核心痛点。 传统笔记工具的局限在于——它们只是被动的“存储箱”,而非主动的“思考伙伴”。你记录的内容越多,检索和整理的负担就越重,知识库最终沦为数字垃圾场。
AI与知识管理的结合正在改变这一局面。ChatGPT擅长理解、总结与生成,Notion擅长结构化存储与灵活组织,两者互补形成了完整的知识管理闭环:AI负责“消化”信息,Notion负责“存储”知识,而你只需掌控方向。
本文的目标,就是带你从零开始搭建一个个人智能知识库——它能够自动摘要网页文章、智能打标签、支持自然语言问答,真正实现高效信息管理。无论你是学生、研究者还是职场人士,这套方法论都将为你打开一扇新的大门。
准备工作:工具介绍与账号设置
在动手之前,我们先来了解两位主角,并完成基础配置。
Notion基础:工作区、页面、数据库概念
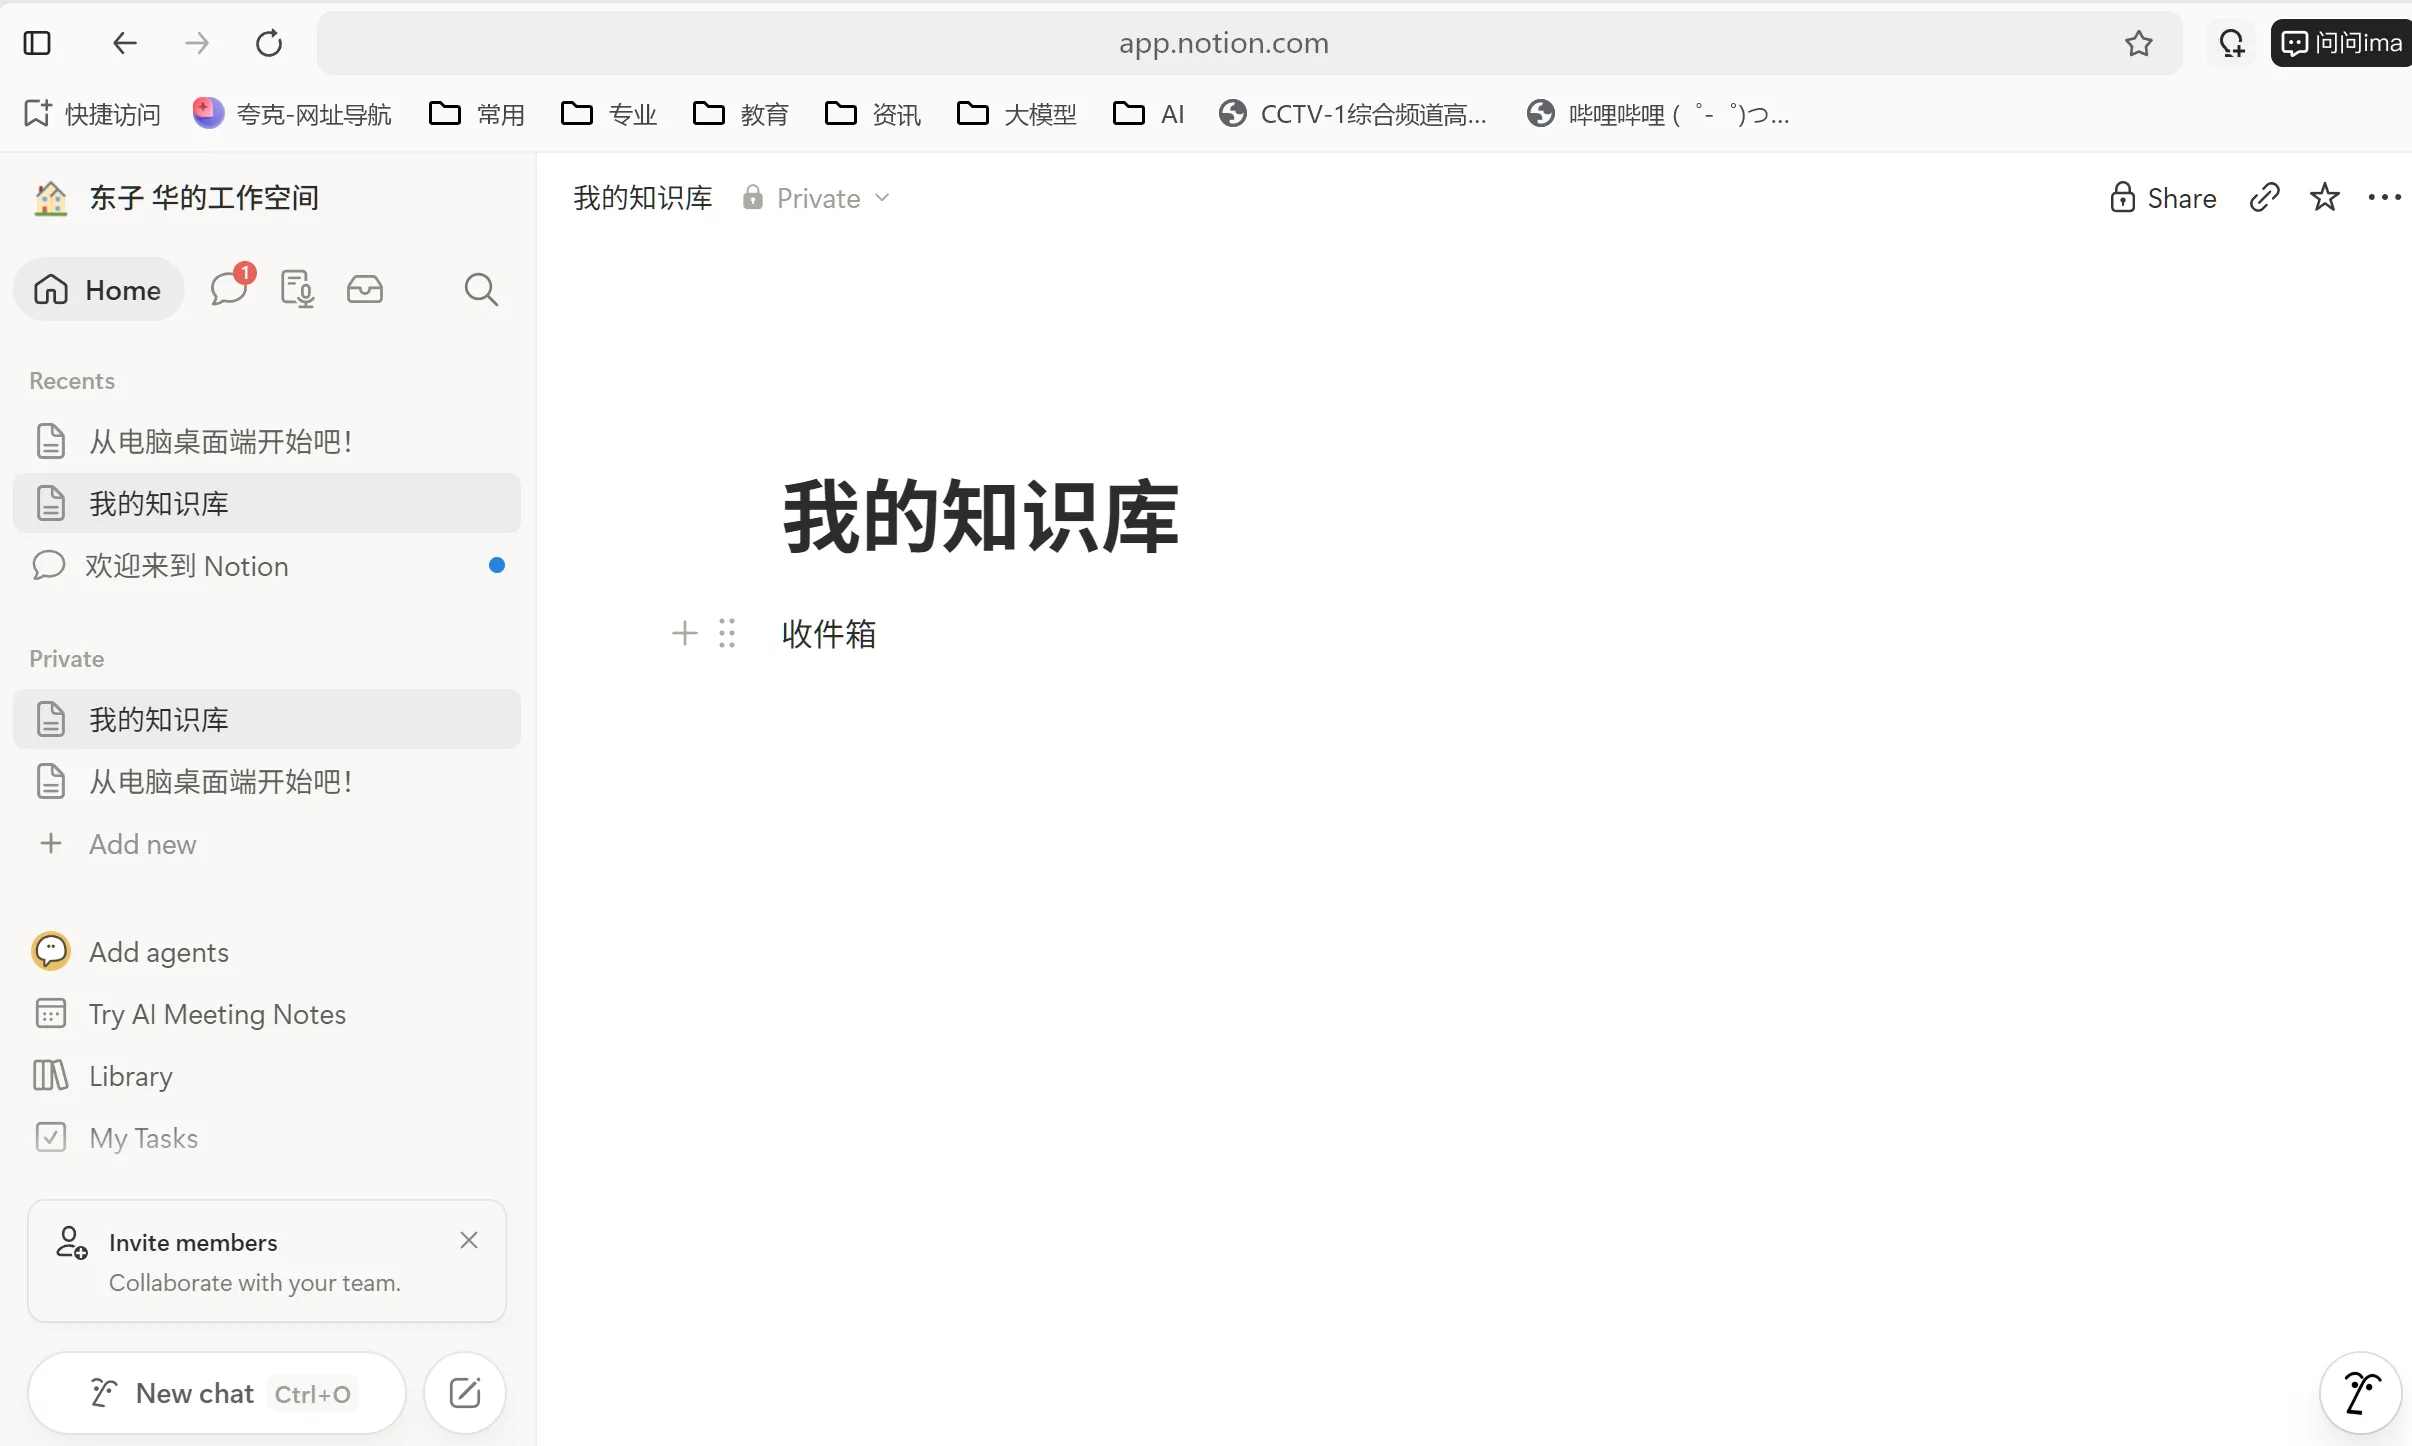
Notion是一款集笔记、文档、数据库、看板于一体的协作平台。理解以下核心概念即可上手:
- 工作区(Workspace):你的私人空间,可理解为“一个专属的云盘”。
- 页面(Page):Notion中的基本单元,可以是一篇笔记、一个文档,也可以嵌套子页面。
- 数据库(Database):Notion的灵魂,支持表格、看板、日历、画廊等多种视图,可自定义字段和属性。
- 块(Block):Notion最基本的内容单位,页面中的每一段文字、每一个图片、每一条待办事项都是一个块。
- 属性(Properties):数据库页面的字段,用于筛选、排序和分组,决定了数据以何种维度被组织和检索。
ChatGPT简介:API与网页版的差异
OpenAI 提供网页端与 API 两种主要调用方式,二者差异如下:
对比维度 | 网页版 | API(应用程序接口) |
|---|---|---|
使用方式 | 浏览器交互,手动输入 | 代码调用,可自动化 |
适用场景 | 单次问答、写作辅助 | 批量处理、集成到工作流 |
成本 | 订阅制(如ChatGPT Plus) | 按token计费 |
灵活性 | 低,无法程序化控制 | 高,可自定义参数 |
对于自动化知识流水线,API是更优选择。 它允许你通过Python等编程语言调用模型能力,将处理流程嵌入到日常工具中。
注册与基础配置
- 创建Notion账号:访问notion.so,用邮箱注册即可。个人使用免费版足够。
- 获取ChatGPT API密钥:
- 访问platform.openai.com,注册或登录。注意:OpenAI Platform 账户与 ChatGPT 账户相互独立,仅订阅 ChatGPT Plus 并不等于拥有 API 调用额度。
- 进入 Settings → Billing,绑定支付方式并设置充值金额——没有可用的支付方式,即使创建了密钥也无法调用 API。
- 进入“API Keys”页面,点击“Create new secret key”,复制保存(注意:密钥只显示一次,请妥善保管)。
安全提示:API密钥等同于你的资金账户凭证,切勿上传到公开仓库或分享给他人。建议在代码中通过环境变量引用。
Notion环境搭建
创建知识库主页:页面结构与导航
打开Notion,创建一个新页面,命名为“我的知识库”。在此页面下,你可以规划以下结构:
我的知识库
├── 📥 收件箱(Inbox)—— 临时存放待处理内容
├── 📚 文章库 —— 已处理的文章摘要与链接
├── 💡 灵感笔记 —— 碎片化想法与灵感
├── 📊 项目资料 —— 按项目分类的文档
└── 🏷️ 标签管理 —— 统一的标签体系说明
页面层级不必过于复杂,保持“收集-处理-归档”的清晰路径即可。
建立数据库:标签、属性、视图设计
在“文章库”页面下,创建一个数据库(选择“表格”视图),并设置以下属性:
属性名 | 类型 | 说明 |
|---|---|---|
标题 | 标题(Title) | 文章标题 |
摘要 | 文本(Text) | AI生成的简要总结 |
标签 | 多选(Multi-select) | 如:AI、生产力、心理学 |
来源 | 链接(URL) | 原文链接 |
日期 | 日期(Date) | 收录日期 |
状态 | 选择(Select) | 待读/已读/重点回顾 |
关键词 | 文本(Text) | 便于检索的术语 |
视图切换是Notion数据库的强大之处:
- 表格视图:适合批量浏览和编辑。
- 看板视图:按“状态”分组,适合管理阅读进度。
- 日历视图:按“日期”查看,适合追踪时间线。
模板库使用:提高效率的预设模板
Notion内置了大量模板,点击页面右上角的“模板”按钮即可浏览。推荐使用:
- 读书笔记模板:包含摘要、金句、思考等字段。
- 会议记录模板:结构化记录会议要点。
- 项目追踪模板:结合看板与时间线。
你也可以将自己的数据库保存为模板,方便以后复用。
ChatGPT接入准备
选择接入方式:API调用、第三方集成或手动复制
针对不同技术水平的用户,有三种接入方式:
- 手动复制(零门槛):将内容复制到ChatGPT网页版,获得总结后粘贴回Notion。适合低频使用。
- 第三方集成(低门槛):使用Zapier、Make(原Integromat)等自动化平台,连接ChatGPT API与Notion数据库。适合不想写代码的用户。
- API调用(高灵活):编写Python脚本直接调用OpenAI API,实现完全可控的自动化流水线。这是本文推荐的方式,下文将给出示例。
获取API密钥与安全注意事项
- 在OpenAI平台创建密钥后,建议将其存储在本地环境变量中,而非硬编码在脚本里。
- 设置用量上限(在OpenAI平台“Limits”页面),防止意外超额。
- 定期轮换密钥,降低泄露风险。
了解模型能力:文本生成、摘要、问答等
ChatGPT(特别是GPT-4系列)具备以下与知识库相关的能力:
- 文本摘要:将长文章压缩为要点。
- 信息提取:从非结构化文本中抽取结构化数据(如标签、关键词)。
- 问答:基于给定上下文回答问题。
- 改写与润色:优化笔记的表达。
明确这些能力边界,有助于你设计合理的自动化流程。
核心流程:构建自动化知识管理流水线
现在进入正题。我们的目标是构建一条“采集→处理→存储”的自动化流水线,让知识管理变得轻松高效。
采集:高效捕获信息
信息采集是知识库的入口,关键在于“无 friction”(不打断心流)。
- Notion Web Clipper:官方浏览器插件,一键将网页保存到指定数据库。支持自定义属性映射,非常方便。
- Pocket / Instapaper:先收藏后整理,配合IFTTT或Zapier自动转发到Notion。
- 手机安装Notion应用后,可通过“分享”菜单直接将文本、链接或图片发送到收件箱页面。
- 使用快捷指令(iOS)或Tasker(Android),创建“一键发送到Notion”的快捷方式。
Notion支持从Evernote、OneNote等工具导入。路径:设置 → 导入 → 选择来源。导入后注意清理格式和标签。
处理:ChatGPT自动化工作流
这是整个知识库的“大脑”环节。我们通过Python脚本调用ChatGPT API,实现自动摘要和标签生成。
以下是一个简化示例,演示如何调用OpenAI API对文本进行摘要:
import os
from openai import OpenAI

# 从环境变量读取API密钥
client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

def summarize(text, max_tokens=200):
    """使用ChatGPT生成文本摘要"""
    response = client.chat.completions.create(
        model="gpt-4o-mini",  # 可根据需求选择模型
        messages=[
            {"role": "system", "content": "你是一个专业的摘要助手,请用简洁的中文概括以下内容的要点,控制在200字以内。"},
            {"role": "user", "content": text}
        ],
        max_tokens=max_tokens,
        temperature=0.3  # 降低随机性,保证输出稳定
    )
    return response.choices[0].message.content

# 示例:从文件读取文章内容并生成摘要
with open("article.txt", "r", encoding="utf-8") as f:
    content = f.read()

summary = summarize(content)
print("摘要结果:")
print(summary)
提示词(Prompt)的设计直接影响输出效果。以下是一些经验:
- 明确角色:告诉模型“你是一个……助手”。
- 指定格式:要求输出为JSON,方便后续解析。示例:
prompt = """
请对以下文本进行摘要,并提取3个关键词。以JSON格式输出,包含"summary"和"tags"两个字段。

文本:{text}
"""- 提供示例:在提示词中给出一个输入输出对,模型会模仿该格式。
将上述逻辑封装成函数,遍历收件箱中的未处理条目,批量生成摘要和标签,然后写入Notion数据库。可使用notion-client库操作Notion API:
from notion_client import Client

notion = Client(auth=os.environ["NOTION_API_KEY"])
database_id = "你的数据库ID"

# 查询未处理条目
results = notion.databases.query(
    database_id=database_id,
    filter={"property": "状态", "select": {"equals": "待处理"}}
)

for page in results["results"]:
    # 提取原始文本(假设存在"原文"属性)
    raw_text = page["properties"]["原文"]["rich_text"][0]["text"]["content"]

    # 调用ChatGPT生成摘要和标签
    result = process_with_chatgpt(raw_text)

    # 更新Notion页面属性
    notion.pages.update(
        page_id=page["id"],
        properties={
            "摘要": {"rich_text": [{"text": {"content": result["summary"]}}]},
            "标签": {"multi_select": [{"name": tag} for tag in result["tags"]]},
            "状态": {"select": {"name": "已处理"}}
        }
)注意:以上代码为示意,实际使用时需根据你的数据库结构调整属性名称和类型。
存储:Notion数据库设计
结合AI处理结果,建议数据库包含以下字段:
字段 | 类型 | 用途 |
|---|---|---|
标题 | 标题 | 内容标题 |
摘要 | 文本 | AI生成的简要总结 |
标签 | 多选 | 自动+人工标签 |
关键词 | 文本 | 便于精确检索 |
来源 | 链接 | 原文地址 |
日期 | 日期 | 收录时间 |
状态 | 选择 | 待读/已读/重点 |
AI评分 | 数字 | 可让ChatGPT评估内容价值(0-10) |
- 表格:默认视图,适合快速浏览和编辑。
- 看板:按“状态”分组,适合管理阅读队列。
- 日历:按“日期”查看,适合回顾每日收集情况。
Notion支持数据库之间的关联。例如,你可以创建“项目”数据库,并通过“关系”属性将文章链接到相关项目。这样,在项目页面中即可看到所有关联资料。
进阶技巧:提升知识库的智能性
基础流水线已经跑通,现在让我们为知识库注入更多“智能”。
智能问答:让知识库“活”起来
静态的知识库只是资料库,而动态的问答系统才是“第二大脑”。
RAG(Retrieval-Augmented Generation)的核心思路:先从知识库中检索相关片段,再让ChatGPT基于这些片段生成回答。这比直接问ChatGPT更可靠,因为答案基于你的私有知识。
实现方案:
- 将Notion数据库内容导出为文本文件,或通过API实时读取。
- 将文本切分为小块(chunk),并转为向量(embedding)存储。
- 用户提问时,计算问题向量与各块的相似度,返回Top-K相关内容。
- 将检索结果与问题一起交给ChatGPT,生成最终回答。
简化版本:使用Notion API搜索关键词,将匹配的页面内容拼接后发给ChatGPT。虽然不如向量检索精确,但实现成本低。
def ask_knowledge_base(question):
    # 1. 在Notion中搜索相关页面
    results = notion.search(query=question, filter={"property": "object", "value": "page"})

    # 2. 提取页面文本内容(需递归获取块内容)
    context = ""
    for page in results["results"]:
        blocks = notion.blocks.children.list(block_id=page["id"])
        for block in blocks["results"]:
            if block["type"] == "paragraph":
                context += block["paragraph"]["rich_text"][0]["text"]["content"] + "\n"

    # 3. 将上下文与问题发送给ChatGPT
    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": "你是知识库助手,请基于以下上下文回答用户问题。如果上下文中没有相关信息,请如实说明。"},
            {"role": "user", "content": f"上下文:\n{context}\n\n问题:{question}"}
        ]
    )
    return response.choices[0].message.content
想象一下:你积累了一年的阅读笔记,现在只需在聊天框中输入“我之前看过关于习惯养成的文章吗?核心观点是什么?”,系统就能从知识库中检索并总结出答案。这正是RAG流程的魅力。
自动化标签与分类
手动打标签耗时且不一致,AI可以大幅减轻这一负担。
在摘要的同时,让ChatGPT生成3-5个标签。关键技巧:
- 在提示词中给出标签风格示例,如“简洁、名词性、避免过细”。
- 限制标签数量,避免标签爆炸。
对于已有标签体系,可以建立关键词映射表。例如:
- 包含“GPT”、“AI”、“机器学习” → 自动添加“AI”标签。
- 包含“效率”、“时间管理” → 自动添加“生产力”标签。
在Python中实现:
RULES = {
    "AI": ["GPT", "人工智能", "机器学习", "神经网络"],
    "生产力": ["效率", "时间管理", "GTD", "习惯"],
    "心理学": ["认知偏差", "情绪", "行为"]
}

def auto_tag(text):
    tags = set()
    for tag, keywords in RULES.items():
        for kw in keywords:
            if kw.lower() in text.lower():
                tags.add(tag)
                break
return list(tags)AI生成的标签并非完美,建议每周花10分钟审视新入库的条目,合并相似标签、删除错误标签。人机协同是知识管理的最佳实践。
实战案例:搭建个人知识库的完整过程
理论讲得再多,不如动手实践。让我们跟随一位研究者的真实需求,走一遍完整流程。
案例背景:一位研究者的知识管理需求
小李是社会学专业的博士生,日常需要阅读大量文献、新闻和公众号文章。他面临三个痛点:
- 文献阅读后容易遗忘,无法快速回顾。
- 不同来源的资料分散,缺乏统一检索入口。
- 写文献综述时,难以快速找到相关主题的所有材料。
他决定用ChatGPT+Notion搭建个人知识库,目标:
- 自动生成文献摘要和关键词。
- 按研究主题(如“数字鸿沟”、“平台经济”)自动分类。
- 支持自然语言检索:“我关于数字鸿沟的笔记有哪些?”
从零搭建:步骤演示与截图
步骤1:创建Notion数据库
小李创建了“文献库”数据库,字段包括:标题、摘要、主题(多选)、来源、日期、状态。
步骤2:设置自动化脚本
他编写了一个Python脚本,监听“收件箱”数据库的新条目。当有新文献加入时,脚本自动:
- 提取PDF/网页文本。
- 调用ChatGPT生成摘要和主题标签。
- 将结果写回数据库,并将状态改为“已处理”。
步骤3:配置智能问答
小李使用Notion API + ChatGPT构建了一个简单的问答脚本。他在终端运行python ask.py "数字鸿沟的研究进展",系统返回知识库中相关的笔记摘要和原文链接。
步骤4:日常使用
每天花15分钟处理“收件箱”中的新条目,每周日花30分钟回顾“重点”状态的文献,每月调整一次标签体系。
效果展示:知识库的日常使用与收益
三个月后,小李的知识库已有500+篇文献和笔记。他明显感受到:
- 检索效率提升:写综述时,输入关键词即可获取所有相关材料,节省大量翻找时间。
- 记忆负担减轻:AI生成的摘要让他快速回忆文献核心,无需重读原文。
- 新发现涌现:通过标签关联,他发现了一些跨主题的联系,启发了新的研究思路。
常见问题与解决方案
API调用频率限制与错误处理
OpenAI API有速率限制(Rate Limit),超出后会返回429错误。此外,账户配额耗尽(insufficient_quota)也可能触发 429 错误,两者需区分排查。解决方案:
- 在代码中加入重试机制,使用
tenacity库或手动实现指数退避。 - 批量处理时增加
time.sleep()间隔。 - 合理规划任务,避免短时间高并发请求。
import time
from tenacity import retry, stop_after_attempt, wait_exponential

@retry(stop=stop_after_attempt(3), wait=wait_exponential(multiplier=1, min=2, max=10))
def call_api_with_retry(**kwargs):
    return client.chat.completions.create(**kwargs)
Notion数据库性能优化
当数据库条目超过数千条时,可能出现加载缓慢。优化建议:
- 合理使用视图:避免在表格视图中加载全部列,使用筛选器缩小范围。
- 归档旧数据:将超过一年的数据移入“归档”数据库。
- 避免过多的关系属性:关系属性会拖慢性能,仅在必要时使用。
数据安全与隐私保护
- 敏感内容不上传:不要将密码、身份证号等机密信息存入云端知识库。
- API密钥管理:使用环境变量或密钥管理服务,不要硬编码。
- 定期备份:Notion支持导出为Markdown/CSV,建议每月备份一次。
结语:打造你的第二大脑
回顾全文,我们从“为什么需要智能知识库”出发,完成了工具准备、环境搭建、核心流水线构建,再到进阶技巧和实战案例,一步步实现了从零到一的跨越。
核心要点总结:
- 工具组合:ChatGPT负责智能处理,Notion负责结构化存储,两者互补。
- 核心流程:采集(多渠道捕获)→ 处理(AI摘要与打标)→ 存储(Notion数据库)。
- 进阶方向:RAG问答系统、自动化标签、定期回顾机制。
- 关键思维:知识库不是“存储箱”,而是“思考伙伴”,需要持续维护和迭代。
鼓励实践:从小处开始,逐步迭代
不必追求一步到位。你可以先手动使用ChatGPT处理几篇文章,感受效果;再逐步引入API自动化;最后尝试搭建问答系统。最重要的是开始行动,并在实践中不断调整。
展望未来:AI与知识管理的趋势
随着大模型能力的提升和成本的下降,我们可以预见:
- 更智能的检索:语义搜索将取代关键词匹配。
- 主动式知识管理:AI不仅回答问题,还会主动提醒你“某篇新文章与你正在写的综述相关”。
- 多模态知识库:图片、音频、视频都将被纳入统一的知识体系。
你的“第二大脑”正在等待被唤醒。现在,就动手创建你的第一个智能知识库吧!
行动清单: - [ ] 注册Notion账号,创建“我的知识库”主页 - [ ] 获取OpenAI API密钥,设置环境变量 - [ ] 创建数据库,设计字段和视图 - [ ] 运行示例脚本,测试自动摘要功能 - [ ] 收集5篇你感兴趣的文章,走通全流程
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号