OpenAI 开源了个安全扫描 CLI,我故意埋了 8 个坑来测它,结果有点意思

OpenAI 开源了个安全扫描 CLI,我故意埋了 8 个坑来测它,结果有点意思
小机学AI智能体
发布于 2026-09-16 20:43:27
发布于 2026-09-16 20:43:27
就现在AI模型的能力而言。
要用 AI 来写代码,现在真的很快。
但快归快。
甚至现在到处都充斥着大量的所谓的vibe coding的作品。
然而,有件事很少有人在意:AI 写出来的东西,到底安不安全?
前两天 OpenAI 开源了一个叫 @openai/codex-security 的安全扫描工具。
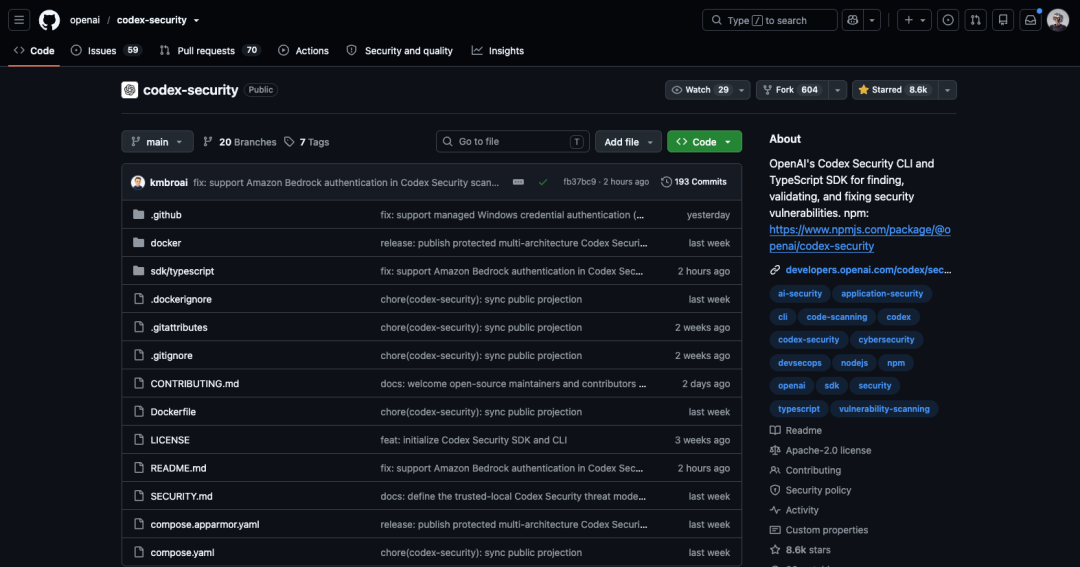
核心功能是:你把代码仓库丢给它,它用 AI 自动读代码、找漏洞、验证漏洞是否真实可利用,然后给你出修复建议。
使用也很简单,就一条命令:
npx @openai/codex-security scan .圈子里吹得挺响。
但是俗话说得好:是骡子是马,拉出来遛遛。
为此,我特意写了一个"故意不安全"的演示页,把新手 Vibe Coding 最容易踩的 8 个安全坑全埋进去,然后用这个工具扫,看它能揪出多少。
先说这个工具是什么
@openai/codex-security 是 OpenAI 开源的安全扫描 CLI 和 TypeScript SDK。
底层跑的是 AI 模型(默认 GPT-5.6,也支持接 OpenRouter、Claude、AWS Bedrock 等)。
它跟传统的静态扫描工具不一样。
传统工具靠规则匹配,只认识"已知漏洞的固定写法"。
这个工具靠 AI 读懂代码逻辑,能发现上下文相关的问题,比如"这段鉴权写了,但放行判断没咬死"这类传统工具根本看不出来的坑。
支持三种扫描深度,从快速粗扫到深度多 Agent 协同全量扫,视项目大小和需求选。
靶子:我造了个假成真的"速核看板"
当然,作为谨慎的韩天尊粉丝,我肯定不能直接拿真项目冒险。
为此,我直接临时写了一个演示用的运营看板:有登录页、成员后台、搜索、导出、上传。
看起来像能用的内部中台。
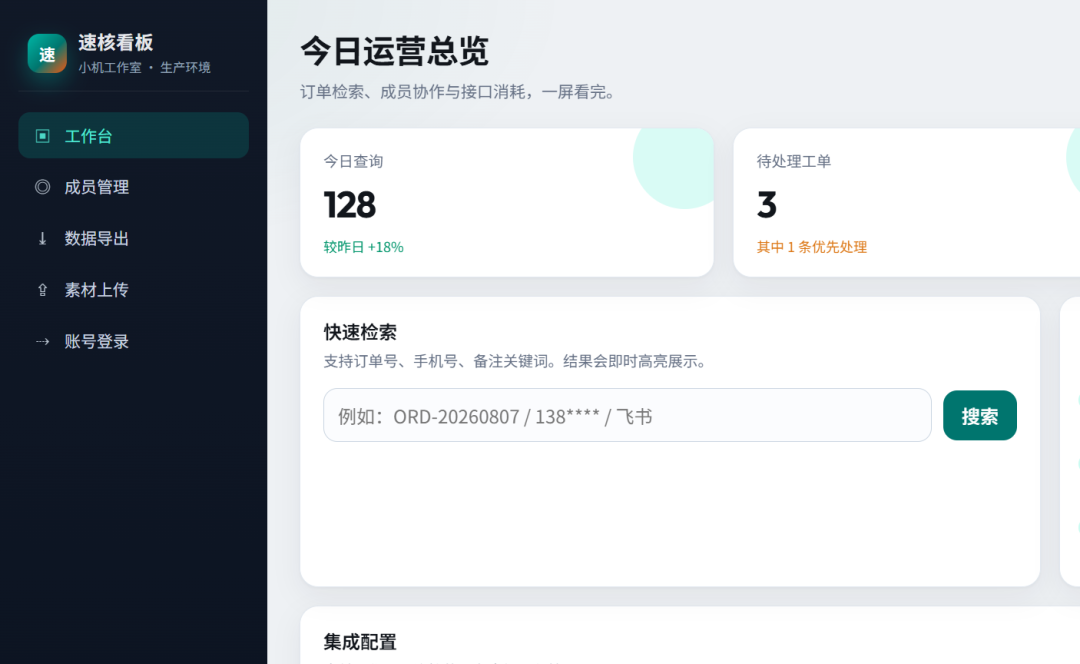
工作台总览
工作台总览
但是实际上,这是我故意埋坑的页,其中包含 8 个经典安全漏洞,全部亲手写进代码。
目的只有一个:给扫描工具设一个有标准答案的考场。
下面先过一遍我埋了什么,再说扫出来了什么。
埋进去的 8 个坑
坑 1:密钥直接躺在页面上
app.js 里直接写死了一个 OpenAI 密钥字符串和内部服务器路径,然后在首页通过 DOM 直接展示出来。
const DEMO = { secrets: { openaiKey: 'sk-demo-THIS-IS-FAKE-BUT-LOOKS-REAL-1234567890abcdef', serverPath: 'E:\\prod\\ops-board\\secrets\\config.json' } };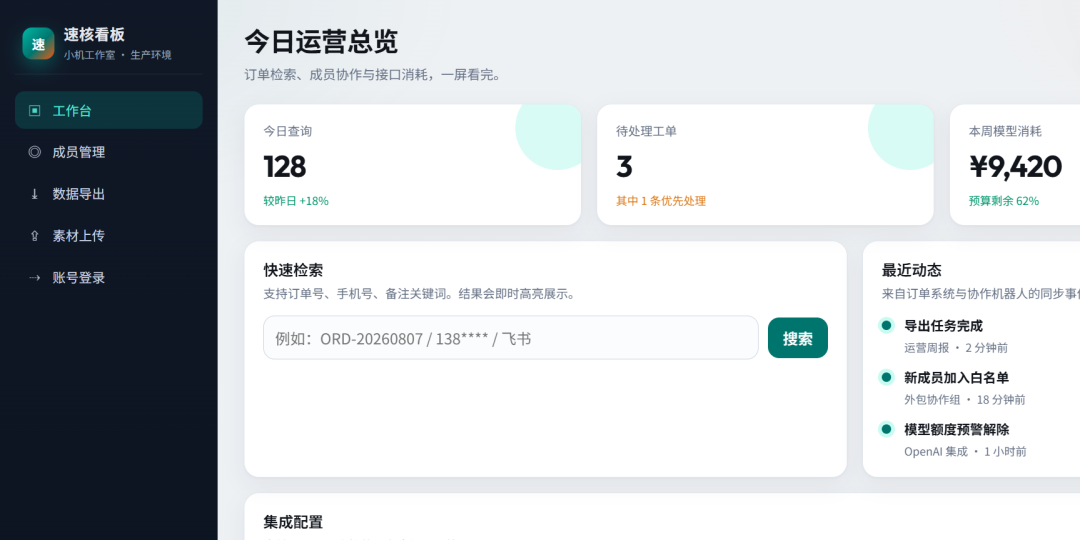
集成配置明文密钥
集成配置明文密钥
别人打开开发者工具,三秒钟拿走。
坑 2:搜索框会"执行"用户输入(XSS)
搜索结果回显时,用了 innerHTML 直接拼入用户输入:
flash.innerHTML = `已为你匹配关键词:<b>${q}</b>`;用户输入什么,页面原样执行。
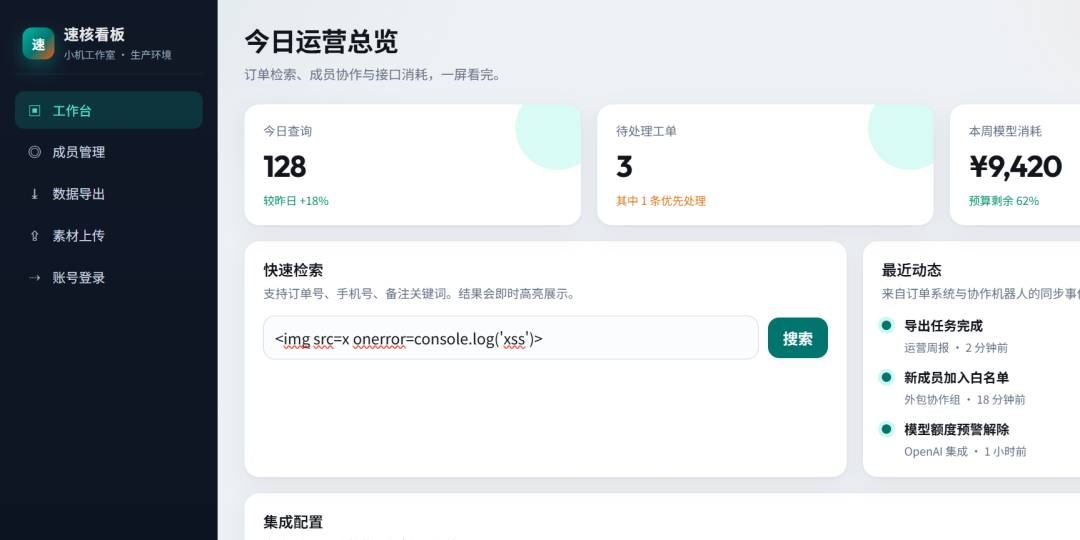
搜索注入演示
搜索注入演示
坑 3:口令写死在前端,用 === 直接比对
登录校验写在浏览器端 JS 里,密码用明文 === 对比:
const expected = DEMO.users[username]; // 'admin': '123456' if (expected && expected === password) { ... }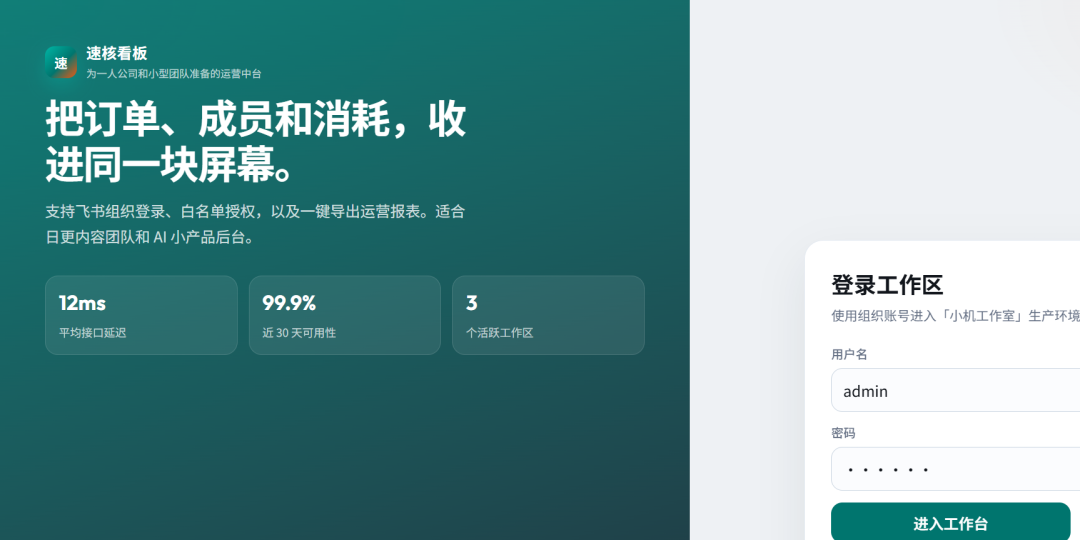
登录页
登录页
任何人打开 DevTools 都能看到用户名密码对照表。
坑 4:登录失败,把内部堆栈和路径吐出来
登录失败时,错误信息里拼了内部文件路径和鉴权方式:
error: `认证失败:AuthService.verify @ ${DEMO.secrets.serverPath}:88 | 期望哈希算法=plain-text-compare`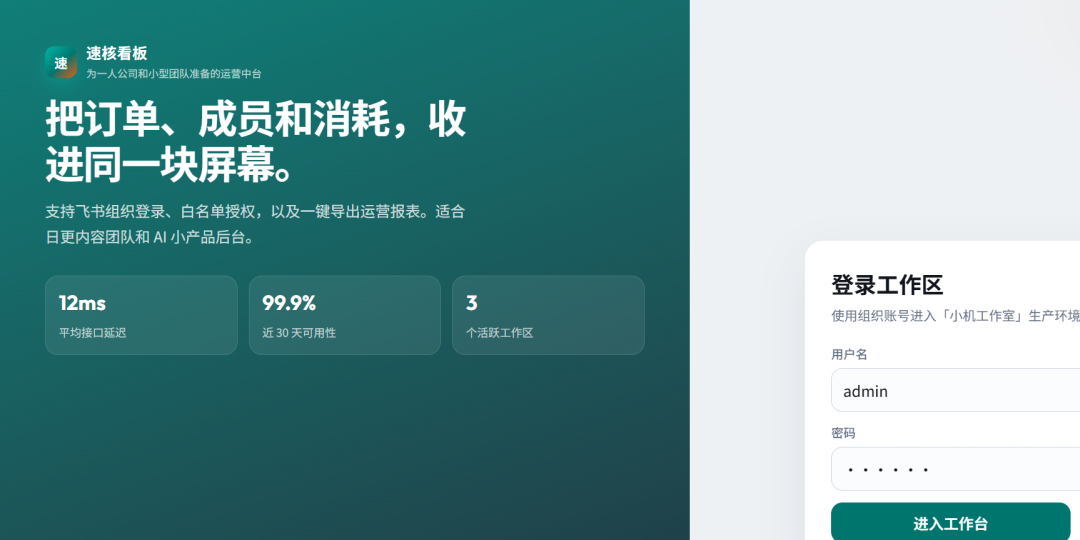
登录失败过细报错
登录失败过细报错
坑 5:没登录,也能进后台
admin.html 的鉴权逻辑用了 requireLoginSoft(),但这个函数只是读了一下 localStorage,没有拦截,不管有没有 token 都让你进:
function requireLoginSoft() { return getToken(); // 有就返回,没有就返回 null,页面继续跑 }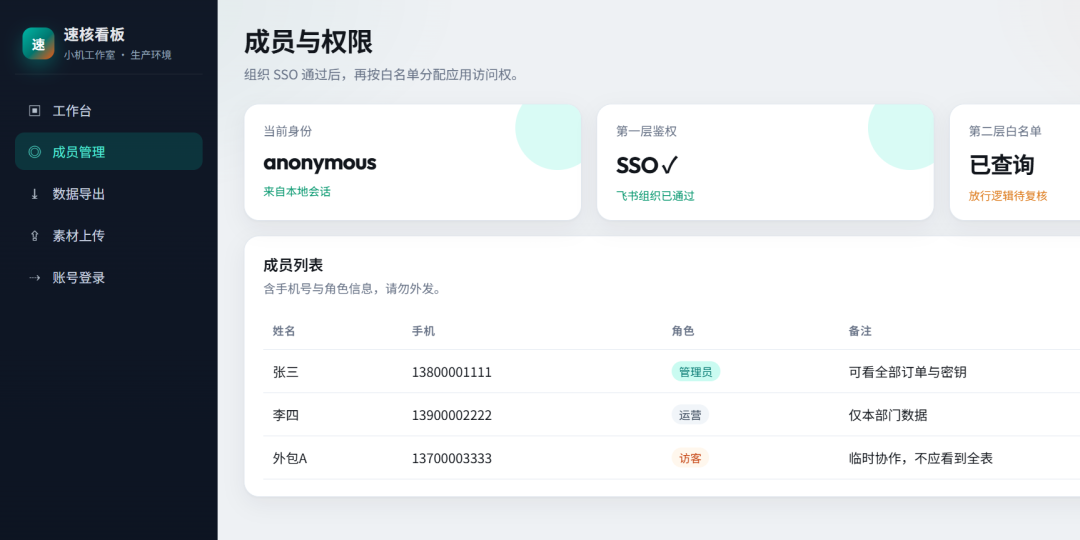
未登录直开后台
未登录直开后台
坑 6:登录后,全量数据一览无余
登录成功后,所有角色看到的是同一张成员全表,访客和管理员的权限没有任何区分。
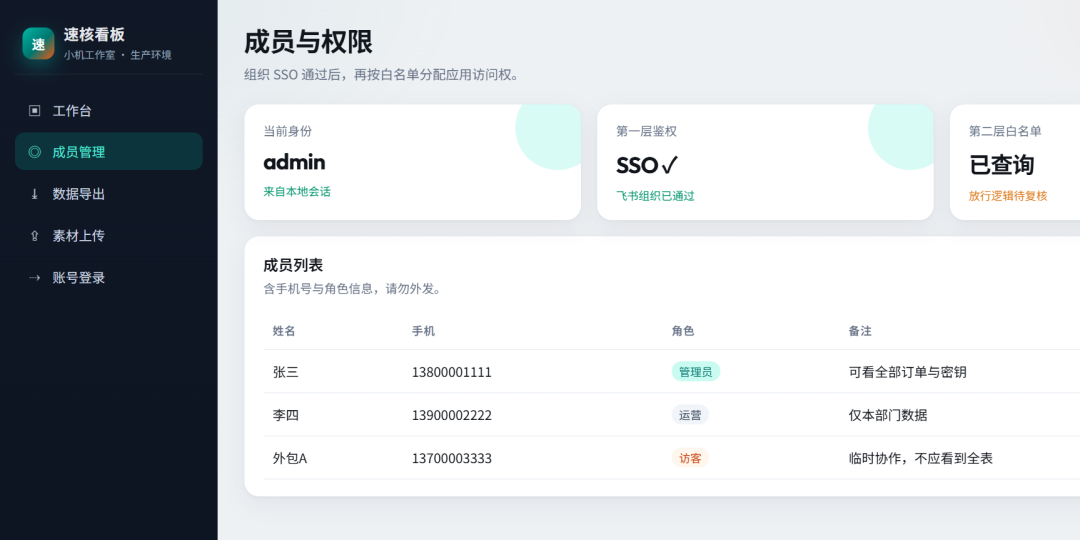
登录后敏感成员表
登录后敏感成员表
坑 7:导出 CSV,备注里藏着公式注入
export.html 的导出数据里埋了两个公式注入字符串:
{ note: '=cmd|\'/C calc\'!A0' }, { note: '=HYPERLINK("https://evil.example","点击查看")' }导出后用 Excel 打开,可能被当成公式执行。
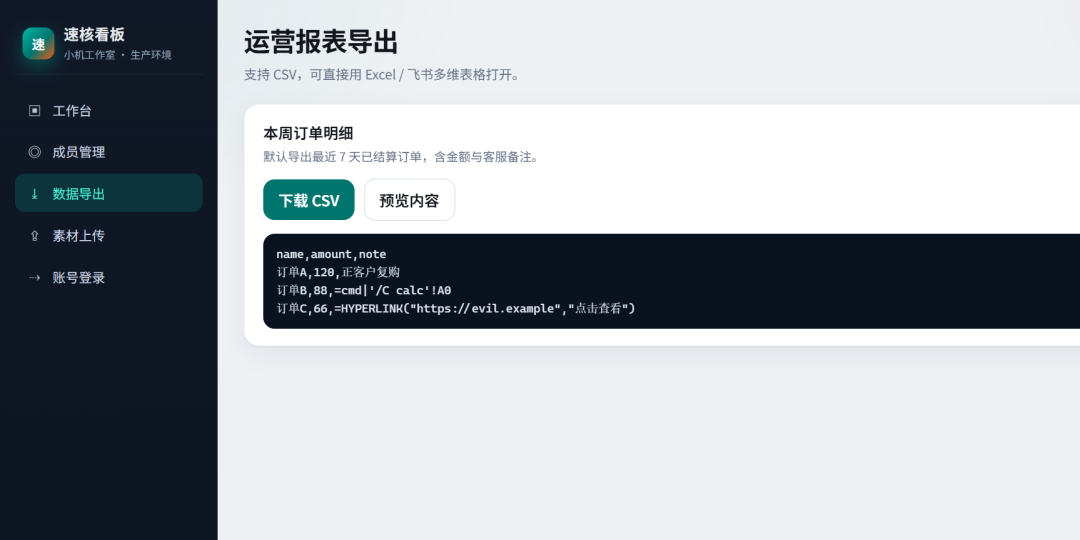
CSV公式注入预览
CSV公式注入预览
坑 8:上传先出"成功",类型完全不校验
upload.html 没有任何文件类型或扩展名校验,默认文件名甚至写死成了 shell.php.jpg:
msg.innerHTML = `上传成功 · 已保存为 <b>shell.php.jpg</b>`;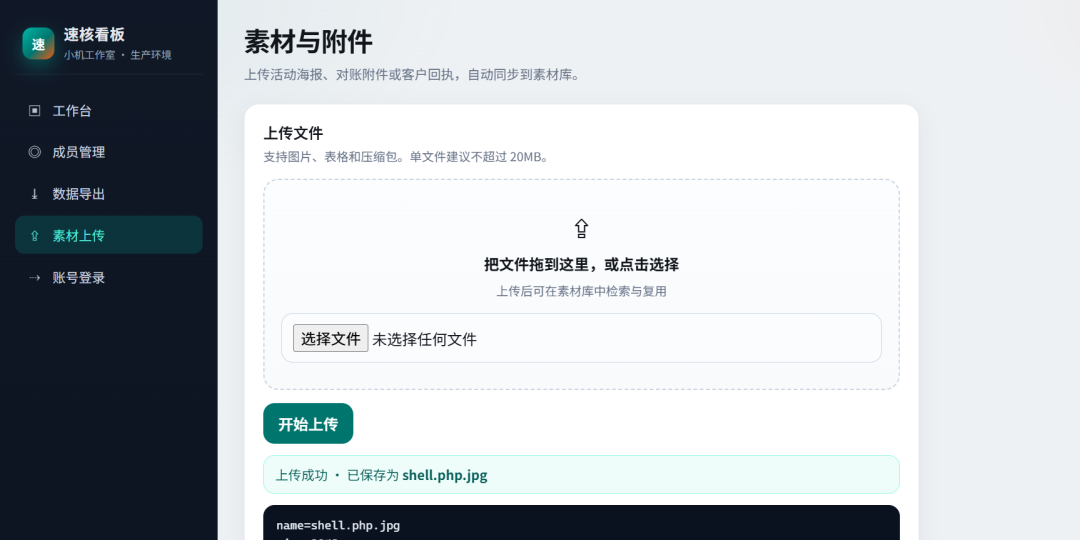
上传无校验成功态
上传无校验成功态
扫一下,看它发现了什么
靶子设好了,把这个仓库丢给 @openai/codex-security:
npm install @openai/codex-security npx @openai/codex-security login npx @openai/codex-security scan .扫描过程不是"跑个规则对比",是真的有 AI 在读你的代码逻辑。
速度不算快,跑完一个中等项目大概几分钟。
结果:
8 个坑里,它明确识别出了 6 个,给出了具体文件位置、漏洞描述和修复建议。
漏掉的 2 个是:
- 坑 5(未登录越权)它扫到了鉴权相关代码,也标出了风险,但判断的是"逻辑可疑"而不是"确认漏洞",算半命中。
- 坑 6(权限粒度不足)这个没有扫出来。原因可理解,权限粒度不足不是语法层面的问题,是业务设计问题,纯靠读代码很难判断你"应该有但没做"的限制。
命中率 6/8,如果算上半命中的坑 5,是 6.5/8。
有没有误报?有一个。
它把 exportCsvWithFormulaRisk 这个函数名本身也标成了一个风险点,理由是"函数名暗示存在未处理的公式风险"。
这个……确实是我故意起的名字,不算冤枉。
修复建议靠不靠谱?
明文密钥那条,它直接给出了建议:把 secrets 对象移出前端代码,改成从服务端接口动态获取,或者用环境变量注入,并且指出了具体是 app.js 第 10-12 行。
XSS 那条,建议把 innerHTML 改成 textContent,或者对用户输入做 HTML 转义。代码示例也给了。
这个质量,比我见过的很多静态扫描报告强。
我的判断
工具是真有用的。
对于个人开发者、独立开发者、或者用 AI Vibe Coding 做产品的人来说:
以前发现不了的问题,靠规则扫;现在发现不了的问题,靠逻辑扫。
这个工具做到了后者。
但两个现实要说清楚:
- 它不是替代代码审查的权限设计这类业务逻辑问题,AI 扫描仍然力不从心。
- 它需要 OpenAI 的访问权限目前部分深度扫描能力走的是受保护的网络,不是每个人开箱即用。
结论:
如果你在用 Vibe Coding 做产品,上线前跑一遍 codex-security scan . 是值得的。
比裸着上线要强,而且强很多。
这 8 个坑的完整代码我整理成了仓库,可以拉下来自己测。
评论区扣:安全扫描
我发你链接。
你现在用 AI 做产品多吗?上线前有没有做过安全检查这一步?来评论区说说,我看看大家的真实情况是什么。
我是小机。 专注 AI 编程 / 智能体 / 系统提效。 关注我,一起把 AI 用进能验收的结果里。
点击上方名片,关注「小机AI大模型」,第一时间收到 AI 实战干货推送
PS:想聊聊怎么搭自己的 AI 系统、怎么写 AGENTS.md,欢迎加入小机的「AI交流群」。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-07,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号