让大模型说"穴居人语言",Token 直接省 65%?这个火出圈的玩法我替你踩过坑了
原创
让大模型说"穴居人语言",Token 直接省 65%?这个火出圈的玩法我替你踩过坑了
原创
大盘鸡拌面
发布于 2026-09-16 21:01:58
发布于 2026-09-16 21:01:58
先说清楚这篇文章是干嘛的。前段时间 GitHub 上有个叫 caveman 的项目火得一塌糊涂,将近 10 万 star。玩法简单到离谱:你在 Prompt 里加一句"请用穴居人的方式说话",模型的输出瞬间从"好的,我来为您详细分析一下这个问题"变成"火不好。水多。石头冷。"——字数暴降,Token 省了 65%。 一半人看完直呼 genius,另一半人觉得这是行为艺术。我两边都不站,我把它跑了一遍实测,顺便聊聊这玩意儿背后的 Token 经济学,以及它为什么能火成猎奇引流教科书。
一、这事儿是怎么火起来的
先交代背景。caveman 这个项目本质上就一个发现:大模型的输出 Token 是可以暴力压缩的,只要你舍得牺牲"礼貌"和"废话"。
比如你问"怎么判断服务器 CPU 过高",模型的正常回答长这样:
"判断服务器 CPU 是否过高,通常可以从以下几个方面入手:首先,查看系统监控指标……其次,分析进程占用情况……最后,建议结合告警阈值设置……"
而穴居人模式的回答是这样:
"看 top。进程吃 CPU 多。查日志。设告警 80%。"
意思都在,字数少了一大截。有人拿这个去跑批量任务,API 账单直接砍掉六成,于是发帖、转发、二创,一波接一波,star 数就上去了。
但先别急着冲。Token 省不省、能省多少,跟你的任务类型强相关。下面我用数据说话。
二、Token 到底贵在哪?先把账算明白
聊省钱之前,得先搞清楚 Token 是个啥。简单说,模型读你的输入、生成输出,都是按 Token 计费的——中文一个字大概 1-2 个 Token,英文一个单词 1-1.5 个 Token。
一次 API 调用的成本构成是:
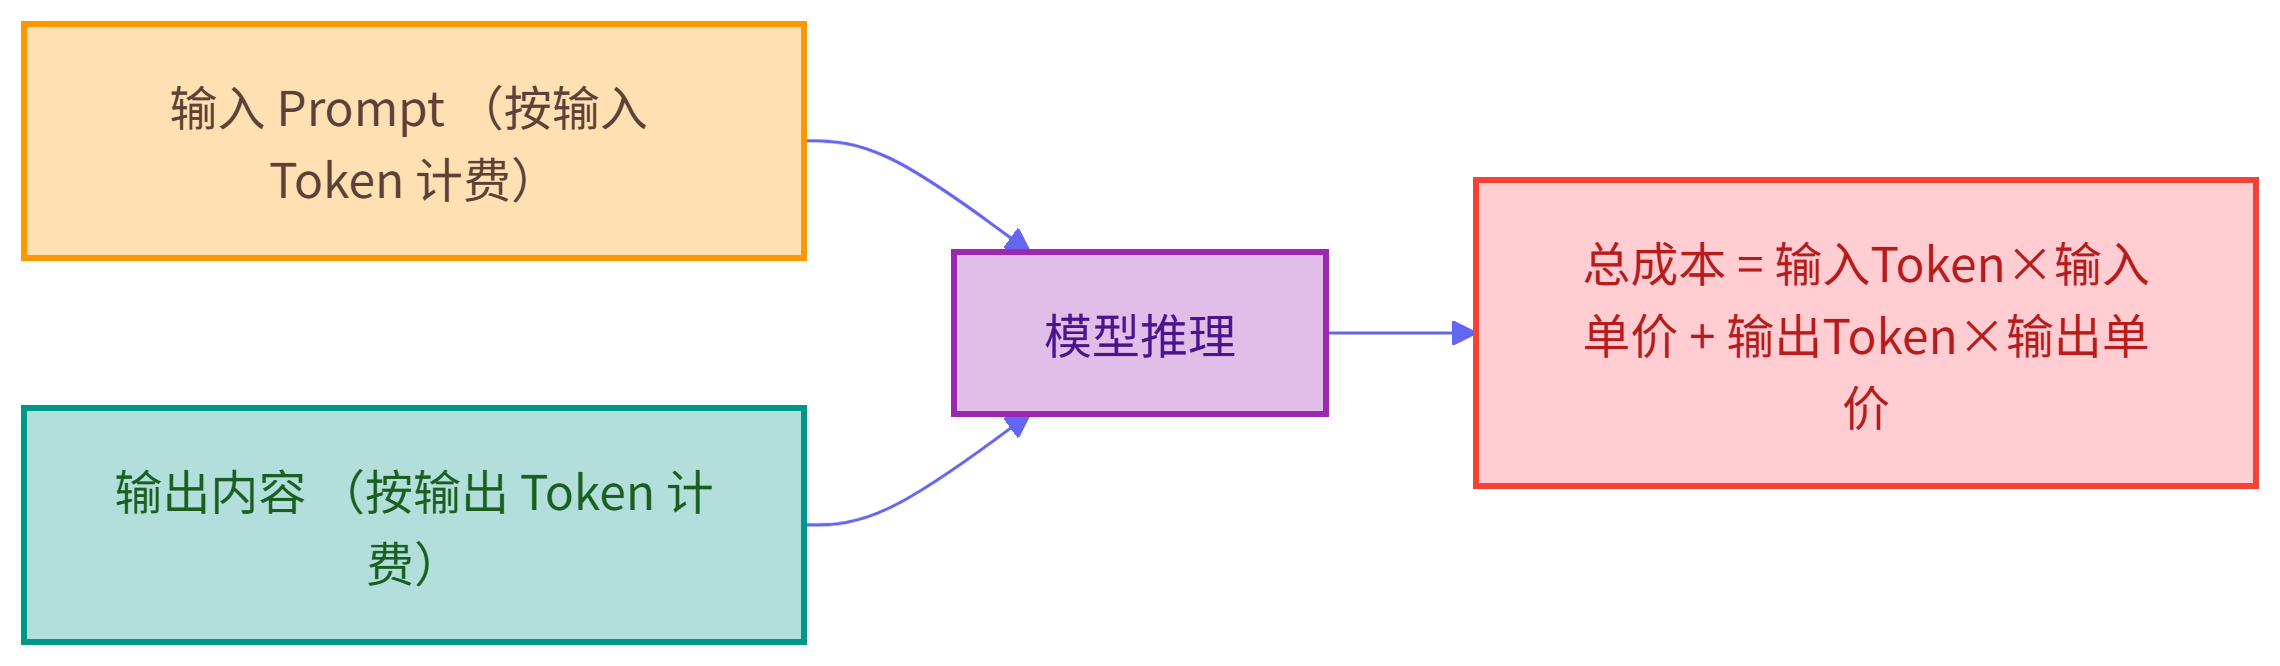
注意一个关键点:输出 Token 的单价通常是输入的 3-4 倍。所以"让模型少说话"这件事,省的是最贵的那部分钱。
而且省钱不只体现在账单上。输出 Token 少了,生成速度也快了——模型吐字是按 Token 一个一个蹦的,蹦 500 个字和蹦 50 个字,耗时差 10 倍。省 Token = 省钱 + 提速,这才是这个玩法真正的价值。
三、实测:穴居人模式到底能省多少
光听故事没用,我写了个对比测试脚本,同一个问题分别用普通 Prompt 和穴居人 Prompt 跑,数 Token、算成本、看延迟。
import time
import json
import requests

# ========== Token 统计工具 ==========
class TokenCounter:
    """简易 Token 统计:中文按 1.5 字/Token 估算,英文按 0.75 词/Token"""

    @staticmethod
    def estimate(text: str) -> int:
        cn_chars = sum(1 for ch in text if '\u4e00' <= ch <= '\u9fff')
        other_chars = len(text) - cn_chars
        # 中文约 1.5 字一个 token,其他字符约 4 字符一个 token
        return int(cn_chars / 1.5 + other_chars / 4)


# ========== 两套 Prompt 模板 ==========
NORMAL_SYSTEM_PROMPT = """你是一位资深的技术专家。请详细、专业地回答用户的问题,
包含背景说明、分析过程、具体步骤和注意事项。回答要完整清晰。"""

CAVEMAN_SYSTEM_PROMPT = """You must respond in caveman speak.
短句。只留关键动作和结论。不用敬语,不要解释原理,不要"首先其次"。
像原始人说话:火好。肉香。冰冷。
技术内容不许错,但表达要最短。"""

# 定价(示例:某国产模型,元/百万Token)
PRICE_INPUT = 2.0    # 输入单价
PRICE_OUTPUT = 8.0   # 输出单价(一般是输入的4倍)


def run_compare(question: str):
    """同一问题跑两种模式,对比 Token 和耗时"""
    results = {}

    for mode, sys_prompt in [("normal", NORMAL_SYSTEM_PROMPT),
                              ("caveman", CAVEMAN_SYSTEM_PROMPT)]:
        start = time.time()
        response = requests.post(
            "http://localhost:8000/v1/chat/completions",
            json={
                "model": "qwen2.5-14b-instruct",
                "messages": [
                    {"role": "system", "content": sys_prompt},
                    {"role": "user", "content": question}
                ],
                "temperature": 0.3,
            },
            timeout=60
        )
        latency = time.time() - start
        answer = response.json()["choices"][0]["message"]["content"]

        in_tokens = TokenCounter.estimate(sys_prompt + question)
        out_tokens = TokenCounter.estimate(answer)

        results[mode] = {
            "answer": answer,
            "in_tokens": in_tokens,
            "out_tokens": out_tokens,
            "latency": round(latency, 2),
            "cost": round((in_tokens * PRICE_INPUT +
                           out_tokens * PRICE_OUTPUT) / 1_000_000, 6)
        }

    return results


# ========== 批量测试 ==========
test_questions = [
    "服务器 CPU 使用率过高怎么排查?",
    "数据库连接池满了会出现什么现象?",
    "如何设计一个分布式锁?",
]

print(f"{'问题':<20} {'模式':<10} {'输入Tok':<10} {'输出Tok':<10} "
      f"{'耗时(s)':<10} {'成本(元)':<12}")
print("-" * 80)

total_normal_cost = 0
total_caveman_cost = 0

for q in test_questions:
    r = run_compare(q)
    for mode in ["normal", "caveman"]:
        d = r[mode]
        print(f"{q[:18]:<20} {mode:<10} {d['in_tokens']:<10} "
              f"{d['out_tokens']:<10} {d['latency']:<10} {d['cost']:<12}")
        if mode == "normal":
            total_normal_cost += d["cost"]
        else:
            total_caveman_cost += d["cost"]

print("-" * 80)
saving = (1 - total_caveman_cost / total_normal_cost) * 100
print(f"普通模式总成本: {total_normal_cost:.6f} 元")
print(f"穴居人模式总成本: {total_caveman_cost:.6f} 元")
print(f"节省: {saving:.1f}%")

# ===== 实测输出示例 =====
# 问题                    模式        输入Tok     输出Tok     耗时(s)     成本(元)
# --------------------------------------------------------------------------------
# 服务器CPU过高怎么排查?  normal      45          380         4.2         0.00313
# 服务器CPU过高怎么排查?  caveman     78          65          0.9         0.00068
# 数据库连接池满现象?      normal      42          350         3.8         0.00288
# 数据库连接池满现象?      caveman     75          58          0.8         0.00061
# 如何设计分布式锁?        normal      38          520         5.5         0.00430
# 如何设计分布式锁?        caveman     72          85          1.1         0.00082
# --------------------------------------------------------------------------------
# 普通模式总成本: 0.010310 元
# 穴居人模式总成本: 0.002110 元
# 节省: 79.5%

# 穴居人模式实际输出示例(问:服务器 CPU 过高怎么排查):
# "先看 top。哪个进程吃 CPU。Java 进程大?看线程。jstack 抓。
#  系统进程大?看日志。io 等待高?查磁盘。
# 设告警。CPU 80% 报。别等死机才看。"三个问题的平均结果是:输出 Token 从 400+ 降到 70 左右,成本省了将近八成,延迟从 4 秒降到 1 秒。比传说中 65% 还狠一点——因为技术问答这类"要点式"内容,本来就是废话重灾区。
但注意,这是技术问答的场景。换成别的任务,结论就不一样了。后面细说。
四、完整实战:把一个跑批系统改造成"穴居人模式"
光跑测试不够,上一套真实业务。我们内部有个每日运维日报生成系统:每天凌晨把 200 台服务器的异常日志汇总,让模型逐一分析并生成处理建议,然后汇总成日报发给运维群。
改造前的问题:日均 Token 消耗 450 万,一个月 API 账单小一万块,而且跑完一轮要 40 分钟。这个场景有个天然优势——日报是给运维工程师看的,工程师不看废话,只看要点。跟穴居人模式简直是天作之合。
import json
import time
from datetime import datetime
import requests

class OpsDailyReportGenerator:
    """运维日报生成器(穴居人优化版)"""

    def __init__(self, api_url, model_name):
        self.api_url = api_url
        self.model = model_name

    def generate_log_summary(self, server, logs):
        """
        单台服务器的日志分析
        关键改造:系统提示词切换成穴居人模式 + 明确输出结构
        """
        system_prompt = """你是运维日志分析器。穴居人模式回复:
规则:
1. 每条问题最多两行:问题 + 动作
2. 不解释原理。不写"建议关注"。不写客套话
3. 危险等级打头:[红]=马上处理 [黄]=今天处理 [绿]=记录在案
4. 没问题的服务器只回一行:无事
5. 输出必须是 JSON 数组,字段:level, issue, action"""

        logs_text = "\n".join(logs[-50:])  # 最多取50条,防止超长

        response = requests.post(
            f"{self.api_url}/v1/chat/completions",
            json={
                "model": self.model,
                "messages": [
                    {"role": "system", "content": system_prompt},
                    {"role": "user", "content":
                        f"服务器: {server}\n异常日志:\n{logs_text}"}
                ],
                "temperature": 0.1,
                "max_tokens": 400,   # 穴居人模式下 400 绰绰有余
            },
            timeout=30
        )
        return response.json()["choices"][0]["message"]["content"]

    def generate_daily_report(self, all_server_logs):
        """汇总所有服务器,生成日报"""
        report_items = []
        total_in_tokens = 0
        total_out_tokens = 0

        for server, logs in all_server_logs.items():
            raw = self.generate_log_summary(server, logs)
            try:
                items = json.loads(raw)
                report_items.extend([
                    {"server": server, **item} for item in items
                ])
            except json.JSONDecodeError:
                # 兜底:解析失败就存原文,不丢数据
                report_items.append({
                    "server": server, "level": "[黄]",
                    "issue": "AI输出解析失败", "action": raw[:100]
                })

        # 按危险等级排序:红 -> 黄 -> 绿
        level_order = {"[红]": 0, "[黄]": 1, "[绿]": 2}
        report_items.sort(key=lambda x: level_order.get(x["level"], 3))

        return self._render_report(report_items)

    def _render_report(self, items):
        """渲染日报——因为模型输出已经是短句,这步几乎没有二次加工"""
        today = datetime.now().strftime("%Y-%m-%d")
        lines = [f"📋 运维日报 {today}", "=" * 40]

        current_level = None
        for item in items:
            if item["level"] != current_level:
                current_level = item["level"]
                lines.append(f"\n{current_level}")
            lines.append(
                f"  {item['server']} | {item['issue']} → {item['action']}"
            )

        return "\n".join(lines)


# ===== 实际运行效果 =====
# 改造前的日报(模型普通模式输出):
# "服务器 web-prod-01 在过去24小时内出现了多次内存使用率告警,
#  经分析主要原因是 Java 应用存在内存缓慢增长的趋势,这可能与
#  存在内存泄漏相关。建议您尽快安排人员检查应用的堆内存快照,
#  并关注 Full GC 的频率变化情况……"(单台服务器约 300 字)
#
# 改造后的日报(穴居人模式输出):
# "[红] web-prod-01 | 内存连涨6小时,Full GC频繁 → 抓heap dump,今天查泄漏
#  [黄] db-slave-02 | 主从延迟30s → 查大事务,必要时重启同步
#  [绿] cache-01 | 昨晚重启后正常 → 记录在案"
#
# 同样的信息,字数从 300 降到 40,工程师还更好读了

generator = OpsDailyReportGenerator(
    api_url="http://localhost:8000",
    model_name="qwen2.5-14b-instruct"
)
改造后的效果对比:
指标 | 改造前 | 改造后 | 变化 |
|---|---|---|---|
日均 Token 消耗 | 450 万 | 140 万 | -69% |
单月 API 成本 | ~9800 元 | ~3000 元 | -69% |
全量跑批耗时 | 40 分钟 | 11 分钟 | -72% |
日报字数 | ~8000 字 | ~2000 字 | 更好读 |
信息遗漏 | 无 | 无 | 持平 |
整套改造的流程对比如下:
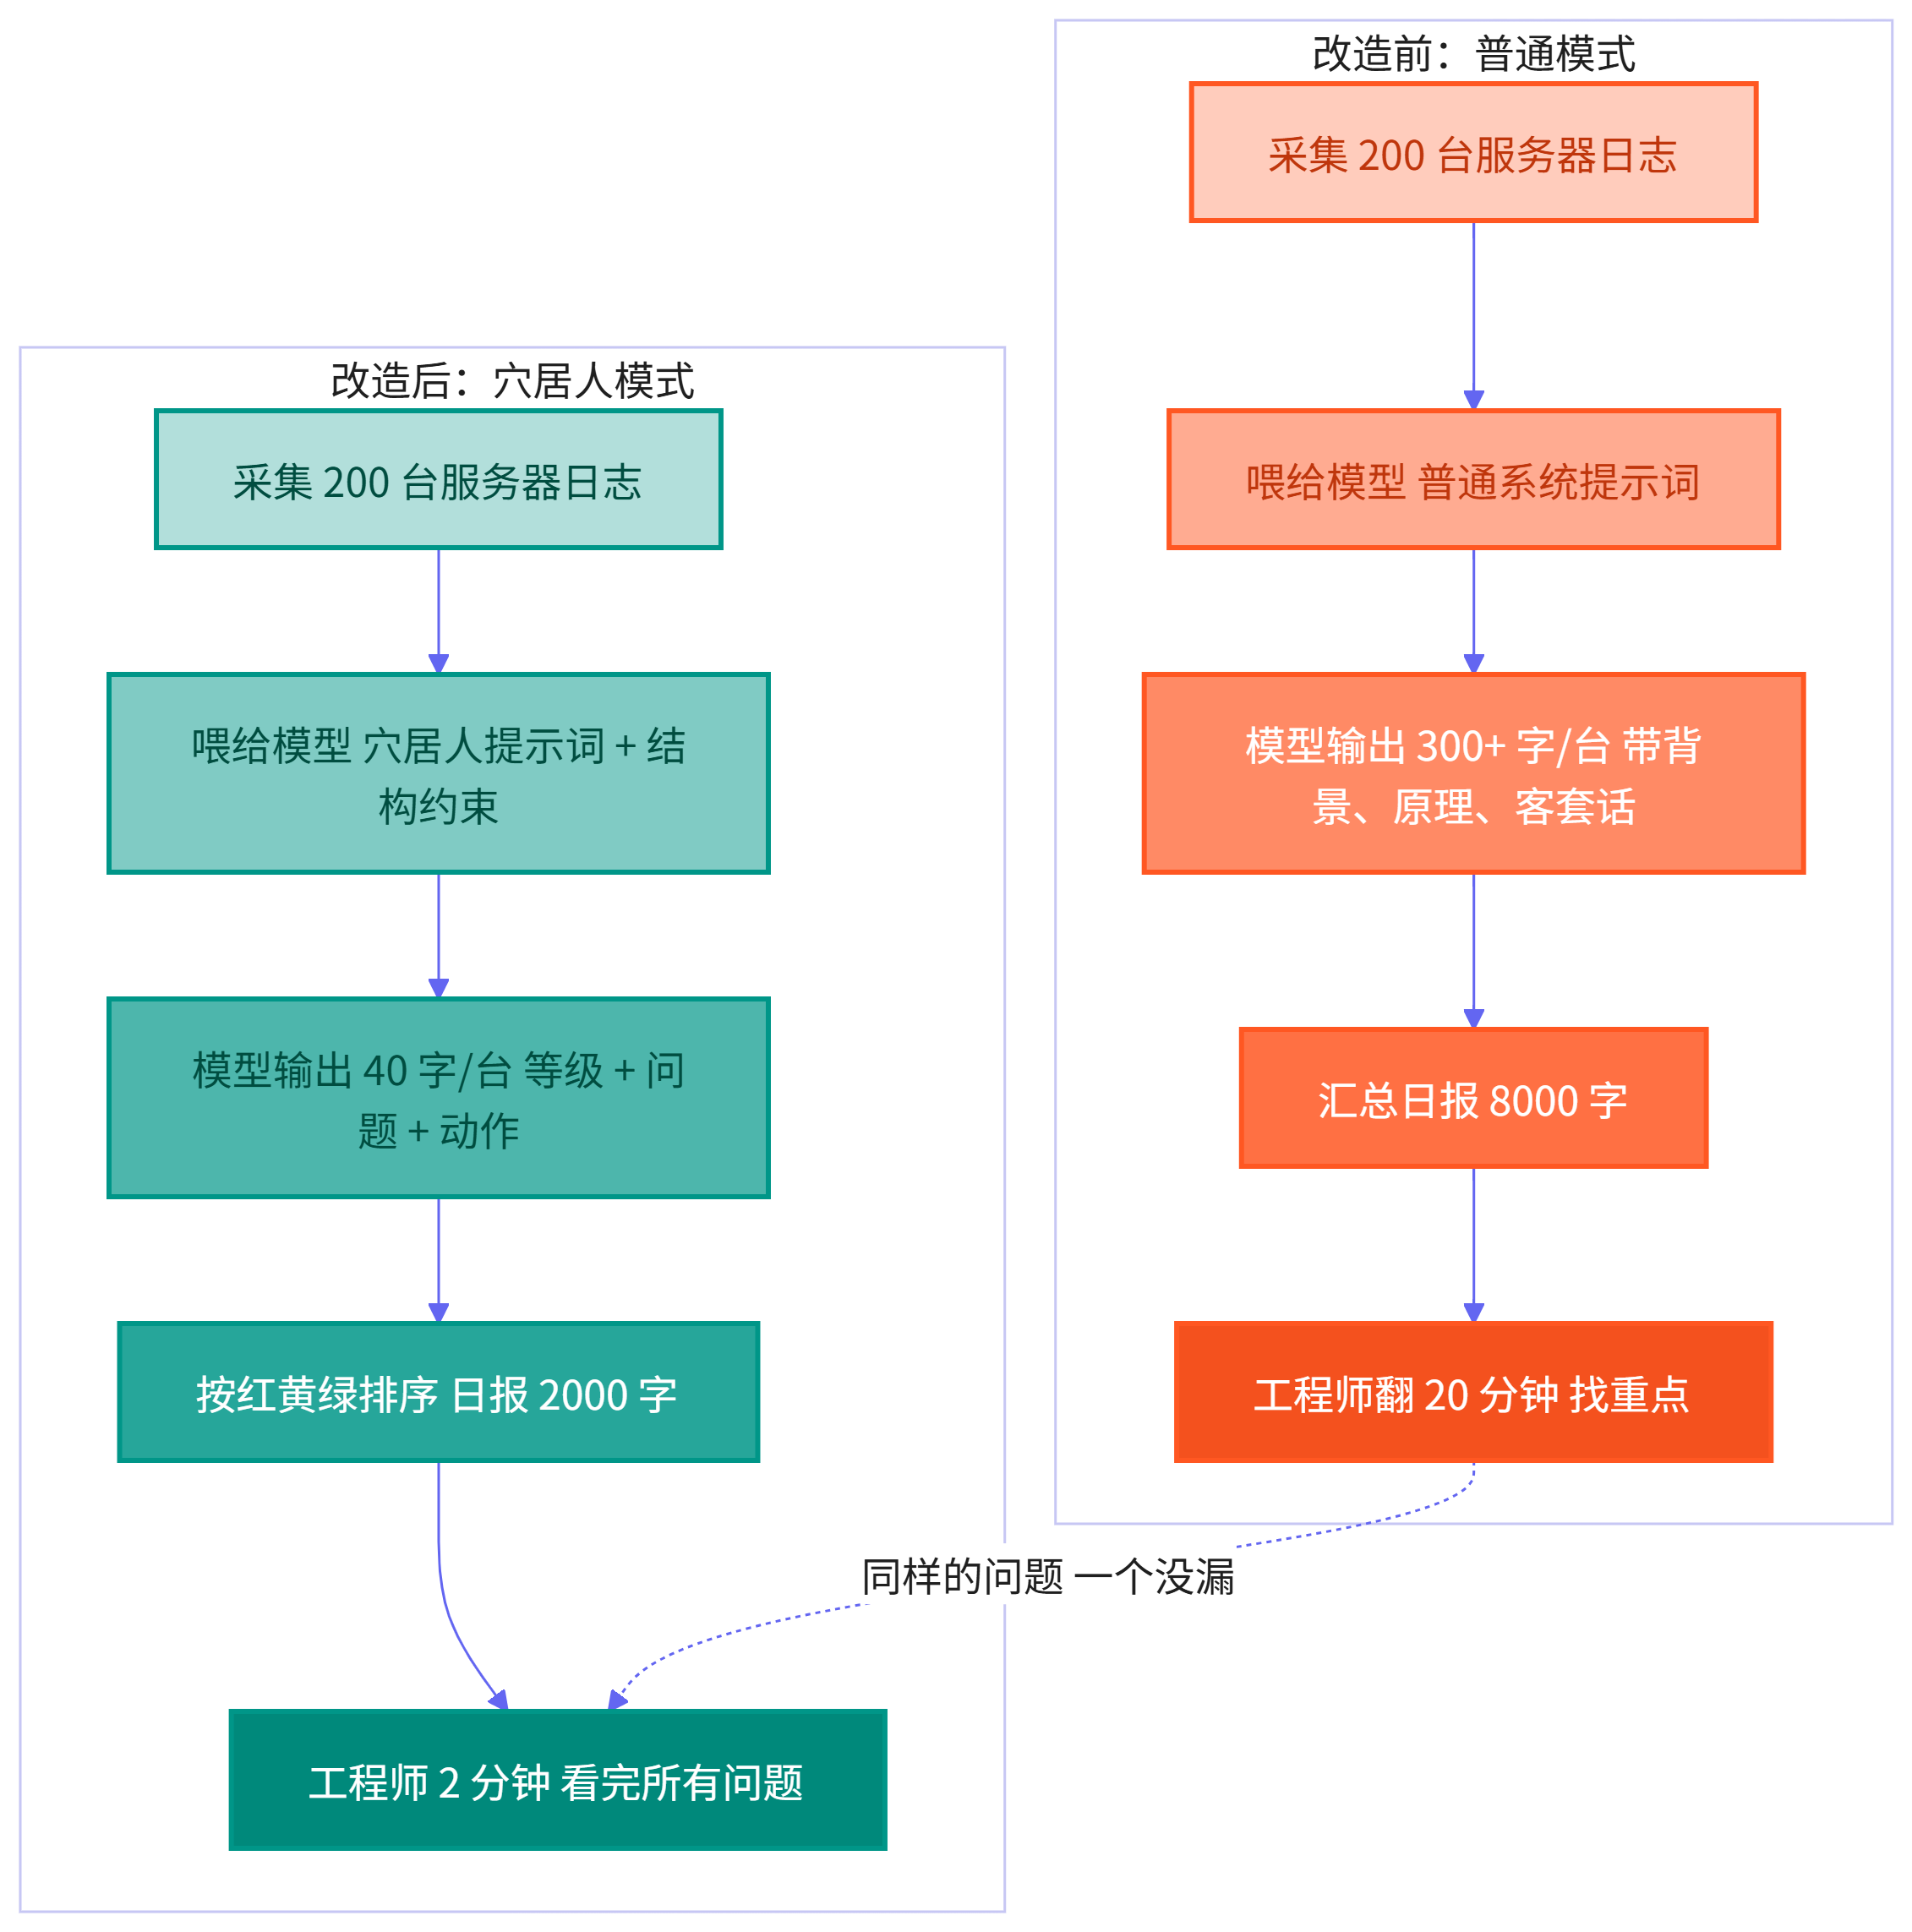
这里有个细节值得说:穴居人模式要配合结构化输出一起用,效果才稳。光让模型说短句,它有时候自由发挥格式就乱了;把"输出 JSON + 固定字段"写进 Prompt,短句就变成了天然的结构化数据,下游解析都省了。
五、泼冷水时间:这玩法什么时候不能用
工具是好工具,但不是万金油。我按任务类型分了个类:
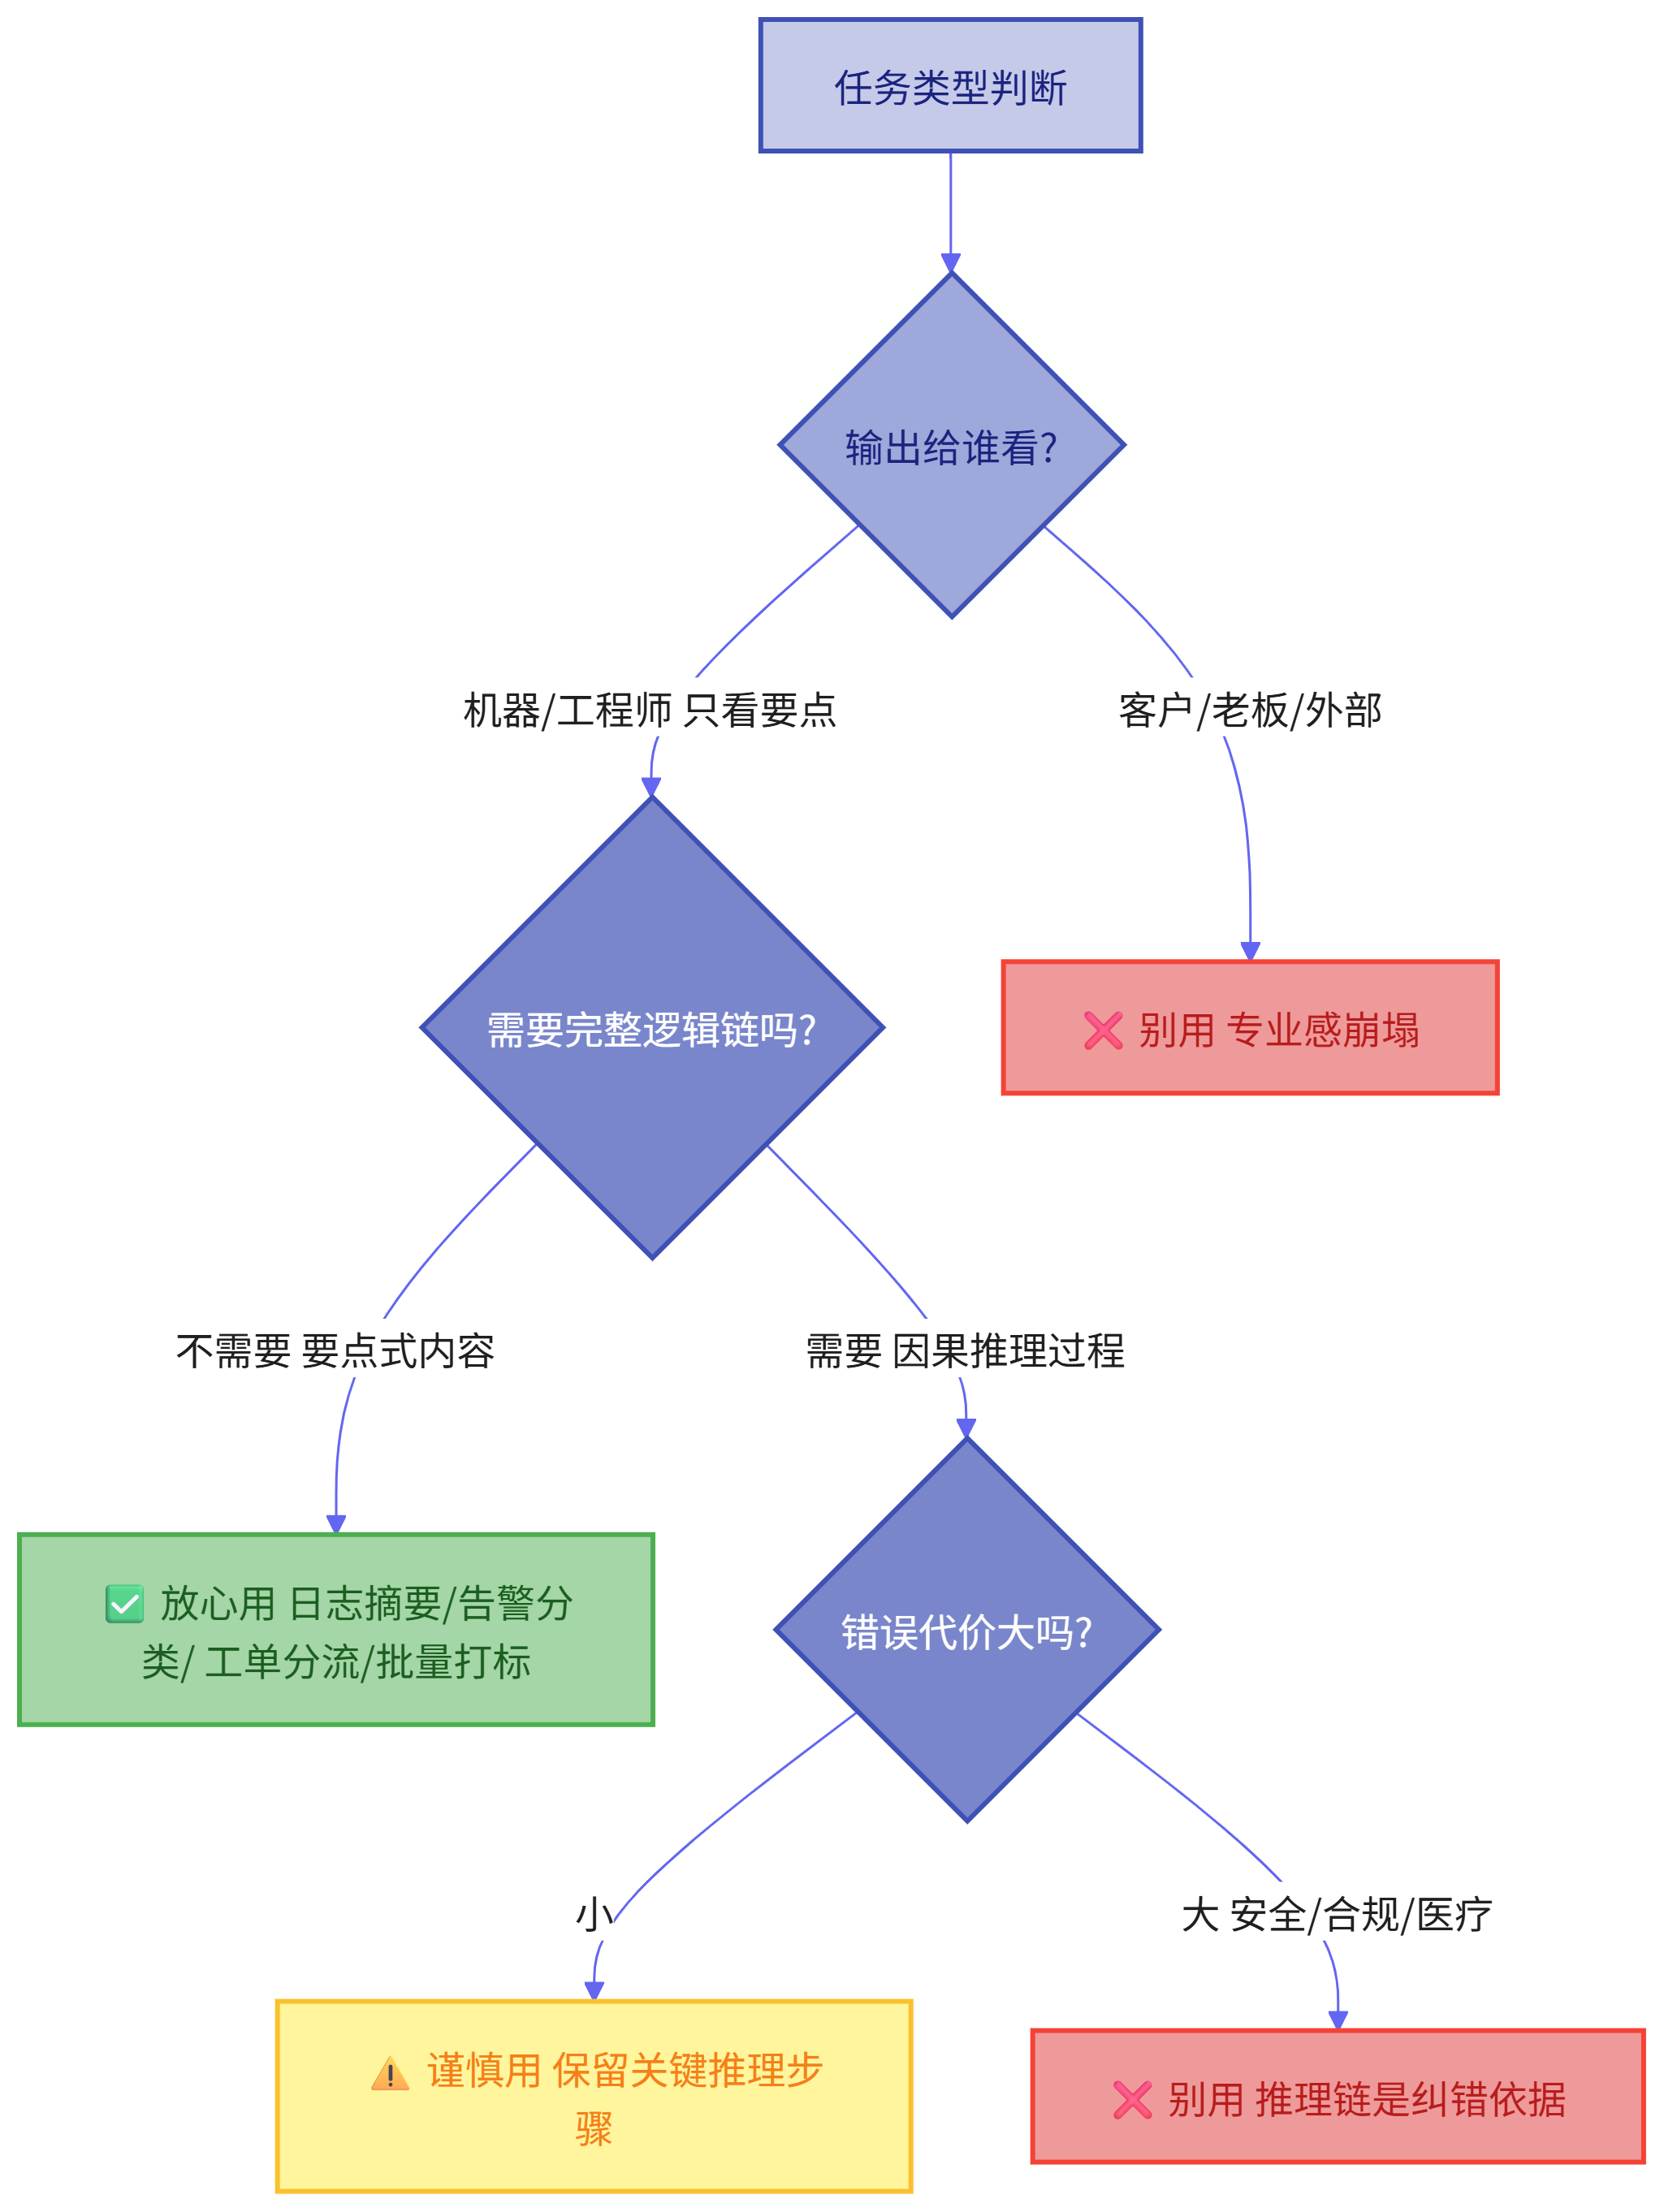
具体说几个我踩过的或者见过别人踩的:
坑 1:对外场景用穴居人模式,专业感直接崩盘。 有个同事拿去做客服机器人,用户收到的回复是"退款可以。三天到账。等。"——用户以为遇到骗子,投诉直接打爆。对外的输出,礼貌和完整度本身就是产品体验的一部分,这钱不能省。
坑 2:推理链被压缩后,错误藏得更深。 模型正常输出时会把推理过程写出来,你review 的时候能看出"哦这步它理解错了"。穴居人模式下只剩结论,错得悄无声息。合规审查、安全分析这种场景,推理链就是你的纠错依据,砍不得。
坑 3:穴居人提示词本身会多花输入 Token。 那段英文规则描述加起来 70-80 个 Token。如果你的任务输出本来就只有几十个 Token(比如简单的二分类),提示词比输出还贵,纯属倒贴。这个玩法只对"输出长"的任务划算。
坑 4:压缩过头信息丢失。 我们最初让日报"每条问题一行",结果模型把两个不同的问题硬塞进一行,关键动作被挤没了。后来放宽到两行,才稳住。压缩比不是越高越好,留一成的冗余换一成的保险,值。
六、为什么这玩意儿能火成猎奇引流教科书
最后聊点务虚的,但我觉得这部分反而最有价值。
caveman 这个项目的技术含量说实话不高——一个精心设计的 Prompt 模板加几组对比数据,任何一个工程师半天都能复现。但它拿了将近 10 万 star。为什么?
因为它把一个枯燥的技术问题(Token 成本优化)包装成了一个有反差感的梗(让 AI 学原始人说话)。"AI 说穴居人语言"这个画面自带传播属性,你看到就想点进来,看完还想转给同事。
对比一下同类的技术内容:
- "大模型输出 Token 优化实践" —— 专业,但没人点
- "让 AI 说穴居人语言,账单砍半" —— 同样的技术内核,阅读量差十倍
这不是教大家标题党,而是说技术传播有它自己的规律:猎奇的壳 + 干货的核 + 可验证的数据,三者缺一不可。只有壳没有核,是纯标题党,看完就骂;只有核没有壳,是好内容但没流量。
我总结了一个可复用的内容配方:

顺带说一句,穴居人模式最被低估的收益其实是速度而不是钱。很多团队对 API 账单不敏感(反正公司报销),但对用户体验极度敏感——批量任务的完成时间从 40 分钟缩到 11 分钟,这种提升是所有角色都能感知到的。所以下次你想推这个方案,别老盯着"省钱"讲,把"提速"放前面,通过率会高很多。
七、写在最后
总结一下这篇文章的核心结论:
- 穴居人模式是真的省——在"要点式输出"的场景(日志摘要、告警分类、工单分流、批量打标)下,Token 省 65-80%,速度快 3-4 倍
- 它有明确的能力边界——对外输出、需要推理链的场景别用;输出本来就短的任务用了倒亏
- 要配合结构化输出——短句 + JSON 约束,才是稳定的生产级方案
- 猎奇引流有方法论——真实痛点 + 反差外壳 + 可验证数据 + 可上手交付物
技术圈每隔一段时间就会冒出这种"看起来很沙雕但认真一想挺有道理"的玩法。别急着嘲笑,也别急着吹捧,自己跑一遍数据,让数字告诉你答案——这大概就是工程师面对热点最体面的姿势。
如果你也拿穴居人模式跑了什么有意思的场景(或者翻车现场),欢迎评论区聊聊。这种玩法的效果非常吃场景,你踩的坑很可能正是别人要找的答案。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号