列式存储不等于列式数据库:Columnar模式为Elasticsearch带来了什么
原创
列式存储不等于列式数据库:Columnar模式为Elasticsearch带来了什么
原创
点火三周
发布于 2026-09-17 09:52:29
发布于 2026-09-17 09:52:29
当我们撰文称Elasticsearch正在成为列式数据库时,收到的最高赞回复是:它已经就是列式数据库了。从事实上看,这个回复没错。Doc values——Elasticsearch从Lucene继承的按字段列式存储——早在2013年就已问世,自Elasticsearch 2.0将其设为默认以来,Elasticsearch查询语言(ES|QL)中的几乎所有聚合、排序和查询都在读取它们。每个字段的值都集中存放在磁盘上的各自文件中。因此,真正有趣的问题是:列式数据库还需要什么(而不是我们是否按列存储),而答案归结为五个关键要素。
Doc values的设计初衷是在文档引擎上实现聚合、排序和分组,并且它们做得非常出色。Columnar模式改变了这些列的使用目的,本文将通过五个属性来阐述:存储列与成为列式数据库之间的区别。
五个属性区分列式存储与列式数据库
Doc values是建立在_source之上的优化
在过去十年的大部分时间里,原始JSON文档是事实来源,而列只是派生的便利手段。这种顺序对整个引擎产生了深远的影响。
由于引擎始终可以回退到_source,按字段的存储允许有损。文本字段根本没有doc values,因为需要时可以从存储的文档中重新读取。即使是合成_source(从字段重建文档而非存储副本),有时也会从行状结构中读取,以忠实于传入的JSON——例如超过ignore_above的值以及传入时未映射的字段,都会进入存储字段。
结果是一个清晰的契约:无论你发送什么JSON,你都能原样收回,而列则加速其他所有操作。对于一个以返回文档为任务的引擎来说,这是正确的顺序。Columnar模式将其反转。每个字段只以doc values形式存储一次,doc values无法关闭,文本字段也获得doc values,当有请求时,文档从列中重建。
字典编码如何处理高基数数据
有序doc values(关键字字段的默认方式)存储一个包含不同值的字典,外加每个文档指向字典的一个序号。当值重复时,这是一个极好的权衡。来自一百台机器的host.name字段,或者几乎总是200的状态码,都能得到出色的压缩和快速的分组。
它就像仓库里的索引卡片。当50个箱子装有相同产品时,一张卡片加50个指针胜过将产品名称写50次。当50个箱子装有相同产品时,你可以将产品名称存在索引中,并附上50个箱子ID的列表。而当每个箱子都装着独一无二的产品时,你干脆把产品名称写在箱子上就好;索引虽然能帮你找到想要的箱子,但不会节省墨水。
高基数字段描述了大量真实数据,包括URL、追踪标识符以及消息体。Columnar模式跳过字典,改用块压缩对值进行编码,为高基数字符串使用二进制doc values。一个字段采用哪种方式无需你配置。引擎根据实际看到的值,按字段决定,因此每一列都针对其实际持有的数据进行编码,而不是对所有字段应用一个默认值。纯列式系统长期以来在其类型系统中携带着基数信息,但通常需要你声明,当底层数据发生变化时,风险由你承担。而在这里,这是引擎的工作。
为什么默认情况下每个字段都建立倒排索引
默认情况下,关键字字段还会建立倒排索引,数值字段还会建立BKD树。每个字段都如此,因为在写入时,引擎不知道你在读取时需要哪种能力,这显著增加了每个字段的存储占用。这些结构还必须在段合并期间重建,而这正好在写入最繁忙时消耗CPU。
我们的时序引擎(TSDB)就是证明:当你停止为工作负载不使用的功能付费时,会发生什么。用_doc value skippers(稀疏结构,保存每个文档块的最小值和最大值)替换@timestamp和维度字段上的索引,每个OpenTelemetry(OTel)数据点从原来的25字节中移除了10字节。在时间范围和维度过滤上,没有可测量的查询回归,而索引CPU下降了约10%,作为额外收益。
Columnar模式将这种默认行为泛化。字段不会被索引,除非有需求需要它们;只有文本映射字段保留倒排索引以支持快速全文搜索。
元数据字段(如_id和_routing)曾是行状的
那些你从未想过的字段也遵循了文档优先的设计。_id字段是一个存储字段加上倒排索引。自定义_routing是一个存储字段。序列号用于乐观并发控制,无论工作负载是否更新文档。
TSDB处理了所有这些。它从已有的标识数据点的_tsid和@timestamp值中合成_id,并使用段级布隆过滤器检测重复项,从而每个数据点移除5字节且功能无损。一旦复制不再需要序列号,便将其修剪,移除4字节。再将编解码器块大小从128增加到512个元素,又节省2字节。这四个改动在9.1到9.4版本中,将OTel指标从每个数据点25字节降至3.75字节。
Columnar模式将这些理念泛化,使其不仅适用于指标。到正式发布(GA)时,所有元数据字段都将以doc values形式存储自身,而我们还计划跟进添加一种排序ID模式,从索引排序字段合成标识符,此外还有派生字段,将时序中_tsid的功能泛化到任意字段集。
ES|QL计算引擎中的列式查询执行
列式存储只有在引擎按列读取时才能发挥价值。聚合继承了搜索中逐文档的处理形态,这对于以文档为中心的引擎来说是自然匹配。而按列读取则让引擎可以将整个值块交给单个指令处理,以下数字正来源于此。
ES|QL计算引擎改变了这种形态,TSDB再次展示了效果的大小:
- 向量化执行:时序聚合本身可带来高达8倍的性能提升。
- 直接从磁盘解码到引擎聚合所用的原始数组,无需中间拷贝,大约再带来10倍提升。
- 常量块:将重复值转化为内存中的游程编码形式。
- 过滤下推:将过滤条件下推到Lucene,skipper可以不经打开就丢弃整个块。
结合其余块级查询工作,与早期版本相比,查询延迟提升高达160倍。
这项工作仍在继续。支持skipper的运算符、基于序号分组并尽可能晚转换为真实值的聚合,以及更丰富的每块摘要,都在推进中,并且所有索引模式都能从中受益,因为所有模式底层都读取doc values。
Columnar模式为日志和分析数据带来的改变
按列存储值只是一个存储细节。列式数据库需要五个要素:
- 列是数据的唯一副本。
- 每一列都针对其实际持有的数据进行编码。
- 元数据也是列式的。
- 字段仅在需要时添加索引。
- 查询引擎处理值块,而非记录或文档。
TSDB在Elasticsearch 9.4中已针对指标达成了全部五项目标,这也是为什么本文中的数字来自指标而非幻灯片。Columnar模式将相同的处理方式应用于日志、安全遥测以及分析数据。它在Elasticsearch 9.5中以技术预览版提供,正式发布(GA)目标为9.7。
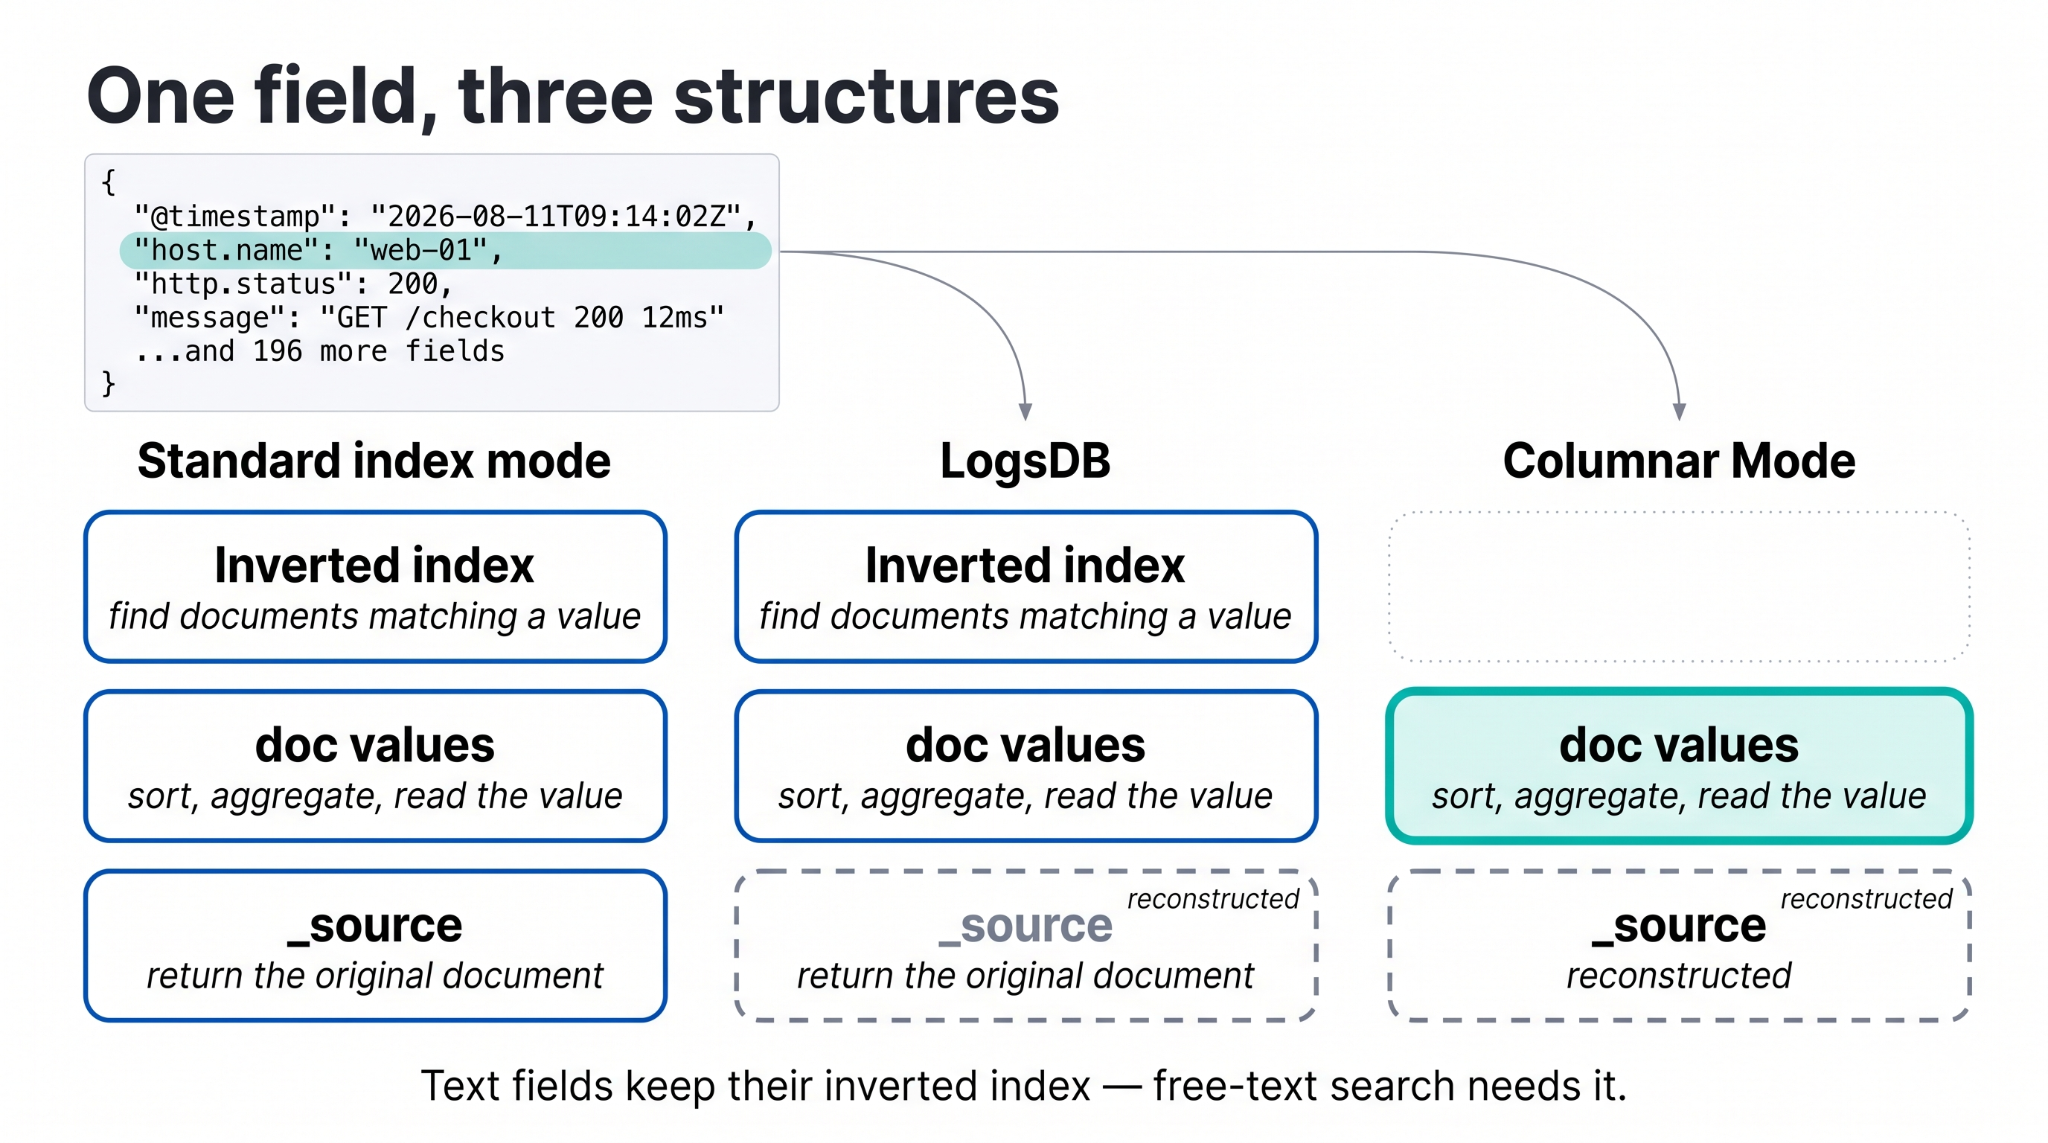
Elasticsearch doc values, inverted index and _source across standard index mode, LogsDB and Columnar Mode
每个字段只存储自身一次,仅在需要时才添加索引。
本文所述任何功能或特性的发布和时间安排完全由Elastic自行决定。目前未提供的任何功能或特性可能无法按时交付或根本无法交付。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号