应用反噬模型,AI价值链开始逆转 |爱分析洞察
原创
应用反噬模型,AI价值链开始逆转 |爱分析洞察
原创
爱分析ifenxi1
发布于 2026-09-17 11:35:57
发布于 2026-09-17 11:35:57
近期,a16z合伙人Martin Casado给出了一个让模型厂商不太舒服的判断,算力供给放开、开源模型成熟之后,AI产业链价值会重新分配,应用层将拿走越来越多的份额,模型厂商的利润份额会被侵蚀。
其背后的逻辑比较直接,模型走向商品化,使得模型变得同质化而可替换,依靠模型本身形成差异化的难度将越来越大。这个判断,反驳的正是过去两年的主流叙事:模型将吃掉应用。
过去两年,行业达成高度共识,认为模型要是足够强,就能一路吃掉一层层应用,应用只是模型的一层薄薄的壳,随时可能被模型厂商吞并。
这个叙事之所以流行,是因为模型厂商站在价值链最上游,定价权和利润都握在自己手里。比如,在编程、视频等应用上,强势产品均出自强势的模型厂商,模型能力几乎等于应用能力。
现在,这条价值链的方向正在逆转。尤其是在办公应用中,强势产品WorkBuddy并不来自最强的模型厂商,且办公应用也没有与模型深度绑定,都开放了多模型接入。由此可以看出,模型的强弱已经不再决定产品的高下,模型在应用里的话语权正在下降。
爱分析认为,这是一次价值链决定权的分水岭。模型商品化让模型随时可换,但任务数据只会沉淀在应用一侧,价值链的决定权由此从模型厂商手中转移至应用厂商,而这背后的推动力,正是今年开始热议的Harness。
Harness是指模型之外、把模型能力落成具体任务执行的系统,涵盖Agent Loop、上下文管理与记忆、工具调用、任务编排、结果反馈等,它并不能提升应用的智力上限,但它决定智力以怎样的方式被正确使用。
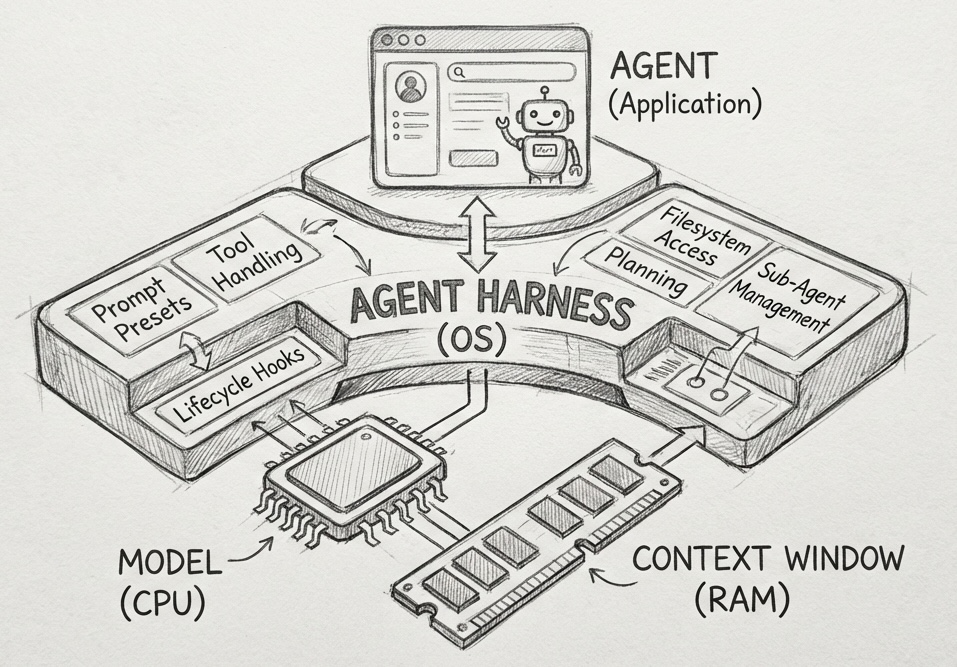
图1:Harness示意图
01 任务的成败,正在从模型转向Harness
今年8月,OpenAI披露过一组数据,其当时最新的模型GPT-5.6 Sol通过Harness调整,在ARC-AGI-3基准上得分从13.3%提升到38.3%。
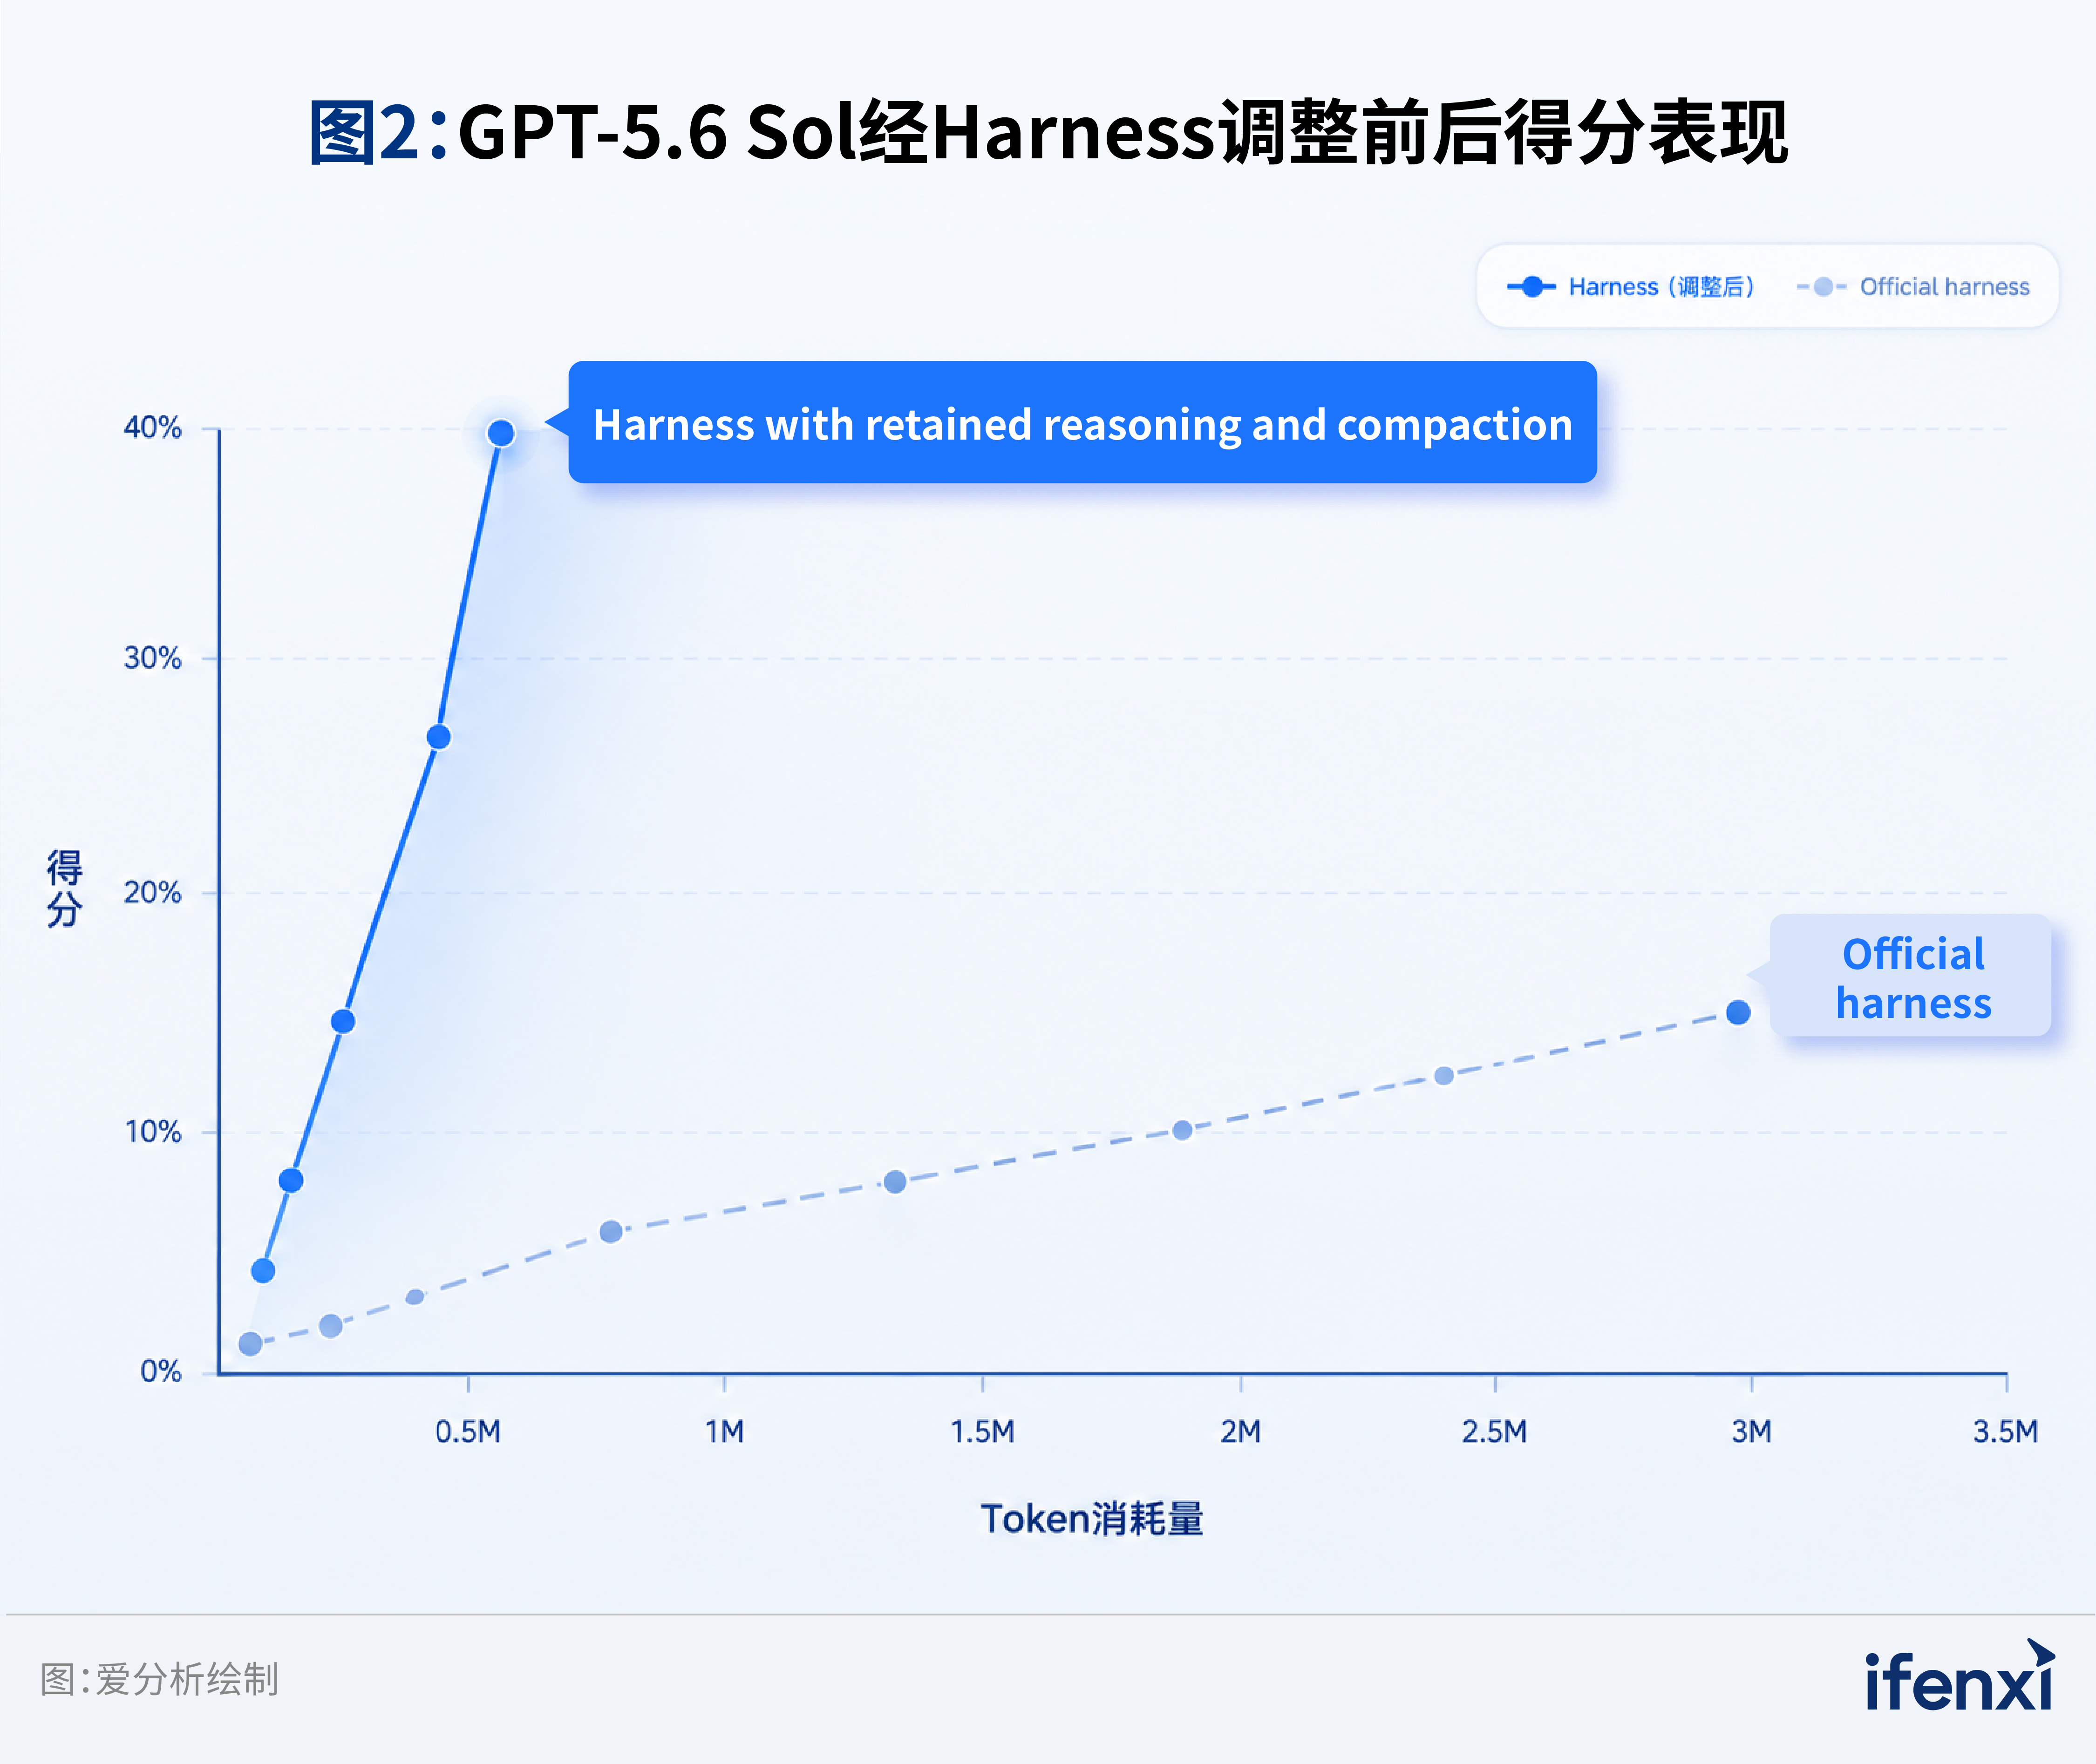
图2:GPT-5.6 Sol经Harness调整前后得分表现
从评测结果看,模型本身没有变化,得分却提升近三倍,这是通过Harness释放了模型本已具备、但此前没被释放出来的能力,这正是Harness层的价值。
除了OpenAI, 2026年有多篇研究论文中也做了相关受控实验,来量化Harness的价值。比如其中一篇杜兰大学等学者论文(Stop Comparing LLM Agents Without Disclosing the Harness)中的实验是,选取同一批长程任务,先固定Harness,更换不同模型各测一遍,再固定模型,更换不同Harness各测一遍,比较两组结果的波动幅度,波动数值越大,说明这一变量对结果的影响越大。实验结果是,更换Harness造成的成绩波动,是更换模型的7.8倍。
Harness的作用不只体现在任务执行效果上,也体现在成本控制上。
在刚才提到的GPT-5.6 Sol测试中,Harness框架下Token消耗为无框架状态的1/6。此外,也有AI公司Writer(The Harness Effect: How Orchestration Design Sets the Token Economics of Enterprise Agentic AI)做过另一组实验,同一批长程任务,只更换Harness、不动模型,结果单任务成本下降41%、耗时下降44%、token消耗下降38%,但质量持平。也就是说,同样的模型,被更合理的Harness调度,完成任务的资源消耗可以少近一半。
02 静态Harness只是暂时领先,会进化的Harness才是壁垒
上述静态的Harness工程可以被轻松复现,模型厂商并不会因此被应用厂商反噬。爱分析认为,数据驱动的Harness自进化闭环才是壁垒,而这个闭环只能长在应用侧,这也是AI叙事从模型转向应用的核心原因。
一个真实的长程任务由一连串调用构成:先理解需求,再拆解步骤,调用工具,检查结果,出错重试,最后汇总。这些调用之间的因果链,只有发起任务的应用知道,模型厂商看到的只是收到的若干次请求,既不知道这些请求是否属于同一个任务,也不知道它们之间的先后与成败。因此,模型厂商也就无法针对真实任务去打磨Harness。
而对于应用侧而言,情况就完全不同了。比如,办公产品每接入一个行业,就多一类任务模式,多一份真实数据。行业接入得越多,Harness见过的场景越全,对后续新任务的处理就越准,而且接入新行业的边际成本也随之下降。
所以,对于应用厂商来讲,这是一个正向循环,Harness系统越强,越有能力接住更复杂的场景,这也催生了一批Harness自进化的新机会。值得注意的是,这个自进化是有天花板的,它能把模型用得更对更好,却改变不了模型本身的能力上限。
03 模型厂商的反制措施,开源Harness
为了反制这次价值链变化,模型厂商以开源Harness作为手段,试图拆掉应用厂商构建的壁垒。
下半年,国内的DeepSeek、Qwen等先后开源了各自的Harness或Agent框架,开发者不必从零搭建,就可以站在现成基座上快速起步。模型厂商用意很明确,当Harness成为公开可得的基础构件,生态中的各方都可以针对各自的应用场景对Harness做优化,应用厂商依靠自研建立优势的空间随之被压缩。模型厂商开源一举两得,既打破对手的竞争壁垒,又让更多开发者站到自己一侧,把生态吸附在模型层周围。
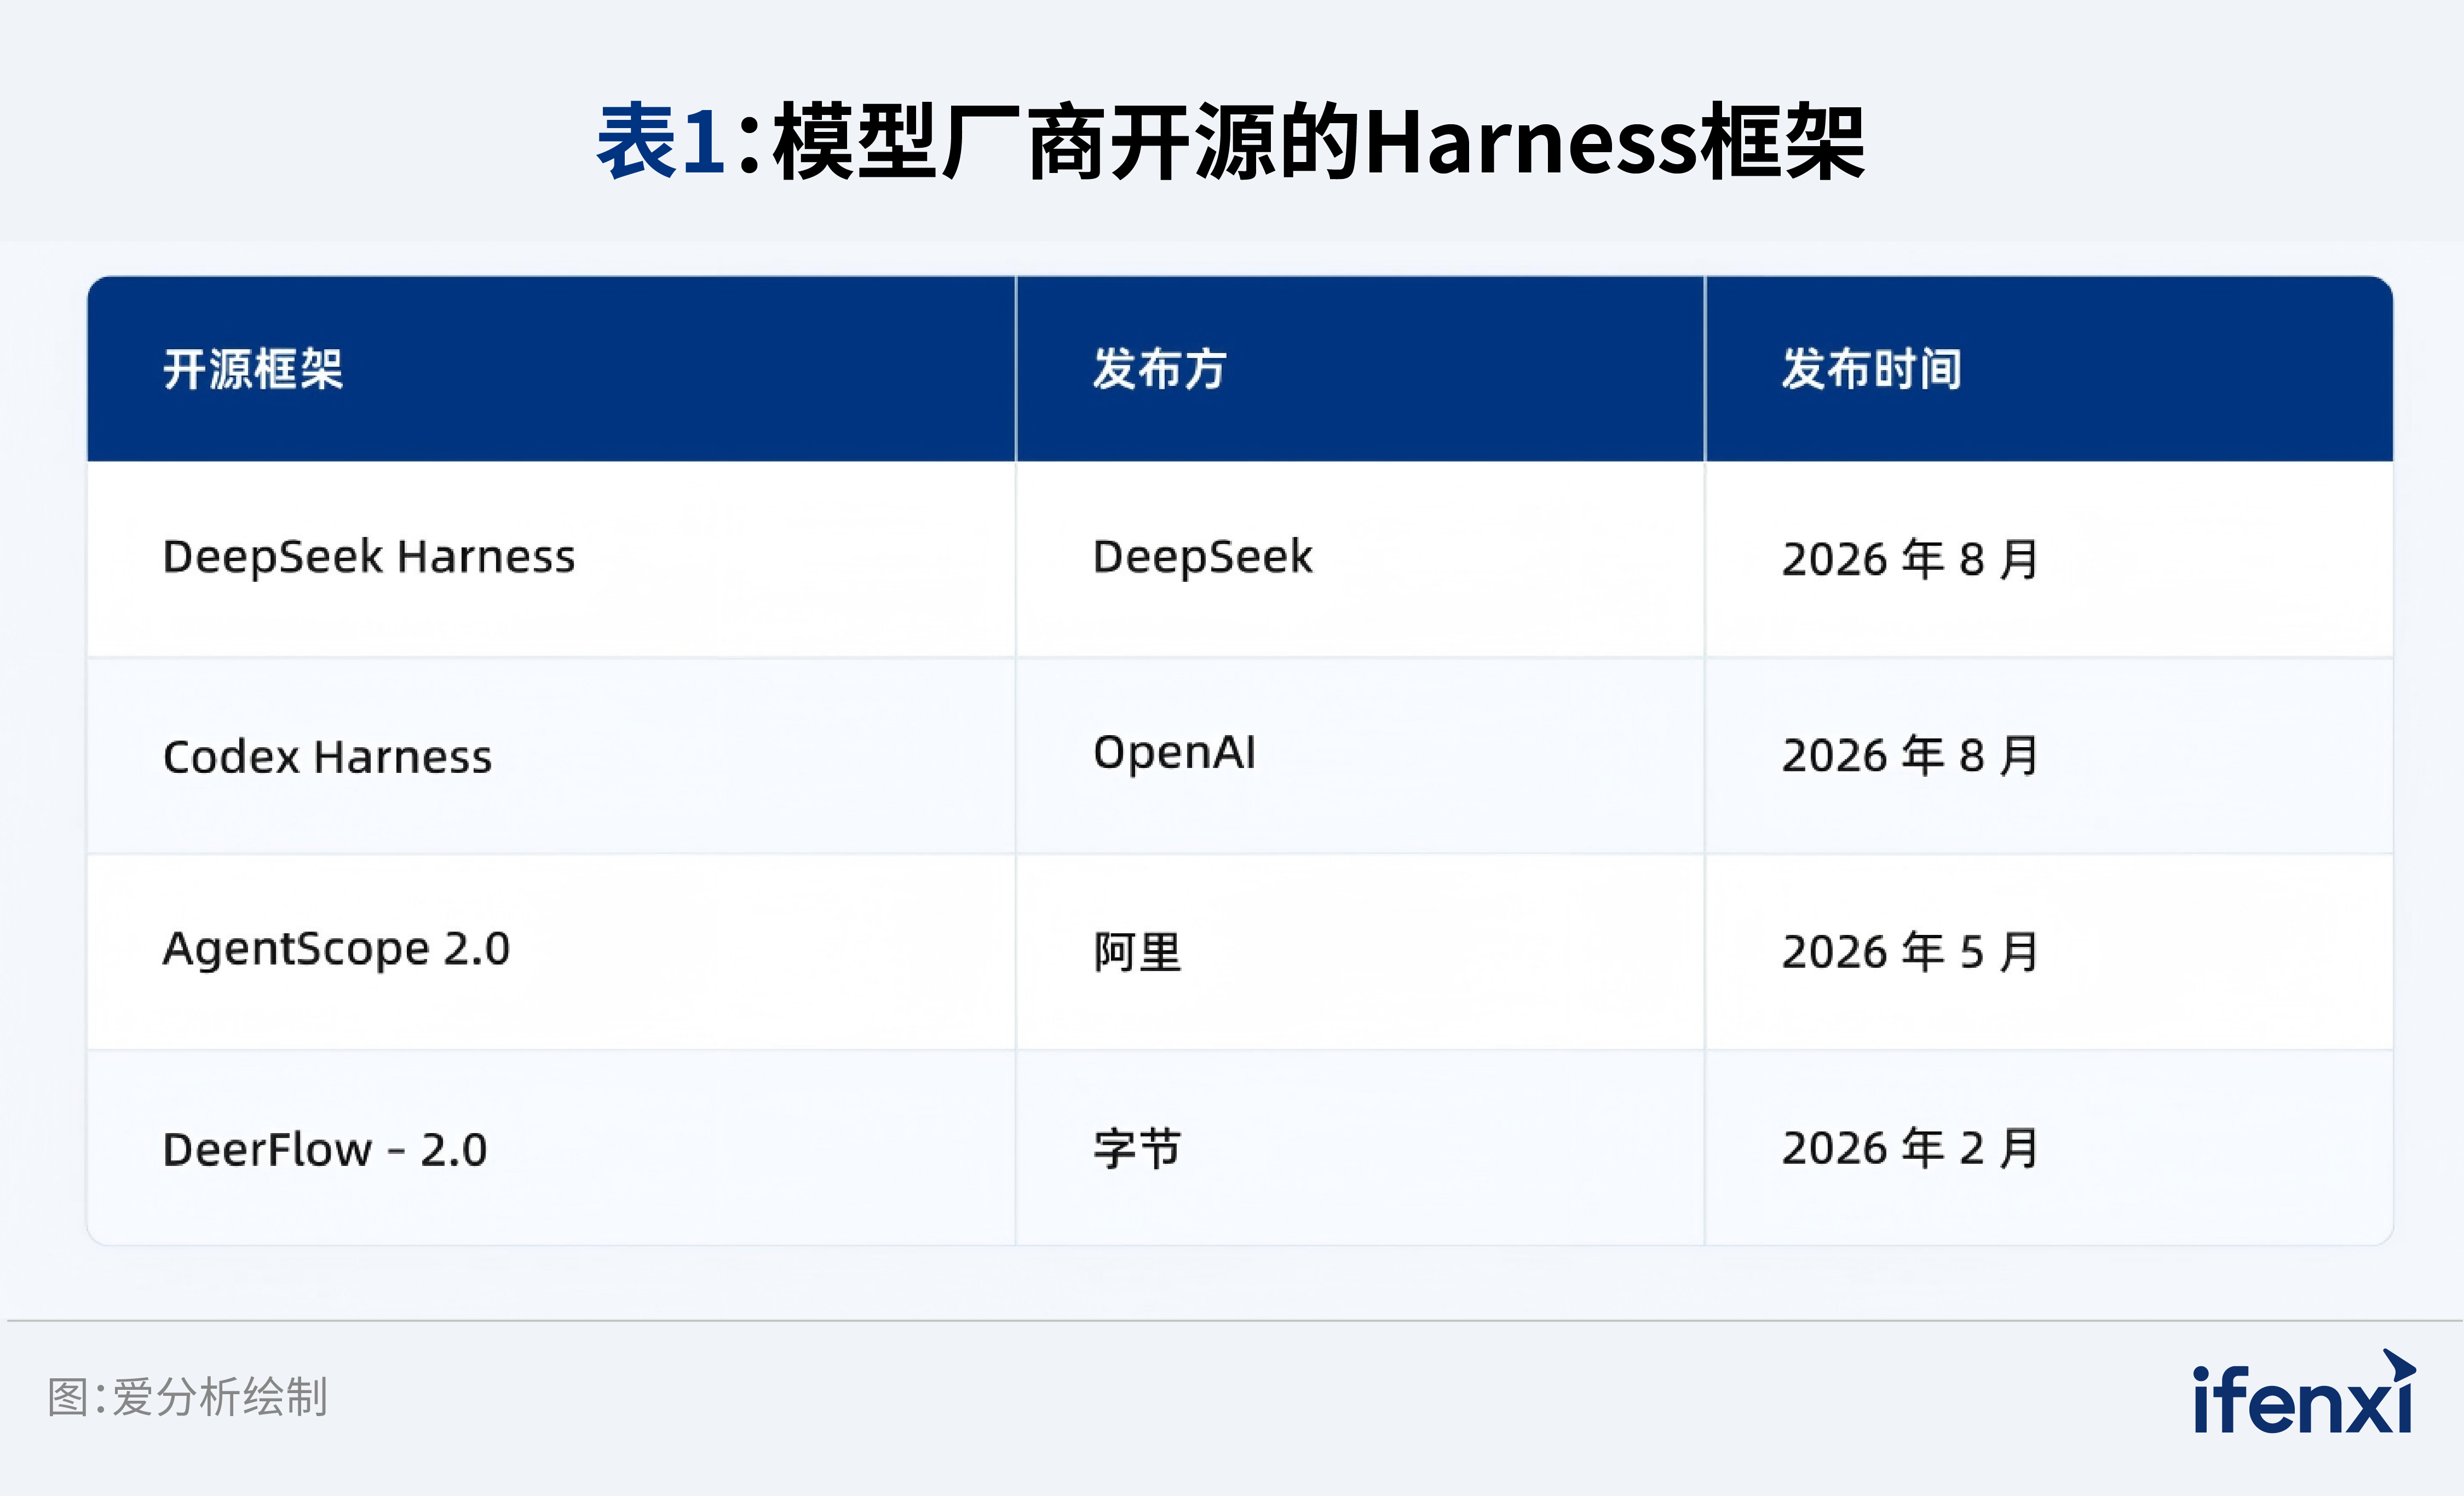
表1:模型厂商开源的Harness框架
爱分析认为,模型厂商开源Harness框架,阶段性会对自研Harness的应用厂商造成影响。应用厂商绝不会开源自己的Harness,因为那是它连接用户、沉淀数据的入口,也是多年试错换来的Knowhow沉淀,一旦开源,等于把打法公开,并削弱自己的商业化能力。
但这种影响是暂时的模型厂商开源,只能冲击应用厂商的静态Harness壁垒,当自进化能力成为Harness的主体之后,这种冲击便随之消解,开源闭源不再是关键变量,数据闭环才是真正的壁垒。模型厂商代表开源生态,应用厂商代表闭源生态,未来数据闭环在哪个生态,哪边的话语权就更为强势。
04 应用反噬的边界:应用拿走入口,模型保留天花板
应用反噬模型也是有边界的,终局并不会以应用吃掉模型收场,也并不代表应用能够回到自训模型的老路上。
首先,应用厂商反噬掉的,是模型对于用户的心智占领。过去模型能力等于应用能力,用户对于模型品牌认知很强;现在模型能力与应用能力逐步解耦,用户逐步被应用品牌占领心智,模型厂商退到幕后,变成一个可替换的供应商。
其次,模型壁垒依然存在。如同前文所述,任务执行能力的上限由模型决定,Harness是在模型能力范围改善任务的稳定性、成本与成功率。也就是说,天花板级别的高难度任务,能否被解决取决于模型。
腾讯集团副总裁李强对Harness与模型的边界给出了一个准确表述,“模型是引擎,Harness是把引擎变成整车的工程,发动机决定上限,Harness决定能不能跑、跑多远、跑多稳。”也就是说,模型代表上限,Harness决定能否逼近上限。
综合以上两点,爱分析认为,应用反噬模型的周期会很长,企业和开发者当下并不会将Harness的重要度置于模型之上。一方面,Harness框架和模型都没有到达稳态,如果应用输出质量发生变化,很难正确归因,导致应用迭代缺乏方向。另一方面,突破任务天花板的价值度依然很高,这方面依然要仰仗SOTA模型。
未来,应用和模型的关系将逐步从竞争转向分工协作。
模型厂商退守能力上限,应用厂商占据执行与入口,两方的价值重新聚焦:模型厂商把精力放在把模型能力继续往上抬,应用厂商把精力放在把真实任务跑通、跑顺,双方从上下游的争夺关系,转为分工互补的关系。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号