从 5530 词到 2434 词:我用 WorkBuddy 做了一套离线背单词 PWA
原创
从 5530 词到 2434 词:我用 WorkBuddy 做了一套离线背单词 PWA
原创
用户12769381
发布于 2026-09-17 15:48:52
发布于 2026-09-17 15:48:52
一个纯前端、零后端、能装到手机主屏、断网也能背的背单词工具。真正的难点不在界面,而在词库——把 5500 个词的清单,洗成一份"每一个都值得背"的清单。
起因:市面上的背单词 App,我只需要它十分之一的功能
我想要的东西其实很朴素:词表干净(别把 it、they 这种词也算进考研词汇)、能离线、手机点开就能背、换手机进度别丢。市面上的产品要么词库大到需要付费解锁、要么社区、打卡、商城一堆功能。
正好我手上有一份"考研英语二"的目标词表需求,于是决定自己做一套。全程用 WorkBuddy:下载和合并开源词库、写清洗脚本、生成前端页面、部署上线,都在对话里一步步推着走。
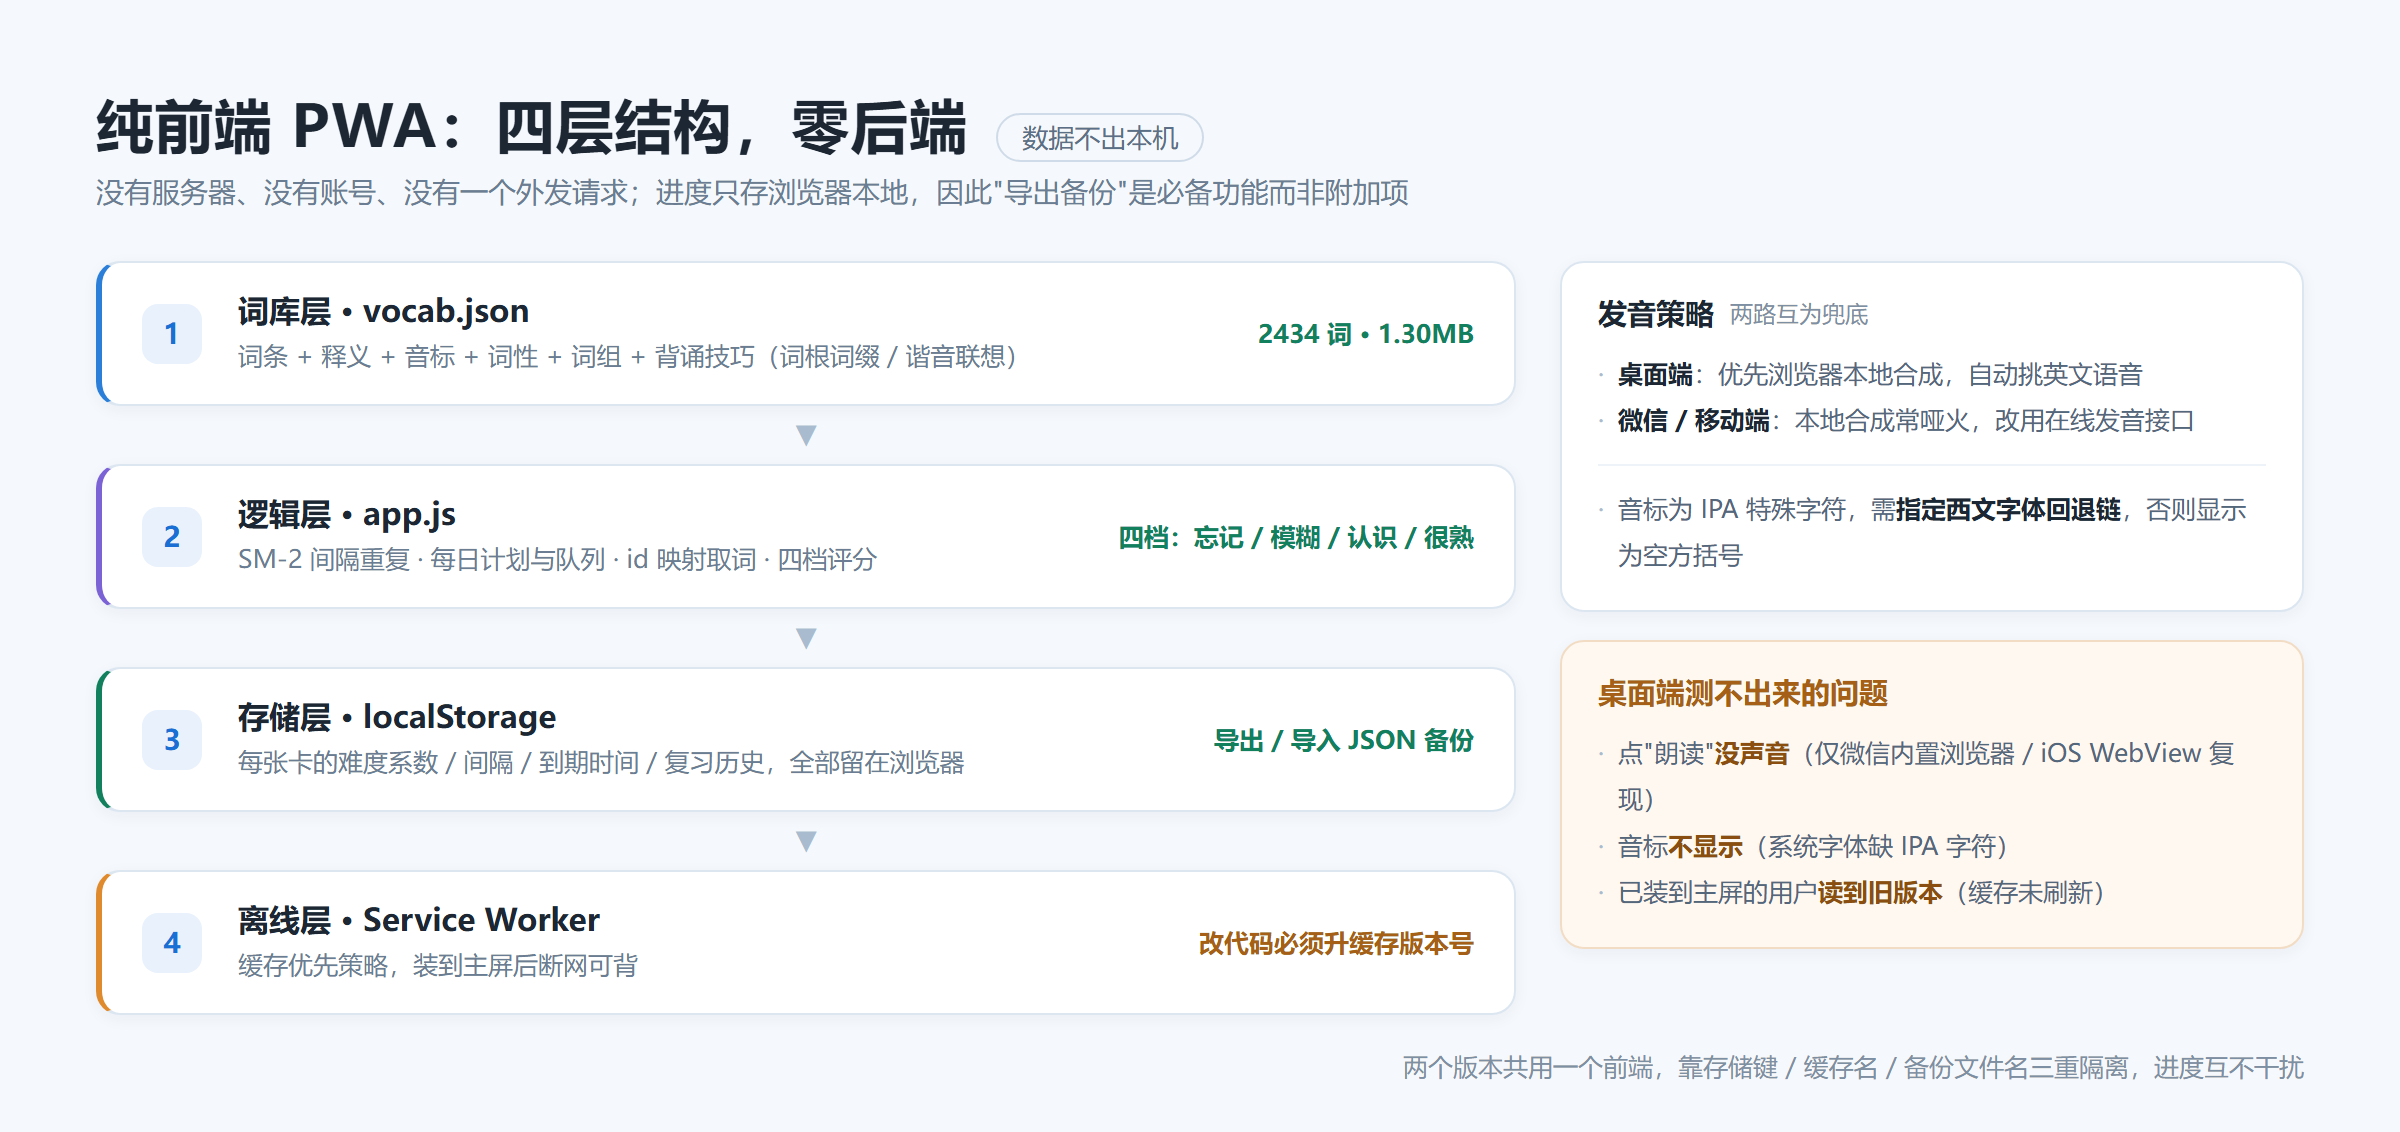
一、为什么是 PWA,而不是做个 App
这是第一个要定的事。三条理由:
- 不用上架。写纯前端,扔到静态空间就是一个链接,改一次发一次,没有审核。
- 加到主屏就是 App。配一个
manifest.json+ Service Worker,iPhone 上"添加到主屏幕"后全屏运行,有图标、有名字,看不出和原生 App 的区别。 - 数据天然在自己手里。进度存
localStorage,一个请求都不往外发,不需要账号、不需要服务器,也就不存在"我的学习数据存在谁的服务器上"这个问题。
代价也要说清楚:localStorage 是跟浏览器绑的,清缓存就没了。所以导出/导入备份不是"锦上添花的功能",而是必备功能——我在设置页留了「导出进度备份」,换设备前先导一份,到新设备导进去就能续着背。
二、把两份开源词库拼成一份能用的
第一步是找词库。我没有自己去爬,用了两份开源数据:
- 一份考研词表(5530 词),字段比较全:词频、释义、分类、其他拼写,带 CC BY-NC-SA 许可;
- 一份通用英语词表(9602 条),优势是有词性和词组搭配。
两份各有短板,就合并:以考研词表为主表,按单词匹配,把通用表里的词性 + 词组补进来。结果是 5530 词、释义 0 缺失,4807 个带词性、3961 个带词组。
音标:从一份 66MB 的词典里捞 5000 条
词库里没有音标字段。我去下载了一份开源英汉词典的 CSV——约 66MB、77 万词条,然后把目标词的 phonetic 字段一条条提出来,生成一个 phonetic_map.json,前端加载词库时按词补齐。
5394 个待补词命中 5375 个。剩下 19 个是什么?ice cream、grown-up、so-called、air conditioning 这类复合词和英式拼写——大词典里收录形式不一样。这些手工补掉就行,一共 15 个。
⚠️ 有个小坑值得记一下:这份词典的音标是 ASCII 近似 IPA(比如 sә:tәn),不是标准的 Unicode IPA(ˈsɜːtn)。够用、能看懂,但不是学术标准的音标。要么接受,要么换音标源重做一遍。
背诵技巧:能程序化的程序化,不能的才人工
"这个词怎么记"是最难自动化的部分。我最终的做法是分两类处理:
- 能程序化的 → 构词法自动拆解。内置了一张前缀(89 条)、后缀(60 条)、词根(184 条)字典,按规则对单词做拆解,生成"前缀
ac-(朝向、加强)+"这类提示。这类拆解是规则生成、100% 准确的,量大且不需要人工。 - 不能程序化的 → 精选谐音/联想。谐音记忆没有规律,只能人工写。我整理了一批高频难词的谐音联想(纯中文短句),覆盖一千多个词。
两类合起来,主版本 2434 个词里 2329 个带背诵技巧;按类型拆是词根词缀 1686 条、谐音联想 1081 条、词组搭配 327 条。剩下的词是很短的词,本来也不需要技巧。
一开始我还想过去外部助记数据集找现成的,但那些源在当前网络环境下拿不到,最后是"程序化 + 精选"这条路把覆盖率顶到 95% 以上——反而比纯依赖外部数据更稳。
三、最花时间的一步:判断"这个词到底该不该背"
界面搭完自己用了一遍,问题立刻暴露:词太简单了。it、they、man、woman 这些词混在里面,背十条有六条是在浪费时间。
于是要做一件事:把高中及以前的词汇全部剔除。听着简单,但它有个前置问题——拿什么当"高中及以前"的判定基准?
踩坑一:不能拿"词典常见度"当基准
我一开始想用词典里的 oxford(牛津 3000 核心词)和 collins(柯林斯星级)标签来筛。这是错的:牛津 3000 里包含 analyse、anticipate、career、client、capable 这类词,而这些恰恰是考研必须背的。用它当基准会大批误删核心词。
正确的基准只有一个:高考大纲词表。考纲以内的词,默认你高中就学过;考纲以外的,才是考研需要补的。
踩坑二:网上的"高考 3500 词表",没有一份是全的
我找了两份现成的高考词表,结果发现两份都不全:
- 一份解析出 3772 词
- 另一份 3875 词,但漏了
man、woman、life、hear、give等 22 个最基础的词 - 而第一份又漏了
after(只收了afternoon、afterward)
取并集(3772 ∪ 3875 = 4029 词)之后,再手工补上 5 个漏网的介词/连词/代词(after、despite、underneath、whereas、whoever)作为兜底。
结论很朴素但很实用:"基础词表"这种东西,别信单一来源,取并集 + 人工抽查才靠谱。 这一步如果偷懒,用户背到 man 的时候就会直接卸载。
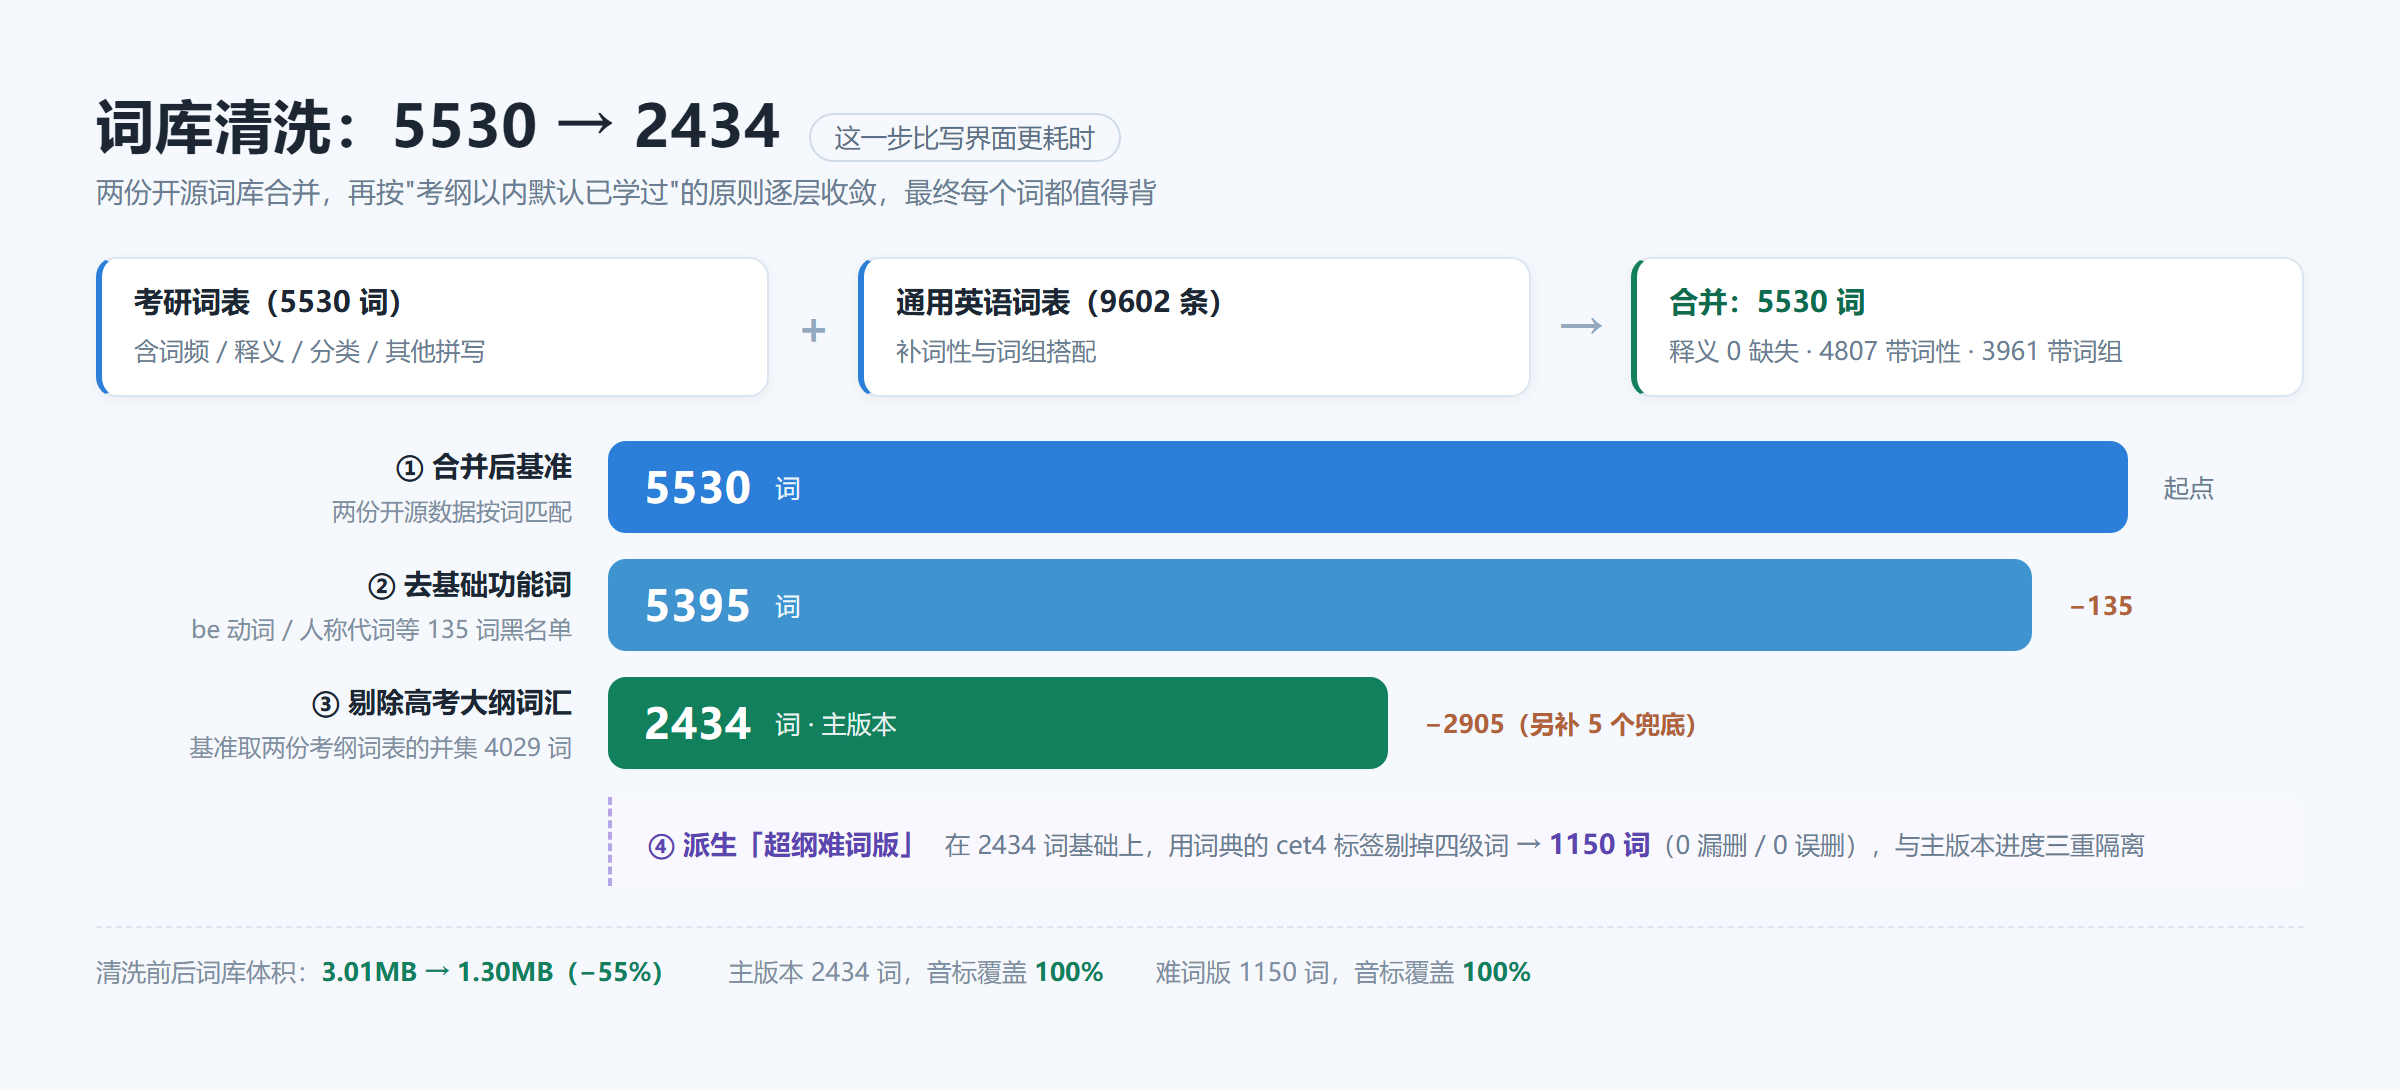
清洗结果
步骤 | 词数 | 说明 |
|---|---|---|
原始考研词表 | 5530 | 合并后的基准 |
去黑名单基础词 | 5395 | 早期用 135 词黑名单,剔掉 be 动词、人称代词 |
剔除高考大纲并集 | 2434 | 去掉 2905 个 + 手工补 5 个兜底,泄漏 0 |
再剔四级词(难词版) | 1150 | 用词典的 cet4 标签筛,只留六级/考研/托福/雅思及无标记难词 |
清洗前后,词库文件从 3.01MB 降到 1.30MB,少了 55%——这不只是体积问题,手机端首屏加载速度是实打实的体验差别。
四、算法:把 SM-2 塞进一张手机卡片
复习算法用的是SM-2 间隔重复,也就是 Anki 那一套。核心逻辑不长:
- 评分分四档:忘记(1)/ 模糊(3)/ 认识(4)/ 很熟(5);
- 答"忘记",间隔归零、难度系数下调、10 分钟后重新塞回本轮队列——当天的坑当天填;
- 答对则间隔按 1 天 → 6 天 →
上次间隔 × 难度系数递增; - 连续答对且间隔超过 30 天,标记为 已掌握。
其中有个容易忽略的细节:难度系数(EF)的下限是 1.3。不设下限的话,一个词反复答错会把系数压到接近 0,间隔就再也拉不长了。
交互上就是一张翻面卡片:正面单词 + 音标 + 朗读,点一下显示释义、背诵技巧和词组,再点四个评分按钮。每日计划、连续学习天数、近 30 天记忆保持率曲线、学习进度条都用 Canvas 画,没有引入任何图表库。
五、三个"只有跑起来才暴露"的坑
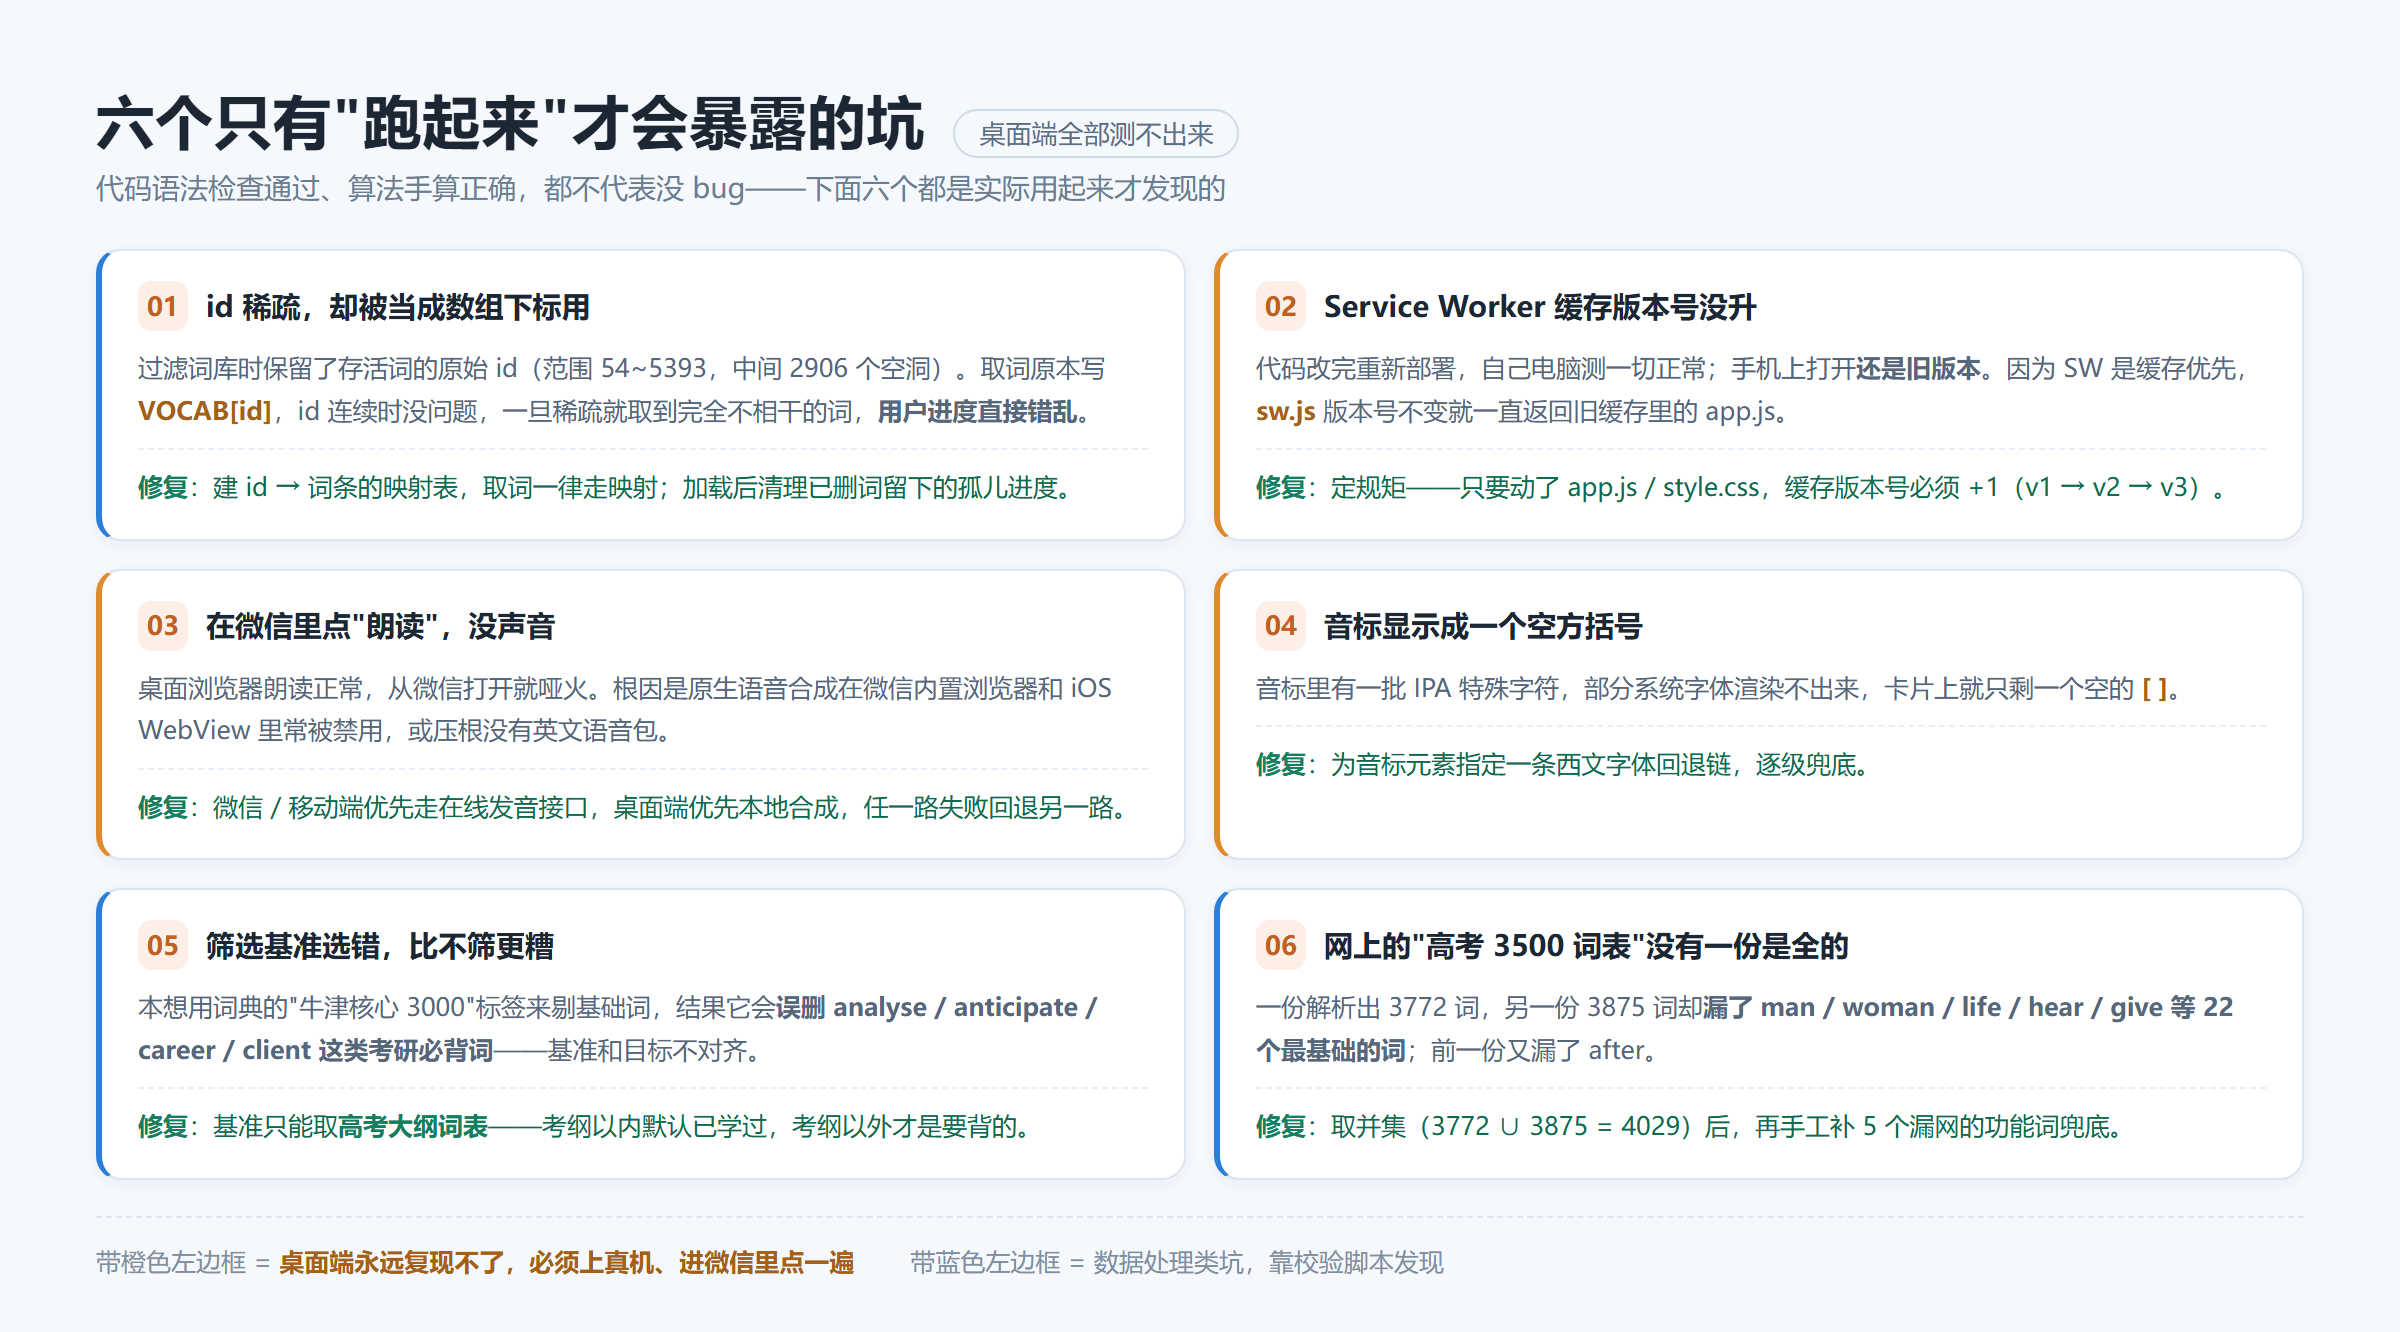
界面写完、语法检查通过、算法手算也对——但这不代表没 bug。下面三个都是实际用起来才发现的。
坑一:id 稀疏导致进度错乱
剔除词汇时,我保留了存活词的原始 id(原来是第 5000 个词,过滤后还是这个 id),好处是用户已有的学习进度不会错位。但代价是 id 变成了稀疏的——范围 54~5393,中间有 2906 个空洞。
而代码里取词原本写的是 VOCAB[id]——拿 id 当数组下标用。id 连续时这没问题,一旦 id 稀疏,取得的就是完全不相干的词。
修复是引入一张 id → 词条 的映射表,所有取词都走映射;同时在词库加载后清理已删词留下的孤儿进度,否则统计数字会把已经不存在的词算进去。
坑二:Service Worker 不升版本号,老用户永远读旧代码
PWA 的 Service Worker 默认是缓存优先。我改完代码重新部署,用自己的电脑测一切正常——但手机上打开还是老样子。
原因很简单:sw.js 里的缓存版本号没改,Service Worker 就一直拿旧缓存里的 app.js 返回。后来定了个规矩:只要动了 app.js / style.css,缓存版本号必须 +1(v1 → v2 → v3 就是这么来的)。
如果你的 PWA 有"代码更新了但已安装用户看不到"的现象,八成是这里。
坑三:在微信里点"朗读"没反应
桌面浏览器上朗读正常,发到手机、从微信里打开——按了没声音。
根因是浏览器原生的 speechSynthesis 在微信内置浏览器和 iOS WebView 里经常被禁用,或者压根没有英文语音包。修法是加一条发音策略:
- 微信 / 移动端:优先走在线发音接口(国内可访问、支持单词和短语);
- 桌面端:优先本地合成,并自动挑一个英文语音;
- 任一路失败,回退到另一路,都失败才提示。
顺带还有个显示问题:音标里有一堆 IPA 特殊字符,某些系统字体渲染不出来,卡片上就只剩一个空的方括号。最后是靠指定一条西文字体回退链解决的。
这类问题有个共同点:桌面端测不出来。所以只要做移动端,最终必须上真机、进真实容器(微信)里点一遍。
六、派生一个"超纲难词版":同一套代码,两份进度互不干扰
主版本跑通后,又有个新需求:去掉四级词,只留超纲难词(适合二刷、冲刺阶段用)。
数据上的处理很简单——用词典里的 cet4 标签把四级词全部剔掉,2434 词剩 1150 词(纯六级/考研/托福/雅思及无标记难词),校验下来 0 漏删、0 误删,1150 词 100% 有音标和释义、93% 有背诵技巧。
真正要小心的是进度隔离。两版共用一套代码,如果存储键一样,用户的进度就会互相覆盖。所以我做了三重隔离:
隔离项 | 主版本 | 难词版 |
|---|---|---|
进度存储键 | ky2_state_v1 | ky2hard_state_v1 |
配置存储键 | ky2_config_v1 | ky2hard_config_v1 |
SW 缓存名 | 主版缓存 | ky2-hard-v1 |
备份文件名 | ky2_backup_* | ky2hard_backup_* |
在同一个手机上把两版都加到主屏,进度各走各的,互不影响。
七、成品
两个版本都是纯静态前端,各自独立部署:主版本 2434 词,超纲难词版 1150 词。手机上用浏览器打开后「添加到主屏幕」,就是一个有图标、能全屏、断网也能背的小 App,两版可以同时装着各背各的。
两版部署后的实测数据:
指标 | 主版本 | 难词版 |
|---|---|---|
词数 | 2434 | 1150 |
音标覆盖 | 100% | 100% |
词性覆盖 | 95.5% | 91.5% |
背诵技巧覆盖 | 95.7% | 93.5% |
词组搭配 | 1734 词 | 698 词 |
词库体积 | 1.30MB | 0.58MB |
八、复盘:这次真正有价值的是这 6 条
- "数据清洗"往往比"写功能"更耗时,也更决定成败。 前端代码写了一轮就稳定了,词库来来回回洗了三轮(去基础词 → 补音标 → 加技巧 → 再按考纲过滤)。
- 筛选基准选错,比不筛选更糟。 用牛津 3000 当"基础词"基准,会误删一批考研核心词——基准必须和真实目标对齐(考纲)。
- 别信单一来源的基础词表。 两份"高考 3500"都不全,取并集 + 人工兜底才干净。
- 能程序化的就程序化,不能的才人工。 词根词缀用规则拆(准确、量大),谐音联想人工精选(不可规则化),两层叠加覆盖率就过 95%。
- 过滤数据时要保留原 id,但代码绝不能拿 id 当数组下标。 稀疏 id 是隐形炸弹,一旦炸了就是用户进度错乱。
- 前端改动后,别忘了 Service Worker 的缓存版本号。 否则你自己测着正常,用户手机上永远是旧版本。
以及一条最实际的:桌面端通过 ≠ 能用。朗读哑火、音标不显示,这两个问题在电脑上永远复现不了,必须上真机、进微信里点。
本文提到的词库来自公开开源数据,仅用于个人学习用途。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号