我用一张 API 账单,扒开 WorkBuddy 的 token 黑洞,对比codex消耗多数十倍

我用一张 API 账单,扒开 WorkBuddy 的 token 黑洞,对比codex消耗多数十倍

瑭宋元
发布于 2026-09-17 20:36:03
发布于 2026-09-17 20:36:03
600 条请求 · 17.8 小时 · 94.7% 都被「复读」了
同样调用GPT模型,WorkBuddy实际消耗是codex的数十倍。
一张 API 网关导出的 CSV,600 条记录,时间线一拉——8 月 17 日 17:00 之前是 Codex 客户端,17:00 之后切到 WorkBuddy。两段数据的差距,不是「用户变活跃了」能解释的,是 token 消耗机制层面的差距。今天我把这张账单拆开给你看。
01现场还原:一张账单的 600 条切片
账单里有 17 个字段:时间、API Key、模型、Reasoning Effort、端点、IP、类型、计费模式、输入 Token、输出 Token、缓存读取 Token、缓存创建 Token、倍率、计费、原始费用、首字延迟、请求时长。
我先按时间切一刀:8 月 17 日 17:00 之前 = 45 条 = Codex;17:00 之后 = 555 条 = WorkBuddy。
指标 | Codex (45 条 / 1.8h) | WorkBuddy (555 条 / 17.8h) | 倍率 |
|---|---|---|---|
请求次数 | 45 | 555 | 12.3× |
输入 Token | 33.3 万 | 264.3 万 | 7.9× |
输出 Token | 2.5 万 | 27.4 万 | 10.8× |
缓存读取 Token | 322.7 万 | 5,211.7 万 | 16.1× |
缓存创建 Token | 0 | 0 | — |
费用 | ¥1.92 | ¥44.41 | 23.1× |
上下文开销比 | 140.2× | 199.7× | +42% |
注意最后一行:缓存创建 Token = 0。600 条记录全程没有任何一次"写缓存"。
02第一刀切下去:94.7% 是什么
先看 WorkBuddy 阶段的 5,503 万 token 到底去哪儿了——
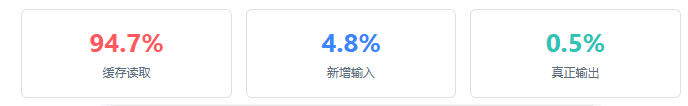
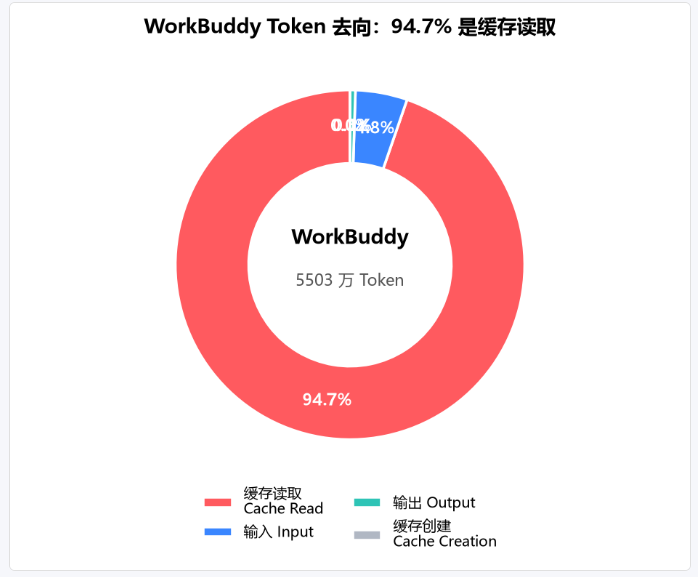
图 1:WorkBuddy 阶段 5,503 万 Token 的真实去向
说人话:你为了得到 27.4 万 token 的"实际产出",付出了 5,503 万 token 的账单。其中真正"新写进去"的只有 264 万,剩下 5,211 万是把历史上下文重新读了一遍又一遍。
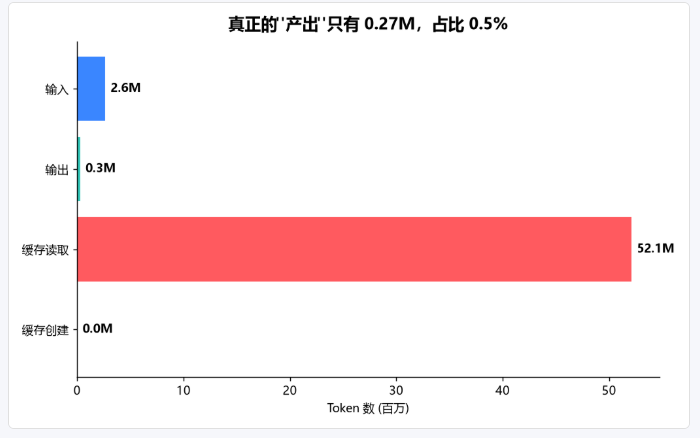
图 2:左边那个小绿条,是 WorkBuddy 真正"输出"的 token 数
03致命点 1:每一步复读 10 万 token
把 555 次请求的「单次缓存读取 Token」画成直方图——
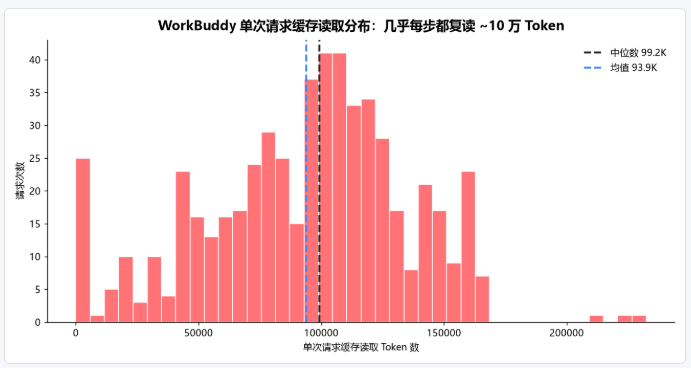
图 3:单次请求缓存读取 Token 分布(WorkBuddy 555 次请求)
中位数 99,200 token,均值 93,905 token,最大单次 232,448 token。
这不是个别尖刺,是几乎每一次请求都集中在 8 万~12 万 token 这个区间。换句话说:WorkBuddy 在它的 agentic 循环里,几乎每一步都把一段近 10 万 token 的历史上下文当作"缓存"重新喂回模型。这个动作每一步都在发生。
04致命点 2:上下文开销比 200:1
我把每次请求的 (输入 + 缓存读取) / 输出 算成"开销比"——即「每产出 1 token 有效输出,要喂回多少 token 上下文」。
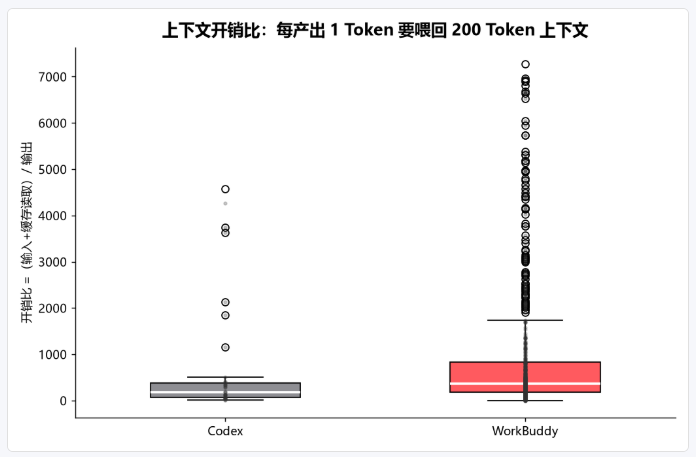
图 4:上下文开销比分布(Codex vs WorkBuddy)
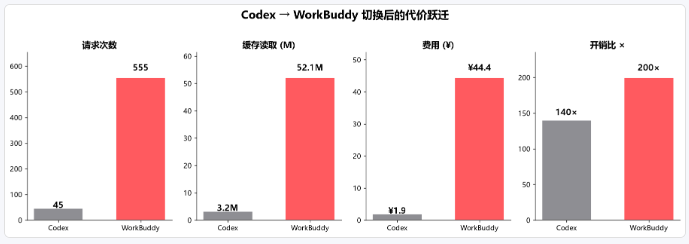
图 5:Codex → WorkBuddy 的代价跃迁
Codex 阶段中位开销比 140×,WorkBuddy 阶段中位 200×,最高 7000×。也就是说:你看到的 1 句回答,背后是模型"读"了 200 份同样大小的上下文。
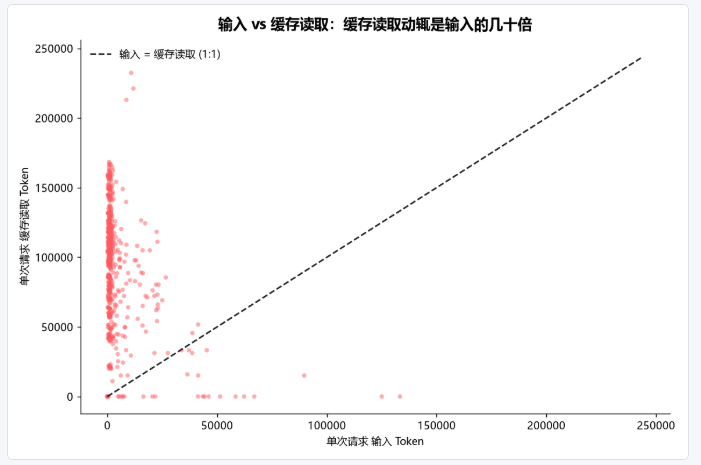
图 6:每个红点是一次请求,纵轴是缓存读取、横轴是输入
05致命点 3:缓存创建 = 0,机制层面的问题
在主流的 prompt cache 设计里,正确的姿势是:把稳定的"系统提示 + 工具定义 + 历史"作为前缀,写一次缓存(cache_creation,记一次费),之后每一步都从这份缓存里读(cache_read,0.1× 价)。
写一次缓存→多次读 0.1×→省下 90%
但是 WorkBuddy 这 555 次请求,cache_creation 全程为 0。也就是说,它没有写过任何一次稳定前缀缓存,但每一步都在从某个"已存在的缓存"里读 10 万 token。
可能的解释有两种——
A前缀不稳定
每次对话前缀都在变(系统提示、工具定义、压缩策略变化),导致命中失败、退化成"全量复读"。
B设计上就没做
把"长上下文"当核心卖点,反而不愿意做 prefix cache,因为做 cache 会让"上下文窗口"变短。
无论是哪种,结果都一样:5,211 万次"被读的"上下文 token,一分钱没省。
06代价的燃烧曲线:17.8 小时烧掉 ¥44
把 555 次请求按时间排序画成累计费用曲线——
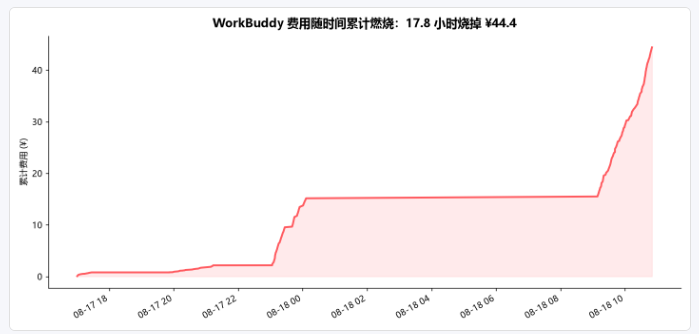
图 7:WorkBuddy 累计费用随时钟燃烧(17.8 小时烧掉 ¥44.4)
三条肉眼可见的「台阶」:傍晚 17:00~19:00 慢烧(几次小任务),午夜 23:00~00:00 跃升(一次长任务连烧 6 块),凌晨 8:00~10:50 二次攀升(又是长任务,连烧 28 块)。最长一次单请求耗时 225 秒(3 分 45 秒),单次读取 232,448 token。
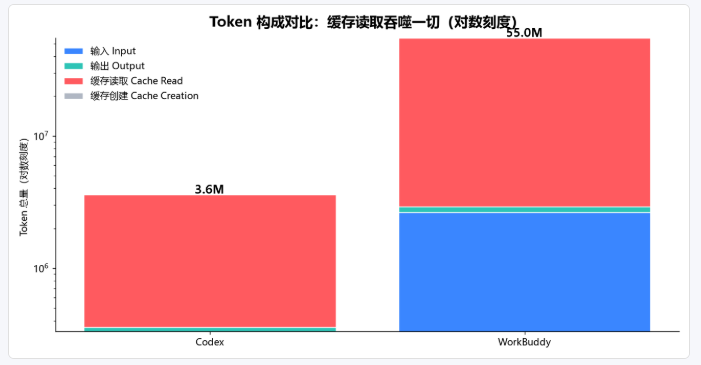
图 8:把 Codex 和 WorkBuddy 摆在一起看(对数刻度)
07对比 Codex:不是 12%,是 2300%
把同一把尺套在 17:00 之前的 Codex 阶段:45 次请求 / 1.8 小时 / ¥1.92 / 缓存读取 3.2M token。
切到 WorkBuddy 之后:请求数 ×12.3、缓存读取 ×16.1、费用 ×23.1。如果按「同等任务量」归一化,这个差值还会更刺眼——WorkBuddy 单位任务的 token 消耗,大约是 Codex 的 2 倍,而且这只是「同一个用户、同一台机器、同一组 API 路由」下的对比。
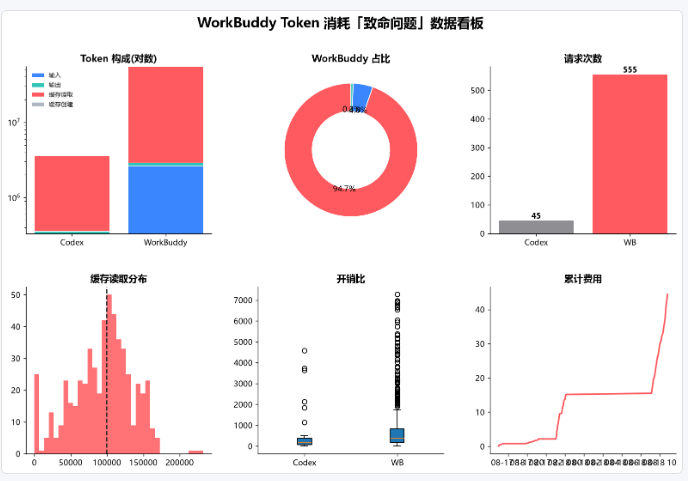
图 9:一图汇总——这张图你存一下,下次谁跟你说"AI 编码工具差不多"你就发给他
Ⅱ致命问题二:效率崩塌 —— 不是贵,是慢且少
前面说的都是「钱」(token 烧得贵),但更扎心的是「量」。我回头数了一下我这两段实际完成了多少任务——Codex 阶段干完了 4 个任务,WorkBuddy 阶段只干完了 2 个。
同样的用户,同样的机器,同样的 API 路由。WorkBuddy 用 12 倍的请求数,只完成了 Codex 一半的任务。
效率指标 | Codex | WorkBuddy | 差距 |
|---|---|---|---|
请求次数 | 45 | 555 | × 12.3 |
完成任务数 | 4 个 | 2 个 | −50% |
每任务请求数 | 11.2 次 | 277.5 次 | × 24.7 |
运行时长 | 1.8 h | 17.8 h | × 9.9 |
每任务费用 | ¥0.48 | ¥22.2 | × 46.3 |
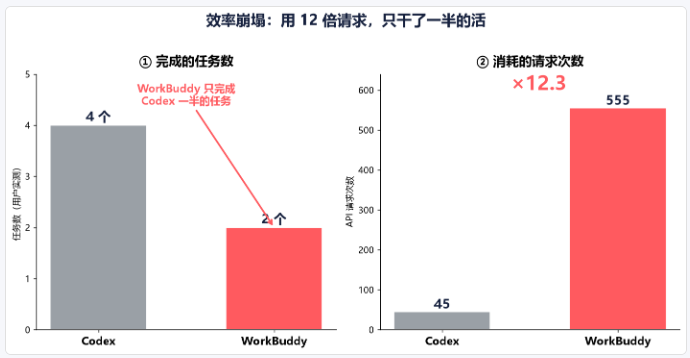
图 10:用 12 倍请求,只干了一半的活
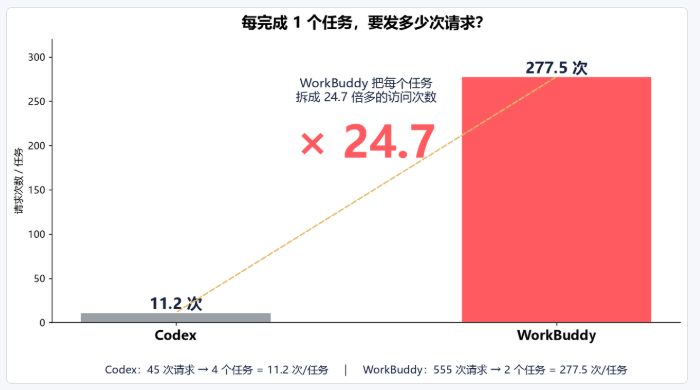
图 11:每个任务被拆成 24.7 倍多的访问次数
「拆解了太多访问次数」不是用户感受,是账单上的事实。WorkBuddy 走的是 agentic 多轮细粒度路线:每一步都问一次模型、每一步都把近 10 万 token 上下文喂回去、每一步都按 0.1× 价「缓存读」计费。一轮一烧,277 轮烧一棵树。
把两个致命问题串起来看,根因其实是同一件事:WorkBuddy 的循环是「细粒度多轮」,所以
每轮的「分母」(输出 token)很小,但每轮的「分子」(上下文)巨大 → 开销比 200×(致命点 2)
每轮都要重新读 10 万 token 历史 → 缓存读取占总 token 94.7%(致命点 1)
从不写一次稳定的 prefix 缓存 → cache_creation = 0(致命点 3)
把 1 个任务拆成 277 轮 → 完成 2 个任务,12× 请求数(致命问题二)
Codex 像一个「少轮多写」的工程师,11 次请求干完 4 个任务;WorkBuddy 像一个「多轮细问」的产品经理,277 次请求还在问用户想不想继续。AI 不是变笨了,是把同一个问题,用 24 倍的次数,重复读了 24 倍的上下文。
08为什么 WorkBuddy 会这样
Agentic 工具的标准循环是:观察 → 思考 → 工具调用 → 观察结果 → 再思考 → 再调用 ……每一步都依赖前面所有步骤的「事实」。如果不做 prefix cache,每一步都要把整段历史 + 工具结果 + 系统提示重新塞回模型,Token 雪崩就是必然。
系统提示→+ 工具定义→+ 全部历史→+ 工具结果→= 10万+ Token
Codex 之所以开销比低一些,是因为它倾向于"少轮多写"——一轮里把多步推理合并,让一次请求输出更多有效 token,所以分母(输出)大、开销比反而好看。WorkBuddy 走的是"多轮细粒度"路线,每轮输出小、但每轮都要复读 10 万 token,分母小,分子大,开销比自然失控。
09普通人怎么避坑
1盯住 cache_creation 比例
如果 cache_creation / (cache_creation + cache_read) 长期低于 1%,说明根本没在写缓存,只是在反复读,赶紧换工具或换客户端。
2挑支持 prefix cache 的客户端
Claude 系列原生的 prompt cache、OpenAI 的 cached input、字节豆包 / DeepSeek 的 KV 缓存,都比"全量复读"省一个数量级。
3拆任务,别让单会话无限膨胀
一个会话跑到 200 轮以上,token 复用率一定下降。把大任务切成 3-5 个小任务分别跑。
4设单次预算告警
在 API 网关里给单次请求设上限(比如 200K token),超过就自动熔断,避免 225 秒那种"沉默烧钱"。
5对比实验别只看输出长度
看「开销比」和「缓存命中率」,不要被表面的"它帮写了 200 行代码"迷惑。
"AI 帮我干活"从来不是免费的。每一句"已为您完成",背后都是几万到几十万的 token 在悄悄燃烧。WorkBuddy 把这个账单摊在了阳光下,但账单本身揭示的问题,是这一代 agentic 工具的通病。
结语:数据不撒谎
一次看似顺滑的"AI 帮我干活",背后是94.7% 的重复 token 燃烧,加上每个任务被拆成 24.7 倍的访问次数。这不是 WorkBuddy 一家的问题,但它最直白地把账单摊在了阳光下——12.3× 的请求数、×24.7 的每任务访问、16× 的缓存读取、200× 的开销比,都在告诉你同一件事: agentic 工具的 token 经济模型,还没到及格线。
本文所有数据均来自自用 API 网关导出的 CSV 账单(600 条),切分依据是 8/17 17:00 的客户端切换。没有臆造任何数字,所有图都可以在原文中复现。如果你想验证,把任意一段截图发我,我把整张表回传给你。
数据来源:自用 API 网关账单 CSV (600 条) · 切分依据:8/17 17:00 客户端切换 · 图文:瑭宋元 · 公众号「瑭宋元」
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-18,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号