拆解字节开源 DeerFlow:查资料写报告这件事,Agent 真能全自动了
原创
拆解字节开源 DeerFlow:查资料写报告这件事,Agent 真能全自动了
原创
大盘鸡拌面
发布于 2026-09-17 22:47:46
发布于 2026-09-17 22:47:46
上个月有个朋友让我帮他调研一个行业,我打开浏览器搜了俩小时,关了十几个标签页,最后写出来一份他自己都不想看的总结。同一个周末,我把字节开源的 DeerFlow 翻了一遍,跑了一个类似的调研任务,Agent 自己拆任务、自己搜资料、自己跑数据、自己成稿——我在旁边就干了一件事:确认了一下它的研究计划。
这篇文章就把 DeerFlow 从架构到源码、从部署到二次开发,掰开揉碎讲一遍。我尽量不整那些"赋能""闭环"之类的大词,就讲这个东西是怎么干活的、哪里好用、哪里硌手。
一、DeerFlow 到底是个啥
一句话:字节开源的"深度研究"(Deep Research)多智能体框架。你可以把它理解成 OpenAI 那个 Deep Research 功能的开源平替——你丢给它一个研究主题,它自己规划怎么查、去哪查、要不要写代码分析数据,最后吐给你一份带引用来源的研究报告。
几个关键标签先摆出来:
- 字节出品,GitHub 上 bytedance/deer-flow,星标涨得飞快
- 基于 LangGraph 构建,状态机和流程编排都是标准玩法,二次开发门槛不高
- LLM 无关,OpenAI 兼容接口的模型都能接,DeepSeek、Qwen 这些国产模型也行
- 工具生态:Tavily / Brave / DuckDuckGo / arXiv 搜索、Jina 爬虫、Python REPL 代码执行,还支持 MCP 接入
- 前后端齐全:FastAPI 后端 + Next.js 前端,SSE 流式输出,前端能实时看到 Agent 干到哪一步了
说白了,它解决的就是我朋友那个需求:把"查资料 → 筛信息 → 做分析 → 写报告"这条流水线自动化。而它的架构设计,正是整篇文章最值得聊的部分。
二、整体架构:五个角色的流水线
DeerFlow 的核心是五个角色分工的流水线,每个角色职责非常克制。先上架构图(这张图我特意上了色,后面每张图都是,方便对着看):
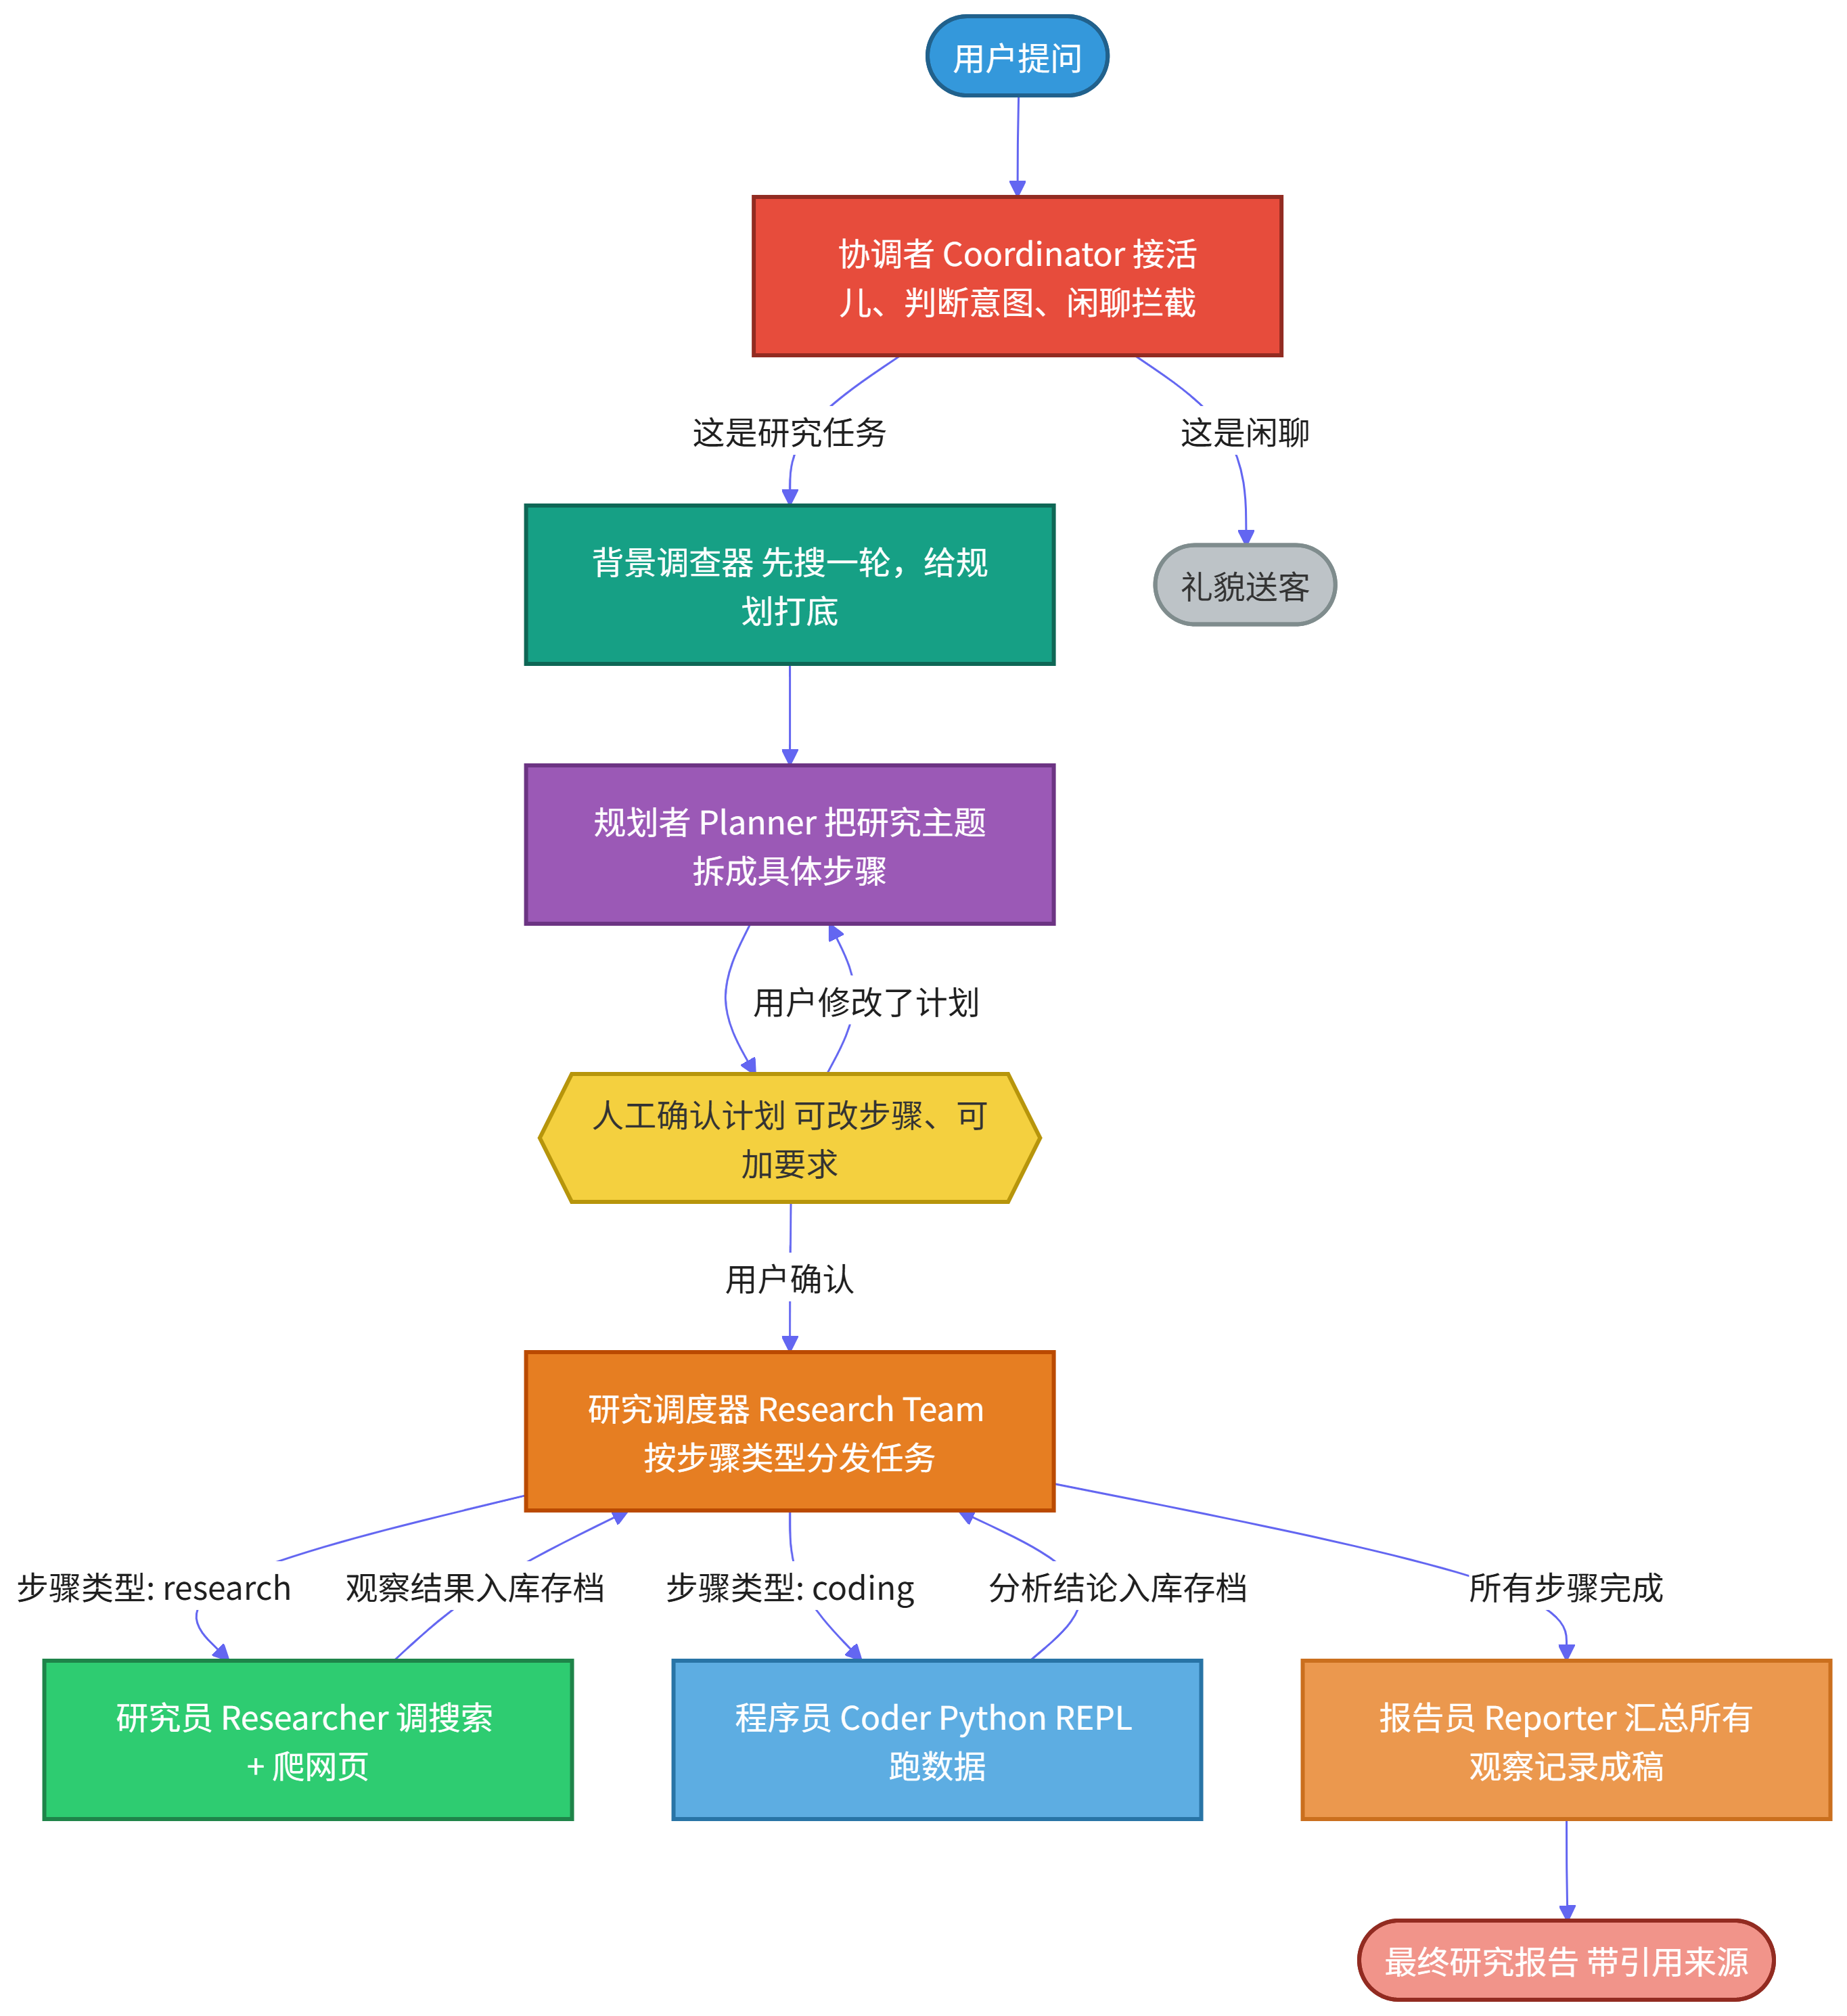
我对这套设计有两个观感:
第一,它克制。 没有一上来就搞十几个 Agent 互相喊话的"多智能体宇宙",就是一条清晰的流水线。协调者只管分流,规划者只管拆解,研究员和程序员只管执行,报告员只管成稿。每个角色一个 LLM 调用上下文,不会出现"六个 Agent 开会讨论了半小时谁也没干活"的场面。
第二,人卡在关键位置。 规划者拆完任务后有个 human_feedback 节点,计划先给你看,你可以改步骤、加要求,确认了才往下跑。这个设计非常实用——AI 拆任务十次里有三次会跑偏,与其让它错着跑完浪费几十万 token,不如花十秒钟看一眼计划。
三、源码级拆解:状态和图是怎么转起来的
3.1 状态定义:一个 State 串起全场
DeerFlow 用 LangGraph 的 StateGraph 管理整个流程,所有角色的产出都写进同一个 State。简化后的核心字段长这样:
from typing import Annotated, Sequence, TypedDict
from langchain_core.messages import BaseMessage
from langgraph.graph.message import add_messages
import operator


class Plan(TypedDict):
    """研究计划:由规划者生成,人工可编辑"""
    locale: str                      # 输出语言
    has_enough_context: bool         # 信息是否足够,不够就继续规划
    thought: str                     # 规划思路
    title: str                       # 报告标题
    steps: list                      # 步骤列表,每步有执行说明

class Step(TypedDict):
    """单个研究步骤"""
    need_search: bool                # 是否需要联网搜索
    title: str                       # 步骤标题
    description: str                 # 执行说明
    step_type: str                   # research / processing
    execution_res: str               # 执行结果(研究员/程序员回填)


class State(TypedDict):
    """全局状态:五个角色共享的工作台"""
    messages: Annotated[Sequence[BaseMessage], add_messages]

    # 流程控制
    goto: str                        # 下一跳节点
    locale: str

    # 研究主题相关
    research_topic: str              # 用户的研究主题
    background_investigation_results: str   # 背景调查结果
    plan: Plan                       # 研究计划
    observations: Annotated[list, operator.add]  # 观察记录,只增不减
重点看 observations 这个字段,用的 operator.add 注解——它只增不减。研究员每次搜索的结果、程序员每次跑代码的结论,都追加进去。最后报告员写稿的时候,手里拿的就是这一整包观察记录。这个设计简单粗暴,但意味着上下文会随着研究深入不断膨胀,后面踩坑部分我会展开讲。
3.2 图的构建:一张图定死流程
src/graph/builder.py 里的图构建逻辑,简化后是这样:
from langgraph.graph import StateGraph, START, END
from src.graph.types import State
from src.graph.nodes import (
    coordinator_node,
    background_investigation_node,
    planner_node,
    human_feedback_node,
    research_team_node,
    researcher_node,
    coder_node,
    reporter_node,
)


def _build_graph() -> StateGraph:
    builder = StateGraph(State)

    # 注册节点:五个角色 + 背景调查 + 人工确认
    builder.add_node("coordinator", coordinator_node)
    builder.add_node("background_investigator", background_investigation_node)
    builder.add_node("planner", planner_node)
    builder.add_node("human_feedback", human_feedback_node)
    builder.add_node("research_team", research_team_node)
    builder.add_node("researcher", researcher_node)
    builder.add_node("coder", coder_node)
    builder.add_node("reporter", reporter_node)

    # 连线
    builder.add_edge(START, "coordinator")

    # 协调者分流:闲聊直接结束,研究任务进背景调查
    builder.add_conditional_edges(
        "coordinator",
        lambda state: state["goto"],
        ["background_investigator", END],
    )

    # 背景调查 → 规划
    builder.add_edge("background_investigator", "planner")

    # 规划 → 人工确认(interrupt_before 是关键!)
    builder.add_edge("planner", "human_feedback")

    # 人工确认 → 研究调度器
    builder.add_edge("human_feedback", "research_team")

    # 核心循环:调度器根据步骤类型,派给研究员或程序员
    builder.add_conditional_edges(
        "research_team",
        lambda state: state["goto"],   # research / coder / reporter
        ["researcher", "coder", "reporter"],
    )

    # 研究员/程序员干完活,回到调度器看还有没有下一步
    builder.add_edge("researcher", "research_team")
    builder.add_edge("coder", "research_team")

    # 全部完成 → 报告员 → 结束
    builder.add_edge("reporter", END)

    return builder


# 编译图。interrupt_before 让流程在 human_feedback 前暂停,
# 等用户确认计划后再继续——这就是"人机协同"的实现方式
graph = _build_graph().compile(checkpointer=memory, interrupt_before=["human_feedback"])interrupt_before=["human_feedback"] 这一行值得单独说:LangGraph 的中断机制,流程跑到人工确认节点前会挂起,把计划吐给前端,等用户点确认(或改完计划)再恢复执行。配合 checkpointer 做状态持久化,用户隔半小时再确认,流程也能从断点接着跑。这个模式做审批流的同学应该很眼熟。
四、人机协同的完整交互:一次研究任务的生命周期
把上面架构串起来跑一遍,一次完整研究任务的时序是这样的(不同底色对应不同阶段):
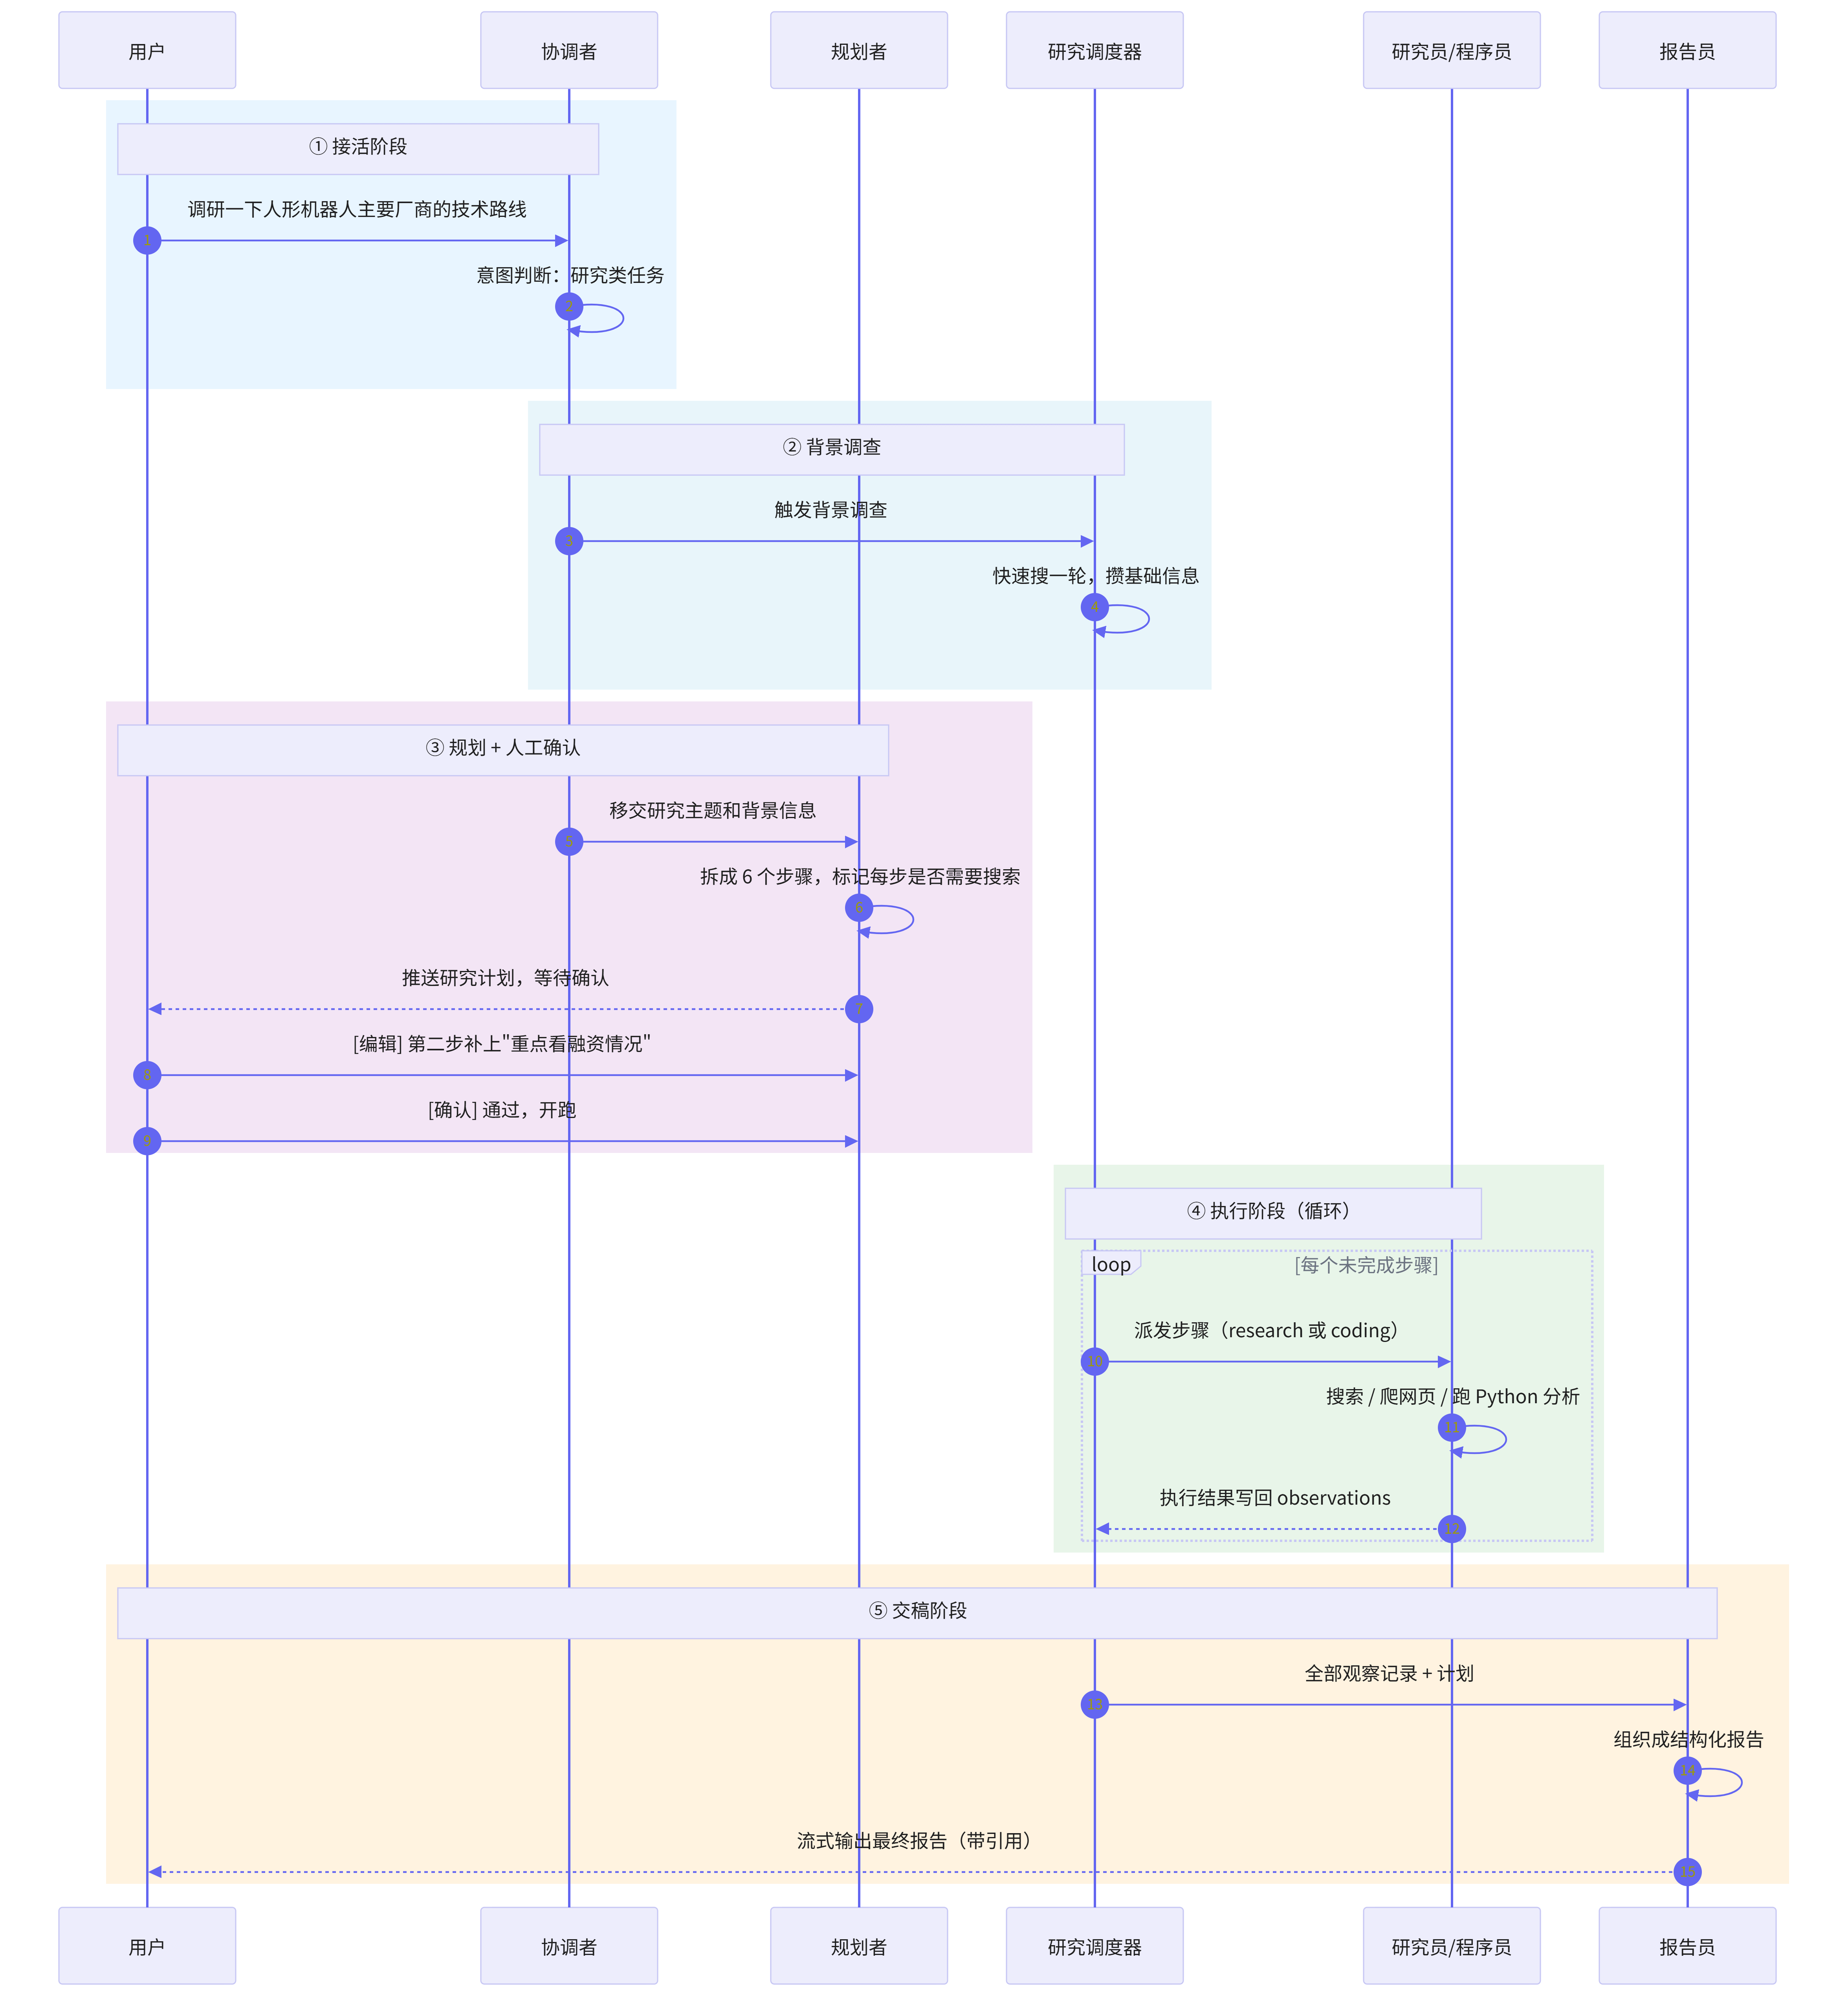
整个链路里我最喜欢的是③和④的衔接:计划是可改的,执行是透明的。前端界面上能看到每一步的执行状态、搜到了什么网页、代码跑了什么结果。出了问题能定位到具体哪一步跑偏,而不是拿到一份黑盒报告不知道哪来的。
五、执行层的两个苦力:研究员和程序员
流水线的重活都压在执行层,这两个角色的实现值得细看。
5.1 研究员:搜索 + 爬取的经典组合
研究员是一个 ReAct 模式的 Agent,手里有两个核心工具:
# 研究员的工具配置(简化)
from langgraph.prebuilt import create_react_agent
from src.tools.tavily_search import tavily_search
from src.tools.crawler import crawl_tool


def create_researcher_agent():
    prompt = """你是专业研究员。基于给定步骤执行研究:
    1. 需要信息时调用 tavily_search 搜索
    2. 搜索结果不够细,用 crawl_tool 抓取完整网页
    3. 综合多来源信息,产出带来源标注的研究发现
    4. 引用格式:使用标题和 URL 列表"""

    return create_react_agent(
        model=llm,
        tools=[tavily_search, crawl_tool],   # 搜索 + 爬虫,就这俩
        prompt=prompt,
    )
搜索工具内部做了适配层,Tavily、Brave、DuckDuckGo 换着用,接口统一:
# src/tools/tavily_search.py(简化)
from langchain_core.tools import tool
from tavily import TavilyClient

@tool
def tavily_search(query: str, search_depth: str = "advanced",
                  max_results: int = 5, topic: str = "general") -> str:
    """联网搜索工具:查询最新信息、行业动态、技术资料时使用。

    Args:
        query: 搜索关键词,尽量具体
        search_depth: basic 或 advanced
        max_results: 返回条数
        topic: general / news,新闻类查询用 news 效果更好
    """
    client = TavilyClient(api_key=TAVILY_API_KEY)
    results = client.search(
        query=query,
        search_depth=search_depth,
        max_results=max_results,
        topic=topic,
    )

    # 把结果压成模型友好的格式:标题 + 摘要 + URL
    formatted = []
    for r in results.get("results", []):
        formatted.append(
            f"标题: {r['title']}\n"
            f"摘要: {r.get('content', '')[:500]}\n"
            f"URL: {r['url']}\n"
            f"相关度: {r.get('score', 0):.2f}\n---"
        )
    return "\n".join(formatted)
5.2 程序员:能跑代码的数据分析员
Coder 角色挂的是 Python REPL 工具,涉及数据对比、计算、画图这类活儿就归它:
# src/tools/python_repl.py(简化思路)
from langchain_experimental.tools.python.tool import PythonAstREPLTool

@tool
def python_repl_tool(code: str) -> str:
    """执行 Python 代码做数据分析。可以处理前面步骤产出的
    结构化数据(表格、数值对比),返回计算结果或生成图表。

    注意:代码在受限环境中执行,无网络访问权限。"""
    # DeerFlow 的实际实现是一个持久化的 REPL 会话,
    # 变量在多次调用之间保留,方便分步处理数据
    ...
实战里 coder 的出场率取决于你的研究主题。查"厂商技术路线对比"这类定性问题,researcher 包圆了;但一旦涉及"这几家公司的营收增速对比""专利数量趋势",coder 就顶上来了——它能把前面搜到的数字抽出来,写 pandas 一跑,输出个对比表,报告员直接引用。
六、实战:从零跑通一个完整研究报告
光看架构不过瘾,来一遍完整实操。目标:让 DeerFlow 产出一份"人形机器人主要厂商技术路线与融资情况"的研究报告。
6.1 部署启动
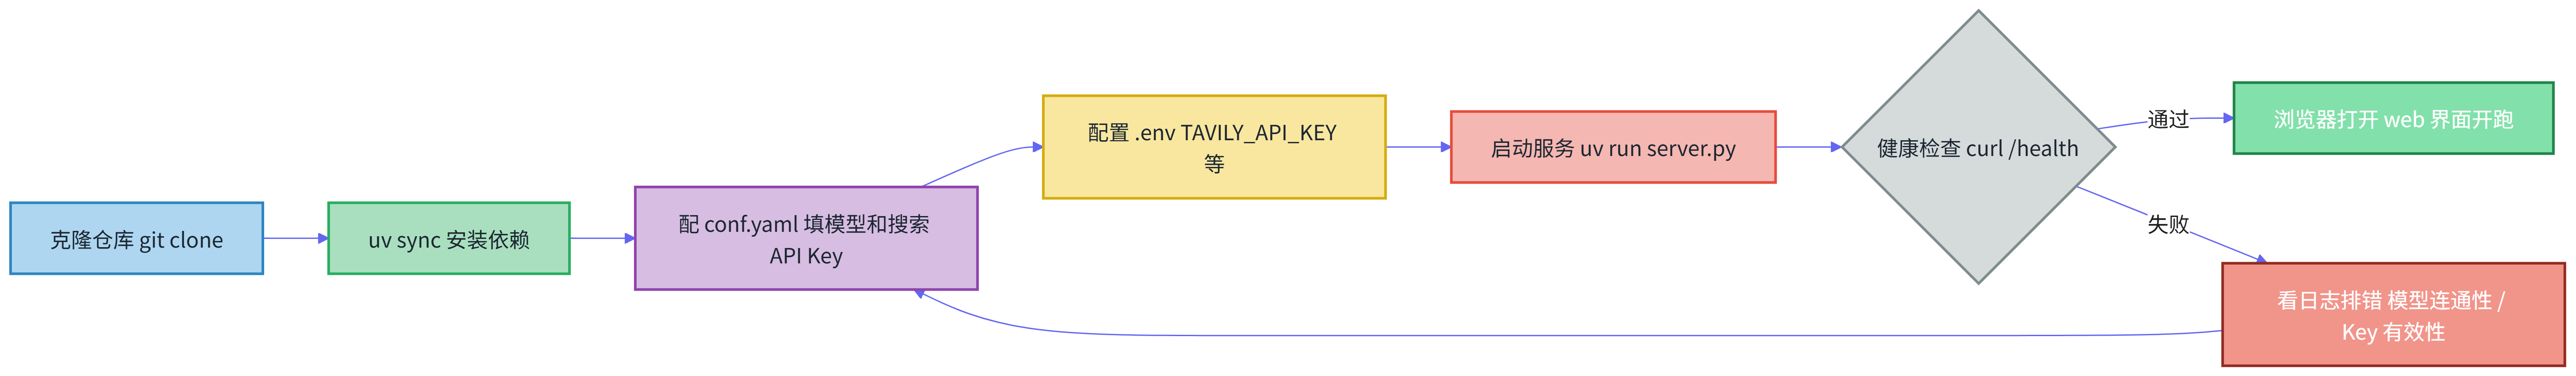
具体命令:
# 1. 克隆并安装(官方推荐 uv,依赖装得快)
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow
uv sync

# 2. 配置 LLM:复制示例配置后编辑
cp conf.yaml.example conf.yaml
# conf.yaml 关键项:
#   BASIC_MODEL:      便宜快的模型,干协调者、规划者的活
#   REASONING_MODEL:  推理强的模型,干深度研究和报告成稿

# 3. 配置搜索工具的 Key(.env)
echo "TAVILY_API_KEY=tvly-xxxxx" >> .env

# 4. 启动后端(默认 8000 端口)
uv run python server.py --port 8000

# 5. 前端(另开一个终端)
cd web && pnpm install && pnpm dev
conf.yaml 的模型分层配置是我的重点推荐——规划用快模型,成稿用强模型,成本能砍一半以上:
# conf.yaml 关键部分
BASIC_MODEL:
  base_url: "https://api.deepseek.com/v1"
  model: "deepseek-chat"          # 快、便宜,规划协调够用

REASONING_MODEL:
  base_url: "https://api.deepseek.com/v1"
  model: "deepseek-reasoner"      # 推理强,研究报告质量关键

SEARCH_API: tavily                 # 可选 tavily / brave / duckduckgo / arxiv
MAX_PLAN_STEPS: 5                  # 限制计划步数,防止规划者上头
6.2 调用 API 跑一次研究
不开前端也行,直接撸 API。DeerFlow 的接口是 SSE 流式返回,事件流里能看到计划、每步执行结果和最终报告:
curl -N -X POST http://localhost:8000/api/chat/stream \
  -H "Content-Type: application/json" \
  -d '{
    "messages": [
      {"role": "user", "content": "调研人形机器人主要厂商的技术路线差异和最新融资情况,输出中文报告"}
    ],
    "recursion_limit": 50,
    "max_plan_iterations": 2
  }'
SSE 事件流长这样(我截了真实返回的关键片段):
event: agent
data: {"node": "planner", "content": {"title": "人形机器人行业研究报告", "steps": [
  {"title": "梳理主要厂商及产品矩阵", "step_type": "research", "need_search": true},
  {"title": "对比技术路线:全尺寸/轮式/仿生关节方案", "step_type": "research", "need_search": true},
  {"title": "汇总 2024-2026 年融资事件与金额", "step_type": "research", "need_search": true},
  {"title": "量化对比:融资规模 vs 发布机型数量", "step_type": "processing", "need_search": false},
  {"title": "撰写综合报告", "step_type": "processing", "need_search": false}
]}}

event: agent
data: {"node": "researcher", "content": "步骤1执行完毕:识别出 8 家主要厂商...[含 12 个引用来源]"}

event: agent
data: {"node": "coder", "content": "已完成融资规模与机型数量的交叉对比,TOP3 为..."}

event: agent
data: {"node": "reporter", "content": "# 人形机器人行业研究报告\n\n## 一、行业概况\n..."}实测数据(deepseek-chat 规划 + deepseek-reasoner 成稿,2026 年 9 月跑的):整个任务调用搜索 14 次、爬取 6 个网页、跑 2 段分析代码,总耗时约 6 分钟,消耗 token 约 22 万,按 DeepSeek 的价格算不到 3 块钱。产出报告约 4000 字,结构完整、引用齐全。
平心而论,这份报告拿去直接交差还差点意思——细节深度不如人写两天的东西,而且有些表述还是有股子"AI 味"。但作为初稿生成器,它把 80% 的资料搜集和结构化工作干完了,你在它基础上改,效率是纯手写的三倍不止。
七、二次开发:把公司内部知识库喂给它
DeerFlow 对企业场景最有价值的改造点,是让它能搜内部资料。做法有两条路:改代码注册工具,或者走 MCP(推荐后者,不动框架源码)。
7.1 方式一:MCP 接入(推荐)
新版 DeerFlow 原生支持 MCP,在 conf.yaml 里加一段就行:
# conf.yaml 追加 MCP 配置
MCP_SERVERS:
  - name: internal-wiki
    transport: sse
    url: "http://internal-mcp.example.com/sse"
    description: "公司内部知识库搜索,包含历史项目文档、技术方案、流程规范"
配上之后,研究员的工具列表里就多了内部知识库搜索,研究计划里涉及"公司内部情况"的步骤会自动调它。
7.2 方式二:改源码注册自定义工具
想深度定制(比如内部搜索要做权限过滤),就直接写工具类注册进去:
# src/tools/internal_wiki_search.py
import os
import requests
from langchain_core.tools import tool


@tool
def internal_wiki_search(query: str, max_results: int = 5) -> str:
    """搜索公司内部知识库。当研究涉及公司内部项目、
    历史技术方案、内部流程规范时调用此工具。

    Args:
        query: 搜索关键词
        max_results: 最多返回条数
    """
    resp = requests.get(
        "http://internal-wiki.example.com/api/v1/search",
        params={"q": query, "limit": max_results},
        headers={
            "Authorization": f"Bearer {os.environ['WIKI_TOKEN']}",
            "X-User-Id": os.environ.get("CURRENT_USER", "system"),
        },
        timeout=10,
    )
    resp.raise_for_status()
    docs = resp.json().get("results", [])

    if not docs:
        return "内部知识库未找到相关内容,建议仅依赖外部公开资料。"

    formatted = []
    for d in docs:
        formatted.append(
            f"[内部文档] {d['title']} (更新于 {d['updated_at'][:10]})\n"
            f"摘要: {d['snippet'][:300]}\n"
            f"来源: {d['url']}\n---"
        )
    return "\n".join(formatted)
注册到研究员的工具列表(版本不同接入点略有差异,我这边是在 agents 构建处改的):
# src/agents/agents.py 中研究员的工具注入(简化)
from src.tools.internal_wiki_search import internal_wiki_search

research_agent = create_react_agent(
    model=llm,
    tools=[tavily_search, crawl_tool, internal_wiki_search],  # 挂上内部搜索
    prompt=researcher_prompt,
)
7.3 内外部资料混合研究的流程变化
接入内部库之后,研究员的工作流会变成"先内后外":
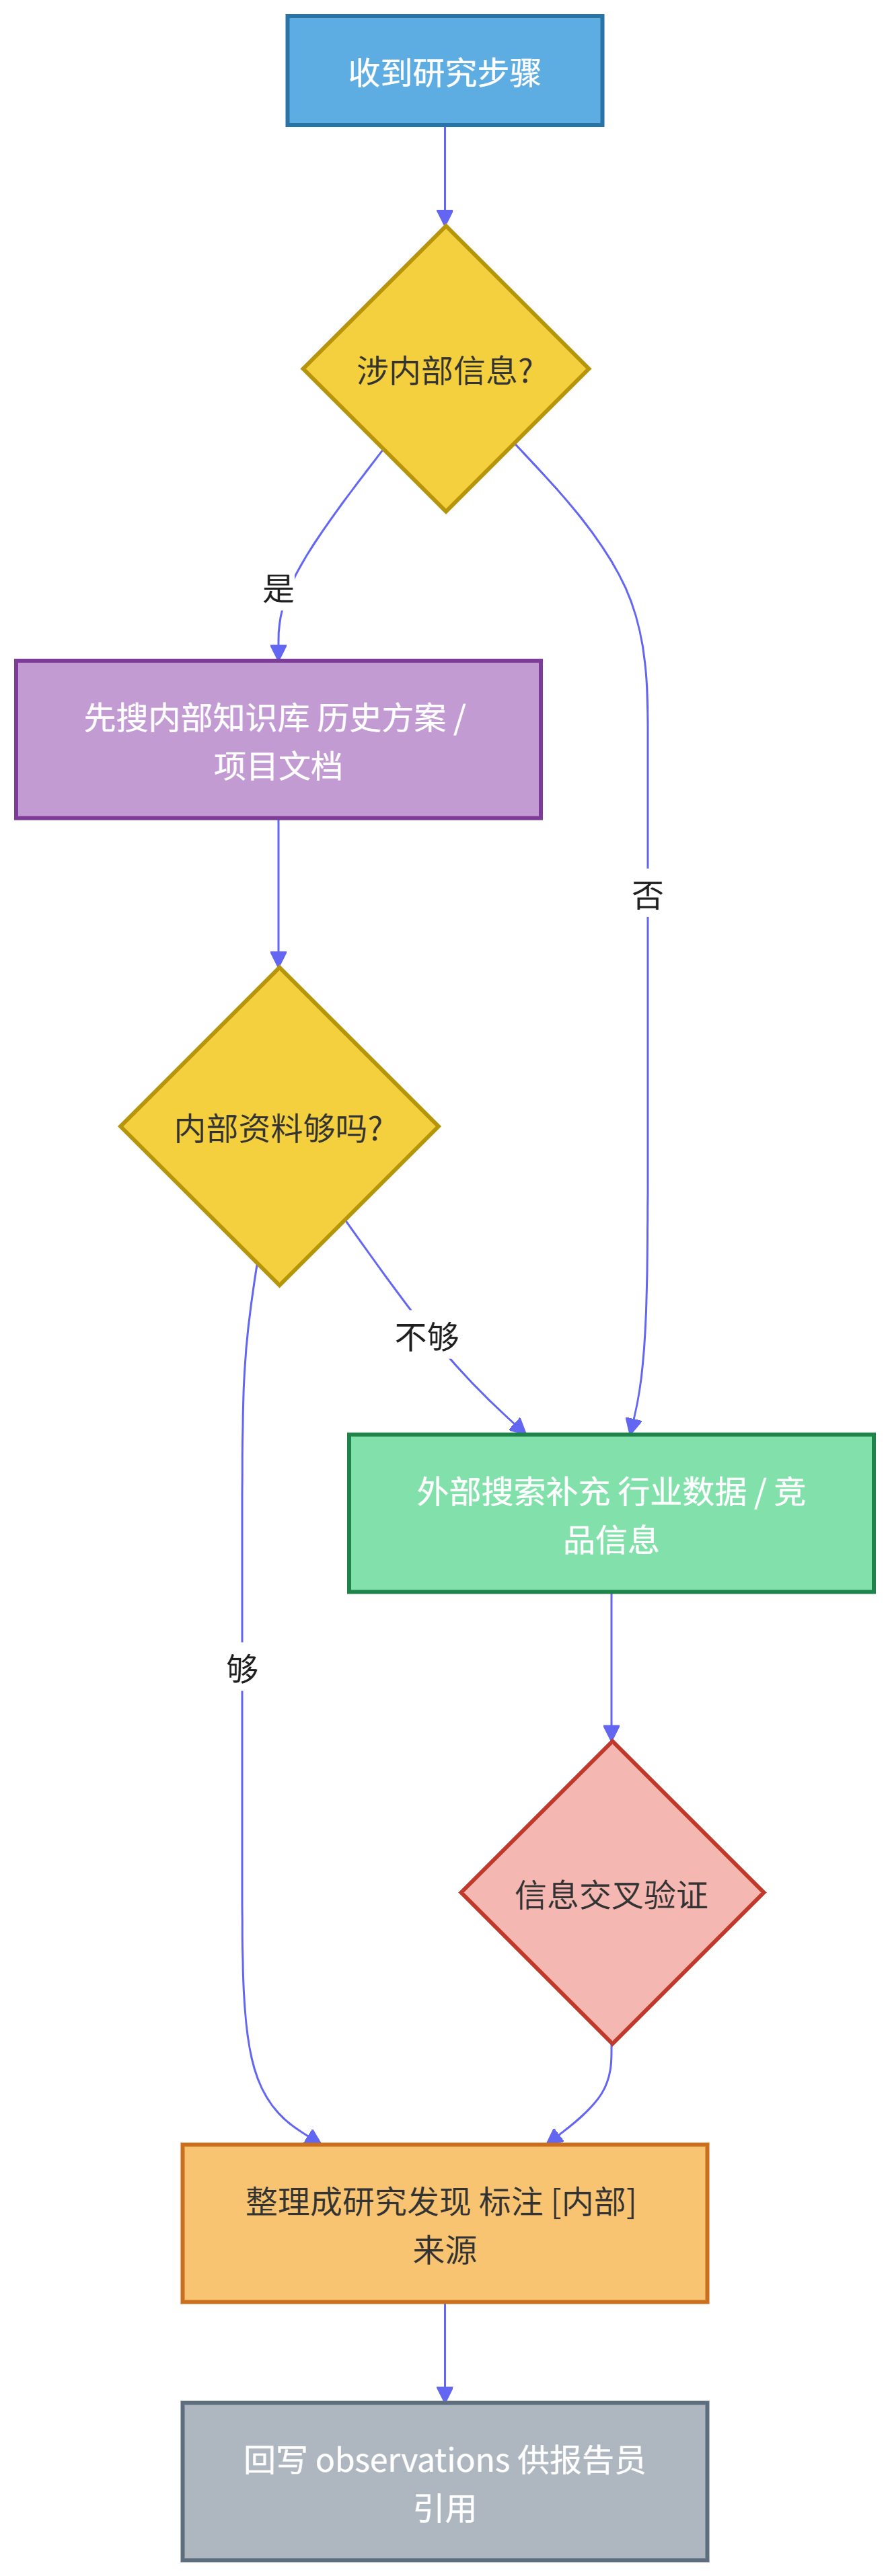
我们拿这个改造版跑过一次内部场景:"对比部门现有推荐系统和业界最新方案的差距"。内部库贡献了架构文档和历史迭代记录,外部搜索补了论文和竞品动态,两边在报告里交叉引用——这种混合研究纯靠人工干,一天起步;DeerFlow 跑一轮十五分钟,质量够写周会汇报了。
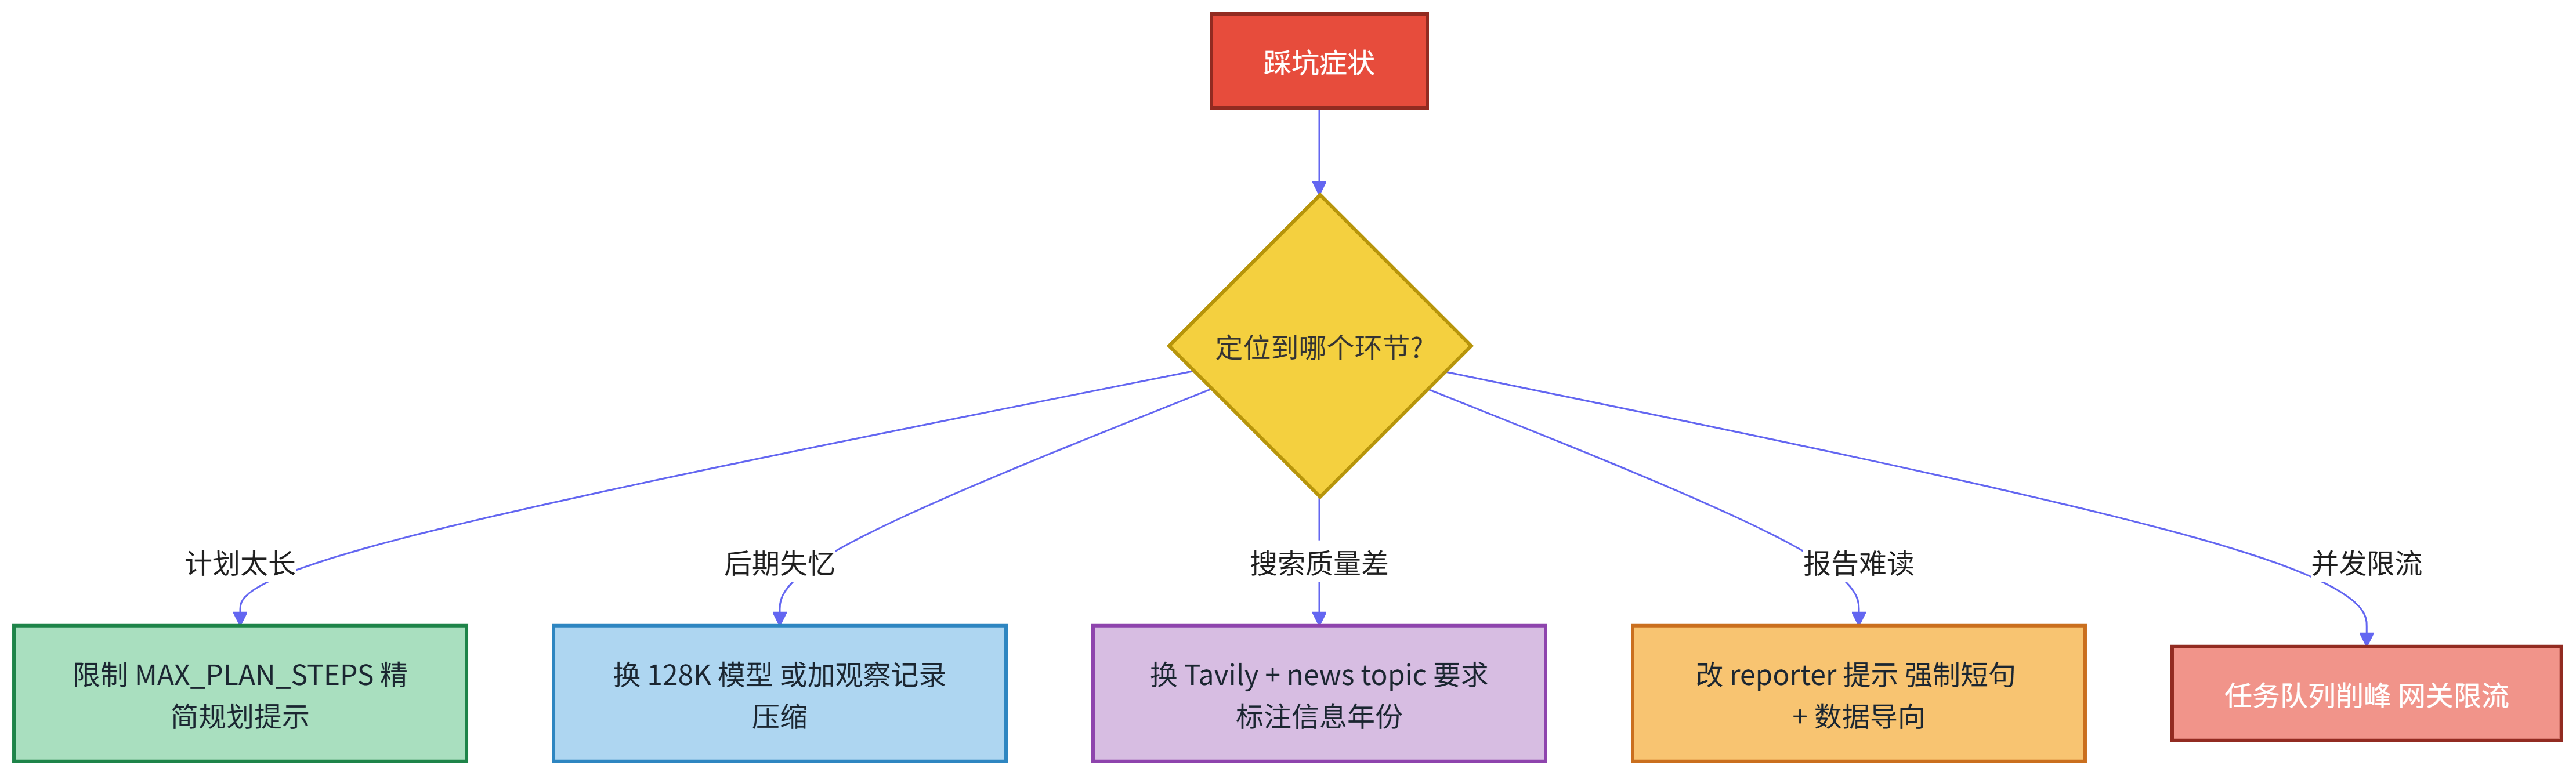
八、踩坑记录:五个血泪教训
坑一:规划者上头,一拆拆出十二步。 默认配置下,复杂主题的规划者可能拆出特别长的计划,token 烧得肉疼还容易跑偏。对策:conf.yaml 里限制 MAX_PLAN_STEPS,再在系统提示里强调"聚焦核心问题,5 步以内"。收效明显。
坑二:observations 膨胀,后期步骤吃不到早期信息。 研究跑到后半段,State 里的观察记录已经几十 K 了,部分模型上下文一紧,报告员就开始"选择性失忆"——早期搜到的关键数据在报告里消失了。对策:把 REASONING_MODEL 换成 128K 上下文的模型;或者自己加一步"观察记录压缩",在执行阶段每 3 步做一次摘要合并。
坑三:搜索噪声。 DuckDuckGo 免费但质量参差,搜"XX公司 融资"能搜出 2019 年的旧闻。预算允许就上 Tavily,topic 参数用 news 加时间过滤;对时效敏感的主题,在规划提示里要求"注明信息年份,超过两年的数据单独标注"。
坑四:报告 AI 味重。 模板感、排比句、"综上所述"满天飞。两个对策:一是改 reporter 的系统提示,明确要求"多用数据说话、短句、少用排比";二是把成稿当初稿,人工过一遍。别指望跳过人工环节,那是自欺欺人。
坑五:并发跑多个研究任务,GPU 或 API 限流顶不住。 团队几个人同时提交任务,DeepSeek API 直接 429。对策:加个任务队列做削峰,或者用网关做请求排队。这个属于运维基本功了——任何上生产的 AI 服务都一样,并发控制没做,第一天就会给你好看。
把 DeerFlow 玩了一圈之后,我的整体判断是:这是目前开源深度研究框架里,架构最干净、二次开发最顺手的之一。它没有堆砌花哨的 Agent 招式,就是老老实实把"规划-确认-执行-成稿"这条流水线做扎实,再把 LangGraph 的中断恢复、状态持久化这些基础设施用到位。
它适合谁?
- 分析师、研究员:当调研初稿生成器,省掉 80% 的资料搜集时间
- 技术团队:拿它当多智能体框架的参考实现,学 LangGraph 状态机怎么设计
- 企业:接上内部知识库,做行业+内部混合研究,竞品分析、技术调研都能提效
它不适合谁?想找"一键生成完美报告"的人——说实话这种东西不存在,AI 负责跑腿和结构化,判断和质量把控永远是人的责任。
我自己的用法是把它当"研究实习生":活儿干得快、不知道累,但交上来的东西你得亲自过目。带好这个实习生,你的产出效率是真的能翻倍的。
有兴趣的同学建议直接去撸一遍源码,src/graph/nodes/ 目录下每个节点的实现都不长,比看十篇二手解读收获大。有跑不通的地方,也欢迎交流——踩坑的路上,人多不冷清。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号