WorkBuddy 内置可选模型科研场景模型选型对照卡
原创
WorkBuddy 内置可选模型科研场景模型选型对照卡
原创
用户12771112
发布于 2026-09-18 11:13:52
发布于 2026-09-18 11:13:52
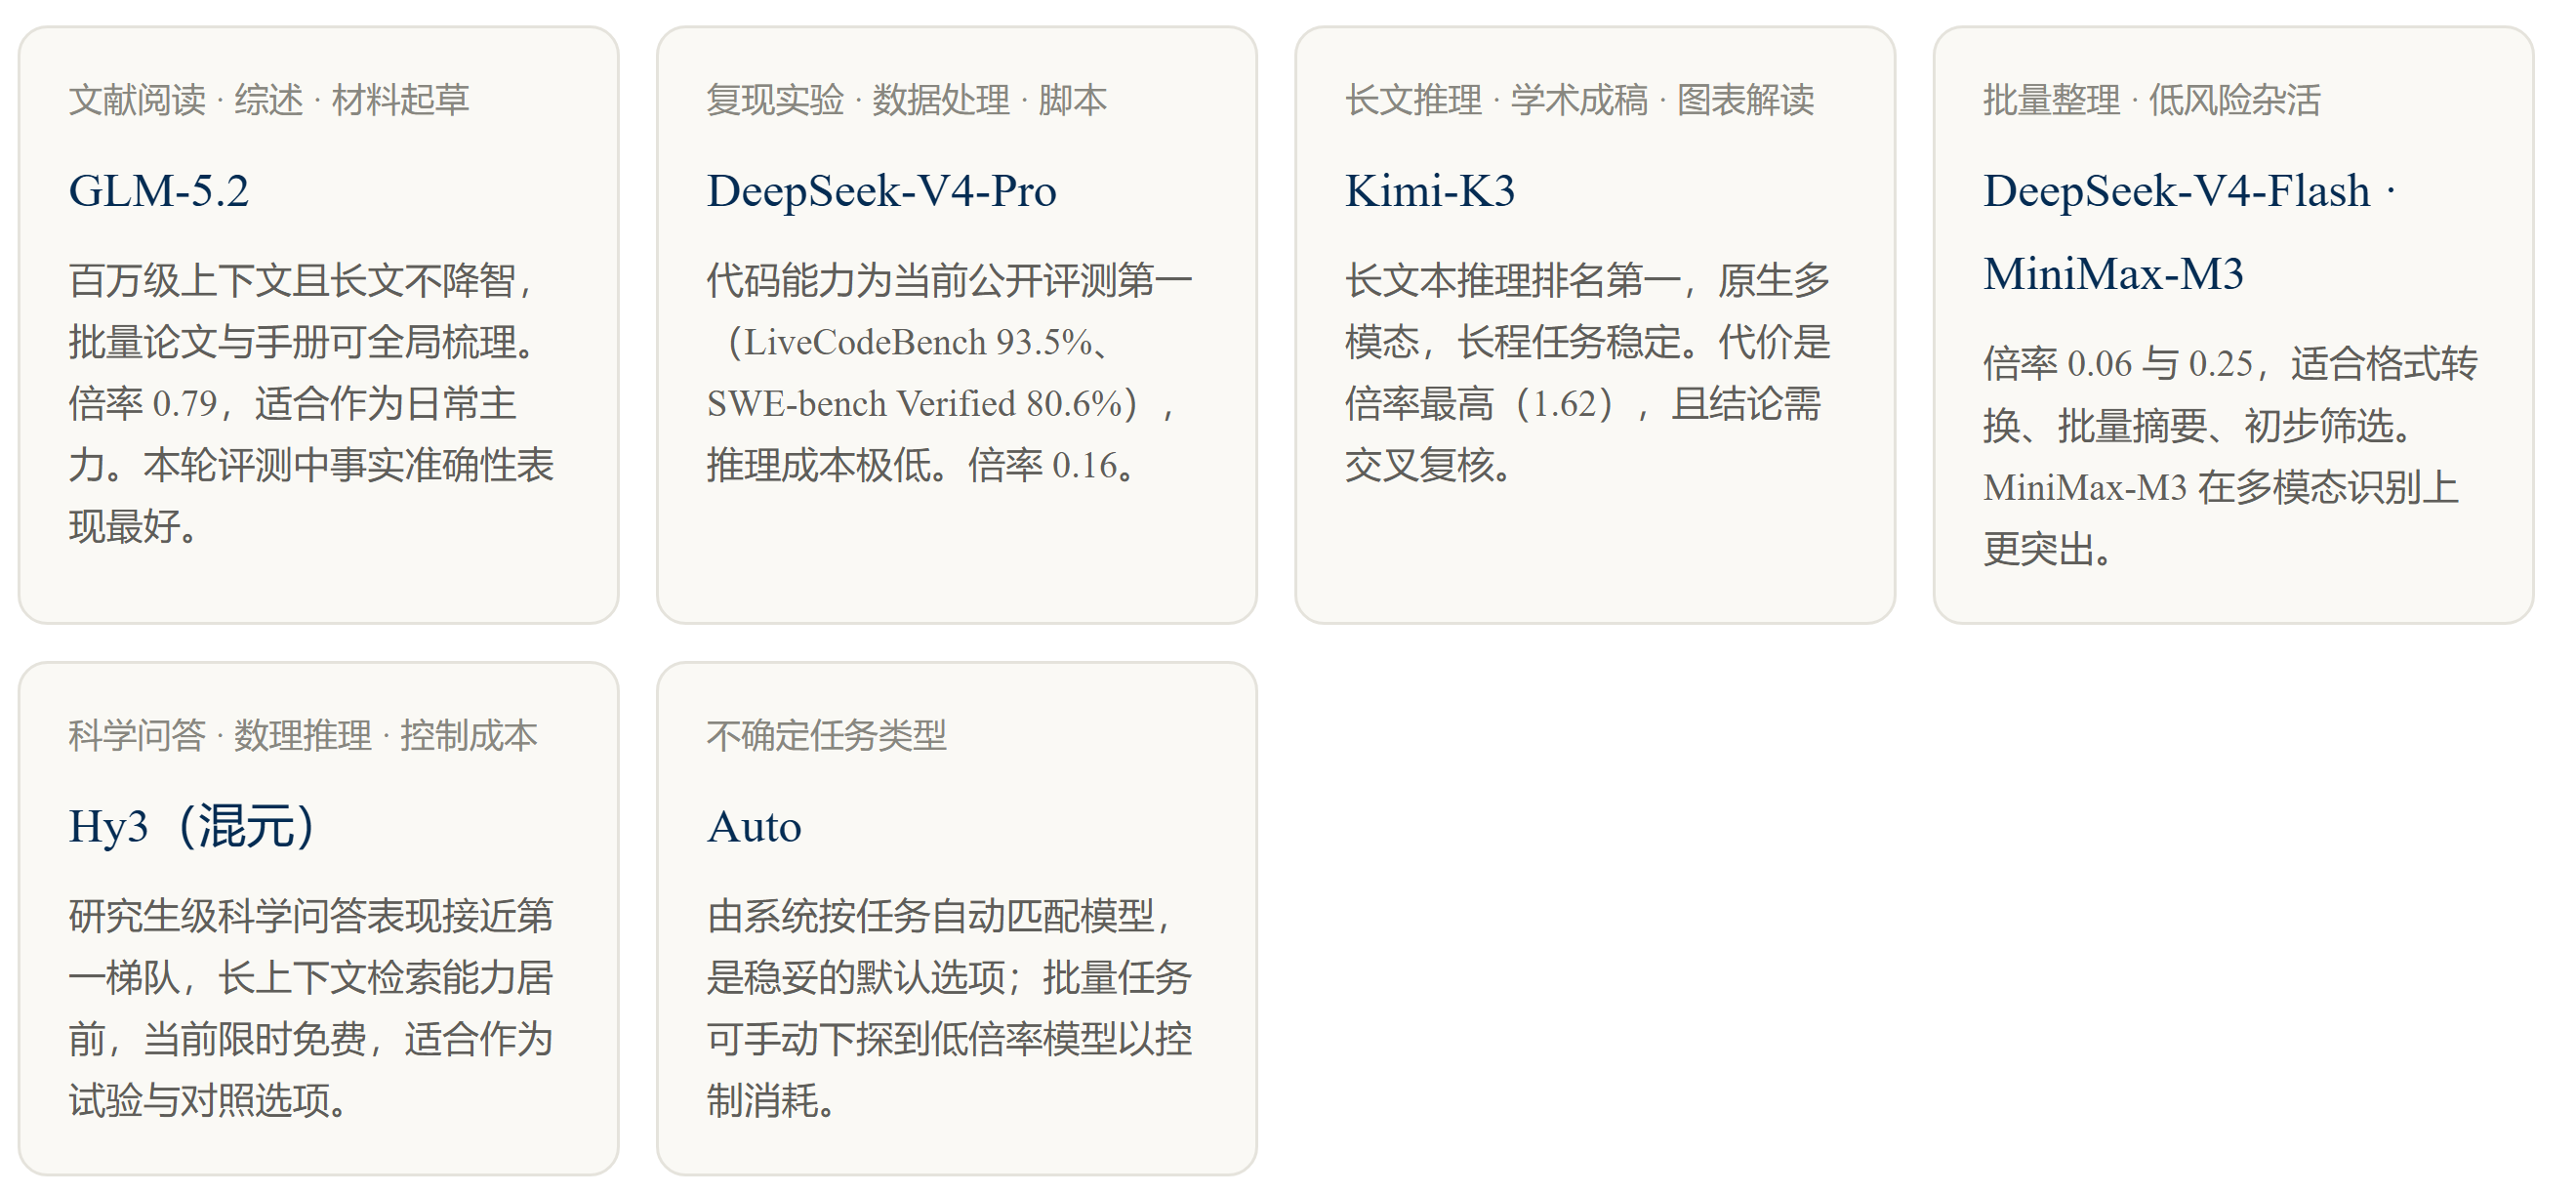
一句话结论:没有单项全胜的模型。读文献与综述用 GLM-5.2,复现与数据处理用 DeepSeek-V4-Pro,长文推理与成稿用 Kimi-K3, 而关键事实、数据与引文必须人工核验——这是本次评估中唯一没有替代方案的环节。
一、按任务维度的适配度
科研任务 | Kimi-K3x1.62 | GLM-5.2x0.79 | DeepSeek-V4-Prox0.16 | DeepSeek-V4-Flashx0.06 | Hy3 混元限时免费 | MiniMax-M3x0.25 |
|---|---|---|---|---|---|---|
长文阅读与综述 | 强 | 强 | 中 | 弱 | 中 | 弱 |
论文复现与代码 | 强 | 强 | 强 | 中 | 中 | 中 |
数据分析与统计 | 强 | 中 | 强 | 中 | 中 | 弱 |
学术写作与润色 | 强 | 中 | 中 | 弱 | 中 | 弱 |
事实准确性 | 中 | 强 | 弱 | 中 | 中 | 中 |
图表与扫描件 | 强 | 中 | 中 | 中 | 弱 | 强 |
「事实准确性」那一行才是真正的分水岭
这是本次评估中唯一没有替代方案的环节,而几个模型的差距在这里最刺眼:
- GLM-5.2 的第三方非幻觉率约 72%,高于 Claude Opus 4.8 的 64%;
- Kimi-K3 的可靠性数据自相矛盾——一家给出幻觉率 6.2%、列第一梯队,另一家给出「非幻觉率仅 49%、答得越多错得越多」。口径互相矛盾本身就是信号:不能只信好话的那一份;
- DeepSeek-V4-Pro 在 AA-Omniscience 上的幻觉率约 94%,含义是它几乎无论知不知道都会作答。这是它最适合当工具、最不适合当事实来源的根本原因。
二、分场景推荐
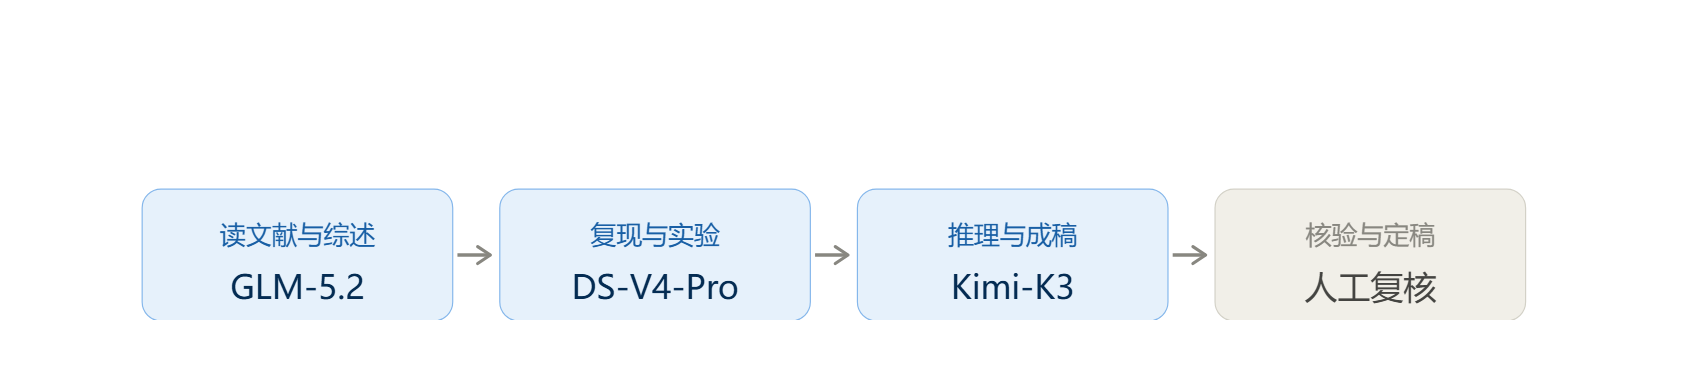
科研流程四阶段模型分工建议
三、三点必须知道的局限
- 同一模型的分数在不同来源之间差异极大。以 Kimi-K3 为例,其 GPQA Diamond 分数在不同评测中出现约 87、92.6、93.5 三个值,智力综合指数亦从第 3 名到第 4 名不等。 因此排行榜只可用于粗略分层,不可作为选型定论。
- 主流基准已接近饱和或存在污染风险。GPQA Diamond、MMLU 类知识型基准的前沿分数已压缩到噪声范围内,1 分差距约等于 2 道题,属于运行波动。 相对更有区分度的是科研类长程任务与事实校准类评测。
- 积分倍率会随产品更新变化。本卡所列倍率来自官方文档快照,实际以模型选择面板显示为准。自定义模型(含本地部署)的费用与数据处理规则由第三方决定。
方法说明:本卡为公开资料的归纳整理,不代表任何厂商官方结论。 科研场景中,模型的角色是加速理解与执行,不是结论来源;文献引用、实验数据、统计显著性判断均需回到原始文献与原始数据核对。
数据来源:Artificial Analysis 智力指数、Vellum 与 BenchLM 榜单、Epoch AI 基准分析、DeepInfra 开放权重横评、腾讯云与厂商公开技术资料,以及 WorkBuddy 官方模型选择文档。快照时间 2026 年 7–9 月。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号