一个 Agent 不够用?AutoGen 多智能体实战:让一队 AI 替你干活
原创
一个 Agent 不够用?AutoGen 多智能体实战:让一队 AI 替你干活
原创
大盘鸡拌面
发布于 2026-09-18 22:59:49
发布于 2026-09-18 22:59:49
说个扎心的事:我去年搭的运维助手,单体 Agent,Prompt 写了两千字,什么故障分析、根因定位、处置建议全塞一个脑子上。效果呢?像个"什么都会一点但什么都不精"的实习生。后来接触了 AutoGen,把一个"全能实习生"拆成一个"专家团队",效果直接上了一个台阶。这篇聊聊我的实战心得。
AutoGen 是微软开源的多智能体框架,GitHub 上 star 数早就破了几万。它解决的核心问题就一句话:让多个各司其职的 AI Agent 通过对话协作,完成单个 Agent 搞不定的复杂任务。
一、为什么单体 Agent 会撞墙?
先说说我踩过的坑。单体 Agent 处理复杂任务的典型困境:
- Prompt 越写越长——你想让它分析日志、判断根因、生成预案、写汇报,四个职责塞一个 System Prompt 里,模型注意力被稀释,哪个都干不好
- 没有"复核"环节——它说啥就是啥,没人 review 它的输出,幻觉直接漏到生产
- 上下文爆炸——一轮对话塞进日志 + 监控 + 历史工单,token 分分钟超限
打个比方:单体 Agent 就像让一个人同时当侦探、法官、消防员和书记员。不是不能干,是干不好。
多 Agent 的思路是拆角色 + 对话协作 + 互相制衡:
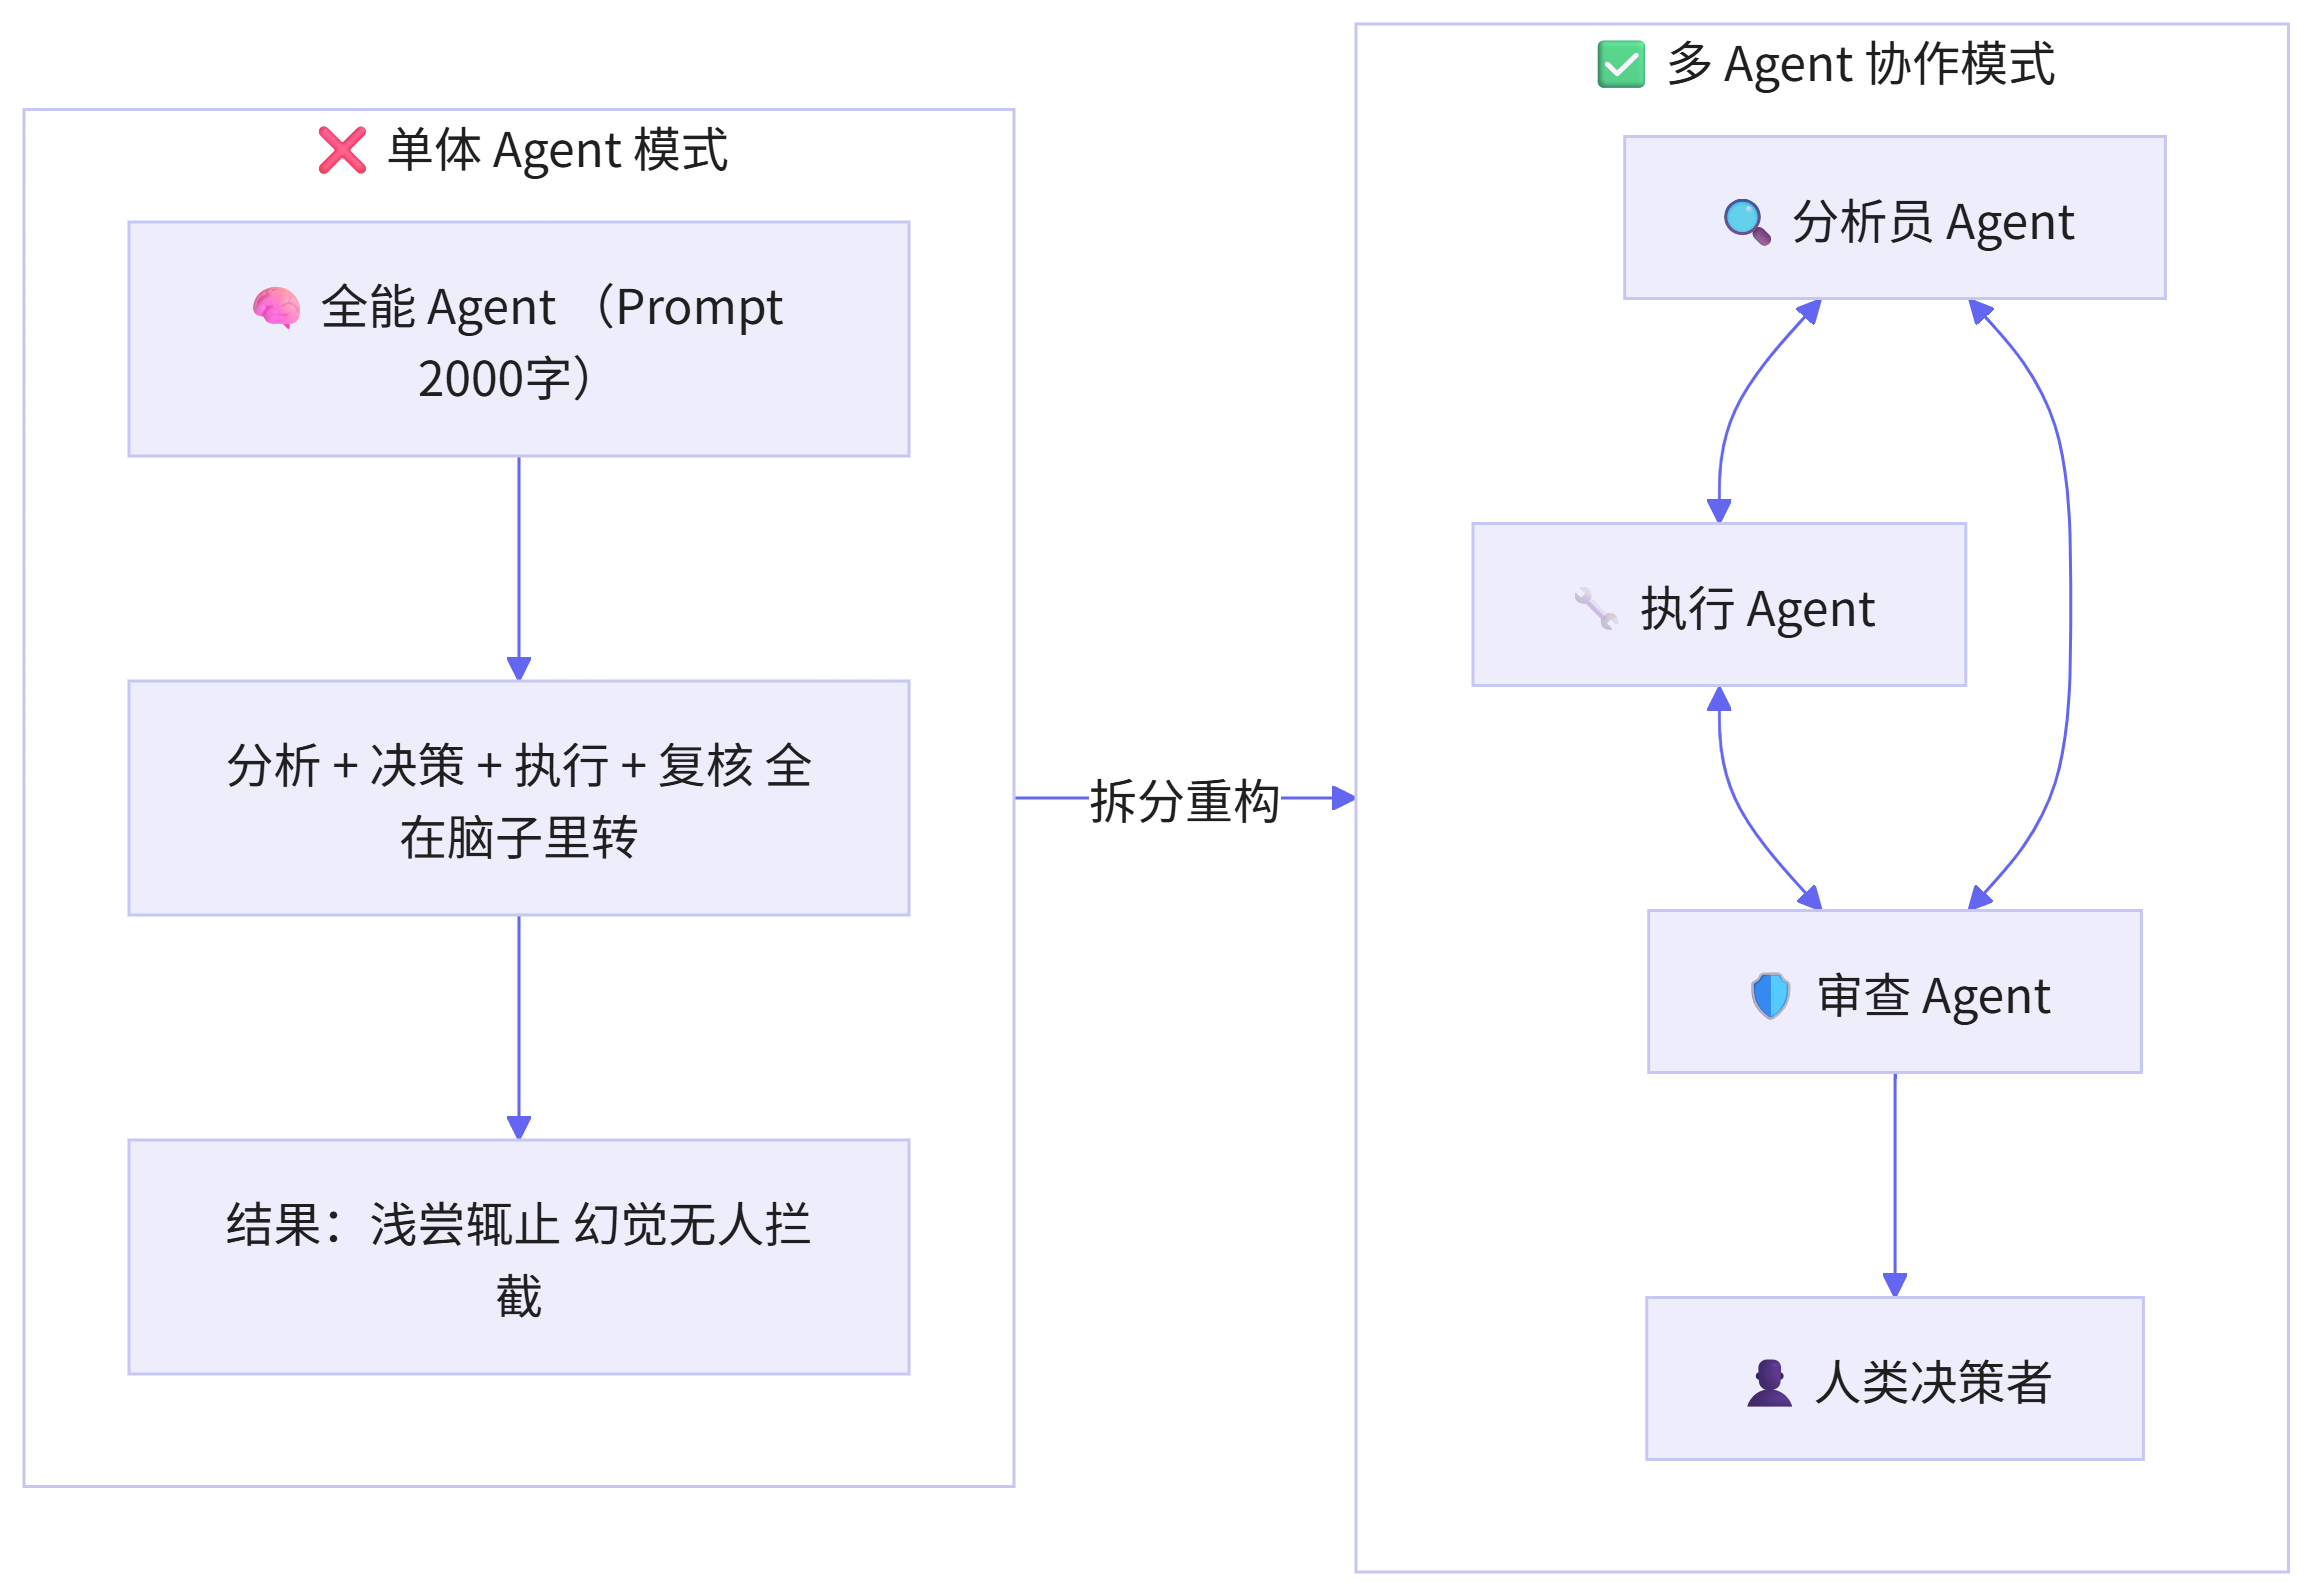
AutoGen 就是帮你把右边这套协作机制工程化的框架。
二、AutoGen 核心概念:15 分钟上手
AutoGen 里最重要的概念是 ConversableAgent(可对话智能体),顾名思义,每个 Agent 都能收消息、发消息、执行动作。两个最常用的配置项:
-
llm_config:大脑,接哪家模型 -
human_input_mode:什么时候需要人介入(NEVER / TERMINATE / ALWAYS)
来个最简单的例子——两个 Agent 对话,一个出题一个解题:
import autogen

# 模型配置(这里用内网 vLLM 部署的开源模型,不花钱也不泄密)
config_list = [
    {
        "model": "qwen2.5-32b",
        "base_url": "http://localhost:8000/v1",
        "api_key": "EMPTY",
    }
]
llm_config = {"config_list": config_list, "temperature": 0.2}

# Agent 1:出题人
assistant = autogen.AssistantAgent(
    name="Coder",
    llm_config=llm_config,
    system_message="你是一位资深 Python 工程师,负责编写高质量代码。"
                   "代码必须包含类型注解和 docstring。",
)

# Agent 2:审查人(绝不轻易放行)
reviewer = autogen.AssistantAgent(
    name="Reviewer",
    llm_config=llm_config,
    system_message="你是一位严格的代码审查员。重点检查:安全漏洞、边界条件、"
                   "异常处理。发现任何问题都要指出并要求修改,"
                   "只有代码完全达标才回复 'APPROVE'。",
)

# Agent 3:人类代表(自动运行,最后把关)
user_proxy = autogen.UserProxyAgent(
    name="Admin",
    human_input_mode="NEVER",
    max_consecutive_auto_reply=3,  # 最多自动来回 3 轮,防止死循环
    is_termination_msg=lambda msg: "APPROVE" in msg.get("content", ""),
    code_execution_config=False,
)

# 启动协作:人类发起任务,Coder 和 Reviewer 自动协作
user_proxy.initiate_chat(
    assistant,
    message="""写一个函数:解析 Nginx 访问日志,统计 Top 10 IP。
要求:日志文件可能很大(10GB+),注意内存效率。"""
)

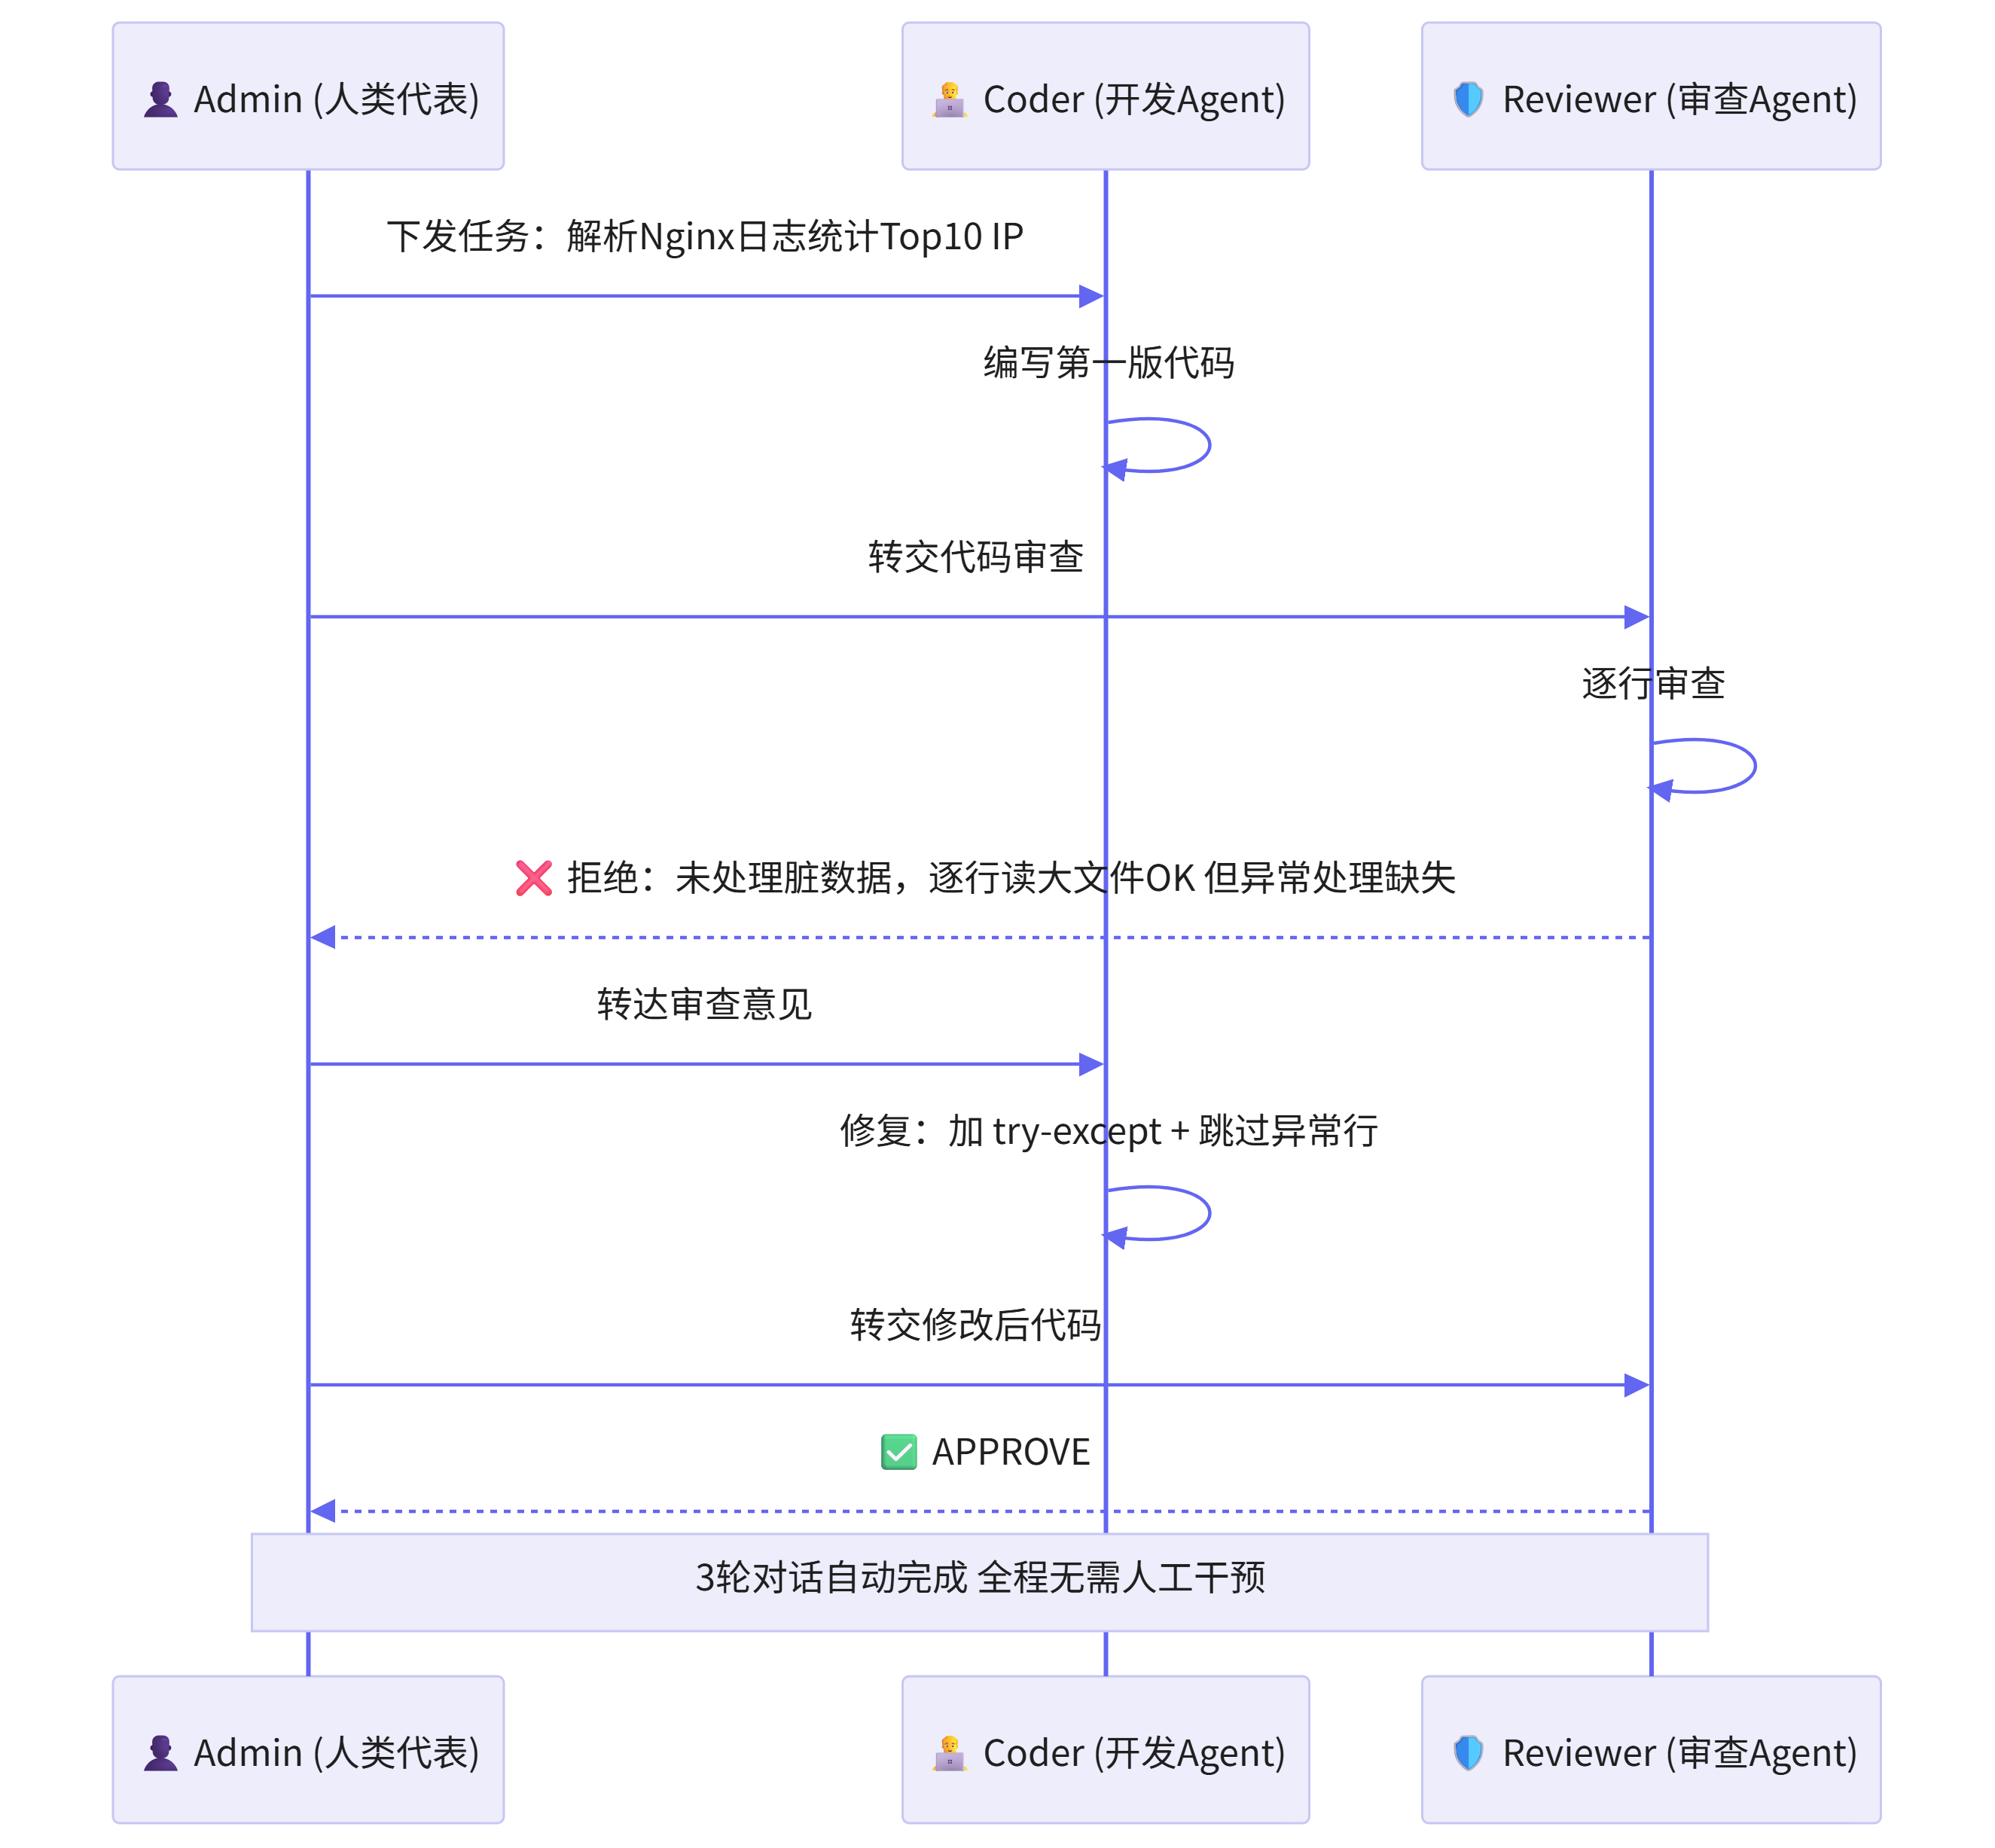
# 发生的事情(自动展开):
# 1. Coder 写出第一版代码
# 2. Admin 把代码转给 Reviewer 审查
# 3. Reviewer:"第 12 行逐行读文件没问题,但没处理格式异常的行,
#    遇到脏数据会崩,请修复后重新提交"
# 4. Coder 修复,加上了 try-except 和跳过逻辑
# 5. Reviewer:"APPROVE"
# 6. 对话结束看到没?你没写任何流程控制代码,协作流程是 Agent 之间"聊"出来的。这就是 AutoGen 和 LangChain 这类编排框架的本质区别:LangChain 是你画好流程图让它跑,AutoGen 是给角色定好规则让它们自己对话。
三、GroupChat:让一队 Agent 开会
两个 Agent 是"对线",真实业务往往是"开会"。比如一次线上故障排查,需要监控分析、日志排查、方案制定、执行复核四个角色。AutoGen 的 GroupChat + GroupChatManager 就是干这个的:
import autogen

config_list = [
    {"model": "qwen2.5-32b", "base_url": "http://localhost:8000/v1", "api_key": "EMPTY"}
]
llm_config = {"config_list": config_list, "temperature": 0.2}

# ===== 故障应急响应团队的四个角色 =====

# 1. 监控分析员:看指标
monitor_analyst = autogen.AssistantAgent(
    name="MonitorAnalyst",
    llm_config=llm_config,
    system_message="""你是监控分析专家,负责解读 Prometheus 指标。
你收到告警后要输出:异常指标清单、异常开始时间、影响范围初步判断。
不负责给出修复方案,只负责把"发生了什么"讲清楚。""",
)

# 2. 日志侦探:翻日志找线索
log_detective = autogen.AssistantAgent(
    name="LogDetective",
    llm_config=llm_config,
    system_message="""你是日志分析专家,负责从应用日志中找异常线索。
重点:异常堆栈、错误模式、时间相关性。只陈述日志中的事实,
不做没有证据的推测。""",
)

# 3. 应急指挥官:整合信息做决策
commander = autogen.AssistantAgent(
    name="Commander",
    llm_config=llm_config,
    system_message="""你是故障应急指挥官。综合 MonitorAnalyst 和
LogDetective 的信息,输出:
1. 根因判断(含置信度)
2. 处置方案(按优先级)
3. 是否需要人工决策的说明
方案必须包含回滚预案。""",
)

# 4. 安全审查员:复核方案
safety_reviewer = autogen.AssistantAgent(
    name="SafetyReviewer",
    llm_config=llm_config,
    system_message="""你是变更安全审查员。审查 Commander 的处置方案:
- 是否有影响其他服务的副作用
- 是否符合变更管理规范(生产操作必须可回滚)
- 高危操作(重启、扩容、切流)必须标记需要人工审批
发现问题直接打回,通过则回复 '方案通过'。""",
)

# 人类代表
admin = autogen.UserProxyAgent(
    name="OnCallEngineer",
    human_input_mode="NEVER",
    max_consecutive_auto_reply=15,  # GroupChat 需要更多轮次
    is_termination_msg=lambda msg: "方案通过" in msg.get("content", ""),
    code_execution_config=False,
)

# ===== 组建群聊 =====
groupchat = autogen.GroupChat(
    agents=[admin, monitor_analyst, log_detective, commander, safety_reviewer],
    messages=[],
    max_round=15,               # 最多 15 轮,防失控
    speaker_selection_method="auto",  # LLM 自动选择下一个发言者
)

manager = autogen.GroupChatManager(
    groupchat=groupchat,
    llm_config=llm_config,
)

# ===== 模拟一次真实告警 =====
admin.initiate_chat(
    manager,
    message="""【P2 告警】订单服务响应延迟异常
- 告警时间:14:23
- 当前指标:
  * order-service P99 延迟:3200ms(正常 200ms)
  * order-service 错误率:8.2%(正常 0.1%)
  * 数据库连接池使用率:98%
  * Redis 缓存命中率:45%(正常 92%)
- 最近变更:1 小时前 order-service 发布了新版本 v2.3.1
- 应用日志片段(最近100行):
  14:21:33 ERROR OrderDao - Connection timeout after 30000ms
  14:21:35 WARN  HikariPool - Connection pool nearly exhausted (49/50)
  14:22:10 ERROR CacheService - Redis GET timeout, fallback to DB
  (后续大量重复的 Connection timeout 日志)

请各位协作分析并给出处置方案。""",
)

# 自动展开的过程:
# 1. MonitorAnalyst:P99 和错误率 14:21 左右开始飙升,
#    连接池 98% 是最突出的异常,缓存命中率骤降会加剧 DB 压力
# 2. LogDetective:日志确认连接超时从 14:21:33 开始,
#    早于 v2.3.1 发布?不对,发布是 13:23,日志 14:21 才开始异常,
#    说明不是发布直接导致——更像是连接池泄漏逐渐积累到爆
# 3. Commander:综合判断,根因可能是 v2.3.1 新代码存在连接泄漏,
#    1 小时后累积到池上限。方案:① 重启 order-service 快速恢复
#    ② 回滚到 v2.3.0 根治 ③ 排查新版本连接关闭逻辑
# 4. SafetyReviewer:重启和回滚都属于高危操作,标记需人工审批;
#    回滚前确认 v2.3.0 无未修复的安全补丁——方案通过(附人工确认项)
# 5. 对话结束,OnCallEngineer 拿到一份带证据链的完整应急方案
这个过程放在图上看就很直观了:
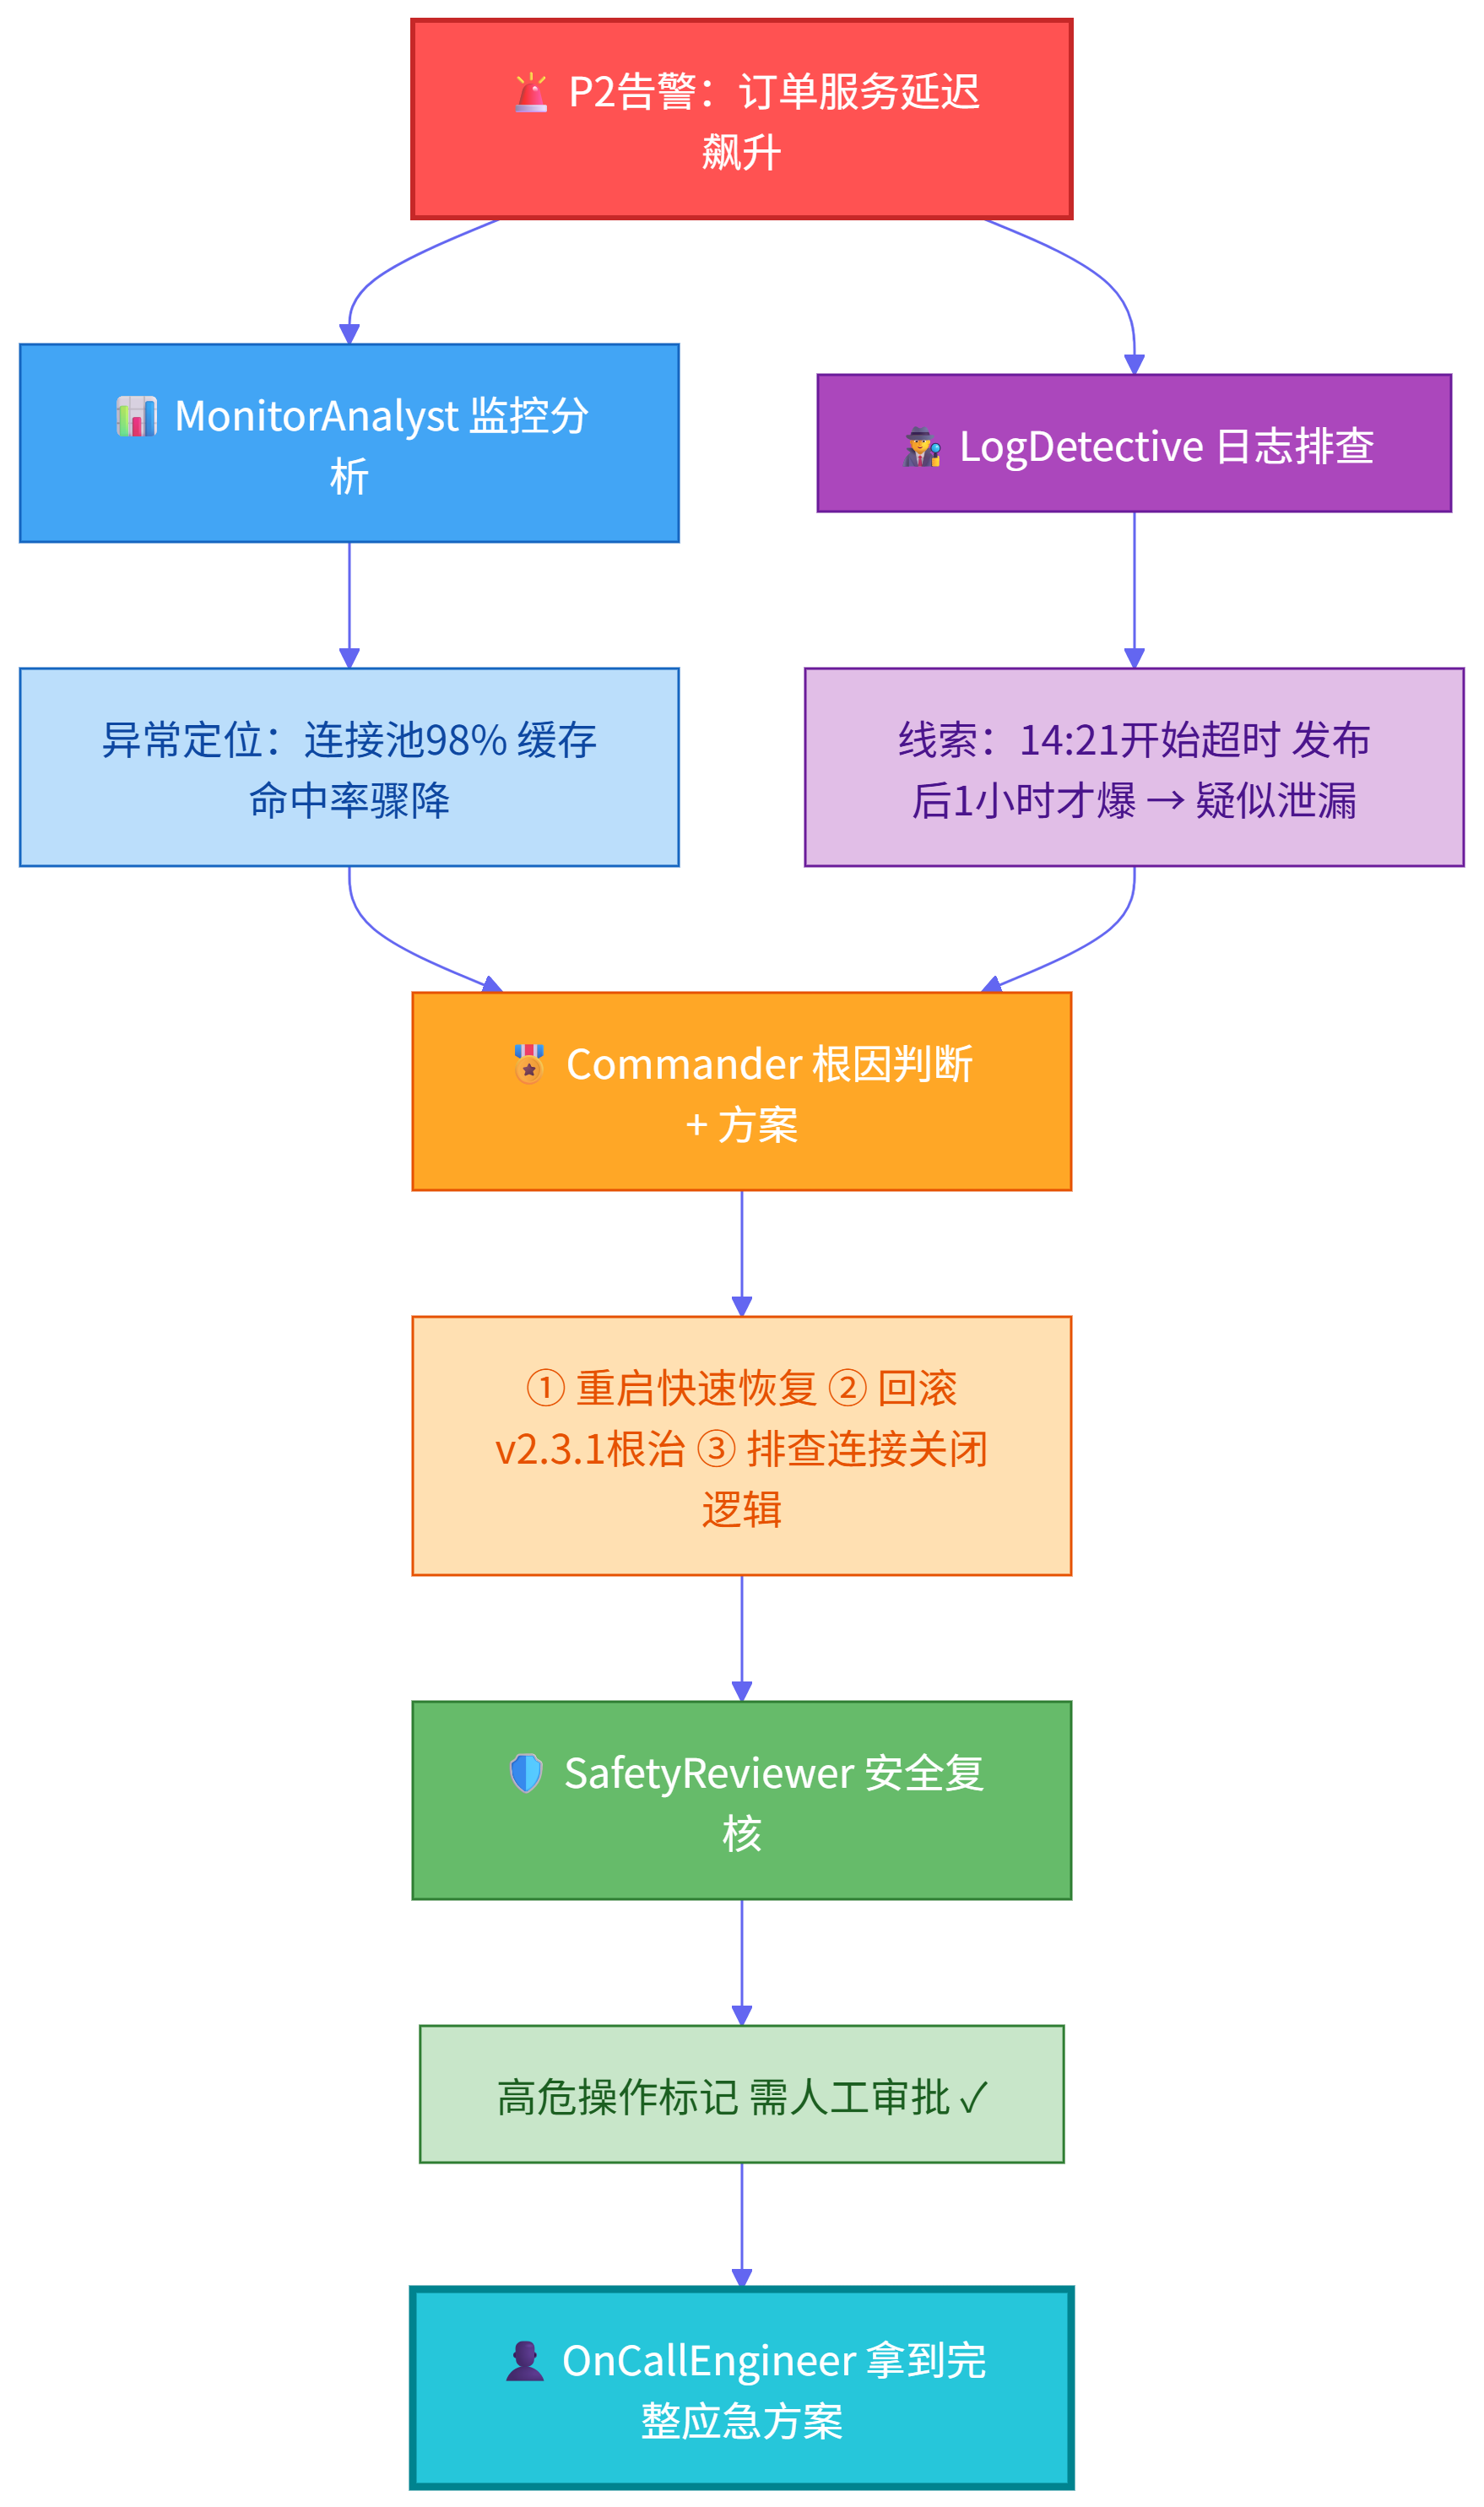
注意一个关键细节:LogDetective 纠正了"发布导致故障"的第一直觉——发布是 13:23,故障是 14:21 才开始,中间隔了一小时。这种时间线分析恰恰是"逐个翻证据"的侦探角色比"全能选手"强的地方。单体 Agent 经常第一个假设出来就直接下结论了,多 Agent 架构里有人负责唱反调。
四、进阶:注册工具,让 Agent 真正动手
光聊天不解决问题。AutoGen 支持 register_for_execution / register_for_llm,让 Agent 调用真实工具。给监控分析员接上 Prometheus API:
import autogen
import requests
from datetime import datetime, timedelta

config_list = [
    {"model": "qwen2.5-32b", "base_url": "http://localhost:8000/v1", "api_key": "EMPTY"}
]

admin = autogen.UserProxyAgent(
    name="OnCallEngineer",
    human_input_mode="NEVER",
    is_termination_msg=lambda msg: "TERMINATE" in msg.get("content", ""),
    code_execution_config=False,
)

monitor_analyst = autogen.AssistantAgent(
    name="MonitorAnalyst",
    llm_config={"config_list": config_list, "temperature": 0.2},
    system_message="你是监控分析专家。使用提供的工具查询指标,基于真实数据回答,"
                   "禁止编造数字。分析完成后回复 TERMINATE。",
)


# ===== 注册真实工具:查 Prometheus =====
@monitor_analyst.register_for_llm(
    name="query_prometheus",
    description="查询 Prometheus 指标。参数:query(PromQL语句), "
                "duration_minutes(回溯时长分钟数)"
)
def query_prometheus(query: str, duration_minutes: int = 30):
    """从 Prometheus 查询指标数据"""
    end = datetime.now()
    start = end - timedelta(minutes=duration_minutes)

    resp = requests.get(
        "http://prometheus.internal:9090/api/v1/query_range",
        params={
            "query": query,
            "start": start.isoformat(),
            "end": end.isoformat(),
            "step": "60s",
        },
        timeout=10,
    )
    data = resp.json()

    if data.get("status") != "success":
        return {"error": data.get("error", "unknown")}

    # 精简返回,只给 Agent 需要的信息(省 token)
    result = []
    for item in data["data"]["result"][:5]:
        metric = item.get("metric", {})
        values = item.get("values", [])
        if values:
            vals = [float(v[1]) for v in values]
            result.append({
                "metric": metric.get("__name__", ""),
                "instance": metric.get("instance", ""),
                "current": vals[-1],
                "max": max(vals),
                "min": min(vals),
                "avg": round(sum(vals) / len(vals), 2),
            })
    return result


@monitor_analyst.register_for_llm(
    name="get_active_alerts",
    description="获取当前活跃的告警列表"
)
def get_active_alerts():
    """获取 Prometheus 当前告警"""
    resp = requests.get(
        "http://prometheus.internal:9090/api/v1/alerts", timeout=10
    )
    data = resp.json()
    alerts = []
    for a in data.get("data", {}).get("alerts", []):
        alerts.append({
            "name": a["labels"].get("alertname", ""),
            "severity": a["labels"].get("severity", ""),
            "instance": a["labels"].get("instance", ""),
            "description": a.get("annotations", {}).get("description", ""),
            "active_since": a.get("activeAt", ""),
        })
    return alerts


# 工具执行注册到 admin(由人类代表侧实际执行)
# (生产实践中通常用 docker 容器执行或本地函数白名单)


# ===== 实战运行 =====
admin.initiate_chat(
    monitor_analyst,
    message="""订单服务响应慢,请你:
1. 先查当前活跃告警
2. 查询 order-service 最近 30 分钟的 P99 延迟趋势
3. 查询数据库连接池使用率
基于查询到的真实数据分析问题。分析完成后回复 TERMINATE。""",
)

# Agent 会自主决定调用哪些工具、以什么参数调用:
# → 调用 get_active_alerts()
#   发现:DatabaseConnectionPoolNearlyFull (critical)
# → 调用 query_prometheus('http_server_p99_seconds{app="order-service"}', 30)
#   发现:P99 从 0.2s 攀升到 3.2s
# → 调用 query_prometheus('hikaricp_connections_usage_ratio{app="order-service"}', 30)
#   发现:连接池使用率 30 分钟内从 40% 爬到 98%
# → 综合输出:"连接池在 30 分钟内被逐渐耗尽,趋势是爬坡式的,
#   符合连接泄漏特征,而非流量突增(流量指标平稳)..."
这就是"有手有脚"的 Agent——不是靠你在 Prompt 里贴死数据,而是它自己决定查什么、查多久,基于真实数据推理。
五、真实业务场景:把这套东西跑在生产上
光讲原理不过瘾,说说我们实际落地的架构。场景还是那个故障应急响应,但加了生产级的周边配套:
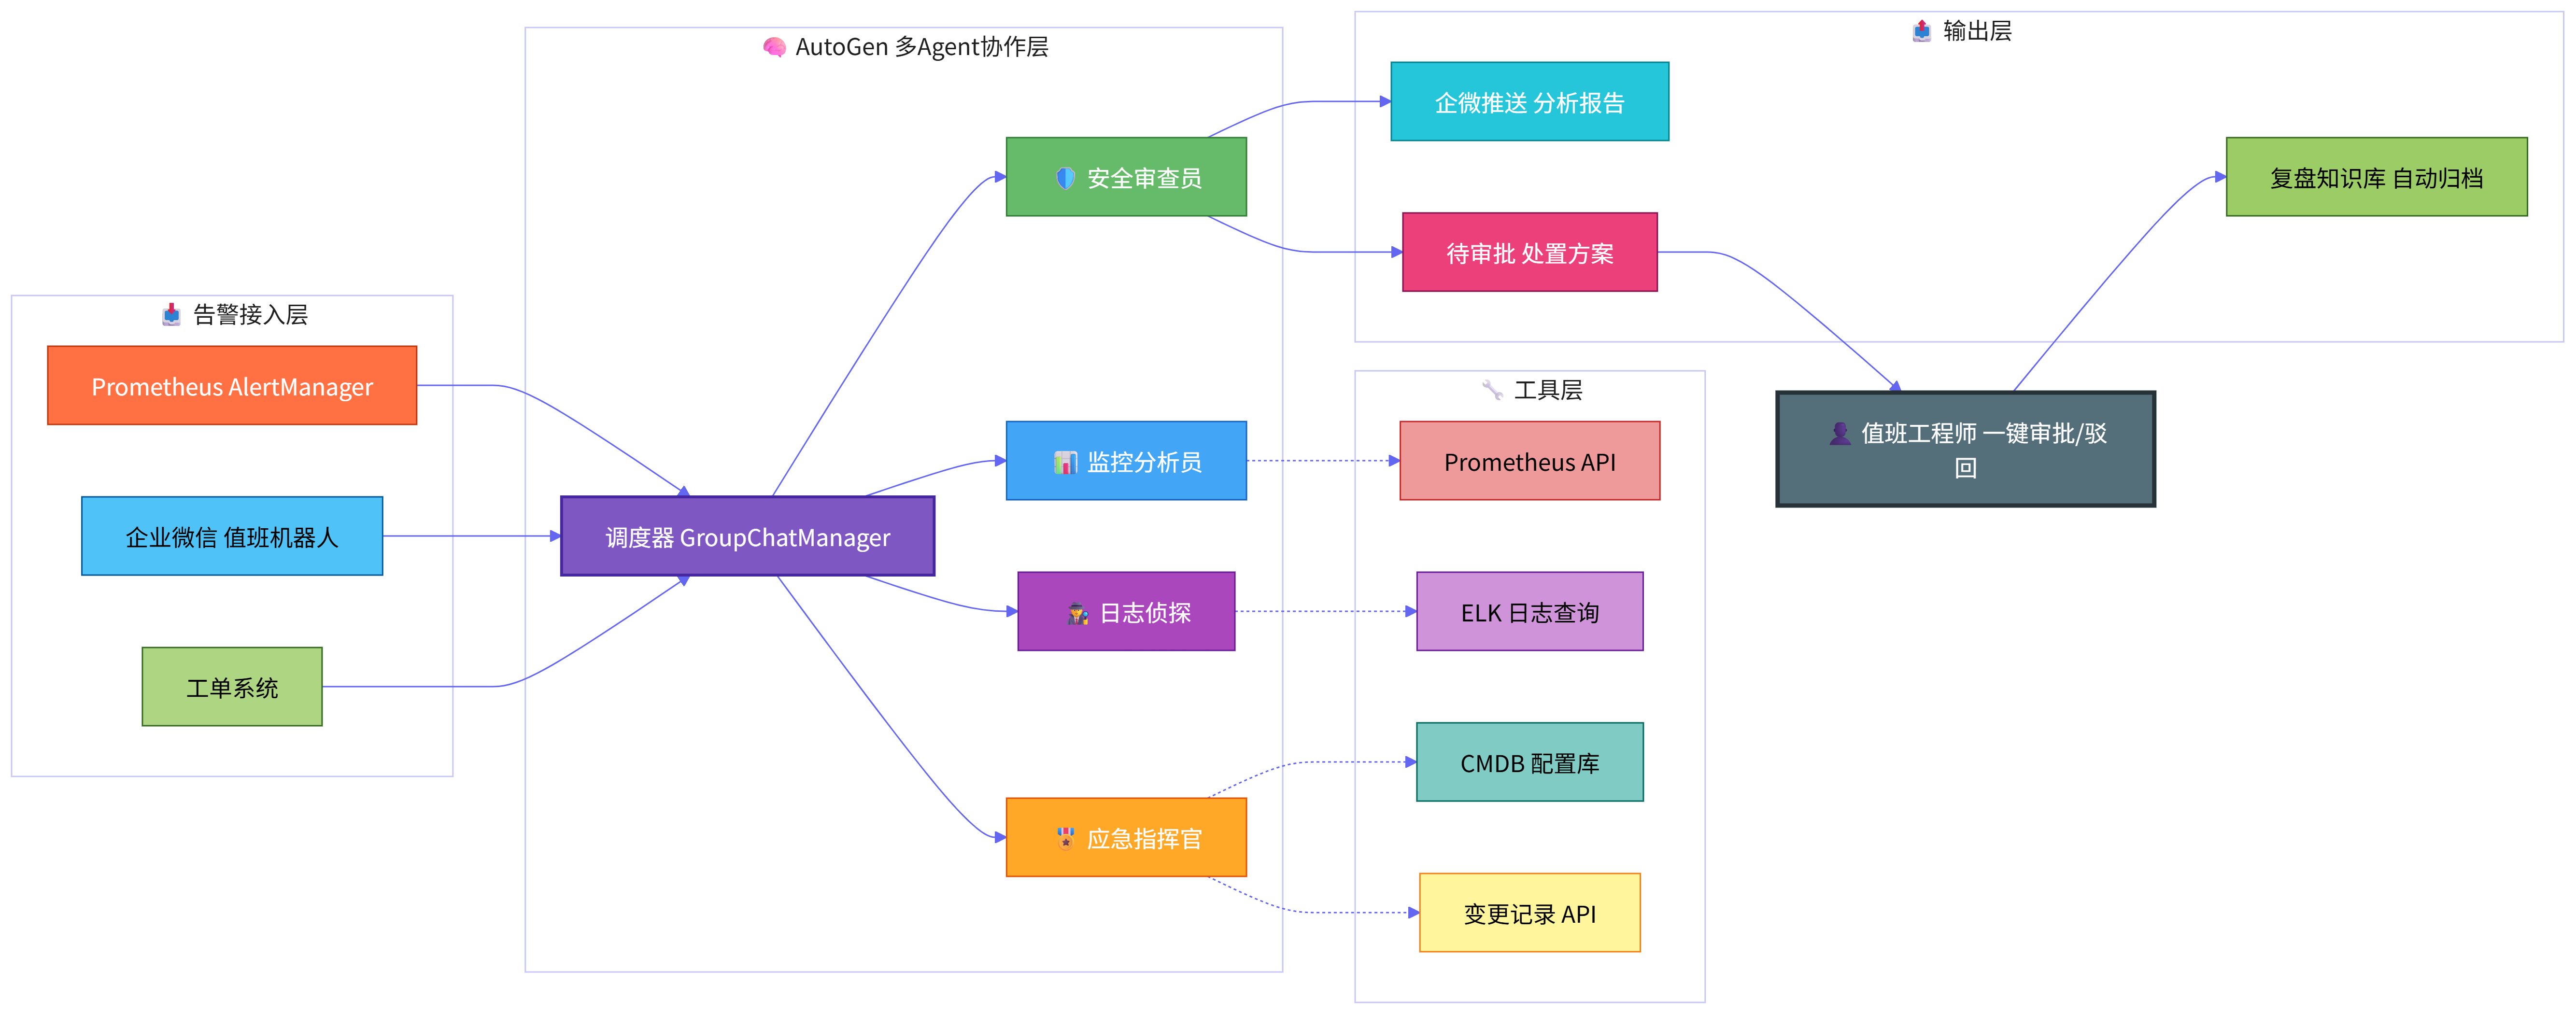
上线三个月的实际效果,说几个数据:
- P2/P3 级故障的初步根因分析时间从平均 40 分钟缩到 8 分钟(AI 并行查指标和日志,人类只做最终决策)
- 误判率约 15%——五分之一的结论需要人类纠正,所以我们在架构上强制保留安全审查员 + 人工审批,没有一个方案能直接触达生产
- Token 成本:平均一次故障分析消耗约 3 万 token(4 个 Agent 来回对话 + 工具结果),内网开源模型基本零边际成本
六、踩坑实录:这五个坑我都替你踩过了
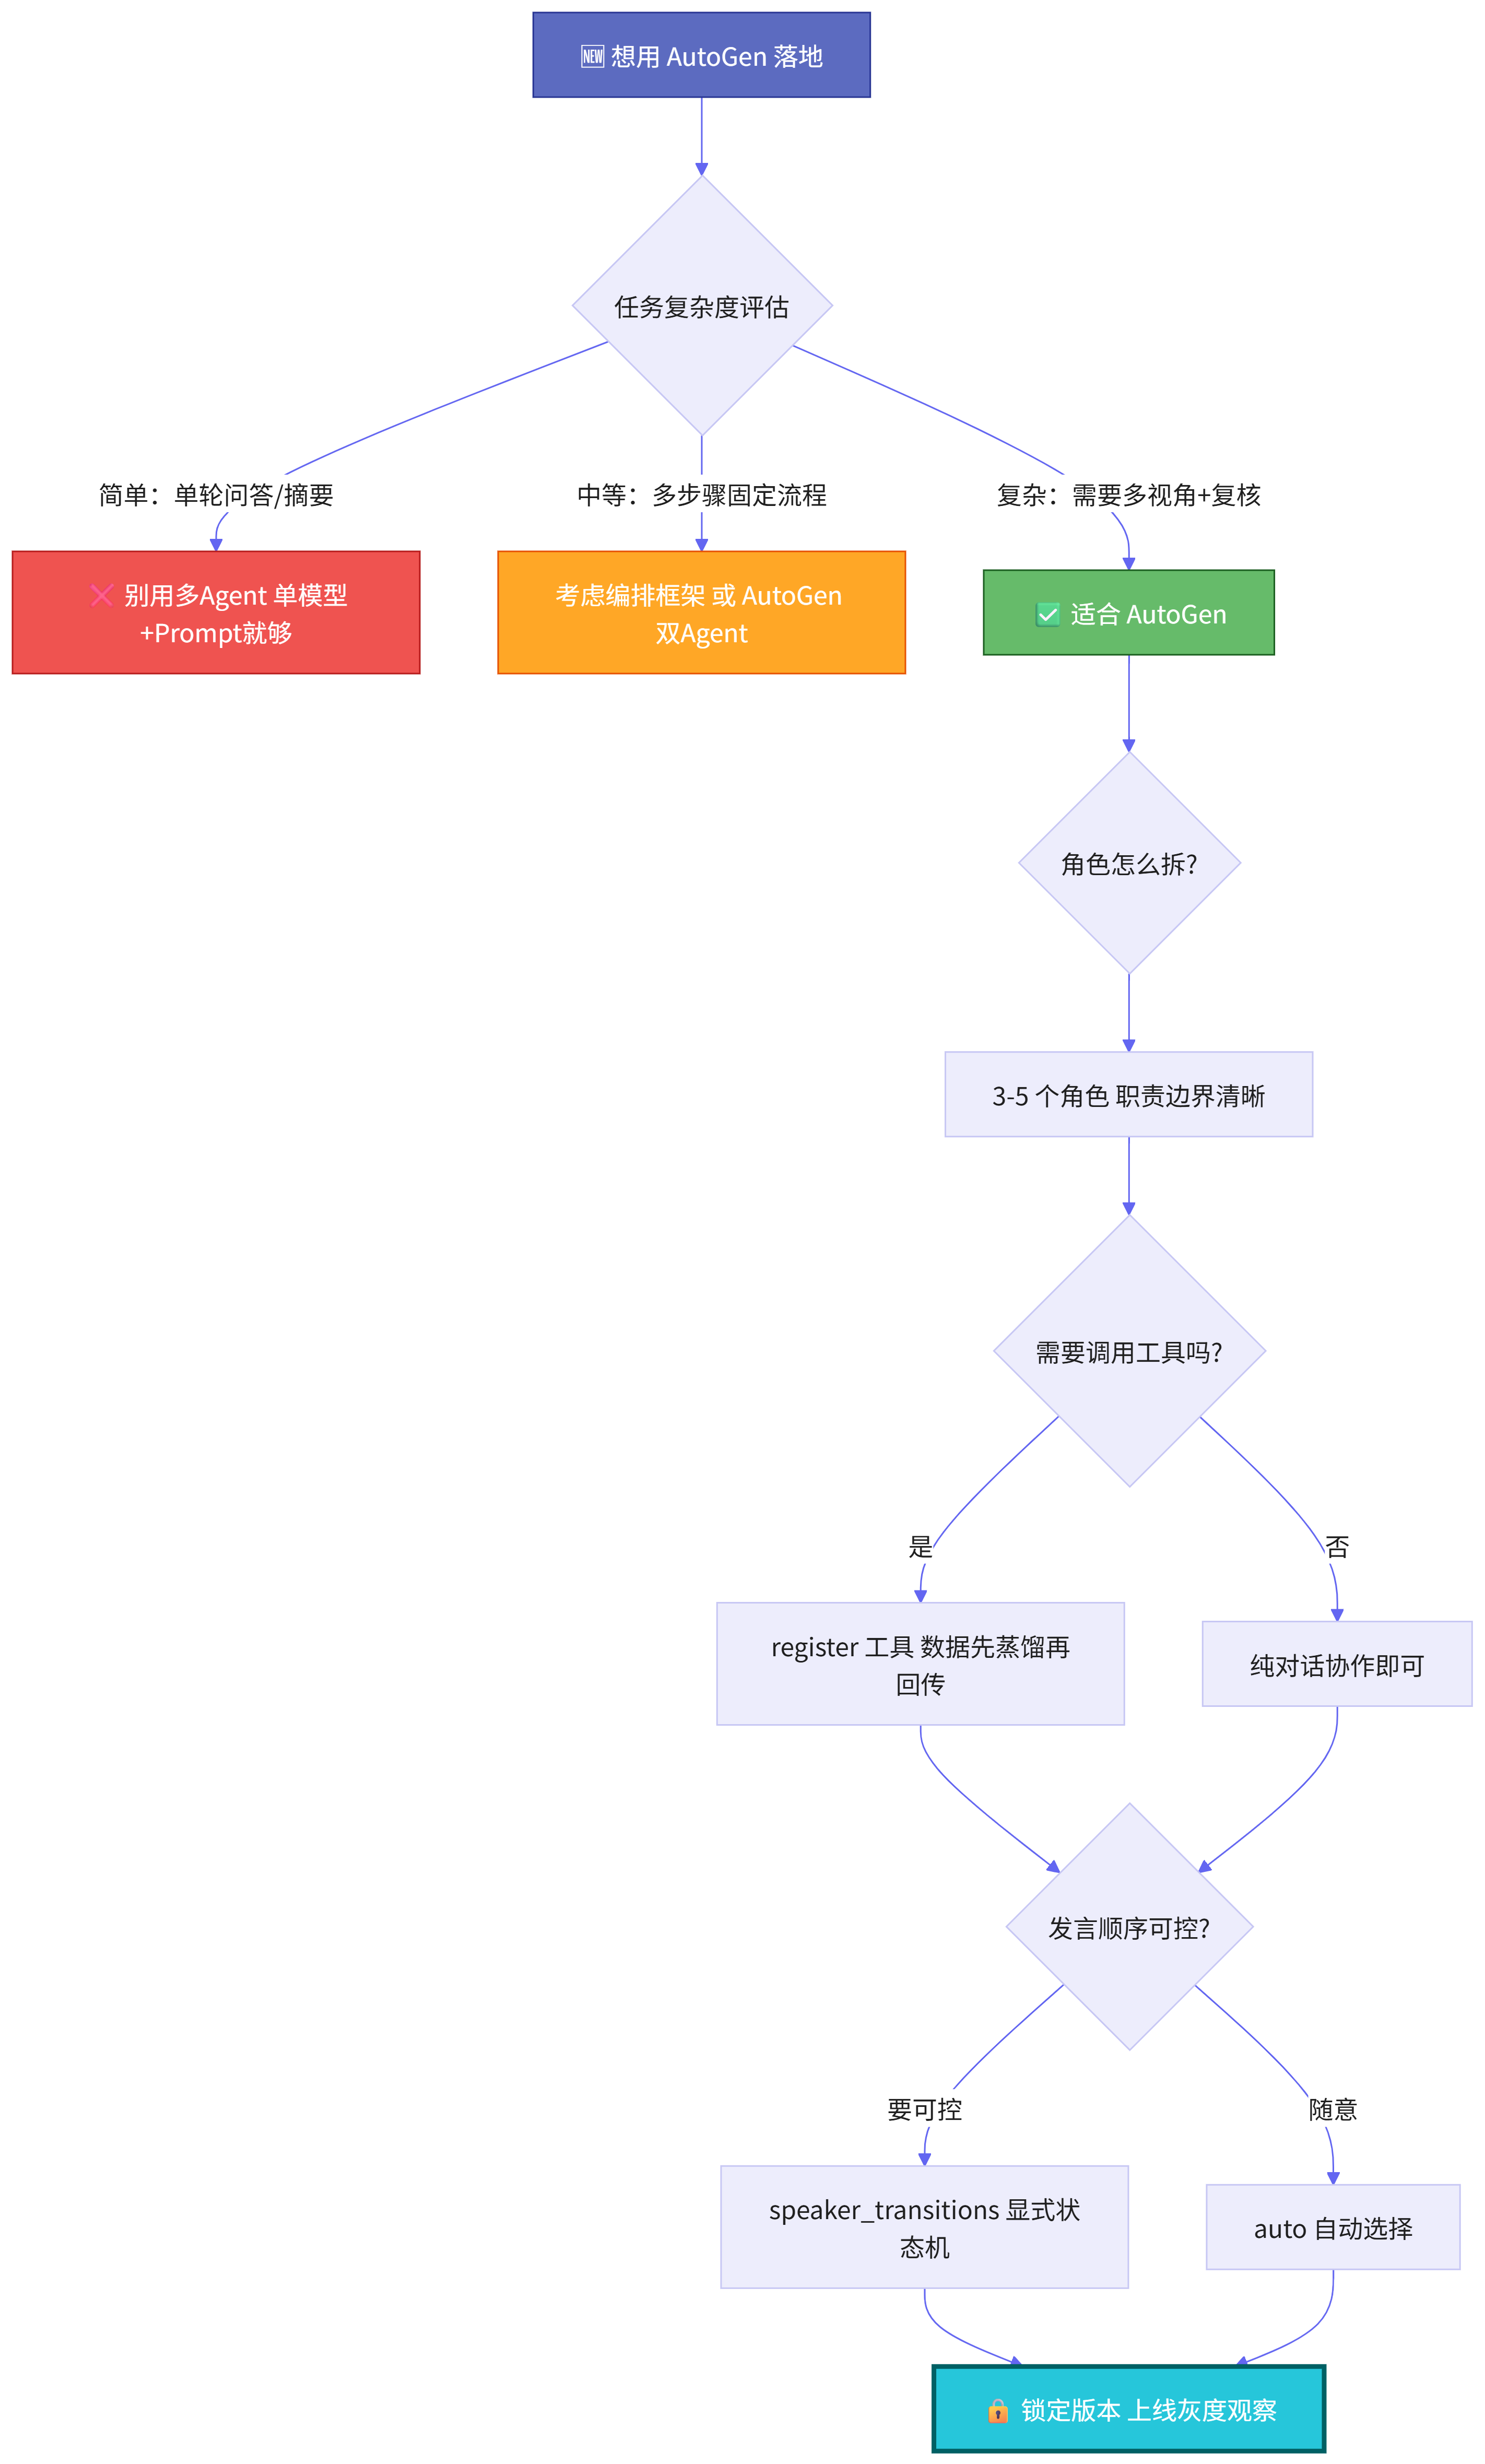
坑 1:Agent 角色划分太细,会议开不完。 我试过拆八个角色,一个简单故障开了二十多轮对话还没结论,token 烧得心疼。经验是 3-5 个角色最合理,每个角色职责边界要写清楚"你不负责什么"。
坑 2:不设终止条件,对话停不下来。 两个 Agent 互相客气:"您说得很对""感谢补充"——聊了几十轮没有任何推进。必须设置 is_termination_msg 和 max_round,并且给每个 Agent 的 System Prompt 写明"任务完成请明确说 XXX"。
坑 3:让 LLM 选发言者,选得稀里糊涂。 speaker_selection_method="auto" 方便,但有时会连续让同一个 Agent 发言好几次。我们的解法:高频核心链路改用 allowed_or_speaker_transitions 显式指定状态机的转移关系:
from autogen import GroupChat

# 显式指定发言顺序的合法转移,避免群聊跑偏
allowed_transitions = {
    admin: [monitor_analyst, log_detective],
    monitor_analyst: [commander, log_detective],
    log_detective: [commander, monitor_analyst],
    commander: [safety_reviewer, monitor_analyst],
    safety_reviewer: [commander, admin],  # 审查打回指挥官,通过则回人类
}

groupchat = autogen.GroupChat(
    agents=[admin, monitor_analyst, log_detective, commander, safety_reviewer],
    messages=[],
    max_round=12,
    speaker_transitions_type="allowed",
    allowed_or_speaker_transitions_dict=allowed_transitions,
)
坑 4:工具返回数据太大,上下文秒爆。 Prometheus 一次 range 查询几百个点全塞回对话,两轮就把上下文吃满。解法:工具层做数据蒸馏——只返回 current/max/min/avg 四个数,Agent 要细粒度数据再发专门查询。就像前面代码里那样。
坑 5:AutoGen 版本升级是 breaking change 重灾区。 0.2 到 0.4 版本整个架构推倒重来(换成了事件驱动的 Actor 模型),代码几乎全要改。生产项目锁版本,新特性在测试环境玩,别追新。
用了大半年 AutoGen,我的核心体会是:多 Agent 的价值不在于"多个 AI 更聪明",而在于"流程上互相制衡"。一个 Agent 说的话另一个 Agent 会质疑,幻觉被拦在对话内部;高危操作有专门的审查角色把关;每个角色的上下文干净聚焦,回答质量反而比"全能模式"高。
但它也不是银弹。任务简单的时候,多 Agent 就是杀鸡用牛刀,还费钱。判断标准很简单:你的任务需要"多视角 + 交叉验证 + 人工兜底"吗? 需要就上,不需要就老老实实写 Prompt。
另外提醒一句:多 Agent 系统的可观测性比单体重要十倍。每次对话的完整记录、每个工具调用的参数和返回、每轮 token 消耗——这些一定要落库。不然线上出了诡异结论,你连"哪个 Agent 在哪一步开始跑偏的"都查不出来。
如果你也在折腾多 Agent,或者已经在生产上跑了一套,欢迎聊聊各自的架构取舍——尤其是 GroupChat 的发言控制这块,总觉得还有更优雅的做法。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号