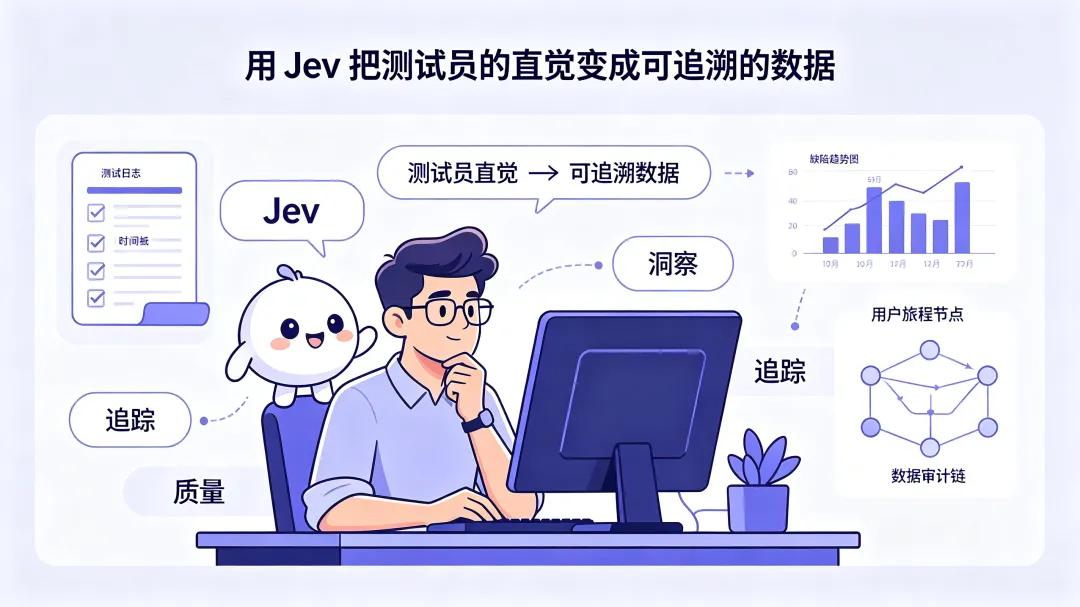
用 Jev 把测试员的直觉变成可追溯的数据
原创
图片
一、探索性测试的产出,为什么用不起来
Session-Based Exploratory Testing(基于会话的探索性测试)留下的东西,通常是测试员在一个 Charter(测试目标)指引下,边测边随手记的一堆"发现"(findings),比如:
支付页面点了两次提交按钮,弹了两个成功提示,感觉有点问题
搜索框输入表情符号,后端报 500
个人中心头像上传大图(>10MB)没有任何进度提示,页面卡了快 10 秒
优惠券叠加使用的时候,金额算得好像不对,具体规则不太确定
这些笔记本身很有价值——探索性测试的核心优势就是能发现测试用例设计不到的边界情况——但它们几乎无法被复用:
- 无法统计。 这个迭代周期发现的问题里,有多少是性能类、多少是功能类?没人知道,因为没有字段可以聚合。
- 无法追溯。 三个月后想查"支付模块历史上出现过哪些探索性测试发现",只能翻聊天记录或者 Word 文档,全凭记忆和运气。
- 优先级全靠现场判断。 笔记写完往往当场口头讨论一下要不要开缺陷单,讨论完这条判断依据就随风而去了。
这正是一个"不需要生成新文字,只需要打标签"的任务——而这恰好是 Jev 的舒适区。
二、为什么"不生成散文"在这里是优点,不是限制
前几篇文章里,"Jev 不生成文本"更多是作为一个需要绕开的限制来讨论的。但在这个场景里,情况反过来了:我们本来就不希望模型替测试员重写笔记。
原始笔记里那句"感觉有点问题"、"不太确定",看似不严谨,但其实包含了测试员当下的真实判断状态,是有价值的一手信息,不应该被模型的"优雅改写"抹掉。我们需要的是在保留原文的前提下,给每条笔记打上结构化标签:
判断 | Jev 原语 | 输出 |
|---|---|---|
属于哪个功能模块 | Choice | 模块名 + 概率分布 + 原生 confidence |
可能是哪类问题 | Choice | 功能/性能/UI/兼容性/易用性等 + confidence |
严重程度大致如何 | Score | 连续分值 + 原生 confidence |
是否值得转成正式缺陷单 | Noul | 0~1 概率,需自行推导 confidence |
一条笔记,四个问题,原文一个字不改——这正是"打标签"和"写文章"的本质区别,也是为什么一个不生成文本的模型反而比生成式大模型更适合干这件事:它没有"顺手帮你把话说圆"的冲动。
三、环境准备
pip install typesafe-sdk
export TYPESAFE_API_KEY="your-api-key"from typesafe_sdk import Choice, Noul, Score, TypeSafeClient四、一次调用问完四个问题
官方 API 支持在一次 system_one 调用里混合 Choice、Score、Noul 多种类型的问题,一次性返回所有答案——这意味着结构化一条笔记不需要发四次请求,一次就够,对延迟和成本都更友好。
"""
single_note_structuring.py
单条探索性测试笔记的结构化示例
"""
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

# 除了笔记原文,把 session 的 charter(测试目标)一起作为上下文传入,
# 帮助模型理解笔记发生的场景,判断会更准确(详见第六节)
session_context = {
    "charter": "探索个人中心 - 头像上传功能的边界情况(大文件、异常格式、弱网环境)",
    "raw_note": "个人中心头像上传大图(>10MB)没有任何进度提示,页面卡了快 10 秒",
}

with TypeSafeClient(model="jev-1.13.0") as client:
    response = client.system_one(
        state=session_context,
        questions={
            "module": Choice(
                instructions="这条笔记描述的问题属于哪个功能模块?",
                criteria={
                    "用户中心": "个人资料、头像、账号设置相关",
                    "支付结算": "下单、支付、优惠券相关",
                    "搜索": "搜索、筛选、排序相关",
                    "其他": "不属于以上任何模块",
                },
            ),
            "defect_type": Choice(
                instructions="这条笔记更接近哪一类问题?",
                criteria={
                    "功能缺陷": "功能本身没有按预期工作",
                    "性能问题": "响应慢、卡顿、资源占用异常",
                    "交互体验": "缺少必要的用户反馈(如进度提示、错误提示)但功能本身可用",
                    "兼容性问题": "特定设备/浏览器/网络环境下才出现",
                },
            ),
            "severity": Score(
                instructions="这条笔记描述的问题严重程度如何",
                criteria=[
                    "低:体验瑕疵,不影响任务完成",
                    "中:影响体验但有替代操作路径",
                    "高:可能导致用户无法完成核心任务或引发误解(如上传成功与否不明确)",
                ],
            ),
            "needs_bug_ticket": Noul(
                instructions="这条笔记是否值得转成一个正式缺陷单跟进?",
                criteria={
                    "true": "问题清晰、可复现或高度疑似真实缺陷,值得跟进",
                    "false": "更像是建议/待确认/信息不足以判断,暂不适合直接开单",
                },
            ),
        },
    )

print(f"模块: {response.choices['module'].choice} (置信度 {response.choices['module'].confidence:.2f})")
print(f"问题类型: {response.choices['defect_type'].choice} (置信度 {response.choices['defect_type'].confidence:.2f})")
print(f"严重度: {response.scores['severity'].score:.2f} (置信度 {response.scores['severity'].confidence:.2f})")
print(f"建议开单概率: {response.nouls['needs_bug_ticket'].noul:.2f}")
五、批量处理一整场探索性测试 Session
真实场景中,一场探索性测试 session 往往会产出十几到几十条零散笔记。下面的脚本把一整场 session 的笔记批量结构化,并导出成 CSV,方便直接导入你现有的缺陷管理系统或做统计分析。
"""
session_notes_pipeline.py
批量结构化一场探索性测试 session 的全部笔记
"""
import csv
from concurrent.futures import ThreadPoolExecutor, as_completed
from dataclasses import dataclass, asdict
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

MODEL = "jev-1.13.0"
CONFIDENCE_THRESHOLD = 0.7

MODULE_OPTIONS = {
    "用户中心": "个人资料、头像、账号设置相关",
    "支付结算": "下单、支付、优惠券相关",
    "搜索": "搜索、筛选、排序相关",
    "其他": "不属于以上任何模块",
}
DEFECT_TYPE_OPTIONS = {
    "功能缺陷": "功能本身没有按预期工作",
    "性能问题": "响应慢、卡顿、资源占用异常",
    "交互体验": "缺少必要的用户反馈但功能本身可用",
    "兼容性问题": "特定设备/浏览器/网络环境下才出现",
}
SEVERITY_LEVELS = [
    "低:体验瑕疵,不影响任务完成",
    "中:影响体验但有替代操作路径",
    "高:可能导致用户无法完成核心任务",
]

# ---------- 模拟一场 session 的原始笔记 ----------
SESSION_CHARTER = "探索个人中心与支付流程的边界情况(大文件、异常输入、弱网、重复操作)"
RAW_NOTES = [
    "支付页面点了两次提交按钮,弹了两个成功提示,感觉有点问题",
    "搜索框输入表情符号,后端报 500",
    "个人中心头像上传大图(>10MB)没有任何进度提示,页面卡了快 10 秒",
    "优惠券叠加使用的时候,金额算得好像不对,具体规则不太确定",
    "退出登录后返回按钮还能看到之前的购物车内容,应该是缓存没清",
]


@dataclass
class StructuredFinding:
    raw_note: str
    module: str
    module_confidence: float
    defect_type: str
    defect_type_confidence: float
    severity_score: float
    severity_confidence: float
    bug_ticket_prob: float
    bug_ticket_confidence: float


def structure_one_note(client: TypeSafeClient, charter: str, raw_note: str) -> StructuredFinding:
    response = client.system_one(
        state={"charter": charter, "raw_note": raw_note},
        questions={
            "module": Choice(instructions="这条笔记描述的问题属于哪个功能模块?", criteria=MODULE_OPTIONS),
            "defect_type": Choice(instructions="这条笔记更接近哪一类问题?", criteria=DEFECT_TYPE_OPTIONS),
            "severity": Score(instructions="这条笔记描述的问题严重程度如何", criteria=SEVERITY_LEVELS),
            "needs_bug_ticket": Noul(
                instructions="这条笔记是否值得转成一个正式缺陷单跟进?",
                criteria={
                    "true": "问题清晰、可复现或高度疑似真实缺陷",
                    "false": "更像建议/待确认/信息不足",
                },
            ),
        },
    )
    module = response.choices["module"]
    defect_type = response.choices["defect_type"]
    severity = response.scores["severity"]
    bug_ticket = response.nouls["needs_bug_ticket"]

    return StructuredFinding(
        raw_note=raw_note,
        module=module.choice, module_confidence=module.confidence,
        defect_type=defect_type.choice, defect_type_confidence=defect_type.confidence,
        severity_score=severity.score, severity_confidence=severity.confidence,
        bug_ticket_prob=bug_ticket.noul,
        bug_ticket_confidence=abs(bug_ticket.noul - 0.5) * 2,
    )


def main():
    findings = []
    with TypeSafeClient(model=MODEL) as client:
        with ThreadPoolExecutor(max_workers=8) as pool:
            futures = {
                pool.submit(structure_one_note, client, SESSION_CHARTER, note): note
                for note in RAW_NOTES
            }
            for future in as_completed(futures):
                findings.append(future.result())

    # 导出为 CSV,方便导入缺陷管理系统或做统计分析
    with open("session_findings_structured.csv", "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=list(asdict(findings[0]).keys()))
        writer.writeheader()
        for finding in findings:
            writer.writerow(asdict(finding))

    print(f"已结构化 {len(findings)} 条笔记,写入 session_findings_structured.csv\n")

    suggested_tickets = [
        f for f in findings
        if f.bug_ticket_prob >= 0.5 and f.bug_ticket_confidence >= CONFIDENCE_THRESHOLD
    ]
    low_confidence = [f for f in findings if f.module_confidence < CONFIDENCE_THRESHOLD
                       or f.defect_type_confidence < CONFIDENCE_THRESHOLD]

    print("=== 建议直接开缺陷单 ===")
    for f in suggested_tickets:
        print(f"  [{f.module}/{f.defect_type}] {f.raw_note} "
              f"(严重度 {f.severity_score:.2f}, 开单概率 {f.bug_ticket_prob:.2f})")

    if low_confidence:
        print("\n=== 分类置信度不足,建议人工核对 ===")
        for f in low_confidence:
            print(f"  {f.raw_note} (模块置信度 {f.module_confidence:.2f}, "
                  f"类型置信度 {f.defect_type_confidence:.2f})")


if __name__ == "__main__":
main()跑完之后,你会得到一份带模块、问题类型、严重度、开单建议的结构化表格,笔记原文一字未改,测试员当时"感觉有点问题""不太确定"这些原始判断依据都完整保留在 raw_note字段里,同时多了可以统计、可以筛选、可以追溯的结构化维度。
六、笔记质量决定判断质量
探索性测试笔记天生简短、口语化,甚至偶尔词不达意,这是它的特点,不是缺陷本身。但对判断质量而言,光靠一句"页面卡了快 10 秒",模型能判断的信息量是有限的。两个实用建议:
- 把 Charter(测试目标)作为上下文一起传入。 上面代码里
session_context/SESSION_CHARTER就是干这个的——"探索个人中心头像上传的边界情况"这句话,能帮模型把"页面卡了快 10 秒"这条简短笔记准确关联到"用户中心"模块,而不是靠孤立的一句话瞎猜。 - 不要指望模型帮你把笔记"补全"。 如果笔记本身没写清楚复现路径、触发条件,Jev 不会替你编一个出来——它是分类判断模型,不是生成模型,缺失的信息就是缺失,分类判断也会相应地置信度偏低(这正是为什么低置信度要转人工核对,而不是硬让模型编个理由)。真正的解法是在测试过程管理上引导测试员:哪怕笔记简短,至少写清楚"做了什么操作 + 看到了什么现象"这两个基本要素,这是流程规范的问题,不是靠接入 Jev 能绕过去的。
七、这套方案能带来什么,不能带来什么
能带来的:
- 让探索性测试的产出从"一堆聊天记录"变成可以按模块、类型、严重度筛选和统计的结构化数据;
- 保留测试员原始判断的同时,减少"这条要不要开单"这种口头讨论的随意性——低置信度的统一转人工,高置信度的有统一标准可依;
- 为后续做"哪个模块的探索性测试发现率最高""哪类问题在哪个迭代周期集中出现"这类趋势分析提供数据基础。
不能带来的:
- 不能替代测试员做判断,只是把判断结构化、留痕化;
- 不能提升笔记本身的写作质量——它不生成文本,笔记写得越简略,分类判断的置信度就会越低;
- 不能替代"要不要开单"这件事背后真正的判断责任——
needs_bug_ticket只是一个建议信号,高置信度也不代表可以完全跳过人工确认再直接进入缺陷跟踪系统,具体自动化程度应该由团队自己的流程规范决定。
八、小结
探索性测试的价值本来就在于测试员那些没法被用例脚本捕捉的直觉和随手记录,把这些原始判断"翻译"成漂亮的正式报告,反而容易丢掉最有价值的一手信息。用 Jev 的 Choice/Score/Noul 原语给笔记打结构化标签、原文保持不动,恰好是"不生成文本"这个特性最合适的用武之地——这不是一个需要模型帮你写东西的任务,是一个需要模型帮你分类的任务。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号