ip定位查询:识别AI爬虫的底线判据

ip定位查询:识别AI爬虫的底线判据
创意信号站_思绪棱镜
修改于 2026-09-22 14:30:42
修改于 2026-09-22 14:30:42
最近不少网站运维注意到一个现象:日志里半夜涌进一批请求,UA写的是Chrome、还带着正常的Referer,看着像真人,可访问节奏和路径全是机器特征。这不是错觉。9月15日起,Cloudflare对新增域名默认屏蔽Training(训练类)与Agent(智能体类)爬虫,Search(搜索类)默认放行。判断"来的是人还是机器",正在变成网站的第一道防线——UA和浏览器指纹都能伪装,真正难造假的是来源IP的网络属性,这正是做一次ip定位查询就能拿到的判据。
一、先看数据:拦截爬虫已经是大盘动作
第三方测量显示,2026年9月4日这个时点,头部站点里已有24.0%至少全量屏蔽了一个AI爬虫;没有给出规范声明的自动化请求里,35.9%到37.1%被即时返回4xx。Cloudflare的默认策略覆盖全网20%以上的域名。往前看,《纽约时报》诉OpenAI、微软案解封的文件披露,超1000万篇文章被用于模型训练,近三分之一来自《纽约时报》单一来源。一边是内容方维权,一边是基础设施默认拦截,爬虫与反爬的拉锯从"要不要拦"推进到了"怎么拦得准"。
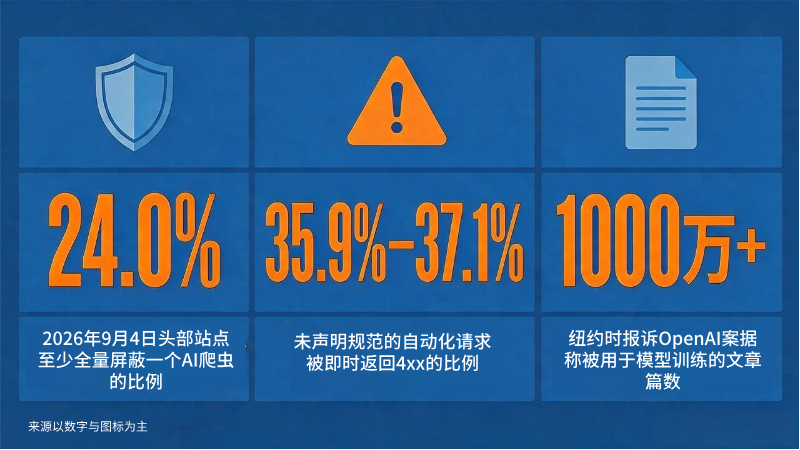
AI爬虫屏蔽比例与自动化请求返回率数据信息图
二、UA和指纹为什么不够用
UA是自报家门,把User-Agent写死成Chrome就能过掉简单的白名单;浏览器指纹——屏幕分辨率、字体、Canvas渲染差异——可以被自动化框架搅浑。这两样都踩在"客户端可声明"这条线上,声明方想改就改。真正难低成本伪造的,是"你从哪里连出来":来源IP挂在哪个ASN、属于什么网络类型,是网络接入侧的事实,不是请求头里写什么就是什么。
三、怎么用ip定位查询判定:看ASN和网络类型
做一次ip定位查询,除了归属地,还要看两个字段:ASN(自治域编号)和网络类型。住宅宽带、商业宽带、数据中心机房,在风控侧是完全不同的风险基线。真实用户大多落在住宅或移动网络段;批量训练爬虫、数据采集脚本几乎都跑在数据中心机房。判定逻辑可以压成一句话:来源IP一旦命中数据中心网络类型,先标成高风险、进下一步核验,而不是默认放行。
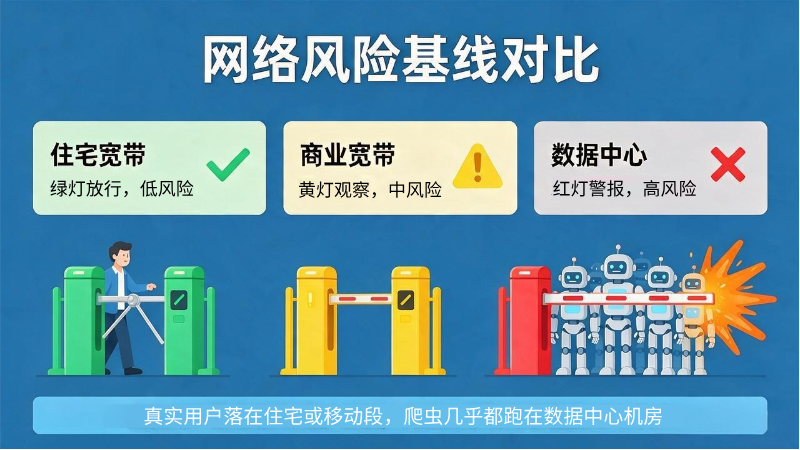
三种网络类型的风险基线对比图
四、代码实操:一次查询加一个判定
下面这段Python做两件事:调用IP查询接口拿ASN与网络类型,再按网络类型给出"是否为数据中心"的判定。三个细节要留意:网络类型做大小写归一;接口字段可能缺省或为None,要兜底;HTTP为200不代表业务成功,成功码以官方文档为准。
Python
import requests
API = "https://api.ipdatacloud.com/v2/query"
TIMEOUT = 1.5
DATACENTER_TYPES = {"idc", "hosting", "datacenter", "cloud", "cdn"}
def inspect_source(ip: str, key: str) -> dict:
 ip = str(ip or "").strip()
 if not ip:
 return {"status": "invalid_ip"}
 try:
 resp = requests.get(API, params={"ip": ip, "key": key}, timeout=TIMEOUT)
 resp.raise_for_status()
 body = resp.json()
 except (requests.RequestException, ValueError):
 return {"status": "query_failed"}
 data = body.get("data") if isinstance(body, dict) else None
 if not isinstance(data, dict) or not data:
 return {"status": "no_data"}
 net_type = str(data.get("net_type") or "").strip().lower()
 return {
 "status": "ok",
 "asn": str(data.get("asn") or "").strip() or None,
 "country": str(data.get("country") or "").strip() or None,
 "net_type": net_type or None,
 "is_datacenter": net_type in DATACENTER_TYPES,
 }
三个典型应用:注册登录风控里对来源做双栈解析;内容站对批量抓取做限速前的第一道分流;API网关在鉴权前按网络类型粗筛。这里有个隐患值得提:风控如果只看归属地、不看网络类型,数据中心段的爬虫会混在正常流量里进来,等发现时往往已经吃了几轮抓取。这套判定逻辑用ip定位查询就能落地,剩下的只是阈值和放行策略。
五、边界:识别不等于封禁
识别机器流量不等于封禁爬虫。判定结果拿来限速、分流、二次核验,而不是简单放行或全部拦下;给合规爬虫留一条按robots.txt声明来源的路,才站得住。判定要跟着网络类型走,而不是只盯归属地。想先验证自家出口的网络类型,可以在免费查询入口测一次,看本机落在住宅段还是机房段,再决定要不要接企业级API。
数据来源
- Cloudflare官方(2026年9月15日起默认屏蔽Training/Agent爬虫的策略说明)
- 第三方测量(2026年9月4日头部站点AI爬虫屏蔽比例与自动化请求4xx返回率)
- 《纽约时报》诉OpenAI、微软案解封文件(2026年9月17日)
本文系转载,前往查看
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号