让 AI 亲自上网干活:browser-use 开源项目实战拆解与踩坑
原创
让 AI 亲自上网干活:browser-use 开源项目实战拆解与踩坑
原创
大盘鸡拌面
发布于 2026-09-24 21:39:39
发布于 2026-09-24 21:39:39
一、先唠个嗑:你是不是也烦这些破事
说实话,搞开发、搞数据、搞运营的朋友,多少都干过这种活儿:每天早上打开某个后台,把昨天的数据扒下来,复制到表格里,再发个邮件给领导。或者盯着好几个电商网站比价,手动刷新、手动截图、手动记数字。
这种活儿无聊归无聊,但以前还真没啥好办法。写爬虫?好一点的网站都有反爬,JS 渲染的页面你得啃 Playwright,登录态还得维护 Cookie,网站改个按钮位置,脚本直接原地报废。用 RPA 工具?商业软件按坐席收费,一年下来钱包遭不住。
于是问题就变成了:能不能让 AI 直接看懂网页,然后替我把这些活儿干了?
答案是可以。今天要聊的这个开源项目叫 browser-use,GitHub 上已经攒了超过 10 万颗星,PyPI 上每个月的下载量 5000 多万次,直接杀进了 PyPI 下载榜前 600。它干的事情一句话就能说清楚:给 AI 装上一双能操作浏览器的手。
你用大白话告诉它"去这个网站,把销售额前十的商品信息整理出来",它自己打开浏览器、自己点页面、自己翻页、自己把数据抠出来还给你。不用写一个选择器,不用管 Cookie,甚至登录都能帮你搞定。
这篇咱们就把这个东西从头到尾扒一遍:它是啥、为啥这么火、底层怎么跑的、代码怎么写、生产环境能拿来干啥。全程说人话,看完你就能上手。
二、browser-use 到底是个啥
先给个官方定义压压惊:browser-use 是一个 Python 库,把大语言模型(LLM)和真实的 Chrome 浏览器连接起来,让 AI Agent 能像人一样浏览网页——看页面、点按钮、填表单、翻页、提取数据,一条龙。
几个关键事实先摆出来,你感受一下这个项目的分量:
- 出身:2024 年由苏黎世联邦理工(ETH Zurich)的两个小哥搞出来的,MIT 协议开源,商用随便用
- 热度:GitHub 10 万+ Star,曾经是开源史上 Star 涨得最快的项目之一
- 生态:LangChain、LlamaIndex 等主流 Agent 框架都有集成案例,一大堆商业产品(比如一些 AI 招投简历工具)底子就是它
- 技术底子:底层走的是 Chrome DevTools Protocol(CDP),不是传统的 Playwright 封装,性能更猛;2026 年的新版本还搞了个 Rust 写的内核(browser-harness),专给新一代模型"松绑"
- 门槛:Python 3.11+,pip 装完配个 API Key 就能跑,也支持本地 Ollama 模型
说白了,它解决的是一个特别朴素的矛盾:网页是给人看的,不是给 AI 看的。传统的 API 调用要等厂商开放接口,写爬虫要跟反爬斗智斗勇,而 browser-use 的思路是——别折腾了,让 AI 直接用"人的方式"上网。人能点的它就能点,人能看的它就能看。
三、它凭啥这么火:三个字,"真省事"
我第一次跑起来的时候,感受就俩字:离谱。我只写了一句中文任务描述,它自己打开了浏览器,自己搜索,自己点了三页翻页按钮,最后把结构化数据吐回来了。整个过程中我就喝了个水的功夫。
为啥能做到这一点?核心在于它对网页的"翻译"方式。它把页面的 DOM 抽象成一份带编号的元素清单,类似这样:
[1] <input type="search" placeholder="搜索商品">
[2] <button>搜索</button>
[3] <a> 电饭煲 ¥299 </a>
[4] <button>下一页</button>
然后把这份清单连同你的任务一起丢给 LLM。模型一看就懂了:"哦,我要搜电饭煲,先往 [1] 里填字,再点 [2]。"它返回一个动作指令,browser-use 负责真的去页面上执行,执行完拿到新页面的清单,再丢回给模型……如此循环,直到模型认为任务完成,输出最终结果。
这里面的妙处在于:LLM 负责思考和决策,browser-use 负责看和动手,两者各干各的擅长的事。而且因为看到的是"语义化的元素清单"而不是原始截图,模型的理解准确率比纯视觉方案高出一大截,token 消耗还更省。
四、工作原理:一图看懂整个循环
咱们把上面说的这套流程画出来,你就彻底明白了。browser-use 的核心就是一个 "感知 → 决策 → 执行 → 反馈" 的闭环:
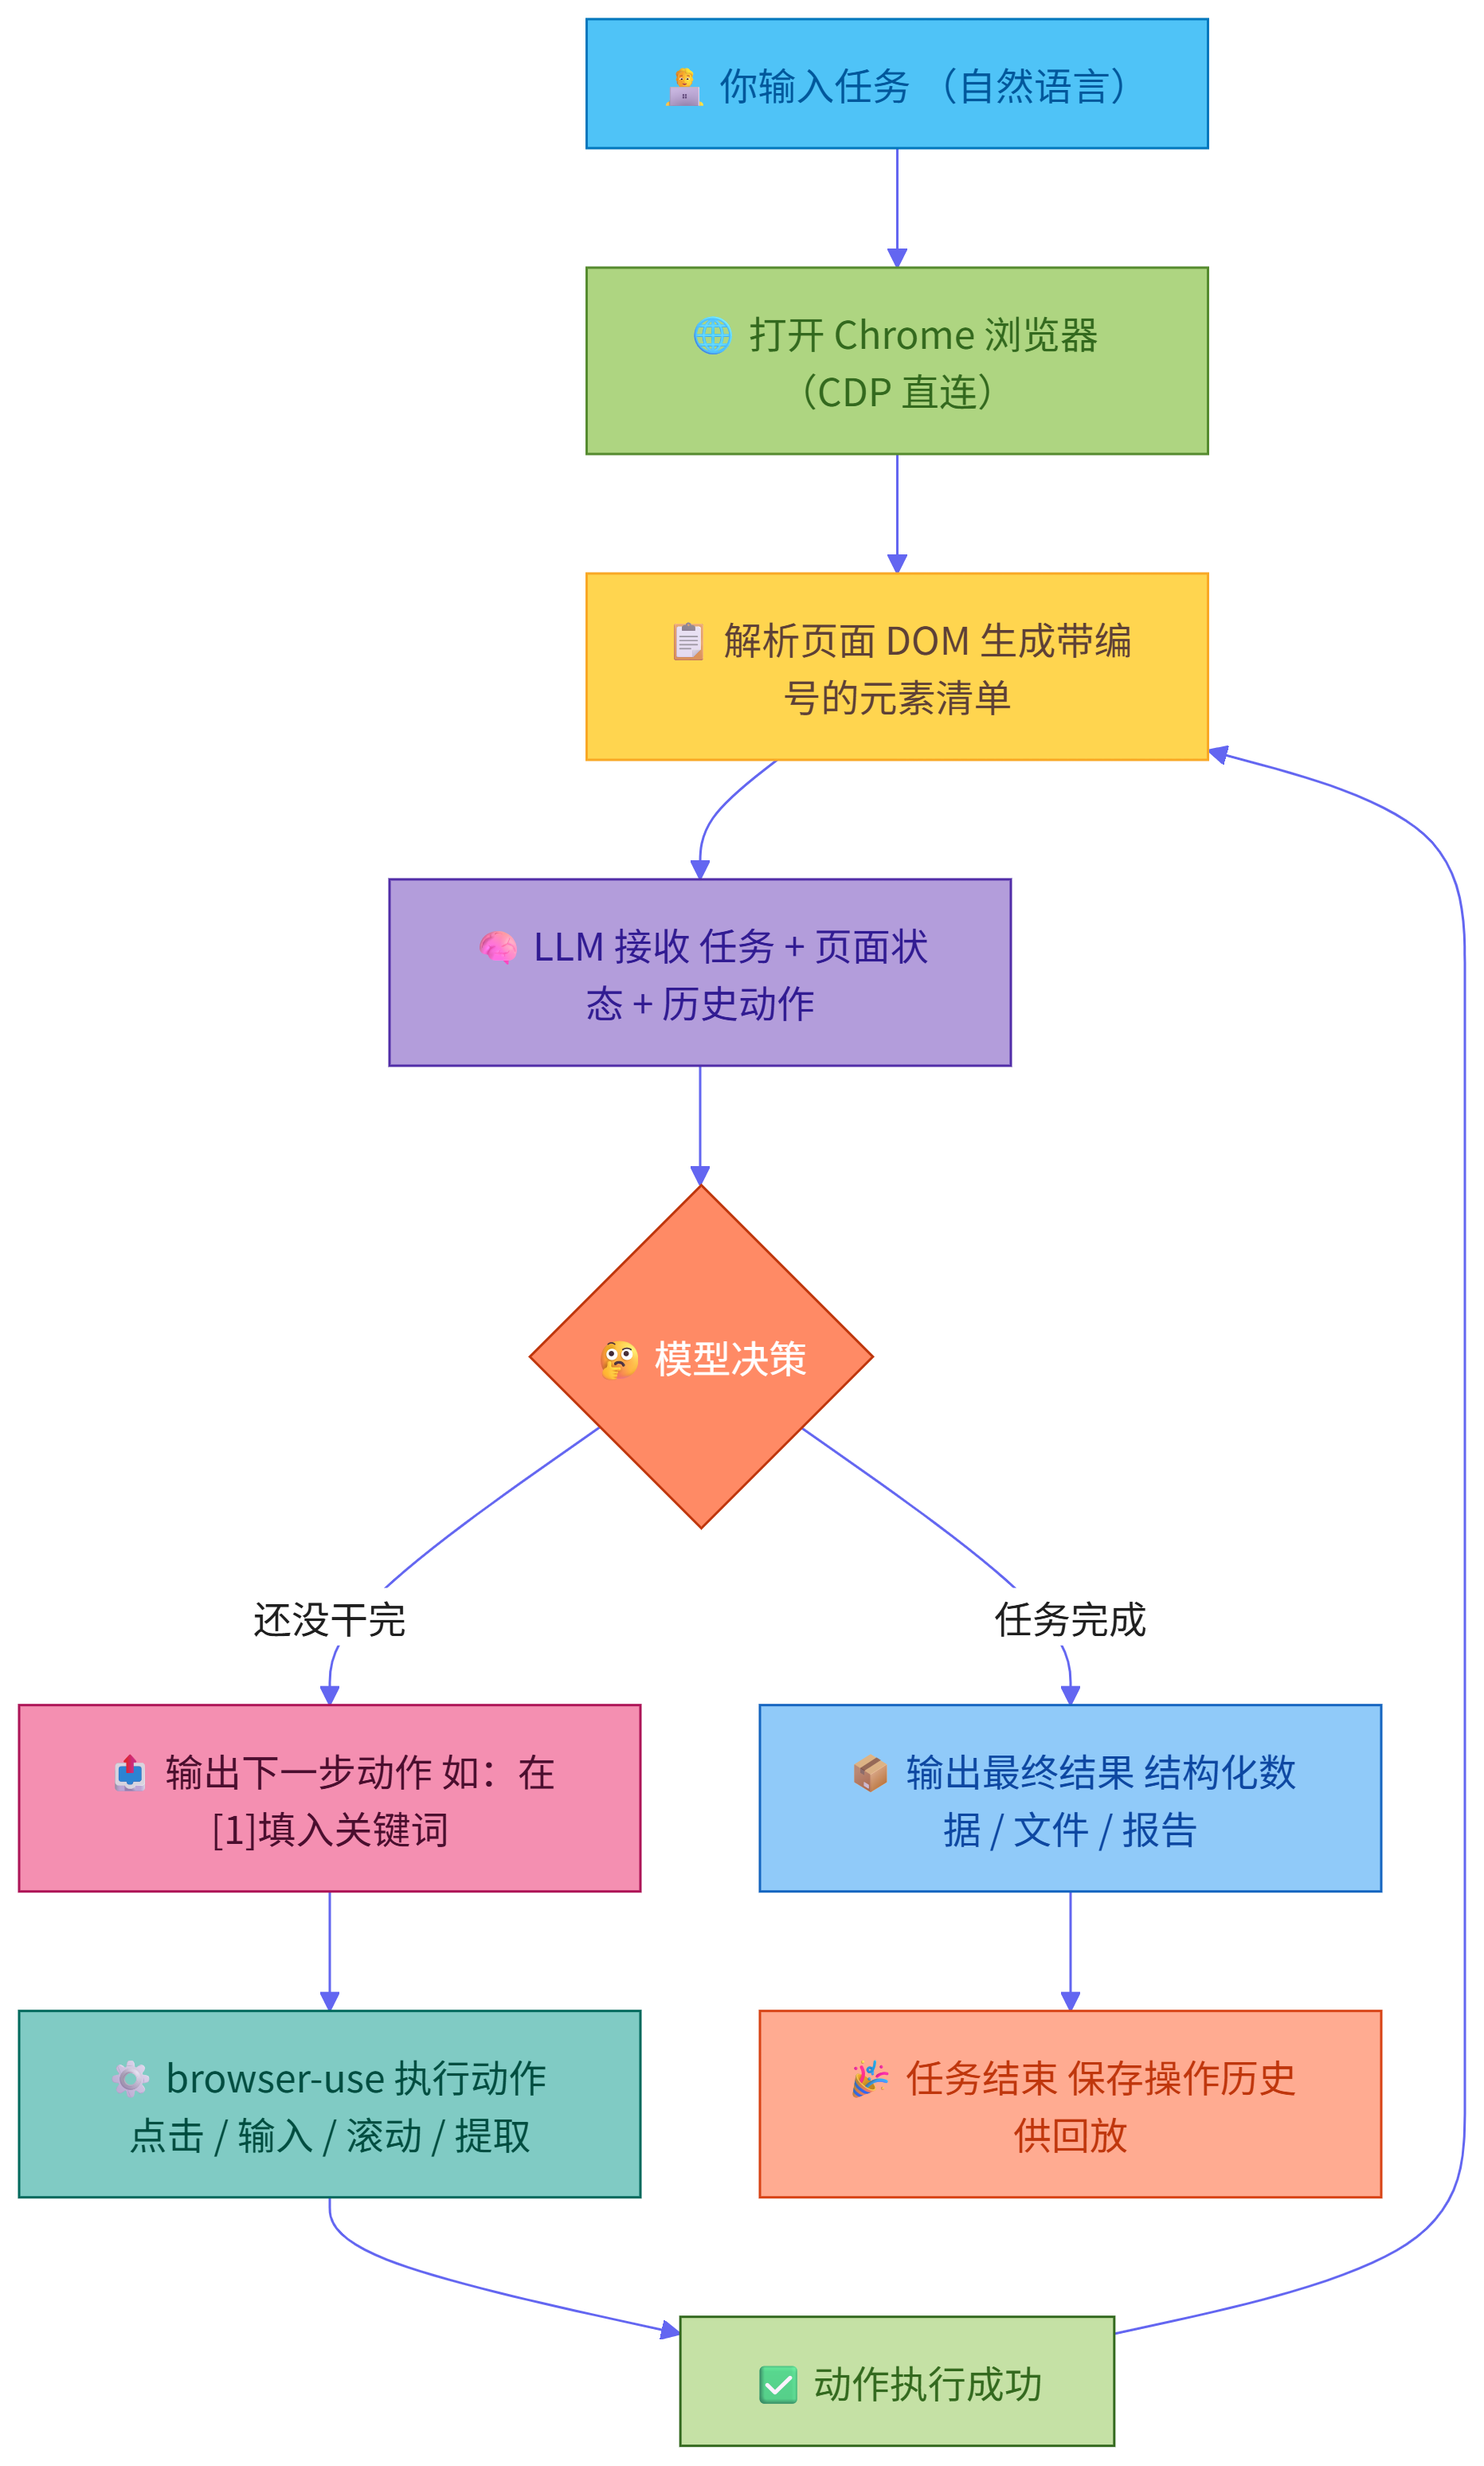
两个值得多嘴一句的点:
第一,它有"记忆"和"恢复"能力。 每一步动作都会记进 history,网页弹个窗、跳个 404、按钮点不动,模型会根据新的页面状态自己想办法绕过去,而不是像老脚本一样直接崩掉。这就是 Agent 和传统自动化脚本最本质的区别——脚本只会走剧本,Agent 会临场发挥。
第二,安全和边界是可配的。 你可以限制它只能访问哪些域名(allowed_domains),可以禁止它碰某些操作,敏感信息(密码、Key)有专门的传参通道,不会出现在日志里。生产环境用之前,这些配置一定要过一遍。
五、手把手跑起来:五分钟上手
5.1 安装
环境要求 Python 3.11 以上。推荐用 uv 装体验最好,普通 pip 也完全没问题:
# 方式一:pip 直接装
pip install browser-use

# 方式二:要体验 2026 年最新的 Rust 内核 beta 版
pip install "browser-use[core]"

# 装 Playwright 的浏览器内核(首次需要)
playwright install chromium --with-deps
然后建个 .env 文件,填上大模型的 Key:
# .env
OPENAI_API_KEY=sk-你的key
# 国产模型也行,DeepSeek、通义、Kimi 都有对应接入方式
5.2 第一个 Demo:让 AI 去查 GitHub 星标
经典开箱示例,10 行代码,让 Agent 去查 browser-use 仓库有多少 Star:
import asyncio
from dotenv import load_dotenv
from browser_use import Agent, Browser
from browser_use.llm import ChatOpenAI

load_dotenv()

async def main():
    browser = Browser(
        headless=False,  # 设成 True 就看不到浏览器窗口了
    )
    agent = Agent(
        task="去 GitHub 打开 browser-use 仓库页面,告诉我它现在有多少 Star、多少 Fork,最近一次提交是什么时候",
        llm=ChatOpenAI(model="gpt-4o"),
        browser=browser,
    )
    history = await agent.run()
    print("最终结果:", history.final_result())

asyncio.run(main())
跑起来之后你会亲眼看到浏览器被"一只看不见的手"操控:打开 github.com、搜索、点进仓库、读页面数字,最后在你的终端里打印出答案。第一次看到这画面的人,基本上都会愣三秒。
5.3 进阶:结构化数据提取 + 结果校验
实际干活的时候,我们一般不要"一句话回答",要的是结构化的数据,方便直接进数据库或 Excel。browser-use 支持用 Pydantic 定义输出格式,模型会照着这个 schema 吐 JSON:
import asyncio
from dotenv import load_dotenv
from pydantic import BaseModel
from browser_use import Agent, Browser
from browser_use.llm import ChatOpenAI

load_dotenv()

class JobInfo(BaseModel):
    """单条招聘岗位信息"""
    title: str          # 岗位名称
    company: str        # 公司名
    salary: str         # 薪资范围
    location: str       # 城市
    tags: list[str]     # 技术标签

class JobList(BaseModel):
    """岗位列表"""
    jobs: list[JobInfo]
    total_found: int

async def main():
    browser = Browser(headless=True)
    agent = Agent(
        task=(
            "去招聘网站搜索'大模型算法工程师'岗位,"
            "提取前两页的岗位信息,包括岗位名、公司、薪资、城市和技术标签。"
        ),
        llm=ChatOpenAI(model="gpt-4o"),
        browser=browser,
        output_schema=JobList,   # 关键:指定输出结构
    )
    history = await agent.run()
    result = JobList.model_validate_json(history.final_result())
    for job in result.jobs:
        print(f"{job.company} | {job.title} | {job.salary} | {job.location}")

asyncio.run(main())这段代码跑完,result 就是一个正经的 Python 对象列表,jobs[0].salary 直接取值,入库、发报告随便你。这就是"AI 爬虫"和传统爬虫最大的体验差异——你描述要什么,而不是研究页面结构怎么抠。
六、完整实战:电商价格监控助手
光看 Demo 不过瘾,来个真实业务场景的完整例子。假设你是某消费品牌的运营,老板每天早上要一份竞品价格日报:去三个电商平台查自家主推商品和竞品的价格,汇总成表,有降价的要标红提醒。
人工干这活的痛点很明显:三个平台登录方式不一样,有的还要扫码,每天花四十分钟纯属浪费生命。上 browser-use 之后的方案是这样的:
import asyncio
import json
from datetime import datetime
from dotenv import load_dotenv
from pydantic import BaseModel
from browser_use import Agent, Browser, BrowserProfile
from browser_use.llm import ChatOpenAI

load_dotenv()

# ---------- 数据结构 ----------
class PriceRecord(BaseModel):
    platform: str      # 平台:京东/淘宝/拼多多
    product: str       # 商品名
    price: float       # 当前价
    shop_type: str     # 自营/旗舰店/第三方
    coupon: str        # 优惠信息,没有则写"无"

class PriceReport(BaseModel):
    records: list[PriceRecord]
    collected_at: str

# ---------- 昨天的价格基线(实际项目里从数据库读) ----------
BASELINE = {
    "品牌A空气炸锅 5L": 299.0,
    "竞品B空气炸锅 4.5L": 349.0,
    "竞品C可视化炸锅": 399.0,
}

async def collect_one(browser: Browser, platform: str, task: str) -> PriceReport:
    """单个平台的采集任务,独立 Agent 跑,互不干扰"""
    agent = Agent(
        task=task,
        llm=ChatOpenAI(model="gpt-4o"),
        browser=browser,
        output_schema=PriceReport,
        browser_profile=BrowserProfile(
            allowed_domains=[f"*{platform}.com"],  # 安全边界:只准去这个平台
        ),
    )
    history = await agent.run()
    return PriceReport.model_validate_json(history.final_result())

async def main():
    browser = Browser(headless=True)

    tasks = [
        ("jd",  "打开京东,搜索'空气炸锅',找到'品牌A空气炸锅 5L'、'竞品B空气炸锅 4.5L'、'竞品C可视化炸锅'这三个商品,记录当前价格、店铺类型和优惠信息"),
        ("taobao", "打开淘宝,搜索上述三款空气炸锅,记录各店铺当前价格和是否有优惠券"),
        ("pinduoduo", "打开拼多多,搜索上述三款空气炸锅,记录百亿补贴价"),
    ]

    all_records = []
    for platform, desc in tasks:
        try:
            report = await collect_one(browser, platform, desc)
            all_records.extend(report.records)
        except Exception as e:
            # 单个平台失败不影响整体,记录后继续
            print(f"[WARN] {platform} 采集失败: {e}")

    await browser.close()

    # ---------- 对比基线,生成日报 ----------
    lines = ["# 竞品价格日报 " + datetime.now().strftime("%Y-%m-%d"), ""]
    for r in all_records:
        old = BASELINE.get(r.product)
        if old is None:
            continue
        diff = round(r.price - old, 2)
        if diff < 0:
            flag = f"🔴 降价 {abs(diff)} 元!"       # 降价标红
        elif diff > 0:
            flag = f"🟢 涨价 {diff} 元"
        else:
            flag = "➖ 持平"
        lines.append(f"- 【{r.platform}】{r.product}:¥{r.price}({flag})优惠券:{r.coupon}")

    daily = "\n".join(lines)
    with open(f"price_report_{datetime.now():%Y%m%d}.md", "w", encoding="utf-8") as f:
        f.write(daily)
    print(daily)
    # 生产环境里,这里接企业微信/钉钉 webhook 把日报推给老板

asyncio.run(main())
再配个 Linux crontab,每天早上七点自动跑:
# 每天早上 7:00 执行价格监控
0 7 * * * cd /opt/price-monitor && /usr/bin/python3 monitor.py >> logs/run.log 2>&1
这套方案落地之后,原来每天四十分钟的手工活儿变成了零成本。而且它比传统爬虫皮实得多——平台改版了,按钮挪位置了,Agent 看一眼新页面自己就适应了,不用半夜爬起来改 XPath。
七、多平台并发时的调用关系
上面例子里是串行跑三个平台,实际生产中一般用 asyncio.gather 并发跑,速度快三倍。这时候整个系统的调用链长这样:
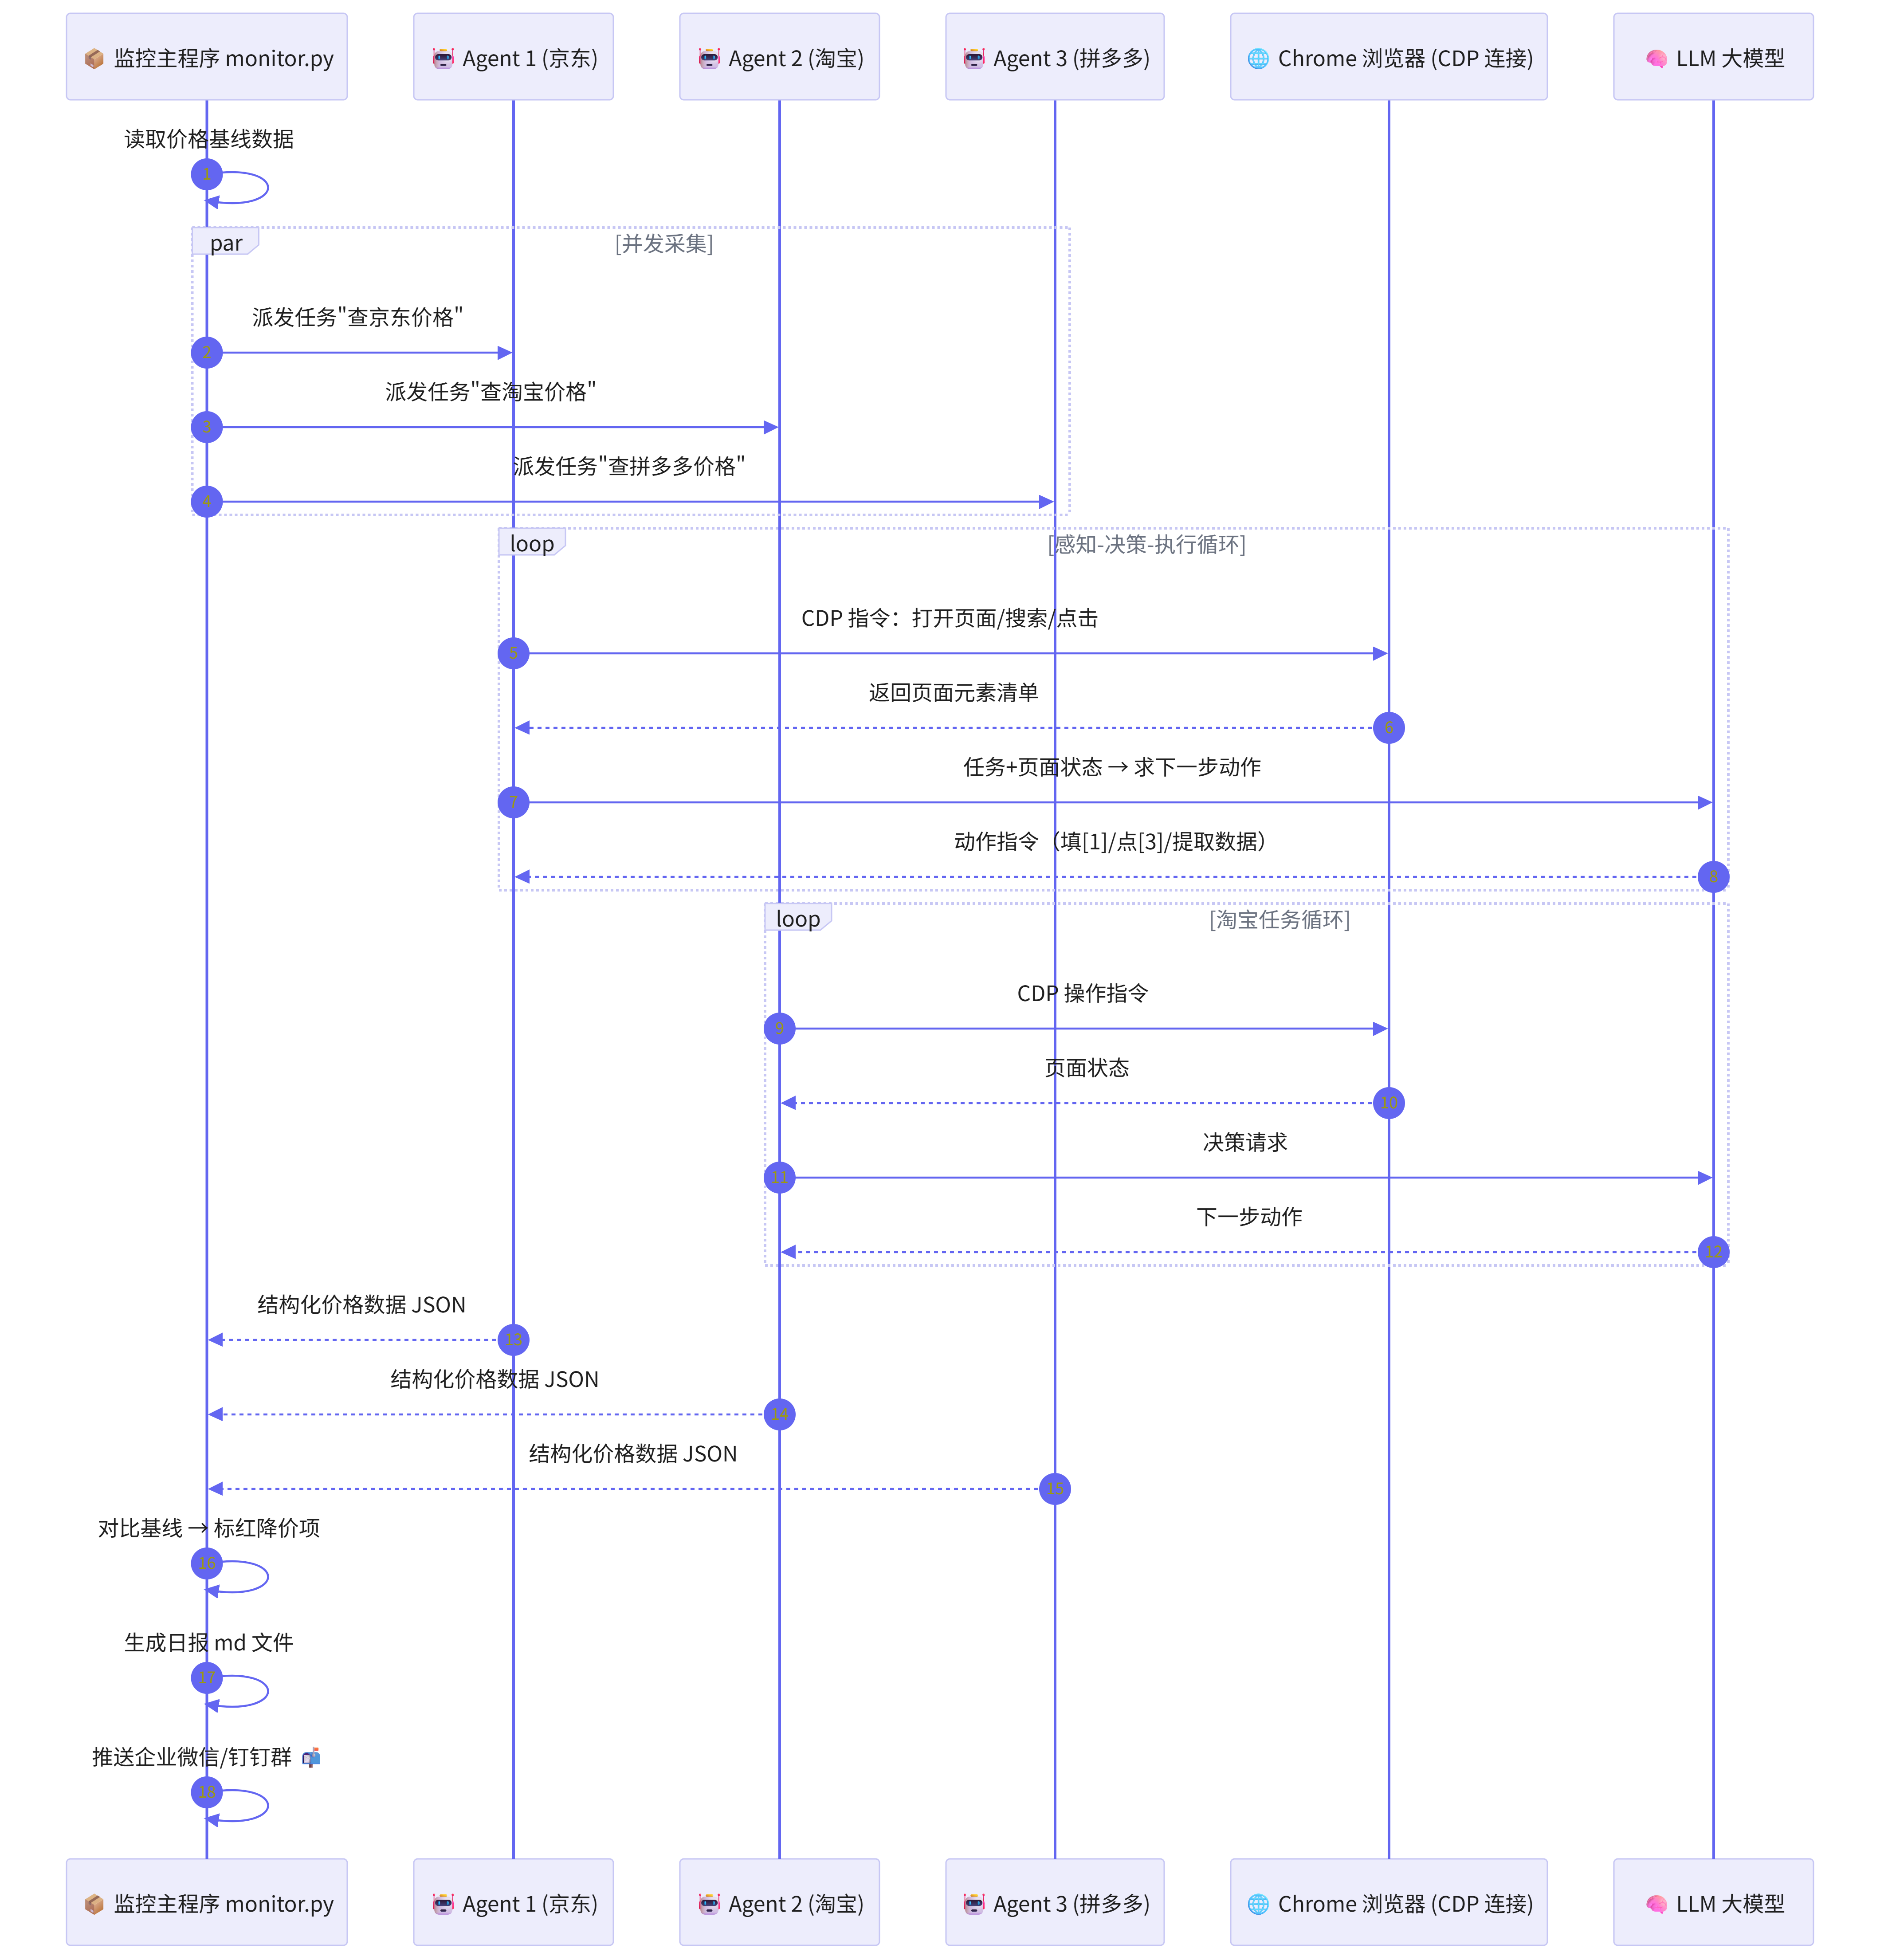
从这个时序图能看清一个重点:每个 Agent 都在独立地和浏览器、大模型对话,主程序只负责派活儿和收结果。哪一路挂了不影响其他路,这就是把"任务编排"和"页面操作"解耦带来的好处。
八、生产环境避坑指南
吹了这么多,得泼点冷水。browser-use 好用,但往生产环境里放之前,有几个坑你必须知道:
1. Token 成本会吓你一跳。 每一步都要把页面元素清单发给大模型,一个复杂任务跑几十步很正常,token 烧得比普通对话快得多。建议:简单任务用便宜模型(DeepSeek、GPT-4o-mini),只在关键决策上用贵模型;能用 output_schema 一次吐结果的别让它多跑几轮。
2. 登录态要靠 Browser Profile 保住。 别让 Agent 每次都重新登录。用 user_data_dir 指定持久化的浏览器配置目录,Cookie 和 Session 会留下来,下次直接用。
3. 别让它"自由发挥"改数据。 监控类任务只读不写,一定要用 allowed_domains 划好地盘,重要操作(下单、删数据)加人工确认环节。Agent 偶尔会"聪明反被聪明误",你让它比价,它可能顺手帮你下单了——真事儿,社区里有人踩过。
4. 反爬依然存在。 Agent 模拟的是真人操作,频率上比传统爬虫温和,但高并发跑还是会被风控盯上。控制并发数、加随机延迟、该上代理就上代理。
5. 结果要校验。 大模型会有幻觉,价格提取错了、漏了商品,都可能发生。关键数据建议跑两遍交叉验证,或者对异常值(比如价格低得离谱)单独复核。history.is_done() 和 history.final_result() 之外,多看看 history.errors()。
九、它跟 LangChain、Playwright 是什么关系
不少人会混淆,捋一下:
对比项 | 传统爬虫 (requests/Scrapy) | 浏览器自动化 (Playwright/Selenium) | browser-use |
|---|---|---|---|
写法 | 手写选择器和解析规则 | 手写页面操作脚本 | 自然语言描述任务 |
应对改版 | 页面一改就崩 | 脚本一改就崩 | Agent 自己适应 |
登录/验证码 | 很麻烦 | 需要额外处理 | Agent 自己想办法 |
成本 | 几乎为零 | 低 | LLM token 费用 |
适合场景 | 大批量、结构稳定 | 固定流程回归测试 | 低频、多变、复杂流程 |
一句话总结:高频稳定的大流量采集,用传统爬虫更省;流程复杂、页面多变、量不大的活儿,browser-use 是降维打击。它跟 LangChain 是互补关系——LangChain 管逻辑编排,browser-use 是其中一个能上网的"工具手"。
十、写在最后
回过头看,browser-use 火起来不是偶然。它踩中了两个趋势的交汇点:一是大模型的理解能力终于强到能可靠地"看懂"网页了;二是企业里大量脏活累活恰恰都困在浏览器里——各种没有 API 的后台、各种要人肉搬运的数据。
我的判断是:未来两三年,"让 AI 替你上网干活"会像 Excel 宏一样成为职场标配技能。你现在花一个下午把 browser-use 玩明白,可能就省下后面几年里几百个小时的重复劳动。
动手吧,从让它帮你查个天气开始。
参考资料:
- browser-use 官方仓库:https://github.com/browser-use/browser-use
- browser-use 官方文档:https://docs.browser-use.com
- PyPI:https://pypi.org/project/browser-use/
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号