ARTS 0927: 单栈逐层展开嵌套字符串、包管理器与 Agent 沙箱本质同源与单次前向传播复刻极速决策模型
原创
ARTS 0927: 单栈逐层展开嵌套字符串、包管理器与 Agent 沙箱本质同源与单次前向传播复刻极速决策模型
原创
leikooo
发布于 2026-09-27 21:45:50
发布于 2026-09-27 21:45:50
ARTS 0927: 单栈逐层展开嵌套字符串、包管理器与 Agent 沙箱本质同源与单次前向传播复刻极速决策模型
每周完成一个 ARTS: 至少做一个 leetcode 的算法题、阅读并点评至少一篇英文技术文章、学习至少一个技术技巧、分享一篇有观点和思考的技术文章。(也就是 Algorithm、Review、Tips、Share 简称 ARTS)
Algorithm
算法:https://leetcode.cn/problems/decode-string/?envType=study-plan-v2&envId=selected-coding-interview
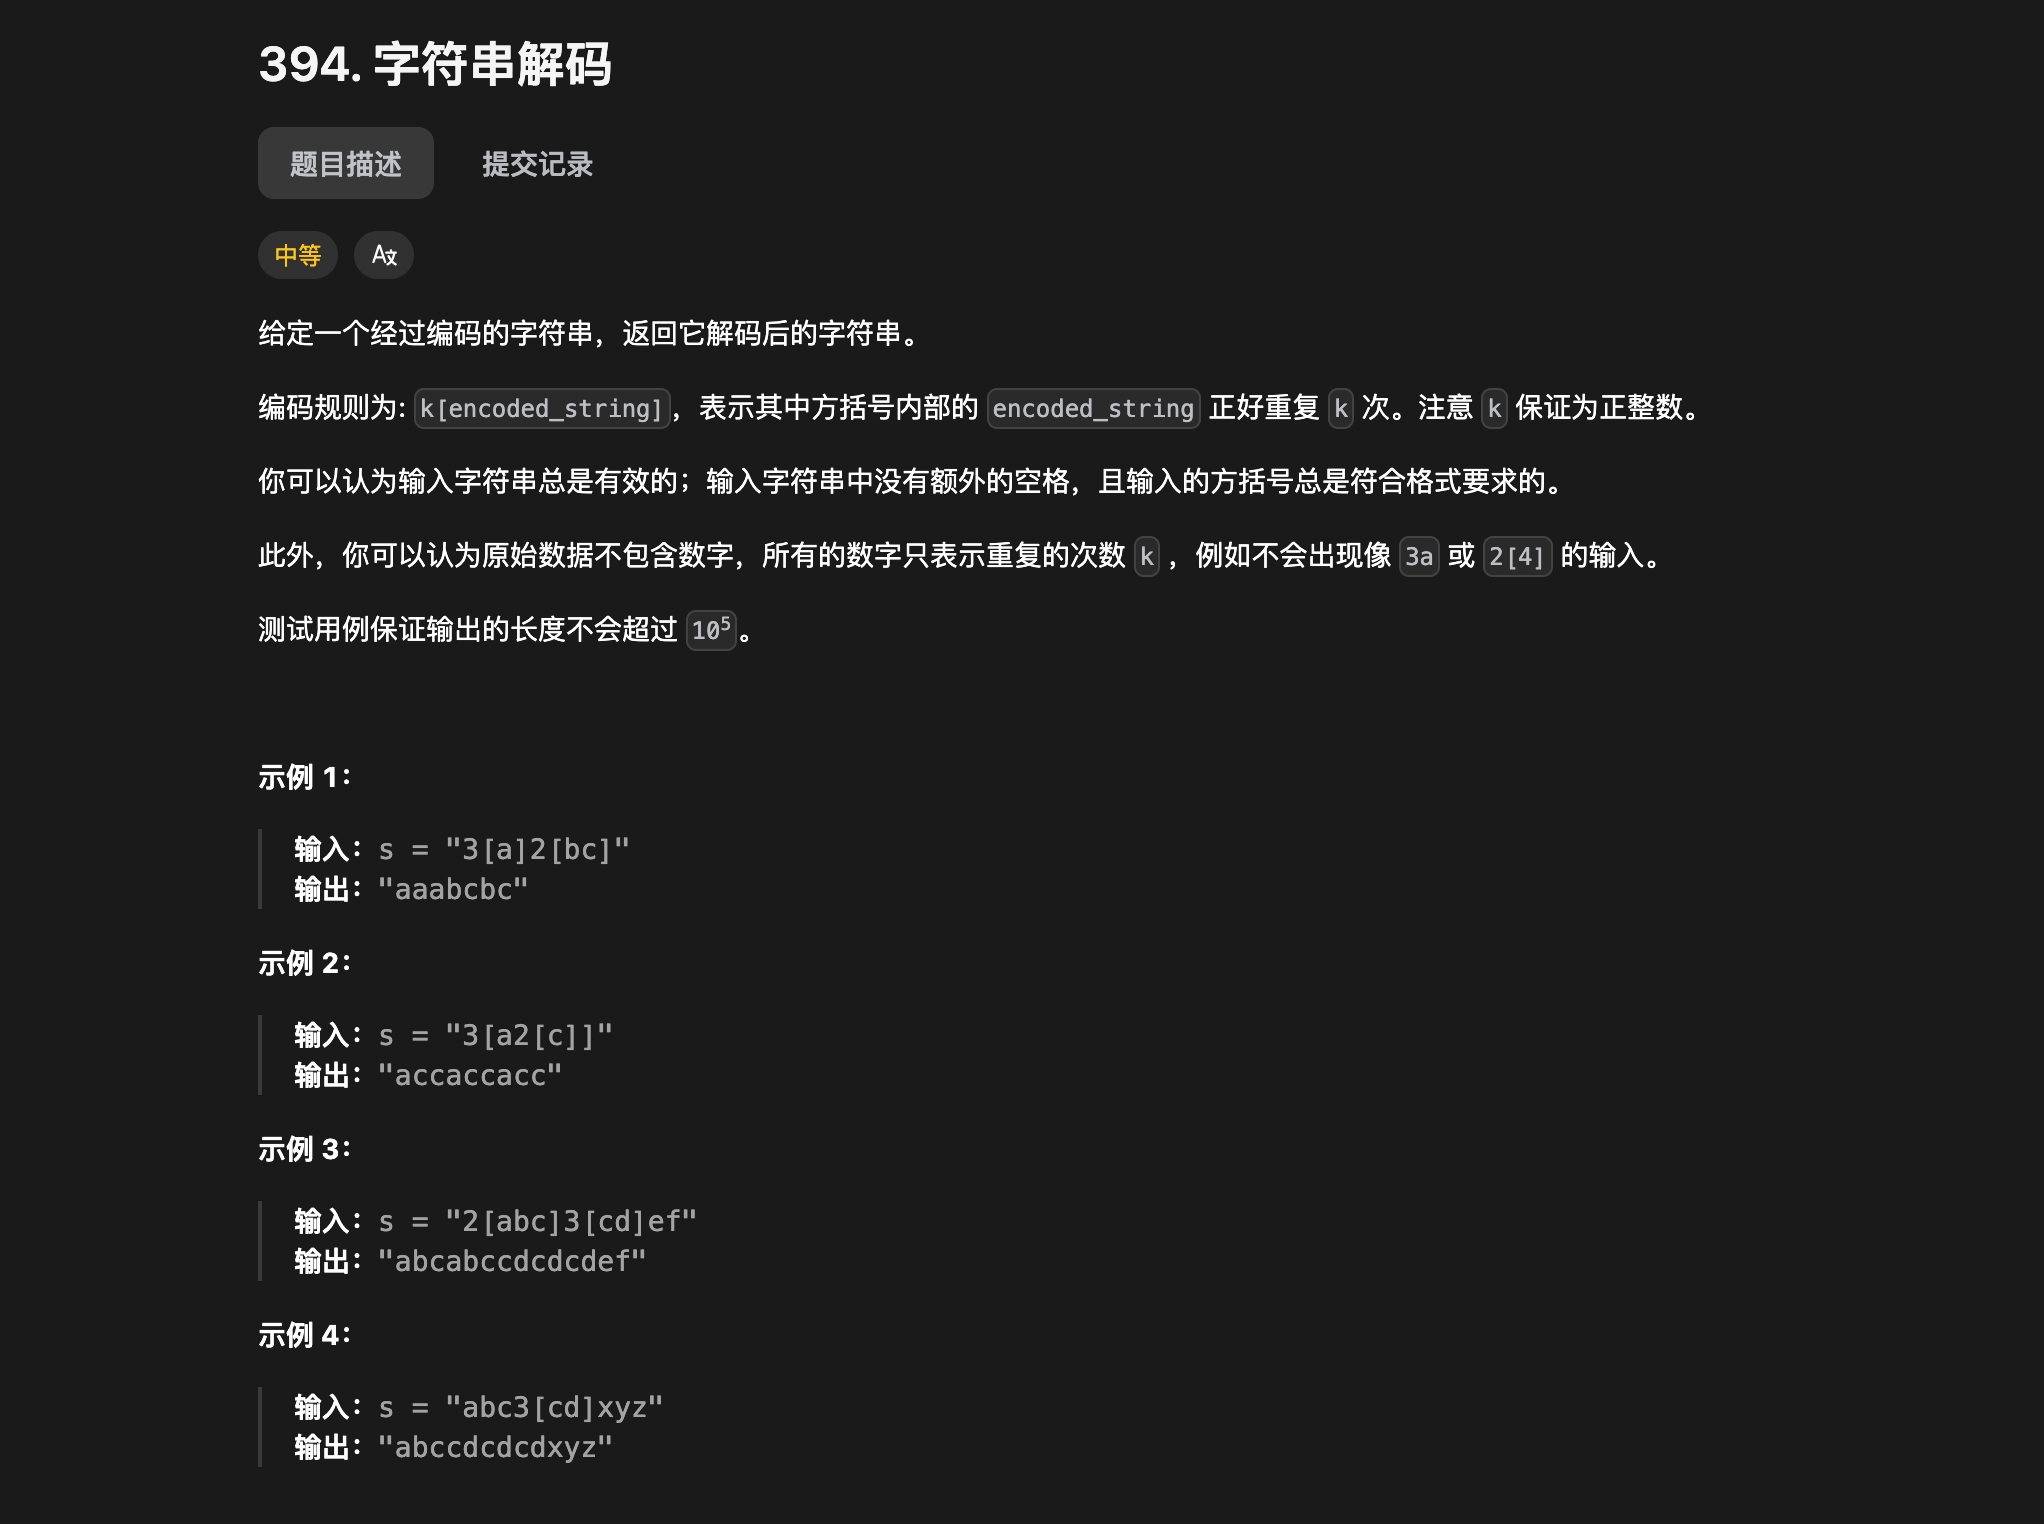
image-20260927181325161
我目前想到的思路。遍历字符串,数字、[、字母依次压栈,遇到 ] 时往回 pop 到 [,取出前面的数字,重复拼接后压回栈。嵌套括号也能自然处理,因为内层展开后压回栈,外层再 pop 时拿到的就是已经展开好的字符串。
需要注意(踩过的 3 个坑):
1、重复次数:pop 出来的 values 里已经有一份了,循环应该从 j=0 到 j < nums-1,否则会多重复一次
2、不能用 `reverse()` 处理 pop 顺序:栈里有些元素是之前展开过的多字符字符串(比如 "jkjk"),如果先 append 再对整个 values 做 reverse(),会把多字符元素内部顺序也反转掉。正确做法是 pop 的时候直接用 insert(0, stacks.pop()) 保持正确顺序
3、最终拼接用 `append` 不是 `insert(0,...)`:Java 的 Stack for-each 从底到顶遍历,用 append 才是正序拼接
代码:
public String decodeString(String s) {
    if (s.isEmpty()) {
        return "";
    }
    char[] chars = s.toCharArray();
    Stack<String> stacks = new Stack<>();
    StringBuilder num = new StringBuilder();
    for (char c : chars) {
        if (Character.isDigit(c)) {
            num.append(c);
        } else if (c == '[') {
            if (num.length() > 0) {
                stacks.push(num.toString());
                num = new StringBuilder();
            }
            stacks.push(String.valueOf(c));
        } else if (c == ']') {
            StringBuilder values = new StringBuilder();
            while (!stacks.isEmpty() && !"[".equals(stacks.peek())) {
                values.insert(0, stacks.pop());
            }
            // 单独拿出来 [
            stacks.pop();
            int nums = Integer.parseInt(stacks.pop());
            String coreStr = values.toString();

            for (int j = 0; j < nums - 1; j++) {
                values.append(coreStr);
            }
            stacks.push(values.toString());
        } else {
            stacks.push(String.valueOf(c));
        }
    }
    StringBuilder result = new StringBuilder();
    for (String str : stacks) {
        result.append(str);
    }
    return result.toString();
}
Review
文章:https://nesbitt.io/2026/09/24/package-manager-sandboxing.html
Andrew Nesbitt(Homebrew 维护者)对各包管理器沙箱机制做了一次全面调查。文章核心观点是:包管理器沙箱和 AI 编码 Agent 沙箱本质上是同一个问题,都需要执行未经审查的第三方代码,都收敛到了同一组 OS 原语(macOS 的 Seatbelt、Linux 的 Landlock/namespace),甚至在实际场景中互相嵌套运行(Homebrew 专门处理了"在 Agent 沙箱里运行 brew"的情况)。
几个关键发现:
- 已默认启用 OS 级沙箱的包管理器屈指可数:opam(2018 年起)、SwiftPM(仅 macOS)、Nix/Guix(初衷是可复现性而非安全)、Bazel。大部分主流包管理器的沙箱提案还停留在 Issue 阶段
- 白名单 ≠ 沙箱:JS 生态在 Shai-Hulud 蠕虫事件后全面转向安装脚本白名单(pnpm → Bun → Yarn → npm 12),但白名单是二元的:要么运行要么不运行。沙箱解决的是"运行时能访问什么",比如允许 esbuild 编译但禁止它读 SSH 密钥
- "交接"(hand-off)是最薄弱的环节:沙箱内构建产出的清单、缓存、步骤列表,会被包管理器以完整权限执行。Homebrew 7.0 修复的 LaunchServices 沙箱逃逸就是这类交接 Bug
- 消除代码执行可能比沙箱更有效:Go 和 Elm 从未有安装钩子;NuGet 删除了
install.ps1;Homebrew 的*_steps把任意 Ruby 钩子替换为签名的声明式数据
最让人印象深刻的一个数据:Anthropic 报告用户对 Claude Code 权限弹窗的批准率高达 93% —— 这就是为什么"每次都问用户"行不通,必须走沙箱路线。真正使用的时候,都是不看内容,直接无脑点击同意的,我就是这样😂
Agent 具备自主安装依赖的能力 + 包管理器缺乏沙箱 = 供应链攻击的绝佳放大器。Shai-Hulud 蠕虫通过 npm postinstall 传播后,居然还能把 hook 写入 Claude Code 的配置文件实现持久化,这说明 Agent 和包管理器的安全边界必须协同设计,而不是各管各的。
Tips
最近没啥 Tips 推荐一些 mac 软件吧:
1、Stats:展示状态
2、OpenUsage:查看 Cursor、Claude、Codex 等等的使用额度、充值时间等等,这里不推荐 OpenClaw 之父的 CodexBar,他运行一段时间磁盘的读取量非常夸张,个人强烈不推荐,下面是官方的演示图片:
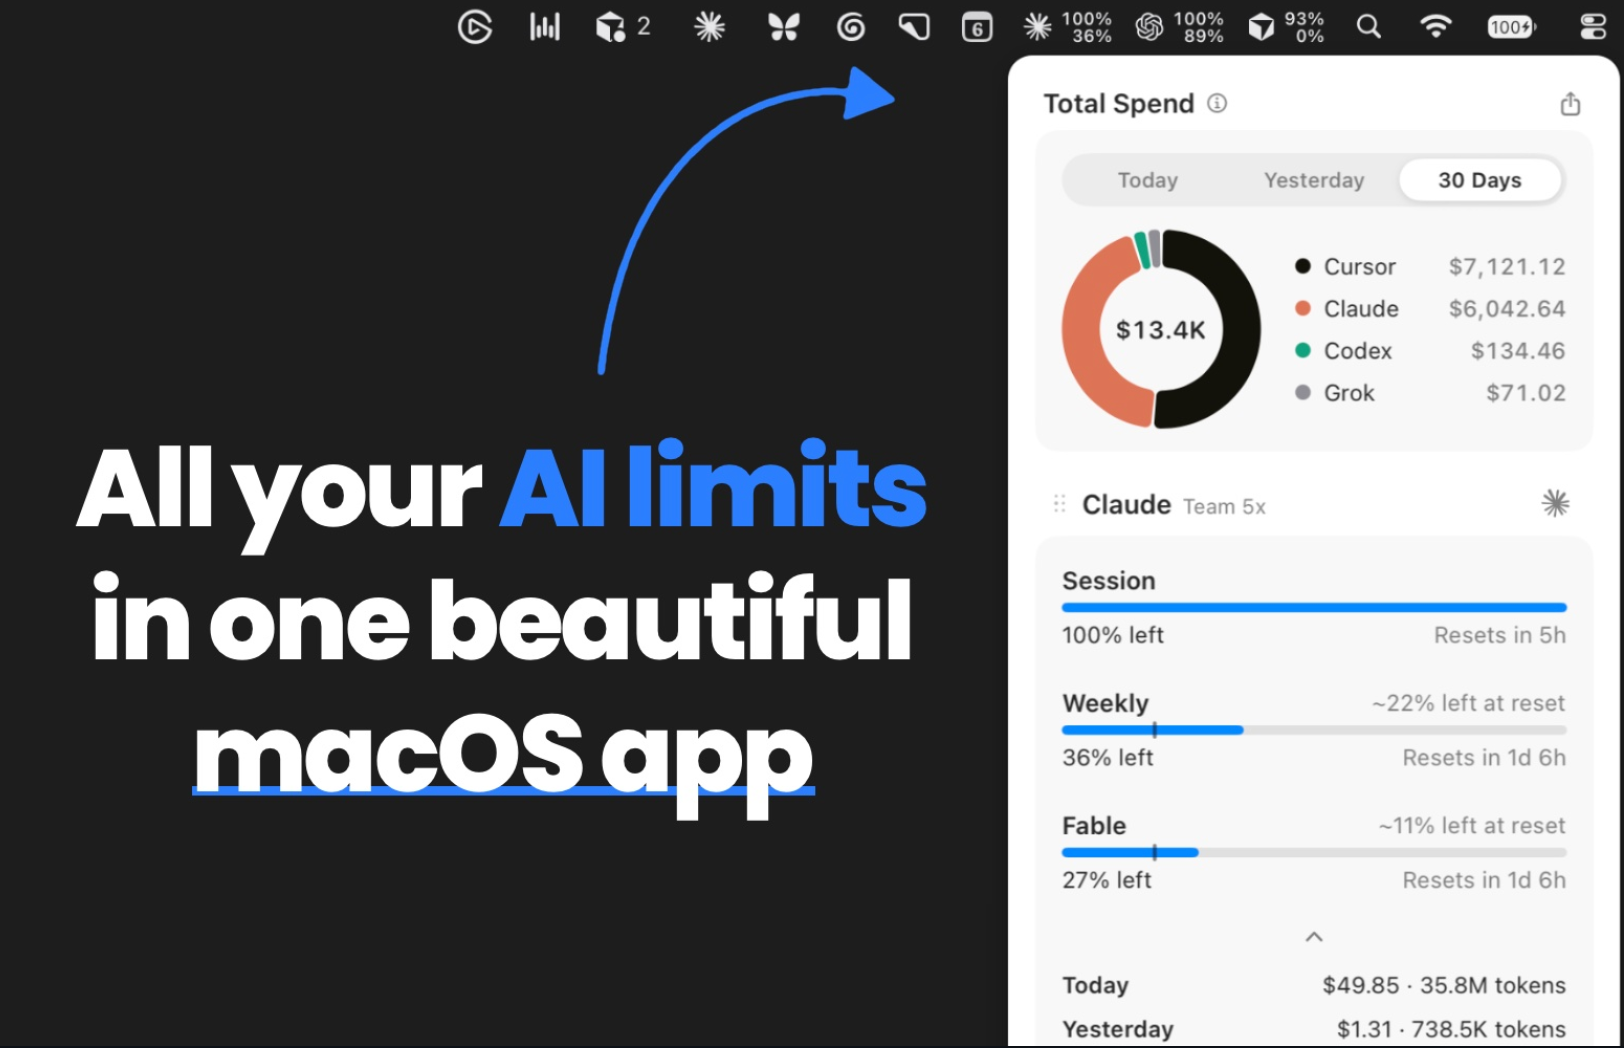
image-20260927223113013
3、EcoPaste:剪切板,如果有一些问题可以让 AI 修复之后继续使用,免费开源的 yyds
Share
文章:https://www.privatemode.ai/blog/system-one-from-glm-flash(虽然有点广子,但是还有有东西的)
Privatemode AI 这篇文章演示了一个非常巧妙的技巧:如何把普通的开源 LLM(GLM-5.3-Flash)变成一个类似 TypeSafe AI Jev 的 "System One" 决策模型。
背景:TypeSafe AI 最近发布了 Jev,一个专为结构化决策设计的非自回归模型。它不像传统 LLM 那样逐 token 生成文本,而是在单次前向传播中直接输出决策结果和校准过的置信概率,号称比前沿 LLM 快 ~200x、便宜 ~400x。但 Jev 是闭源的。
核心技巧:这篇文章展示了如何用开源模型复刻这个能力,关键就是 vLLM 的 allowed_token_ids 参数。
`allowed_token_ids` 是什么? 它是 vLLM SamplingParams 中的一个参数,作用是在采样阶段对 logits 做 masking:把不在列表里的所有 token 的概率被严格限制为 0,保证绝对不会被生成 ,强制模型只能从你指定的 token 中选择输出。这意味着模型在一次前向传播中,会把所有概率质量分配给你允许的那几个 token。
怎么用? 举一个情感分类的例子:
from vllm import LLM, SamplingParams
import math

llm = LLM(model="zai-org/glm-4-9b-chat-1m")
tokenizer = llm.get_tokenizer()

# 定义标签 → 获取对应的 token ID
labels = ["0", "1", "2"]  # 0=正面, 1=负面, 2=中性
allowed_ids = [tokenizer.encode(l)[0] for l in labels]

params = SamplingParams(
    max_tokens=1,              # 只输出一个 token
    allowed_token_ids=allowed_ids,
    logprobs=len(labels),      # 获取所有候选的 logprob
    temperature=0,             # 确定性输出
)

prompt = "判断以下评论的情感倾向(0=正面/1=负面/2=中性):'这个产品太好用了!'\n答案:"
outputs = llm.generate([prompt], params)

# 读取结果
token = outputs[0].outputs[0].text
logprob = outputs[0].outputs[0].logprobs[0][int(outputs[0].outputs[0].token_ids[0])].logprob
confidence = math.exp(logprob)  # e^logprob = 概率

print(f"分类: {token}, 置信度: {confidence:.2%}")
# 输出: 分类: 0, 置信度: 94.32%几个关键细节:
- `max_tokens=1`:只生成一个 token,跳过自回归循环,这是速度提升的关键
- logprob → 置信度:
logprob=0.0表示 100% 置信 e^0=1,越负越不确定。通过math.exp(logprob)可以直接得到概率值 - 标签必须是单 token:如果标签被 tokenizer 拆成多个 token(比如 "Very Positive"),只会生成第一个 token,结果就废了。所以用数字编号("0"/"1"/"2")是最安全的
- 与 structured output 的区别:vLLM 也有
guided_decoding(JSON schema 约束),但那是在多 token 生成中逐步约束,仍然是自回归的。allowed_token_ids+max_tokens=1才是真正的"单次前向传播"
那么折腾了半天和原版的 Jev 有啥区别?这个 「Jev」可以做到图像做分类决策、可以更换更强的开源模型做决策等等
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号