10GB 数据 12 秒入库,计算比 Python 快 71 倍!DolphinDB 新能源场景实测曝光
原创
10GB 数据 12 秒入库,计算比 Python 快 71 倍!DolphinDB 新能源场景实测曝光
原创
DolphinDB
修改于 2026-09-28 13:36:08
修改于 2026-09-28 13:36:08
在我国“双碳”目标驱动下,新能源装机规模持续增长,新能源场站正加速向规模化、智能化演进,随之而来的是设备监测数据量的极速攀升。与此同时,光伏、储能、叶片监测等业务场景多元发展,数据来源多样、格式繁杂、时效要求各异,如何高效存储与计算这些海量高频数据,正成为新能源企业数字化建设进程中必须直面的命题。
多系统拼接,成为新能源数据底座的“绊脚石”
某新能源企业在数据底座选型过程中,发现传统方案面临数据分散、技术体系不匹配、运维复杂等问题,迫切希望找到一套轻量化解决方案。在实际建设中,传统方案普遍采用的是多系统拼接模式,数据存储在数据库中,业务计算则依赖 Python 等外部程序从数据库拉取数据后再另行处理,这套模式在新能源场景中通常会面临以下核心痛点:
•计算复杂,开发难:新能源场景下的监测数据分析往往涉及复杂业务逻辑,开发人员需在库外完成取数、解析、筛选与复杂计算逻辑实现,代码量大、步骤繁琐、开发周期长。
•链路冗长,延迟高:数据需要在不同系统之间反复搬运,大幅增加了处理延迟,难以满足高频数据的实时分析需求。
•运维复杂,成本高:存储、计算、流处理、调度等组件各自为政,技术栈复杂,数据孤岛严重,部署、排障和运维成本高。
DolphinDB 一体化解决方案
面对新能源业务中多种类型监测数据的存储与计算需求,经严格选型,该企业选择了基于 DolphinDB 开发的一体化解决方案:无需多组件拼装,仅需部署 DolphinDB 即可同时承担数据接入、存储、计算与分析的全链路职责。其主要优势在于:
•内置函数丰富,复杂逻辑不用从头写:DolphinDB 内置大量窗口计算、时序聚合、异常检测等函数,并且支持基于内置能力实现风电湍流强度计算、振动波形特征提取等新能源场景的常见业务算子,复杂逻辑无需从零写起,提升开发效率。
•库内计算,实时分析跟得上:数据在库内即可计算,减少数据搬运和调用开销,让高频数据的低时延实时分析与预警成为可能。
•轻量起步,告别多组件拼接:以一体化架构打通实时接入、流计算到结果输出的全链路,减少多组件拼接和跨系统协同,技术栈统一,数据互通。此外,DolphinDB 支持从单节点起步轻量化部署,可以从小场景切入,逐步融入企业现有系统,大幅降低建设数据底座的技术门槛。
性能实测:不只是能用,更是碾压
采用客户提供的风电、激光雷达、叶片声纹、叶片负载、塔筒倾斜、塔筒负载、光电、振动 CMS 等多种新能源领域典型监测数据在写入、读取、计算等维度进行了 POC 测试,结果显示,DolphinDB 在计算性能及开发便捷性上均具有压倒性优势。
•入库性能优异
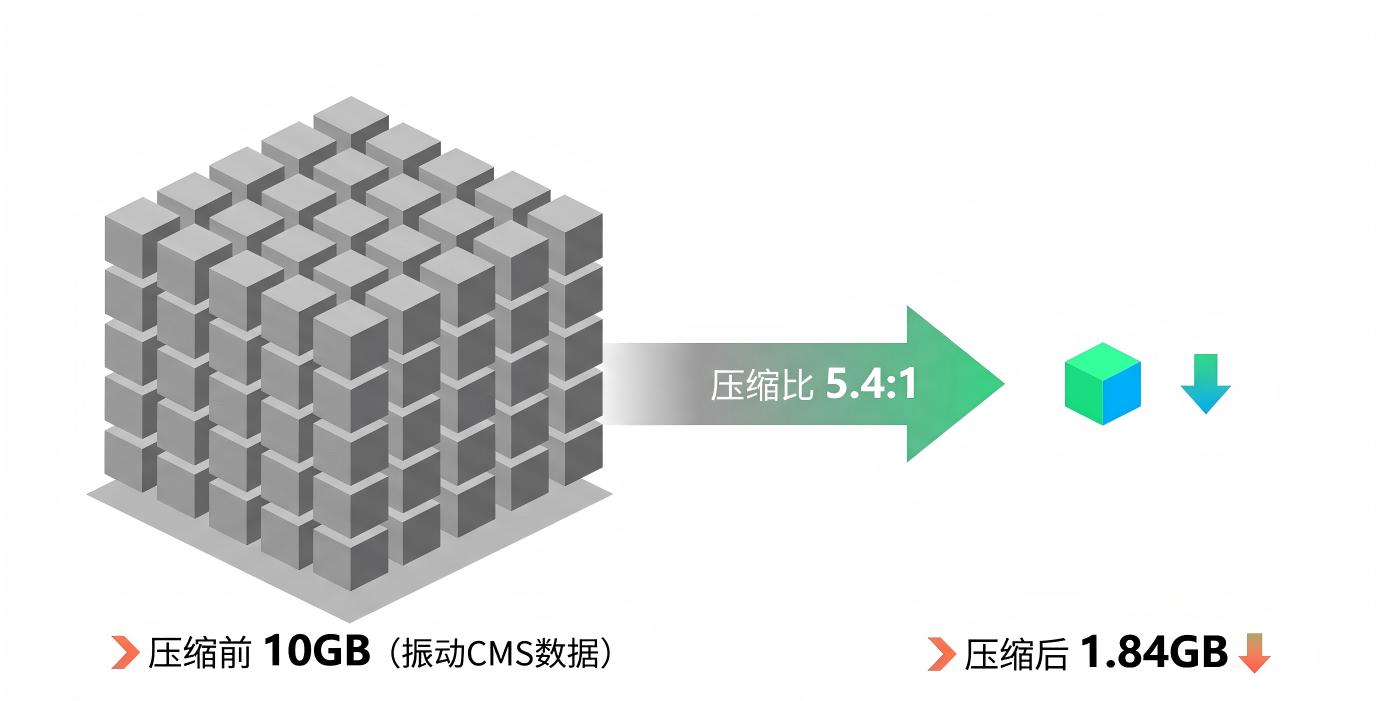
以振动 CMS 数据为例,60000 个振动 CMS 数据文件(共计约 10 GB),仅需 12 秒即可完成全量落盘入库, MB/s;落盘后文件大小仅 1.84 GB,压缩比达 5.4:1,可大幅降低存储资源占用。
•计算性能卓越
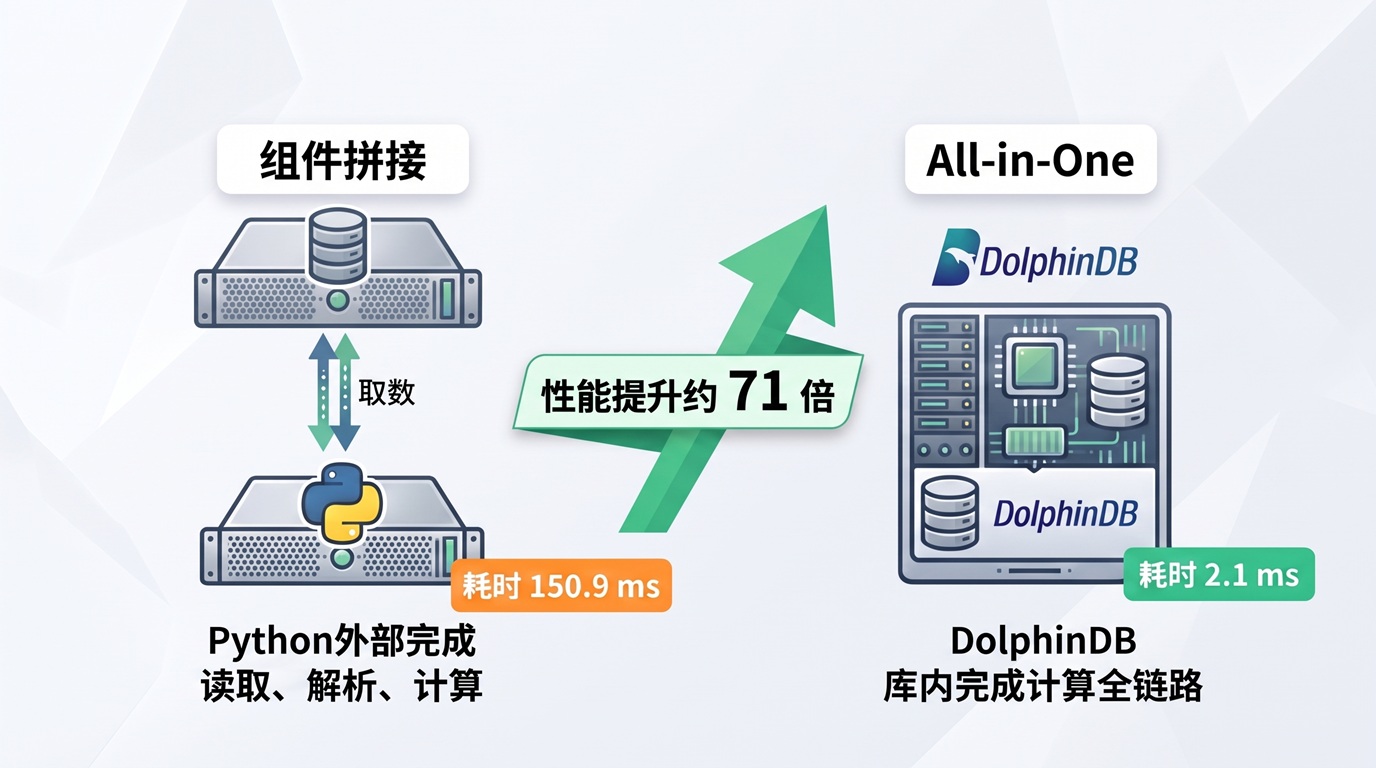
一体化架构下,相较于利用 Python 实现,通用算子与风电湍流算子的计算性能分别提升了 57 倍和 71 倍,且计算结果完全一致,兼顾了高性能与准确性。
两种模式下数据读取+计算的时耗对比
算子类型 | DolphinDB 一体化模式 | 数据库 + Python 模式 |
|---|---|---|
通用算子 | 2.0 ms | 114.6 ms |
风电湍流算子 | 2.1 ms | 150.9 ms |
注:DolphinDB 一体化模式是指 DolphinDB 在库内直接完成数据读取和计算;数据库 + Python 模式是指 Python 先从数据库中拉取数据,再进行计算;算子的性能测试结果是通过 10 次相同测试得出的平均水准。
•代码简洁,可复用性强
以风电湍流算子为例,在 DolphinDB 中代码实现如下:
timer{
  sample = select stdp(ai_wnd001) / avg(ai_wnd001) as turbulenceIntensity
      from t
      where date = testDate,
            ts >= startTime,
            ts <= endTime
}
print(sample.turbulenceIntensity)
相比之下,在 Python 中实现风电湍流算子代码需要拆分多个步骤:
1、从数据库读取数据:
def read_wind_data_from_database(
    """
    本函数的主要作用是从数据库读取数据
    并包含相关的数据转换操作
    """
    )
2、解析数据,按时间范围筛选:
# 解析数据
selected = wind_speed[(timestamps >= start_time) & (timestamps <= end_time)]
values = selected.dropna().to_numpy(dtype=np.float64, copy=False)
if values.size == 0:
    raise ValueError("指定时间范围内没有有效的瞬时风速数据")
3、计算:
# 平均值计算
mean_wind_speed = float(np.mean(values))

# 标准差计算
stdp_wind_speed = float(np.std(values, ddof=0))
turbulence_intensity = (
    stdp_wind_speed / mean_wind_speed if mean_wind_speed != 0.0 else 0.0
)
可以看出,在 DolphinDB 一体化架构的支撑下,省去了客户端的数据读取、转换等步骤,简化了开发流程。
性能只是开始,落地才是答案
在新能源领域的数据底座选型中,面对多源异构的监测数据,用户可以从高频数据存储、特征计算等具体场景切入,以轻量化方案快速验证价值,再逐步扩展至完整的平台体系。这一路径之所以可行,得益于 DolphinDB 的架构设计,它以单一平台替代多组件拼装,大幅降低了系统复杂度与开发运维成本;而算子的优异性能和可复用性,意味着当用户新增同类设备或监测指标时,只需在已有模型和算子实现基础上调整测点映射与时间窗口参数,即可快速完成适配,无需重复造轮子。
随着 DolphinDB 在能源电力、工业物联网等领域的持续深耕,这套“轻量起步、场景切入、逐步扩展”的实践路径,正在为越来越多企业的数据中台建设与智能化运营提供借鉴。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号