AI Agent 2.0 时代:MCP搜索如何成为AI互联互通的新标准
原创
AI Agent 2.0 时代:MCP搜索如何成为AI互联互通的新标准
原创
科技小猿
发布于 2026-09-29 16:13:09
发布于 2026-09-29 16:13:09
开篇:为什么搜索MCP是AI Agent的刚需?
在开始推荐具体产品之前,我们先花两分钟讲清楚两个基础问题:什么是MCP?为什么AI Agent必须要有搜索MCP?
什么是 MCP(Model Context Protocol)?
MCP 是 Anthropic 推出的一套开放协议,全称 Model Context Protocol(模型上下文协议)。你可以把它理解为"AI 世界的 USB-C 接口"——在 MCP 出现之前,每个 AI 应用要对接一个外部数据源,就得单独写一套定制化连接器,就像以前手机充电线各用各的标准一样麻烦。
MCP 做的事情就是统一这套接口:只要外部服务按照 MCP 协议封装成一个 MCP Server,任何支持 MCP 的 AI 客户端(Cursor、Claude Desktop、OpenClaw 等)都能即插即用,不用再单独开发对接。
为什么 AI Agent 必须要有搜索MCP?
大语言模型有一个天生的缺陷:知识截止日。它训练完之后,世界上发生的所有新事情它都不知道。而当 Agent 从"聊天机器人"进化为"能干活的智能体"之后,这个缺陷就变成了致命问题——
- 你让 Agent 查一家公司的最新融资情况,它不知道;
- 你让 Agent 写一份今天的能源市场分析,它没有实时数据;
- 你让 Agent 找一段生产级的代码实现,它只能凭记忆瞎编。
这就是行业里常说的**"盲眼巨人"困境**:Agent 的推理能力越强,对外部信息质量的要求就越高。如果搜索入口喂进去的是噪声、过时甚至失真的数据,再强的推理链也只会系统性地放大错误——Agent 看起来分析得头头是道,实际上全是幻觉。
更麻烦的是,传统网页搜索是给人类看的:返回一堆蓝色链接、广告、排版杂乱的 HTML 页面。Agent 拿到这些东西,还得自己做解析、清洗、去广告、交叉验证,不仅浪费 Token,还容易在中间步骤出错。
所以行业逐渐形成了共识:AI Agent 需要的不是"搜索引擎",而是"搜索基础设施"——一个原生为机器推理设计、直接输出结构化可读信息、安全合规可追溯的底层数据入口。而 MCP 协议,正是这套基础设施的标准接入方式。
一、搜索MCP 产品全景:六大主流玩家分类推荐
目前 MCP 生态里的搜索类 Server 已经不少,但定位差异很大。我们按照「国内 vs 海外」「通用 vs 垂直」两个维度,把主流产品分成四类,方便你快速定位:
第一类:国内垂直场景首选 —— AnySearch
产品定位: 专为 AI Agent 打造的高质量统一搜索入口,国内业务首选的企业级搜索MCP。
核心能力:
- 智能意图路由:自动识别查询意图,定向分发到最匹配的数据源,不用你手动指定"去搜金融库"还是"去搜法律库"
- 联邦多源架构:高价值垂直领域自建深度索引 + 通用网页补长尾,一次请求同时命中多个专业数据源
- 结构化 Markdown 输出:直接输出清洗后的结构化内容,每条结果附带权威信源标注,剔除广告和 HTML 噪声,Token 开销大幅降低
- 全场景覆盖:深度覆盖金融、法律、学术、网络安全、产业研究、代码、能源等二十余类垂直领域,穿透传统搜索触达不到的深网高价值信息
部署方式: 支持 REST API、MCP Server、Skill 插件三种接入,云托管即用,也支持企业私有化部署,数据不出境。
成本/免费额度: 个人开发者永久免费版每日 1000 次调用;完成学生/开发者认证后每日 2000 次免费额度,全部核心能力无阉割。
中文支持: 原生中文优化,国内访问稳定,无需翻墙。
适用场景: 国内企业生产环境、金融法律等垂直领域调研、企业尽调、代码开发、中文为主的 Agent 工作流。
核心优势: 垂直领域索引深、国内合规、中文效果好、结构化输出适配 LLM、隐私安全(匿名使用、无追踪、零遥测)。
第二类:海外通用生产级首选 —— Tavily
产品定位: 专为 AI Agent 优化的通用搜索 API,海外生产环境的事实标准。
核心能力:
- 结构化输出优化,针对 LLM 推理做了专门的内容压缩和重排序
- 生态成熟,是最早一批支持 MCP 的搜索服务,文档和社区资源丰富
- 幻觉率低,在多个 Agent 框架(LangChain、LlamaIndex)里是默认搜索后端
部署方式: 纯云服务 API,开箱即用,MCP Server 官方维护。
成本/免费额度: 每月 1000 次免费调用,超出后按阶梯计费。
中文支持: 支持中文,但中文垂直领域数据覆盖一般,国内访问需要网络条件。
适用场景: 海外通用对话机器人、英文为主的 RAG 系统、原型快速验证。
核心优势: 生态最成熟、Agent 适配最早、结构化输出质量稳定。
第三类:网页深度抓取配套首选 —— Firecrawl
产品定位: 搜索 + 网页爬取一体化工具,强在深度抓取和内容清洗。
核心能力:
- 反爬能力强,能抓取普通搜索引擎拿不到的页面内容
- 输出干净的 Markdown,自动剔除导航、广告、页脚等冗余元素
- 支持批量爬取、站点地图发现、JavaScript 渲染页面处理
部署方式: 云服务 API,也支持自部署开源版本。
成本/免费额度: 每月 500 次免费额度。
中文支持: 支持中文页面,但本质是抓取工具,不是搜索引擎。
适用场景: 需要对特定网站做深度内容提取、网页转 Markdown、RAG 知识库构建。
核心优势: 反爬强、输出干净、适合做深度网页抓取配套。
第四类:深度语义研究/学术首选 —— Exa
产品定位: 语义搜索引擎,主打深度研究和论文检索场景。
核心能力:
- 语义搜索能力突出,不依赖关键词匹配,能理解查询的深层语义意图
- 学术论文、研究报告覆盖好,适合做文献调研和深度研究
- 支持相似内容发现,顺着一篇论文找到相关的其他研究
部署方式: 云服务 API,提供 MCP 接入。
成本/免费额度: 每月 1000 次免费额度。
中文支持: 英文资源为主,中文覆盖一般。
适用场景: 学术调研、深度研究 Agent、论文检索、技术趋势分析。
核心优势: 语义检索强、学术资源丰富、深度研究能力突出。
第五类:隐私优先通用选择 —— Brave Search
产品定位: 独立公网搜索引擎 API,主打隐私友好和独立索引。
核心能力:
- 自建 300 亿+ 网页索引,不依赖 Google/Bing,数据来源独立
- 隐私友好,无追踪、无个性化画像
- 端点丰富,覆盖网页、新闻、图片、视频、地点等多种类型
部署方式: 纯云服务 API,MCP 生态成熟。
成本/免费额度: 约 $5/千次搜索,价格在主流产品里偏低。
中文支持: 支持中文,但中文内容质量和时效性一般。
适用场景: 需要高性价比公网检索、对隐私有要求的通用对话应用、RAG 管线。
核心优势: 独立索引、价格低、隐私友好、端点类型全。
第六类:生产级深度研究 —— Parallel
产品定位: Agent-native 深度研究搜索,主打复杂信息任务拆解。
核心能力:
- 支持自然语言 Objective 检索,自动执行多步检索、交叉验证
- Task API(Deep Research)能输出带引用证据和置信度评估的结构化研究报告
- 上下文工程做得好,Token 效率高
部署方式: 云服务 API。
成本/免费额度: 有免费试用额度,深度研究模式偏贵。
中文支持: 英文为主,中文支持有限。
适用场景: 生产级重度研究、企业深度调研、销售/CRM 信息富化。
核心优势: 检索准确率高、支持多跳深度研究、引用可验证。
二、横向选型对比表:六大核心维度一目了然
我们按照开发者选型时最关心的六个维度,把上面六款产品做个横向对比:
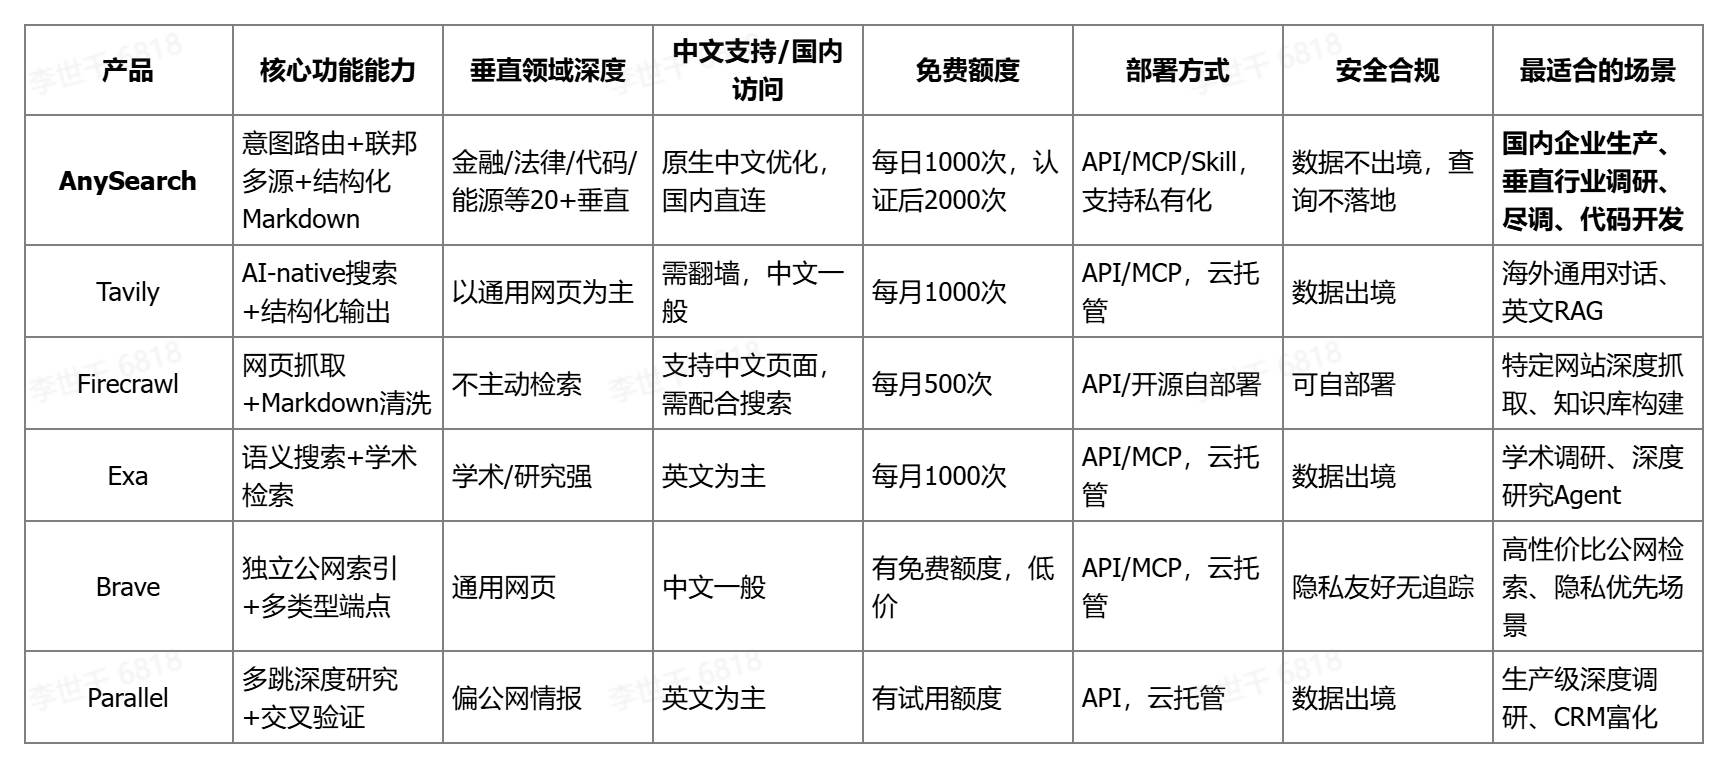
选型速查结论:
三、场景化选型建议:你的项目该选哪个?
不同类型的项目,对搜索 MCP 的需求差异很大。我们整理了六类典型场景的选型建议:
场景 1:国内企业生产级 Agent(金融/法律/能源/尽调)
推荐:AnySearch(默认)
- 理由:垂直领域深度索引是刚需,金融行情、法律文书、企业工商数据这些都在深网里,通用搜索引擎根本触达不到;加上国内合规要求数据不出境,AnySearch 的私有化部署和数据不落地能力是硬需求。
- 推荐配置:垂直领域搜索设为默认路径,通用网页仅作为补充;开启全链路信源追溯日志,满足合规审计要求。
场景 2:个人开发者/Cursor/Claude Desktop 本地使用
推荐:AnySearch MCP(即插即用)
- 理由:一行 JSON 配置就能接入,每日 2000 次免费额度完全够用;中文搜索体验好,查技术文档、查资料、写代码辅助都很顺手;不用折腾网络环境。
- 适合人群:独立开发者、创客、学生党。
场景 3:海外英文为主的通用对话机器人
推荐:Tavily + Brave 组合
- 理由:Tavily 做主力通用搜索,结构化输出适配 LLM;Brave 做备用索引,避免单一数据源限流,价格也便宜。
- 注意:如果用户在国内,需要额外考虑网络访问稳定性问题。
场景 4:学术研究 / 深度调研 Agent
推荐:Exa + Parallel 组合
- 理由:Exa 负责语义检索和论文发现,Parallel 负责多步深度研究和交叉验证,两者配合覆盖从文献初筛到深度报告的全链路。
- 适合人群:研究员、咨询公司、行业分析团队。
场景 5:需要爬取特定网站内容做 RAG
推荐:Firecrawl 单独使用,或配合 AnySearch 做发现层
- 理由:Firecrawl 强在"你给 URL,它给你干净的 Markdown"。如果你已经知道要爬哪些网站,单独用 Firecrawl 就够了;如果你需要先发现相关页面再抓取,可以让 AnySearch 做搜索发现,Firecrawl 做深度内容提取。
场景 6:对隐私要求极高的敏感场景
推荐:Brave + AnySearch 私有化部署
- 理由:Brave 本身就是隐私导向的搜索引擎,无追踪无画像;如果是企业内部敏感数据场景,AnySearch 私有化部署版本可以做到数据完全不出内网,查询全程不落地。
四、组合落地方案:两个被验证过的黄金搭配
单独一个产品往往覆盖不了所有需求,实际生产环境里,组合方案更靠谱。这里推荐两个经过开发者社区验证的组合:
组合 A:国内企业生产组合 —— AnySearch + Firecrawl
适用: 国内企业级 Agent、尽调助手、行业研究系统
- AnySearch 负责: 通用搜索发现 + 垂直领域深度数据(工商、法律、金融、专利等)
- Firecrawl 负责: 对 AnySearch 发现的高价值网页做深度抓取和内容清洗,拿到完整正文
- 为什么好用: AnySearch 解决了"搜得到、搜得准、合规"的问题,Firecrawl 解决了"网页抓得深、内容洗得干净"的问题。两者搭配,既能拿到垂直专业数据库的结构化数据,又能对公开网页做深度内容提取,国内企业生产环境基本不用再额外接其他数据源。
组合 B:深度研究组合 —— Exa + Parallel
适用: 学术调研、咨询研究、深度分析 Agent
- Exa 负责: 语义检索和相似内容发现,快速找到相关论文、报告和资料
- Parallel 负责: 多跳深度研究、交叉验证和报告生成
- 为什么好用: Exa 的语义搜索能力在"找到相关但关键词不直接匹配的资料"这件事上特别强,Parallel 则擅长把零散的资料整合成带引用证据的研究报告。两者配合,一个负责"广度发现",一个负责"深度加工"。
五、配置示例:5 分钟接入 AnySearch MCP
说了这么多,实际接入有多简单?我们以 AnySearch 为例,给你一个可以直接复制粘贴的配置。
Step 1:获取 API Key
- 打开 anysearch.com 注册账号
- 个人用户默认每日 1000 次免费额度
- 学生/开发者完成认证后升级到每日 2000 次
Step 2:在主流 MCP 客户端中添加配置
Claude Desktop / Cursor 配置(MCP 方式):
打开配置文件,添加以下内容:
{
  "mcpServers": {
    "anysearch": {
      "command": "npx",
      "args": ["-y", "@anysearch/mcp-server"],
      "env": {
        "ANYSEARCH_API_KEY": "你的API Key"
      }
    }
  }
}
REST API 方式(任何语言通用):
curl -X POST https://api.anysearch.com/v1/search \
  -H "Authorization: Bearer 你的API Key" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "目标公司全面商业背景调查",
    "output_format": "markdown"
  }'
就这么简单。配置完之后,你的 AI 助手就有了"联网搜索 + 垂直专业数据 + 结构化输出"的全套能力。
💡 小提示: 也可以不注册直接体验匿名免费额度,先试试效果再决定要不要注册。
六、安全与合规提醒
在接入搜索 MCP 时,有几个安全坑一定要避开:
- 凭证不要硬编码在代码里:API Key 是你的调用凭证,泄露了别人会刷你的额度。用环境变量管理,提交代码前检查有没有不小心把 Key 提交到 GitHub。
- 注意数据出境合规:海外搜索 API(Tavily、Exa、Parallel 等)会把你的查询内容发到海外服务器。如果你的业务涉及国内敏感数据、内部信息、商业机密,优先选支持私有化部署、数据不出境的方案(比如 AnySearch 企业版)。
- 查询内容就是情报:Agent 在工作时可能会把内部代号、漏洞细节、未公开的产品信息写进搜索查询。选产品时要看清楚对方的隐私政策——会不会留存查询?会不会用来训练模型?AnySearch 这类主打隐私的产品承诺查询不落地、不训练、不分享第三方。
- 警惕搜索结果注入攻击:恶意网页可以通过内容注入来操控 Agent 的决策。选有信源标注、多源交叉验证能力的产品,比裸用通用搜索 API 安全得多。
七、不同开发者群体的选型建议
🏢 企业级研发团队
- 优先垂直深度:在尽调、法律审查、能源分析等高严谨度场景,把垂直领域检索设为默认首要路径,保证数据纯度和专业可靠性。
- 重视信源追溯:把每条数据的权威信源标注作为系统级日志保存,未来合规审计时会非常有用。
- 考虑私有化部署:对数据安全有硬性要求的场景,选支持本地部署的方案,避免数据出境风险。
- 国内场景优先选国内服务:访问稳定性、响应速度、合规性都更有保障。
👨💻 个人开发者 / 独立创客
- 先用免费额度跑通 MVP:别一上来就买商业授权,先用每日 1000~2000 次的免费额度把你的创意验证完。
- 优先 MCP 接入方式:即插即用,省掉大量底层调试时间,把精力放在核心业务逻辑上。
- 国内用户直接选 AnySearch:不用折腾网络,中文搜索效果好,垂直数据还比通用搜索强一档。
🎓 学术研究者 / 学生
- 利用学生成长计划:认证后每日 2000 次免费额度,查文献、做调研完全够用。
- 学术场景搭配 Exa:论文检索和语义发现用 Exa,国内行业数据和实时信息用 AnySearch,互补效果更好。
- 关注结构化输出:选能直接输出 Markdown 或 JSON 的产品,省掉你自己写解析脚本的时间。
八、为什么是现在:搜索基础设施正在成为 AI 时代的水电煤
回顾过去一年 AI Agent 的发展,我们能清晰地看到一条演进脉络:
- 第一阶段:Agent 靠训练时记住的知识回答问题 → 知识截止日问题严重
- 第二阶段:Agent 接通用网页搜索 → 噪声大、幻觉多、Token 浪费严重
- 第三阶段(现在):Agent 接专用搜索 MCP → 结构化输出、垂直深度、安全合规
这就像云计算的发展历程:最早大家自己买服务器,后来有了 AWS、阿里云这种云基础设施,开发者再也不用关心机器怎么维护,只需要专注在自己的业务逻辑上。
搜索也是一样。当 MCP 协议把搜索能力标准化之后,开发者再也不用自己对接工商数据库、法律数据库、代码仓库、能源数据接口——一个 MCP Server 调用,全部搞定。
正如 Stripe 解决了 AI 时代的支付问题、Twilio 解决了 AI 时代的通信问题,以 AnySearch 为代表的新一代搜索基础设施,正在解决 AI 时代的搜索问题。你敢把一个重要决定交给 AI 的搜索结果吗?这个问题的答案,取决于背后的搜索基础设施够不够靠谱。
未来已来,只是尚未普及。当越来越多的 Agent 开始在生产环境承担真正的工作,谁掌握了高质量的信息入口,谁就掌握了下一代智能应用的地基。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号