代码只改了几行,为什么可能需要重跑几千条测试?
原创
代码只改了几行,为什么可能需要重跑几千条测试?
原创
AI智享空间
发布于 2026-10-02 16:44:42
发布于 2026-10-02 16:44:42
 图片
图片
一、那根不动的进度条
提交了一个三行的修复,PR 页面上流水线开始转。你点开详情,触发的用例数写着"几千条"。
你知道这三行改的是什么,心里估摸着,真正相关的也就几十条。但没人敢只跑几十条。上次有人这么干,合入后夜间回归红了,回滚、复盘、写报告,折腾了两天。从那以后,团队形成了默契:宁可多等两小时,也不背那个锅。
于是回归测试变成了一座围城:城里的人嫌慢,不敢出;城外的人想快,不敢进。
问题不在"能不能少跑",而在"凭什么说这些可以不跑"。这篇文章就围绕这个问题展开:变更影响分析靠什么信号判断,AI能补上什么,又会在哪里失手。
二、几行代码,为什么牵出几千条用例
先把"为什么多"讲清楚,因为这决定了该从哪里下手。
- 扇入(fan-in)效应。 一个被几百处调用的公共函数,改三行,调用方全部受影响。改动大小和影响面是两回事,影响面取决于被谁依赖,而不是改了多少行。
- 传递闭包。 影响沿着调用链向上传递,A调B,B调C,改C,A的测试也得看。
- 集成测试覆盖面宽。 一条端到端用例可能一路穿过十几个模块,哪个模块变了都算它的事。
- 不确定就保守。 配置、数据库结构、开关、事件订阅这些"代码里看不见的依赖",图上没有边。工具不知道谁依赖谁,最安全的做法就是全跑。
为了让这件事看得见,我搭了一个模拟代码库来验证(后面会交代细节):960个函数,分8层,3000条测试(70%单元测试、30%集成测试),公共基础层被上层大量调用。
在这个模拟里,同样是"只改一个函数":
- 改公共基础层的一个函数,按依赖和覆盖率筛选,会选中 579 条测试(占全部的约19%),这个函数有 480 个静态上游调用方;
- 改最上层业务的一个叶子函数,只选中 44 条(约1.5%),没有上游调用方。
同样是一个函数、同样几行代码,选中的测试差了十几倍。所谓"几行代码要跑几千条",绝大多数时候是撞上了高扇入的公共代码。
这给了一个很实际的启发:不要对所有变更用同一种回归策略。先识别这次改的是"叶子"还是"枢纽"。
三、影响分析靠什么信号
AI不是凭空判断的,它依赖的是下面这些信号。理解它们各自的盲区,比知道"用了AI"重要得多。
信号 | 能回答什么 | 盲区 |
|---|---|---|
代码差异(diff) | 改了哪些文件、函数、行 | 看不出语义:是重构、改逻辑还是改配置 |
静态调用关系 | 谁直接或间接调用了被改代码 | 反射、事件、配置驱动的调用看不到 |
模块依赖 | 哪些模块在构建上依赖被改模块 | 粒度太粗,通常高估影响面 |
测试覆盖率(运行时) | 每条测试实际执行过哪些函数 | 数据会陈旧;新增的调用路径它还没见过 |
历史缺陷与失败记录 | 过去改这里时哪些测试失败过 | 对新代码、新模块没有记忆 |
一个从设计上就能得出的判断:运行时覆盖率比静态调用图更不容易被"看不见的边"拖累。覆盖率记录的是测试实际走过的路径,反射、配置驱动这类静态分析看不见的调用,它天然能记录下来。需要说明的是,我的模拟里筛选器用的是覆盖率,静态图只参与风险打分,所以这里并没有拿静态图做筛选的对照实验。反过来,覆盖率数据陈旧,才是更值得盯的风险,后面的敏感性实验会看到它的影响。
四、AI在这条链路里能做什么
把AI放进来,不是让它替代上面的信号,而是做三件传统规则做不好的事:
1. 读懂变更的语义。同样是改了10行,是改注释和重命名,还是改了金额计算的边界条件?规则分不出来,模型可以读 diff 并分类:纯重构、行为变更、配置变更、接口契约变更。分类结果决定了后面的风险等级。
2. 补全图上没有的依赖。 读 diff 时发现改了配置文件里的超时参数、SQL 的字段、某个功能开关的默认值,模型可以据此提示"这类改动可能影响依赖该配置的模块",并从文档、历史工单里找出关联用例。这正是调用图盲区所在的地方。
3. 排序与解释。给每条推荐用例附上理由和置信度:是因为覆盖了被改函数,还是因为历史上和这个模块同时失败过,还是仅仅因为语义相似。理由写得清楚,审核的人才敢信、才有办法纠错。
这里有一条我认为最重要的使用原则,放在这里单独强调:
AI的建议只能"加测试",不能"减测试"。
也就是说,AI可以扩大筛选范围("这次改动我觉得还应该跑支付回调那组"),但缩小范围必须有确定性证据(覆盖率里确实没有这个函数)。大模型会自信地给出错误的判断,让它拥有"删除"权限,等于让一个会犯错的角色掌握了关闭报警器的开关。
一个最小可行的合并逻辑大概是这样:
def select_tests(change):
    must_run   = coverage_hits(change) | owner_tests(change)        # 确定性证据,必须跑
    history    = history_cofail(change)                              # 历史共同失败,必须跑
    ai_extra   = ai_suggest(change, min_confidence=0.6)              # AI只能在此基础上追加
    selected   = must_run | history | ai_extra
    if uncertainty(change) >= THRESHOLD:                             # 不确定性高,升级全量
        return ALL_TESTS
    return selected
五、三种策略,跑出了什么
下面是模拟实验的结果。先把话说在前面:
这是一个构造的模拟代码库,不是真实项目。绝对数值(比如"只需跑3%")完全取决于我设定的参数,不能直接套到你的项目上。它真正能给你的,是各策略之间的相对关系,以及一套可以搬到自己项目里的对比方法。参数和脚本都写在附带的
impact_sim.py里,可以直接复现。
设定:每个随机种子模拟2000次提交,每次改1到3个函数,约10%的提交带有缺陷;共10个随机种子,合计1984个"全量回归能发现"的缺陷。测试执行耗时按随机分布生成,以相对占比表示。
策略 | 平均执行测试占比 | 提交前缺陷检出率(均值,范围) | 漏到夜间全量的缺陷数 |
|---|---|---|---|
全量回归 | 100% | 100% | 0 |
规则筛选(只跑被改模块自己的测试) | 2.1% | 96.2%(94.4%~98.5%) | 74 |
依赖+覆盖率+历史筛选 | 3.3% | 99.8%(99.1%~100%) | 4 |
依赖+覆盖率+历史+风险兜底 | 31.3% | 99.9%(99.5%~100%) | 3 |
这张表有三个地方值得细看:
第一,规则筛选"看起来也不错"。96.2%的检出率,在单元测试为主的项目里很有迷惑性。但当我把集成测试占比从30%提到60%(6个种子均值),规则筛选的检出率掉到 91.2%(最低 87.8%),而依赖+覆盖率筛选仍在 99.7%。规则筛选的问题是:它只认"目录对应关系",而集成测试恰恰跨目录。
第二,风险兜底的代价很高,收益却不明显。 兜底把 29.7% 的提交升级成了全量回归,执行耗时占比从 3.3% 涨到 31.3%,检出率只从 99.8% 变成 99.9%。为什么?因为我这里的升级条件是"影响面大"(高扇入、选中太多),而漏掉的缺陷,恰恰来自"图里没有的耦合"。影响面大,不等于不确定性高。兜底规则如果只盯着爆炸半径,就是花大钱买了一份错位的保险。
第三,漏测不会消失,只是被推迟。即使是最好的策略,也有极少数缺陷在合入前没被拦住,靠夜间的全量回归捞回来。这不是缺陷,这是这套机制的设计:快速通道负责速度,全量回归负责底线。
再看信号变差时会发生什么(6个随机种子,下面的数据与上表口径略有差异):
场景 | 依赖+覆盖率+历史 检出率(最低值) | 漏到夜间 |
|---|---|---|
基线 | 99.9%(99.5%) | 1 |
覆盖率数据陈旧30% | 99.7%(99.5%) | 4 |
非调用耦合占30%,且历史完全学不到 | 99.0%(97.9%) | 12 |
最后一行是最值得警惕的:当缺陷的传播渠道是共享配置、共享数据、功能开关这类"没有调用关系的耦合",而你的历史记录里又没有它的痕迹时,漏测会成倍增加。而这恰恰是第四节里AI可以帮上忙的位置。
六、一个真实世界里的参照
模拟毕竟是模拟。真实世界里有一个被公开验证过的案例:Facebook 在 2019 年 ICSE 软件工程实践方向发表了《Predictive Test Selection》。他们用历史代码变更和测试结果训练模型,来挑选每次变更需要运行的测试。论文报告的结果是:整体测试基础设施成本降低一半,同时仍能报告出超过95%的单个测试失败和超过99.9%的缺陷变更;选出的测试不到按构建依赖筛选结果的三分之一。
这个例子有两点值得注意:一是它用的是基于历史的统计学习,不是大语言模型,说明"让数据告诉你该跑什么"这条路本身是成立的;二是它们衡量成功的口径,是"有缺陷的变更里,有多少至少被一条测试拦住",而不是"用例失败总数被检出多少"。以缺陷变更为单位算检出率,是评估这类系统最合理的口径。
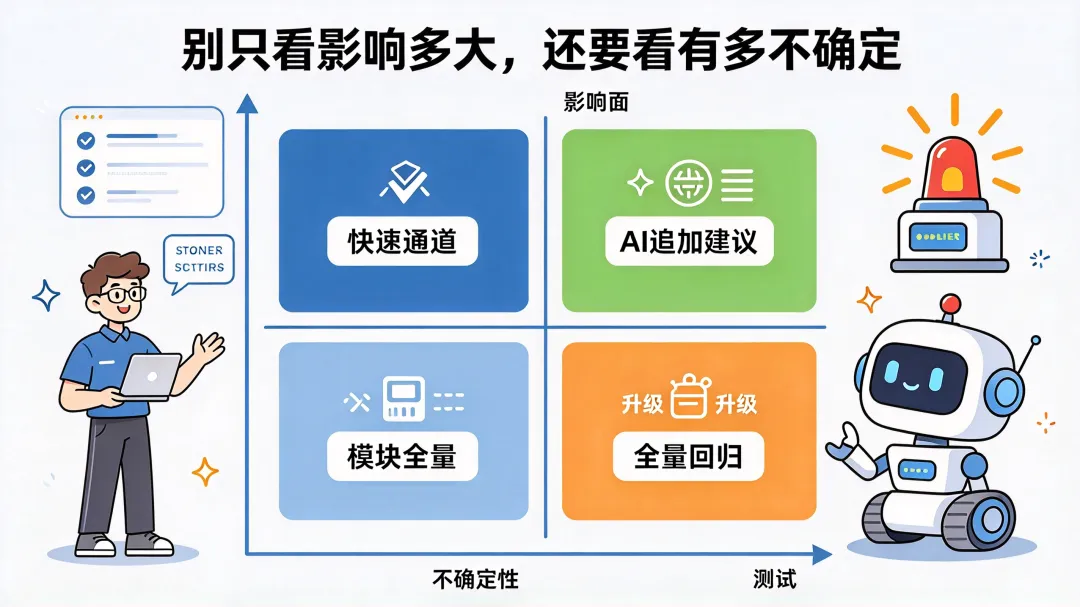
七、别只看"影响多大",还要看"我们有多不确定"
图片
基于上面的发现,我建议把风险分级拆成两个维度,而不是一个:
不确定性低 | 不确定性高 | |
|---|---|---|
影响面小 | 快速通道,只跑精选用例 | 精选用例 + AI追加建议 |
影响面大 | 精选用例 + 对应模块全量 | 升级全量回归 |
其中:
- 影响面看:被改函数的上游规模(扇入)、是否位于公共基础层、选出的用例比例;
- 不确定性看:覆盖率数据的新鲜度、diff 是否涉及配置/数据库结构/开关/接口契约、该区域过去是否发生过"夜间才被发现"的缺陷、AI 对这次变更语义判断的置信度。
只有第二个维度高的时候,才应该花全量回归的钱。这样升级全量的比例会更低,命中的又更准。
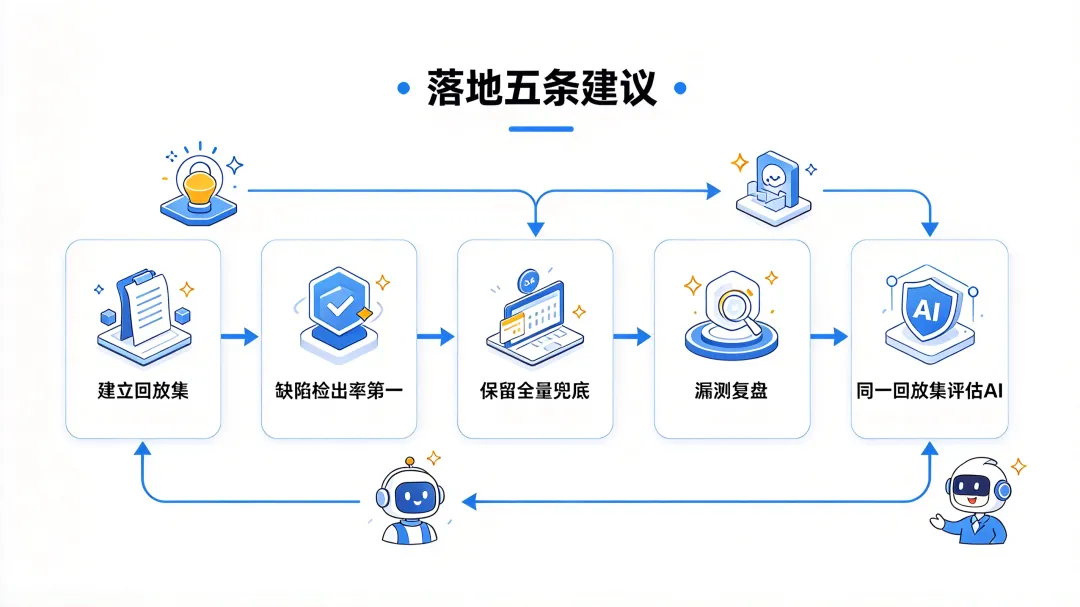
八、落地时的五条建议
图片
- 先建立回放集,再谈优化。 取最近几个月的真实提交和对应的测试结果,作为后续所有策略的统一评测基准。没有这个基准,谁都没法证明"筛选后没有漏"。
- 以"缺陷变更的检出率"作为第一指标。 其次才是耗时节省。省下的时间如果以漏测为代价,账是算不平的。
- 保留全量回归作为兜底,并给它固定的节奏。 夜间或发布前全量必须有,而且每一次它"捞到"的缺陷,都要回灌:加入历史记录、补充覆盖数据、调整风险规则。
- 漏测一次,复盘一次。 每个被夜间全量捞到的缺陷,都要问同一个问题:当时哪个信号缺失了?是覆盖率陈旧,还是存在图上没有的耦合?这份记录比任何调参都有价值。
- 用同一个回放集评估AI。 想知道AI层到底有没有增益,就固定其他条件,只把"选择器"从"依赖+覆盖率+历史"替换成"加上AI建议",对比检出率、漏测数和耗时占比。我没有在本文的实验里调用大模型,所以上面的数字不包含AI的增益,这个对比需要在你自己的项目数据上做。
九、回到标题
几行代码要跑几千条测试,背后是三种东西叠在一起:真实的高扇入、过于保守的不确定处理,以及一份没人敢担的责任。
AI能帮我们做的,是更准确地看清楚改动的语义、更完整地找出隐藏的依赖、更清楚地解释为什么选这些用例。但它不应该被赋予"少跑"的权力,而应该被赋予"多想"的能力。
真正让团队敢于少跑的,从来不是某个聪明的模型,而是一套能承受漏测的体系:有回放集可以证明,有全量兜底可以接住,有复盘机制把每一次漏测变成下一次的信号。
最后留一个问题:你们团队上一次因为"只跑了一部分回归"而出的事,是在哪个信号上漏掉的?如果答不上来,说明你们还没有那份可以回放的记录,先从这里开始。
附:模拟脚本 impact_sim.py(Python + NumPy,固定随机种子,可直接复现全部数据)。
"""
变更影响分析与测试选择:模拟代码库实验(可复现)
说明:这是一个构造的模拟环境,所有参数写在 PARAMS 中,结论只反映这些假设下的现象,
不代表任何真实项目的统计数据。这里没有调用任何大模型,模拟的是"依赖图+覆盖率+历史"
这一层确定性信号;AI 层应基于同一份回放数据替换"选择器"后再对比。
"""
import numpy as np, sys

PARAMS = dict(
    N_MOD=80, F=12, N_LAYER=8,          # 80个模块,每个12个函数,共960个函数,分8层(第0层为公共基础层)
    N_TEST=3000,                         # 3000条测试
    EDGE_TAKEN=0.75,                     # 集成测试执行时,每条调用边被走到的概率
    INT_FRAC=0.3,                        # 集成测试占比;其余为单元测试(依赖被mock,只执行本模块内函数)
    MAX_OUT=6,                           # 每个函数最多调用几个其他函数(0~MAX_OUT-1)
    HIDDEN_EDGE=0.08,                    # 静态分析看不到的调用边(反射/事件/配置驱动)占比
    COV_STALE=0.04,                      # 覆盖率记录与真实执行不一致的比例(数据陈旧)
    COUPLE=0.10,                         # 函数存在"非调用耦合"(共享配置/表/开关)的概率
    COUPLE_KNOWN=0.5,                    # 其中被历史缺陷记录学到的比例
    N_COMMIT=2000, BUG_RATE=0.10,        # 每个提交含缺陷的概率
    P_DET_UNIT=0.6, P_DET_INT=0.25,      # 单元/集成测试执行到缺陷函数时,断言真正失败的概率
    P_DET_COUPLE=0.5,                    # 执行到耦合函数的测试,因共享状态失败的概率
    ESCALATE_FRAC=0.35,                  # 筛选结果超过该比例直接升级全量
)

def build(seed, P):
    rng = np.random.default_rng(seed)
    NM, F = P["N_MOD"], P["F"]; NF = NM*F; per_layer = NM//P["N_LAYER"]
    mod_of = np.arange(NF)//F; layer_of_mod = np.arange(NM)//per_layer
    edges = []  # (src,dst,hidden)
    def zipf(n): w = 1/(np.arange(n)+1)**0.8; return w/w.sum()
    for f in range(NF):
        m = mod_of[f]; L = layer_of_mod[m]; loc = f % F
        for _ in range(rng.integers(0,P["MAX_OUT"])):
            if (L == 0 or rng.random() < 0.35):
                if loc == 0: continue
                g = m*F + rng.integers(0,loc)
            else:
                lw = np.array([2.0]+[1.0]*(L-1))[:L]; lw/=lw.sum()
                tl = rng.choice(L, p=lw)
                tm = tl*per_layer + rng.choice(per_layer, p=zipf(per_layer))
                g = tm*F + rng.choice(F, p=zipf(F))
            edges.append((f,g,rng.random()<P["HIDDEN_EDGE"]))
    out = [[] for _ in range(NF)]; sinc = [[] for _ in range(NF)]
    for s,d,h in edges:
        out[s].append(d)
        if not h: sinc[d].append(s)
    # 静态反向传递闭包规模(谁会直接或间接调用我)
    reach = np.zeros(NF, int)
    for f in range(NF):
        seen={f}; st=[f]
        while st:
            x=st.pop()
            for c in sinc[x]:
                if c not in seen: seen.add(c); st.append(c)
        reach[f]=len(seen)-1
    # 测试
    T = P["N_TEST"]
    lay_w = np.array([0.5,0.5,0.8,1,1.2,1.5,1.8,2.0])[:P["N_LAYER"]]
    mw = lay_w[layer_of_mod]; mw = mw/mw.sum()
    is_int = rng.random(T) < P["INT_FRAC"]
    owner = rng.choice(NM, size=T, p=mw)
    hi_mods = np.where(layer_of_mod>=3)[0]
    owner[is_int] = rng.choice(hi_mods, size=is_int.sum())
    cov = np.zeros((T,NF), bool)
    for t in range(T):
        entries = rng.choice(np.arange(owner[t]*F,(owner[t]+1)*F), size=rng.integers(1,4), replace=False)
        seen=set(entries); st=list(entries)
        while st:
            x=st.pop()
            for c in out[x]:
                if c in seen: continue
                if is_int[t]:
                    if rng.random()<P["EDGE_TAKEN"]: seen.add(c); st.append(c)
                elif mod_of[c]==owner[t] and rng.random()<0.8:
                    seen.add(c); st.append(c)
        cov[t,list(seen)] = True
    dur = rng.lognormal(0,0.9,T)
    cov_rec = cov & (rng.random(cov.shape) > P["COV_STALE"])
    coupled = np.full(NF,-1)
    for f in range(NF):
        if rng.random()<P["COUPLE"]:
            h=rng.integers(0,NF)
            if mod_of[h]!=mod_of[f]: coupled[f]=h
    known = np.array([coupled[f]>=0 and rng.random()<P["COUPLE_KNOWN"] for f in range(NF)])
    return dict(is_int=is_int,rng=rng,NF=NF,mod_of=mod_of,layer_of_mod=layer_of_mod,reach=reach,owner=owner,
                cov=cov,cov_rec=cov_rec,dur=dur,coupled=coupled,known=known,T=T)

def run(seed, P, verbose=False):
    W = build(seed,P); rng=W["rng"]; T=W["T"]; cov=W["cov"]; rec=W["cov_rec"]
    owner=W["owner"]; mod_of=W["mod_of"]; dur=W["dur"]; coupled=W["coupled"]; known=W["known"]
    thr = np.percentile(W["reach"],85)
    S = {k:dict(n=0,d=0.0,det=0,miss=0) for k in ["全量回归","规则筛选(目录映射)","依赖+覆盖+历史","依赖+覆盖+历史+风险兜底"]}
    bugs=0; undetectable=0; esc=0; sizeC=[]; by_layer={}; examples=[]
    for _ in range(P["N_COMMIT"]):
        k = rng.choice([1,2,3],p=[.5,.3,.2]); ch = rng.choice(W["NF"],k,replace=False)
        has_bug = rng.random()<P["BUG_RATE"]; b = rng.choice(ch)
        # 各策略选中的测试
        full = np.ones(T,bool)
        B = np.isin(owner, np.unique(mod_of[ch]))
        C = B | rec[:,ch].any(1)
        for f in ch:
            if known[f]: C |= rec[:,coupled[f]]
        risk = (W["reach"][ch]>=thr).any() or known[ch].any() or C.mean()>P["ESCALATE_FRAC"]
        D = full if risk else C
        esc += int(risk)
        sizeC.append(C.mean())
        lay = W["layer_of_mod"][mod_of[ch].min()]
        by_layer.setdefault(lay,[]).append(C.mean())
        if k==1: examples.append((lay,int(C.sum()),int(ch[0]),int(W["reach"][ch[0]])))
        sel = {"全量回归":full,"规则筛选(目录映射)":B,"依赖+覆盖+历史":C,"依赖+覆盖+历史+风险兜底":D}
        for name,s in sel.items():
            S[name]["n"]+=s.sum(); S[name]["d"]+=dur[s].sum()
        if has_bug:
            bugs+=1
            pdet = np.where(W["is_int"],P["P_DET_INT"],P["P_DET_UNIT"])
            Dset = (cov[:,b] & (rng.random(T)<pdet))
            if coupled[b]>=0: Dset |= (cov[:,coupled[b]] & (rng.random(T)<P["P_DET_COUPLE"]))
            if not Dset.any(): undetectable+=1; continue
            for name,s in sel.items():
                if (s&Dset).any(): S[name]["det"]+=1
                else: S[name]["miss"]+=1
    detectable = bugs-undetectable
    res = {n:dict(test_frac=v["n"]/(T*P["N_COMMIT"]), dur_frac=v["d"]/(dur.sum()*P["N_COMMIT"]),
                  recall=v["det"]/max(detectable,1), miss=v["miss"]) for n,v in S.items()}
    sizeC=np.array(sizeC)
    extra = dict(bugs=bugs,detectable=detectable,esc_rate=esc/P["N_COMMIT"],
                 medC=np.median(sizeC)*T,p90C=np.percentile(sizeC,90)*T,maxC=sizeC.max()*T,
                 gt50=(sizeC>0.5).mean(), by_layer={l:np.mean(v)*T for l,v in sorted(by_layer.items())},
                 examples=examples, T=T)
    return res, extra

if __name__=="__main__":
    P=dict(PARAMS)
    agg={}; ex=None
    for seed in range(10):
        r,e = run(seed,P)
        for n,v in r.items(): agg.setdefault(n,[]).append(v)
        if seed==0: ex=e
        agg.setdefault("_bugs",[]).append(e["detectable"]); agg.setdefault("_esc",[]).append(e["esc_rate"])
    print("== 10个随机种子汇总(每个种子2000次提交)==")
    print("可发现缺陷总数(10种子合计):", sum(agg["_bugs"]), " 风险兜底升级为全量的提交占比: %.1f%%"%(100*np.mean(agg["_esc"])))
    for n in ["全量回归","规则筛选(目录映射)","依赖+覆盖+历史","依赖+覆盖+历史+风险兜底"]:
        v=agg[n]
        tf=np.mean([x["test_frac"] for x in v]); df=np.mean([x["dur_frac"] for x in v])
        rc=[x["recall"] for x in v]; ms=sum(x["miss"] for x in v)
        print(f"{n}: 平均执行测试占比 {tf*100:.1f}% | 耗时占比 {df*100:.1f}% | 提交前缺陷检出率 均值 {np.mean(rc)*100:.1f}% (范围 {min(rc)*100:.1f}%~{max(rc)*100:.1f}%) | 漏到夜间全量的缺陷数 {ms}")
    print("\n== 种子0:选中规模分布(依赖+覆盖+历史,未兜底) ==")
    print(f"中位数 {ex['medC']:.0f} 条, P90 {ex['p90C']:.0f} 条, 最大 {ex['maxC']:.0f} 条, 选中超过一半用例的提交占比 {ex['gt50']*100:.1f}%")
    print("按被改函数所在层(0=公共基础层)的平均选中条数:", {l:round(v) for l,v in ex["by_layer"].items()})
    one=[x for x in ex["examples"]]
    hi=max(one,key=lambda x:x[1]); lo=min([x for x in one if x[0]==7] or one,key=lambda x:x[1])
    print("单函数改动里选中最多:",f"层{hi[0]}, 选中{hi[1]}条, 静态上游调用方{hi[3]}个")
    print("第7层单函数改动里选中最少:",f"选中{lo[1]}条, 静态上游调用方{lo[3]}个")
    print("\n== 敏感性:非调用耦合概率 COUPLE 对 提交前缺陷检出率 的影响(5种子均值) ==")
    for c in [0.0,0.1,0.2,0.3]:
        Q=dict(P); Q["COUPLE"]=c
        rs=[run(s,Q)[0] for s in range(5)]
        for n in ["规则筛选(目录映射)","依赖+覆盖+历史","依赖+覆盖+历史+风险兜底"]:
            print(f"COUPLE={c}: {n}: 检出率 {np.mean([r[n]['recall'] for r in rs])*100:.1f}%  耗时占比 {np.mean([r[n]['dur_frac'] for r in rs])*100:.1f}%")
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号