向量数据库与图数据库协同实践:融合大模型搭建图数据知识检索与关联推理智能应用24.2
原创
向量数据库与图数据库协同实践:融合大模型搭建图数据知识检索与关联推理智能应用24.2
原创
未闻花名
发布于 2026-10-02 21:22:12
发布于 2026-10-02 21:22:12
一、前言
基于大模型应用落地,我们最先接触的方案就是RAG检索增强生成。基本一开始只简单接入向量数据库,把文档切片向量化存储,依靠相似度匹配召回文本交给大模型。上线后很快会暴露出一系列棘手问题:向量检索只能做到 “语义相似匹配”,无法识别实体之间的关联关系。
大家都遇到过很常见的场景:知识库存储大量企业人员、项目、合同资料。当提问 “参与A项目的员工负责了哪些相关合同”,纯向量检索只能找到零散文本,无法自动梳理人员、项目、合同三者的关联链路;大模型只能依靠文本片段自行推测关系,极易产生事实幻觉。想要解决这类关联推理类问题,单纯依靠向量数据库远远不够。图数据库擅长存储实体、关系、属性,天然适配网状关联数据;向量数据库擅长高维向量近似相似度搜索。二者不存在替代关系,而是互补组合。
当向量数据库的语义检索能力,搭配图数据库的关系推理能力,再结合大模型理解自然语言、总结生成内容的能力,就能搭建一套既能语义查找资料,又能挖掘实体关联、具备逻辑推理能力的智能系统。
二、基础概念认知
1. 向量数据库核心能力
文本、图片、音频无法直接被计算机做语义对比,需要借助Embedding嵌入模型,将非结构化数据转化为固定维度的浮点数组,也就是向量。语义越接近的数据,对应的向量在高维空间中距离越近。
传统关系型数据库、普通 KV 数据库不擅长高维向量检索。如果使用暴力遍历方式计算向量距离,数据量上涨后查询延迟会指数级增长。向量数据库应运而生,核心目标就是高效完成大规模向量近似最近邻搜索(ANN)。
向量数据库内置多种索引算法:HNSW、IVF_FLAT、SCANN等,通过牺牲极小精度,大幅降低检索耗时。除向量检索基础能力外,主流向量数据库(Chroma、Pinecone、Qdrant)还支持:向量与标量混合过滤、动态数据增删改查、分片扩容、持久化存储。
向量数据库核心优势:
- 擅长非结构化数据语义匹配:文档、图片、音视频向量化检索;
- 支持模糊语义查询,用户不需要精准关键词,依靠语义即可召回内容;
- 完美适配传统 RAG 流程,解决大模型 “不知道外部私有数据” 的问题。
向量数据库天然短板:
- 没有实体、关系概念,无法显式记录A和B之间存在何种关联;
- 只能做相似度匹配,不具备链式推理、路径查询能力;
- 面对多层关联查询,只能依靠大量文本片段间接推导,效率低、容易信息断裂。
简易向量嵌入应用示例:
from sentence_transformers import SentenceTransformer
import numpy as np

# 加载开源嵌入模型
model = SentenceTransformer("all-MiniLM-L6-v2")

# 原始文档文本
docs = [
    "张三参与智慧城市建设项目",
    "智慧城市项目签订三号工程合同",
    "张三负责三号合同现场管理工作"
]
# 生成向量
embeddings = model.encode(docs)
print("向量维度:", embeddings.shape)
# 输出:向量维度: (3, 384)
2. 图数据库核心能力
图数据库以图模型存储数据,基础单元分为节点(实体)、边(关系)、属性。节点代表客观实体:人员、项目、产品、设备;边代表实体之间定向关系:参与、负责、签订、归属。每条节点和边都可以挂载自定义属性。
行业主流图数据库分为两类:一类支持 Cypher 查询语言(Neo4j),上手简单,适合中小型知识图谱快速搭建;另一类原生分布式图数据库(NebulaGraph、TuGraph),支撑十亿级别节点与边,面向大规模生产环境。
图查询语言可以轻松实现路径遍历、关联筛选、多层关系挖掘。例如查询:找到张三参与的所有项目,以及项目关联的全部合同。这条需求只需要简短语句完成链路检索。
图数据库核心优势:
- 原生表达实体网状关联,擅长多层关系查询、路径挖掘;
- 查询关联数据性能稳定,不会像关系数据库多表 JOIN 随数据增长急剧变慢;
- 可以沉淀结构化知识图谱,为大模型提供确定性事实依据,减少幻觉。
图数据库天然短板:
- 依赖精准实体名称检索,无法直接进行模糊语义搜索;
- 无法直接处理原始长文本,必须先抽取实体与关系结构化之后入库;
- 单独使用很难直接检索非结构化文档原文。
Neo4j基础Cypher示例:
# 创建实体与关系
CREATE (p:Person{name:"张三"})-[:JOIN]->(proj:Project{name:"智慧城市项目"})
-[:SIGN]->(contract:Contract{name:"三号工程合同"})

# 查询张三参与项目关联的合同
MATCH (p:Person{name:"张三"})-[:JOIN]->(proj:Project)-[:SIGN]->(c:Contract)
RETURN proj.name,c.name
3. 两类数据库核心差异
很多技术选型误区,就是试图用一种数据库解决所有问题。这里清晰划清边界:
- 数据形态:向量数据库存储向量 + 原始文本;图数据库存储实体、关系、属性结构化数据;
- 查询模式:向量库 = 语义相似度检索;图数据库 = 关系路径遍历;
- 输入要求:向量库直接接收原始文本;图库需要先做信息抽取;
- 典型场景:向量库→文档检索、多媒体搜索;图库→知识图谱、关联溯源、链路分析。
二者不是竞争关系,而是互补。在大模型应用架构中各司其职,共同提供数据支撑。
三、大模型应用差异体现
1. 纯向量RAG的局限
绝大多数初创项目落地 AI 应用,首选方案:文档切片→向量化→存入向量库→用户问题向量化,检索topK文本送入大模型。这套架构实现简单,落地门槛低,但随着业务复杂度提升,局限性持续暴露。
第一,缺乏关联视角。假设知识库有多份相互关联文档,分散存储:
- 向量检索只能独立召回相似度高的段落,无法自动识别段落内部实体存在关联。
- 大模型只能依靠碎片化文本自行推理,一旦信息分散,很容易丢失关联逻辑。
第二,无法精准溯源实体关系。当用户提出具备链式逻辑问题,例如 “找出所有和A项目存在合作关系的供应商,梳理合作时间线”:
- 纯向量检索只能找到零散文档,不能直接梳理网状关系。
- 大模型需要整合大量文本自行归纳,极易出现关系错乱,生成不存在的关联,也就是典型幻觉。
第三,无法支持结构化深度查询。如果业务需要统计、链路查询、多层实体挖掘,纯向量RAG很难高效实现。反复调用大模型文本分析,成本高、稳定性差。
2. 单独使用图数据库的局限
如果只搭建知识图谱 + 图数据库,不搭配向量库,同样存在明显瓶颈:
首先,原始非结构化文本无法直接检索。
- 业务中大量资料是 PDF、Word、会议纪要,无法全部提前完成实体抽取。
- 很多场景下用户需要直接查找原文,而不仅仅是结构化实体关系。
其次,实体名称模糊匹配困难:
- 用户提问经常使用别称、简称、模糊描述。
- 例如用户输入 “负责城市数字化项目的员工”,没有精准实体名称,图数据库无法直接匹配节点,必须依靠语义能力做实体链接。
3. 大模型幻觉的根源之一
大模型本身不掌握私有业务数据,所有知识来源于Prompt传入内容。
- 如果传入信息碎片化、缺少关联:模型靠自身参数知识脑补信息,产生幻觉;
- 如果只有结构化关系,缺少原始文本佐证:模型缺少原文依据,描述细节容易失真; 理想方案:同时提供原始文本素材(向量库提供)+ 结构化关联事实(图数据库提供),双重信息输入大模型,既有原文参考,又有确定关系约束,最大限度抑制幻觉。
4. 双库融合实践流程
想要兼顾语义检索与关系推理,架构上需要打通向量数据库、图数据库。形成一套工作流: 自然语言问题 → 大模型理解意图 → 分支 1:向量库检索相关原始文档;分支 2:抽取实体,图库查询关联链路;汇总两类结果 → 整合上下文送入大模型生成答案。
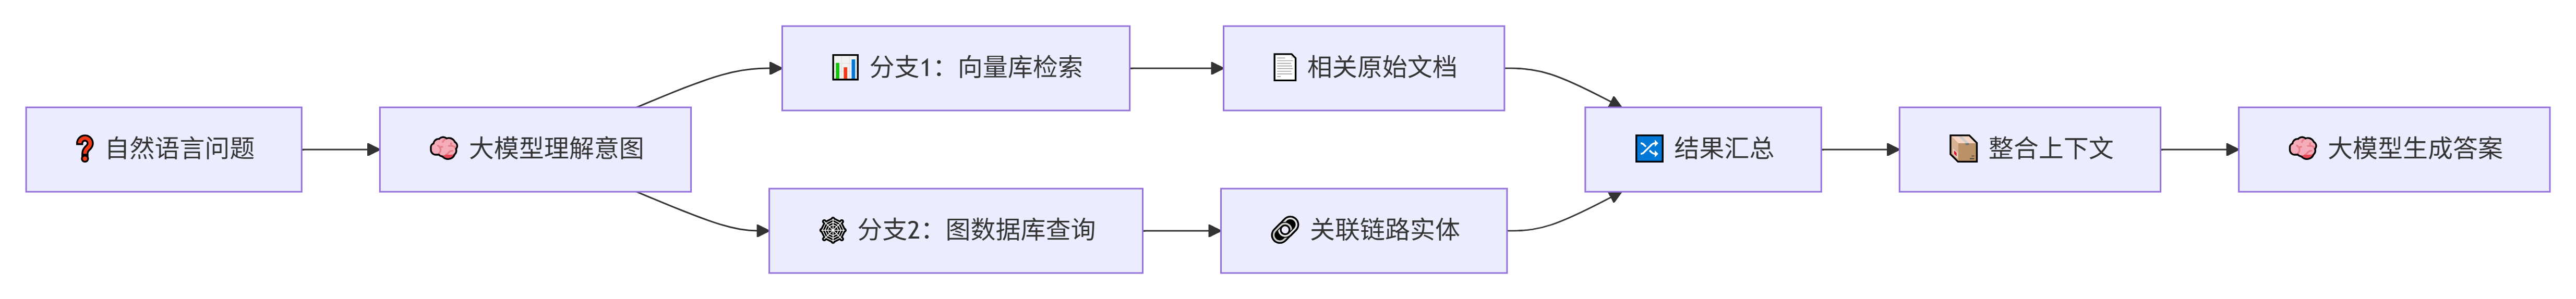
流程详细说明:
- 1. 用户输入自然语言问题
- 2. 大模型理解意图 → 根据问题类型分两条检索路径:
- 分支1(向量库):语义相似度检索,召回相关原始文档
- 分支2(图库):抽取实体,查询关系路径与关联链路
- 3. 结果汇总:合并两条分支的检索结果
- 4. 整合上下文:将文档片段与图关联信息一并注入上下文
- 5. 大模型生成答案:基于融合后的信息生成最终回答
四、向量库与图库融合架构
1. 主流融合架构模式
方案一:松耦合双库独立部署
向量数据库、图数据库分别独立部署,不存在底层联动,通过业务代码完成数据互通。 数据流:
- 1. 原始文档经过切片、Embedding,存入向量数据库;
- 2. 使用大模型信息抽取(IE),从文档中提取实体、关系;
- 3. 将实体、关系写入图数据库;
- 4. 用户查询时,并行发起向量检索 + 图查询;
- 5. 把文档片段和图谱关系一同组装Prompt交给大模型。

优势:架构简单、易于开发调试;两个组件可以独立扩容、独立运维;组件选型灵活,可以自由组合向量数据库+Neo4j、Qdrant+NebulaGraph。
劣势:需要维护两套数据写入逻辑;需要保证向量库文档和图谱实体数据一致性,存在数据同步成本。
方案二:向量嵌入内置到图数据库
Neo4j、NebulaGraph 等图数据库支持为节点增加向量属性。实体名称、实体描述生成向量,存储在节点属性中。 查询方式:用户问题向量,和所有实体向量做相似度匹配,实现模糊实体匹配(实体链接),找到目标节点后再执行图路径查询。

优势:只维护一套存储,架构极简;非常适合实体检索、知识问答场景。
劣势:图数据库向量检索性能弱于专业向量数据库;不适合存储海量文档向量,仅适合实体描述向量,无法承载大规模文档检索场景。
方案三:向量数据库关联图谱ID
文档入库向量库时,文档中抽取出来的实体绑定图谱节点ID;向量库每条向量携带实体ID标签。检索到文档之后,直接根据标签ID联动图数据库查询实体关联信息。

优势:文档与实体强关联,可以精准根据检索到的文档实体展开图谱查询,减少无效图库查询;查询效率更高。
劣势:写入逻辑更加复杂,数据链路更长,需要做好 ID 映射管理。
绝大多数工程落地,松耦合架构是性价比最高的选择,下文示例代码也基于松耦合模式实现。
2. 完整业务数据流拆解
2.1 数据预处理阶段(离线/准实时) 原始文档 → 文本清洗 → 文本切片:
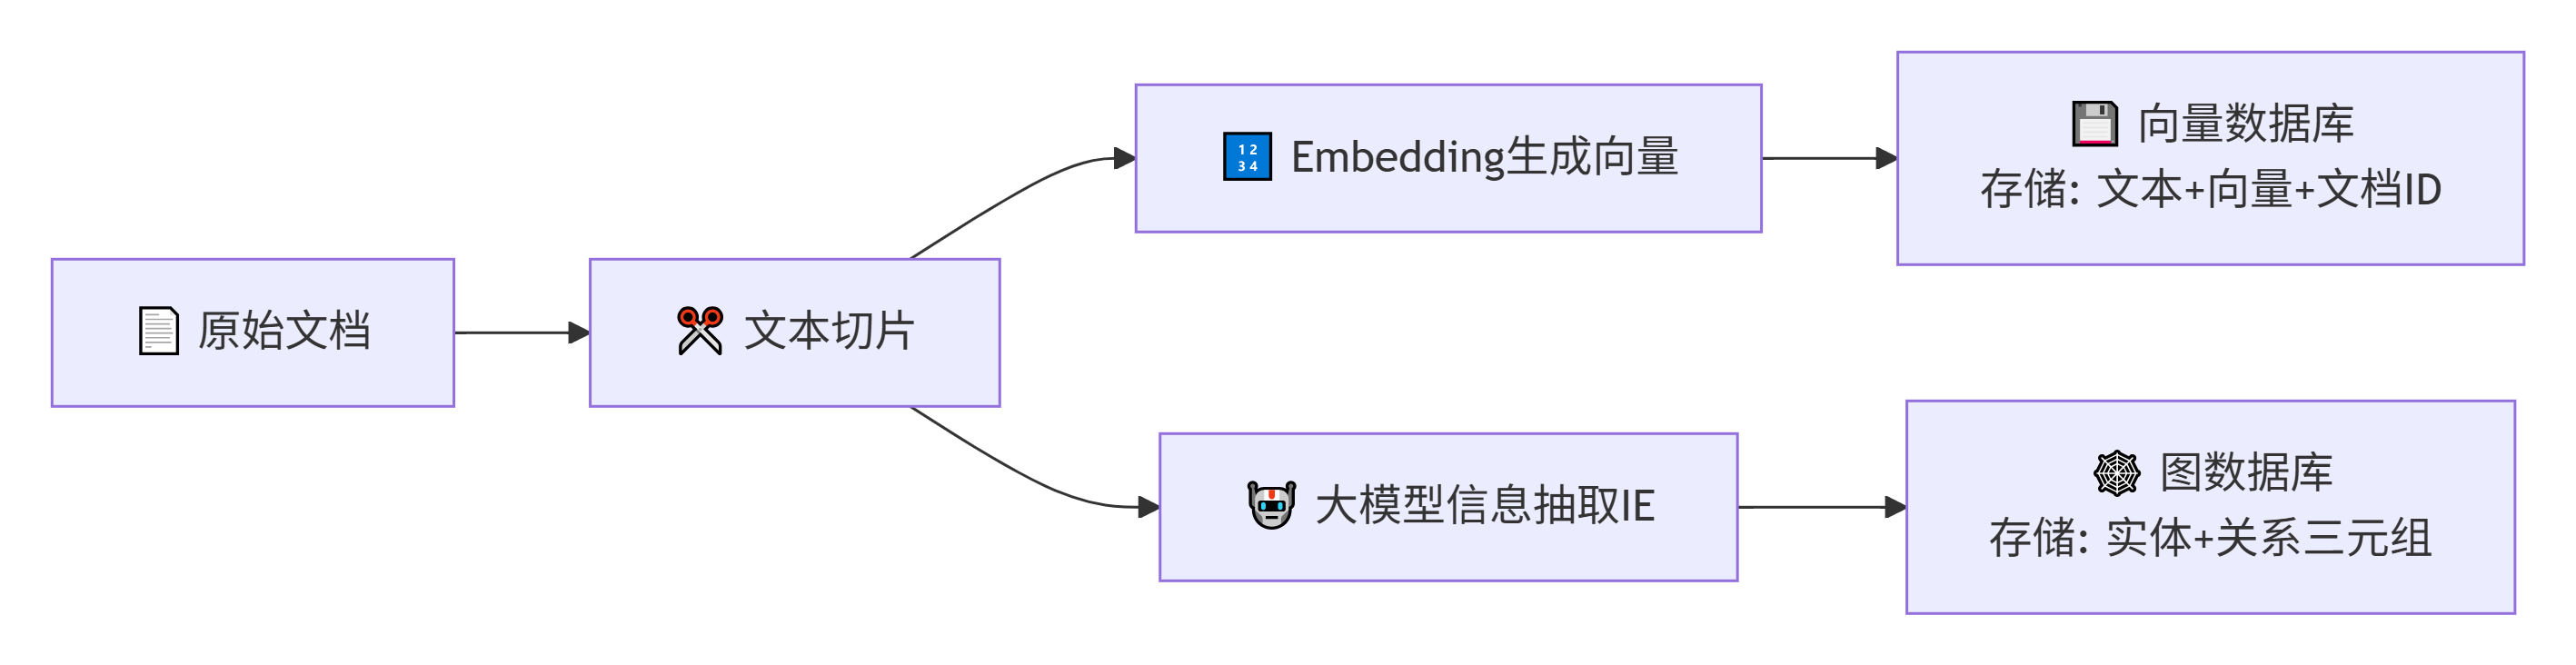
- ① 切片文本生成向量,写入向量数据库,存储文本、向量、文档ID;
- ② 使用大模型对切片文本做信息抽取,输出实体、关系三元组;
- ③ 将三元组写入图数据库构建知识图谱。
2.2 用户查询在线推理阶段 用户输入问题 →:
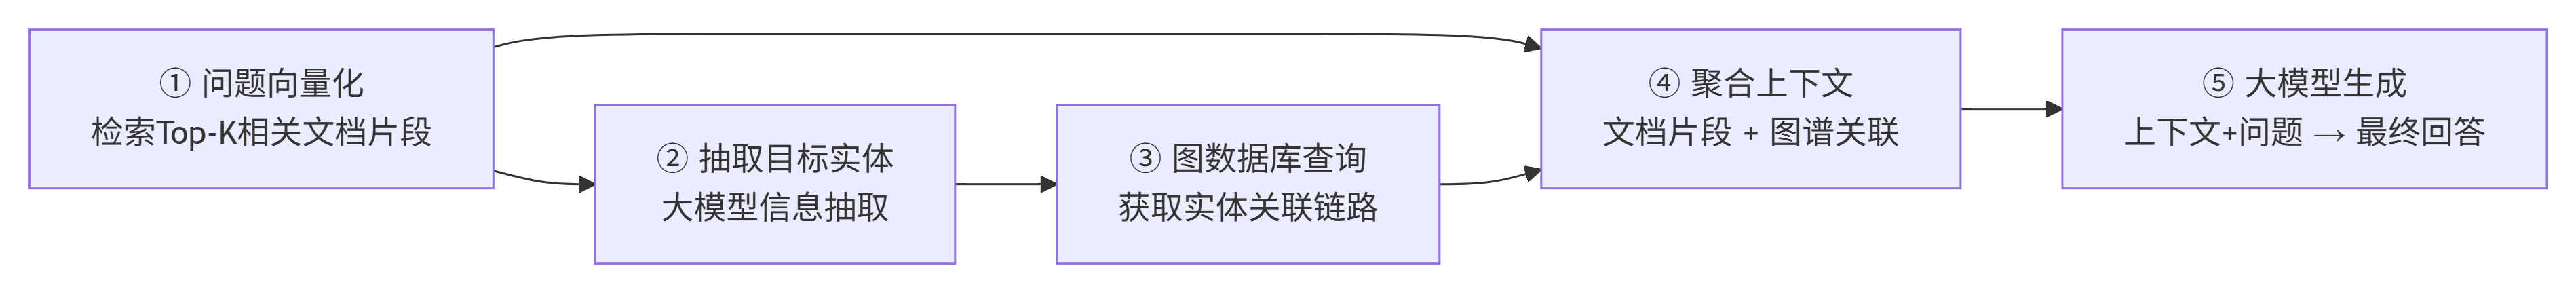
- 步骤 1:问题向量化,调用向量数据库检索Top-K相关文档片段;
- 步骤 2:调用大模型从用户问题中抽取目标实体;
- 步骤 3:使用抽取到的实体执行图数据库查询,获取实体关联链路;
- 步骤 4:聚合【文档片段】+【图谱关联关系】构建完整上下文;
- 步骤 5:上下文连同用户问题一起输入大模型,生成最终回答。
2.3 两步并行检索 → 融合 → 生成
- 1. 问题向量化:将用户问题转为向量,从向量数据库检索Top-K相关文档片段,获取语义相似内容。
- 2. 抽取目标实体:调用大模型从用户问题中提取关键实体
- 3. 图数据库查询:使用抽取的实体执行图查询,获取关联链路(结构关系)
- 4. 聚合上下文:将文档片段与图谱关联关系合并,构建完整上下文
- 5. 大模型生成:上下文+用户问题一起输入大模型,生成最终回答
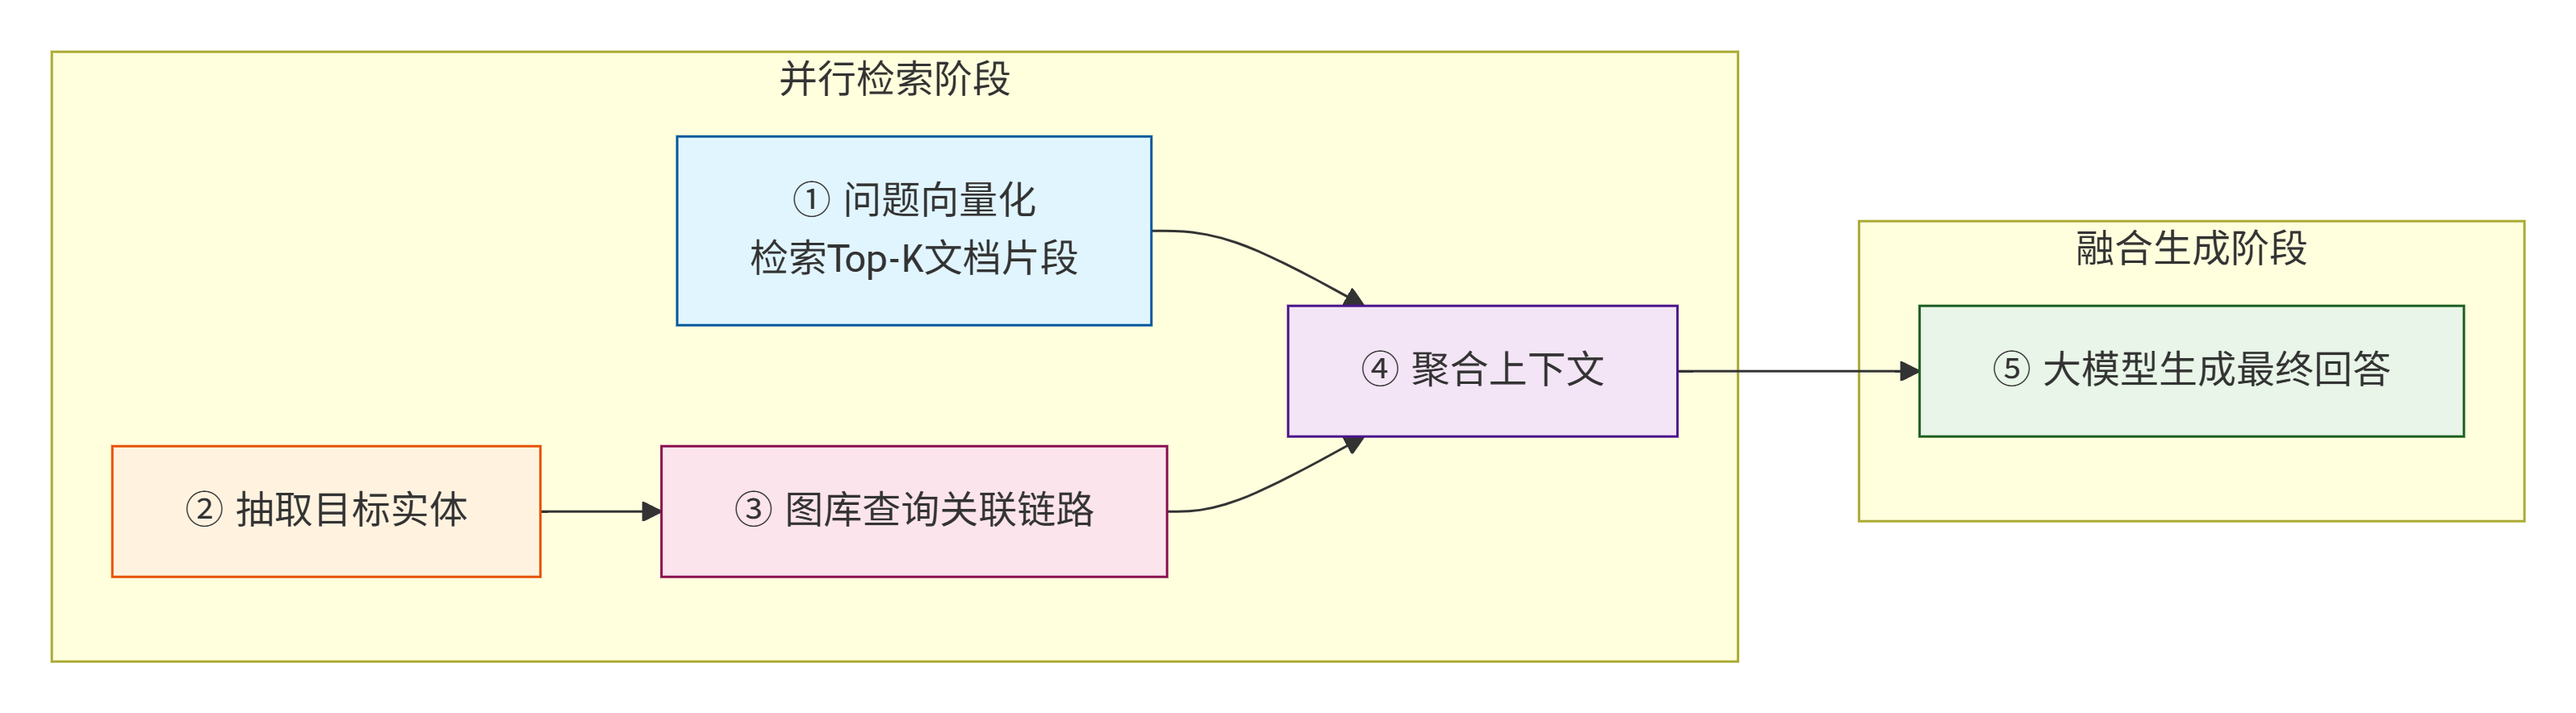
核心价值:同时利用语义相似(向量库)与结构关系(图库)两路信息,互补支撑精准回答。
3. Prompt设计关键技巧
双库架构下,Prompt不能简单堆砌信息,需要分层组织:
以下参考资料分为两部分: 【1.相关原始文档片段】 {向量检索结果} 【2.实体关联关系】 {图库查询得到的关系链路} 要求:回答优先参考原始文档内容,实体关联关系用来梳理逻辑脉络;不允许编造不存在的实体和关系,如果资料不足直接说明,禁止猜测。 用户问题:{query}
区分两类信息来源,引导大模型优先使用原文,同时利用图谱理清实体关联,有效降低幻觉。
五、工程代码实战演示
示例采用松耦合架构:Qdrant 向量数据库 + Neo4j 图数据库 + OpenAI Embedding实践;
1. 核心依赖安装
pip install qdrant-client neo4j sentence-transformers2. 向量数据库初始化与写入
以下示例实现了一个基于Qdrant向量数据库的知识检索模块:使用SentenceTransformer将文本编码为384维向量,批量写入Qdrant集合,并提供向量相似度搜索接口,支持通过查询语句快速检索最相关的文档内容,为RAG等应用场景提供底层向量检索能力。
from qdrant_client import QdrantClient
from qdrant_client.models import PointStruct, VectorParams, Distance
from sentence_transformers import SentenceTransformer

# 初始化向量模型
embed_model = SentenceTransformer("all-MiniLM-L6-v2")
vector_dim = 384

# 连接Qdrant向量库
qdrant_client = QdrantClient(host="127.0.0.1", port=6333)
collection_name = "knowledge_docs"

# 创建集合
if not qdrant_client.collection_exists(collection_name):
    qdrant_client.create_collection(
        collection_name=collection_name,
        vectors_config=VectorParams(size=vector_dim, distance=Distance.COSINE)
    )

# 测试文档
texts = [
    "张三参与智慧城市建设项目",
    "智慧城市项目签订三号工程合同",
    "张三负责三号合同现场管理工作"
]
vectors = embed_model.encode(texts)

# 批量写入向量库
points = []
for idx, (text, vec) in enumerate(zip(texts, vectors)):
    points.append(PointStruct(id=idx, vector=vec, payload={"text": text}))

qdrant_client.upsert(collection_name=collection_name, points=points)

# 向量检索函数
def search_vector_db(query: str, topk=3):
    query_vec = embed_model.encode(query)
    res = qdrant_client.search(
        collection_name=collection_name,
        query_vector=query_vec,
        limit=topk
    )
    return [hit.payload["text"] for hit in res]
2. Neo4j 图数据库查询封装
以下示例实现了一个基于Neo4j图数据库的人物关系查询模块:通过Bolt协议连接Neo4j实例,使用 Cypher查询语言匹配指定人物的所有关联节点与关系类型,将查询结果格式化为"人名-关系-目标名"的三元组列表返回,适用于知识图谱构建与实体关系探索场景。
from neo4j import GraphDatabase

driver = GraphDatabase.driver("bolt://127.0.0.1:7687", auth=("neo4j", "password"))

def graph_query_person(person_name: str):
    cypher = """
    MATCH (p:Person{name:$name})-r->(target)
    RETURN p.name,type(r),target.name
    """
    with driver.session() as session:
        result = session.run(cypher, name=person_name)
        records = []
        for rec in result:
            records.append(f"{rec[0]} {rec[1]} {rec[2]}")
    return records
3. 融合检索主流程
该示例实现了一个混合检索(Hybrid Search)上下文组装函数:同时调用向量数据库做语义检索、图数据库做实体关系查询,将两路结果拼接为结构化上下文,供大模型生成回答时使用,实现"语义相似 + 关系推理"的多源信息融合。
def hybrid_search(user_query: str, entity_name: str):
    # 1.向量检索文档
    doc_result = search_vector_db(user_query)
    # 2.图数据库查询关联关系
    graph_result = graph_query_person(entity_name)

    context = f"""
【相关文档素材】
{chr(10).join(doc_result)}

【实体关联关系】
{chr(10).join(graph_result)}
"""
    return context

# 调用测试
if __name__ == "__main__":
    ctx = hybrid_search("张三参与了哪些项目与合同", "张三")
    print(ctx)
六、应用实践优化总结
1. 数据同步一致性难题
松耦合架构最大痛点:向量库文档更新、删除后,图数据库对应的实体三元组需要同步变更,如果两边数据不一致,大模型会获取相互矛盾信息。可行优化方案:
- 统一事件总线;文档变更触发消息,同时触发向量库更新、图谱实体更新;
- 定期离线校验任务:遍历文档,重新抽取实体对比图库数据,修正差异;
- 重要业务场景避免硬删除数据,采用逻辑删除标记。
2. 实体抽取质量影响图谱效果
知识图谱质量上限由信息抽取效果决定。短文本抽取难度较低;长文档、非规范会议纪要,大模型很容易漏实体、错识别关系。优化策略:
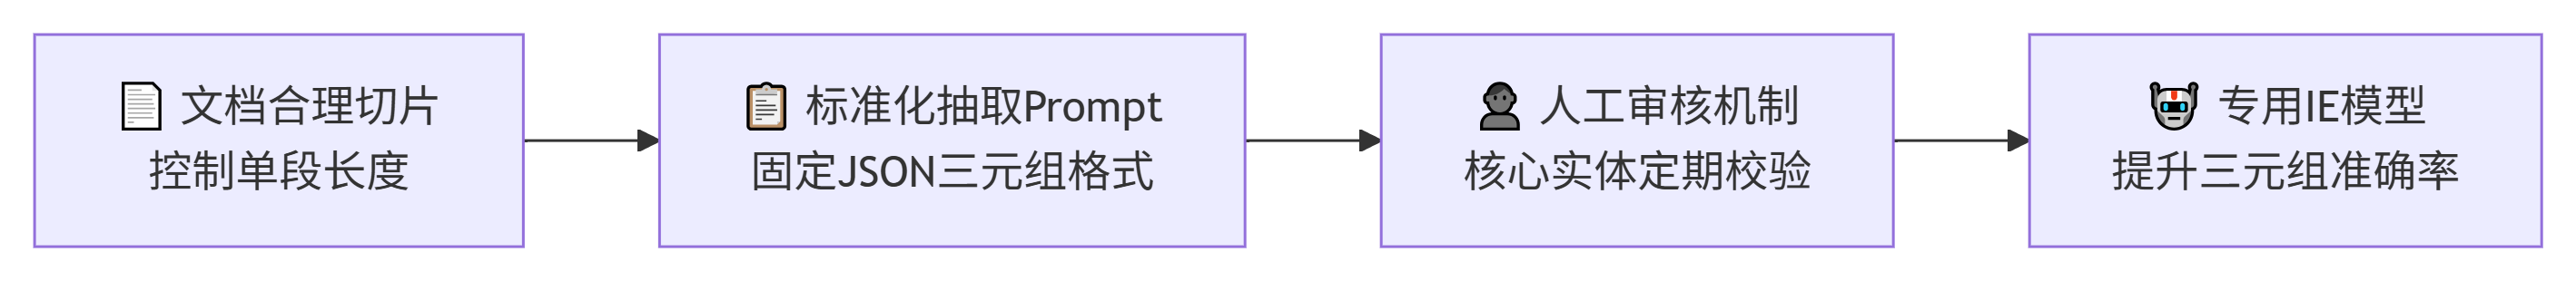
- 文档不要过长,合理切片,控制单段文本长度;
- 设计标准化抽取 Prompt,固定三元组输出格式,使用 JSON 结构化返回方便程序解析;
- 引入人工审核机制,核心业务实体定期人工校验;
- 使用专门信息抽取模型提升三元组准确率。
3. 查询性能优化策略
随着文档数量、实体规模上涨,双库并发查询会产生延迟。
- 向量库优化:合理选择索引 HNSW;按需开启标量过滤;冷热数据分离;分片部署。
- 图数据库优化:给常用查询节点建立索引;限制查询遍历深度,防止超长路径查询拖垮服务;避免全图扫描。
- 工程层面:向量检索与图查询并行执行,串行调用会叠加耗时。
4. 成本与复杂度权衡
并不是所有 AI 应用都需要立刻上双库架构。给大家清晰选型标准:
适合向量库 + 图库融合场景:
- 需要回答关联类、溯源类、链式推理问题;
- 存在大量实体关系需要挖掘;
- 业务对答案事实准确性要求高,需要降低幻觉。
不需要搭建图数据库:
- 仅做简单文档问答,没有实体关联查询需求;
- 业务以非结构化文本检索为主,几乎不涉及关系分析。
切勿盲目搭建知识图谱,后续长期维护成本极高,业务却用不上关系查询,造成资源浪费。技术架构需要匹配业务需求,避免过度设计。
七、行业落地典型场景
1. 企业内部智能知识库
企业内部包含人员、项目、合同、供应商、流程文档。
- 向量库:存储所有制度文档、会议纪要、项目资料,支持全文语义检索;
- 图数据库:构建人员、项目、合同、供应商知识图谱; 员工提问:“和 XX 供应商合作过哪些项目,相关负责人是谁,有哪些合同资料”。 系统先检索相关合同文档,同时查询图谱梳理合作链路,结合两类信息回答问题,既能给出原始文件,又能清晰展示关联脉络。
2. 金融风控与产业链分析
产业链上下游企业构成网状关系:
- 向量库存储研报、公告新闻;
- 图库存储企业、投资、担保、上下游关系。
用户可以查询某企业关联的所有关联公司,同时检索相关新闻公告,辅助风险研判。
3. 医疗文献、科研资料分析
查询某药物相关临床试验文献,以及药物与疾病、不良反应之间关联关系:
- 文献文本存入向量库实现语义检索;
- 疾病、药物、症状、临床试验构建知识图谱。
八、总结
向量数据库擅长语义相似度检索,处理海量非结构化文本;图数据库擅长实体关系挖掘与路径推理,二者能力互补,单纯向量RAG在关联推理场景存在明显短板,容易引发大模型幻觉;只使用图数据库无法直接检索原始文本,依赖高质量结构化抽取。向量库 + 图库 + 大模型融合架构,通过同时提供原始文本素材与结构化关联事实,有效提升答案准确性,拓展AI应用能力边界。
随着大模型技术持续发展,多模态嵌入、原生图向量一体化数据库正在快速发展。未来会出现更多原生支持图结构 + 向量检索的存储引擎,降低双库运维复杂度。与此同时,Agent智能体技术兴起,结合图谱路径规划、向量检索工具调用,可以打造具备自主信息检索、多步推理能力的智能 Agent。
技术永远只是工具。向量数据库、图数据库、大模型最终都是为业务服务。理解每种组件能力边界,合理组合搭建架构,用最低复杂度方案解决业务问题,才是技术落地最重要的思路。
附录:对话式审批助手实践
该示例整合了前面所有模块,构建了一个完整的对话式审批助手:通过Qdrant向量库与 Neo4j图数据库实现混合检索,调用LLM生成回答,并配套长期记忆管理(去重、压缩、衰减、冲突检测、版本更新)与反馈闭环(bad case筛选、人工标注、评测集沉淀),形成"检索→生成→记忆→反馈"的完整闭环架构。
import time
import uuid
import math
import numpy as np
from dataclasses import dataclass, field
from typing import List, Optional, Tuple

from qdrant_client import QdrantClient
from qdrant_client.models import PointStruct, VectorParams, Distance
from sentence_transformers import SentenceTransformer
from neo4j import GraphDatabase


# ============================================================
# 1. 记忆模块
# ============================================================

@dataclass
class MemoryItem:
    memory_id: str = field(default_factory=lambda: str(uuid.uuid4()))
    content: str = ""
    embedding: Optional[List[float]] = None
    create_time: float = field(default_factory=time.time)
    last_access_time: float = field(default_factory=time.time)
    weight: float = 1.0
    tags: List[str] = field(default_factory=list)
    source: str = "chat"
    version: int = 1
    is_valid: bool = True


class BaseMemoryStore:
    def __init__(self):
        self.memory_pool: dict[str, MemoryItem] = {}

    def add_memory(self, item: MemoryItem):
        self.memory_pool[item.memory_id] = item

    def get_all(self) -> List[MemoryItem]:
        return list(self.memory_pool.values())


def cosine_similarity(vec1: List[float], vec2: List[float]) -> float:
    a = np.array(vec1)
    b = np.array(vec2)
    return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)))


def deduplicate_memory(new_mem: MemoryItem, store: BaseMemoryStore, threshold=0.85) -> bool:
    """返回 True 表示存在重复,不入库"""
    if not new_mem.embedding:
        return False
    for mem in store.get_all():
        if not mem.embedding or not mem.is_valid:
            continue
        if cosine_similarity(new_mem.embedding, mem.embedding) >= threshold:
            mem.last_access_time = time.time()
            return True
    return False


def compress_memory_content(raw_text: str, level: str = "light") -> str:
    if len(raw_text) < 120:
        return raw_text
    # 此处替换为真实 LLM 调用
    return f"【{level}压缩结果】{raw_text[:60]}..."


def update_memory(store: BaseMemoryStore, target_id: str, new_content: str):
    if target_id not in store.memory_pool:
        return None
    old_mem = store.memory_pool[target_id]
    old_mem.is_valid = False
    new_mem = MemoryItem(
        content=new_content,
        tags=old_mem.tags.copy(),
        source=old_mem.source,
        version=old_mem.version + 1
    )
    store.add_memory(new_mem)
    return new_mem


def decay_weight(mem: MemoryItem, decay_lambda=0.0001, min_weight=0.1):
    delta = time.time() - mem.last_access_time
    new_weight = mem.weight * math.exp(-decay_lambda * delta)
    mem.weight = max(new_weight, min_weight)
    mem.last_access_time = time.time()
    return mem.weight


def detect_memory_conflict(mem_list: List[MemoryItem]) -> List[Tuple[str, str]]:
    conflict_pairs = []
    for i in range(len(mem_list)):
        for j in range(i + 1, len(mem_list)):
            m1, m2 = mem_list[i], mem_list[j]
            # 此处调用 LLM 判断冲突
            # if llm.check_conflict(m1.content, m2.content) == "冲突":
            #     conflict_pairs.append((m1.memory_id, m2.memory_id))
    return conflict_pairs


# ============================================================
# 2. 向量检索模块(Qdrant)
# ============================================================

embed_model = SentenceTransformer("all-MiniLM-L6-v2")
vector_dim = 384

qdrant_client = QdrantClient(host="127.0.0.1", port=6333)
collection_name = "knowledge_docs"

if not qdrant_client.collection_exists(collection_name):
    qdrant_client.create_collection(
        collection_name=collection_name,
        vectors_config=VectorParams(size=vector_dim, distance=Distance.COSINE)
    )


def index_documents(texts: List[str]):
    vectors = embed_model.encode(texts)
    points = [
        PointStruct(id=idx, vector=vec.tolist(), payload={"text": text})
        for idx, (text, vec) in enumerate(zip(texts, vectors))
    ]
    qdrant_client.upsert(collection_name=collection_name, points=points)


def search_vector_db(query: str, topk=3):
    query_vec = embed_model.encode(query)
    res = qdrant_client.search(
        collection_name=collection_name,
        query_vector=query_vec.tolist(),
        limit=topk
    )
    return [hit.payload["text"] for hit in res]


# ============================================================
# 3. 图数据库模块(Neo4j)
# ============================================================

driver = GraphDatabase.driver("bolt://127.0.0.1:7687", auth=("neo4j", "password"))


def graph_query_person(person_name: str):
    cypher = """
    MATCH (p:Person{name:$name})-r->(target)
    RETURN p.name, type(r), target.name
    """
    with driver.session() as session:
        result = session.run(cypher, name=person_name)
        return [f"{rec[0]} {rec[1]} {rec[2]}" for rec in result]


# ============================================================
# 4. 混合检索 + 上下文组装
# ============================================================

def hybrid_search(user_query: str, entity_name: str):
    doc_result = search_vector_db(user_query)
    graph_result = graph_query_person(entity_name)
    context = f"""
【相关文档素材】
{chr(10).join(doc_result)}

【实体关联关系】
{chr(10).join(graph_result)}
"""
    return context


# ============================================================
# 5. 反馈闭环模块
# ============================================================

class FeedbackPipeline:
    def __init__(self):
        self.candidate_bad_cases = []
        self.labeled_samples = []

    def auto_filter_bad_case(self, log_item: dict) -> bool:
        if log_item.get("user_dislike"):
            return True
        if len(log_item.get("response", "")) < 10:
            return True
        return False

    def add_labeled_sample(self, sample):
        self.labeled_samples.append(sample)
        self.export_to_eval_set()

    def export_to_eval_set(self):
        # 此处替换为真实存储逻辑
        print(f"导出 {len(self.labeled_samples)} 条样本到评测集")


# ============================================================
# 6. 审批助手主流程
# ============================================================

class ApprovalAssistant:
    def __init__(self):
        self.memory_store = BaseMemoryStore()
        self.feedback = FeedbackPipeline()

    def chat(self, user_query: str, entity_name: str = "张三"):
        # 1. 混合检索,组装上下文
        context = hybrid_search(user_query, entity_name)

        # 2. 调用 LLM 生成回答(此处模拟)
        response = f"根据检索结果,{user_query} 的相关信息如下:\n{context}"

        # 3. 记忆写入(去重 + 压缩)
        new_mem = MemoryItem(content=response, source="approval_chat")
        if not deduplicate_memory(new_mem, self.memory_store):
            compressed = compress_memory_content(response)
            new_mem.content = compressed
            self.memory_store.add_memory(new_mem)

        # 4. 记忆衰减(对所有记忆执行)
        for mem in self.memory_store.get_all():
            decay_weight(mem)

        return response

    def handle_feedback(self, log_item: dict):
        if self.feedback.auto_filter_bad_case(log_item):
            self.feedback.candidate_bad_cases.append(log_item)
            print("⚠️ 已标记为疑似 bad case,待人工标注")


# ============================================================
# 7. 测试入口
# ============================================================

if __name__ == "__main__":
    # 初始化文档索引
    index_documents([
        "张三参与智慧城市建设项目",
        "智慧城市项目签订三号工程合同",
        "张三负责三号合同现场管理工作",
    ])

    # 启动助手
    assistant = ApprovalAssistant()

    # 用户提问
    answer = assistant.chat("张三参与了哪些项目与合同", entity_name="张三")
    print(answer)

    # 模拟用户负反馈
    assistant.handle_feedback({
        "query": "张三参与了哪些项目与合同",
        "response": answer,
        "user_dislike": True
    })
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号