OoderAgent 工具与技能体系架构设计
原创
OoderAgent 工具与技能体系架构设计
原创
OneCode
发布于 2026-10-03 12:04:10
发布于 2026-10-03 12:04:10
Ooder 工具与技能体系架构设计
一个门面 · 四级裁剪 · 五段隔离
在一个 LLM 驱动的开发平台里,"能力"必须以 Function Calling 工具的形态出现在模型面前。真正困难的不是"怎么调一个工具",而是让装配、解耦、上下文、安全、生命周期与分类装载这六件事同时成立。装配与 SPI 解耦上下文构建安全边界生命周期五段体系
Ooder Team | 2026-10-03 | 架构设计 · LLM · Function Calling · 技能平台
0. 架构总览
在一个 LLM 驱动的开发平台里,"能力"必须以 Function Calling 工具的形态出现在模型面前。真正困难的部分不是"怎么调一个工具",而是下面六件事同时成立:
# | 设计目标 | 核心机制 | 关键坐标 |
|---|---|---|---|
1 | 装配:多种来源的能力收敛为单一执行面 | SkillExecutor门面 + 载体级适配器 | SkillExecutorRegistry |
2 | SPI 运行解耦:门面可插拔、可回退、不成为旁路 | 契约冻结 + 只读委托 + 原生上下文透传 | carrier-*适配器 |
3 | 上下文构建:四类执行上下文各自独立、无损传递 | SkillInvocation.nativeContext透传 | nativeContextAs(Class) |
4 | 安全:默认拒绝、显式开口、可审计 | 五道闸 + 调用集求交 + 类别级排除 | ChatToolExposure |
5 | 生命周期:从装载到执行的六个阶段全可观测 | 披露层级四档 + 只读观测端点 | /skills/executors |
6 | 分类与装载:不同场景看到不同工具,且不互相污染 | 五段隔离 + 位/段/域/类别四级收窄 | EntryProfiles |
理解这套架构,只需要抓住三个数字:1 个门面、4 级裁剪、5 个段。
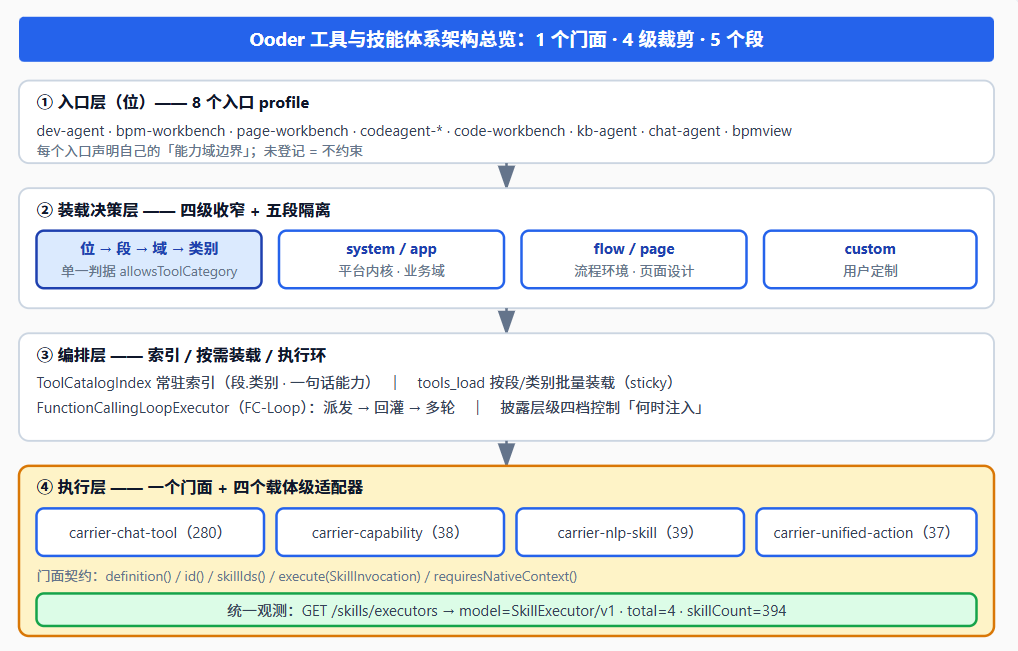
图 1 架构总览:入口层 → 装载决策层 → 编排层 → 执行层
1. 装配:从「多套注册」到「单一执行面」
1.1 分层与依赖方向
层 | 职责 | 关键模块 |
|---|---|---|
L0 技能框架层 | 与业务无关的抽象 | SkillRegistry/SkillDefinition/SkillMdRegistry(SKILL.md 驱动)、ToolCallingApi |
L1 流程引擎层 | 与业务无关的运行时 | scene-engine:流程引擎 +NlpSkill+UnifiedAction |
L2 宿主编排层 | 平台通用编排 | ooder-pro:ChatTool/CapabilityRegistry/ToolEngine/ FC-Loop |
L3 业务模块层 | 可外置 | ooder-biz-finance/ooder-biz-patent(端口自注册) |
硬不变式
依赖方向自上而下(L3 → L2 → L1 → L0),平台不反向依赖业务。门面接口因此被放在 L1(scene-engine),使 L1/L2/L3 的任何载体都能接入它。
1.2 门面契约
public interface SkillExecutor {
    SkillDefinition definition();            // 自述:id / kind / name / bindings
    String id();                             // 适配器 id(carrier-nlp-skill …)
    Collection<String> skillIds();           // 载体自述技能集,供跨载体派发
    SkillResult execute(SkillInvocation in); // 统一执行入口
    boolean requiresNativeContext();         // 是否必须原生上下文
}五个方法构成了最小完备的执行面:能自述、能被寻址、能被派发、能声明前置条件。
1.3 装配点:Spring Bean + SPI 合并去重
SkillExecutorRegistry 承担装配,规则是"两条来源、合并去重、Spring 优先":
- 来源一:Spring 容器里的 SkillExecutor Bean;
- 来源二:META-INF/services 声明的 SPI 实现;
- 建 byId(适配器 id)与 bySkillId(技能 id)双索引——后者让"按技能名跨载体派发"成为一次哈希查找;
- @Lazy(false) 显式提前初始化:宿主开启了 spring.main.lazy-initialization=true,没有注入点的 Bean 不会被实例化,其 @PostConstruct 自然不会执行。凡是"注册表恒空、枚举为空、适配器看不见"的症状,根因都在这里——因此装配点必须显式声明"我要提前初始化"。
1.4 四载体齐备
适配器 id | 载体 | kind | 规模(Studio / 沙箱) |
|---|---|---|---|
carrier-chat-tool | ChatTool | chat_tool | 280 / 291 |
carrier-capability | CapabilityFunction | capability | 38 / 38 |
carrier-nlp-skill | NlpSkill | nlp_skill | 39 / 39 |
carrier-unified-action | UnifiedAction | unified_action | 37 / 37 |
GET /api/studio/chat/skills/executors
{ "model": "SkillExecutor/v1", "total": 4, "skillCount": 394 }架构优势:此前四种载体各有一套注册机制、各自的枚举方式与各自的调用姿势;现在接入一种新载体 = 实现一个适配器,装配、寻址、派发、观测全部自动获得。
2. SPI 运行解耦:可插拔,且拔掉即回退
门面能"插上",更要能"拔掉"。这由四条设计约束保证。
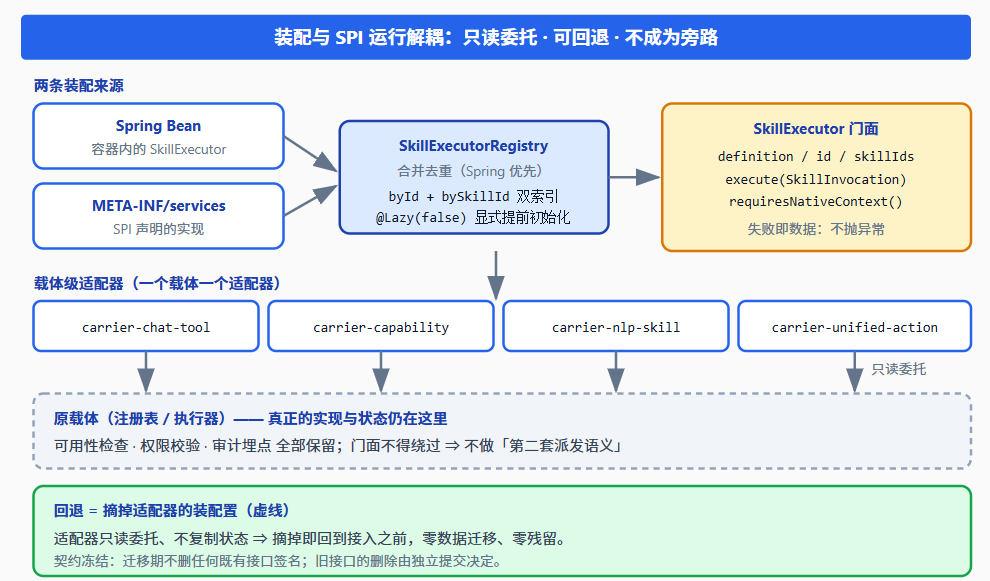
图 2 装配与 SPI 运行解耦:只读委托 · 可回退 · 不成为旁路
2.1 适配器是「载体级」而非「工具级」
一个载体一个适配器(如 carrier-capability 覆盖整个能力载体),而不是每个工具一个适配器。原因有二:其一,工具级适配器会让 190+ 个实例涌入门面,索引与派发都被噪声淹没;其二,工具级适配器常常不是 Spring Bean(例如能力适配器由注册表内部 new 出来),仅实现接口而不接线,门面根本看不见——这正是典型的"假生效"。
2.2 只读委托 ⇒ 回退成本为零
适配器只读委托回原载体,不复制状态、不建立第二份注册表:
SkillExecutor 门面
      └── Adapter(只读委托)
              └── 原载体注册表 / 执行器      ← 真正的实现与状态仍在这里
回退 = 摘掉适配器的装配置,行为立刻回到接入之前。这条约束把"引入门面"的风险降到了可控范围。
2.3 门面不得成为「旁路」
派发必须走载体原有的执行路径,绝不能在门面里另写一套调用逻辑。原因很直接:载体原路径上挂着可用性检查、权限校验、审计埋点;一旦门面绕过它们,安全与可观测性就同时失守。
门面 resolveTool(规范名) → toolEngine.executeTool(规范名, args, ctx)
                             ↑ 可用性检查 / 使用计数 / 审计 全部保留
2.4 两个 id 形态,三档解析
同一个工具在系统里存在两种 id 形态:
形态 | 取值 | 出现处 |
|---|---|---|
A 引擎注册键 | ChatTool.getName()(能力工具即@ToolRef.id()把.换成_) | 引擎注册表 key、LLM function-calling 的name |
B 载体声明 id | @ToolRef.id()原文(可含.) | @CapabilityDeclaration.tools、能力注册表 key |
门面按 bySkillId 寻址时,必须让两种形态都能命中,于是有了三档统一解析:① 形态 A 原样 → ② 形态 B 载体声明 id → ③ 形态 A′(把 . 归一为 _ 后重查注册表)。三档都不命中才判失败。
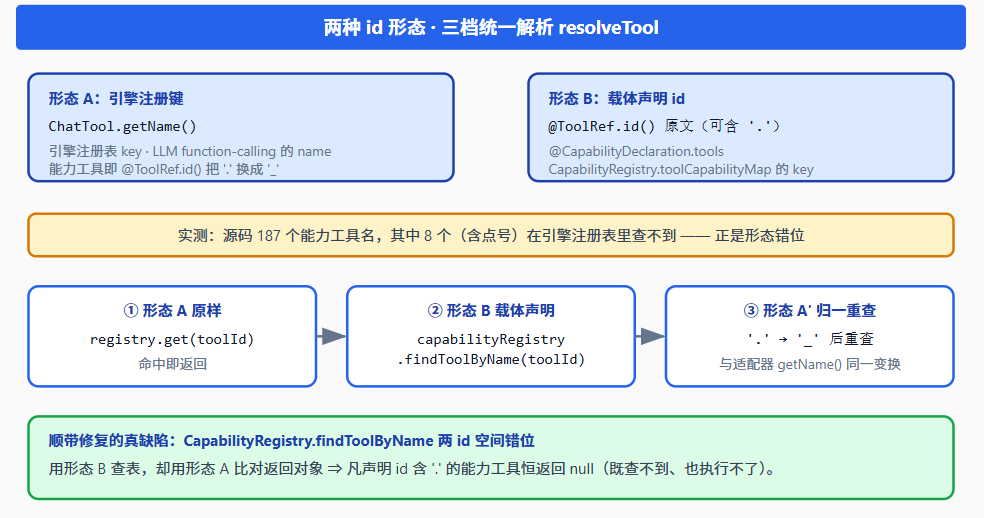
图 3 两种 id 形态 · 三档统一解析
架构优势:SPI 解耦不靠"约定所有人都用同一种 id",而靠在解析层吸收差异——载体与调用方各自保持自己最自然的表达。
3. 上下文构建:四类上下文各自独立,门面只透传
3.1 为什么不统一上下文
四类载体的执行上下文本来就不同,且各自携带不可替代的信息:
原生上下文 | 所属载体 | 关键内容 | 生命周期来源 |
|---|---|---|---|
SkillExecutionContext | NlpSkill | ActivityDefinition/ 流程实例 / 原始上下文 | 流程引擎运行期 |
ActionContext | UnifiedAction | 动作调用上下文 | 动作执行期 |
CapabilityContext | CapabilityFunction | userId/sceneId/sceneGroupId/intent | 会话 → 场景 |
ChatContext | ChatTool | sessionId/userId/sceneId/variables/sceneContext | 会话 → 场景 → 环境 |
强行"统一"它们,只会造出一个什么都能塞、什么都不能保证的万能上下文。架构选择是:不统一,只透传。
public final class SkillInvocation {
    String skillId;
    Map<String,Object> args;
    Object nativeContext;        // 载体原生上下文:门面不解释
    String conversationId, userId, sceneId;
    public <T> T nativeContextAs(Class<T> type) { … }
}
门面只负责把 nativeContext 原样交给适配器;适配器负责把它交给自己熟悉的载体。
3.2 上下文如何被构建出来
上下文的注入是逐层叠加的,每一层只负责自己那一段:
HTTP 请求
  └─ 会话(conversationId / userId / 粘性 profile)
       └─ 意图路由 → 场景(sceneId / sceneContext)
            └─ 环境绑定
                 ├─ _flowEnv   流程上下文(processId / activities / routes / 设计强度)
                 └─ _pageEnv   页面上下文(className / pageId)
└─ 工具执行(ChatContext.variables 汇总上述全部)关键点在于:环境上下文是"声明式"的。当 _flowEnv 被绑定时,流程段工具才被按域注入;当 _pageEnv 被绑定时,页面段工具才进入工具面。上下文不存在时,工具不会被"猜"出来。
3.3 上下文缺失是「可读失败」,不是「静默降级」
requiresNativeContext() == true // 载体声明:我没有原生上下文就跑不了缺上下文时,门面返回的是带原因的失败,而不是伪造一个空上下文让它"跑起来":
NlpSkill 只能在流程执行上下文中运行(需 nativeContext=SkillExecutionContext)
这是刻意的
伪造空上下文会制造"看起来成功、实际什么都没发生"的假绿,比失败更危险。
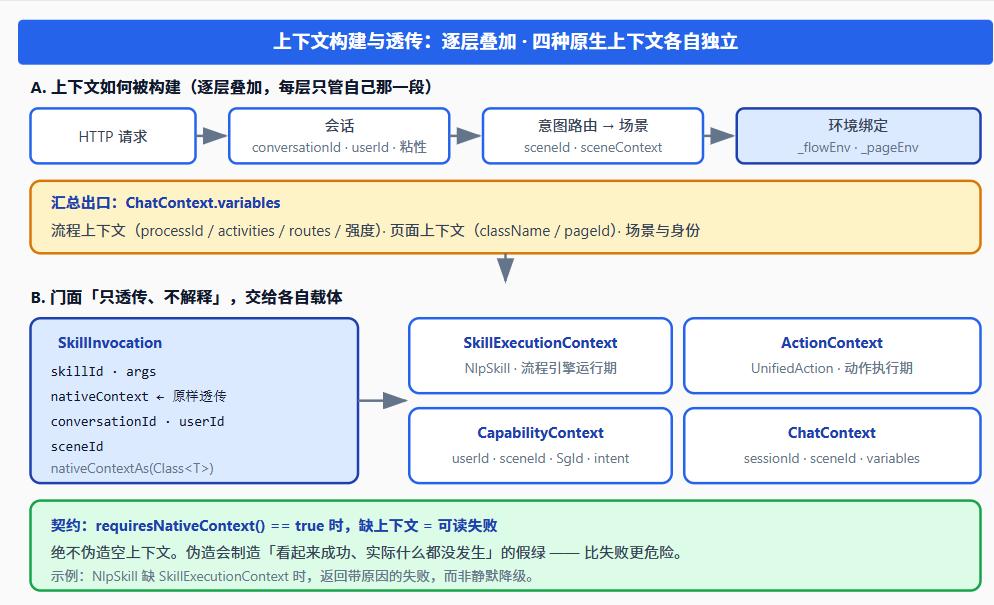
图 4 上下文构建与透传:逐层叠加 · 四种原生上下文各自独立
4. 安全:默认拒绝 · 显式开口 · 可审计
安全不是一层开关,而是五道相互独立的闸。
4.1 工具级闸:高权限工具默认关
以命令执行为例,它有三道闸:
闸 | 机制 | 默认 |
|---|---|---|
开关闸 | ooder.chat.shellExecute.enabled | false(默认关) |
目录闸 | 工作目录必须落在白名单根之内 | 白名单校验 |
内容闸 | 危险命令黑名单(9 条) | 命中即拒 |
设计口径
危险能力的默认值必须是"关"。开启是运维的显式动作,而不是忘记关闭的默认状态。
4.2 调用集求交:发布集即安全边界
LLM 能"装载"的工具集(发布集,callable)与系统能"派发"的工具集(派发集)被刻意设计成:
发布集 ⊆ 派发集 // 发布集 = 场景面 ∪ 能力注册表(求交裁剪)即:能被模型"看见并装载"的工具,一定在安全边界之内。派发集之外的工具不会因为"某个环境默认装载"而意外进入 schema。
4.3 跨场景装载:默认最严,只读显式开口
跨场景按需装载由注解控制,默认关闭:
@ChatToolExposure(crossScene = true, reason = "只读:源码检索")- crossScene 默认 false ⇒ 新增工具默认"仅场景内可调用";
- reason() 供审计,说明"为什么它可以跨场景";
- 首批只放开 6 个明确只读的工具(源码检索 / VFS 读 / 流程摘要 / 流程详情 / HTML 分析 / BPM 节点列举)。
增量式放开是这里的关键:安全边界的扩大必须是一个个显式决定,而不是一次批量授权。
4.4 类别级排除:收敛越权面
入口声明了"需要 system 段",不代表它需要 system 段里的每一个类别。类别级排除让"该入口需要 system 段,但不需要其中某个类别"可以被精确表达——例如把"沙箱运维"类从设计型入口摘掉(摘掉不丢功能,因为工程工作台入口已显式包含它)。
4.5 结构性安全网:收得再紧也不「死局」
无论入口把工具面收得多紧,tools_index / tools_find / tools_load 三件套永不被裁掉。收窄的目标是"减少噪声",不是"切断能力"——LLM 始终保有按需发现并装载域外工具的手段。
4.6 沙箱:非空令牌 + fail-close
沙箱的 /api/test 前缀接口要求非空令牌(X-Sandbox-Token 或 Bearer);未配置令牌时必须 fail-close(拒绝而非放行),仅豁免 /actuator 与 /test/health。
统一口径:fail-close · 默认拒绝 · 显式开口 · 可审计。四条同时成立,才算一条可靠的边界。
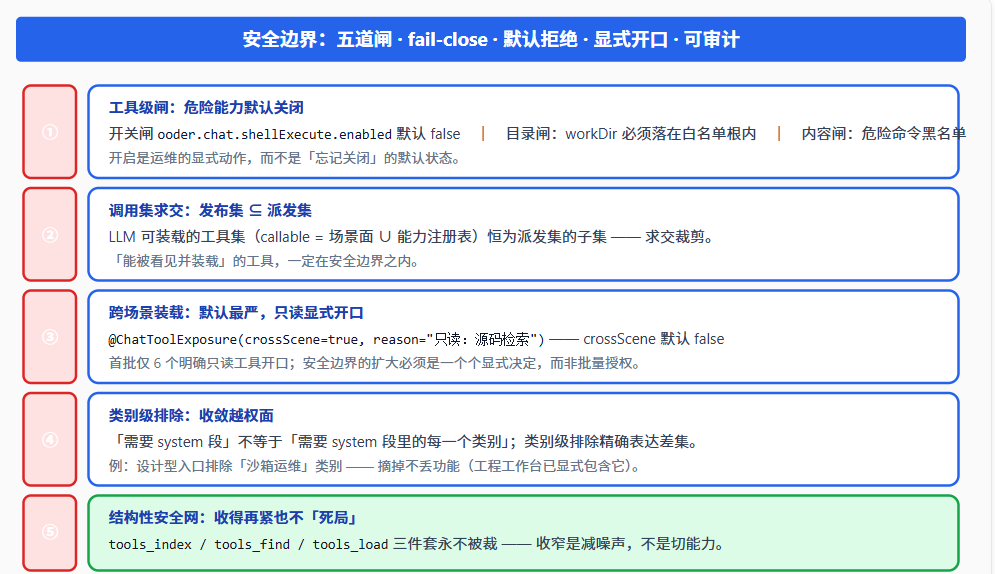
图 5 安全边界:五道闸 + 沙箱 fail-close
5. 生命周期:从装载到观测的六个阶段
一个技能/工具从"存在"到"被调用",经历六个阶段,每个阶段都有确定的机制与可观测的出口:
阶段 | 动作 | 机制 | 观测出口 |
|---|---|---|---|
① 装载 | 从四处来源发现定义 | SKILL.md 解析 / 注解扫描 / 构造器注入 / SPI | 启动日志(技能数、domain) |
② 注册 | 写入注册表并建双向映射 | ToolEngine/CapabilityRegistry/UnifiedSkillRegistry | /skills/index(byKind计数) |
③ 索引 | 生成常驻索引注入 system prompt | ToolCatalogIndex按段/域/类别渲染 | 索引文本(前缀稳定) |
④ 按需装载 | 模型显式加载某类别/段/名称 | tools_load(批次按段/类别,加载后 sticky) | newlyLoaded |
⑤ 执行 | FC-Loop 派发并回灌结果 | 门面寻址 → 载体原路径执行 | flow_tool_call/ 工具结果 |
⑥ 观测 | 只读端点自证 | executors / tool-resolve / execute-sample / matrix | JSON 报告 |
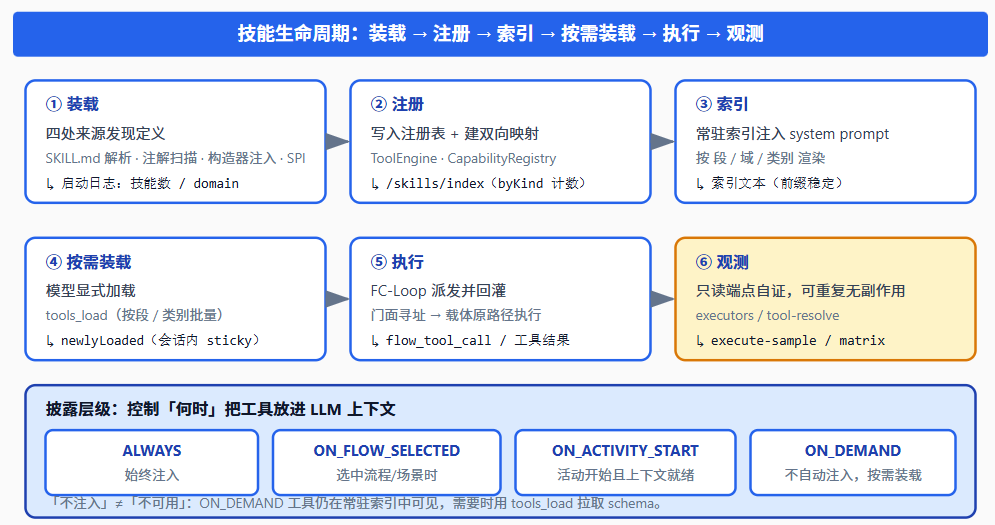
图 6 技能生命周期六阶段与披露层级四档
5.1 披露层级:工具"何时"进入上下文
生命周期里最需要设计的是时机。工具按披露层级分四档:
层级 | 何时注入 | 典型工具 |
|---|---|---|
ALWAYS | 始终注入 | 核心只读工具 |
ON_FLOW_SELECTED | 选中对应流程/场景时 | 场景专属工具 |
ON_ACTIVITY_START | 活动开始且有上下文 | 高级流程工具 |
ON_DEMAND | 不自动注入,按需装载 | 长尾工具 |
"不注入"不等于"不可用":ON_DEMAND 的工具依然出现在常驻索引里,模型知道它存在,需要时用 tools_load 拉取 schema 即可。这使"工具面很小"与"能力不缺失"得以同时成立。
5.2 观测能力是架构的一部分
六个只读、可重复、无副作用的端点,让上面六个阶段每一步都能被独立验证:
GET /api/studio/chat/skills/executors        # 装配:门面自述(4 载体)
GET /api/studio/chat/skills/index            # 注册:byKind 计数
GET /api/studio/chat/skills/tool-resolve     # 寻址:id 三档解析取证
GET /api/studio/chat/skills/execute-sample   # 执行:真实调用(成功 + 契约失败两态)
GET /api/studio/chat/skills/execute-compare  # 等价:门面 ≡ 直连
GET /api/studio/chat/tool-face-matrix # 装载:各入口面与排除分布它们不是"测试代码",而是产品的一部分:既供回归,也供排障("为什么某入口看不到某工具"一次请求即可回答)。
6. 分类体系与装载:五段隔离 + 四级收窄
6.1 五段:先做空间隔离
全量工具按语义分成五段,段的边界就是"不该互相污染"的边界:
段 | 含义 |
|---|---|
system | 平台内核(会话 / 流程 / 配置 / 身份 / 知识基础设施 / 运维协作) |
app | 业务域(设计生成 / 表单 / 文档 / 知识中枢 / 行业场景) |
flow | 流程工具环境(定义 / 画布 / 运行期 / 实例级 / 通道 / 属性 / 知识 / 协作) |
page | 页面设计工具环境 |
custom | 用户定制(随项目 / 租户变化的能力) |
前提
分类的语义正确性是前提:类别必须落到它真正的归属段上,否则"按段收窄"不会报错,只会安静地裁错东西。例如"技能包提供的工具"应当按技能声明的作用域(@domain)归入 system / app / flow / page,而不是笼统地全部丢进custom。
6.2 四级收窄:位 → 段 → 域 → 类别
真正的装载决策发生在四层,逐级收紧、逐层可观测:
① 位(入口 profile)      你是从哪个入口页来的?(8 个入口)
        ↓ 段上界
② 段(5 段)              这个入口根本不该看到哪一段?
        ↓ flow 段内域白名单
③ 域(flow 段内 8 域)    流程段里只保留 运行期/实例/协作/属性/通道/知识
        ↓ 类别级排除
④ 类别                    该入口需要 system 段,但不需要其中某一类
统一判据只有一处:
allowsToolCategory(entry, category):
    ① 类别级排除命中                     → 拒
    ② segmentOf(category) 不在入口允许段 → 拒
③ flow 段:未声明域 → 放行;已声明域 → 仅放行域白名单内类别并且双出口同时生效——无论是"场景直接取面"还是"渐进披露取面",两处都会经过同一判据,避免同一会话在不同路径下看到不一致的工具面。
6.3 场景装载矩阵
不同入口按职责声明不同的段上界,形成稳定的装载矩阵(Studio 全量 280):
入口 | 允许段 | 工具面 | 设计意图 |
|---|---|---|---|
dev-agent | 五段不约束 + 排除sandbox_devops | 258 | 页面 + 流程建模同体,只摘掉沙箱运维 |
bpm-workbench | system + app + flow | 222 | 画布工作台,不做页面设计 |
page-workbench | system + app + page | 191 | 页面设计器,不做流程建模 |
codeagent-workbench | system + app + custom | 177 | 源码管理 + 沙箱 harness |
code-workbench/codeagent-agent | system + app + custom | 177 | 同 codeAgent 职责边界 |
kb-agent | system + app + custom | 155 | 知识维护,排除两个"设计环境"段 |
chat-agent | system + app + custom | 177 | 通用问答 |
bpmview | 不约束(只读深链壳) | 280 | 面极小,靠场景白名单收窄 |
finance-agent/patent-agent | system + app + custom + flow(域收窄) | 254 | 业务走"场景 + 流程",需要运行期而非画布写通道 |
未登记 = 不约束(默认零影响);登记即显式选择该入口的能力域边界。矩阵可随时用 GET /api/studio/chat/tool-face-matrix 复现。
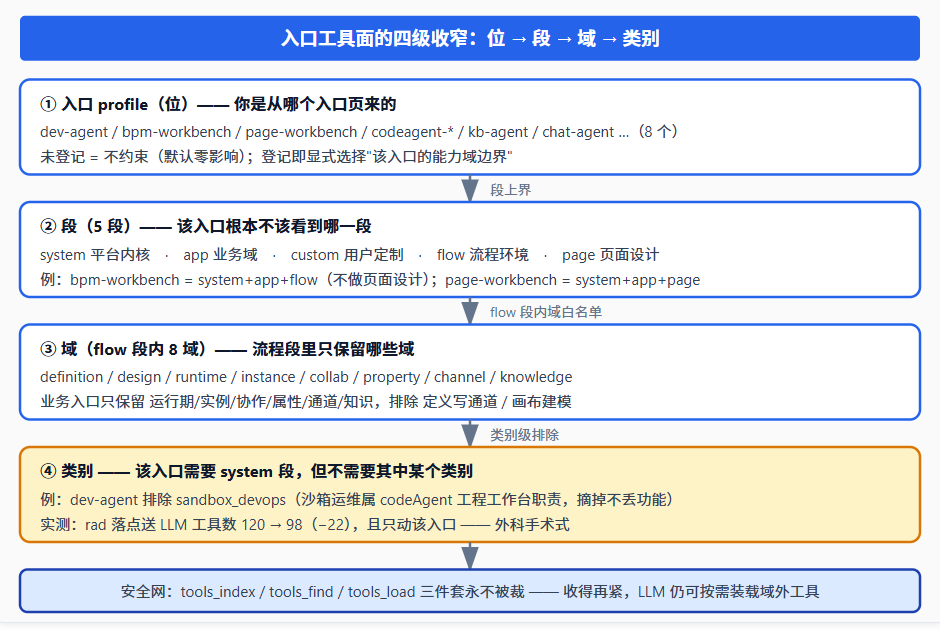
图 7 入口工具面的四级收窄:位 → 段 → 域 → 类别
7. 架构优势小结
维度 | 设计前 | 设计后 | 收益 |
|---|---|---|---|
装配 | 五套载体、四套注册机制,无统一执行面 | 1 个门面 + 4 个载体级适配器;/skills/executors一次可查 | 新载体接入 = 实现一个适配器 |
SPI 解耦 | 接口耦合、难以回退 | 契约冻结 + 只读委托 + 摘装配置即回退 | 引入门面的风险可控 |
上下文 | 上下文形态混杂,易伪造 | 四类原生上下文各自独立,门面只透传;缺失即可读失败 | 杜绝"假绿",载体互不污染 |
安全 | 危险能力开关散落、默认值不明确 | 五道闸:工具级闸 + 求交裁剪 + 默认最严的跨场景 + 类别级排除 + 结构性安全网 | fail-close、可审计、增量放开 |
生命周期 | 装载即不可知 | 六阶段 × 四档披露层级,全部有只读观测出口 | 每一步可独立验证 |
分类与装载 | 工具面靠多个开关叠加,不可复现 | 五段隔离 + 位/段/域/类别四级收窄,单一判据、双出口生效 | 场景间零污染;收窄与防劣化同一枚硬币 |
附:关键坐标
主题 | 位置 |
|---|---|
统一门面 | scene-engine/src/main/java/net/ooder/scene/skill/SkillExecutor.java |
门面装配 | scene-engine/.../skill/SkillExecutorRegistry.java |
载体适配器 | ooder-pro/.../chat/skill/ChatToolExecutorAdapter.java、CapabilityExecutorAdapter.java |
三档解析 | ooder-pro/.../chat/engine/ToolEngine.java#resolveTool |
入口工具面上界 | ooder-pro/.../chat/entry/EntryProfiles.java |
披露层级 | ooder-pro/.../chat/tool/ChatTool.java(DisclosureLevel) |
跨场景声明 | ooder-pro/.../chat/tool/ChatToolExposure.java |
命令执行闸 | ooder-pro/.../chat/tool/ShellExecuteTool.java |
量化矩阵端点 | ooder-pro/.../chat/controller/EntryCatalogController.java |
技能索引 / 观测端点 | ooder-pro/.../chat/skill/SkillIndexController.java |
本文聚焦架构本身:装配、解耦、上下文、安全、生命周期、分类与装载。所有规模数字均来自运行时实测。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号