FDE 的真正交付物:为企业构建会自我进化的 AI 体系 A/B/C 三级服务架构与技能包生产闭环
原创
FDE 的真正交付物:为企业构建会自我进化的 AI 体系 A/B/C 三级服务架构与技能包生产闭环
原创
OneCode
发布于 2026-10-04 11:35:19
发布于 2026-10-04 11:35:19
摘要:FDE(Forward Deployed Engineer,前向部署工程师)进入企业,做的从来不是"装几个 AI 应用"。把 AI 带入企业只是起点,为企业构建完整的 AI 体系才是目标;交付几个可用的技能包只是里程碑,交付企业级的 AI 生产迭代能力才是终点。本文站在企业 AI 完整落地的角度,阐述 FDE 如何用 A/B/C 三级服务架构搭建这套体系:A 级建设企业 AI 基础设施,B 级沉淀企业 AI 知识资产与领域规范,C 级建成部门自助的技能包生产线;并以 devAgent 护栏、NLP 生成管线、三重测试与小时级发布为骨架,形成"需求 → 开发 → 测试 → 上线 → 回流"的完整闭环。FDE 离场之日,留下的不是几个技能包,而是一条企业可以自己持续运转、持续进化的 AI 生产线。 企业 AI 实践系列 · 2026-10
一、引言:FDE 的真正交付物是什么
FDE 是大模型时代企业 AI 落地的关键角色:驻扎在客户现场,把平台的通用能力翻译成企业的真实生产力。但 FDE 工作的定位有三重递进,很多失败的企业 AI 项目,恰恰是停在了第一层。
1.1 三重递进:FDE 工作的三个层级
第一层:把 AI 带入企业。 接入大模型、上线聊天助手、做几个演示应用。这一层解决"有没有"——但它交付的是现象:模型能对话、Demo 能跑。演示结束,热度退去,企业手里的 AI 能力开始停滞。
第二层:为企业构建完整的 AI 体系。 AI 要承载真实业务——财务流程、凭证审核、账龄分析、知识管理、跨部门协作——就必须有一套体系:AI 基础设施(会话、流程、通讯、文件、工具目录)、AI 知识资产(企业的术语、口径、流程规范)、组织协同(谁能读什么、谁能改什么、变更怎么审批)。这一层解决"成不成体系"——它交付的是骨架。
第三层:交付 AI 生产迭代能力。 体系搭建完成只是地基。真正的终点是:企业自己的人 + 企业自己的 devAgent,能够在这套体系上持续地开发、测试、上线、演化新的技能包——不依赖原厂驻场,不依赖外部厂商版本排期。这一层解决"能不能自我进化"——它交付的是生产能力。
判断 FDE 工作成败的标准只有一条:FDE 离场之后,企业的 AI 能力是停滞,还是继续生长。
1.2 构建体系必须回答的三个工程问题
要交付第二、三层的"体系"与"生产能力",FDE 会立刻撞上三个矛盾。这三个矛盾不是管理问题,是必须用架构回答的工程问题:
矛盾一:变更节奏的撕裂。
层 | 变更动力 | 合理节奏 |
|---|---|---|
平台底座 | 架构演进、能力升级 | 月级 |
领域规范 | 客户周期、行业适配 | 周 ~ 月级 |
业务技能 | 部门需求、临时活动 | 天 / 小时级 |
如果三者混在一个代码库里,任何一个业务的紧急修改都要牵动整个平台重新回归测试;而平台的一次重构又会让所有业务排期等待。变更节奏必须被架构显式分层。
矛盾二:知识归属的错位。 平台不能"懂业务"——否则它就成了某个客户的定制品,永远无法复用;但 Agent 要干活,又必须让机器可读地理解业务术语、流程与规则。知识放在哪、谁能读、谁能改、怎么防止"平台知业务",必须有一套硬规矩。
矛盾三:自主与安全的博弈。 devAgent(LLM 驱动的开发代理)要能真正读代码、改代码、跑构建闭环,才有生产力;但放任它改,一次误操作就可能击穿底座护栏、污染领域契约、删除既有知识解释。自主的边界必须被机器可判定地约束,而不是靠提示词恳求。
A/B/C 三级服务架构,就是 FDE 对这三个问题的系统回答——也是企业 AI 体系的蓝图本身。
二、企业 AI 体系的蓝图:A/B/C 三级架构
2.1 三层角色画像
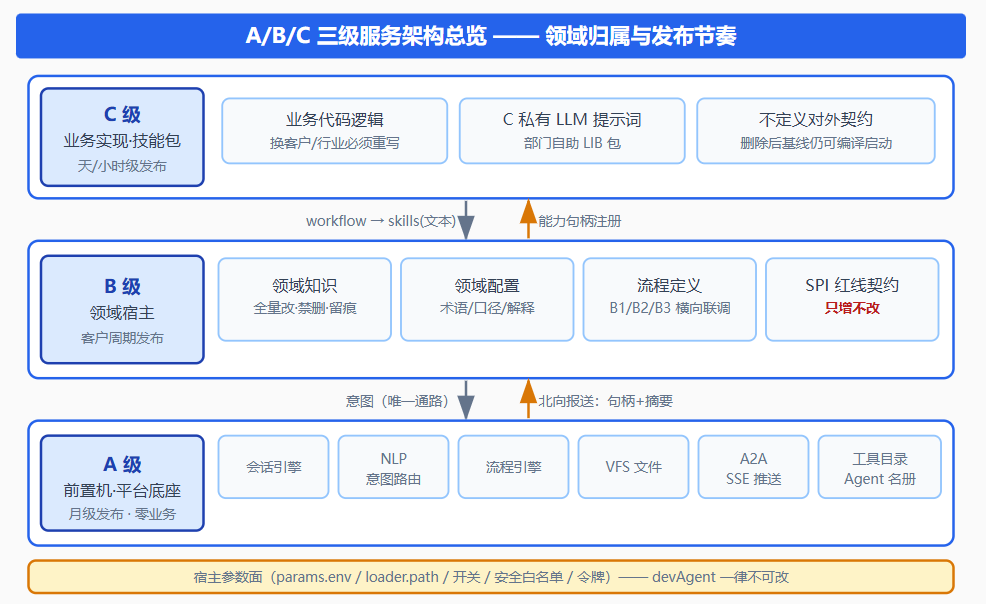
图 1 · A/B/C 三级服务架构总览:领域归属与发布节奏
A 级:企业 AI 基础设施(前置机 · 平台底座)
- 定位:零业务的产品基线,月度发布——整个 AI 体系的"水电煤"。
- 承载:会话引擎、NLP 意图路由、流程引擎、VFS 文件系统、A2A 通讯总线、SSE 事件推送、工具目录索引(ToolCatalogIndex)、Agent 名册等平台能力。
- 铁律:A 不知道 B/C 的存在。A 的代码与配置里不允许出现任何业务词表("报销""凭证""账龄"),也不持有任何领域知识/配置/流程。A 只读"能力句柄 + 摘要",且这些摘要全部由 B 主动报送。
- 发布节奏:月级。平台包永远可以直接卖给任何客户,A 档实例推荐不提供 lib/biz 目录。
B 级:企业 AI 知识资产与领域中枢(领域宿主)
- 定位:企业知识的家,客户周期发布——这是企业 AI 体系中最该被企业自己持有的资产。
- 承载:领域的知识、配置、流程三件套——领域知识库(术语、解释、口径)、SPI 红线契约、流程定义、能力句柄目录。这是领域归属约定的核心:领域的知识/配置/流程统一归 B,C 只放业务实现。
- 红线:SPI 层禁止改/删既有,允许新增与增量更新;知识部分拥有全量修改权但禁止删除。
- 价值:横向联调位——多个 B(B1/B2/B3 各自对应不同客户/领域)共享同一个 A 底座,各自挂载自己的 C。
C 级:部门自助技能生产车间(业务实现 · 逻辑技能包)
- 定位:部门自助的业务实现,天/小时级发布——企业生产迭代能力的发生地。
- 承载:业务代码逻辑、C 私有 LLM 提示词、部门自助 LIB 包。
- 判定标准(三条同时满足才算 C 级代码):换客户/行业/公司必须重写;删除后,基线与引擎仍能编译、启动;不对外定义任何契约与不变式。
2.2 归属矩阵:什么东西放哪里
资产 | 归属 | 载体 | 发布节奏 |
|---|---|---|---|
会话/流程/A2A/SSE/工具目录等平台能力 | A | 平台基线 jar | 月 |
领域知识(术语/解释/口径) | B | lib/domain领域包 | 客户周期 |
流程定义与配置 | B | lib/domain领域包 | 客户周期 |
SPI 契约(红线接口) | B | lib/domain领域包 | 只增不改 |
业务代码逻辑 | C | lib/biz业务 jar | 天/小时 |
C 私有 LLM 提示词 | C | lib/biz业务 jar | 天/小时 |
部门自助 LIB 包 | C | lib/biz业务 jar | 天/小时 |
宿主参数面(params.env / loader.path / 开关 / 白名单 / 令牌) | 不可改 | 实例启动脚本 | 运维受控 |
一句话:A 持平台,B 持领域,C 持实现;A 永远不持领域,C 永远不定义契约。 这也是能力转移的边界——企业接手体系时,接的正是 B 与 C 这两层"自己的资产"。
2.3 为什么 A 必须不知道 B/C 的存在
从 FDE 交付的视角看,这不是洁癖,而是体系可持续的三个前提:
- 防平台知业务(G1 门禁):业务词表扫描在变更门禁中系统性拦截,任何试图把"报销""凭证"写进 A 层代码的提交直接被拒。平台保持可复用性,企业换供应商、平台升版本都不被业务细节绑架。
- 月级发布的独立性:平台包的发布不受任何业务牵连,业务包的发布不需要平台重测。两者在时间轴上正交——这正是企业技能包能"天/小时级"演化的物理前提。
- 能力视图的干净性:A 看到的永远只是"能力句柄 + 摘要"(由 B 报送),看不到 C 的内部实现名(场景 id、流程 id、SKILL.md 正文),从根上杜绝了业务细节从平台侧泄露。
三、发布体系:loader.path 与三级包——产线的物流系统
FDE 要交付"生产迭代能力",第一件事是把发布本身变成企业可自主操作的常规动作,而不是求助厂商的工程。三级包结构就是这条产线的物流系统。
3.1 三级包结构与热更新
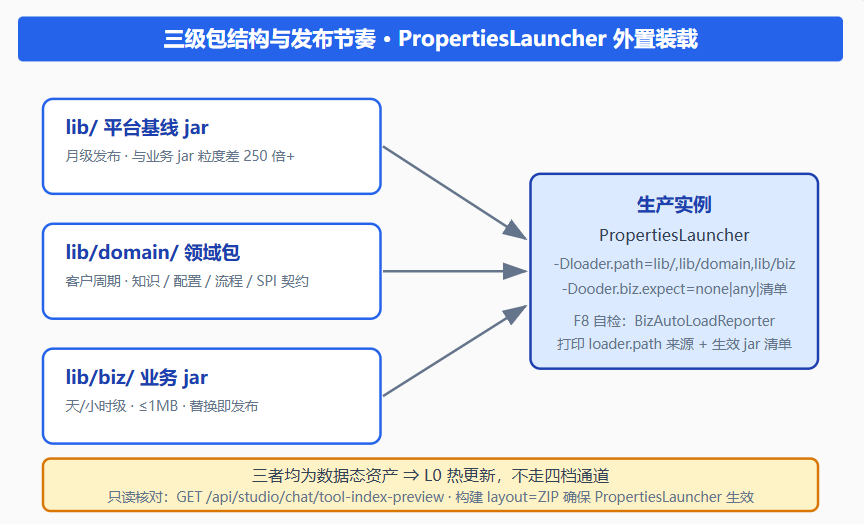
图 2 · loader.path 三级包结构与发布节奏
生产实例统一使用 PropertiesLauncher,业务/领域 jar 外置装载:
# 生产实例启动参数(节选)
-Dloader.path=lib/,lib/domain,lib/biz
-Dooder.biz.expect=none|any|<jar清单> # 期望声明,供 F8 自检核对- 平台基线 jar(lib/):月级发布,与业务 jar 保持 250 倍以上的粒度差异(业务 jar ≤ 1MB)。
- 领域包(lib/domain/):客户周期发布,承载知识/配置/流程。
- 业务包(lib/biz/):天/小时级发布,替换即发布,无需重传平台基线。
三者均为"数据态"资产,统一走 L0 热更新,不占用平台四档发布通道——这是变更节奏分层的物理落地,也是"企业自己能发版"的技术前提。
3.2 F8 自检:装载事实透明化
装载正确性不能靠猜。BizAutoLoadReporter 在启动时打印:
- loader.path 的来源(显式指定 / 环境变量 / 隐式 loader.properties——最容易被忽视的一路);
- 实际生效的业务 jar 清单,并与 -Dooder.biz.expect 期望声明对账。
运行期可用只读端点核对索引:
GET /api/studio/chat/tool-index-preview平台基线构建必须设置 <layout>ZIP</layout>,确保 PropertiesLauncher 生效——这是 A 档构建的硬约束。发布事实透明化,是企业运维团队敢于自主操作的安全网。
四、devAgent:企业第一位"AI 工程师"
FDE 要向企业交付的不是一套开发工具,而是一个新的工程编制:企业自己的 AI 工程师。devAgent(LLM 驱动的开发代理)受聘上岗,而护栏四清单就是它的岗位说明书——企业工程师与 devAgent 协同的人机工程组织,从这里开始运转。
4.1 一句口诀
A 只读;B 加法自由减法禁止;C 可自改但删要授权。
展开成完整职责口径:
层 | 读 | 写 | 删 | 备注 |
|---|---|---|---|---|
A | 只读 | 一律不可改 | 一律不可改 | 基线与元边界护栏(如AgentDevController)、引擎/沙箱本体、桌面客户端均为禁区 |
B·SPI | 可读本域契约 | 只允许新增与增量更新 | 禁止 | 红线契约,保证既有调用方永不被破坏 |
B·知识 | 可读本域知识 | 全量修改权 + 业务解释权 | 禁止删除 | 可新增术语、修订语义、裁定口径,但不得移除既有解释,且须留痕 |
C | 可读本域实现 | 可自改 | 需HUMAN 授权 | 部门自治区 |
宿主参数面 | — | 一律不可改 | — | params.env、loader.path、开关、安全白名单、令牌 |
注意"知识解释权"的设计:B 的知识允许 devAgent 修订语义甚至裁定口径(比如"报销直付的未付口径以 order_date ≤ 当日累积为准"),但只能叠加、不能抹除既有解释——业务知识的演化史本身就是企业的资产。这一条把"AI 改坏企业知识"的风险从制度上清零:知识只会长厚,不会丢失。
4.2 机器可判定的护栏四清单
口诀落到执行层,是四份清单:
{
  "read":        ["lib/domain/fin/**", "lib/biz/**"],
  "allow-add":   ["lib/biz/**", "lib/domain/fin/knowledge/*(add-only)"],
  "allow-modify":["lib/biz/**"],
  "deny-delete": ["lib/domain/**"]
}判定维度全部机器可计算:路径 glob / 包名 / 符号 / 配置键前缀 / 契约坐标。默认拒绝(default deny)——清单之外的任何写操作直接失败,不依赖模型自觉。这份清单随 FDE 一起移交给企业:边界写在配置里,不写在人心里。
4.3 代码修改权限三级
在四清单之上,LLM 可直接编译修改的代码范围再受三级权限控制(agent-dev-scope-policy):
- FREE:可直接编译修改(C 层业务实现主体);
- GUARDED:修改需过门禁复核(B 层知识/SPI 增量);
- DENY:完全禁区(A 层全部、devAgent 自身护栏、沙箱本体、宿主参数面)。
4.4 七道变更门禁
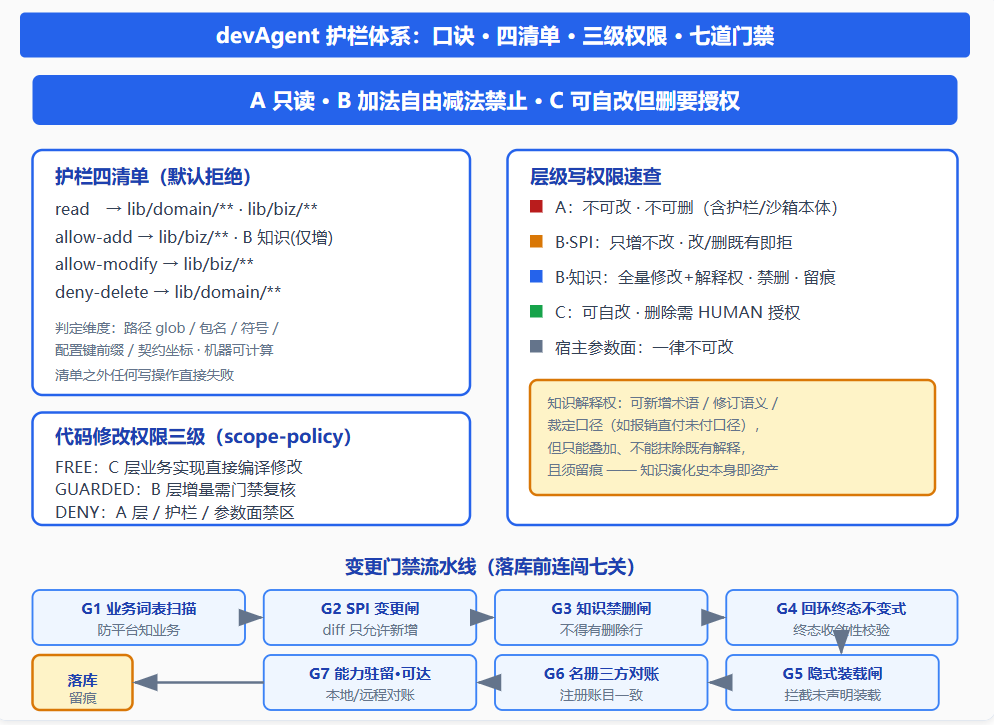
图 3 · devAgent 护栏体系:口诀 · 四清单 · 三级权限 · 七道门禁
devAgent 的每次变更,在落库前要连闯七道机器门禁:
门 | 名称 | 拦什么 |
|---|---|---|
G1 | 业务词表扫描 | 防平台知业务——A 层出现业务词汇直接拒绝 |
G2 | SPI 变更闸 | SPI diff 只允许新增,改/删既有即拒 |
G3 | 知识禁删闸 | 知识文件的 diff 不得出现删除行 |
G4 | 回环终态不变式 | 流程变更不得破坏回环终态收敛性 |
G5 | 隐式装载闸 | 拦截未声明的隐式 jar 装载 |
G6 | 名册三方对账 | agentId / 能力注册三方一致 |
G7 | 能力驻留·可达对账 | 本地驻留能力与远程可达能力账目一致 |
护栏的意义在于:devAgent 的自由度不需要被讨论,只需要被清单化。清单之内全速前进,清单之外寸步难行。企业不必"信任 AI",只需信任这套机器闸门——这正是企业敢把 devAgent 纳入自己工程编制的底气。
五、调用路线:企业 AI 的神经系统
5.1 A→B→C:唯一通路
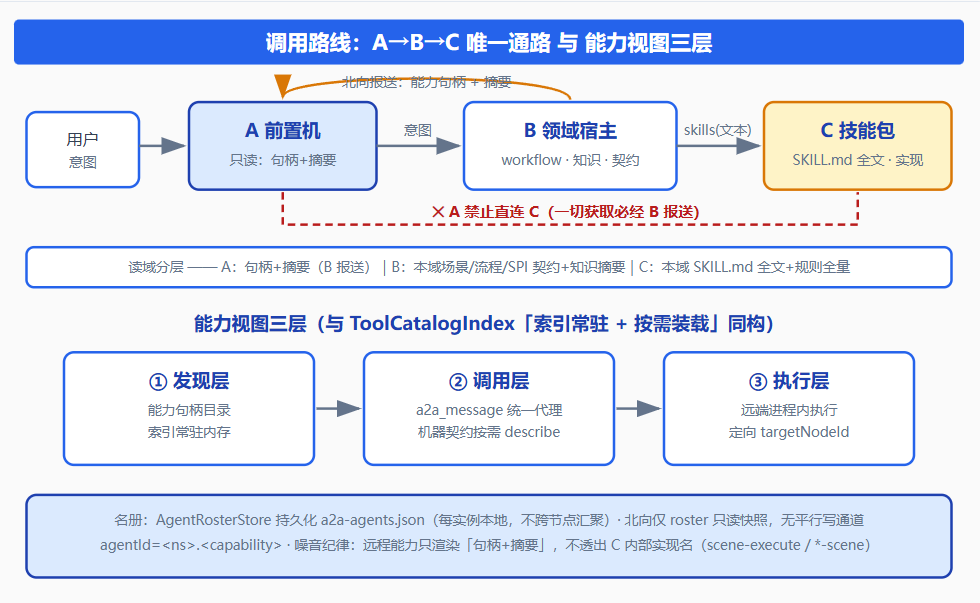
图 4 · A→B→C 调用路线与能力视图三层
用户意图在体系中的流转只有一条合法通路:
A --(意图)--> B --(workflow)--> skills(文本) --> CA 禁止直连 C。 A 的一切获取(能力、知识摘要、流程句柄)都必须经 B 报送(北向协议)。这条单向通路带来三个保证:
- 解耦:A 换版本不影响 B/C,C 重写不影响 A——企业技能包的演化不牵动基础设施;
- 审计:所有跨界流量都过 B 的 workflow,天然留痕——企业 AI 的每一次能力调用可追溯;
- 权限:A 拿不到 C 的内部实现名,泄露面最小化——企业的业务 Know-how 留在企业侧。
5.2 读域分层:谁能看到什么
主体 | 可读内容 | 明确不可读 |
|---|---|---|
A | 能力句柄 + 摘要(B 报送) | C 的内部实现名(场景/流程 id)、业务规则明细、SKILL.md 正文 |
B | 本域场景/流程/SPI 契约 + 知识摘要 | — |
C | 本域 SKILL.md 全文 + 规则全量 | — |
5.3 能力视图三层
与既有 ToolCatalogIndex「索引常驻 + 按需装载」同构,能力视图分三层:
- 发现层:能力句柄目录,索引常驻内存,开销极低;
- 调用层:a2a_message 统一代理 + 按需 describe(机器可读契约不进常驻索引);
- 执行层:远端进程内执行。
5.4 名册与噪音纪律
- AgentRosterStore 持久化 {studio.instance.data.dir}/a2a-agents.json,每实例本地,不跨节点汇聚;
- 北向仅开放 GET /api/studio/a2a/roster 本机只读快照,不开平行 HTTP 写通道;
- agentId = <namespace>.<capability>(如 fin.voucher-fill);
- 噪音纪律:远程能力段只渲染"句柄 + 摘要",绝不透出 C 的内部实现名(scene-execute、*-scene 之类);机器可读契约走按需 describe,不进常驻索引。
这套纪律保证了:无论企业能力目录膨胀到多大,用户面与模型上下文里的信息密度恒定可控——体系不会因为长大而变吵。
六、C 端技能包开发闭环——企业自己的生产线(核心)
前五章是"地基与规矩",本章是 FDE 要交付的核心资产:一条建在企业内部、由企业自己驱动的技能包生产线。FDE 交付的不是这条线上的某个产品,而是这条线本身。
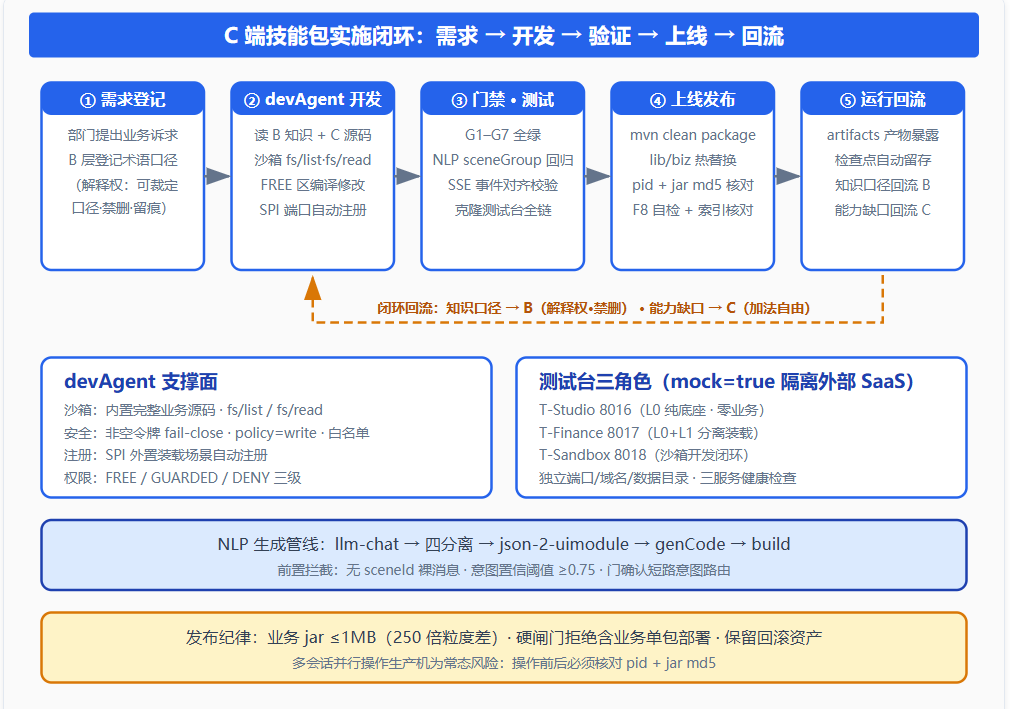
图 5 · C 端技能包实施闭环总图
闭环五阶段:需求登记 → devAgent 开发(读 B 改 C)→ 门禁与测试 → 上线发布 → 运行回流。产线跑通之后,"生产者"从 FDE 换成企业自己的人 + 企业自己的 devAgent;FDE 从生产者退位为教练。
6.1 阶段一:devAgent 开发——读 B 改 C
开发环境的三个支柱:
- 沙箱即工作台:沙箱内置完整业务源码,devAgent 通过 fs/list、fs/read 接口访问,支持真实的开发闭环(不是看片段,而是读全库)。企业的 AI 工程师一上岗就拥有企业全部业务上下文。
- 沙箱安全三件套:非空令牌鉴权(X-Sandbox-Token / Bearer,未配置时 fail-close);ooder.sandbox.policy.level=write 限制 LLM 工具调用风险等级;workspace-root 文件访问白名单禁止越界。
- 知识即上下文:devAgent 对 B 的知识开放——可读领域知识/配置/流程以支撑改 C。这正是"知识归 B"架构约定的直接红利:devAgent 改一个财务技能包时,能读到的是经过治理的领域口径,而非散落的聊天记录。
SPI 注册是技能包的出生证明:业务 jar 必须实现 FinanceAgentSpecPort 一类的 SPI 端口接口,外置装载时场景自动注册——不需要在任何配置文件里手工登记场景,装载即注册,卸载即注销。企业新增一个技能,不需要"求平台",只需要"符合契约"。
6.2 阶段二:NLP 开发——从一句话到可用界面
图 6 · NLP 四级意图分发与生成管线
C 端技能包的界面与交互由 NLP 生成管线生产——这是产线上的"自动化机床":
第一步:NlpModule Meta 知识图谱。 LLM 通过模块元信息知识图谱确定性理解模块结构、元数据层级、组件关系——不靠猜,靠图。
第二步:四级意图分发闭环。
- 意图分类路由:无 sceneId 的裸消息在 SwitchSceneFlowTool 前拦截;带附件路径的意图匹配设置置信阈值(≥0.75)防低置信误切场景;门确认操作短路意图路由,避免选项文本触发 LLM 误匹配新流程。
- 当前界面组件插入:识别当前界面上下文,组件级插入。
- 单页程序创建:一句话生成单页应用骨架。
- CRUD 系统构建 / BPM 节点添加:完整业务系统与流程节点扩展。
第三步:生成管线。
llm-chat → 四分离 → json-2-uimodule → genCode → build- llm-chat:对话式需求澄清;
- 四分离:结构/样式/逻辑/数据四分离的中间表示;
- json-2-uimodule:虚拟 DOM 模型转 ooderA2UI 组件;
- genCode:代码生成;
- build:编译构建,产物直接可装载。
配合 llm-css-renderer(基于虚拟 DOM 模型感知的智能 CSS 渲染),界面产出的视觉质量可持续迭代。这条管线的意义在于:企业里提需求的业务人员,与最终可用界面之间,不再隔着完整的前后端工程团队——产线把工程复杂度封装在了管线里。
6.3 阶段三:测试——三重验证
质量体系是产线的质检环节,FDE 把它连同工具一起移交给企业:
第一重:NLP closed-loop harness。 以 sceneGroup 机制组织场景测试集,经 Trae hooks 集成驱动 llm-chat → 四分离 → json-2-uimodule → genCode → build 全链回归——测的不是"代码对不对",而是"从用户的一句话开始,整条生成链是否还收敛"。
第二重:SSE 事件校验(sse-harness)。 校验后端推送事件与前端消费的对齐完整性:事件名对齐、payload 形态一致、订阅通道正确。实践中沉淀的硬规则包括:
- a2a_message / a2a_failed 必须经 SseEventPushService.broadcastToConversation 透传事件名;
- 实时渲染路径与回读路径的入参形态必须一致,否则"数据到达但 UI 不渲染";
- 门交互组件必须经 flow 通道订阅,保证刷新后回读可见;
- 工具输出必须经后端 userFacingToolResult 抽取人话,前端以 looksLikeStructural 兜底过滤结构化直出。
第三重:克隆测试台全链验证。 测试台完整克隆生产分离模型的三角色拓扑:
测试台角色 | 端口 | 档位 | 验证目标 |
|---|---|---|---|
T-Studio | 8016 | L0 | 纯底座、零业务 |
T-Finance | 8017 | L0+L1 | 领域宿主 + 业务分离装载 |
T-Sandbox | 8018 | — | devAgent 沙箱开发闭环 |
测试环境使用独立端口、域名(tstudio.ai / tfinance.ai / tsandbox.ai)与数据目录,mock=true 隔离生产外部依赖(有成、钉钉等 SaaS),并有三服务(aiserver / studio / ooder-test)健康检查兜底。企业从此可以在自己的"克隆体"上放心演练,不碰生产。
6.4 阶段四:上线——小时级发布
# 1. 构建(clean 避免陈旧内部类残留导致类版本偏移)
mvn -pl ooder-biz-finance,ooder-biz-patent clean package

# 2. 上传业务 jar 到 lib/biz/(按名解析产物,正则 ^Studio(New)?jar$ 防硬编码失效)

# 3. 重启实例(启动脚本注入系统令牌 -Dooder.bpm.system.token=...)

# 4. F8 自检 + 索引核对
GET /api/studio/chat/tool-index-preview
发布纪律:
- 业务 jar ≤ 1MB,与平台基线保持 250 倍粒度差异——替换 lib/biz/ 即发布,平台基线 jar 零传输;
- 部署脚本内置硬闸门:非 -Rollback 参数一律拒绝运行含业务的单包部署(studio-biz profile 已删除,杜绝业务混入基线的"单包"倒退);
- 发布前必须核对 pid + jar md5——多会话并行操作同一生产机是常态风险,勿假设实例状态未变;
- 保留回滚资产:jar 备份 + 启动脚本备份,回滚以分钟计。
这套流程没有一步需要原厂参与——企业运维团队照着清单就能完成一次完整发布,这是"生产迭代能力"最直接的体现。
6.5 阶段五:运行回流
上线不是终点——回流机制让产线具有自我改进能力:
- 检查点在 flow_paused / complete 终态自动触发,状态快照持久化;
- 产物体系按活动声明的 producedOutputs 通用生成 .md + .json 产物,推 flow_artifact 事件,经 GET /api/studio/chat/artifacts 统一暴露(支持下载/编辑);
- 运行中发现的知识口径偏差,回流到 B 层知识修订(解释权),发现的能力缺口回流到 C 层新增(加法自由)——闭环由此滚动,企业的 AI 体系在使用中越长越准。
七、运行时支撑:让体系持续滚动
闭环之上的运行时,有三套纪律值得单独一节。它们是体系"7×24 自转"的保障。
7.1 A2A 消息纪律
- 状态机:出站 SENT → LOCAL_CONSUMED | PUBLISHED | UNDELIVERABLE | FAILED;入站 direction=RECV, status=RECV;
- 工具面:LLM 工具 a2a_message 支持 query / send / handoff 三动作,query 超时返回 {status:"async"} 不阻塞会话;
- 持久化权威:以协议侧 a2a_message 表为权威,会话侧仅存 a2aMessageId 引用及不可变字段;
- 定向投递:跨实例定向消息必须指定 targetNodeId,仅目标节点订阅 ooder/node/{nodeId}/inbox;执行端以 handledLocally 标志防重复消费。
7.2 流程韧性纪律
- 拓扑回环闸:引擎以拓扑事实(_visitedActivities 已执行集合)而非作者声明的 direction 判定回环性——FORWARD 边目标已执行且非 HUMAN/END 即自动重入;同一条边同一纪元内只允许 1 次自动重入,第 2 次 = 确定性死循环 → 实例 FAILED + 单行 ERROR(fail-fast)。这套闸门系统性兜住了九处流程定义中误声明为 FORWARD 的双向边,无需逐条重定义;
- 质检门一次性化:同一失败期只回退一次,防重复回退引发振荡;
- 路由熔断:形状无关的单实例路由总预算(>200 跳即置 FAILED + ERROR 带轨迹),防交替环引发日志风暴。
7.3 用户体验纪律
- SSE 事件直出的必须是人话:flow_tool_output 经 buildToolSubtitle 抽取可读文本;complete/flow_route 剥离冗余字段;flow_paused_summary 状态字段修正为 paused;
- 前端 looksLikeStructural 兜底过滤未处理的结构化数据;
- 会话列表按 COALESCE(NULLIF(last_msg_at,0),updated_at) DESC 排序,最新会话优先。
八、一次完整的 FDE 交付走查
以"财务报销直付"技能包为例,把整条产线走一遍——这也是 FDE 在企业现场的标准工作方式:
- 需求登记:财务部门提出"报销单自动对账 + 直付进度查询"。
- 知识先行(B 层):领域包登记术语与口径——"报销直付的未付口径以 order_date <= 当日 累积计算,历史未支付单据必须可见"。devAgent 拥有解释权,可裁定口径,但只能叠加不能删改既有解释。
- devAgent 开发(C 层):沙箱内读 B 知识 + C 现有源码,新增技能包实现(FREE 区),实现 FinanceAgentSpecPort SPI 注册,编译通过。
- 门禁全绿:G1 词表扫描通过(平台层零业务泄漏);G2 SPI diff 只增;G3 知识 diff 无删除行;G4–G7 对账一致。
- NLP 管线:意图注册 → 四级分发挂接 → llm-chat 生成查询界面 → json-2-uimodule → genCode → build。
- 三重测试:sceneGroup 场景回归;SSE 事件对齐(flow_tool_output 人话化、flow_paused_summary.status=paused);克隆测试台 8016/8017/8018 全链验证(mock=true)。
- 上线:mvn clean package → lib/biz/ 热替换 → 重启 → F8 自检确认装载 → tool-index-preview 核对索引。全程平台基线零改动,从构建到可用以小时计。
- 运行回流:流程产物经 flow_artifact 事件 + artifacts 接口暴露;下载链接按当前流程实例 pid 现算;检查点自动留存;运行期发现"直付进度需要显式刷新意图"——回流为 C 层新增(显式刷新旁路同步接口,不受流程节点状态限制)。
走完这一遍,真正的问题不是"技能包上线了没有",而是:这一次交付,给企业留下了什么?
FDE 离场清单:交付结束时企业手上的资产
# | 资产 | 内容 | 企业自主操作点 |
|---|---|---|---|
1 | A 底座 | 平台基线(会话/流程/A2A/SSE/工具目录)+ 月级发布通道 | 版本升级即换包,业务零牵连 |
2 | B 知识资产 | 术语/口径/流程定义/SPI 契约(禁删、留痕、可解释) | 全量修改 + 解释权,越用越准 |
3 | C 生产线 | SPI 注册 + NLP 生成管线 + build 产物线 | 天/小时级自主发版 |
4 | AI 工程编制 | devAgent + 四清单 + 三级权限 + G1–G7 门禁 | 人机协同开发,边界机器可判 |
5 | 质量体系 | sceneGroup 回归 + SSE 校验 + 克隆测试台(8016/8017/8018) | 上线前全链演练,不碰生产 |
6 | 发布纪律 | 硬闸门 + pid/md5 核对 + 回滚资产 | 运维自主操作,分钟级回滚 |
7 | 运行时韧性 | A2A 状态机 + 拓扑回环闸 + 检查点 + 产物体系 | 7×24 自转,异常 fail-fast |
对照这份清单可以看出 FDE 两层工作方式的差别:L1 型 FDE 交付清单里只有第 1 行和几个技能包;成熟的 FDE 交付全部 7 行。 技能包只是产线运转的证明,产线本身才是交付物。
九、结语:从交付技能包到交付生产能力
企业 AI 落地存在一条清晰的能力阶梯:
- L1 · 把 AI 带入企业:接入模型、交付几个可用的技能包和应用——解决"有没有";
- L2 · 为企业构建 AI 体系:A/B/C 三级架构落地,知识资产归位、发布体系建成、调用通路定型——解决"成不成体系";
- L3 · 交付 AI 生产迭代能力:devAgent 入编、NLP 产线运转、测试与发布纪律移交——企业自己能持续生产、持续演化——解决"能不能自我进化"。
A/B/C 三级架构支撑这条阶梯的本质,是一套三线并行的治理结构:
- 变更节奏线:月 / 客户周期 / 天·小时,由 lib/ / lib/domain/ / lib/biz/ 物理隔离,L0 热更新承载;
- 知识归属线:知识/配置/流程归 B,实现归 C,A 永远零业务,由北向报送协议与 G1 门禁保证;
- 权限边界线:devAgent 的每一个写操作,都在四清单 + 三级权限 + 七道门禁的机器可判定约束之下。
而 C 端技能包的开发闭环——devAgent 读 B 改 C、NLP 四级分发生成、三重测试验证、小时级发布上线、运行回流演进——是这条治理结构上生长出的生产线。护栏越硬,自由度越可以被放心地放大;分层越清,产线滚动得越快;产线越稳,企业离"AI 自我进化"越近。
A 只读,B 加法自由减法禁止,C 可自改但删要授权——护栏之内,全速前进。
对 FDE 而言,这句话还有后半段:把护栏连同产线一起移交给企业,然后离场。企业手里剩下的,是一条会自己生长的 AI 体系——这才是 FDE 的真正交付物。
本文基于 Ooder 企业 Agent 实施体系的 FDE 落地实践整理,相关约定以领域归属口径(A 只读 / B 只增 / C 授权删)与 G1–G7 门禁清单为准绳,随体系演进而更新。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号