Laya 底层架构:33 毫秒做决策的双向编码器是怎么炼成的
原创
Laya 底层架构:33 毫秒做决策的双向编码器是怎么炼成的
原创
老周聊架构
发布于 2026-10-04 16:35:26
发布于 2026-10-04 16:35:26
当整个行业都在卷生成模型谁能聊得更像人,Laya 选了一条更工程化的岔路。它不是一个会写诗会编代码的大模型,而是一个基于 ModernBERT 双向编码器的决策引擎,明确不做文本生成,只做判断。输入一段状态加一组类型化问题,一次前向约 33 毫秒就吐出带校准概率的结构化结果,支持 100 多种语言,本地部署免费。据 Laya 官方给出的对比,它在准确率(76.6% 对 72.7%)和多语言覆盖上还压了闭源的 Jev 一头。本文我从架构师视角把它的五个底层机制拆开讲透,顺手算一笔账,看看它快、准、便宜的真正来源是什么,又有哪些坑是置信度自己填不平的。
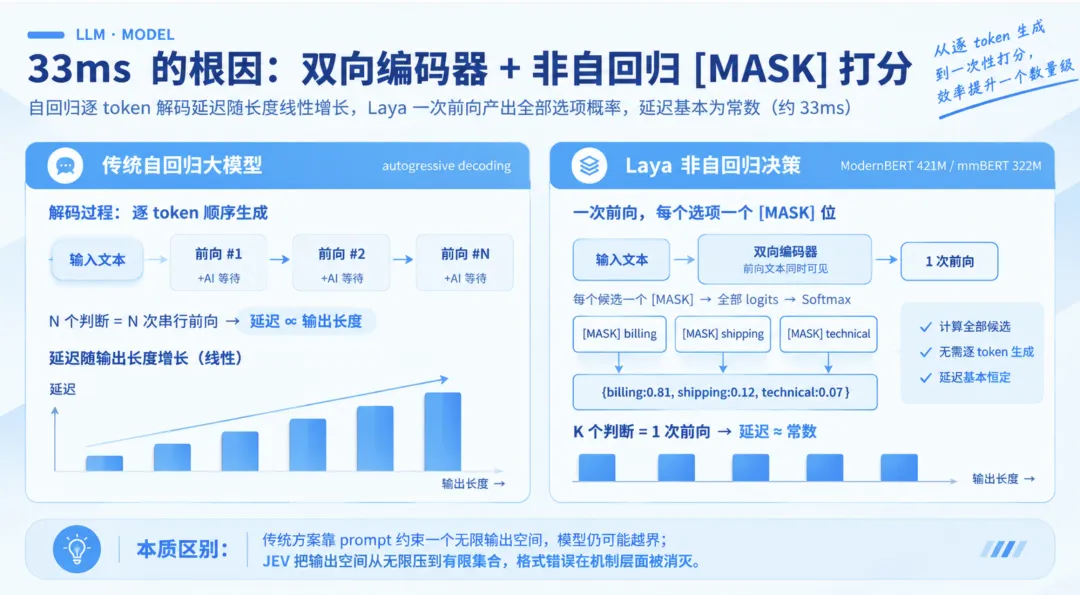
本质一:33 毫秒的根因是双向编码器加非自回归 MASK 打分,不是堆算力
先说清楚一个被很多人搞反的因果。大家习惯把"模型快"等同于"模型小"或者"卡多",但 Laya 这个案例最值得记的不是参数量,而是范式。它背后是 ModernBERT-large(421M)或 mmBERT-base(322M)这样的 bidirectional encoder,输入 token 同时看见前后文,推理时压根不逐字生成文本。
关键动作在这里。Laya 把一次决策建模成:为每一个候选选项分配一个独立的 MASK 位,然后只做一次前向,把所有选项的 logits 一次性算出来,再用 Softmax 归一化成概率分布。对比自回归大模型,后者每多输出一个 token 就要再做一次前向,等上一次的结果才能预测下一个,序列上的 KV cache 依赖让解码天然没法并行,延迟随输出长度线性往上爬。
把"生成"替换成"为每个候选选项放一个独立的 MASK 位、一次前向拿全部 logits",Laya 绕开了自回归解码的串行瓶颈,延迟基本是常数级的。
这背后没有魔法,就是机制红利。421M 的参数量放进生成模型里不算大,但因为它不生成,根本不存在"第 N 个判断等第 N-1 个"那种锁。我的看法是,工程师评估这类模型时别老盯着参数量和算力,要先问一句:它是不是在串行地吐 token。只要还在逐 token 解码,再小的模型在长输出上也快不起来;只要改成一次前向拿全部判断,中等体量也能做到 33 毫秒这种量级。
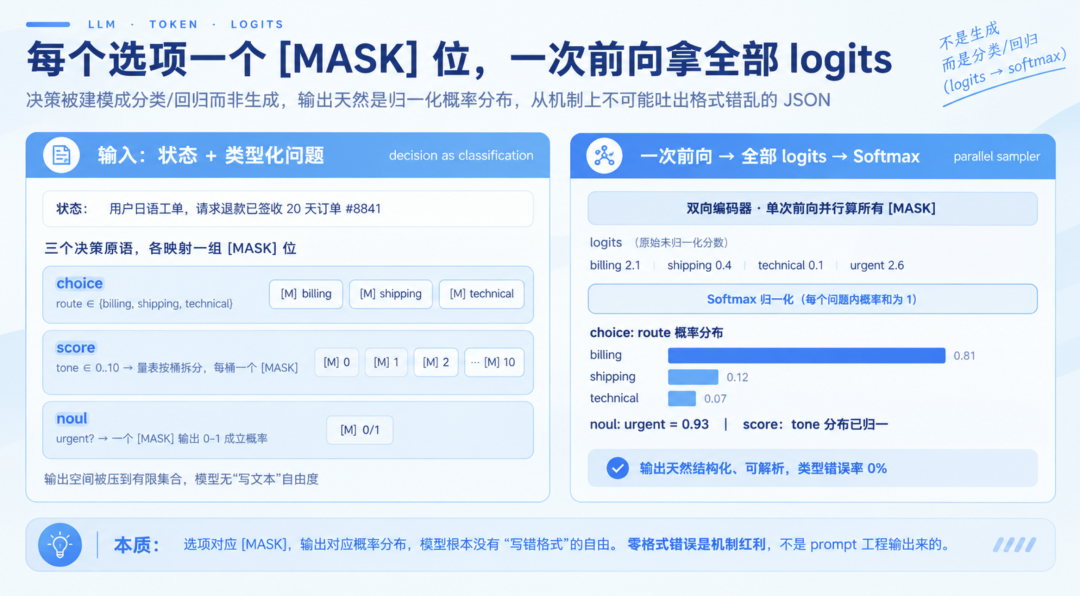
本质二:零格式错误来自把决策变成分类与回归,而不是生成
很多团队用通用大模型做分类、做路由,然后靠 JSON mode 或者 function calling 把结果接出来。这条路在工程上一直脆。模型高兴了给你多写一句"这是我的判断",不高兴在 JSON 里留个尾逗号,再或者把 medium 拼成 meduim,类型直接飘了。你用正则兜底,正则又兜底不全,于是解析失败、重试、降级人工,链路越接越长。
Laya 的解法不是"求模型老实点",而是在机制层面让不老实不可能发生。它把输出空间从"无限可能的自然语言"砍成了"有限集合里的一个选择"。三种决策原语把这件事说得很干净。
- choice 从一组候选项里选一个,并给每个选项一个概率,比如 route 在 billing、shipping、technical 之间分配。
- score 在一个有序量表上打分给分布,比如把情绪强度拆成 0 到 10 的每个桶各给概率。
- noul 回答是非问题,直接返回 0 到 1 的成立概率,比如"这笔工单是否紧急"。
当输出空间本身就是一个有限集合,格式幻觉在机制层面就不可能发生,从根上消灭了类型错误,模型根本没有"写错格式"的自由。
我为什么强调这一点?因为对上游系统来说,可解析性不是锦上添花,是能不能自动化的前提。传统 LLM 即便开了 JSON mode,产出的仍是"看起来像结构化的自由文本",它随时可能越界;Laya 产出的是"天生就是结构化、天生可解析"的概率,每个选项对应一个 MASK,输出天然是归一化的分布。这不是靠 prompt 工程磕出来的稳健,是机制层面的零格式错误。
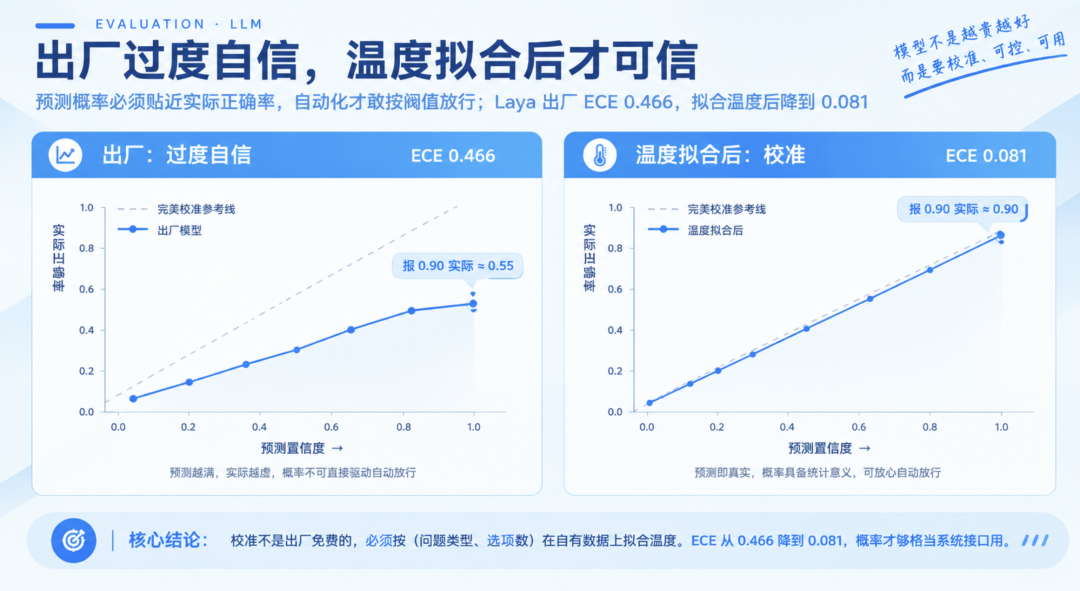
本质三:校准才是自动化的前提,而校准不是出厂就免费送的
一个不准的置信度,比没有置信度更危险。为什么?因为自动化的核心动作就是按阈值替人做决定:大于 0.9 自动执行、0.7 到 0.9 交大模型复核、小于 0.7 转人工。如果模型报 90% 把握,实际只有 55% 真的对,这条规则会系统性地、安静地持续误判,而且你很难发现,它不会抛异常,只会让你月底看指标时一头雾水。
这里要讲清 ECE 这个概念。ECE 是 Expected Calibration Error,预期校准误差,衡量的是"模型报的概率"和"真实正确率"之间的平均偏离,越低越好。校准好的模型,报 90% 的那批任务里大约 90% 真的正确,报 70% 的那批大约 70% 正确,预测概率和真实正确率是对得上的。
出厂 ECE 0.466 意味着模型报 90% 时实际远不到 90%,这种概率不能直接驱动自动放行;必须按(问题类型、选项数)在自有数据上拟合温度,把 ECE 压到 0.081 后,概率才算具备统计意义,才敢拿去做阈值路由。
这事儿最容易被忽视的地方在于,校准不是模型出厂就附赠的。Laya 的出厂 checkpoint 是过度自信的,平均 ECE 高达 0.466,也就是说它对自己的错误非常笃定。要可用,你得在部署阶段按"这个问题是 choice 还是 noul、有几个选项"在自家数据上做温度拟合,把 ECE 从 0.466 降到 0.081。拟合完之后,">0.9 自动执行"这条规则才真正值得信任。我见过太多团队直接把大模型自评的"我觉得把握 90%"当阈值用,那置信度根本没校准过,自动化规则就会安静地持续犯大错,比纯人工还坑。
下面这段是 Laya 的通用调用范式(示意),注意温度拟合这一步是部署时就该做的,它决定了后面阈值路由能不能信:
# 示意:Laya 非自回归决策模型调用范式(基于公开接口形态,示意代码)
from laya import LayaModel

# 1. 加载双向编码器 checkpoint
#    ModernBERT-large 421M 或 mmBERT-base 322M,均为 bidirectional encoder
model = LayaModel.from_pretrained("laya-modernbert-large")

# 2. 部署时按(问题类型, 选项数)在自有数据上拟合温度
#    出厂 ECE 0.466 过度自信,拟合后降到 0.081,概率才可直接驱动自动放行
model.calibrate(temperature_grid="auto")   # 示意:温度拟合

# 3. 一段状态 + 一组类型化问题
state = "工单:用户用日语请求退还已签收 20 天的订单 #8841。"
questions = {
    "route":  model.choice(["billing", "shipping", "technical"]),
    "tone":   model.score(0, 10),     # 有序量表打分给分布
    "urgent": model.noul(),           # 是非题,返回 0-1 成立概率
}

# 4. Router 在 forward 之前检测语言(<0.5ms),自动选英文/多语言 checkpoint
#    一次前向 ~33ms,直接拿全部选项的归一化概率
out = model.decide(state, questions)

# 5. 温度拟合后的校准概率用于阈值路由
if out["urgent"].prob >= 0.90:        # 高置信:自动放行
    auto_escalate()
elif out["route"].best_conf() >= 0.70:  # 中置信:按类别分流
    dispatch(out["route"].best())
else:                                 # 低置信:转人工
    route_to_human()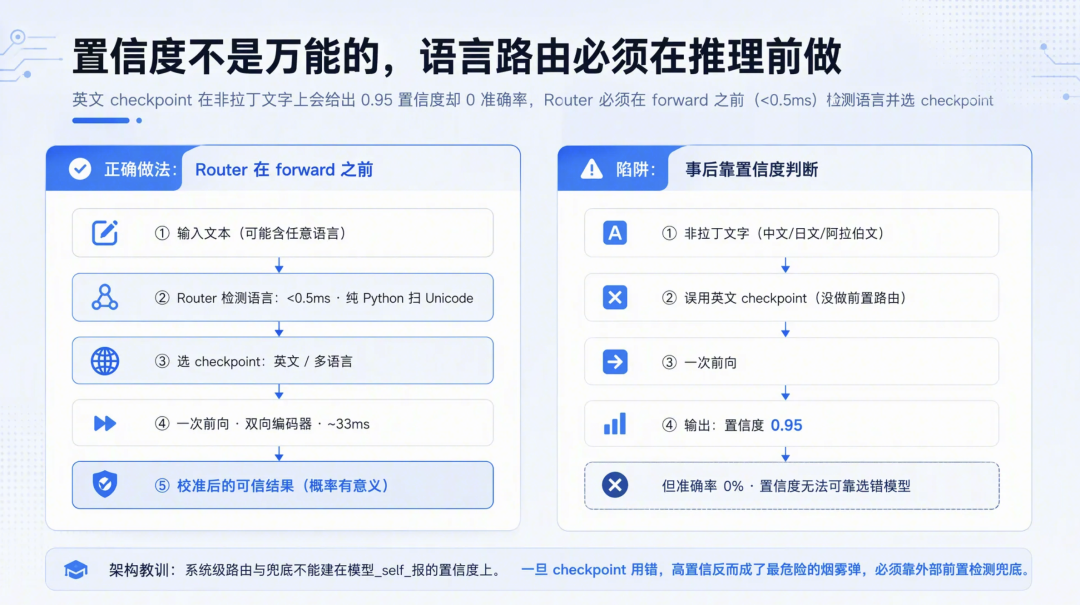
本质四:置信度不是万能的,语言路由必须在推理之前做
这一节是我最想让做系统的人记住的架构教训。Laya 内置了语言路由,Router 在 0.5 毫秒以内检测输入语言,自动分发到英文或多语言 checkpoint。为什么这个检测必须放在 forward 之前,而不是等模型输出后看概率再决定?因为这儿有个反直觉的坑。
英文 checkpoint 跑在非拉丁文字(比如中文、日文、阿拉伯文)上时,会给出 0.95 的置信度,但准确率其实是 0。也就是说,模型对自己的错误非常自信。如果你试图靠"事后看模型报的置信度高不高"来发现"我是不是选错了模型",你会发现自己根本发现不了,因为置信度本身就是错的、还高得吓人。
英文 checkpoint 在非拉丁文字上会"0.95 置信度 + 0 准确率"地坑你,而置信度自己不会预警这种选错模型的情况,所以路由必须在 forward 之前用外部检测完成,不能依赖模型self报的概率。
我的看法是,这事儿折射出一个很通用的工程真相:系统级的兜底和路由,不能建在模型自称的置信度上。置信度只有在"模型本身没选错"的前提下才有意义,一旦 checkpoint 用错了,置信度反而会变成最危险的烟雾弹。路由、降级、兜底这些动作,必须靠模型之外的、确定性的前置检测来兜底,比如纯 Python 扫一遍 Unicode 字符集判断语言,几百微秒搞定,然后才把请求送进对应的 checkpoint。把这种决策推给模型自己,是架构上的偷懒。
本质五:RLCD 用严格真评分规则逼出诚实概率,专治盲目自信
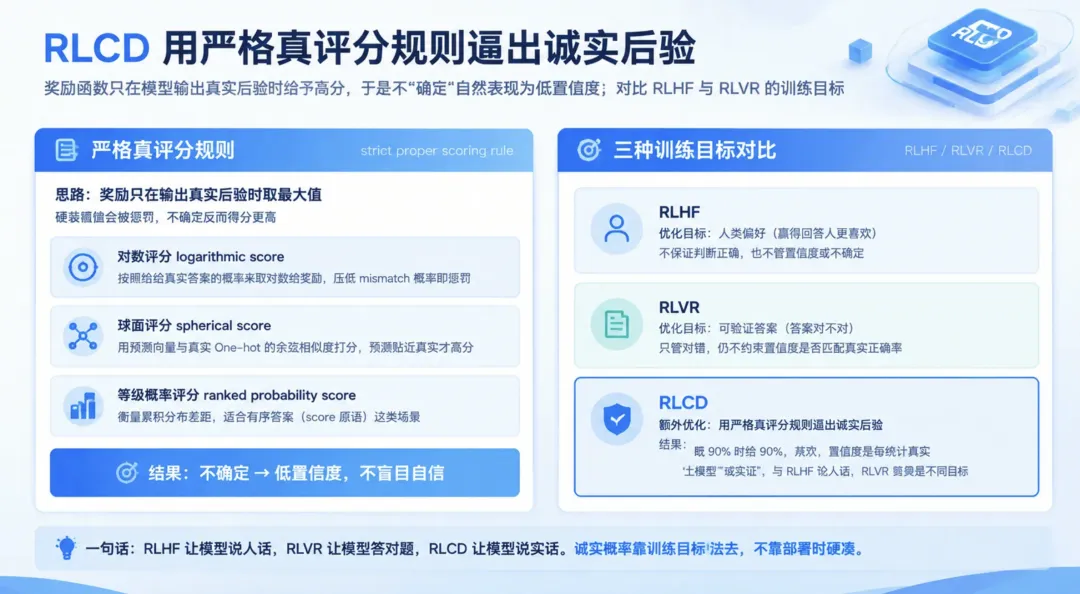
传统大模型最容易被诟病的一点就是"瞎自信",明明答错了还给你写得理直气壮。Laya 用来治这个毛病的是 RLCD 训练,核心思想是一个叫 strict proper scoring rule(严格真评分规则)的东西。
说人话。严格真评分规则是一类奖励函数,它的脾气很怪:模型只有在输出"真实后验概率"的时候,才能拿到最高的期望奖励。换言之,你不确定就是不确定,硬装确信反而会丢分。这跟我们前面说的校准是一脉相承的,RLCD 就是把"概率要诚实"直接写进了训练目标里。
- 对数评分(logarithmic score) 按模型给真实答案的概率取对数给奖励,把概率压低到不匹配真实分布就会被惩罚。
- 球面评分(spherical score) 用预测向量和真实 One-hot 向量的余弦相似度打分,同样只在预测贴近真实时高分。
- 等级概率评分(ranked probability score) 衡量累积分布和真实累积分布的差距,适合有序量表这类场景。
strict proper scoring rule 的巧妙之处在于,奖励函数只有在模型输出真实后验时才给高分,于是"不确定"会自然表现为低置信度,而不是盲目自信。
把这件事放到更大的版图里看更清楚。RLHF 优化的是人类偏好,哪种回答人更喜欢;RLVR 优化的是可验证答案,答案对不对。它们都不保证模型说自己有几分把握时是诚实的。RLCD 在这一层之上额外优化了"置信度是否匹配真实正确率",所以 Laya 才能在训练目标层面逼出校准过的概率,而不用全靠部署时的温度拟合来补。一个对比的角度是:RLHF 让模型"说人话",RLVR 让模型"答对题",RLCD 让模型"说实话"——这三件事其实是三件不同的事。
反模式:用通用大模型硬做路由,或者把出厂概率当圣旨
讲完机制,说三个我在生产里真见过的反模式,每一个都对应前面某一节的坑。
- 用通用大模型加 JSON 解析硬做路由和分类。 一个退款风险分类,你调一次前沿大模型,单次成本比这类专用模型高出一个数量级,延迟从几百毫秒变成几秒,而且输出还得自己解析。模型偶尔输出脏 JSON,解析挂了就重试,重试又烧钱又加延迟,高频场景下这套链路直接崩。
- 以为模型报的置信度都可信。 给大模型套个"我觉得把握 90%"的自评,然后大于 0.9 自动执行。问题是这置信度根本没校准过,模型报 90% 实际可能只有一半对,自动化规则安静地持续犯大错,比纯人工还坑,而且不抛异常你很难察觉。
- 忽视校准直接拿出厂概率驱动自动决策。 像 Laya 这种模型出厂 ECE 0.466 是过度自信的,你若不拟合温度就直接拿概率去路由,等于在"报 90% 实际远不到"的分布上做决策,风险被藏在水面下。
下面这段就是用通用 LLM 加 JSON 解析做同样路由的脆弱写法,注意那个正则兜底有多容易破,以及字段一旦拼错就直接 unknown:
# 反例:用通用大模型 + JSON 解析做同样决策(脆弱写法,示意)
import openai, json, re

def decide_by_llm(text: str):
    prompt = (
        '把下面工单分类为 billing/shipping/technical,并判断紧急与否,'
        '用 JSON 返回,如 {"route":"billing","urgent":true}。\n' + text
    )
    raw = openai.ChatCompletion.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
    )["choices"][0]["message"]["content"]

    # 脆弱点 1:模型偶尔把 JSON 包进 ```代码块或补一句废话
    # 脆弱点 2:字段拼错(True 不符合 JSON 规范)、尾逗号非法、选项拼错
    try:
        obj = json.loads(re.search(r"\{.*\}", raw, re.DOTALL).group(0))
        return obj["route"], obj.get("urgent", False)
    except Exception:
        # 解析失败 -> 重试或降级人工,成本和延迟都炸
        return None, None
对比 Laya 那条链路:Schema 锁死、输出天生可解析、置信度经过校准且路由在推理前完成。同样一件事,一个在机制上就稳,一个得靠正则和运气续命。我的判断是,凡是高频、结构化、要自动化的小判断,都不该丢给会生成文本的通用大模型,把它们交给 Laya 这类非自回归决策模型,才是把成本、延迟和可靠性同时按住的正解。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号