从一句话需求到小时级上线:ooderAgent 技能包工具集实战
原创
从一句话需求到小时级上线:ooderAgent 技能包工具集实战
原创
OneCode
发布于 2026-10-06 11:22:37
发布于 2026-10-06 11:22:37
摘要:本文是《FDE 的真正交付物:A/B/C 三级服务架构与技能包生产闭环》的实战续篇。上一篇讲清了体系蓝图——A 级平台底座、B 级领域知识资产、C 级部门自助技能包;这一篇深入 C 端生产线本身,把 ooderAgent 技能包工具集摊开在桌面上:NLP 字典如何让机器听懂企业的话,流程定义如何把对话编排成带审批门的业务闭环,工程工作台如何提供真实的代码修改武器,沙箱测试与发布链如何把变更小时级送上生产。全程以财务域九流程——报销审批、资金日报、报销直付、业财对账、往来管家、税务雷达、凭证引擎——为贯穿实例,配以薄壳实机截图。读完全文你会看到:一条"一句话需求 → NLP 生成 → 流程绑定 → 代码修改 → 沙箱测试 → 小时级发布"的完整生产线,如何在企业自己的工程师手里转起来。
背景工具地图NLP 字典流程代码修改测试与发布完整走查结语
一、背景:A/B/C 三级架构下的 C 端生产线
先快速回收前作的结论(详见《FDE 的真正交付物》一文):
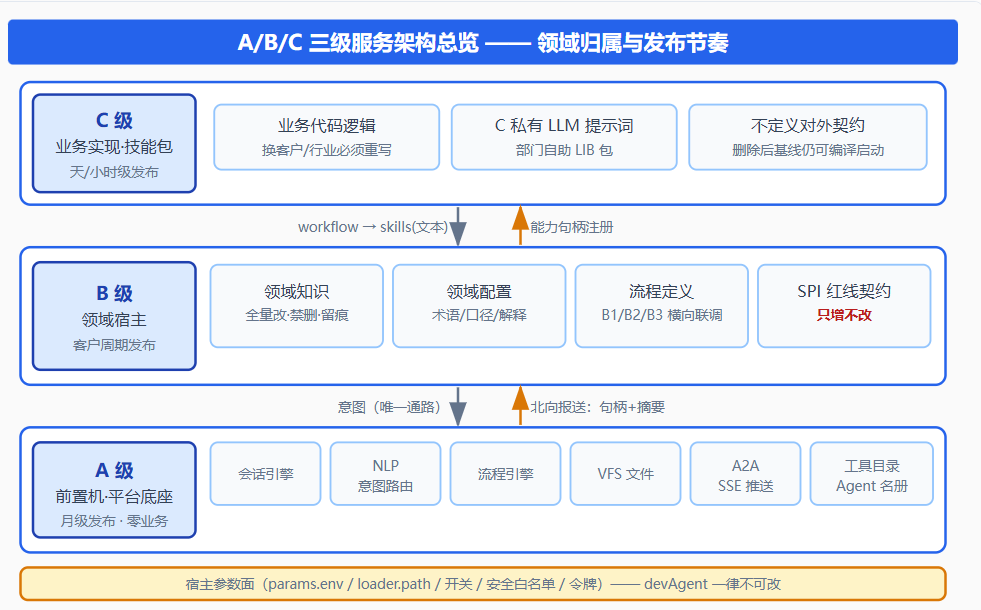
- A 级(平台底座):零业务的产品基线,月级发布。会话引擎、NLP 意图路由、流程引擎、VFS 文件系统、A2A 通讯总线、工具目录索引都在这里。铁律是 A 不知道 B/C 的存在——平台代码里不允许出现"报销""凭证""账龄"任何一个业务词。
- B 级(领域宿主):企业知识的家,客户周期发布。领域的知识、配置、流程三件套统一归 B:领域术语库、SPI 红线契约(只增不改)、流程定义。SPI 层禁止改删既有,知识禁止删除。
- C 级(业务实现):部门自助的技能生产车间,天/小时级发布。判定标准三条:换客户必须重写、删掉后基线照常编译启动、不对外定义任何契约。
C 级技能包不是一堆零散脚本,而是有明确结构的生产物:业务代码逻辑 + C 私有 LLM 提示词 + 部门自助 LIB 包,打成 ≤1MB 的业务 jar,落在生产实例的 lib/biz/ 目录下替换即发布(见第六节)。
本文的舞台是财务域。一条业务 jar(ooder-biz-finance)里装着九个流程场景,其中六个作为独立 A2A 执行体注册进集群名册:
流程 id | 展示名 | 能力段(A2A capability) |
|---|---|---|
bank-statement-convert-scene | 资金日报 | bank-statement |
reimburse-pay-export-scene | 报销直付 | reimburse |
invoice-receipt-reconcile-scene | 业财对账 | invoice-recon |
ledger-aging-scene | 往来管家 | ledger-aging |
tax-burden-scene | 税务雷达 | tax |
voucher-fill-scene | 凭证引擎 | voucher-fill |
expense-approval-flow | 费用报销审批 | —(编排流) |
expense-reimburse-flow | 员工报销(推有成) | —(编排流) |
month-end-close-flow | 月结业务线 | —(编排流) |
这张表本身就是一条工程纪律的产物:执行体清单从流程枚举派生(FinanceFlowIds.a2aExecutables()),而不是手写常量——曾经名册里漏登记了两个执行体,根因就是"手写清单"与"流程真源"两处维护。让清单从真源派生,缺陷类就消失了。
二、工具集总览:一张地图
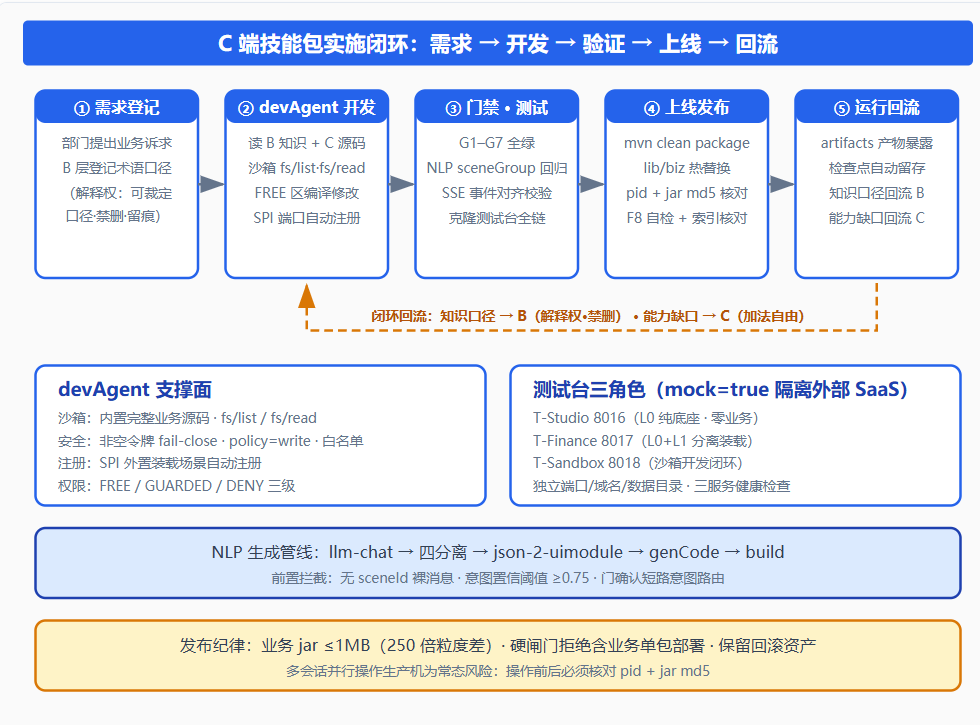
C 端工具集按生产环节分为五组,每组与平台能力一一对应:
生产环节 | 工具集 | 平台锚点 |
|---|---|---|
听懂需求 | NLP 字典 + 意图分发 + 生成管线 | skills/rad-component-reader/knowledge/*、NlpOrchestrator |
编排流程 | BPM 画布 + 流程定义 + 审批门 | process-def/*/definition.json、BpmPageChannel |
修改代码 | 工程工作台(源码树/读写/检索/编译) | /api/codeagent/fs/*、/api/codeagent/compile |
测试 | 沙箱 harness + mock 外部依赖 | /api/codeagent/sandbox/*、ooder-test |
发布 | 打包/部署/运行/发布四档 + lib/biz 热更新 | /api/codeagent/{package,deploy,run,release/*} |
下面四节按这条生产线依次展开。
三、NLP 字典:让机器听懂企业的话
3.1 三层字典,各管一件事
NLP 能把"帮我做一个报销审批单"变成一张可编译的表单,前提是它带着三套机器可读的字典:
第一层:意图关键词表(intent-keywords.txt)。把自然语言信号映射到意图与组件类型——"表单/申请单/登记"→ CREATE_FORM,"列表/台账/流水"→ CREATE_GRID,"图表/统计/占比"→ CREATE_CHART。带权重与冲突规则(比如"管理页面"与"管理系统"的级别差)。
第二层:领域词条表(domain-dictionary.txt)。企业中文词 → 规范英文字段名。"报销人"→ reimburseUser、"发票号码"→ invoiceNo。LLM 字段提取后靠它落成 PascalCase 模块名与驼峰字段名——没有这一层,每次生成的英文名都会漂移,生成的 Java 代码就没法长期维护。
第三层:组件知识库(component-type-registry.json + component-defaults/ + component-events/ + component-templates/)。每个组件的默认属性、事件枚举、代码模板。TreeGrid 该有什么列定义、Form 的事件回调是 FormCallBack.SAVE 还是 SAVEANDRELOAD、Gallery 为什么不能有 children 只能用 items——全在这里。
3.2 知识不是一次性塞给 LLM 的:L1-L5 分级披露
把 100 多个知识文件全量塞进 prompt,上下文会先于业务爆炸。平台的做法是五级披露,每级有 token 预算与注入时机:
级别 | 内容 | token 预算 | 注入时机 |
|---|---|---|---|
L1 IDENTITY | 角色定义 + 工作流程 + 输出规范 | 300 | 始终注入 |
L2 STRUCTURE | 代码模板 + 组件选择 + CS 参考 | 500 | 场景匹配后 |
L3 RULES | 四分离规则 + 降级指引 | 400 | 合规修正阶段 |
L4 REFERENCE | 组件详情 + 事件 + 行为 + 样式模板 | 1000 | 工具按需加载 |
L5 EXPERT | 图表深度 + 样式图谱 | 2000 | 深度场景按需 |
这套机制的负责人是 knowledge-index.json——它不仅是索引,还登记每个知识块的重复与冲突状态(duplicates 字段标记 FALLBACK/EXTENDED/RESOLVED),防止"同一规则两个版本各说各话"的知识腐烂。
3.3 数据飞轮:每次兜底都让下一次更准
字典覆盖不了口语。"搞个学生列表""整一个客户表"这类输入,关键词表接不住,平台走存疑补偿:关键词匹配置信度不足 → LLM 兜底判定 → 判定结果写回知识库(nlp-intent-kb)并向量化;下次相似查询先查 RAG(相似度 ≥0.75 直接命中),不再花一次 LLM 调用。实测 64 条四级意图基线 100% 通过之后,破坏性基线(口语/否定句/复合意图)暴露的长尾正是靠这个飞轮逐步收敛的。
值得强调:飞轮写回的是C 端自己的知识库,不是 A 级平台代码。口语偏好属于业务知识,按 A/B/C 归属约定落 B/C 层——平台保持零业务。
3.4 实拍:NLP 对话生成
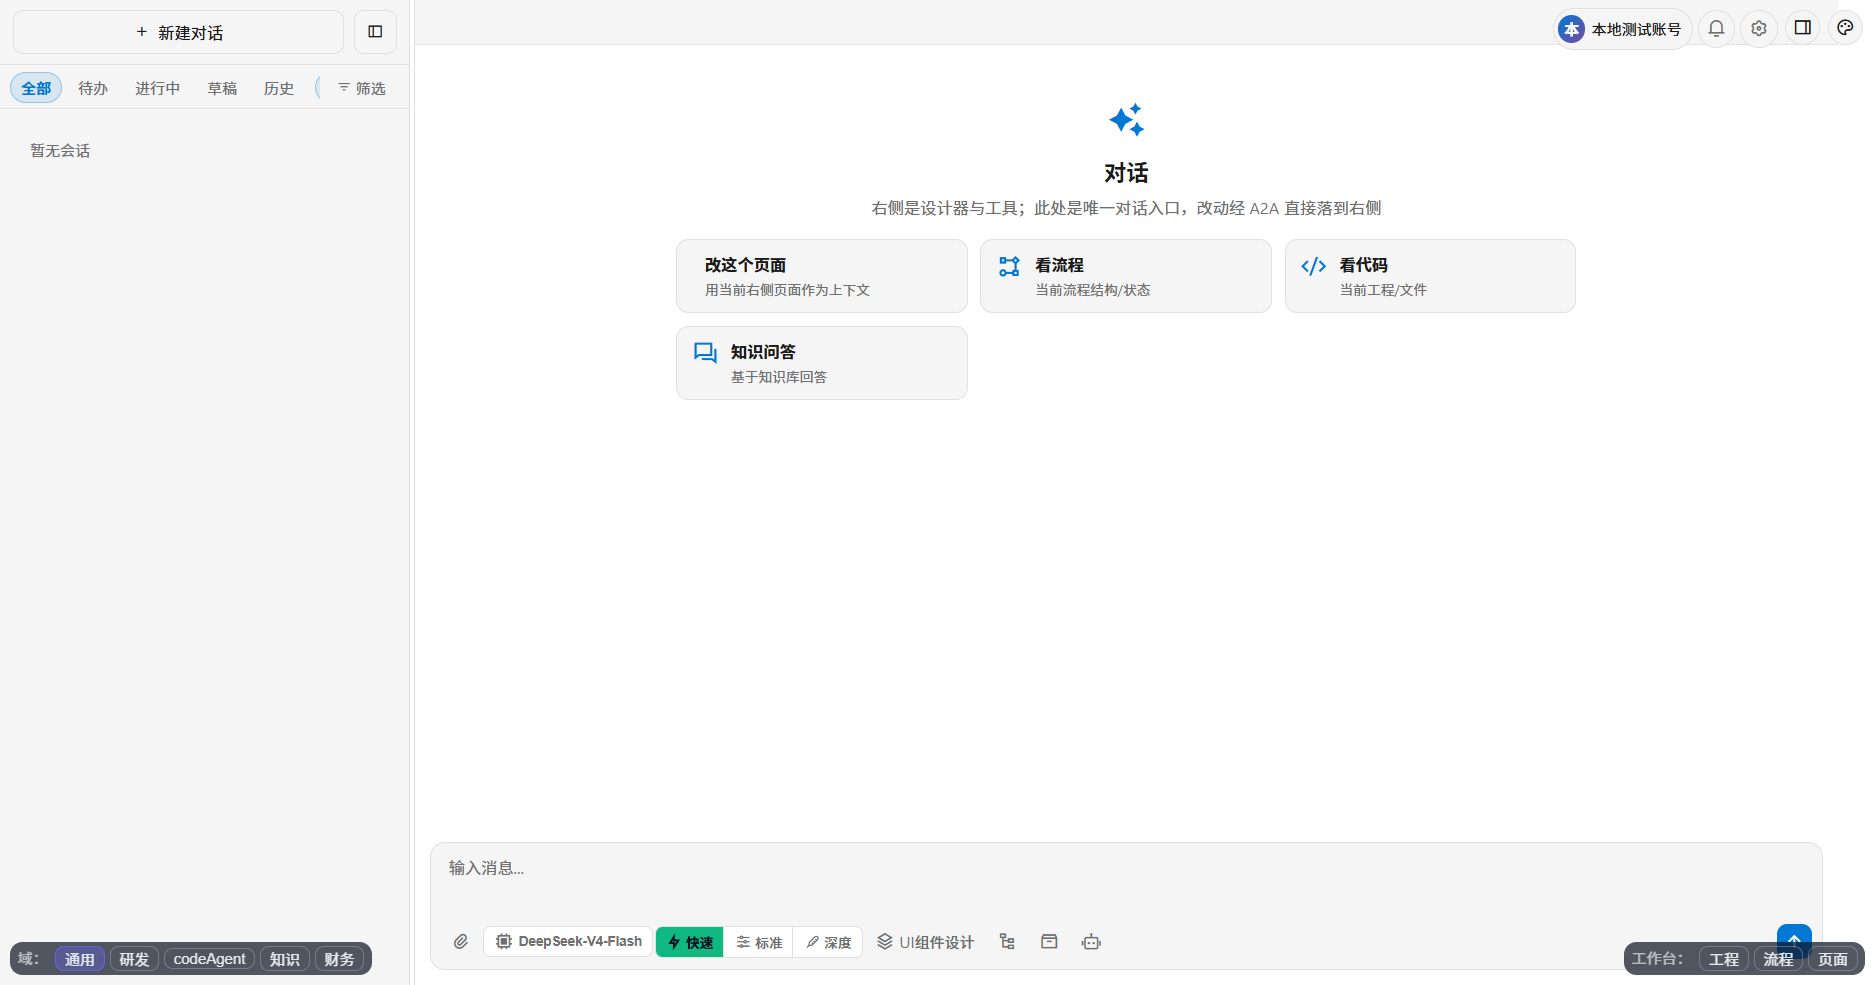
主控制台对话页(薄壳实机)。右侧是设计器与工具的统一对话入口,右下角「工程 / 流程 / 页面」即工作台导航条——所有工作区都从主控制台进入,不再散落独立地址。
以财务域输入 "帮我做一个报销审批单" 为例,管线实际发生的事:
意图识别   CREATE_FORM(FORM-003 基线用例)
字段提取   报销人→reimburseUser、金额→amount(Double)、
           事由→reason、报销类型→expenseType(枚举)
英文名映射 domain-dictionary.txt 命中
布局计算   FormLayout 双列配对:col=2 → 网格4列,
           target=B1/D1/B2/D2(Label 列 A/C,Value 列 B/D)
四分离     Properties(caption/dock)+ Styles(CS 样式键值)
           + Events(FormCallBack.SAVE)+ Behaviors(autoSave)
逆向转换   genJson → UIModule → view.ExpenseApproval.cls
代码生成   AggRootBuild:View + VO + Entity + Service + DAO
           FTL 模板渲染 → dynCompile → .class
其中 target=B1/D1 这一步值得单独说:FormLayout 是"双列配对"网格,奇数列放标签、偶数列放输入框。NLP 管线按字段索引计算 target = 列字母 + 行号,与设计器手工拖拽时的 autoPaint 算法完全同一套公式——这是 NLP 生成的页面与手工设计的页面能在同一个设计器里继续编辑的前提。
四、流程:把对话编排成业务闭环
4.1 四级意图分发:先分清"你要的是哪种活"
NLP 生成的第一道闸不是生成,是分诊。四级意图模型决定这句话走哪条生产线:
级别 | 意图 | 典型输入 | 走法 |
|---|---|---|---|
L1 | 当前界面注入组件 | "给列表添加双击编辑" | PageChannel 实时注入,不建新页 |
L2 | BPM 插入节点 | "在审批后加一个会签节点" | BpmPageChannel 画布渲染 |
L3 | 创建单页程序 | "做一个报销审批单" | 单模块闭环,AggRootBuild |
L4 | 构建完整系统 | "构建一个报销管理系统" | 三阶段构建 + 用户确认 + 并行页面 |
分诊错了,后面全错——曾经"订单管理页面"被误判成 Layout 而不是 NavTree,五层缺陷叠加才修干净。所以四级模型各有独立的校验链与兜底:L1 失败降级为整页刷新,L3 有 ClsAuditStep 四维评分(低于 60 分打回重生成),L4 的持久层生成前必须过用户确认门(120 秒超时自动继续)。
4.2 流程定义:审批门是流程的骨架
以贯穿全文的 expense-approval-flow(费用报销审批)为例,看一段真实的流程定义:
{
  "definitionId": "expense-approval-flow",
  "name": "费用报销审批",
  "workMode": "business",
  "parentFlowId": "intent-dispatch",
  "activities": [
    {
      "activityId": "ea_submit",
      "agentType": "HUMAN",
      "displayName": "提交报销申请",
      "humanMode": "CONFIRM",
      "humanConfirmRequired": true,
      "producedOutputs": ["amount", "reason"],
      "activityToolIds": ["human_confirm"]
    },
    {
      "activityId": "ea_manager_review",
      "agentType": "HUMAN",
      "displayName": "经理审批",
      "humanMode": "APPROVAL",
      "noMatchPolicy": "ESCALATE_HUMAN",
      "timeoutPolicy": "ESCALATE_HUMAN",
      "timeoutMs": 300000,
      "approvalActions": ["APPROVE", "REJECT"],
      "performerList": [
        { "performerType": "USER", "performerId": "user1", "performerName": "测试用户一" }
      ]
    }
  ]
}
四个关键字段撑起真实业务语义:
- humanMode: APPROVAL + approvalActions:审批门。批准流转、驳回退回提交人,门卡在会话里渲染成可点击卡片,点"门确认"短路意图路由(避免选项文本被 LLM 误匹配成新流程)。
- performerList:角色→人落地。审批活动按办理人清单生成各岗位真实待办(BpmTodoSyncListener 镜像为 BPM 活动实例),不是泛泛的"某角色会收到通知"。
- noMatchPolicy: ESCALATE_HUMAN:路由无匹配时不静默失败——升级人工。流程对"听不懂"的态度是显式声明每个节点怎么办:FAIL/SKIP/WAIT/ESCALATE_HUMAN 四选一。
- timeoutPolicy:5 分钟无响应自动升级,防止审批门变成流程黑洞。
4.3 回环闸:兜住作者声明错误的确定性保险
财务流程普遍存在"驳回重做"回环边。历史定义里 *_redo_1/*_failed 类边被系统性误声明为 FORWARD 方向——如果引擎按声明执行,就是自动死循环。平台的解法是拓扑回环闸:
引擎以拓扑事实(_visitedActivities 已执行集合)而非作者声明的 direction 判定回环性。FORWARD 边目标已执行过且非 HUMAN/END = 自动重入;同一条边同一纪元(HUMAN 门完成即清零)内只允许 1 次自动重入,第 2 次 = 确定性死循环 → 实例 FAILED + 单行 ERROR(fail-fast),并带 12 跳轨迹防日志风暴。
这个设计的原则是:不指望 9+ 处历史定义逐条改对,而是让引擎对"声明错误"免疫。回环必须经过 HUMAN 门(外部输入),纯自动回环一律拦截——业务上的"驳回重做"本来就必然经过人工修改,拓扑约束与业务语义天然重合。
4.4 实拍:BPM 工作台
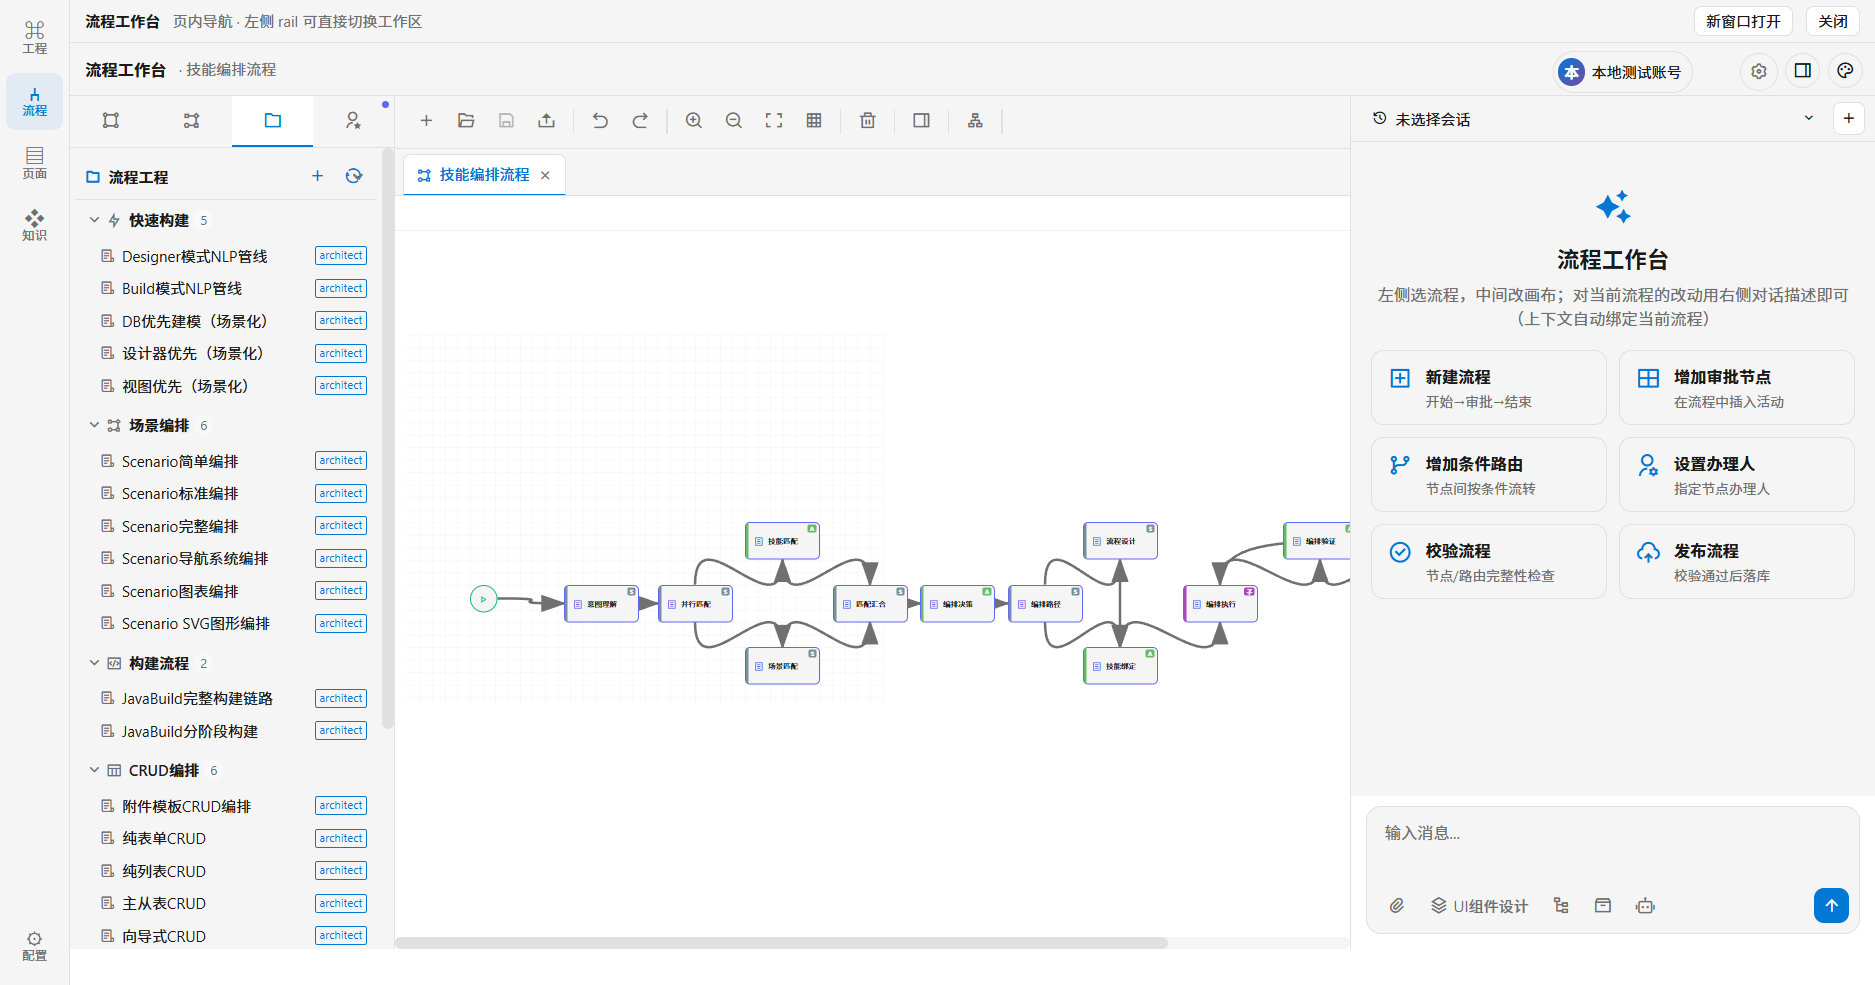
BPM 流程工作台(薄壳实机,页内导航形态)。从工程工作台左侧 rail 点「流程」在本页内嵌展开——顶部细条提供「新窗口打开 / 关闭」,rail 高亮随工作区切换,不再弹出新窗口。左侧流程树为真实数据(快速构建 / 场景编排 / CRUD 模板),对话说"在审批后加一个会签节点"(L2 意图),BpmPageChannel 推送 createActivity 命令,画布毫秒级渲染新节点。
五、代码修改:工程工作台里的"真实武器"
NLP 生成了 80 分的骨架,最后 20 分的口径校准("报销直付要按 order_date <= 当日 的累积未付口径查")永远要落到代码上。工程工作台提供的不是"演示级"的代码预览,是真 javac、真文件系统、真编译诊断:
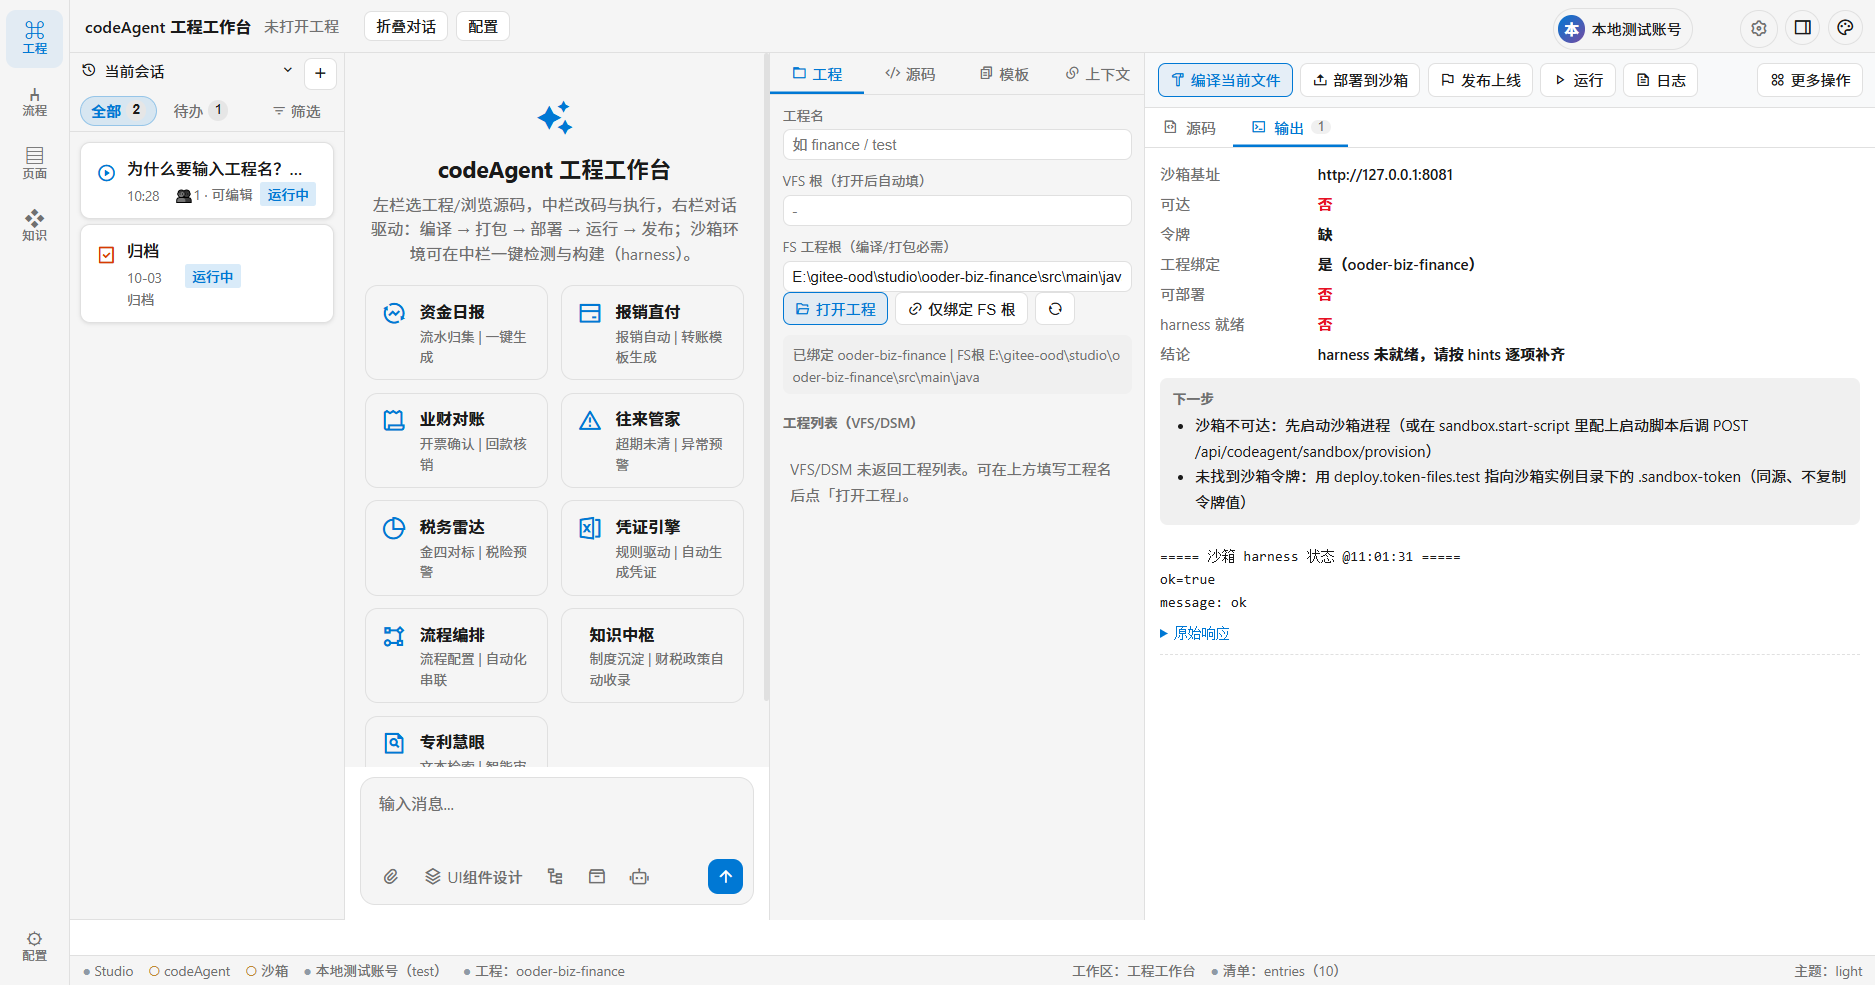
工程工作台(薄壳实机)。左侧 56px 竖向 rail(工程 / 流程 / 页面 / 知识 / 配置)+ 中部工程管理:VFS 工程列表、工程绑定(VFS 根 + FS 根)、沙箱状态、工程动作;右侧对话可折叠为 48px 竖条。
5.1 端点与能力一一对应
能力 | 端点 | 说明 |
|---|---|---|
工程列表 | GET /admin/getProjectList | VFS/DSM 侧工程 |
打开工程 | GET /RAD/openProject?projectName= | 返回 files/rootPath,旁路绑 VFS 根 |
补绑 FS 根 | POST /api/codeagent/project | 编译/打包真正消费的路径 |
实时树 | GET /api/codeagent/fs/tree | 工程源码树 |
读/检索 | GET /api/codeagent/fs/read / search | 工程内全文检索 |
覆盖写 | POST /api/codeagent/fs/write | 默认 .oodbak 备份 |
编译 | POST /api/codeagent/compile | 真 javac,立刻看诊断 |
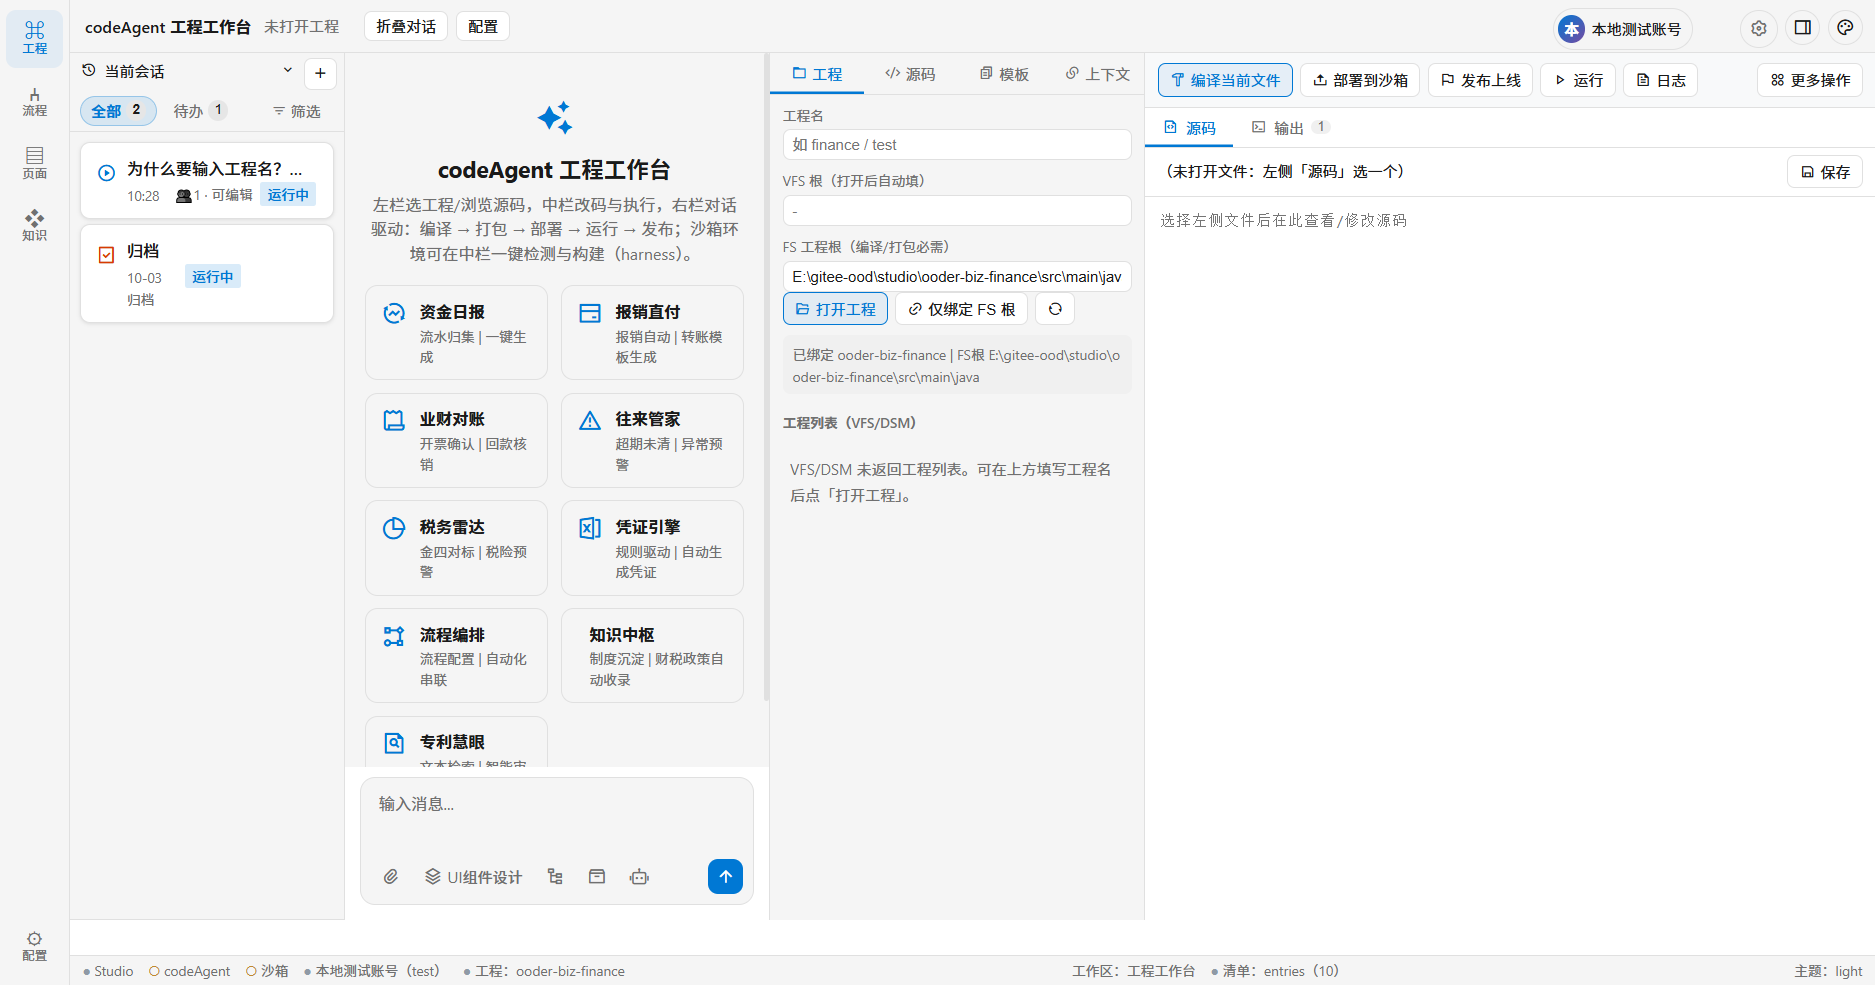
工程工作台·源码页签(薄壳实机,已绑定 ooder-biz-finance 工程后的真实数据——左侧源码树直接读文件系统 net/ooder/... 目录,非演示数据)。绑定工程后,左侧即源码树 + 全文检索,右侧为代码编辑与编译输出;fs/write 默认落 .oodbak 备份,编译失败原样显示诊断。
5.2 两条设计纪律
纪律一:所有失败原样显示,不做静默兜底。 页面 JS 里的约定写得很直白:"所有失败都在'输出'面板里原样显示(HTTP 码 / 失败信封 message),不做静默兜底"。这条纪律来自真实教训——控制台曾经把双层信封响应 {url, upstreamStatus, data:{code,message}} 只取外层,23 个实际成功的授权全被判成失败。UI 层吞掉的每一个错误,都会变成排查时多烧掉的一小时。
纪律二:慢动作不走同步桥。 桌面端内嵌时,读/状态类动作走 cefQuery 桥(与桌面端顶部菜单同一执行体),但 compile/package/deploy 这些分钟级操作刻意走异步 fetch——cefQuery 是同步阻塞通道,走桥会把页面卡死几分钟。工具集的每一层都要想清楚自己的通道语义。
5.3 财务示例:改一处口径的三步
以"报销直付按累积未付口径查询"为例:
- fs/search 检索 order_date 定位到 ReimbursePayConvertService 的查询段;
- fs/write 修改查询条件为 order_date <= 当日 累积未付(自动落 .oodbak);
- compile 即时编译,诊断面板给出 BUILD SUCCESS 或具体错误行——错了当场改,不进"提交后才发现"的循环。
六、测试与发布:小时级上线的物理前提
6.1 沙箱 harness:先体检,再构建
GET  /api/codeagent/sandbox/status     → 能不能用、缺什么(hints)
POST /api/codeagent/sandbox/provision  → 按步骤构建/修复环境
沙箱是测试的第一道门:status 返回的 hints 明确告诉你缺什么(JDK、工作区白名单、令牌),provision 按步骤修复而不是让用户读天书日志。沙箱策略配置 ooder.sandbox.policy.level=write 限制 LLM 工具调用风险等级,workspace-root 白名单禁止越界读系统文件,令牌未配置时 fail-close——测试环境的安全闸不比生产松。
测试环境的铁律:所有业务依赖必须走 mock(mock=true),禁止访问生产的有成云/钉钉等外部 SaaS。测试数据污染生产,是集成测试里最贵的事故类别。
6.2 发布链:四档动作 + 外置装载
POST /api/codeagent/package          → 打包业务 jar
POST /api/codeagent/deploy           → 部署到目标实例 lib/biz/
POST /api/codeagent/run/start|stop   → 运行控制
POST /api/codeagent/release/prepare|activate|rollback   → 发布三段
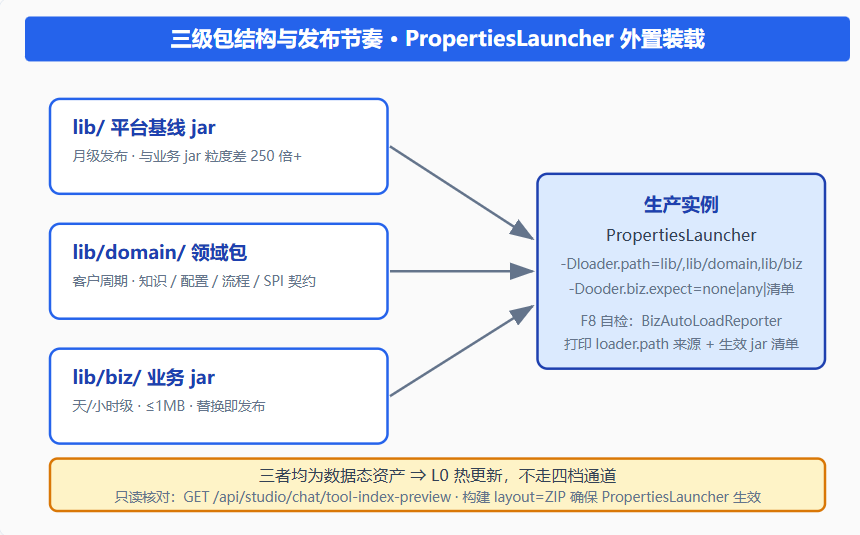
发布体系的物理基础是 PropertiesLauncher 外置装载:生产实例以 -Dloader.path=lib/,lib/domain,lib/biz 启动,业务 jar(≤1MB)与平台基线 jar(250 倍以上粒度差异)物理分离。业务发布 = 替换 lib/biz/ 目录下的一个 jar,不需要重传平台、不需要全量回归——这是"小时级发布"能成立的前提,而不是团队加班加出来的。
配套的透明化机制是 F8 自检(BizAutoLoadReporter):启动时打印 loader.path 的来源(显式/环境变量/隐式 loader.properties——最容易忽视的一路)+ 实际生效的业务 jar 清单,并与 -Dooder.biz.expect 期望声明对账。装载事实不透明,运维就不敢自己发版;敢于自主发版,才是企业自己的生产能力。
6.3 发布纪律清单
纪律 | 违反的代价 |
|---|---|
构建不带 clean(增量编译) | clean 会删空 target/classes,javac 在有错时不产出任何 class |
业务 jar ≤ 1MB | 超限说明 C 级代码里混进了该归 B/A 的东西 |
SPI 只增不改(G2 门禁) | 改既有契约 = 打破其他 B/C 挂载方 |
换装 seed 前先 cp -a 备份,验证"权威流程 ID ⊆ 本地 seed" | 丢服务器侧自建流程 |
发布后核对 jar md5 + pid | 多人并行操作生产机是常态,别假设实例没被别人动过 |
七、一次完整走查:报销审批单从一句话到上线
把五组工具串成一条线,看报销审批单的完整旅程:
第 1 步:一句话生成表单(NLP 管线,分钟级) 输入"帮我做一个报销审批单"。意图 CREATE_FORM,领域字典映射字段,FormLayout 双列配对落 target,四分离审计过 60 分线,.cls 落盘 + AggRootBuild 生成 View/VO/Service/DAO,dynCompile 出 .class。
第 2 步:流程绑定(BPM 工具,分钟级) 对话说"在财务审批后加一个出纳付款节点"(L2 意图),BpmPageChannel 在画布渲染新 HUMAN 节点;流程定义声明 performerList 落地到具体审批人,驳回边声明走拓扑回环闸校验。llmPredictableBranch=true 的 HUMAN 门可让 LLM 高置信预判分支自动放行——但必须显式声明,不做隐式魔法。
第 3 步:口径校准(工程工作台,分钟级) fs/search 定位查询段,fs/write 修改(.oodbak 兜底),compile 立刻验证。
第 4 步:沙箱测试(分钟级) sandbox/status 体检 → provision 修复 → mock 模式跑通审批链:提交 → 经理审批(APPROVE/REJECT 门卡)→ 财务审批 → 出纳付款 → 归档。检查点在 flow_paused/complete 终态自动产出,审计报告按活动声明的 producedOutputs 通用生成 .md+.json 产物并推 flow_artifact 事件。
第 5 步:发布(小时级) package → deploy 到测试实例 lib/biz/ → 验证 → release 三段推生产。业务 jar 替换即发布,平台不动。
回流:流程产出物经 GET /api/studio/chat/artifacts 统一暴露,前端产物横幅常驻——业务用户在会话里直接拿到报销单据与审计报告,而不是被引导去文件服务器翻目录。
整条走查里,业务用户的入口始终是对话;devAgent 的每次越权冲动都被护栏清单(read / allow-add / allow-modify / deny-delete,机器可判定的路径 glob + 包名 + 符号 + 配置键前缀)挡下——A 只读;B 加法自由减法禁止;C 可自改但删要授权。
八、结语:生产线上的每个工具都值得较真
回看这套工具集,它没有一项是"惊艳"的:字典就是文本文件,流程就是 JSON,工作台就是 CRUD 端点,发布就是换 jar。它的价值在较真:
- 字典较真到"报销人必须永远映射为 reimburseUser",生成的代码才能维护十年;
- 流程较真到"驳回边声明错了引擎也不死",历史定义的债才不会变成生产事故;
- 工作台较真到"每个错误原样显示、每个写操作都有备份",工程师才敢把它当生产工具;
- 发布较真到"装载事实可对账、粒度差异 250 倍",企业运维才敢自己按按钮。
C 端生产线的终极指标只有一个:企业自己的人,用企业自己的 devAgent,把一个新技能包从一句话推到生产,全程不依赖原厂。 工具集的每一处较真,都是在为这句话降低门槛。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号