Semantic Kernel智能化应用框架实践:打通大模型提示词、函数调用与Agent开发链路24.6
原创
Semantic Kernel智能化应用框架实践:打通大模型提示词、函数调用与Agent开发链路24.6
原创
未闻花名
发布于 2026-10-06 18:10:33
发布于 2026-10-06 18:10:33
一、前言
现在大模型应用开发已不再局限于简单调用ChatCompletion接口了。回想以前我们通过直接封装大模型API,写一堆提示词完成需求,构建初步应用,但随着应用程度加深,会发现提示词分散难以统一管理、无法便捷组合大模型能力与本地代码、缺少长期记忆上下文、复杂业务流程很难编排、函数调用逻辑重复编写、切换不同厂商大模型需要大规模改造代码。
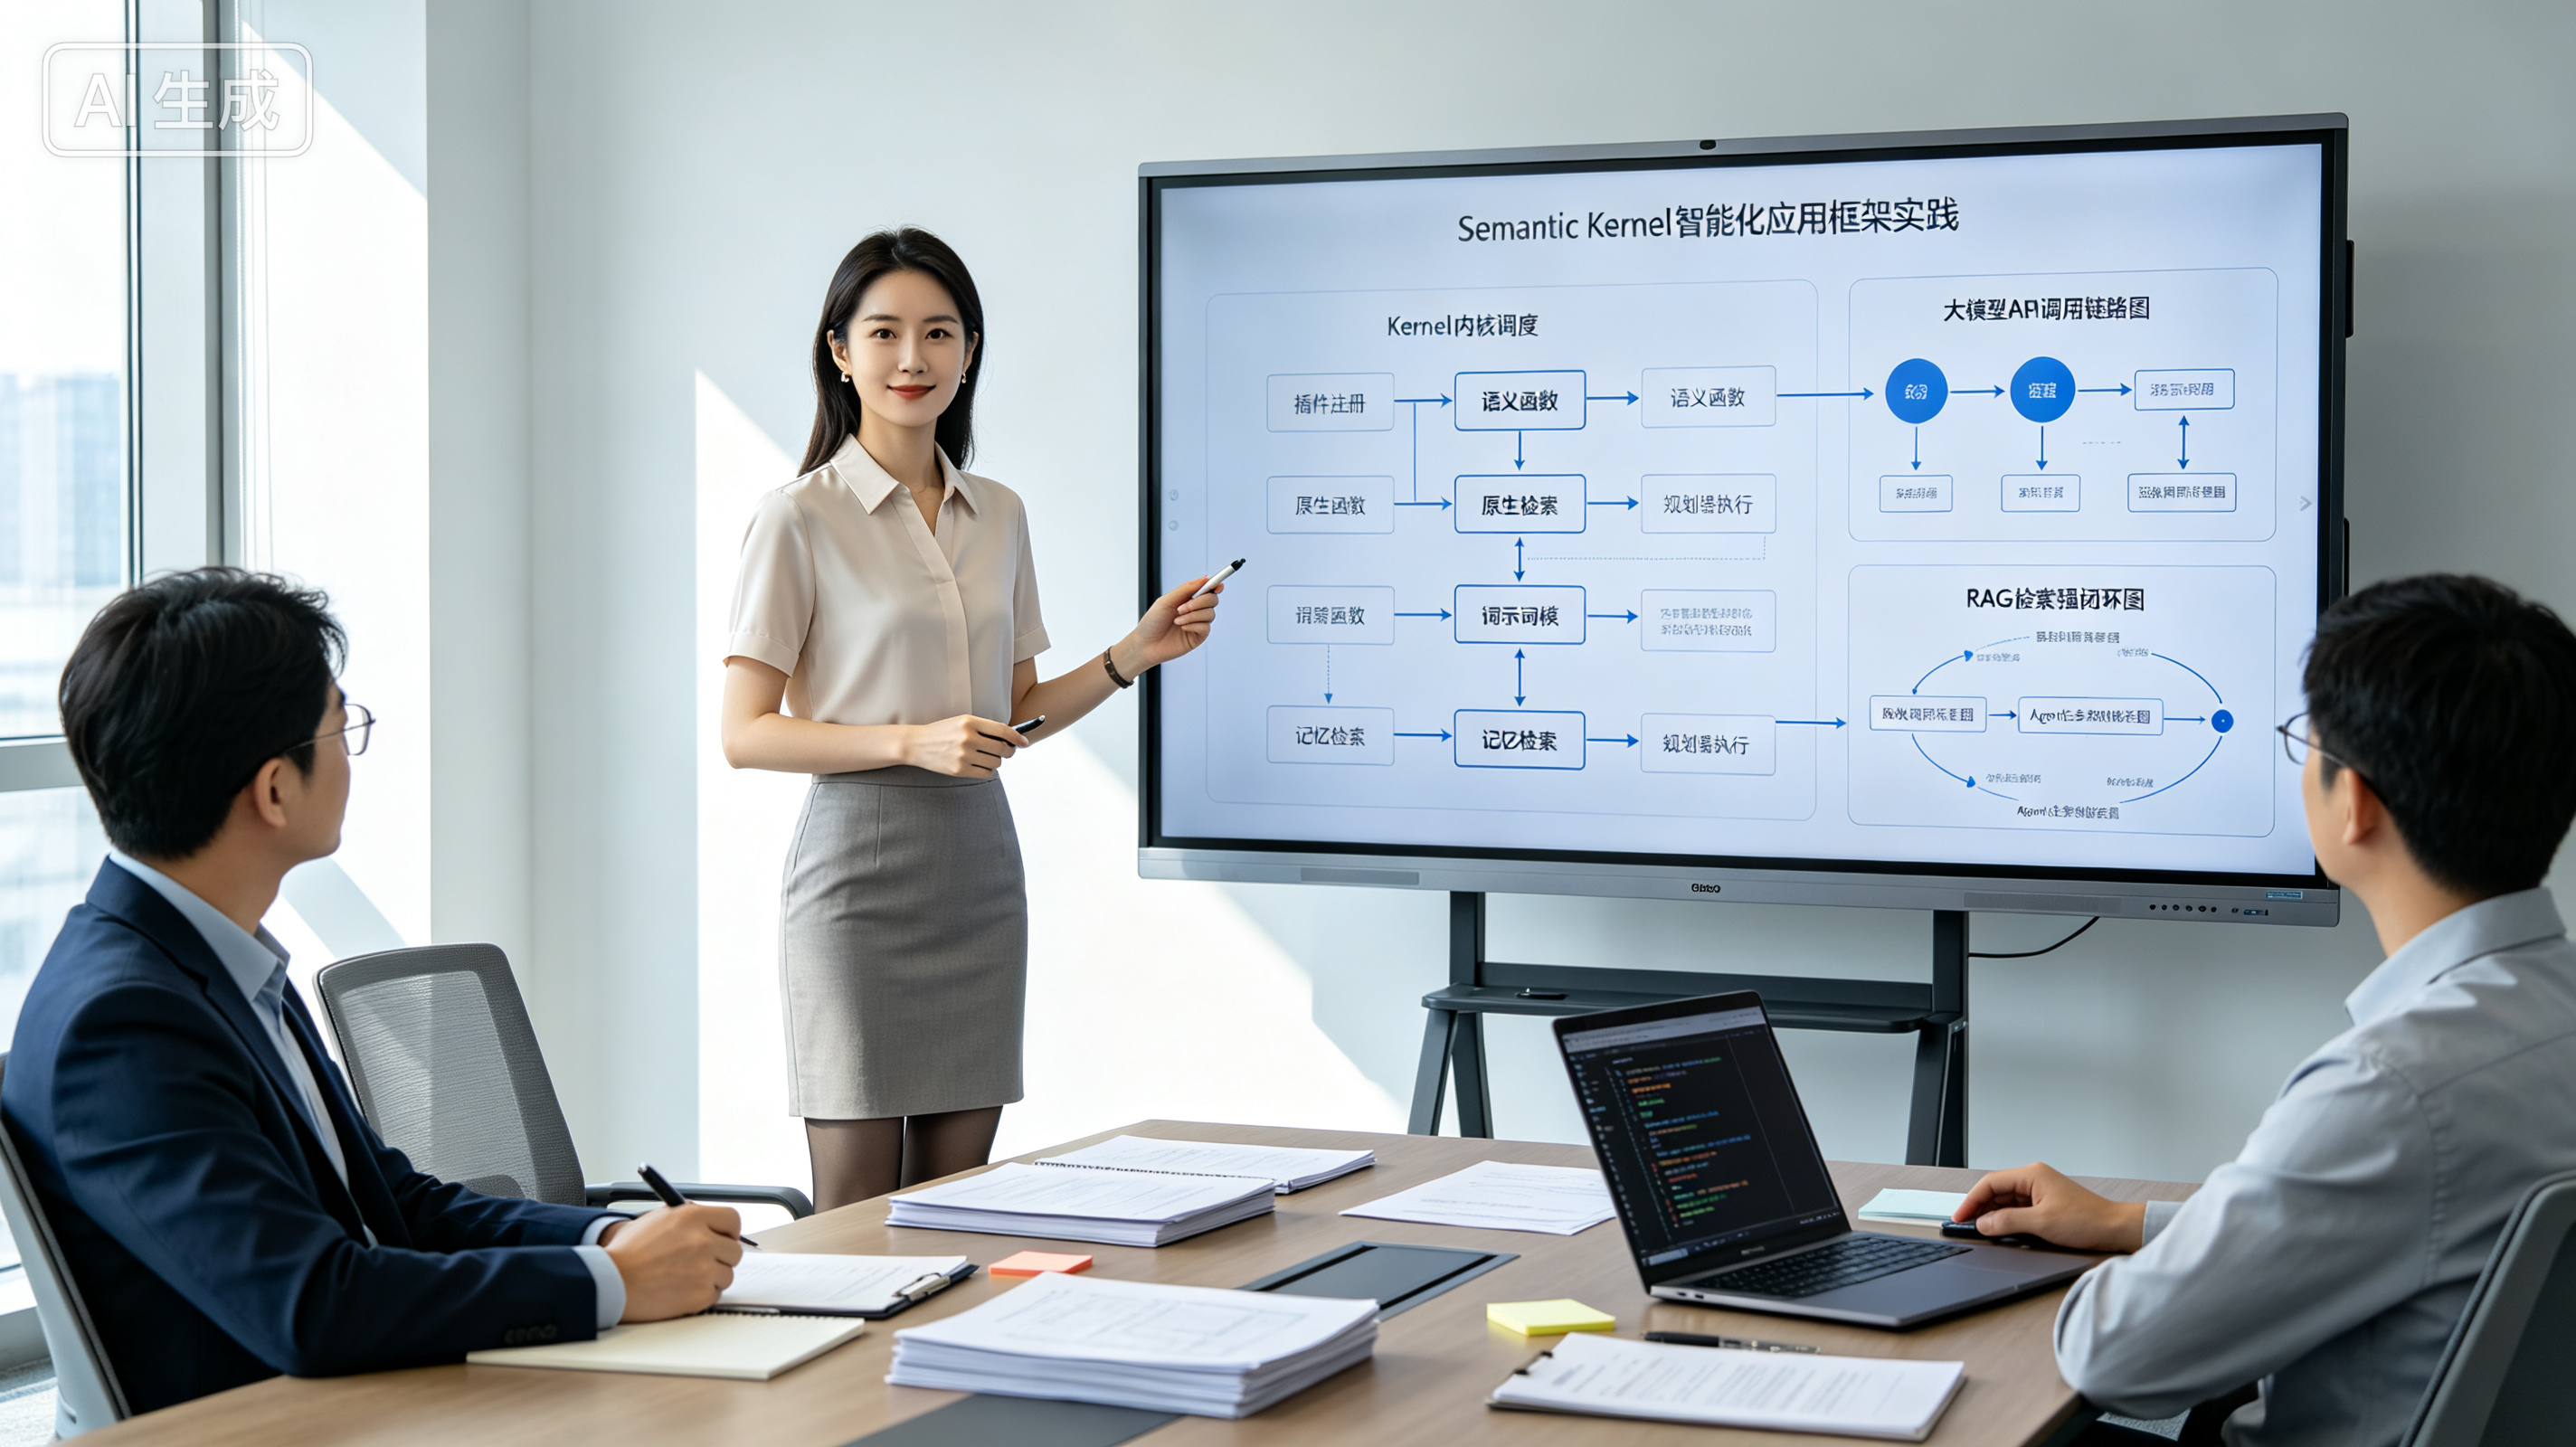
正是面对这些日益凸显的难题,我们也都在尝试调整思路和寻找解决方案,这里引进一个新思路,Semantic Kernel,即语义内核,简称SK,核心定位是连接大模型、原生代码、业务数据的开发框架。它把提示词、自定义函数、向量记忆、规划能力、插件体系封装成一套标准化规范,让我们不用重复造轮子,专注业务智能逻辑。
现有架构体现内,其实LangChain也可以处理这些问题,但各自有各自的优势,两者目标相似但设计理念存在明显区别:SK原生拥抱.NET生态,依托微软平台,对C#友好,同时完整支持 Python、Java;架构轻量化,与 Azure云服务深度打通,更加适合微软技术栈的企业数字化项目。同时SK强调 “语义函数” 与 “原生函数” 统一编排,弱化复杂抽象,上手门槛更低。
二、Semantic Kernel 概述
1. Semantic Kernel基础
Semantic Kernel(SK)是一套开源轻量级大模型编排框架,核心目标是弥合自然语言能力与传统程序代码之间的鸿沟。简单来说:它允许开发者将大模型能力视作可调用函数,同时能够把本地编写的普通代码封装成插件,交给大模型自主调度执行。
我们可以用通俗的方式理解:大模型本身擅长理解语言、推理、总结,但无法直接操作数据库、读取文件、调用第三方接口、执行运算;传统代码擅长数据处理、接口请求,但不具备自然语言理解能力。Semantic Kernel充当中间调度层,让两类能力相互协作。
SK中有两类最基础的函数:
- 语义函数(Semantic Function):基于提示词模板,交由大模型执行,例如文本摘要、情感分析、翻译、文案生成;
- 原生函数(Native Function):使用编程语言编写的普通函数,例如查询天气、读取本地文件、数据库查询、计算数据。
两类函数统一纳入插件体系,内核Kernel统一管理,支持自由组合、链式调用,甚至支持大模型自主规划执行顺序。
2. 核心价值与适用场景
其实很多AI应用通过仅仅封装大模型API就能完成开发,为什么还要引入额外框架?我们梳理SK带来的核心工程价值:

- 模型厂商无关抽象层:SK提供统一调用接口,底层可以无缝切换多种大模型,修改配置即可切换模型,业务代码无需大规模重构。
- 提示词工程规范化管理:支持将提示词独立文件化管理,支持模板变量、版本维护,避免提示词零散写在代码字符串中,方便后期调优、多人协作。
- 原生支持智能规划(Planner):面对复杂用户需求,大模型可以自动拆解任务,自动选择所需插件函数,自动编排执行流程,简易实现基础 Agent 能力。
- 内置记忆组件(Memory):封装向量存储标准接口,支持短期对话上下文记忆与长期向量记忆,快速实现知识库检索增强,简易RAG,不用从零对接向量数据库。
- 插件化扩展架构 所有能力都以插件形式存在,新增业务功能只需要开发新插件,低耦合,便于项目迭代维护。
适合落地的典型场景:
- 企业智能客服、内部知识库问答系统;
- 文档智能处理:摘要、信息抽取、格式转换;
- 个人 / 企业智能助手,自主调用工具完成复合任务;
- 自动化数据分析、智能报表生成;
- 基于 RAG 的私有知识库应用原型开发。
不适用于场景:
- 极致追求最低调用延迟、只需要单次简单大模型请求、项目架构极度轻量化,引入框架会增加维护成本。
3. SK与LangChain差异
市面上最主流的两大编排框架就是Semantic Kernel与LangChain,在深度说明前,这里做清晰对比,以便初步了解:
- 技术生态
- LangChain首发Python,生态更加丰富,社区第三方组件数量更多;
- Semantic Kernel原生优先支持.NET,完整支持Python,和Azure云服务深度集成,企业微软技术栈项目兼容性更好。
- 架构设计
- LangChain抽象层次较多,链 (Chain)、代理 (Agent)、加载器概念繁多;
- SK架构更加简洁,核心对象只有 Kernel、Plugin、Function、Memory、Planner,概念更少,学习曲线平缓。
- 定位方向
- LangChain偏向通用开源AI应用开发,各类向量库、文档加载器适配更广;
- SK面向企业级业务系统集成,强调安全性、可观测性、云原生部署。
- 开发选型建议
- 如果技术栈以Python为主,需要大量文档解析、多样化向量库,优先LangChain;
- 如果团队使用C#/.NET、使用Azure OpenAI服务、追求架构简洁稳定,优先选择Semantic Kernel。
三、Semantic Kernel核心组件
1. Kernel(内核)
Kernel是整个Semantic Kernel体系的核心容器与调度中心,几乎所有操作都围绕Kernel实例展开。 可以把Kernel想象成一个智能工作台:工作台中注册大模型服务、加载各类插件、挂载记忆组件、配置全局参数。所有语义函数、原生函数都注册在内核中,后续由内核统一调度。
Kernel 主要承担职责:
- 管理AI服务连接器,对接各大模型平台;
- 加载、存储所有插件与函数;
- 接收用户输入,调度函数执行;
- 传递上下文变量,管理执行上下文;
- 支持注入日志、遥测、鉴权等中间能力。
创建Kernel的标准流程分为三步:
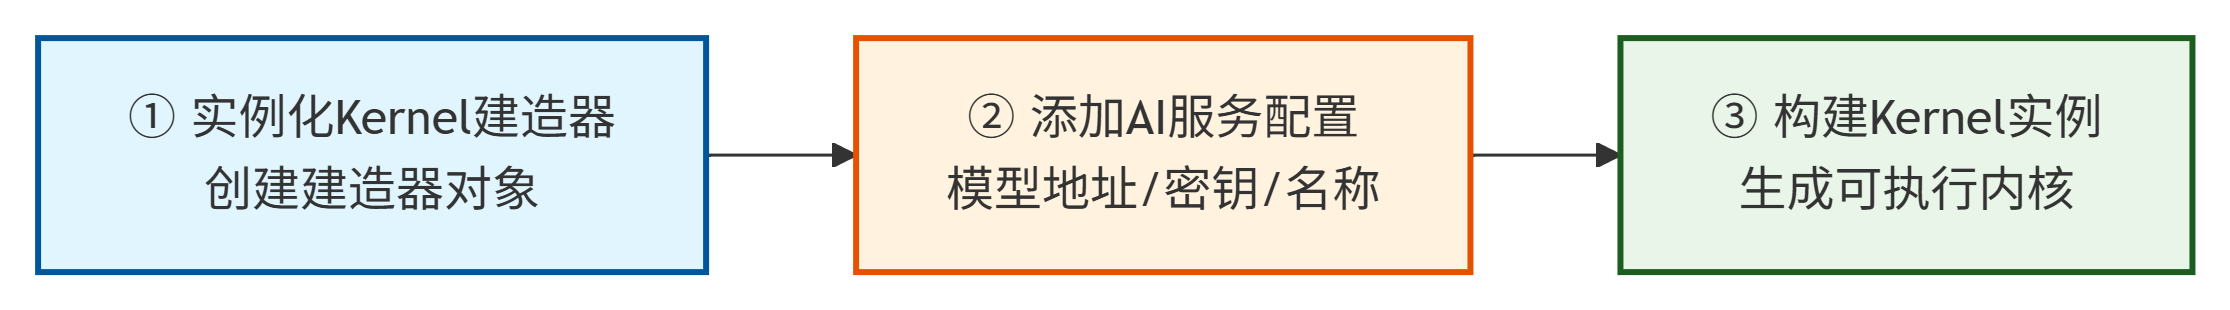
- 1. 实例化Kernel建造器;
- 2. 添加AI服务,配置模型地址、密钥、模型名称;
- 3. 构建Kernel实例。
示例:接入模型构建内核
以下示例基于Python版Semantic Kernel接入Azure OpenAI大模型的基础流程。通过KernelBuilder创建内核构建器,并以部署名称、服务地址和 API 密钥为参数注册 AzureChatCompletion服务,最后调用build()生成内核实例。该内核是后续调用语义函数、插件和规划器的运行基础,相当于AI应用的引擎。
import semantic_kernel as sk
from semantic_kernel.connectors.ai.open_ai import AzureChatCompletion

# 初始化内核构建器
kernel_builder = sk.KernelBuilder()

# 接入Azure OpenAI大模型服务
kernel_builder.add_service(
    AzureChatCompletion(
        deployment_name="gpt-35-turbo",
        endpoint="你的Azure地址",
        api_key="密钥"
    )
)

# 生成内核实例
kernel = kernel_builder.build()
所有后续插件加载、函数调用,都依赖这个kernel对象。整个应用建议全局复用同一个Kernel实例,避免重复创建造成资源浪费。
2. Plugin(插件)
插件是 SK 中功能组织单元,一组关联性强的函数可以封装为一个插件。一个插件可以同时包含多个语义函数与原生函数。设计思想类似程序中的模块,插件机制实现功能解耦,按需加载。例如:
- DocumentPlugin负责文档处理;
- WeatherPlugin负责天气查询;
- FilePlugin负责本地文件读写。
两种插件定义方式:
- 1. 语义插件:使用文件夹存放提示词模板(config.json 提示词配置 + skprompt.txt 提示词正文),Kernel直接从目录加载,无需硬编码提示词;
- 2. 原生插件:普通Python/C# 类,使用装饰器标记函数,Kernel自动扫描注册为可调用函数。
示例:原生插件简单应用
该示例展示了Semantic Kernel中自定义插件的创建与注册流程。先导入kernel_function装饰器,定义 WeatherPlugin 类,用@kernel_function将get_weather方法标记为可被大模型调用的语义函数,并附带功能描述。方法内部模拟调用天气接口返回字符串。最后通过kernel.add_plugin 将插件实例以 "Weather" 为名注册到内核,使大模型在对话中可按需自动调用该函数获取实时数据。
from semantic_kernel.functions import kernel_function

class WeatherPlugin:
    @kernel_function(description="查询指定城市天气")
    def get_weather(self, city: str) -> str:
        # 模拟接口调用
        return f"{city} 当前气温26℃,多云"

# 将插件加载到内核
kernel.add_plugin(WeatherPlugin(), plugin_name="Weather")
加载完成后,内核可以通过Weather-get_weather格式调用该函数,大模型规划器也能够自动识别函数描述,按需调用。
3. Function(函数)
SK内一切可被调度执行的单元统称为 KernelFunction,分为两类:
3.1 语义函数 SemanticFunction
本质是封装好的提示词模板,执行时将变量填充进提示词,发送给大模型获取结果。 支持配置参数:最大生成长度、温度 top_p、系统提示词等。 目录形式组织语义函数目录结构标准:
项目目录结构:
Plugins/
└── SummaryPlugin/
    └── TextSummary/
        ├── skprompt.txt    # 提示词模板
        └── config.json     # LLM推理参数配置
skprompt.txt 示例:
请对下面文本进行精炼总结,控制在100字以内:
{{$input}}
config.json 示例:
{
  "max_tokens": 300,
  "temperature": 0.3
}
内核一行代码加载整个插件目录:
kernel.add_plugin_directory("./Plugins", plugin_parent_directory=".")3.2 原生函数 NativeFunction
普通编程语言函数,不经过大模型,直接本地运行,用来补齐大模型不具备的工具能力。两类函数对外调用形式完全一致,内核统一调度,使用过程中无需区分。
4. Context Variables(上下文变量)
执行函数时依靠上下文传递数据,上下文变量采用键值结构。
- $input:默认内置变量,作为函数输入;
- 支持自定义变量 {{$name}}、{{$time}} 在提示词模板中直接引用。
示例:调用插件执行摘要
通过异步调用已注册插件中的语义函数的流程:
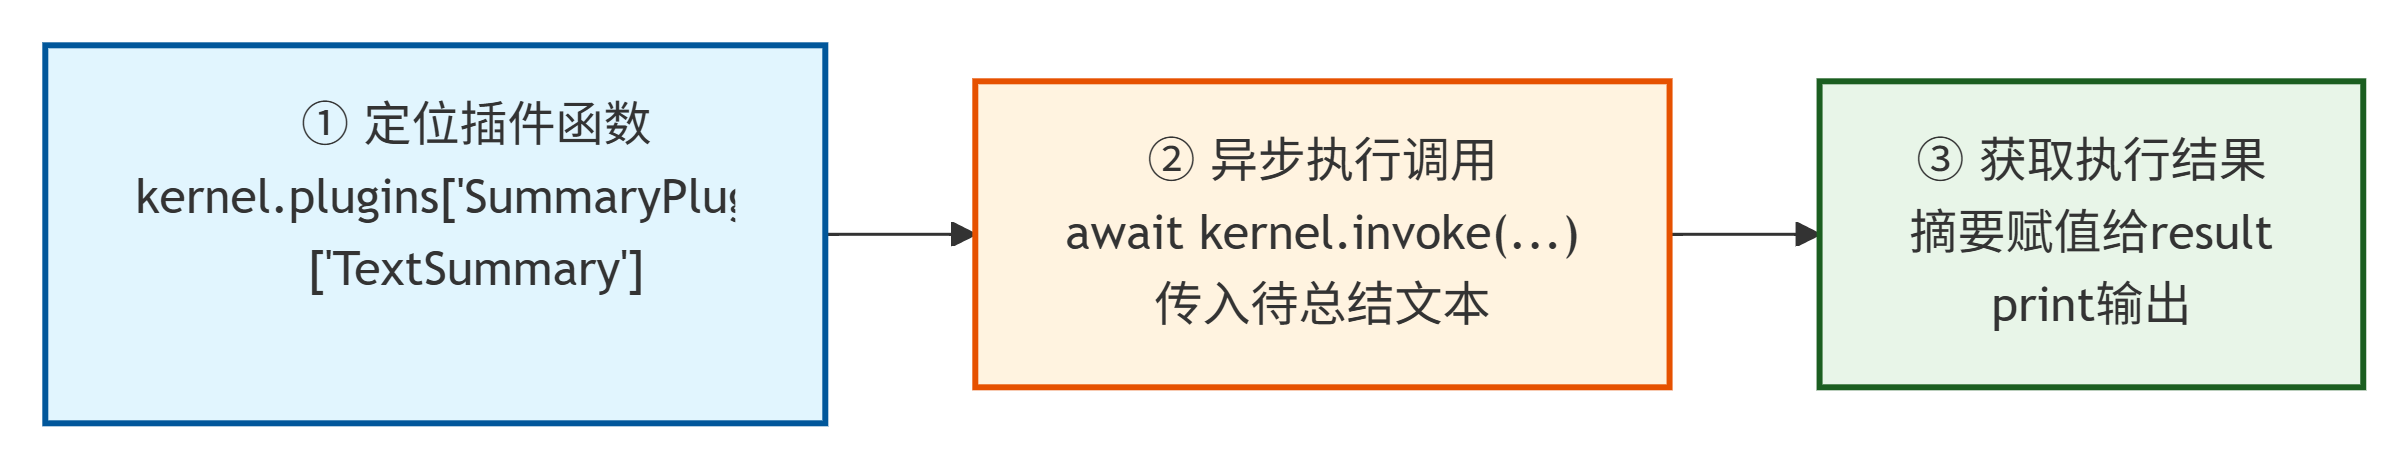
- 首先通过 kernel.plugins["SummaryPlugin"]["TextSummary"] 以字典方式定位到SummaryPlugin插件下的TextSummary函数;
- 再使用 await kernel.invoke(...) 异步执行该函数,并将 "待总结的长文本内容" 作为input参数传入。
- 执行完成后,函数返回的摘要结果被赋值给result变量,最后通过print(result)输出到控制台。
result = await kernel.invoke(
    kernel.plugins["SummaryPlugin"]["TextSummary"],
    input="待总结的长文本内容"
)
print(result)
5. Memory(记忆组件)
Memory是SK内置用于存储信息、实现检索增强的核心模块,分为两大形态:
- 短期记忆:单次对话上下文,保存在会话中,程序重启丢失;
- 长期记忆:文本向量化存入向量存储,支持语义相似度检索,用来构建知识库 RAG。
SK抽象了Memory Store标准接口,内置内存向量库用于测试,生产环境可对接Chroma、Pinecone、Redis Vector、Azure AI Search。
示例:基础记忆写入与检索
完整展示在Semantic Kernel中内存向量存储的完整流程:
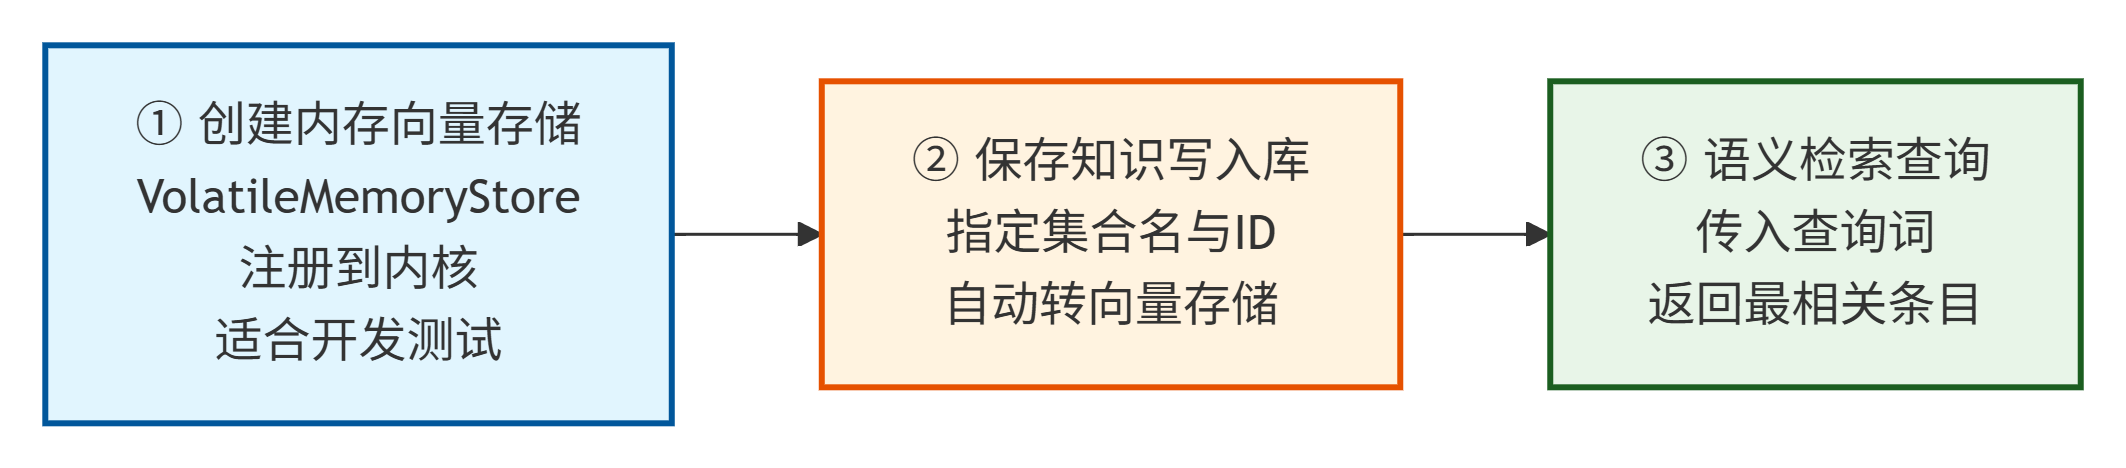
- 首先通过VolatileMemoryStore创建一个基于内存的向量存储实例并注册到内核,该存储运行在 RAM中、速度快但非持久化,适合开发测试阶段。
- 接着调用save_information将一条公司知识以指定集合名和ID写入知识库,框架会自动将文本转为向量存储。
- 最后通过 search 方法传入查询词"下班时间"进行语义检索,框架会计算向量相似度,返回与查询语义最相关的知识条目,实现类似 RAG 的检索增强生成基础能力。
# 使用内存向量存储
from semantic_kernel.memory import VolatileMemoryStore

memory = VolatileMemoryStore()
kernel.add_memory(memory)

# 写入知识库
await kernel.memory.save_information(
    collection="company_knowledge",
    id="info001",
    text="公司上下班时间为9:00-18:00,午休一小时"
)

# 语义检索
results = await kernel.memory.search("company_knowledge", "下班时间")
6. Planner(规划器)
Planner是实现简易Agent的核心组件。当用户需求复杂,需要连续调用多个插件函数完成任务时,规划器会让大模型自动拆解任务、生成执行计划。
举个例子:用户提问 “查询杭州天气,然后写一段适合出行的朋友圈文案”。 规划器自动拆解两步:
- 1. 调用 Weather-get_weather 获取杭州天气;
- 2. 将天气结果传入文本生成函数,生成文案。
SK提供多种规划器:BasicPlanner、SequentialPlanner、FunctionCallingPlanner。现阶段推荐使用FunctionCallingPlanner,依托大模型原生Function Call能力,稳定性更高。
四、基础应用实战
1. 开发环境准备
我们采用Python版本Semantic Kernel进行演示。
环境依赖安装
pip install semantic-kernel2. 示例1:异步调用插件翻译
目标:构建文本翻译语义函数,输入中文自动翻译成英文。 新建目录结构:
Plugins/ └── TranslatePlugin/ └── ZhToEn/ ├── skprompt.txt └── config.json
skprompt.txt完整内容:
你是专业翻译,将用户输入中文准确翻译成英文,不要额外输出解释。
输入内容:{{$input}}
config.json大模型参数配置
{
  "temperature": 0,
  "max_tokens": 200
}
完整运行代码:
基于Semantic Kernel框架的完整异步应用流程,整个流程串联了内核构建、插件加载、函数调用三个核心环节:
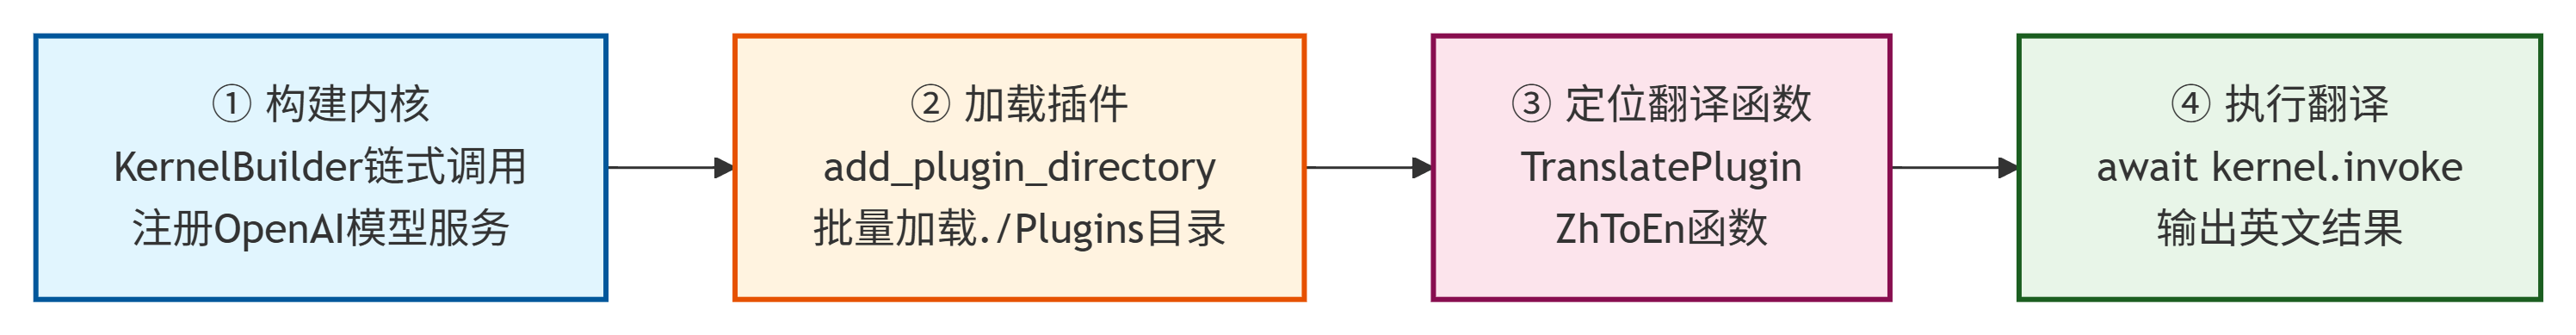
- 首先通过KernelBuilder链式调用注册OpenAI的模型服务并构建内核;
- 接着用add_plugin_directory从本地./Plugins目录批量加载插件;
- 然后通过字典方式定位到TranslatePlugin下的ZhToEn 翻译函数;
- 最后使用await kernel.invoke(...)异步执行该函数,将中文文本翻译为英文并打印结果。
import asyncio
import semantic_kernel as sk
from semantic_kernel.connectors.ai.open_ai import OpenAIChatCompletion

async def main():
    # 构建内核
    kernel = sk.KernelBuilder()\
        .add_service(
            OpenAIChatCompletion(
                model_id="gpt-3.5-turbo",
                api_key="你的OpenAI Key"
            )
        ).build()

    # 加载插件目录
    kernel.add_plugin_directory(plugin_directory="./Plugins")

    # 获取翻译函数
    translate_func = kernel.plugins["TranslatePlugin"]["ZhToEn"]

    # 执行调用
    result = await kernel.invoke(translate_func, input="人工智能正在改变软件开发方式")
    print(result)

if __name__ == "__main__":
    asyncio.run(main())
运行后输出对应英文翻译。通过这个示例可以看到:提示词和代码分离,后续修改翻译规则只需要修改skprompt.txt,不需要改动业务代码。
3. 示例2:插件对话自动调用
我们实现天气查询原生插件,让大模型自主调用工具获取信息。 实现Semantic Kernel中插件与对话结合实现自动函数调用的完整流程,整个过程实现了"用户提问→模型判断→自动调用工具→返回结果"的Agent式交互链路:
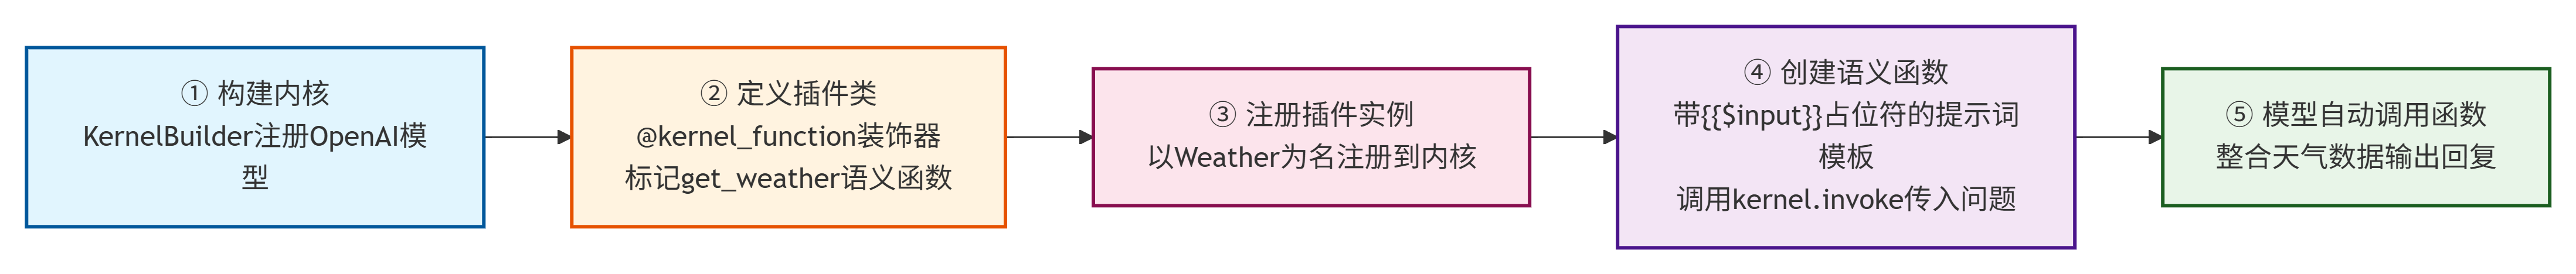
- 首先通过KernelBuilder注册OpenAI的模型构建内核;
- 然后定义WeatherPlugin类,用@kernel_function装饰器将get_weather方法标记为可被模型调用的语义函数,内部以字典模拟天气接口返回数据;
- 接着将插件实例以"Weather"为名注册到内核;
- 最后通过create_semantic_function创建带{{$input}}占位符的提示词模板,调用kernel.invoke传入用户问题"杭州今天天气怎么样?";
- 模型会根据问题语义自动识别并调用get_weather 函数,将返回的天气数据整合到对话回复中输出。
import asyncio
import semantic_kernel as sk
from semantic_kernel.connectors.ai.open_ai import OpenAIChatCompletion
from semantic_kernel.functions import kernel_function

class WeatherPlugin:
    @kernel_function(description="根据城市名称查询天气情况")
    def get_weather(self, city: str) -> str:
        """模拟天气接口"""
        data = {
            "杭州": "28℃,晴",
            "北京": "24℃,小雨",
            "上海": "27℃,多云"
        }
        return data.get(city, f"暂无{city}天气数据")

async def main():
    kernel = sk.KernelBuilder()\
        .add_service(OpenAIChatCompletion(
            model_id="gpt-3.5-turbo",
            api_key="你的密钥"
        )).build()

    # 注册原生插件
    kernel.add_plugin(WeatherPlugin(), "Weather")

    # 直接对话,启用函数调用
    prompt = """
    根据用户问题,如果需要天气信息,请调用工具。
    用户问题:{{$input}}
    """
    weather_chat = kernel.create_semantic_function(prompt, temperature=0)

    res = await kernel.invoke(weather_chat, input="杭州今天天气怎么样?")
    print(res)

if __name__ == "__main__":
    asyncio.run(main())
执行流程:大模型识别需要天气数据,调用get_weather,拿到结果后整合自然语言回答用户。
4. 示例3:基于Memory知识库问答
利用SK内置Memory搭建最小可行知识库问答,实现检索增强,基于Semantic Kernel框架的完整RAG流程:

- 首先通过KernelBuilder链式注册OpenAI的对话模型与text-embedding-ada-002向量嵌入模型并构建内核;
- 接着用VolatileMemoryStore初始化内存向量库,通过save_information将两条公司制度文本写入 staff_rule集合;
- 然后以"几点上班?"为查询词调用memory.search进行语义检索,将返回的匹配文本拼接为上下文;
- 最后构造包含参考资料与用户问题的RAG提示词,通过invoke_prompt异步调用大模型生成回答,实现"先检索知识库、再基于检索结果生成回答"的RAG完整链路。
import asyncio
import semantic_kernel as sk
from semantic_kernel.connectors.ai.open_ai import OpenAIChatCompletion, OpenAIEmbedding
from semantic_kernel.memory import VolatileMemoryStore

async def main():
    kernel_builder = sk.KernelBuilder()
    # 对话模型
    kernel_builder.add_service(
        OpenAIChatCompletion(model_id="gpt-3.5-turbo", api_key="密钥")
    )
    # 向量嵌入模型
    kernel_builder.add_service(
        OpenAIEmbedding(model_id="text-embedding-ada-002", api_key="密钥")
    )
    kernel = kernel_builder.build()

    # 初始化内存向量库
    memory_store = VolatileMemoryStore()
    kernel.add_memory(memory_store)

    # 写入知识库
    await kernel.memory.save_information(
        collection="staff_rule",
        id="rule1",
        text="公司工作日上班时间9点,下班18点,周末双休"
    )
    await kernel.memory.save_information(
        collection="staff_rule",
        id="rule2",
        text="请假需要提前在OA系统提交审批"
    )

    # 用户问题,先检索知识库
    query = "几点上班?"
    search_result = await kernel.memory.search("staff_rule", query, limit=2)
    context_text = "\n".join([item.text for item in search_result])

    # 将检索结果送入大模型回答
    rag_prompt = f"""
    根据下面参考资料回答用户问题,资料不存在的内容不要编造。
    参考资料:
    {context_text}
    用户问题:{query}
    """
    answer = await kernel.invoke_prompt(rag_prompt)
    print(answer)

if __name__ == "__main__":
    asyncio.run(main())
五、规划器与简易Agent开发
1. Planner工作原理
当用户需求无法通过单次函数完成,需要多步骤协作时,就需要规划器。规划器接收用户目标,结合所有已加载插件函数描述,生成有序执行方案,内核按方案分步执行,并把上一步输出传递给下一步输入。
- 早期SequentialPlanner依靠提示词让模型手写计划文本,稳定性较差;
- FunctionCallingPlanner依托大模型原生函数调用能力,错误率更低,是目前首选方案。
规划执行流程:

- 1. 用户输入目标;
- 2. Planner向大模型提供所有可用插件函数清单;
- 3. 大模型判断是否需要调用工具、调用顺序;
- 4. Kernel执行对应函数,获取返回值;
- 5. 返回值回传给大模型,继续后续步骤直至任务完成。
2. Planner实践示例
示例实现了Semantic Kernel中规划器自动编排复合任务的流程:
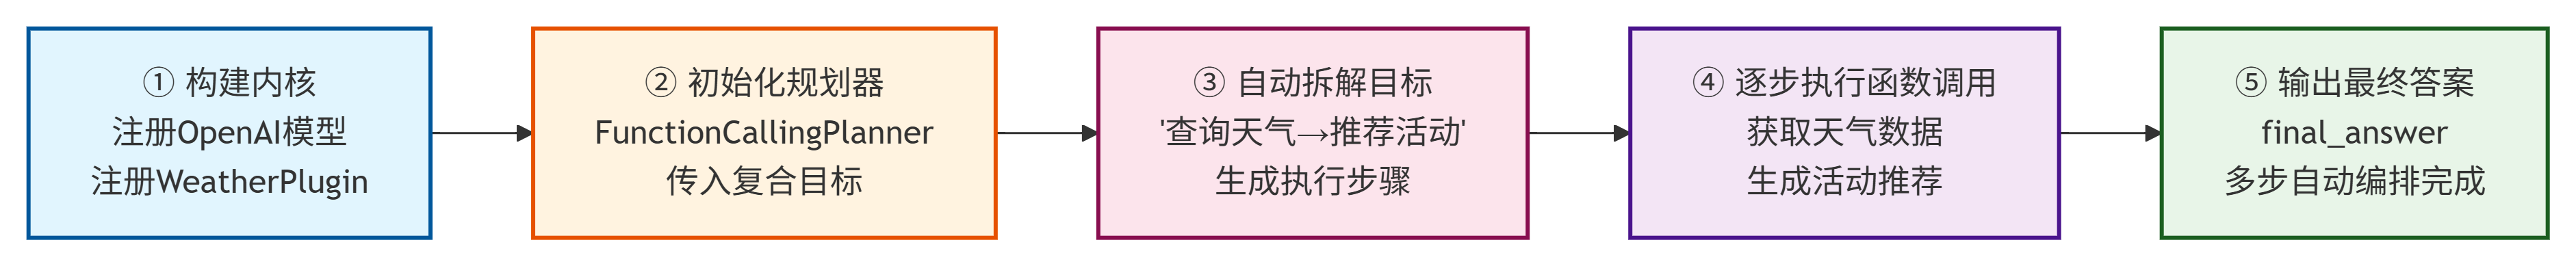
- 首先注册OpenAI对话模型构建内核,并定义WeatherPlugin插件注册到内核;
- 接着初始化FunctionCallingPlanner规划器,传入用户复合目标"查询杭州天气,根据天气推荐户外活动"。
- 规划器会自动分析目标,拆解为"调用天气插件获取数据→基于返回结果生成活动推荐"的执行步骤,依次调用相关函数完成整个任务链;
- 最终输出final_answer,实现从单一函数调用到多步自动编排的能力升级。
import asyncio
import semantic_kernel as sk
from semantic_kernel.connectors.ai.open_ai import OpenAIChatCompletion
from semantic_kernel.functions import kernel_function
from semantic_kernel.planners import FunctionCallingPlanner

class WeatherPlugin:
    @kernel_function(description="查询城市天气")
    def get_weather(self, city: str) -> str:
        map_data = {"杭州":"28℃ 晴天","北京":"24℃ 小雨"}
        return map_data.get(city, "暂无数据")

async def main():
    kernel = sk.KernelBuilder()\
        .add_service(OpenAIChatCompletion(model_id="gpt-3.5-turbo", api_key="密钥"))\
        .build()
    kernel.add_plugin(WeatherPlugin(), "Weather")

    # 初始化规划器
    planner = FunctionCallingPlanner(kernel)

    # 用户复合需求
    goal = "查询杭州天气,根据天气推荐适合开展的户外活动"
    result = await planner.invoke(goal)
    print(result.final_answer)

if __name__ == "__main__":
    asyncio.run(main())
3. Planner注意事项
- 函数description描述必须清晰准确,大模型依靠描述判断何时调用;
- 控制插件数量,一次性加载过多函数会超出模型上下文窗口;
- 复杂业务建议增加校验逻辑,防止大模型生成错误执行计划;
- 高稳定性场景不要完全依赖规划器,关键流程可以预设链式执行方案兜底。
六、应用实践优化总结
1. 提示词工程最佳实践
- 语义函数统一使用文件化管理,禁止代码内硬编码长提示词;
- 区分系统提示词与用户输入,通过模板变量隔离;
- 推理参数固化到config.json,方便调参对比;
- 重要业务增加输入输出长度限制,避免上下文溢出。
2. 性能与资源优化
- Kernel全局单例复用,不要循环重复创建;
- 向量检索做好分页、TopK 限制,减少嵌入计算开销;
- 区分测试内存向量库与生产持久化向量库;
- 频繁调用场景增加结果缓存,减少大模型请求次数。
3. 安全与稳定性
- 用户输入做好过滤,防范提示词注入风险;
- 增加超时、重试机制,封装大模型调用异常捕获;
- 对原生函数做好参数校验,避免大模型传入非法参数;
- 关键业务增加日志记录:用户输入、函数调用记录、模型返回结果,方便问题排查。
4. 模型切换适配
- 业务代码尽量不要硬编码特定模型参数,将模型配置抽离配置文件。
- 依托SK统一抽象接口,切换OpenAI、Azure、国产大模型时,仅修改Kernel的 Service配置,上层插件、函数逻辑无需改动。
七、总结
Semantic Kernel的核心定位:不是用来替代大模型 API,而是一套大模型业务开发的标准化工程框架。Kernel作为调度中枢,插件实现能力模块化拆分,语义函数管理提示词,原生函数补齐工具能力,记忆组件支撑知识库,规划器赋予大模型自主任务执行能力。
对于我们开发者而言,Semantic Kernel降低了AI应用开发的重复工作量:不用重复封装函数调用、不用从零实现向量检索、不用反复编写Agent任务编排逻辑。同时也要清楚框架边界:SK 只是应用层编排工具,无法解决大模型本身的幻觉、上下文长度限制等底层问题。落地项目时,应当结合业务复杂度选型:简单问答可以直接调用API;具备工具调用、知识库、多步骤任务场景,引入SK才能发挥最大价值。
未来大模型应用开发会更加标准化、插件化。掌握更多框架的设计思想,不仅可以快速开发 AI应用,也能够更好理解 Agent、工具调用、检索增强这类主流技术的底层协作逻辑。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号