AI医疗大模型工程实践:详解等保、HIPAA、GDPR与数据脱敏,医疗数据合规全流程24.7
原创
AI医疗大模型工程实践:详解等保、HIPAA、GDPR与数据脱敏,医疗数据合规全流程24.7
原创
未闻花名
发布于 2026-10-07 20:23:08
发布于 2026-10-07 20:23:08
一、前言
随着大模型技术快速普及,AI医疗已经从实验室原型走向真实业务场景。辅助问诊、影像报告解读、电子病历摘要、临床科研问答,各类大模型医疗应用层出不穷。在医疗行业我们不仅要注重模型的效果调优,更要注意医疗行业更重要的数据合规性。
医疗数据属于高度敏感的个人健康信息,一旦泄露,不仅会造成用户隐私泄露,还会触发国内外严苛的法律处罚。国内要满足网络安全等级保护要求,出海业务还要面对HIPAA、GDPR等海外法规约束,数据脱敏更是所有AI医疗项目绕不开的基础工程。
在实际应用中,我们通常避免调用公有大模型API,数据做简单掩码,就算完成合规。现实项目里,这种做法往往存在大量漏洞。比如病历只隐藏姓名身份证,但保留住址、就诊记录、疾病史,依然可以反向定位到具体患者;跨境传输医疗数据,直接将原始病历送入海外大模型接口,直接触碰法规红线;系统没有做好等保建设,模型推理日志随意存储患者信息,上线之后面临整改、罚款甚至项目叫停。为了避免这些情况,我们结合实际案例,讲解等保、HIPAA、GDPR核心约束,同时详解数据脱敏技术方案,从而完整理解AI医疗大模型数据合规全貌,能够识别项目中的合规风险点,并且可以直接把方案思路复用到项目开发中。
二、AI医疗合规基础
1. 医疗数据分类
想要做好合规,第一步要分清我们处理的到底是什么数据。AI医疗场景的数据来源非常丰富,不同类别数据的合规约束等级差异巨大。
- 直接标识信息:可以直接定位到自然人。姓名、身份证号、手机号、家庭住址、医保卡号、就诊卡号。这类信息风险等级最高,法规管控最严格。
- 间接健康敏感信息:单独看无法定位到人,但是组合其他信息就可以还原患者身份。检验报告、诊断记录、手术史、用药记录、影像编号、出生日期、科室就诊时间。很多团队容易忽视这一类,仅仅删除姓名,就认为数据安全,实际上多字段组合依然可以唯一识别患者。
- 去标识化科研数据:经过脱敏处理,移除全部可识别身份字段,无法反向定位到个体。可以用于模型训练、算法科研,但是也要区分脱敏和匿名化,二者法律定义并不等同。
- 公开聚合统计数据:医院年度疾病统计报表,汇总后的发病率,不包含任何个体信息,合规限制最低。
在大模型场景,风险往往发生在数据流全链路:数据采集入库、数据集加工训练、Prompt输入推理、日志存储、模型微调、数据对外共享。任意一个环节泄露可识别信息,都会构成合规风险。
举一个真实项目常见例子:医生使用大模型辅助写病历,把完整电子病历粘贴进Prompt给到大模型API。原始病历包含患者姓名、手机号、完整病史。即便业务不保存返回结果,大模型服务商侧推理日志如果留存输入内容,就产生隐私泄露风险。这也是很多公有大模型不建议直接传入原始医疗数据的原因。
2. 合规核心目标
AI医疗项目做合规,不是单纯为了应付审核检查,核心要达成 4 个目标。
- 身份不可识别:尽可能避免任何方式通过数据集回溯到真实患者;
- 数据访问可控:谁可以读取医疗数据、训练数据,必须有权限管控,操作留痕审计;
- 传输存储安全:静态存储、网络传输过程中敏感医疗数据不被窃取;
- 满足法规约束:区分国内业务、海外业务,匹配对应等保、HIPAA、GDPR的硬性要求。
通常构建项目,优先考虑优化大模型准确率,等到项目准备上线,才发现合规不达标,数据集全部不能使用,需要重新处理数据,浪费大量研发周期。合规应该是AI医疗项目的重要工作,在需求设计阶段就纳入架构设计,而不是后期补丁修补。
3. AI医疗数据流示例
下面给出简化的AI问诊大模型数据流主要处理示例,帮助理解数据流转路径,方便定位风险点位。
# AI辅助问诊数据流(风险标注)
def doctor_assist_chat(original_patient_record:dict):
    # original_patient_record:原始电子病历【高风险:包含身份+健康信息】
    desensitized_data = medical_data_desensitize(original_patient_record) # 脱敏处理
    llm_prompt = build_prompt(desensitized_data) # 构造大模型输入
    llm_result = llm_remote_api.call(llm_prompt) # 调用大模型推理
    save_audit_log(desensitized_data) # 留存审计日志,禁止存储原始病历
return llm_result风险点提示:如果此处传入original_patient_record直接调用大模型,整个流程直接出现合规漏洞;日志如果保存原始完整病历,同样属于高危操作。
三、等保合规要求
1. 等保基础概念
网络安全等级保护,简称等保,是国内所有涉及患者信息医疗信息系统必须遵守的制度。医疗行业业务系统,绝大多数要求等保2.0三级。这里在我们实际执行场景中,会遇到有类似的误解,认为等保只是后端运维的事情,和大模型算法无关。实际并不是,大模型应用系统属于完整业务系统,算法模块、数据集存储、模型服务接口,全部纳入等保测评范围。
等保2.0三级,针对医疗信息系统,重点覆盖五大维度:物理环境安全、网络通信安全、设备主机安全、应用系统安全、数据安全。AI 大模型项目最需要聚焦的是应用安全与数据安全两个部分。
在实际AI项目中我们也曾遇到过:
- 模型服务API没有做访问鉴权;
- 训练数据集随意存放在普通云服务器;
- 推理日志无限制存储患者敏感内容;
- 没有操作审计日志;
- 数据集没有备份与防篡改机制。
这些都会在等保测评中判定为高风险缺陷。
2. AI模块合规约束
针对大模型医疗业务,提取等保三级中高频落地要求:
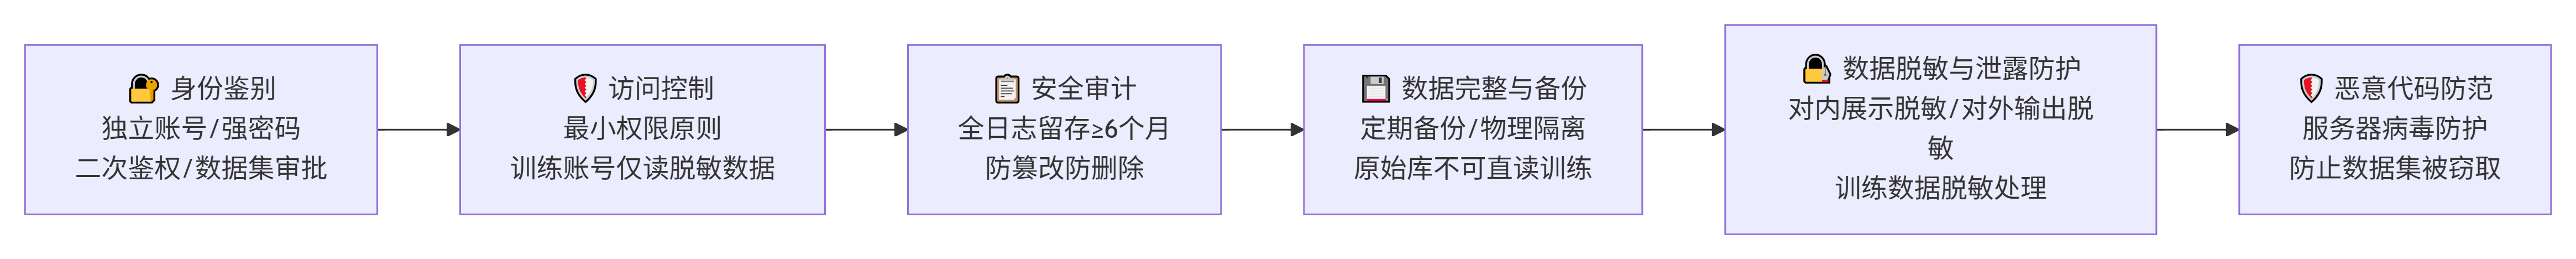
- 1. 身份鉴别:访问模型后台、数据集仓库、大模型推理服务,不能公用账号。每个操作人员独立账号,强密码策略,关键操作二次鉴权。算法人员下载医疗数据集需要单独审批。
- 2. 访问控制:最小权限原则。开发人员不应该拥有全部患者数据集完整读取权限;训练任务账号仅允许读取脱敏数据集,禁止访问原始病历库。
- 3. 安全审计:全部关键操作留日志。谁调用大模型接口、什么时间、输入输出摘要、数据集导出操作,日志留存不少于6个月。日志本身也要保护,禁止被篡改删除。
- 4. 数据完整性与备份:医疗数据集定期备份,防止丢失篡改;原始业务库与训练数据集物理或者逻辑隔离。原始病历库不能直接供给大模型训练读取。
- 5. 数据脱敏与泄露防护:系统内部,原始敏感字段展示必须脱敏;对外输出、给到大模型训练、对外共享,必须执行脱敏处理。
- 6. 恶意代码防范:部署大模型推理服务的服务器做好病毒防护,防止数据集被窃取。
这里需要注意的是,大模型本身的Prompt注入风险,也属于应用安全风险。破坏者会构造恶意Prompt诱导大模型输出记忆的患者信息,属于等保需要考虑的安全威胁。
3. 权限控制示例
以下是一个权限控制简单示例,模拟数据集访问鉴权逻辑,体现最小权限思想。运行结果会抛出权限异常,禁止训练任务触碰原始医疗数据。这就是等保要求的最小权限,不要为了开发方便给全部账号开放最高权限。
# 模拟数据集访问鉴权逻辑 等保最小权限思想
ACCESS_ROLE = {
    "dev": ["read:desensitized_dataset"], # 开发:仅可读脱敏数据集
    "data_admin": ["read:raw_medical","export:dataset"], # 数据管理员可读取原始数据
    "algorithm_train": ["read:desensitized_dataset"] #训练任务账号,只能访问脱敏数据
}

def check_data_permission(user_role:str, operate:str):
    allow_ops = ACCESS_ROLE.get(user_role,[])
    if operate in allow_ops:
        return True
    raise PermissionError(f"角色{user_role}无权限执行{operate}")

# 测试:算法训练账号,尝试读取原始病历会直接拦截
try:
    check_data_permission("algorithm_train","read:raw_medical")
except PermissionError as e:
    print(e)
等保不是一张证书就万事大吉,是系统持续运行过程的安全能力。拿到等保测评之后,如果后续迭代大模型业务新增接口、新增数据集链路,依然需要持续保障安全能力。很多项目拿证之后架构改动,合规能力退化,后续复查出现问题。
四、HIPAA 与 GDPR
1. HIPAA核心要点
HIPAA是美国健康保险流通与责任法案,如果你的AI医疗产品面向美国用户,或者处理美国患者健康信息PHI,就必须遵守HIPAA。PHI即受保护健康信息,是HIPAA的核心对象。PHI包含可以识别个人的全部健康记录:姓名、病历、检验结果、就诊记录、影像资料等。
HIPAA有两个关键角色:Covered Entity(受约束实体,医疗机构)、Business Associate(业务合作方,比如大模型服务商、云服务商)。如果我们调用第三方大模型API处理美国患者 PHI数据,那么大模型厂商就属于BA,双方必须签署BAA业务合作协议。没有签署BAA,直接把 PHI传入普通大模型 API,属于严重违规。国内很多公有大模型默认不支持BAA协议,这是出海AI医疗项目容易遇到的问题。
HIPAA关键约束:
- PHI数据使用、传输必须最小必要,能不用就不用;
- PHI存储传输必须加密;
- 所有访问 PHI 操作完整审计日志;
- 发生数据泄露事件有强制上报流程;
- 如果使用第三方大模型处理PHI,必须签订BAA协议。
这里需要提醒的是,不是做了数据脱敏就万事大吉。HIPAA规定,只有完整移除全部18类PHI 标识符之后,数据才不再被定义为PHI,不再受HIPAA约束。只掩码部分字段,剩下的组合仍然可以定位到人,依旧属于PHI范畴。
2. GDPR核心要点
GDPR是欧盟通用数据保护条例,面向欧盟地区用户的AI医疗项目适用。医疗健康数据在GDPR中属于特殊类别个人数据,管控等级远高于普通用户数据。
GDPR 医疗场景关键规则:
- 合法处理基础:处理患者健康数据,必须具备明确合法基础,获取用户明确授权;授权不能捆绑其他服务,用户可以随时撤回授权。
- 数据最小化:大模型Prompt里面,只放入业务必需的信息,不要把一整本完整病历全部丢给模型。例如仅需要判断用药风险,就不要传入患者全部过往几十年就诊记录。
- 数据主体权利:患者有权查看自己哪些数据被用于大模型训练;有权要求删除自己的医疗数据,也就是被遗忘权。AI医疗项目需要设计流程,支持从训练数据集剔除指定患者数据。
- 数据跨境传输:欧盟医疗数据不可以随意传输到欧盟以外国家,需要满足跨境传输法定机制。直接把欧盟患者病历发送到国内大模型服务,属于违规。
- 泄露通知:一旦发生个人健康数据泄露,72小时之内需要向监管机构上报。
对于大模型微调场景,GDPR带来现实工程难题:用户行使被遗忘权,要求删除自己的数据。如果这条数据已经参与大模型微调,模型权重已经学习该信息,无法简单删除单条样本。行业现有方案包括:记录训练样本索引,必要时做模型遗忘、重新微调,前期尽量使用高度脱敏数据集训练。
3. 法规对比示例
这里简单对比三者核心关注点,方便快速区分:
- 等保 2.0 三级(国内):侧重系统安全、权限、审计、存储备份,管控信息系统本身安全能力;
- HIPAA(美国):聚焦 PHI 健康信息,重点 BAA 协议,去除 18 类标识符;
- GDPR(欧盟):侧重用户个人权利,授权、被遗忘权、跨境传输限制。
应用实践示例:
模拟数据最小化 Prompt 裁剪。业务需求:大模型评估用药禁忌,不需要患者姓名、住址。
# GDPR数据最小化:裁剪多余字段,只保留业务必需信息
raw_phr = {
    "name":"张三",
    "phone":"138xxxx",
    "address":"XX市XX街道",
    "age":45,
    "diagnosis":["高血压"],
    "drug_history":["硝苯地平"]
}
# 仅保留推理必要字段,其余全部剔除
minimal_input = {k:raw_phr[k] for k in ["age","diagnosis","drug_history"]}
prompt = f"""根据患者情况评估用药风险:{minimal_input}"""
print(prompt)
输出prompt中完全去掉姓名、地址这类非必要字段,落实GDPR数据最小原则。这里需要注意写Prompt不能直接塞完整原始 JSON,完全不做字段裁剪,带来不必要合规风险。
五、医疗数据脱敏技术
1. 脱敏概念区分
在AI医疗项目,经常混淆三个名词:掩码、去标识化、匿名化,三者法律效果、技术强度完全不一样。
- 1. 掩码(遮蔽 mask):简单字符替换,手机号138****1234。只是界面展示隐藏,原始真实数据仍然保存在数据库。掩码不能作为对外输出、模型训练的脱敏方案,仅适合前端页面展示。
- 2. 去标识化(de‑identification):删除/扰动直接身份字段,仍然有可能通过多字段组合重识别患者。国内 AI 医疗训练大多使用去标识化数据。法律上,去标识化之后依旧认定为个人信息,依然需要合规管控。
- 3. 匿名化(anonymization):经过处理之后,在任何情况下都无法复原、无法定位到自然人。匿名化之后不再属于个人信息。但是医疗场景做到真正匿名化难度极高。
注意如果仅仅删掉姓名身份证,不等于匿名化。出生日期 + 性别 + 医院就诊时间三者组合,有很高概率唯一锁定特定患者。
数据脱敏分为静态脱敏、动态脱敏。
- 静态脱敏:提前批量处理数据集,产出脱敏后的数据集副本,用于大模型训练、科研。原始库不动。
- 动态脱敏:业务运行时实时处理,数据库查询、调用大模型接口的时候实时对输入内容脱敏,不修改原始数据库。AI 推理线上业务多用动态脱敏。
2. 常用脱敏算法
医疗场景常用脱敏手段,核心总结说明:
- 字段移除:直接删除姓名、身份证、医保号等标识字段,最简单有效。
- 部分掩码:前端展示使用,不建议用于训练数据集。
- 泛化:把精确信息改成模糊信息。例如精确出生日期1995‑03‑12泛化为1995年;精确地址 “XX 区 XX 街道” 泛化为 “XX市”。降低字段识别能力。
- 扰动噪声:数值增加合理噪声,检验指标数值轻微扰动,适合统计、模型训练。需要权衡:扰动不能破坏医疗数据业务可用性,不能让病历完全失去医学意义。
- 重排置换:对数据集内部字段打乱置换,切断记录和真实患者对应关系。
- 实体识别脱敏 (NER 脱敏):针对自由文本电子病历。病历文本是非结构化,里面混杂医生自然书写的姓名、地址。依靠大模型或者NER实体抽取识别出文本中的身份实体,做替换移除。这是AI医疗非常关键的技术。
非结构化电子病历文本是脱敏最大难点。结构化数据库字段很容易处理,但自由文本病历:“患者李四,家住杭州市余杭区,昨日来院就诊”。身份信息藏在自然语句里面,简单字段删除处理不到,必须文本实体脱敏。
3. 脱敏代码实操示例
下面提供简易的医疗文本脱敏示例,模拟NER识别敏感实体做替换。生产环境需要使用成熟医疗领域 NER 模型,这里演示逻辑思路。
import re

def medical_text_desensitize(text:str)->str:
    # 模拟敏感实体正则,生产环境替换为医疗NER大模型
    # 1.身份证
    text = re.sub(r"\d{17}[\dXx]","[身份证号]",text)
    # 2.手机号
    text = re.sub(r"1[3-9]\d{9}","[联系电话]",text)
    # 3.模拟姓名(生产用NER,正则仅演示)
    name_pattern = r"患者(.?),"
    text = re.sub(name_pattern,"患者[姓名],",text)
    return text

# 原始病历文本
raw_text = "患者李明,身份证3301061990xxxx1234,手机号13812345678,主诉持续头晕3天。"
result = medical_text_desensitize(raw_text)
print("脱敏后:",result)
输出结果:
脱敏后: 患者[姓名],[身份证号],[联系电话],主诉持续头晕3天。
注意:正则只能做演示,真实自由病历不要单纯依赖正则表达式。人名、地名表达方式千变万化,生产环境要使用医疗命名实体识别模型,识别文本内的 PER、LOC 等敏感实体再脱敏。
4. 脱敏效果评估
脱敏做完不等于万事大吉,必须做重识别风险评估。评估处理之后数据集,还有多大概率可以反向定位患者。
评估关注点:
- 是否保留高区分度组合字段:精确生日 + 就诊科室 + 就诊日期;
- 数据集是否可以和外部公开数据集做关联匹配;
- 自由文本病历内部,有没有残留被遗漏的身份实体。
很多项目做完脱敏直接投入训练,忽略重识别评估,留下巨大隐患,脱敏强度越高,隐私越安全,但医疗信息可能丢失,大模型训练效果下降。我们需要在隐私安全和模型可用性之间寻找平衡点。
六、大模型全链路合规架构
1. 完整数据流风险点
大模型医疗业务完整链路分为:数据采集存储、数据集加工、模型微调、线上推理服务、日志存储、数据对外共享。每个环节都存在合规风险。

- 原始数据存储层:原始电子病历,隔离保护,严格访问权限;原始数据禁止直接输送到大模型训练、推理。
- 数据集加工层:静态脱敏流水线,产出去标识化数据集;执行重识别风险评估;数据集元数据记录来源、脱敏版本。
- 模型训练微调层:训练仅使用脱敏数据集;做好训练任务访问审计;禁止PHI/HIPAA‑PHI进入微调样本。
- 线上推理服务层:
- 动态脱敏模块:用户/医生输入病历文本,送入大模型之前实时脱敏;
- Prompt 最小化:只传入必要字段;
- 如果调用第三方LLM:海外业务确认BAA协议;国内避免原始敏感外溢;
- 日志层:禁止完整保存原始患者Prompt;日志只保存脱敏摘要,日志审计加密留存;
- 数据输出共享:对外交付数据集,只能输出脱敏版本。
2. 两种部署模式合规对比
AI 医疗大模型一般两种部署方案,合规成本差异很大。
公有 API 调用模式:业务系统调用第三方公有大模型接口。
- 优点:研发快,不需要维护大模型算力;
- 合规难点:医疗敏感数据会流出自有系统;海外场景需要 BAA 协议;需要动态脱敏严格前置;需要确认服务商不会把输入数据用于模型训练。
私有化本地部署大模型:大模型权重部署在企业内网,数据不出本地机房。
- 优点:医疗数据不流出自有环境,极大降低数据传输泄露风险;
- 难点:算力成本高,需要自己维护模型推理服务,同时自身系统依旧要完成等保建设,不能认为私有化就等于全部合规。
私有化部署不等于天然合规。就算大模型跑在内网,如果权限混乱、日志随便存原始病历、没有审计,依旧违反等保以及相关法规。私有化解决数据不出域问题,但权限、审计、脱敏依旧需要完整落地。
3. 架构简易伪代码示例
以下示例实现线上推理完整链路,把动态脱敏嵌入完整请求链路。整条链路,原始敏感文本不会进入大模型、不会写入审计日志。所有对外、向模型输入全部使用脱敏之后内容。
def llm_medical_infer(raw_medical_text:str):
    # step1:动态脱敏
    safe_text = medical_text_desensitize(raw_medical_text)
    # step2:构造最小化prompt
    prompt = f"""基于下面病历给出辅助建议:{safe_text}"""
    # step3:内网私有大模型推理(也可为签署协议的第三方API)
    resp = local_private_llm.call(prompt)
    # step4:审计日志只记录脱敏内容,禁止raw_medical_text落库
    save_audit_log(content=safe_text)
    return resp

# 模拟请求
raw = "患者王某某,手机号13900001111,咳嗽发热5天,请给出辅助建议"
output = llm_medical_infer(raw)
七、常见问题总结
1. 遇到比较频繁问题
结合大量AI医疗项目实践,记录整理最容易出现的问题点,分点列出。
- 只删除姓名身份证,认为完成脱敏。保留精确生日、就诊时间,依然存在重识别风险。
- 直接把原始病历丢入公有大模型Prompt,不做任何动态脱敏。
- 认为私有化部署大模型,就万事大吉,忽略权限、审计、日志规范。
- 出海美国业务,直接传PHI给大模型,没有签署BAA协议。
- 日志完整保存用户全部Prompt原始内容,长期存储大量敏感医疗文本。
- GDPR场景,没有设计用户数据删除流程,训练数据集无法剔除指定患者样本。
- 等保只拿证书,业务迭代新增大模型接口,没有同步更新安全控制。
- 混淆去标识化与匿名化,误以为去标识化数据就完全不受法律约束。
2. 应用实践建议
针对AI医疗技术团队,给出可落地执行建议。
- 合规前置:项目立项阶段就引入合规评估,数据流图画出每一步数据流转,标记风险点。不要等到快要上线才处理合规。
- 分层治理:区分原始库、脱敏数据集。原始业务库和 AI 训练数据集物理 / 逻辑隔离。训练环境永远不要触碰原始病历库。
- 建立脱敏流水线:静态脱敏用于训练数据集;线上推理建设动态脱敏服务模块,作为大模型请求前强制必经关卡。
- 定期风险评估:定期做重识别风险测评;定期审计日志,检查是否出现敏感信息泄露。
- 区分业务地域:国内业务对标等保;美国业务确认BAA;欧盟业务关注授权、被遗忘权、跨境传输,不要一套方案跑全球。
- 技术 + 法务协同:技术负责工程实现,法务审核业务流程、协议条款。技术人员不要自己解读全部法条,和法务配合。
3. 原型阶段最小合规清单
通常我们早期做POC原型,资源有限,可以先落地最小合规清单,避免原型阶段就埋下严重风险:
- POC不要使用真实全量患者原始数据,优先使用模拟合成病历数据;
- 如果必须使用真实病历,必须使用经过去标识化处理数据集;
- POC环境同样做好账号权限,禁止公网暴露数据集;
- 禁止POC阶段直接把原始病历送入公有第三方大模型 API。
八、总结
AI医疗大模型拥有巨大价值,可以帮助医生减轻文书负担,辅助临床判断,助力医学科研。但医疗数据的特殊性决定了,技术效果只是项目的一半,合规能力是另一半生命线。林林总总的条条框框可能会束缚业务开发,但换一个角度,合规不是阻碍创新,而是项目的安全底座。如果忽略合规,再好的大模型算法效果,一旦发生隐私泄露、监管处罚,整个项目都可能直接归零。
AI医疗行业正在快速发展,相关法规标准也在持续迭代更新。信息系统也需跟随业务迭代持续维护数据安全能力。模型效果持续调优的同时,合规架构也要同步迭代。把合规思维融入数据处理、Prompt编写、数据集构建、系统架构每一处细节,才能让大模型真正安全落地医疗场景,发挥技术真正价值。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号