一个开发者的 AI 实战:用最少的提示词解决最头疼的报错
原创
一个开发者的 AI 实战:用最少的提示词解决最头疼的报错
原创
大盘鸡拌面
发布于 2026-10-08 18:41:18
发布于 2026-10-08 18:41:18
上周五下午五点半,我鼠标都摸到关机键了,群里弹出一句:"预发环境起不来,你快看一眼。"
干这行的都懂那种感觉。不是怕问题难,是怕那种"日志里明明写了原因,但你读完三遍还是不知道它在说啥"的问题。
我打开日志,看到这么一坨东西——
org.springframework.beans.factory.BeanCreationException:
Error creating bean with name 'orderController': Unsatisfied dependency expressed through field 'orderService';
nested exception is org.springframework.beans.factory.BeanCreationException:
Error creating bean with name 'orderServiceImpl' defined in file [.../OrderServiceImpl.class]:
Bean instantiation via constructor failed;
nested exception is org.springframework.beans.BeanInstantiationException:
Failed to instantiate [...OrderServiceImpl]: Constructor threw exception;
nested exception is java.net.ConnectException: Connection refused
第一行说的是 orderController。我当时就顺着 orderController 去翻,翻了半天。
但真正的原因压在最后一行:风控服务连不上。
也就是说,一个网络问题,被 Spring 套了四层壳之后,伪装成了一个"依赖注入失败"的问题。你要是不把堆栈拉到最后一行,你在前三行里能绕一整个下午。
这篇文章就想聊聊这件事:这两年我用 AI 查报错,最大的收获不是"它能帮我修 bug",而是我终于找到了一种方式,能用很少的提示词,让 AI 快速告诉我"这个报错到底在说什么"。
下面三个例子都是真事,代码我改过变量名,但问题本身一点没改。
一、先说个反常识的结论:提示词写长没用
我一开始用 AI 查报错,干的事跟大多数人一样——把报错贴进去,然后加一句"帮我看看怎么解决"。
结果特别稳定:它会给我列七八条可能性,从"检查依赖是否引入"到"确认配置文件路径",每一条都正确,每一条都没用。看完跟没看一样。
后来我慢慢发现一件事:AI 给你的建议质量,跟你写了多少字基本没关系,跟你有没有讲清楚三件事关系很大。
我现在查报错的提示词,稳定就三段,不超过两百字:
【第一段】我原本想让它发生什么
我启动 Spring Boot 服务,期望正常启动并注册 Bean。

【第二段】实际发生了什么(原文,别转述)
<把完整堆栈原文贴进来,一行不删>

【第三段】我已经试过什么
1. 检查过 OrderServiceImpl 的注解,@Service 是有的
2. 确认过 risk.internal 域名在预发容器里 ping 不通
3. 本地启动是好的
第三段是我后加的,也是最关键的一段。
为什么?因为 AI 不知道你试过什么。你不说,它就一定会把你已经试过的东西再讲一遍——你花了三十秒读完,发现"哦,这条我试过了",然后再读下一条,还是试过的。三段里有两段是废话。
把"我已经试过什么"写进去,等于直接砍掉它一半的输出,剩下的部分命中率高得吓人。
我现在基本就靠这三段打天下,很少写更长。写得长,反而容易把关键信息稀释掉。
二、实战一:那个伪装成"依赖注入失败"的网络问题
就是开头那个例子,我把完整场景说清楚。
出问题的代码
我们有个订单服务,启动的时候要把风控规则预先拉下来缓存住,免得每次下单都去问风控。当时是这么写的:
@Service
public class OrderServiceImpl implements OrderService {

    private final RiskClient riskClient;
    private final OrderMapper orderMapper;
    private Map<String, Rule> ruleCache;

    public OrderServiceImpl(RiskClient riskClient,
                            OrderMapper orderMapper,
                            @Value("${risk.endpoint}") String endpoint) {
        this.riskClient = riskClient;
        this.orderMapper = orderMapper;
        // 启动时先把规则全量拉下来,省得运行时再查
        this.ruleCache = riskClient.fetchRules(endpoint);
    }

    @Override
    public OrderDetail getDetail(String orderId) {
        Rule rule = ruleCache.get(orderId);
        return orderMapper.selectById(orderId, rule);
    }
}
本地跑一直好好的。上线到预发就起不来,因为预发容器访问风控服务的地址配错了。
我以前会怎么查
按我以前的习惯,看到 BeanCreationException 第一反应就是"Bean 没扫到"或者"循环依赖",然后开始走这条老路:
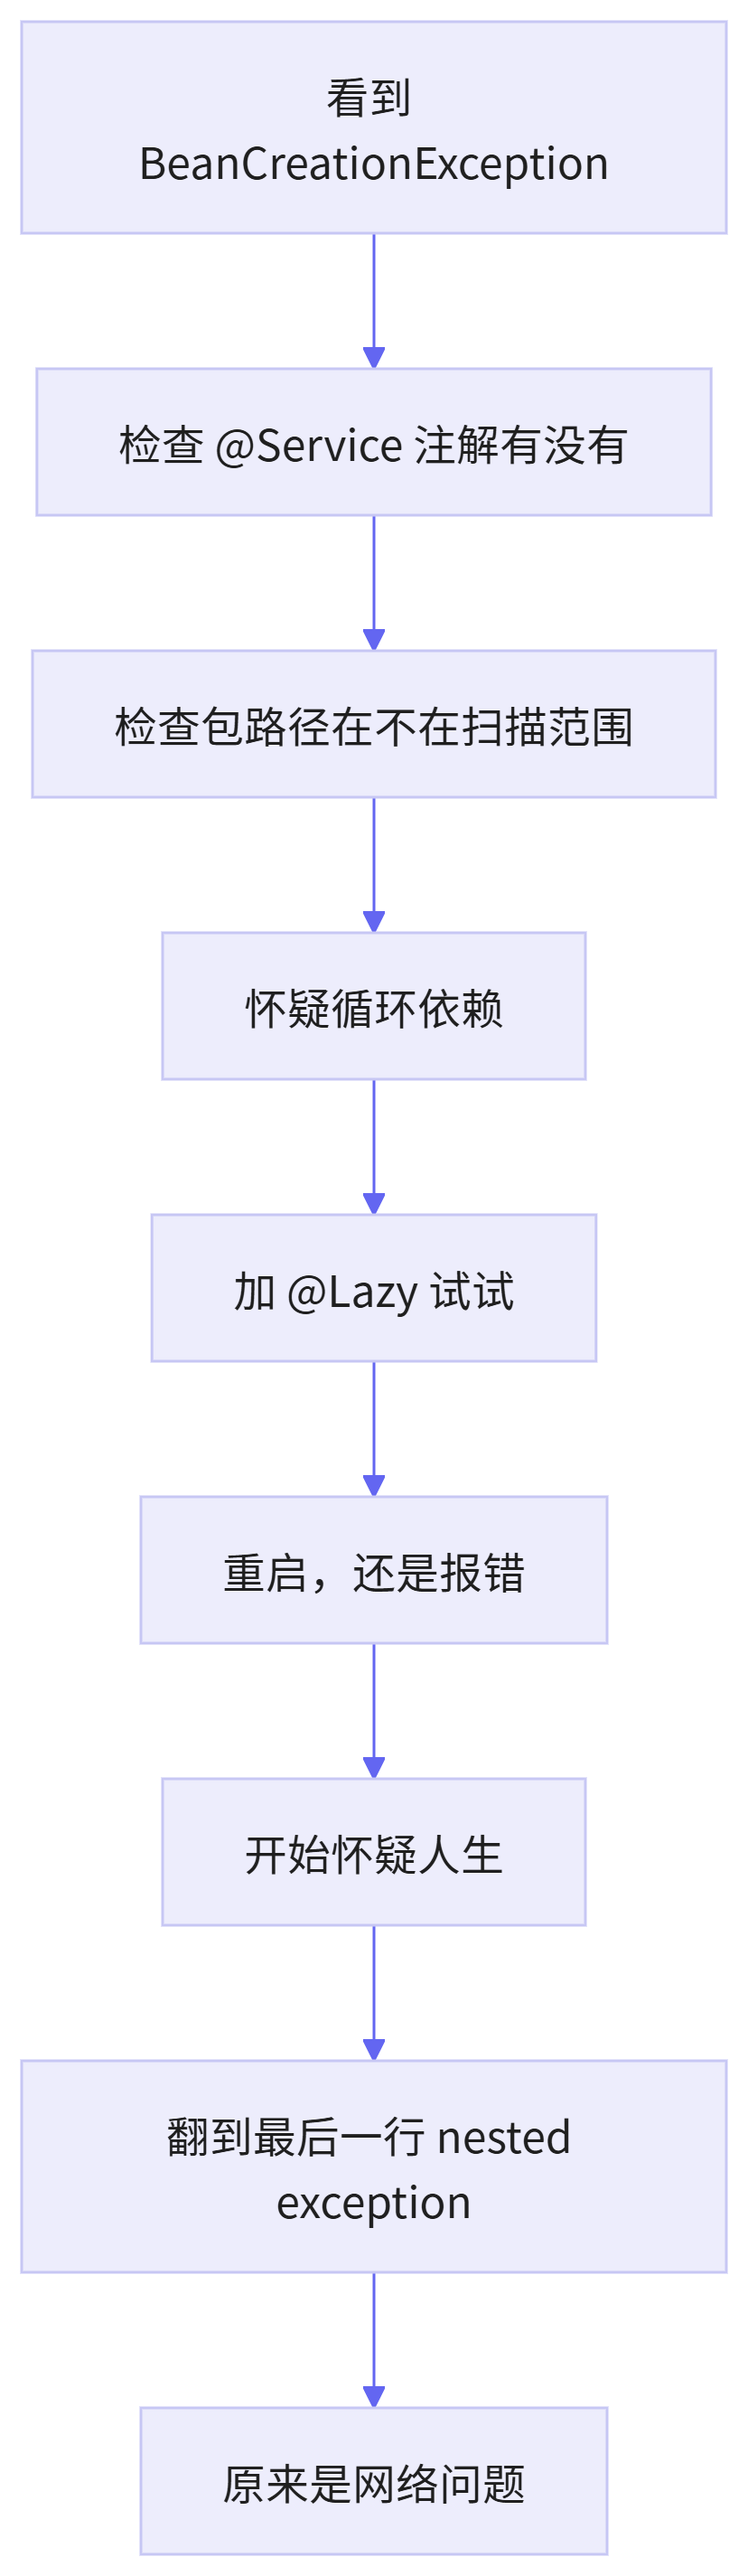
这条路我走过不下五次,每次都要绕到 H 才反应过来。因为人看堆栈的习惯是从上往下看,而 Java 异常的根因偏偏在最后。
现在怎么查
我把堆栈原文和那三段提示词丢给 AI,它第一句回的是:
根因不在依赖注入,在最内层异常:
nested exception is java.net.ConnectException: Connection refused

BeanCreationException 只是外层包装。真正的链路是:
OrderServiceImpl 构造器里调用了 riskClient.fetchRules(endpoint),
这是一个启动时的同步远程调用,下游连不上,构造器抛异常,
Spring 把它包装成了 Bean 创建失败。

你试过的第 2 条已经印证了这一点(预发 ping 不通 risk.internal)。
从贴进去到看到这段话,不到二十秒。
修法
真正的修复其实不是改配置,是不该在构造器里做远程调用。构造器失败 = Bean 创建失败 = 整个应用起不来,这个耦合太重了。
@Service
public class OrderServiceImpl implements OrderService {

    private final RiskClient riskClient;
    private final OrderMapper orderMapper;

    @Value("${risk.endpoint}")
    private String endpoint;

    private volatile Map<String, Rule> ruleCache = Collections.emptyMap();

    /** 启动后异步预热,失败不阻塞启动 */
    @PostConstruct
    public void warmUp() {
        try {
            this.ruleCache = riskClient.fetchRules(endpoint);
            log.info("风控规则预热完成,共 {} 条", ruleCache.size());
        } catch (Exception e) {
            log.warn("风控规则预热失败,启动继续,运行时降级为实时查询", e);
        }
    }

    @Override
    public OrderDetail getDetail(String orderId) {
        Rule rule = ruleCache.get(orderId);
        if (rule == null) {
            rule = riskClient.fetchOne(endpoint, orderId); // 兜底:实时查
        }
        return orderMapper.selectById(orderId, rule);
    }
}
这个改动本身我十分钟就写完了。真正吃时间的是前面那个"看懂报错在说什么"的过程——以前是半小时起,现在是二十秒。
三、实战二:偶发的 socket hang up,AI 帮我砍掉三个假方向
第二个例子换个技术栈,Node 的。
现象
我们有个 Node 写的 BFF 层,去调下游一个内部服务。上线之后偶发报错,一天几次,本地怎么压都复现不了:
Error: socket hang up
    at connResetException (node:internal/errors:704:14)
    at Socket.socketOnEnd (node:_http_client:518:23)
    at TLSSocket.emit (node:events:525:35)
调用代码长这样:
const http = require('http');

const agent = new http.Agent({ keepAlive: true, maxSockets: 100 });

async function callDownstream(path) {
  return new Promise((resolve, reject) => {
    const req = http.request(
      { host: 'risk.internal', port: 8080, path, method: 'GET', agent },
      (res) => {
        let body = '';
        res.on('data', (chunk) => (body += chunk));
        res.on('end', () => resolve(body));
      }
    );
    req.on('error', reject);
    req.end();
  });
}
我试过的三件事(全都白搭)
这里就是那段"我已经试过什么"的来源,我老老实实写了:
已经试过:
1. 给 req 加了 setTimeout(5000),没用
2. 加了三次重试,错误率下降但还是偶发
3. 把 maxSockets 从 100 调到 20,没用
如果我不写这三条,AI 大概率会回我一句"建议增加超时和重试机制"——我试过了,而且没用。
AI 给的方向
它直接跳过了这三个方向,给了这么一段:
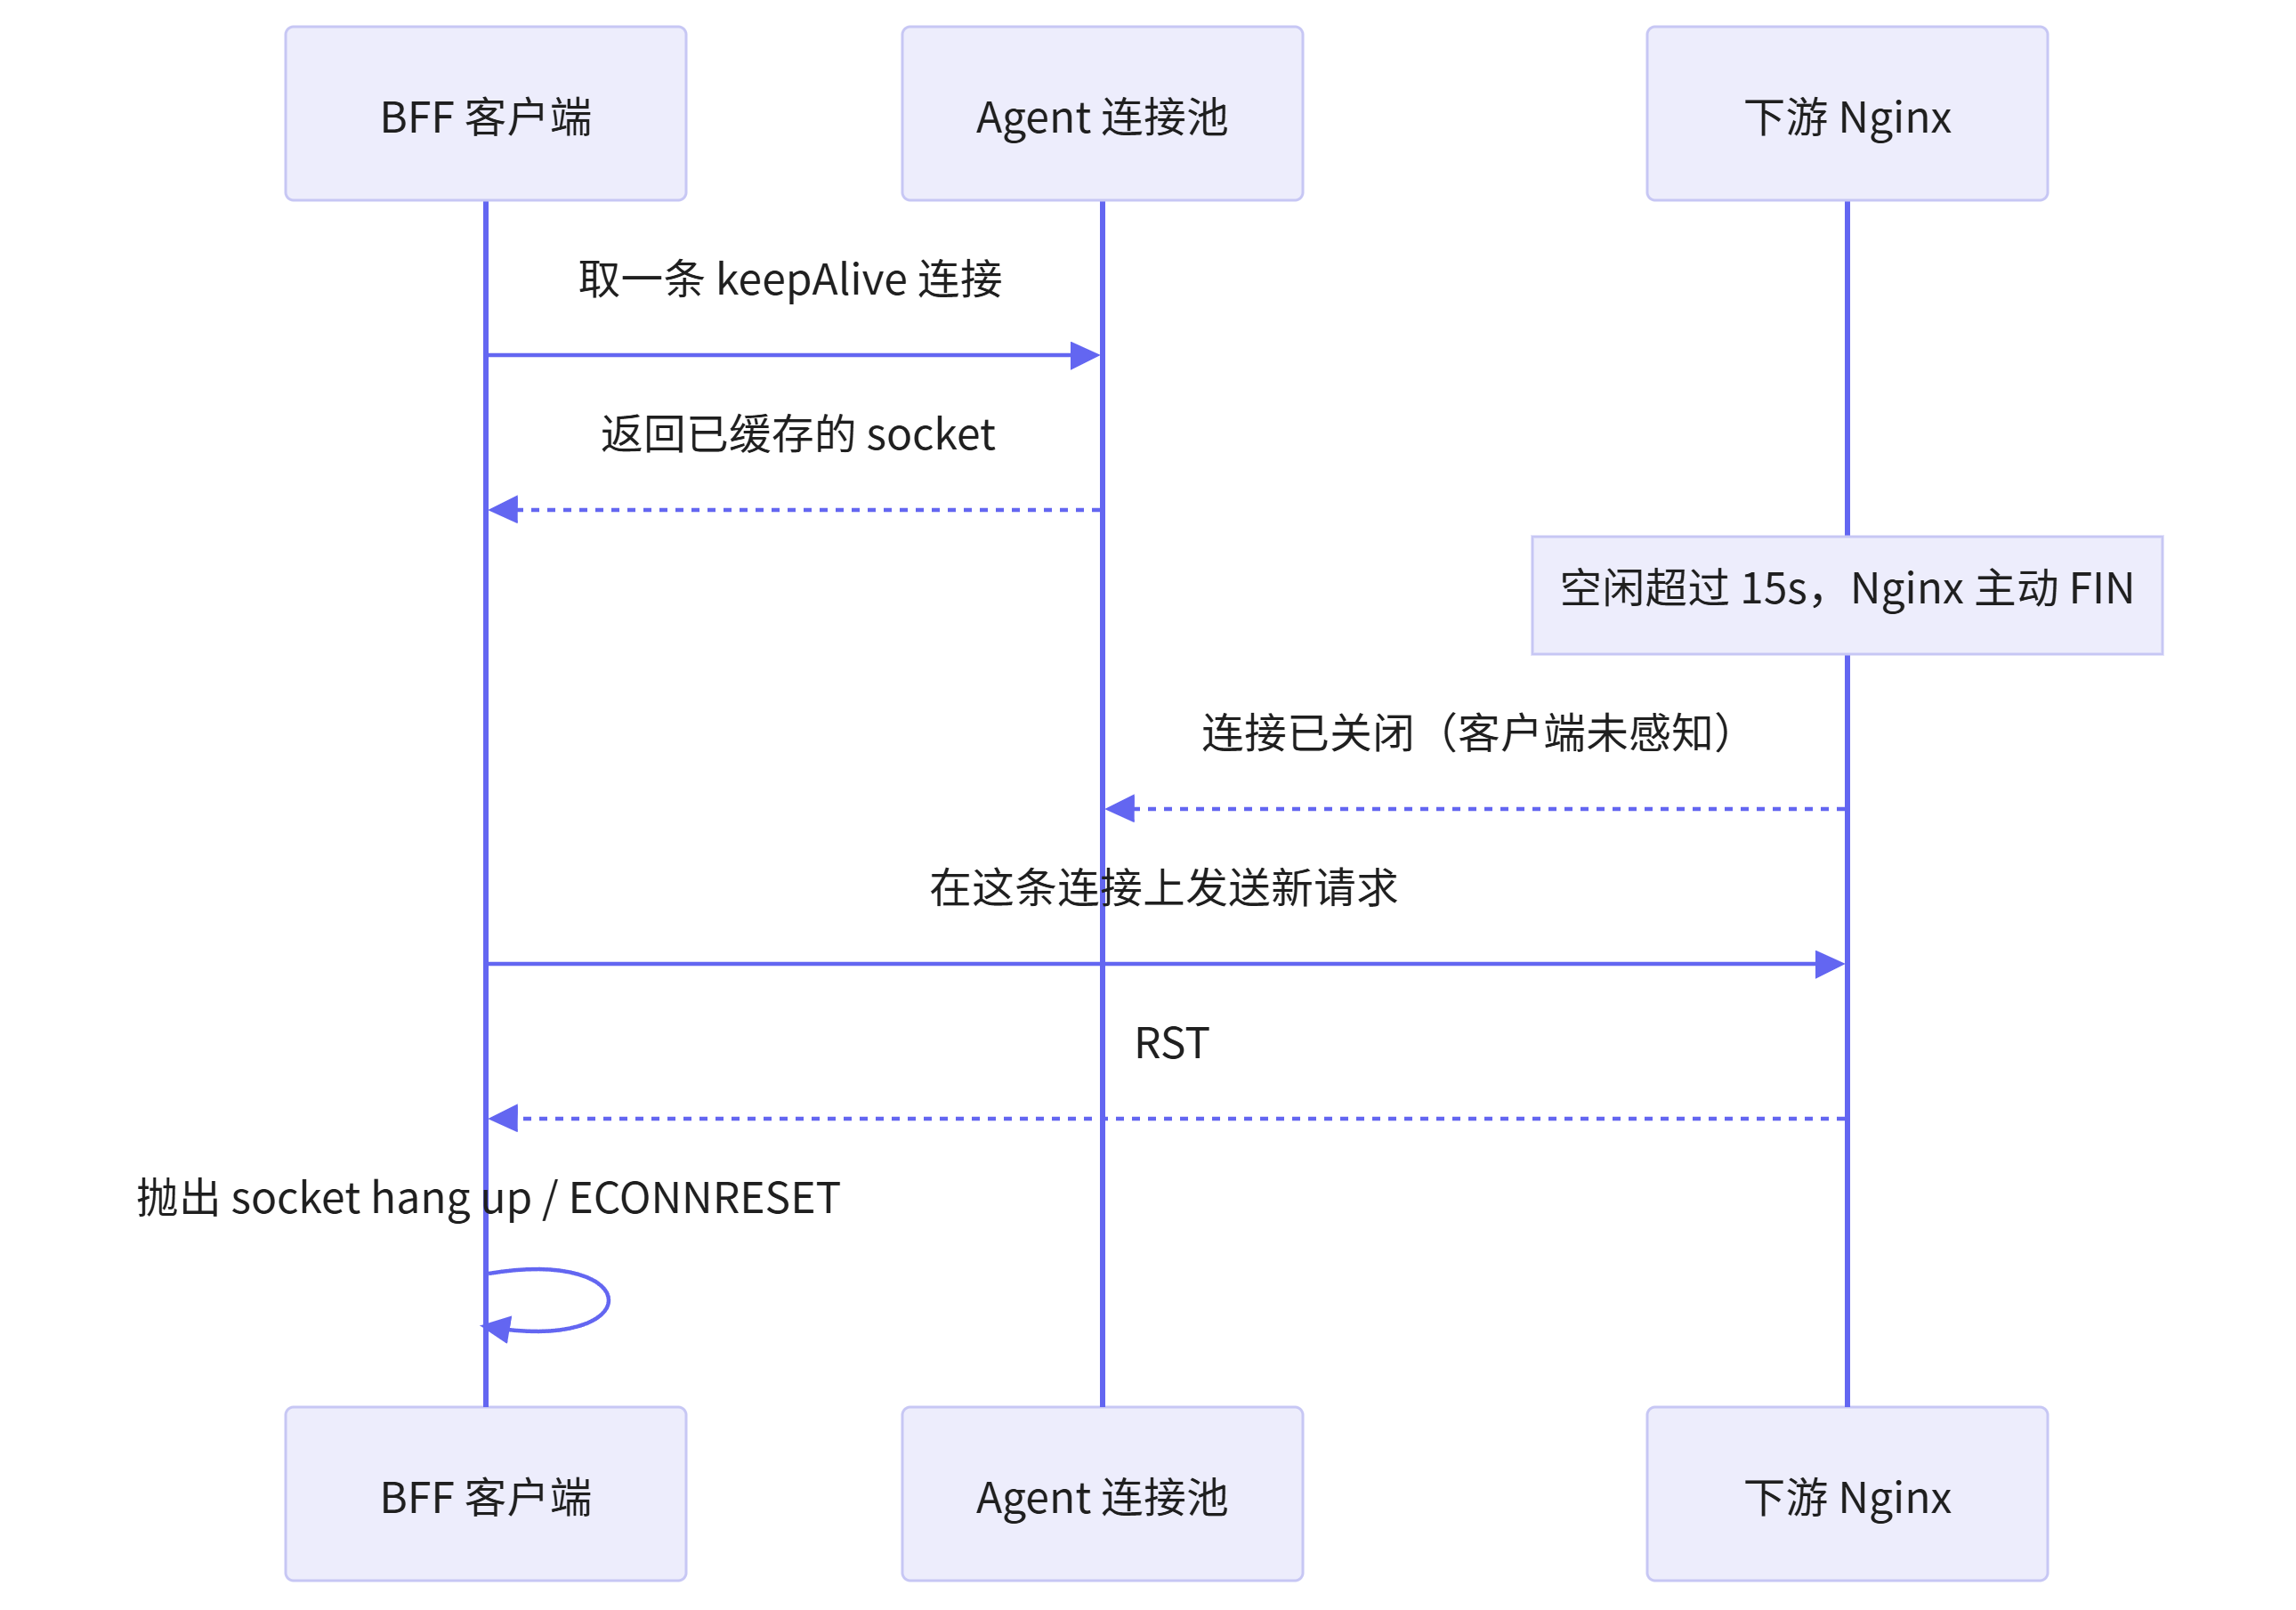
你三个方案都在"客户端单侧"打转,但这个错误的典型成因是连接复用竞态:

下游 nginx 的 keepalive_timeout 通常是 15s 或更短。
你的 agent 开了 keepAlive,但没设空闲回收时间,
于是客户端认为这条连接还活着,继续往里发请求,
可服务端早就把这条连接关了 —— 请求发出去,连接已断,就是 socket hang up。

特征正好对上你说的:低 QPS 时不出现,QPS 一上来就偶发,本地复现不了。
"特征正好对上你说的"——这句话是关键。它把我的现象和它的判断对上了,不是瞎猜。
用时序图看这个竞态特别清楚:
修法
核心就一条:让客户端的空闲回收时间小于服务端的 idle timeout,别去抢那个窗口。
const agent = new http.Agent({
  keepAlive: true,
  maxSockets: 100,
  keepAliveMsecs: 5000,   // 心跳间隔要明显小于下游的 idle timeout
  timeout: 10000,         // socket 空闲 10s 后客户端主动回收,抢在 Nginx 关之前
});

// 兜底:被对端关掉的连接,主动从池里摘掉,别留给下一次复用
agent.on('free', (socket) => {
  if (socket.destroyed || !socket.writable) {
    socket.destroy();
  }
});
改完上线,两天零报错。
说实话这种问题,靠自己想,我可能要挂 tcpdump 抓包才能想明白。AI 的价值在于它见过这个模式,能直接把"你遇到的现象"映射到"它见过的成因"上——这种映射,就是报错排查里最值钱的那一步。
四、实战三:NoSuchMethodError —— 报错里压根没提"依赖冲突"四个字
第三个是我当年第一次遇到时查了一整天的经典坑。
现象
一个缓存工具类启动的时候直接炸:
java.lang.NoSuchMethodError: com.google.common.collect.Sets.newConcurrentHashSet()Ljava/util/Set;
    at com.xxx.cache.RuleCache.init(RuleCache.java:41)
    at com.xxx.cache.RuleCache$$EnhancerBySpringCGLIB$$8f2c1a0.<init>(<generated>)
    ... 30 more
代码就这么几行,看着毫无问题:
@Component
public class RuleCache {
    private final Set<String> keys = Sets.newConcurrentHashSet();

    public void init() {
        keys.add("default");
    }
}
我当时第一反应是"Guava 版本太低",然后去 pom 里把 Guava 升到最新版,没用。
AI 一眼看穿的点
我贴了报错 + 我的 pom 依赖 + 我"已经升过 Guava 版本但没用"这条信息,AI 的回复是:
升级 Guava 无效,说明运行时 classpath 里根本不是你声明的那个版本。

NoSuchMethodError 99% 是"编译时高版本、运行时低版本",
不是"你没引入"。去查谁把老版本带进来了:

mvn dependency:tree -Dincludes=com.google.guava:guava
我照着跑了:
$ mvn dependency:tree -Dincludes=com.google.guava:guava

[INFO] com.xxx:order-service:jar:1.0.0
[INFO] +- com.google.guava:guava:jar:30.1-jre:compile
[INFO] \- com.xxx:legacy-common:jar:2.3.1:compile
[INFO]    \- com.third:sdk-report:jar:1.4.0:compile
[INFO]       \- com.google.guava:guava:jar:11.0.2:compile
看到了吧。我在最顶层声明的 30.1 好好地在那儿,但真正的 classpath 里,legacy-common 下面挂着一个三方报表 SDK,它把 guava 11.0.2 拖了进来,Maven 的"就近原则"让这个 11.0.2 赢了。
而 Sets.newConcurrentHashSet() 是 Guava 15.0 才加的方法。11.0.2 里当然没有。
所以我在 pom 顶层把版本升到 30.1,一点用都没有——我升的是我自己声明的那个,运行时加载的压根不是它。这也是为什么"升级 Guava"这个直觉反应会失效。
像这种套了三四层才露出真身的版本冲突,靠人肉在几百行 dependency:tree 里一眼扫出来,真的很难。
修法
<dependency>
    <groupId>com.xxx</groupId>
    <artifactId>legacy-common</artifactId>
    <version>2.3.1</version>
    <exclusions>
        <exclusion>
            <groupId>com.google.guava</groupId>
            <artifactId>guava</artifactId>
        </exclusion>
    </exclusions>
</dependency>
排掉之后再跑一次 dependency:tree 确认全局只剩一个版本,收工。
这个例子我特别想拿出来讲,是因为它代表了一整类报错:报错信息里说的东西,和真实根因之间隔着一个领域。它跟你说"方法不存在",真实原因是"依赖冲突"。你要是没见过,这个弯根本转不过来;AI 见过,它一步就跳过去了。
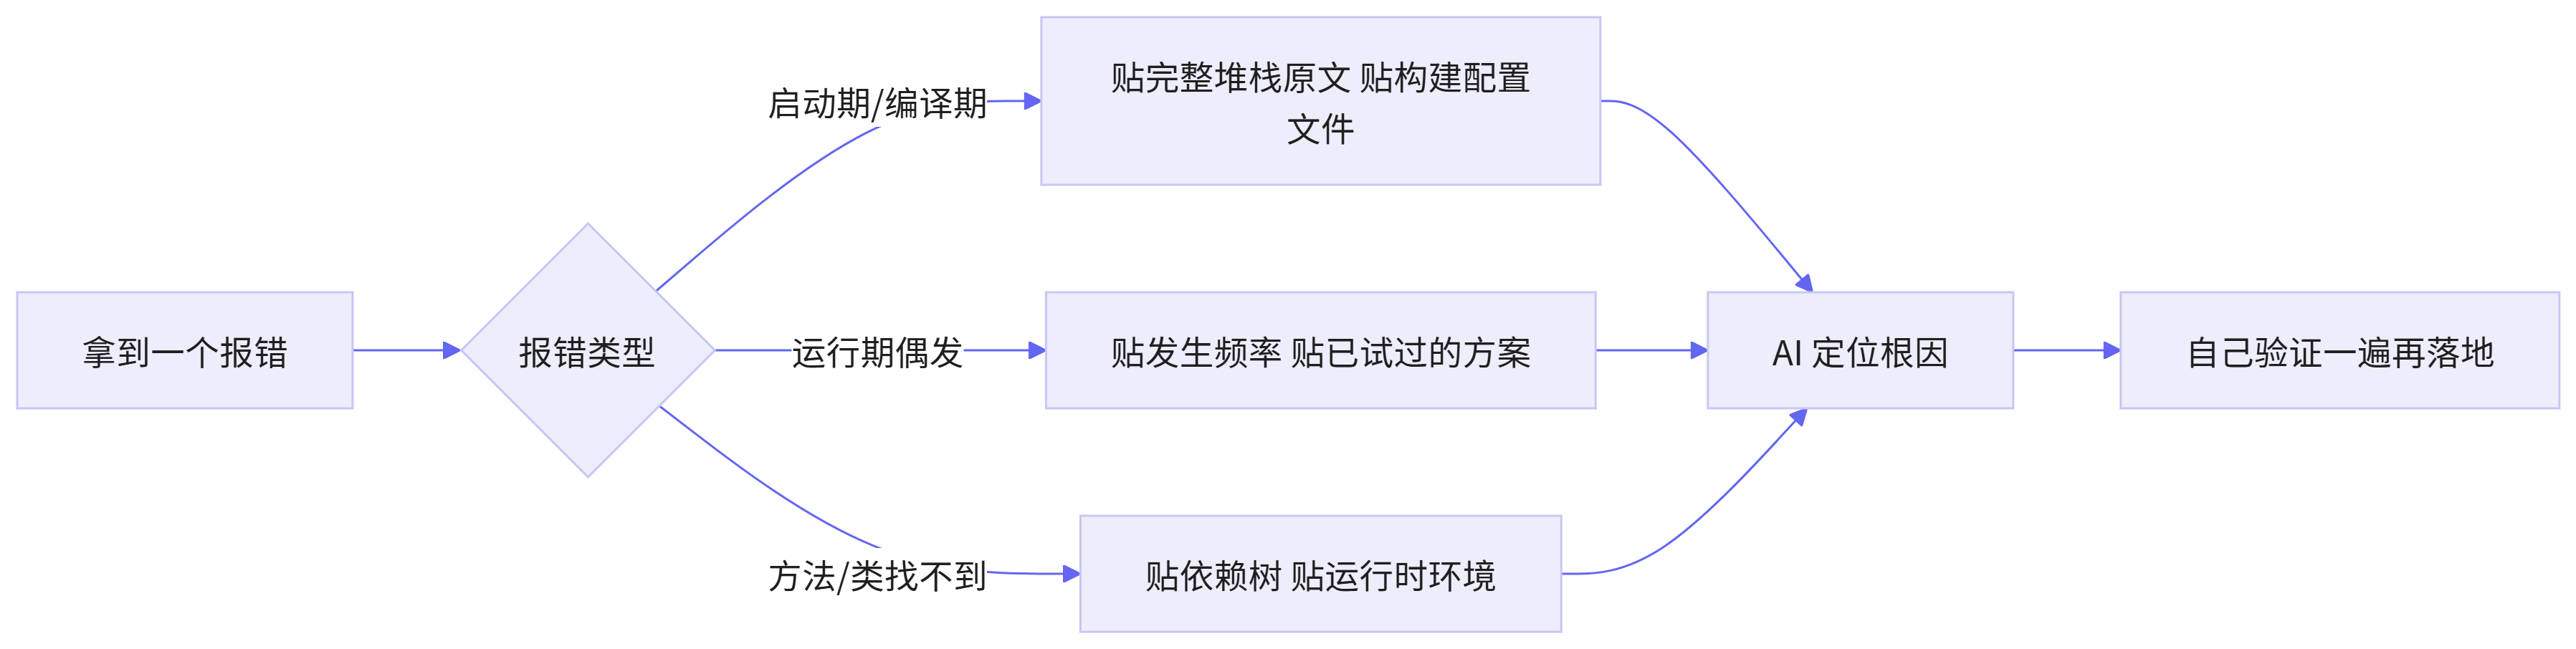
五、这三类报错,我给它配了不同的上下文
用久了之后,我大概摸出个规律:不同种类的报错,AI 需要的信息是不一样的。给错了,它就只能瞎猜。
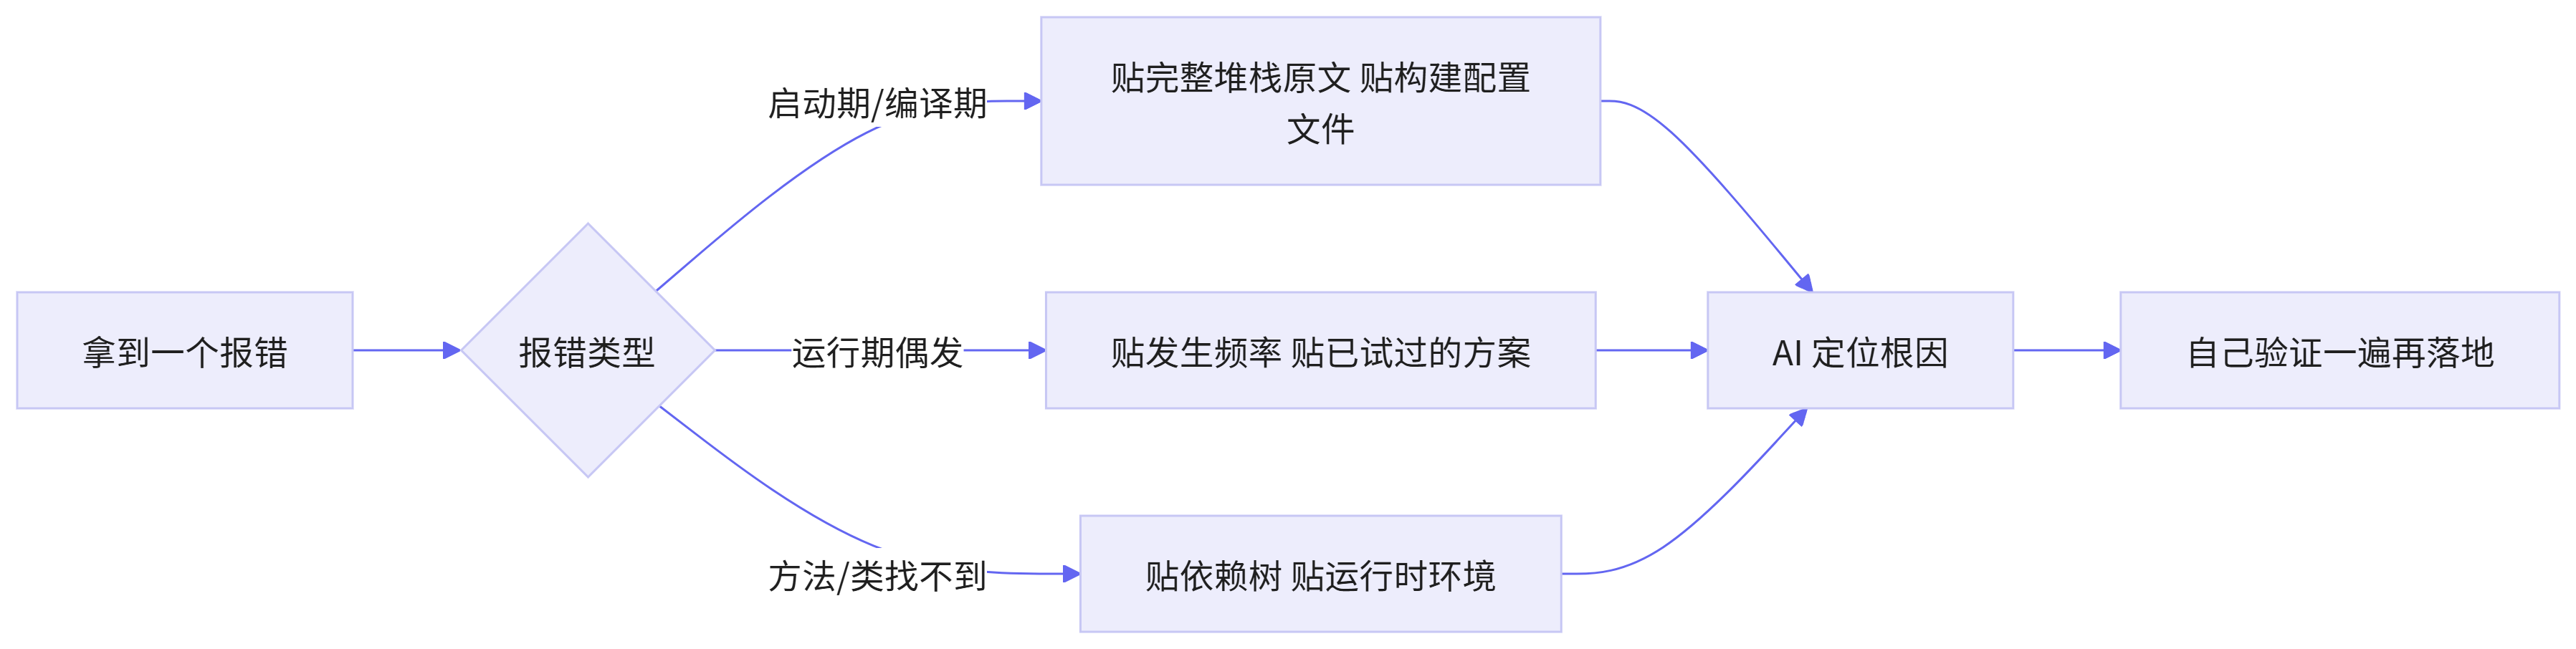
这张图看着简单,但我是在"给了一堆上下文还是被 AI 答偏"好几次之后才总结出来的。
- 启动期、编译期报错:堆栈一定要完整原文,千万别只截最后一行。Java 那套 nested exception,最后一行才是根因,但前面的行给了上下文。
- 运行期偶发报错:重点不是堆栈,是频率和规律。什么时候出现、多久一次、跟什么操作相关——这些 AI 比堆栈更需要。
- NoSuchMethod / ClassNotFound 这类:堆栈基本没信息量,AI 需要的是依赖树和运行时环境(JDK 版本、容器镜像、打包方式)。
六、几个我自己趟出来的土规矩
写到这,说几条我觉得比"提示词技巧"更重要的东西。
第一,先让它解释,别让它改。
我现在的提示词末尾一定会加一句:"先告诉我根因是什么,先别给代码。"
原因很实在:AI 一上来就给代码的话,你会忍不住直接复制粘贴去试。试完发现不对,你已经浪费了五分钟,而且脑子里被它那个错误方向污染了。让它先讲清楚为什么,你判断"这个解释说得通",再要代码,顺序反了会多走很多弯路。
第二,绝对不要说"帮我改到能跑为止"。
这句话我说过一次,结果它给了我一大堆 try-catch 和一个兜底默认值,服务倒是起来了,问题被彻底藏起来了,两周后在另一个地方以更恶心的形式炸出来。
AI 会倾向于"让你的代码不报错",但"不报错"和"没问题"是两回事。你要的是根因,不是静音。
第三,报错原文,一个字都别改。
我见过有人把堆栈"精简"一下再贴给 AI,把觉得无关的行删掉。这是最亏的做法——你觉得无关的行,可能正是 AI 判断版本、判断调用链的依据。复制粘贴不花钱,别省。
第四,AI 给的根因,一定要自己验一遍。
这条我说了三篇文章了,还得说。AI 是"提示",不是"结论"。它说"是依赖冲突",你就去跑 dependency:tree 亲眼看一下;它说"是连接复用竞态",你就去查一下下游的 keepalive_timeout 配置到底是多少。验证这一步省不掉,省了迟早还回来。
回头看这几个例子,我发现一个挺有意思的规律:这三个 bug 修起来分别花了十分钟、五分钟、两分钟,但"看懂报错在说什么"分别花了我半小时、大半天、一整天。
也就是说,报错这个事,成本的大头从来不在"修",在"读"。
而"读"这一步,恰好是 AI 最擅长的——它有耐心,它不会烦躁,它见过比你多得多的报错模式,它不会因为"这破玩意又报错了"而心烦意乱地把堆栈划过去。
我这两年最大的变化,不是查 bug 变快了,是我不怕报错了。以前看到一大坨红色堆栈会下意识烦躁,现在第一反应是"行,贴进去看看它怎么说"。
心态上这一个转变,比省下来的那些时间值钱得多。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号