给非技术同事科普 AI 的正确姿势:我用真实案例讲明白了
原创
给非技术同事科普 AI 的正确姿势:我用真实案例讲明白了
原创
大盘鸡拌面
发布于 2026-10-09 15:47:47
发布于 2026-10-09 15:47:47
去年年底公司搞了个"AI 提效月",行政的小姑娘在群里问了一嘴:有没有什么 AI 工具,能帮我把每周的会议室预约表整理一下?
我当时特别热心,转手丢了个链接过去,还补了一句:"你把表直接贴进去,让它帮你汇总就行。"
半小时后她私信我:哥,它给的答案不对啊,我把表贴进去了,它回我一句"请您提供需要汇总的数据"。
我过去一看,差点笑出声。她贴的是一张截图。
这事儿对我刺激挺大。我后来复盘,问题压根不在她身上,在我。我那句"直接贴进去",对她来说就是一句黑话——我脑子里的"贴"是复制一段可以被选中的文本,她理解的"贴"是发张图片过去。同一个动词,我俩的理解完全不在一个频道上。
更要命的是,我给的是"工具",不是"结果"。她要的是"这周的预约表整理好了",我给的是"你去用这个工具"。中间那一大段路,我压根没陪她走。
从那之后我特意观察了大半年:为什么我们技术同学觉得"这有什么难的"的东西,非技术同事就是死活上手不了?看下来发现,卡点其实特别集中,就那么几个。
二、他们卡在哪:真不是笨,是没有"任务感"
我们写代码写久了,脑子里会自动做一件事——把任何需求拆成"输入是什么、处理规则是什么、输出长什么样"。这三样东西清楚了,剩下的就是体力活。
但非技术同事的思维不是这么跑的。他们的表达往往是结果导向的一句话:"帮我把这个整理一下""帮我写个方案""这个数据你帮我看看"。
这句话里没有输入边界,没有判断标准,也没有交付形态。你把这句话原封不动丢给大模型,模型只能瞎猜,猜出来的东西当然不对。然后同事的结论就变成了:AI 不行,吹得厉害。
所以科普真正要教的,不是 prompt 怎么写、不是哪个工具好用,而是帮他把一句模糊的人话,变成一件 AI 能接得住的活。
我把这个过程叫"三步翻译法",下面这张图是我现在带人时的固定套路:
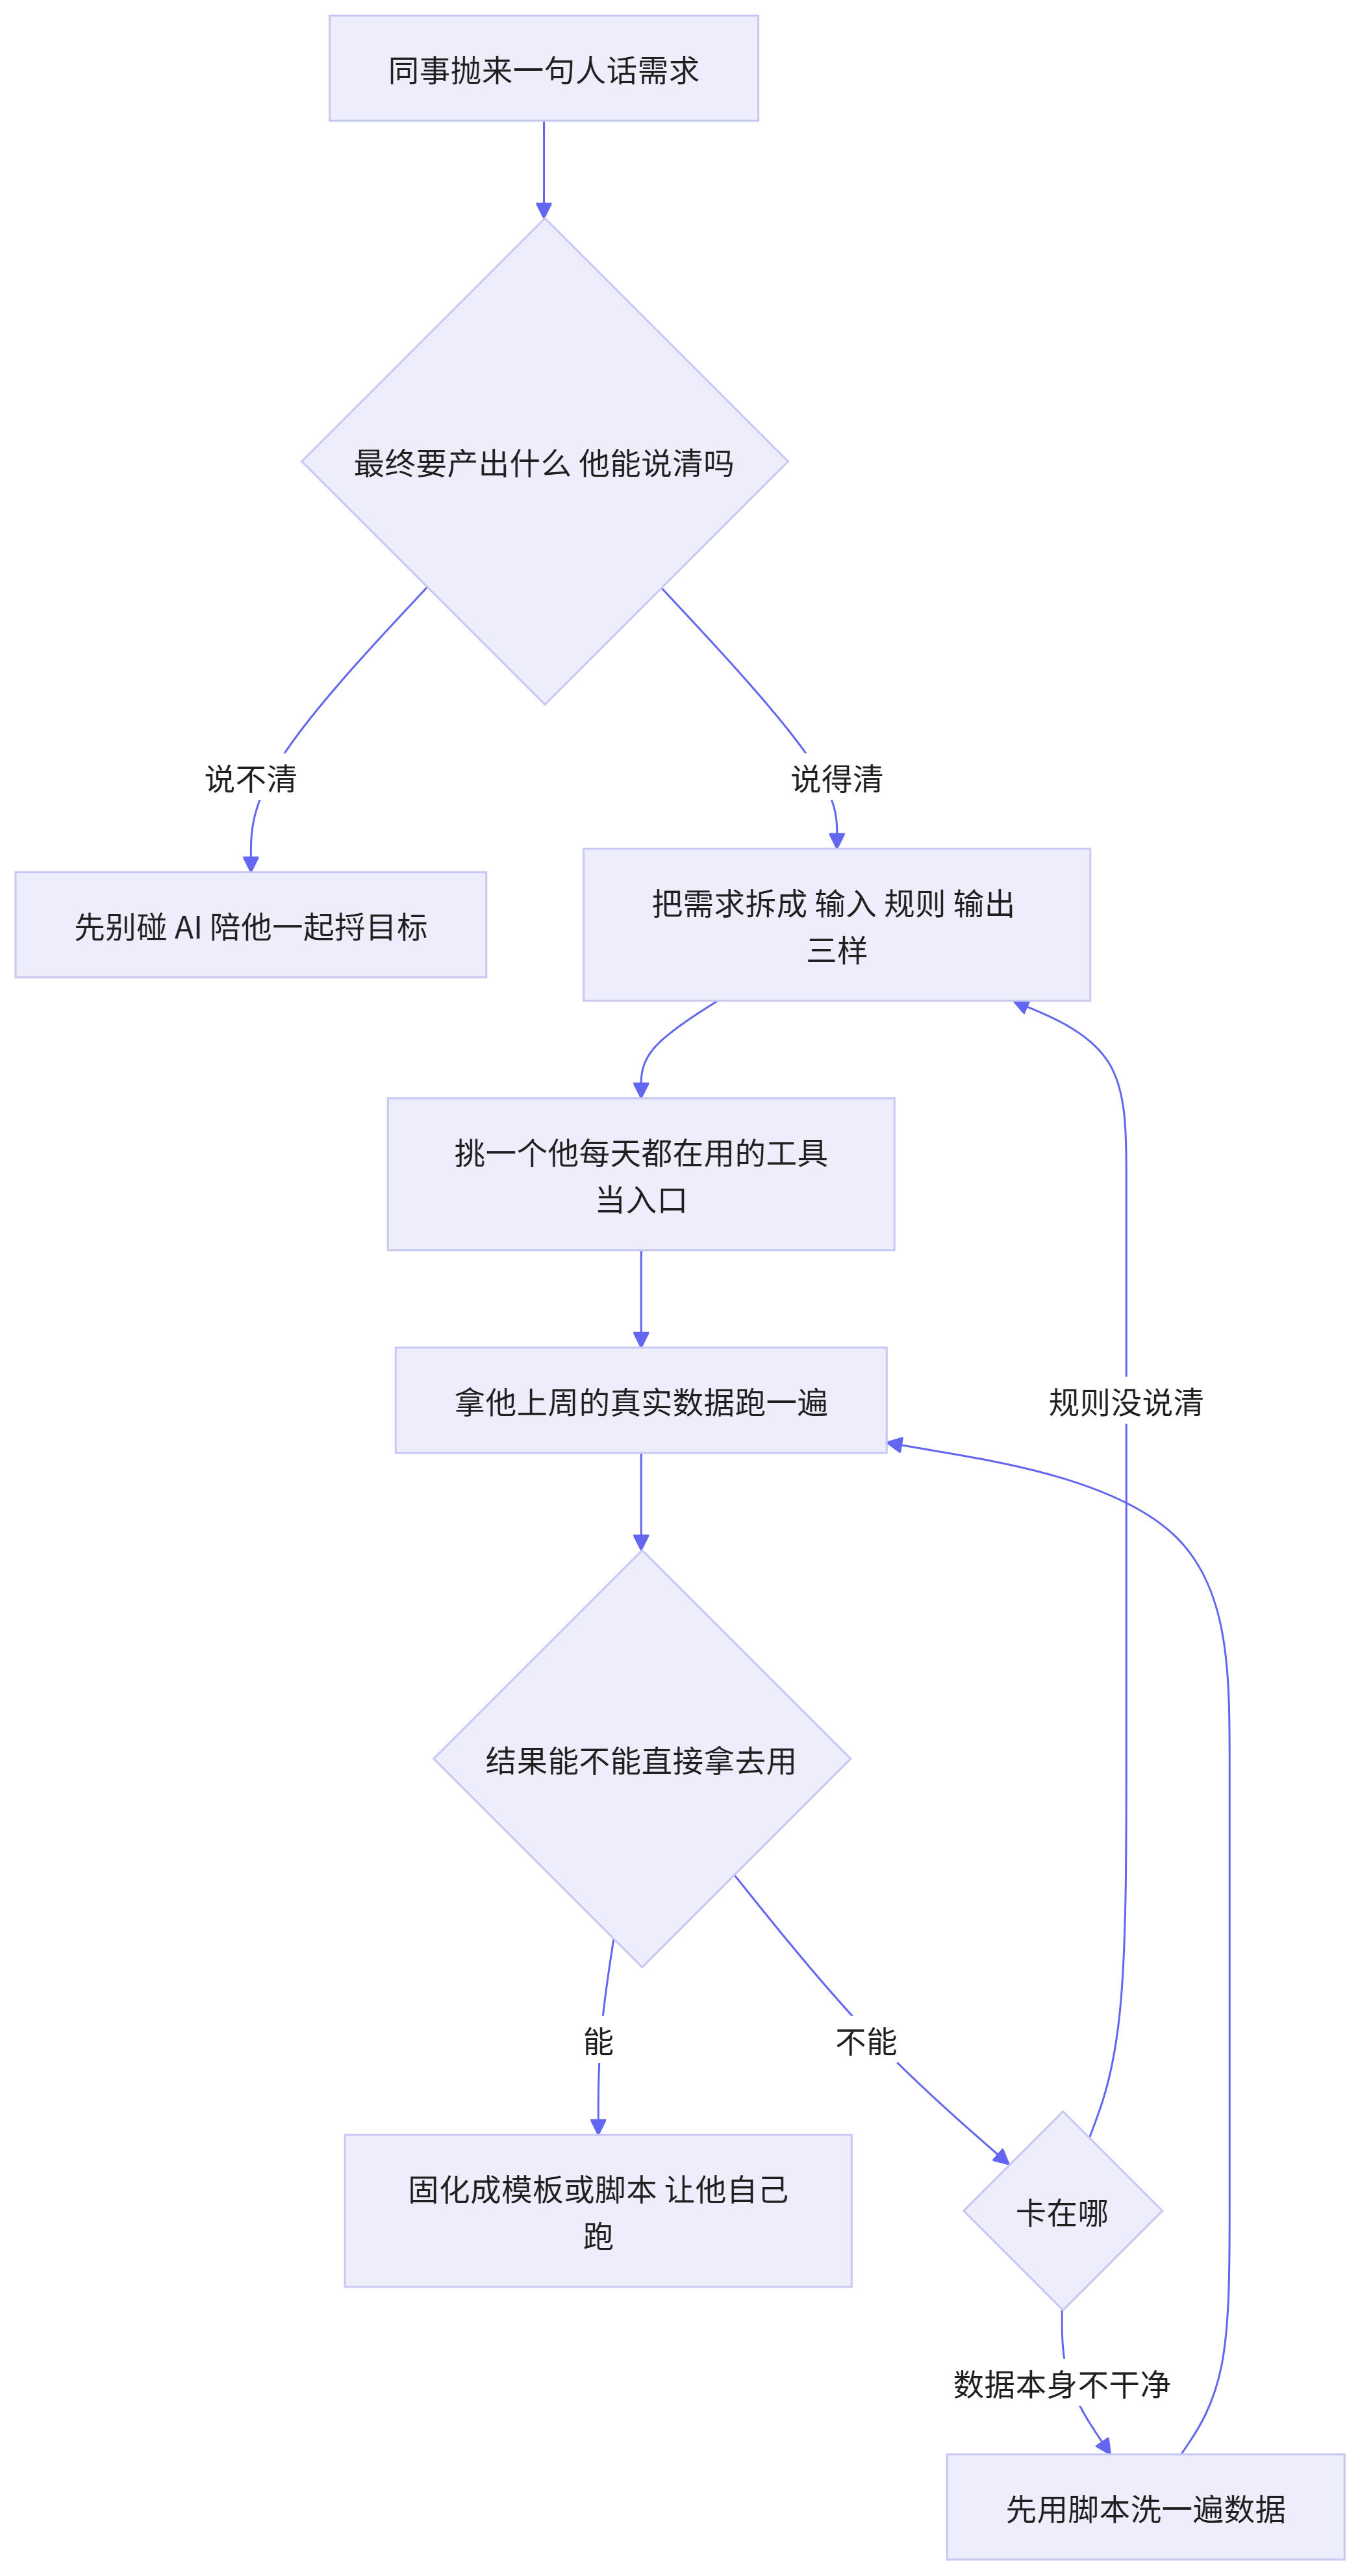
看着平平无奇对吧?但差别巨大。我以前是"丢链接",现在是"陪跑一次"。前者同事试一次失败就放弃了,后者他第二次就能自己来。
三、真实案例一:运营小李的五张渠道表
小李是运营,每周一上午要干一件事:把抖音、小红书、B站、公众号、知乎五个渠道导出的投放表合成一张总表,再写几句说明发到部门群里。她说每次得折腾一个多小时,最烦的是五个渠道表头长得都不一样,每次都得手动对齐。
我跟她的对话大概是这样:
我:你最终要发出去的是什么? 她:一张总表,加两三句话说明,发群里。 我:群里谁看?他们最关心啥? 她:总监看,主要关心哪个渠道烧钱多、哪个便宜。 我:那"便宜"你怎么定义? 她:……花多少钱带来一个转化,越低越好。 我:行,这就够了。
你看,三问之后,输入(五个 xlsx)、规则(按渠道+日期聚合,算 CPA)、输出(一张表+三段说明)全齐了。这活儿剩下的就是纯体力,正好扔给脚本和 AI。
我给她写了个汇总脚本,核心逻辑就是把不同表头对齐成统一字段名,再按天聚合:
# merge_channels.py
# 用途:把五个渠道导出的日报合成一张总表,并算出环比和 CPA
import pandas as pd
from pathlib import Path

# 每个渠道的表头长得都不一样,先做一次列名对齐
COLUMN_MAP = {
    "渠道": "channel",
    "投放渠道": "channel",
    "日期": "date",
    "统计日期": "date",
    "消耗": "cost",
    "花费(元)": "cost",
    "转化数": "conv",
    "转化量": "conv",
    "转化": "conv",
}

KEEP = ["channel", "date", "cost", "conv"]


def load_one(file: Path) -> pd.DataFrame:
    df = pd.read_excel(file)
    df = df.rename(columns=COLUMN_MAP)
    missing = [c for c in KEEP if c not in df.columns]
    if missing:
        raise ValueError(f"{file.name} 少了这几列:{missing},检查一下表头")
    return df[KEEP]


def merge_all(folder: str) -> pd.DataFrame:
    files = list(Path(folder).glob("*.xlsx"))
    if not files:
        raise SystemExit("这个文件夹里没有 xlsx,是不是又把文件放桌面上了")

    df = pd.concat([load_one(f) for f in files], ignore_index=True)
    df["date"] = pd.to_datetime(df["date"])
    df = df.groupby(["date", "channel"], as_index=False).sum()
    df = df.sort_values(["date", "channel"])

    # 跟上一天比,看环比
    df["cost_delta"] = df.groupby("channel")["cost"].pct_change().round(4)
    # CPA:花多少钱换来一个转化
    df["cpa"] = (df["cost"] / df["conv"]).round(2)
    return df


if __name__ == "__main__":
    result = merge_all(r"D:\投放数据\本周")
    out = r"D:\投放数据\汇总_本周.xlsx"
    result.to_excel(out, index=False)
    print(f"搞定,写在 {out}")
print(result.tail(10))表出来了,那段"两三句说明"我本来想让她自己写,后来发现她每次写的风格都不一样,总监还老挑刺。干脆也一起自动化了,关键是把输出格式钉死,不然模型每次发挥都不稳定:
# explain.py
# 用途:把汇总表变成一段能直接复制到群里的解读
import pandas as pd
from openai import OpenAI

client = OpenAI(base_url="https://你的中转地址/v1", api_key="sk-xxxx")

PROMPT = """
你是一个给运营看的数据解读助手。下面是本周各渠道的投放数据,JSON 格式。

严格按下面三段输出,不要加任何开场白和客套话:

第一段:一句话说清本周整体情况,说明涨了还是跌了、幅度多少。
第二段:挑出变化最大的 2 个渠道,每个渠道给一句原因推测,必须标明这是推测。
第三段:给一条下周能直接干的动作建议,要具体到"哪个渠道、做什么、预期什么"。

硬要求:
- 全中文,说人话,不许出现"赋能""抓手""闭环""生态位"这类词
- 所有数字只能来自下面的数据,一个都不许自己编
- 判断不了原因就直说判断不了,不许硬编

数据如下:
{data}
"""


def build_report(xlsx_path: str) -> str:
    df = pd.read_excel(xlsx_path)
    # 只喂最近的数据,全塞进去又贵又容易跑偏
    payload = df.tail(50).to_json(orient="records", force_ascii=False)

    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": PROMPT.format(data=payload)}],
        temperature=0.2,
    )
    return resp.choices[0].message.content


if __name__ == "__main__":
print(build_report(r"D:\投放数据\汇总_本周.xlsx"))我让她拿着上周的真实数据当场跑了一遍。跑完她自己改了两个地方:一是觉得"变化最大的 2 个渠道"应该改成 3 个,二是说推测那段得加上"待和数据组确认"。这两处她是自己提的——因为她看得懂结果,所以她知道哪里不对。
这一步特别关键。你替他跑出来的东西,他必须看得懂、挑得出毛病,否则他永远不会有掌控感,下周还会来找你。
现在她每周一自己拖五个文件进文件夹,双击一下,十分钟搞定。上个月她还自己加了个柱状图。
四、真实案例二:财务王姐的发票核对
王姐的痛点是报销季。每个月几百张发票截图,要一张张打开看金额、看号码,再跟报销单对一遍。她说看到后来眼睛都是花的,最怕的不是累,是漏看。
这个场景我一开始判断是纯 OCR 的活儿,后来发现不对:单纯 OCR 识别率不够,而且发票格式太杂。换成多模态大模型直接读图,反而稳得多。
我的思路不是"让 AI 全做完",而是让 AI 把 90% 没问题的过滤掉,只把可疑的挑给人看。这个定位非常重要,后面我会单独讲。
# invoice_check.py
# 用途:批量读发票截图提成结构化字段,只把对不上的挑出来给人工看
import base64
import json
from pathlib import Path

import pandas as pd
from openai import OpenAI

client = OpenAI(base_url="https://你的中转地址/v1", api_key="sk-xxxx")

SCHEMA = {
    "seller": "销售方名称",
    "amount": "价税合计金额,只要数字",
    "invoice_no": "发票号码",
    "date": "开票日期,格式 YYYY-MM-DD",
}


def extract_one(img_path: Path) -> dict:
    b64 = base64.b64encode(img_path.read_bytes()).decode()
    prompt = f"""
这是一张发票图片。请提取下面这些字段,只返回 JSON,不要解释,不要 markdown 代码块:
{json.dumps(SCHEMA, ensure_ascii=False)}

识别不清的字段填 null,不许猜。
"""
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {
                "role": "user",
                "content": [
                    {"type": "image_url",
                     "image_url": {"url": f"data:image/png;base64,{b64}"}},
                    {"type": "text", "text": prompt},
                ],
            }
        ],
        temperature=0,
    )
    return json.loads(resp.choices[0].message.content.strip())


def check_all(img_dir: str, claim_xlsx: str):
    claim = pd.read_excel(claim_xlsx)
    known = set(claim["发票号码"].astype(str))
    known_amount = dict(zip(claim["发票号码"].astype(str), claim["金额"]))

    problems = []
    for p in sorted(Path(img_dir).glob("*.png")):
        try:
            info = extract_one(p)
        except json.JSONDecodeError:
            problems.append((p.name, "返回的不是合法 JSON,得人工看"))
            continue

        no = info.get("invoice_no")
        if not no:
            problems.append((p.name, "号码没识别出来,得人工看"))
            continue
        if no not in known:
            problems.append((p.name, f"号码 {no} 报销单里没有"))
            continue
        # 金额对不上也要挑出来,哪怕差一块钱
        if info.get("amount") is not None and abs(float(info["amount"]) - float(known_amount[no])) > 0.01:
            problems.append((p.name, f"金额对不上:发票 {info['amount']},报销单 {known_amount[no]}"))
    return problems


if __name__ == "__main__":
    rows = check_all(r"D:\发票\10月", r"D:\发票\报销单.xlsx")
    if not rows:
        print("全部对上了,可以直接过")
    for name, why in rows:
        print(f"[要人工看] {name} -> {why}")
跑完 300 多张,挑出来 12 张要人工看,里头真的有 2 张金额录错了。王姐现在的用法是:脚本先跑一遍,她只看那十几张。
她跟我说了句我印象特别深的话:"以前我是不敢不看,现在我是知道该看哪几张。" 我觉得这句话基本概括了 AI 在办公场景里最正确的位置。
五、真实案例三:那个只会说"帮我写个方案"的同事
前两个是给工具的,这个是不给工具的——因为他的卡点在需求本身。
产品那边有个同事,隔三差五来找我:"你帮我用 AI 写个活动方案呗。"我第一版给他写得挺认真,他看完说"不太对"。我问哪不对,他说不上来。
后来我换了个方式,不给他写,反过来问他四个问题:
- 这个方案最终谁拍板?他最在意什么?
- 有没有去年或者竞品的活动可以参照?
- 预算大概什么量级?
- 方案要几页,是给口头汇报用还是要留档?
问完他自己沉默了一会儿,说"我得先去问清楚预算"。你看,这时候 AI 压根不用出场,问题就解决一半了。
这个来回的过程,我用时序图画一下,比文字清楚:
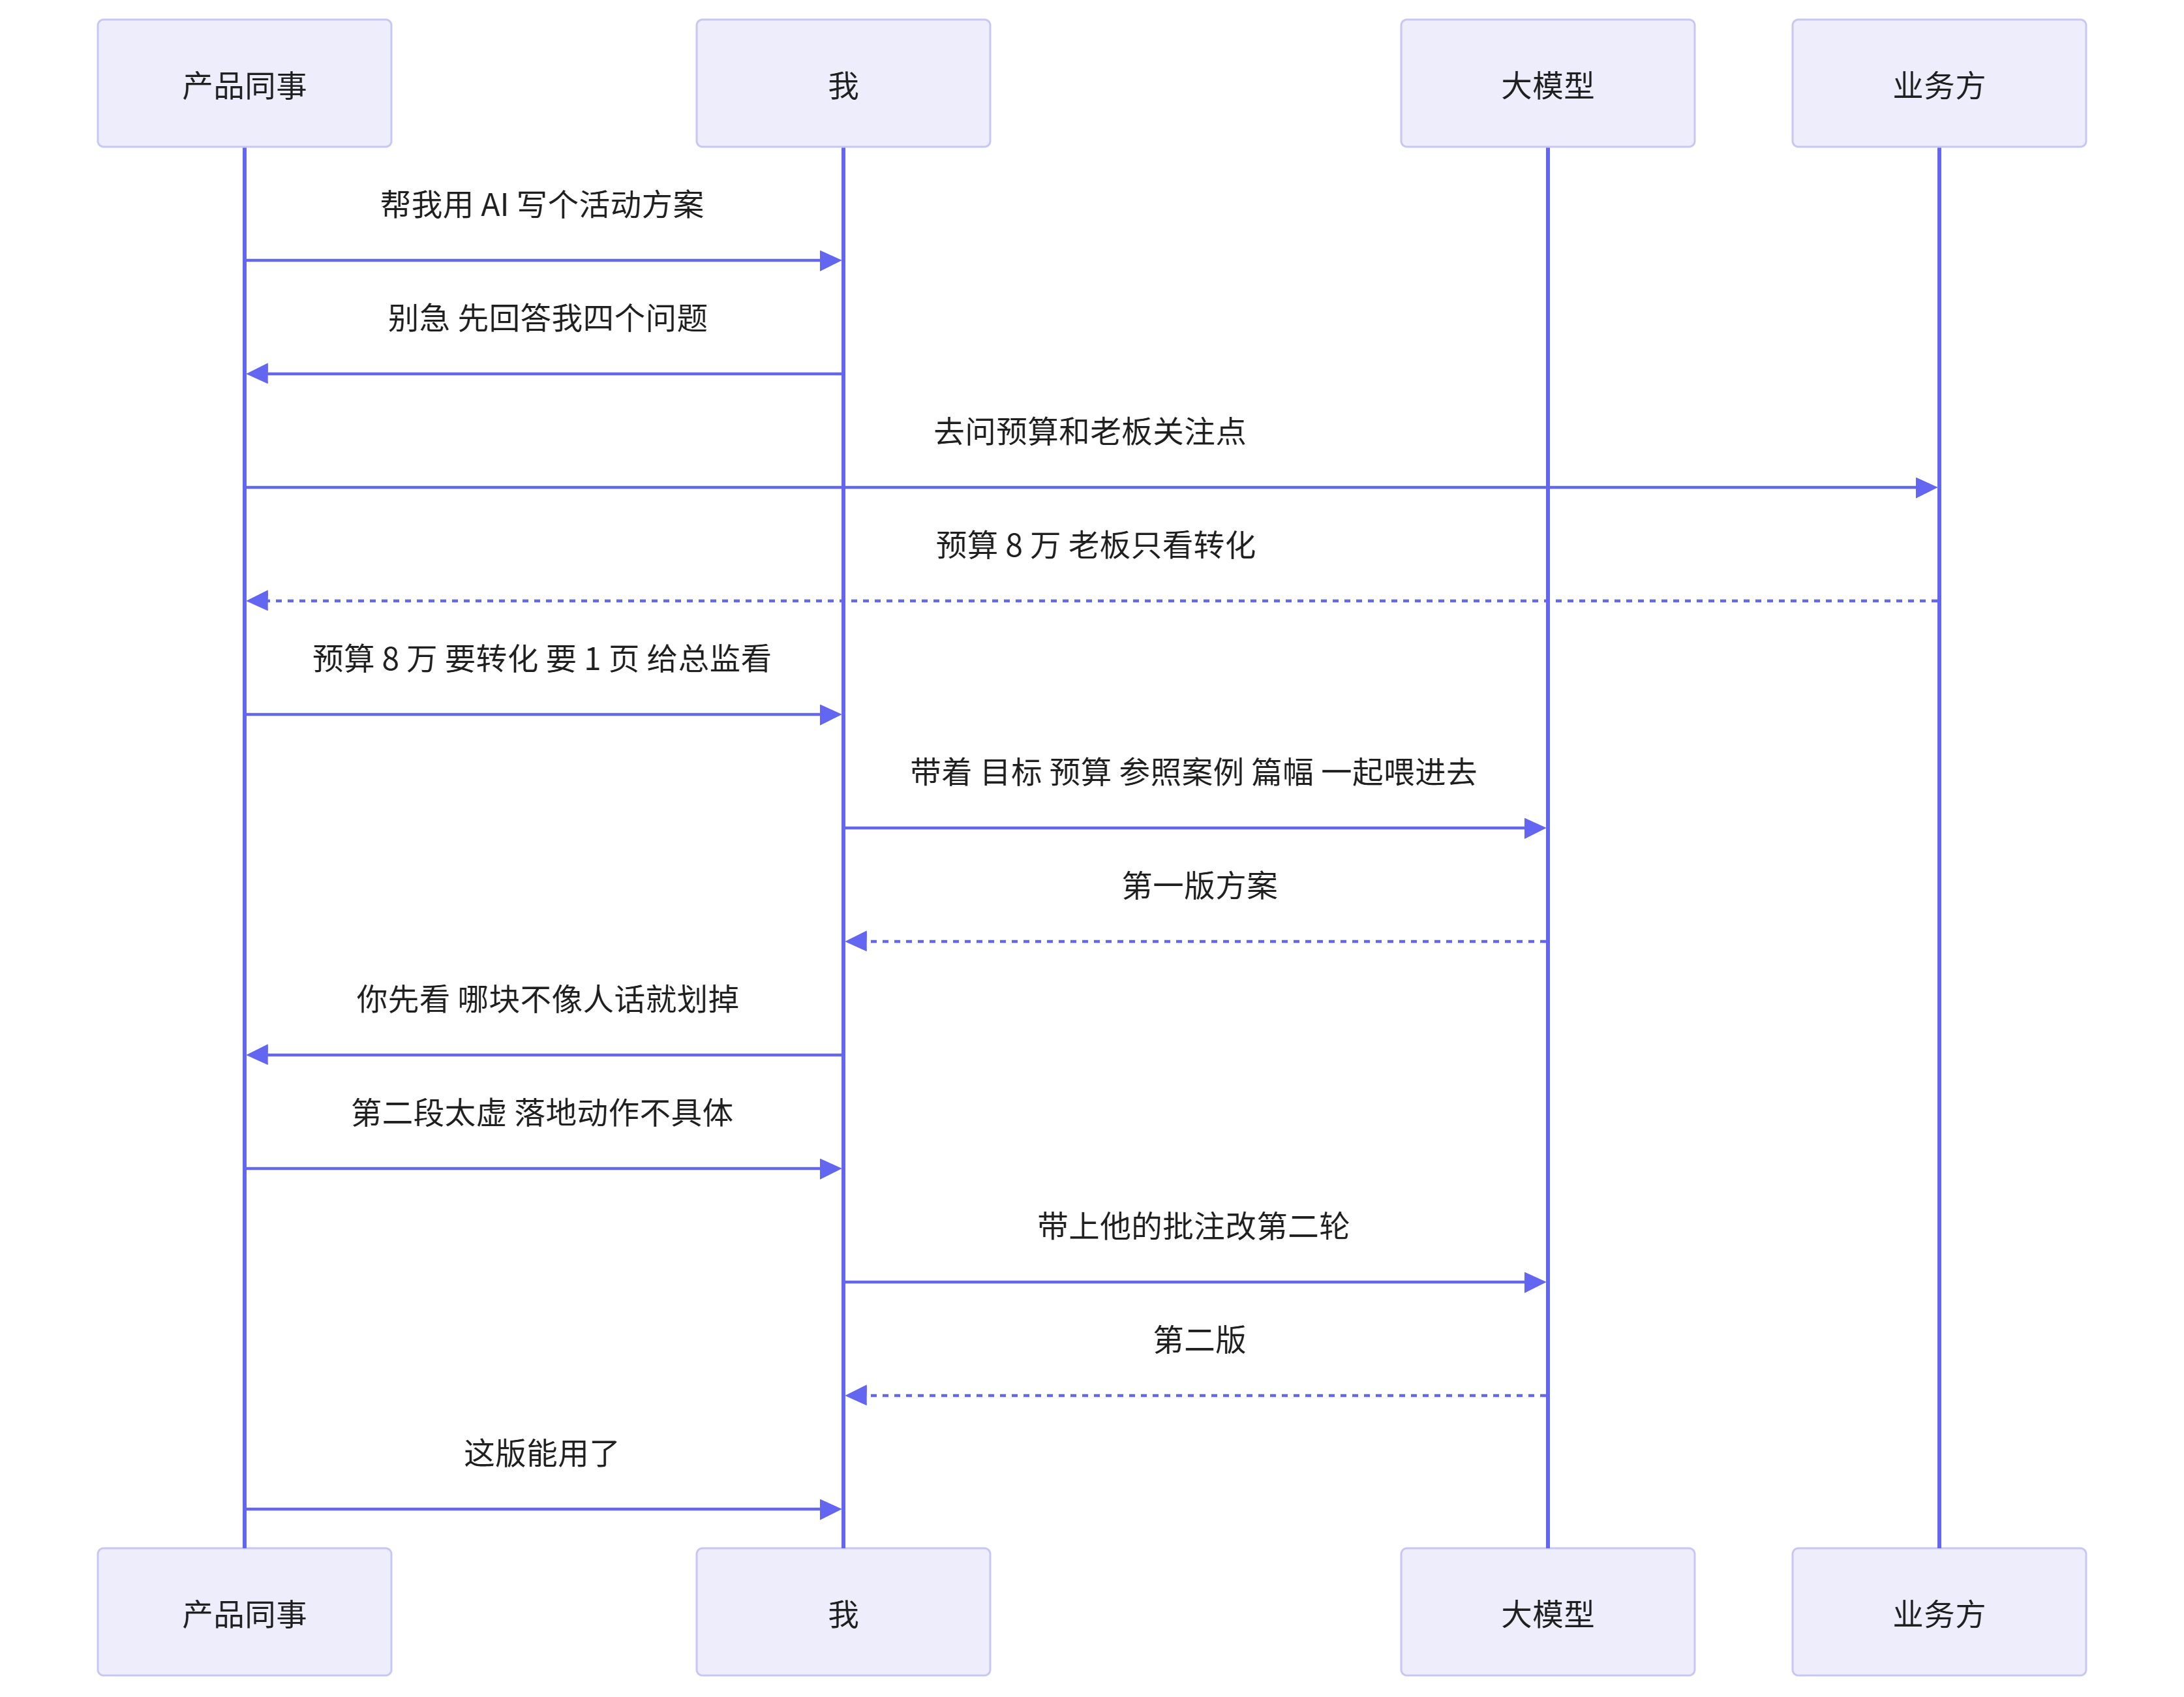
差别在哪?第一版我是把他的原话翻译给我自己,第二版是教他把原话翻译给 AI。前者他永远依赖我,后者他下次能自己来。
后来我干脆把这个"翻译"的活儿也脚本化了,让他自己跑:
# need_translator.py
# 用途:把同事的一句人话,自动补全成能直接喂给大模型的任务单
import json
from openai import OpenAI

client = OpenAI(base_url="https://你的中转地址/v1", api_key="sk-xxxx")

TEMPLATE = """
你是需求翻译官。下面这句话来自一位非技术同事,表达通常很模糊、缺信息。

请补全并输出一个 JSON 任务单,字段如下:
- goal: 他最终想拿到什么(一句话)
- audience: 这个东西给谁看
- inputs: 他已经有的材料(数组,没有就填空数组)
- missing: 还缺哪些信息,必须列出来让他去补(数组)
- steps: 拆成 3 到 5 步,每步一句话,动词开头
- risk: 这件事交给 AI 做,最可能在哪里出问题(一句话)

只输出 JSON,不要任何解释。原话:{raw}
"""


def translate(raw: str) -> dict:
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": TEMPLATE.format(raw=raw)}],
        temperature=0.1,
    )
    return json.loads(resp.choices[0].message.content)


if __name__ == "__main__":
    result = translate("帮我把这次活动的东西整理一下,领导要看")
    print(json.dumps(result, ensure_ascii=False, indent=2))
"帮我把这次活动的东西整理一下,领导要看" 这句跑出来是这样的:
{
  "goal": "产出一份本次活动复盘材料",
  "audience": "部门领导",
  "inputs": [],
  "missing": [
    "活动的全量数据(报名、到场、转化)",
    "活动预算与实际花费",
    "领导最关心哪个指标"
  ],
  "steps": [
    "收集活动全量数据并核对口径",
    "按目标、结果、差距三段整理",
    "挑出两个做得好的点和两个问题点",
    "补上下次具体可执行的改进动作",
    "压缩成一页,重点数据放最上面"
  ],
  "risk": "不先确认领导关注点,很容易写成流水账"
}
他看到 missing 那三行的时候,自己"哦"了一声。这个"哦"比我说十句都管用。
六、几个必须提前打好的预防针
带人这么久,我发现有三件事必须在一开始就讲清楚,不然后面一定出事。
第一,别让 AI 做最终责任人。 我给所有同事的脚本,输出里都留了"要人工看"的口子。报销、合同、对外发的材料,AI 只负责筛掉大多数,最后那一下必须人来看。这不是保守,是因为出错的代价不对等。
第二,数据脱敏这事儿得我替他们做。 同事真不懂哪些能传哪些不能传。我的做法是在脚本里直接把敏感字段干掉,不给他犯错的机会。代码里的 base_url 我都统一指向公司中转地址,不外传。
第三,不是所有活都值得上 AI。 这是我被问得最多的问题,我画了个判断图贴在我们部门的 wiki 上:
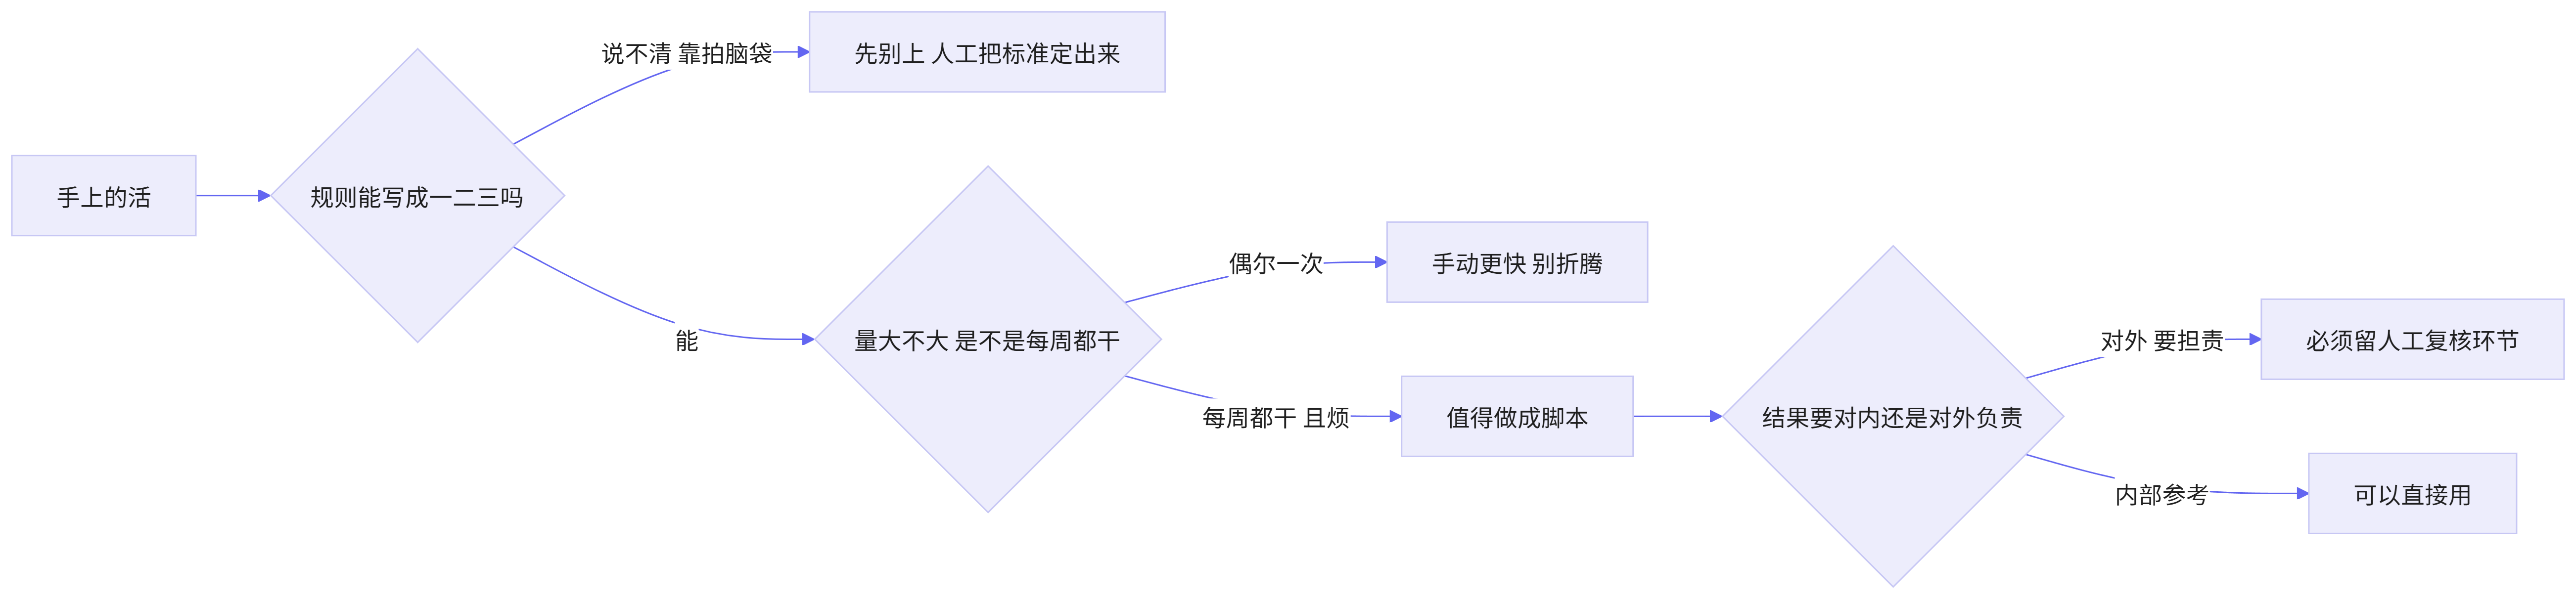
我以前特别喜欢在群里发那种"XX 工具太好用了,大家试试"的链接。现在基本不发了,因为我知道那种链接和没发是一样的。
真正起作用的,是坐过去问他一句"你这活儿最后要交出什么",然后拿他上周的真实数据跑一遍,看着他在旁边挑毛病、自己改两个地方。这个过程大概要花我一个下午,但之后他就不用再找我了。
所以如果你问我"给非技术同事科普 AI 的正确姿势是什么",我的答案可能有点反直觉:不是讲原理,不是教提示词,是帮他把手上那件具体的活做完一次。
他记住的不会是"大模型是什么",他会记住"上周那五张表,我自己十分钟搞定了"。有了这个手感,后面你不用推,他自己会来找你问下一个。
这大半年来我带过的同事里,走得最远的不是最聪明的那个,是那个跑完第一遍就跟我说"这个能不能也用在我每月那个报表上"的人。他开始自己找场景了。
我觉得,这就算讲明白了。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号