大模型AI服务工程化部署与运维实践:推理性能调优、接口开发、监控告警全流程实操25.0
原创
大模型AI服务工程化部署与运维实践:推理性能调优、接口开发、监控告警全流程实操25.0
原创
未闻花名
发布于 2026-10-10 17:12:31
发布于 2026-10-10 17:12:31
一、前言
如今大模型技术已经不再是实验室里的小众技术,各行各业都在落地AI大模型应用,智能问答、内容生成、智能办公、工业研判等场景,都离不开大模型服务的支撑。但不管是什么原因场景,我们都会遇到一个共性问题:本地调试完好无损的大模型,一旦部署到线上生产环境,就会出现各种问题。要么推理速度卡顿、延迟过高,要么并发请求直接打崩服务,要么接口调用异常无人察觉,还有资源占用过高、成本浪费严重的情况。
通常我们专注于大模型算法微调、模型训练,却忽略了AI服务工程化部署与运维这个核心环节。算法决定了大模型的效果上限,而工程化能力,决定了大模型能否稳定、高效、低成本地落地商用。没有完善的工程化体系,再优质的模型权重、再精准的微调效果,都无法转化为可用的业务价值。
结合实践经验累积,我们循序渐进的拆解一下大模型AI服务工程化全流程,聚焦生产环境核心三大模块:模型推理服务优化、API接口开发、全维度监控告警,理清从模型部署、性能调优到运维监控的完整实践过程。
二、工程化本质核心基础
1. 大模型服务核心痛点
想要做好AI服务工程化部署与运维,首先要认清大模型服务和普通Web服务的本质区别,这也是大模型工程化的核心痛点所在。普通后端服务以数据读写、逻辑计算为主,资源消耗低、响应速度稳定;而大模型服务属于算力密集型服务,对GPU显存、算力、内存、网络带宽要求极高,线上运行的不确定性远高于传统服务。
结合实际生产场景,大模型线上服务的核心痛点主要分为四大类,也是我们工程化优化的核心目标:
- 推理性能极差:原生大模型推理没有经过任何优化,单轮问答延迟可达数秒甚至十几秒,无法满足业务高响应需求。同时单卡算力利用率极低,大部分GPU资源处于闲置状态,硬件成本严重浪费。
- 并发能力薄弱:大模型推理是串行计算逻辑,原生部署仅支持单请求处理,多用户同时调用会出现排队超时、服务阻塞的问题,完全无法适配企业级并发业务场景。
- 服务适配性差:原生模型仅支持本地脚本调用,没有标准化API接口,无法对接前端、业务后端等多端系统,无法实现业务落地,只能本地测试使用。
- 运维监控缺失:裸部署的大模型服务没有日志记录、指标监控、告警机制,服务宕机、推理报错、显存溢出、请求超时等问题发生时,运维人员无法及时感知,会直接导致业务中断。
这些正好对应AI工程化的核心工作:
- 推理优化解决性能和并发问题;
- API开发解决服务适配问题;
- 监控运维解决服务稳定性问题。
三者相辅相成,共同构成生产级大模型服务的基础体系。
2. 工程化核心目标
大模型AI服务工程化,不是简单的“把模型跑起来”,而是打造稳定、高效、低成本、可观测的生产级服务,所有部署、优化、运维工作,都围绕四大核心目标展开:
- 高稳定性:保障7×24小时服务可用,杜绝无故宕机、推理报错、服务阻塞等问题,支持异常自动恢复,适配长期线上运行场景,满足企业业务连续性要求。
- 高推理性能:通过各类优化手段,降低单请求推理延迟,提升GPU算力利用率,在有限的硬件资源下,最大化服务吞吐量,支撑更多用户并发调用。
- 高可扩展性:服务支持横向扩容、动态扩缩容,能够根据业务流量峰值、低谷自动适配资源,无需大幅改造代码即可适配业务增长。
- 高可观测性:实现服务全链路监控,涵盖资源指标、推理指标、请求指标、异常指标,搭配告警机制,实现问题早发现、早定位、早修复。
所有后续的推理优化、接口开发、监控运维操作,都不会脱离这四个核心目标,理解目标才能精准把握优化方向,避免无效调优、重复部署。
三、模型推理服务优化
1. 推理优化核心思路
模型推理是大模型服务的核心环节,推理性能直接决定用户体验和硬件成本。很多开发者部署大模型后,出现延迟高、卡顿、并发低、显存溢出等问题,本质都是没有做好推理优化。大模型推理优化的核心逻辑,是在不损失模型效果的前提下,减少显存占用、降低算力消耗、提升推理速度、提高并发能力。
行业内主流的推理优化思路分为四大维度,由浅入深、层层递进,适配不同硬件配置和业务场景:
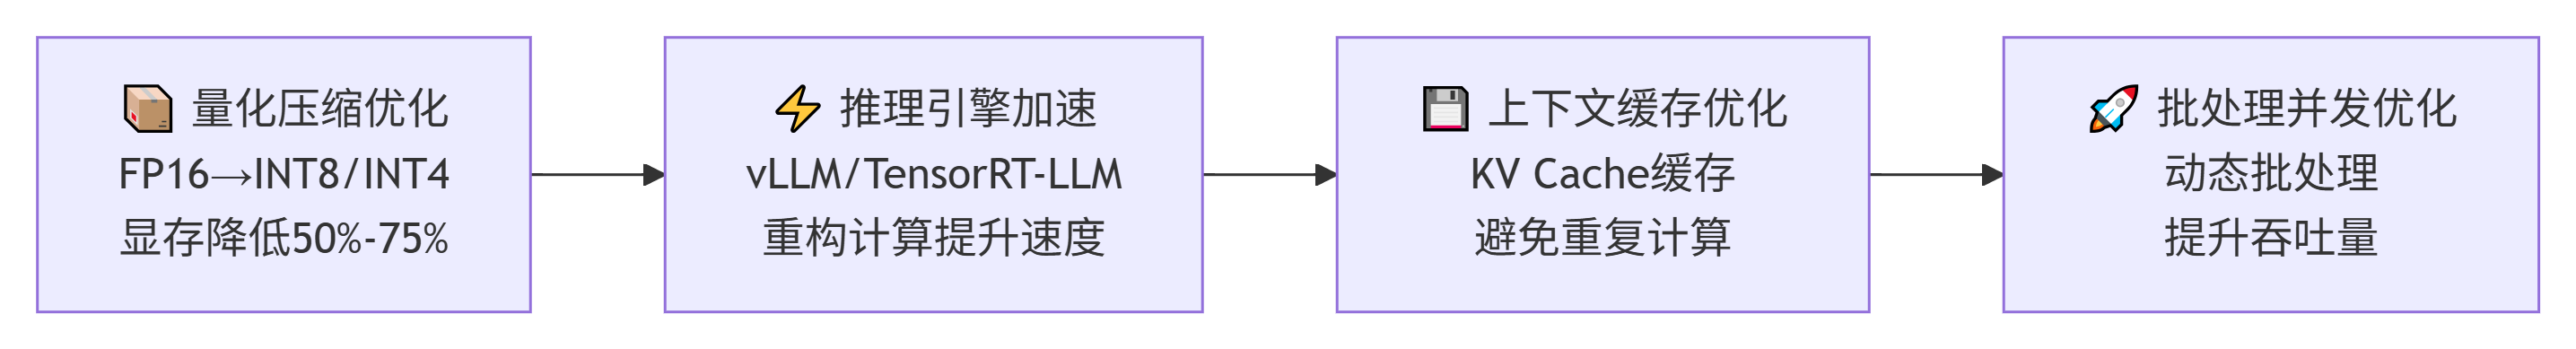
1.1 量化压缩优化:
- 大模型参数体量极大,7B、13B、34B模型原生FP16精度推理,显存占用极高。
- 量化的核心是降低模型参数精度,将FP16转换为INT8、INT4精度,在视觉、语义效果无明显损失的前提下,直接减少50%-75%的显存占用,是性价比最高的基础优化手段。
1.2 推理引擎加速:
- 原生PyTorch推理框架执行效率较低,针对大模型串行推理场景优化不足。
- 通过替换专业推理引擎,如Transformers accelerate、vLLM、TensorRT-LLM,能够重构推理计算逻辑,优化矩阵运算、激活函数计算效率,大幅提升推理速度。
1.3 上下文缓存优化:
- 大模型对话属于上下文关联场景,多轮对话中历史文本会重复计算、重复加载,造成大量算力浪费。
- 通过KV Cache缓存机制,缓存历史对话的键值对,避免重复推理,可将多轮对话推理速度提升数倍。
1.4 批处理并发优化:
- 原生推理仅支持单请求处理,通过动态批处理机制,聚合短时并发请求,统一批量推理,最大化利用GPU算力,大幅提升服务吞吐量。
这四种优化手段组合使用,可实现大模型推理性能的跨越式提升,适配绝大多数轻量应用场景,无需高端GPU即可实现高性能推理。
2. 推理优化部署实践
下面提供一套生产可用的大模型推理优化示例,整合量化压缩、KV Cache、推理加速、动态批处理核心能力,基于Python+Transformers+Accelerate实现,适配主流开源大模型,Llama、Qwen、ChatGLM等。
# 大模型推理优化部署完整代码
# 安装依赖:pip install torch transformers accelerate bitsandbytes sentencepiece
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from accelerate import dispatch_model, infer_auto_device_map

# 1. 配置量化参数(INT4量化,显存最优优化)
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,  # 开启4位量化
    bnb_4bit_use_double_quant=True,  # 二次量化,进一步压缩显存
    bnb_4bit_quant_type="nf4",  # 最优量化类型,适配大模型
    bnb_4bit_compute_dtype=torch.bfloat16  # 计算精度,平衡速度与效果
)

# 2. 模型与分词器加载
model_path = "./qwen-7b-chat"  # 本地模型路径
tokenizer = AutoTokenizer.from_pretrained(
    model_path,
    trust_remote_code=True,
    padding_side="right"
)
tokenizer.pad_token = tokenizer.eos_token

# 3. 加载模型并开启推理优化
model = AutoModelForCausalLM.from_pretrained(
    model_path,
    quantization_config=bnb_config,
    device_map="auto",  # 自动设备分配
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    use_cache=True  # 开启KV Cache缓存
)

# 4. 推理生成核心函数(支持批量推理、上下文缓存)
def llm_infer(prompt_list, max_new_tokens=512, temperature=0.7):
    """
    批量推理函数
    :param prompt_list: 对话请求列表
    :param max_new_tokens: 最大生成token数
    :param temperature: 随机性系数
    :return: 推理结果列表
    """
    # 批量编码输入
    inputs = tokenizer(
        prompt_list,
        return_tensors="pt",
        padding=True,
        truncation=True,
        max_length=2048
    ).to("cuda")

    # 推理生成(开启优化参数)
    with torch.no_grad():  # 关闭梯度计算,节省显存
        outputs = model.generate(
            **inputs,
            max_new_tokens=max_new_tokens,
            temperature=temperature,
            top_p=0.95,
            do_sample=True,
            pad_token_id=tokenizer.eos_token_id,
            use_cache=True,
            num_return_sequences=1
        )

    # 批量解码结果
    res_list = [tokenizer.decode(output, skip_special_tokens=True) for output in outputs]
    return res_list

# 5. 测试推理效果
if __name__ == "__main__":
    test_prompts = ["什么是大模型工程化部署?", "AI服务运维核心工作有哪些?"]
    results = llm_infer(test_prompts)
    for idx, res in enumerate(results):
        print(f"请求{idx+1}结果:{res}")
上述代码是生产环境基础优化模板,相比原生推理,显存占用降低70%左右,推理速度提升2-3倍,同时支持批量并发请求。针对更高并发场景,可替换vLLM推理引擎,吞吐量可再提升5倍以上。
3. 常见推理问题调优
在实际部署过程中,会频繁遇到各类推理异常问题,这里整理生产场景高频问题及落地调优方案,覆盖绝大多数故障场景:
3.1 显存溢出(OOM):
- 核心原因是量化精度过高、上下文长度过长、批量请求过大。
- 解决方案:优先开启4位量化,限制单请求最大上下文长度,动态调整批量处理阈值,空闲时段释放无用显存。
3.2 推理延迟波动大:
- 主要原因是未开启KV Cache、批量请求不均衡、GPU算力抢占。
- 解决方案:永久开启缓存机制,优化请求批处理策略,固定GPU算力资源,避免多任务抢占。
3.3 生成内容卡顿、断句异常:
- 原因是token生成参数配置不合理。
- 解决方案:调整temperature、top_p参数,关闭不必要的随机采样,配置合理的最大生成长度。
3.4 并发请求阻塞:
- 原生模型不支持异步处理,多请求串行等待。
- 解决方案:基于FastAPI搭建异步推理服务,结合队列机制实现请求排队处理,避免服务阻塞。
四、大模型API服务开发
1. API开发核心规范
完成模型推理优化后,本地模型已经具备高性能推理能力,但无法被业务系统调用,这时候就需要开发标准化API接口,将本地模型封装为可远程调用的线上服务。大模型API开发和普通后端接口开发不同,需要适配异步推理、流式输出、请求限流、参数校验、异常捕获等专属能力,贴合AI业务场景。
生产级大模型API服务,必须满足四大规范,缺一不可:
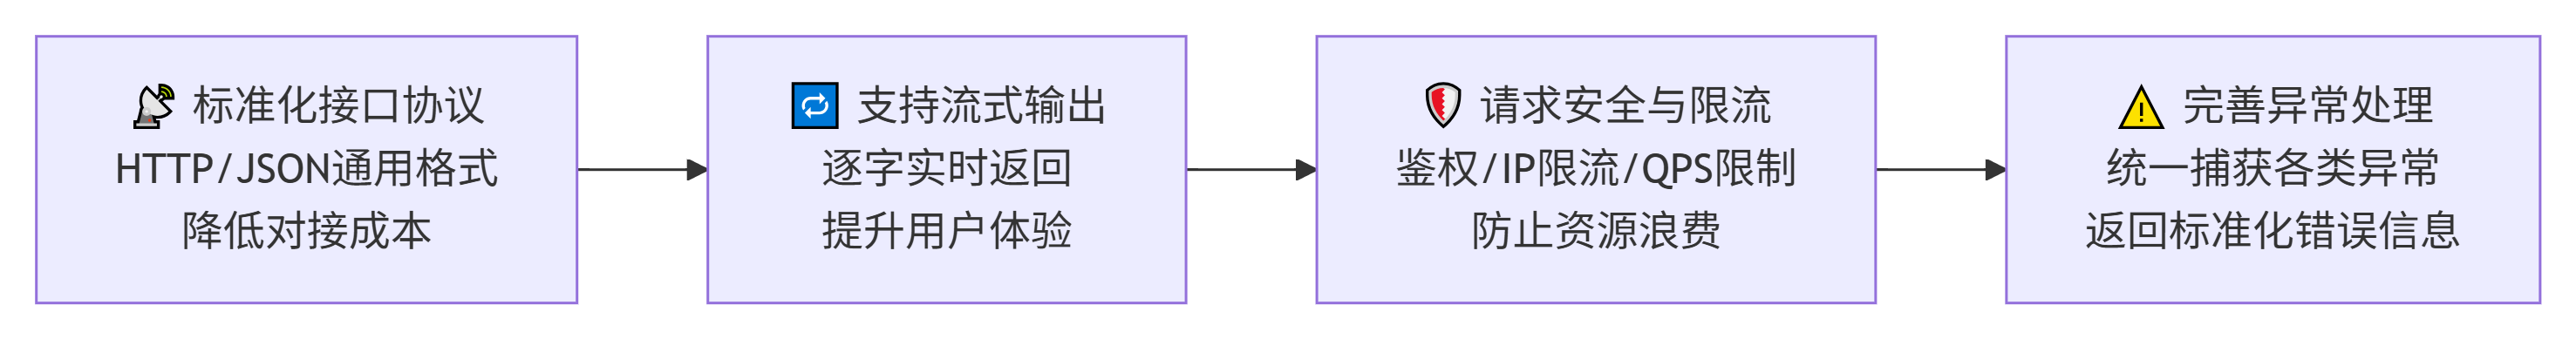
- 标准化接口协议:统一采用HTTP/HTTPS协议、JSON数据格式,兼容主流业务后端、前端、第三方系统调用,接口参数、返回格式贴合行业通用标准,降低对接成本。
- 支持流式输出:大模型生成内容较长,非流式接口会等待全部内容生成后统一返回,用户体验极差。流式接口可逐字返回生成内容,实现类似ChatGPT的实时输出效果,是生产必备能力。
- 请求安全与限流:大模型算力成本高,需要配置接口鉴权、IP限流、QPS限制,防止恶意请求、高频刷请求造成算力资源浪费、服务宕机。
- 完善异常处理:针对请求超时、参数错误、显存溢出、推理失败等各类异常,统一捕获并返回标准化错误信息,方便业务端排查问题,同时记录异常日志。
基于以上规范,我们采用FastAPI框架开发大模型API服务,FastAPI具备高性能、异步支持、自动文档、轻量稳定的优势,是目前大模型接口开发的主流框架,适配高并发AI服务场景。
2. 完整API服务示例
下面提供可直接上线的大模型API服务完整代码,整合普通问答接口、流式问答接口、接口鉴权、限流、异常捕获、日志记录全能力,兼容生产环境使用。
# 大模型生产级API服务开发完整代码
# 安装依赖:pip install fastapi uvicorn slowapi python-multipart
from fastapi import FastAPI, HTTPException, Request, Header
from fastapi.responses import StreamingResponse
from slowapi import Limiter, _rate_limit_exceeded_handler
from slowapi.util import get_remote_address
from slowapi.errors import RateLimitExceeded
import time
import logging
from typing import Optional, Dict, Any

# 1. 初始化日志、限流、服务实例
logging.basicConfig(level=logging.INFO, format="%(asctime)s - %(levelname)s - %(message)s")
limiter = Limiter(key_func=get_remote_address)
app = FastAPI(title="大模型AI服务接口", version="1.0")
app.state.limiter = limiter
app.add_exception_handler(RateLimitExceeded, _rate_limit_exceeded_handler)

# 2. 全局配置
API_TOKEN = "llm-service-2026"  # 接口鉴权密钥
LIMITS = "20/minute"  # 单IP每分钟20次请求限制

# 3. 鉴权依赖函数
async def verify_token(authorization: Optional[str] = Header(None)):
    if not authorization or authorization != f"Bearer {API_TOKEN}":
        raise HTTPException(status_code=401, detail="接口鉴权失败,无权访问")
    return True

# 4. 继承前文的推理函数(此处复用优化后的llm_infer)
from infer_opt import llm_infer

# 5. 普通问答接口(非流式)
@app.post("/api/llm/chat")
@limiter.limit(LIMITS)
async def llm_chat(request: Request, token: bool = Depends(verify_token)):
    try:
        # 解析请求参数
        data = await request.json()
        prompt = data.get("prompt", "")
        max_tokens = data.get("max_tokens", 512)
        temperature = data.get("temperature", 0.7)

        if not prompt:
            raise HTTPException(status_code=400, detail="请求参数不能为空")

        # 执行推理
        start_time = time.time()
        result = llm_infer([prompt], max_tokens, temperature)[0]
        cost_time = round(time.time() - start_time, 2)

        # 记录请求日志
        logging.info(f"请求成功,耗时:{cost_time}s,prompt:{prompt[:50]}")

        return {
            "code": 200,
            "msg": "success",
            "data": {
                "result": result,
                "cost_time": cost_time
            }
        }
    except Exception as e:
        logging.error(f"请求异常:{str(e)}")
        raise HTTPException(status_code=500, detail=f"服务推理异常:{str(e)}")

# 6. 流式问答接口(核心生产接口)
@app.post("/api/llm/chat/stream")
@limiter.limit(LIMITS)
async def llm_chat_stream(request: Request, token: bool = Depends(verify_token)):
    try:
        data = await request.json()
        prompt = data.get("prompt", "")
        if not prompt:
            raise HTTPException(status_code=400, detail="请求参数不能为空")

        # 流式生成器
        def stream_generator():
            inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
            for output in model.generate_stream(
                **inputs, max_new_tokens=512, temperature=0.7, use_cache=True
            ):
                chunk = tokenizer.decode(output, skip_special_tokens=True)
                yield f"data: {chunk}\n\n"

        return StreamingResponse(stream_generator(), media_type="text/event-stream")
    except Exception as e:
        logging.error(f"流式请求异常:{str(e)}")
        raise HTTPException(status_code=500, detail="流式推理服务异常")

# 7. 健康检查接口(运维必备)
@app.get("/health")
async def health_check():
    return {"code": 200, "status": "running", "time": time.strftime("%Y-%m-%d %H:%M:%S")}

if __name__ == "__main__":
    import uvicorn
    # 启动服务:支持多进程、高并发
    uvicorn.run(app, host="0.0.0.0", port=8000, workers=2)
该API服务完全适配生产环境,具备鉴权、限流、日志、健康检查、流式输出、异常捕获全套能力。服务启动后,可通过8000端口对外提供服务,支持多端远程调用,同时兼容并发请求,不会出现服务阻塞问题。
3. 接口生产优化策略
基础API服务开发完成后,还需要针对生产场景做专项优化,提升服务稳定性和并发能力,适配高流量业务场景,具体优化策略:
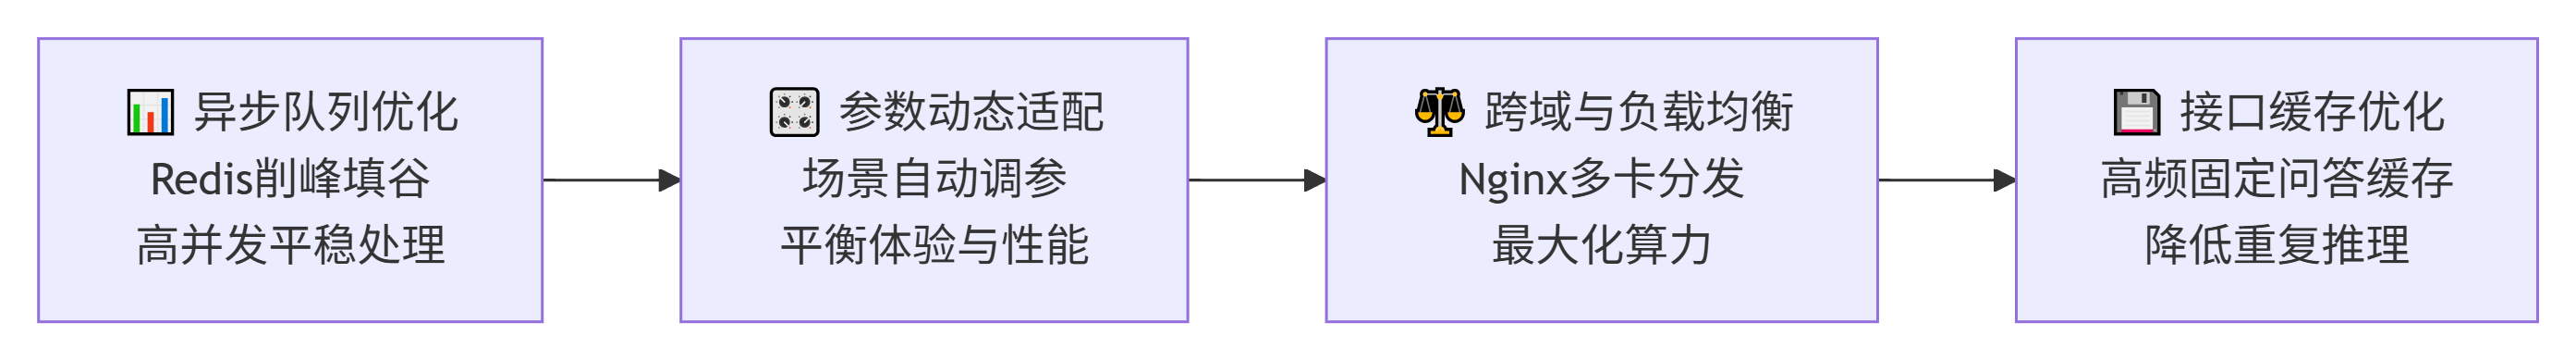
- 异步队列优化:高并发场景下,大量请求同时涌入会导致GPU过载。可基于Redis队列实现请求削峰,将瞬时高并发请求转为平稳队列处理,避免服务崩溃。
- 参数动态适配:根据业务场景自动调整推理参数,简单问答降低生成长度、提高速度;复杂创作场景提高生成长度、调整随机性,平衡体验与性能。
- 跨域与负载均衡:多系统对接时配置跨域权限,多GPU部署场景配置Nginx负载均衡,自动分发请求,最大化利用多卡算力。
- 接口缓存优化:针对高频固定问答场景,开启结果缓存,重复请求直接返回缓存结果,无需重复推理,大幅降低算力消耗。
通过以上优化,API服务可稳定支撑企业级业务流量,彻底解决普通接口并发低、稳定性差、成本高的问题,实现大模型服务的标准化业务落地。
五、服务监控与告警运维
1. 监控运维核心指标
部署并优化好大模型服务后,最后一步也是保障长期稳定运行的核心环节,就是监控告警与日常运维。AI服务和普通服务不同,需要重点监控算力资源、推理指标、请求指标、异常指标四大维度,一旦指标异常,及时触发告警、介入处理,避免业务故障。
四大核心监控维度及对应指标说明如下:
硬件资源监控(运维基础):
- 核心监控GPU显存使用率、GPU算力利用率、CPU使用率、服务器内存、磁盘使用率、网络出入流量。
- 大模型服务对GPU资源极其敏感,显存占用过高会直接触发OOM报错,算力利用率过低代表资源浪费、优化不到位,需要实时监控、及时调优。
推理业务监控(服务质量):
- 核心监控单请求平均推理延迟、token生成速度、批量推理吞吐量、上下文加载耗时、推理成功率。
- 延迟飙升、成功率下降,代表推理服务出现异常,需要及时排查模型、参数、资源问题。
接口请求监控(流量状态):
- 核心监控QPS并发量、总请求数、成功请求数、失败请求数、超时请求数、限流请求数。
- 通过请求数据可直观判断业务流量变化、接口稳定性,提前预判流量峰值,做好扩容准备。
异常日志监控(故障定位):
- 核心监控服务宕机日志、推理报错日志、参数异常日志、显存溢出日志、请求超时日志。
- 通过日志监控,可快速定位故障原因,缩短问题修复时间。
所有监控指标并非盲目采集,核心目的是实现故障提前预警、问题精准定位、资源合理调度、服务持续优化,保障AI服务7×24小时稳定运行。
2. 监控告警搭建示例
示例采用轻量级生产方案,基于Prometheus+Grafana实现指标监控,搭配Python实现自定义告警推送(企业微信/钉钉),无需复杂部署,快速搭建完整监控告警体系。
# 大模型AI服务自定义监控+告警代码
# 安装依赖:pip install prometheus-client psutil pynvml requests
import time
import psutil
import pynvml
import requests
from prometheus_client import Counter, Gauge, Histogram, start_http_server

# 1. 初始化GPU监控工具
pynvml.nvmlInit()
gpu_handle = pynvml.nvmlDeviceGetHandleByIndex(0)

# 2. 定义Prometheus监控指标
# 请求总量
LLM_REQUEST_TOTAL = Counter("llm_request_total", "大模型总请求数", ["status"])
# GPU资源指标
LLM_GPU_MEM = Gauge("llm_gpu_mem_usage", "GPU显存使用率")
LLM_GPU_UTIL = Gauge("llm_gpu_util", "GPU算力利用率")
# 推理延迟指标
LLM_INFER_LATENCY = Histogram("llm_infer_latency", "大模型推理延迟(秒)")

# 3. 钉钉告警推送函数
def ding_alert(msg: str):
    """异常告警推送至钉钉群"""
    webhook = "https://oapi.dingtalk.com/robot/send?access_token=你的钉钉机器人token"
    headers = {"Content-Type": "application/json"}
    data = {
        "msgtype": "text",
        "text": {"content": f"【大模型服务告警】{msg}"}
    }
    try:
        requests.post(webhook, json=data, headers=headers, timeout=5)
    except Exception as e:
        print("告警推送失败:", e)

# 4. 资源指标采集函数
def collect_resource_metric():
    while True:
        # 采集GPU指标
        mem_info = pynvml.nvmlDeviceGetMemoryInfo(gpu_handle)
        mem_usage = mem_info.used / mem_info.total * 100
        gpu_util = pynvml.nvmlDeviceGetUtilizationRates(gpu_handle).gpu

        # 更新监控指标
        LLM_GPU_MEM.set(mem_usage)
        LLM_GPU_UTIL.set(gpu_util)

        # 异常告警判断
        if mem_usage > 90:
            ding_alert(f"GPU显存使用率过高!当前使用率:{round(mem_usage,2)}%,临近溢出风险")
        if gpu_util < 10:
            ding_alert(f"GPU算力利用率过低!当前利用率:{gpu_util}%,资源严重浪费")

        time.sleep(5)  # 5秒采集一次

# 5. 推理延迟监控装饰器
def monitor_infer_latency(func):
    def wrapper(*args, **kwargs):
        start = time.time()
        res = func(*args, **kwargs)
        latency = time.time() - start
        LLM_INFER_LATENCY.observe(latency)
        # 延迟过高告警
        if latency > 10:
            ding_alert(f"推理延迟过高!当前延迟:{round(latency,2)}s")
        return res
    return wrapper

# 6. 请求状态监控
def update_request_status(status: str):
    """status: success/fail/timeout"""
    LLM_REQUEST_TOTAL.labels(status=status).inc()

# 7. 启动监控服务
if __name__ == "__main__":
    # 开启prometheus指标端口
    start_http_server(8090)
    print("监控服务启动成功,端口:8090")
    # 启动资源采集线程
    import threading
    threading.Thread(target=collect_resource_metric, daemon=True).start()
    while True:
        time.sleep(1)
部署上述代码后,即可实现全方位指标采集、异常自动告警,搭配Grafana可可视化展示监控面板,直观查看服务运行状态。同时支持自定义告警阈值,适配不同业务场景,是生产环境轻量化、高性价比的监控方案。
3. 日常运维落地规范
除了自动化监控告警,日常标准化运维是保障服务长期稳定的关键,完整的AI服务运维规范,覆盖四大核心场景:
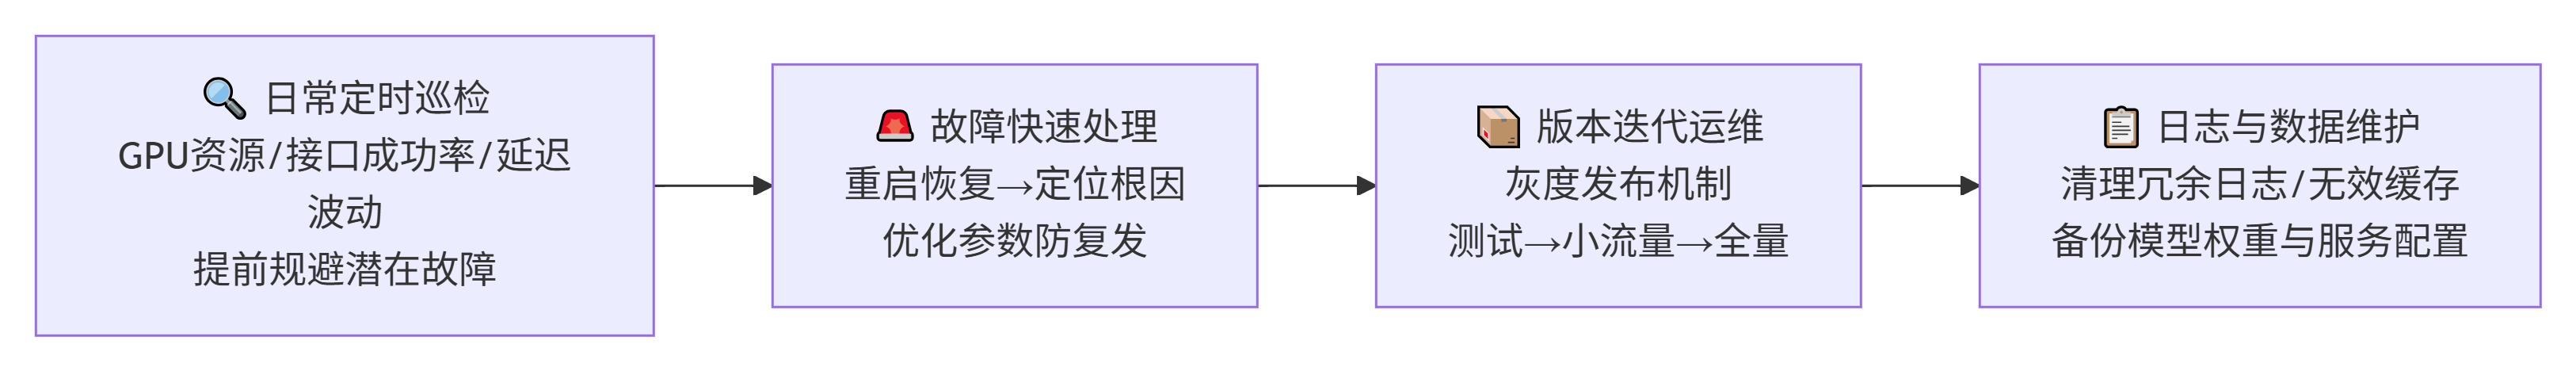
- 日常定时巡检:每日核查GPU资源使用率、接口请求成功率、推理延迟波动,每周统计服务吞吐量、资源利用率,针对性做性能优化、资源扩容,提前规避潜在故障。
- 故障快速处理:遇到服务宕机、推理报错、显存溢出等问题,优先重启服务恢复业务,再通过监控日志定位根因,优化参数、调整资源,避免问题重复发生。
- 版本迭代运维:模型更新、代码优化、参数调整时,采用灰度发布机制,先测试环境验证,再线上小流量灰度,最后全量更新,杜绝直接上线导致的服务故障。
- 日志与数据维护:定时清理冗余日志、无效缓存,释放磁盘空间,定期备份模型权重、服务配置,避免数据丢失,保障服务可回溯、可恢复。
六、总结
大模型AI服务部署与运维流程,核心围绕推理优化、API开发、监控运维三大核心工作,通常我们容易陷入“重算法、轻工程”的误区,认为大模型的核心是训练和微调,但在真实企业落地场景中,工程化能力直接决定了大模型能否商用、能否稳定创造价值。再好的模型效果,没有高性能的推理优化、标准化的接口服务、全方位的监控运维,都只是纸上谈兵,无法落地业务。
大模型应用,推理优化是性能基石,通过量化、缓存、批处理、引擎加速,解决延迟高、显存高、并发低的核心问题;API开发是业务桥梁,通过标准化接口、流式输出、安全限流,实现模型与业务系统的打通;监控运维是稳定保障,通过全维度指标监控、自动告警、标准化运维,实现服务可观测、可维护、高稳定。这三大模块共同构成了完整的大模型工程化体系。技术落地的核心从来不是复杂的理论,而是贴合场景的实战优化。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号