一场活动复盘,AI 帮我从 500 行数据里挖出了真正的增长点
原创
一场活动复盘,AI 帮我从 500 行数据里挖出了真正的增长点
原创
大盘鸡拌面
发布于 2026-10-10 19:07:16
发布于 2026-10-10 19:07:16
10 月底那场「7 天数据分析打卡营」做完,我手里剩下三样东西:一份被老板打回两次的复盘 PPT、一张 512 行的报名导出表、还有一个说不清到底是赚了还是亏了的预算账户。
活动本身不算失败。报名超了目标 20%,群里每天也有人在交作业。但最后付费转化只有 6.8%,跟上半年那期几乎持平——花了两个月筹备,钱砸下去了,人招来了,产出原地踏步。老板在复盘会上问了一句:「这次比上次好在哪?」我答不上来。
这就是我决定把那张表翻出来好好看一遍的原因。
一、500 行数据长什么样
先交代一下数据源。我们的后台导出是个扁平 Excel,一行一个报名用户,字段大概这样:
字段名 | 说明 |
|---|---|
user_id | 用户唯一 ID |
channel | 来源渠道(公众号 / 小红书 / 朋友推荐 / 信息流) |
is_new | 是否首次接触我们的课程 |
signup_time | 报名时间 |
day1_attend ~ day7_attend | 每天是否到课(0/1,缺课为空) |
push_slot | 推送时段(早 9 点 / 晚 8 点) |
pay_amount | 付费金额,未付费为空 |
churn_reason | 流失用户填的原因(文本,大量空着) |
一共 512 行,去掉重复报名(同一个人点了两次链接)后是 498 人。
数据不算多但也不算少——肉眼翻肯定翻不出规律,写 SQL 又总觉得有点重。这种量级正好是 AI 最能帮上忙的地方。
二、第一次尝试:把表丢给 AI,翻车了
我的第一反应很自然:把 CSV 前 50 行贴进对话框,问「帮我分析一下这次活动的增长机会在哪」。
AI 很殷勤地回了八百字,大意是:建议加强用户精细化运营、优化渠道投放结构、提升课程内容质量、建立完善的漏斗监控体系。
全是废话。
不是 AI 不行,是我问得太糙。我当时没告诉它口径是什么——「完课」到底算听满 7 天还是 5 天?「付费转化」的分母是报名人数还是到课人数?它不知道,就只能给我运营教科书上的目录。
而且 500 行数据里,最关键的第 5 列(is_new)跟第 6 列到第 12 列(每日到课)的关系,靠读前 50 行文本是读不出来的。语言模型擅长推理不擅长算数,这是常识,但我当时就是想偷个懒。
三、换个思路:先定口径,再让 AI 写代码
第二次我换了个玩法,把流程倒过来:

图里最关键的是中间那个菱形:不是所有「看起来有差异」的数字都配叫结论。 我这次踩得最狠的坑就在这一步,后面细说。
我的做法变成了「我出脑,AI 出手」——口径我来定,跑数脚本让 AI 写,最后的价值判断我再收回来自己做。
四、先把漏斗拉出来
我给 AI 的指令是这样写的:
我有一个 pandas DataFrame,字段是 xxx。帮我写 Python:①按 user_id 去重保留最早一条;②day1~day7 的空值补 0;③听满 5 天算完课;④输出「去重人数 → 到课 ≥1 天 → 到课 ≥3 天 → 完课 → 付费」五层漏斗,每层带人数、占比、环比流失率。
它一次就写对了。脚本这样:
import pandas as pd

raw = pd.read_excel("campaign_1027.xlsx")

# 1) 去重:同一个人可能点了两次报名链接
df = (raw.sort_values("signup_time")
         .drop_duplicates("user_id", keep="first")
         .reset_index(drop=True))
print(f"报名记录 {len(raw)} 行,去重后 {len(df)} 人")

# 2) 口径统一:缺课是空值,按未到课算
day_cols = [f"day{i}_attend" for i in range(1, 8)]
df[day_cols] = df[day_cols].fillna(0).astype(int)

# 3) 派生字段
df["attend_days"] = df[day_cols].sum(axis=1)
df["completed"]   = df["attend_days"] >= 5      # 内部口径:听满 5 天算完课
df["paid"]        = df["pay_amount"].fillna(0) > 0

# 4) 漏斗输出
total = len(df)
funnel = pd.DataFrame({
    "环节":   ["报名去重", "到课≥1天", "到课≥3天", "完课(≥5天)", "付费"],
    "人数":   [total,
               (df.attend_days >= 1).sum(),
               (df.attend_days >= 3).sum(),
               df.completed.sum(),
               df.paid.sum()],
})
funnel["占比%"]     = (funnel["人数"] / total * 100).round(1)
funnel["环比流失%"] = (-funnel["人数"].pct_change() * 100).round(1)
print(funnel.to_string(index=False))
跑出来是这样:
环节 | 人数 | 占比% | 环比流失% |
|---|---|---|---|
报名去重 | 498 | 100.0 | — |
到课 ≥1 天 | 371 | 74.5 | 25.5 |
到课 ≥3 天 | 262 | 52.6 | 29.4 |
完课(≥5 天) | 186 | 37.3 | 29.0 |
付费 | 34 | 6.8 | 81.7 |
一眼看过去最扎眼的是最后一层:完课的人 186 个,掏钱的只有 34 个,完课到付费只有 18.3%。我当时心里想的是「完了,肯定是销售转化话术有问题」。
我把这张表发给 AI,让它帮我分析。它顺着我的情绪说了一大段关于「付费引导时机」的建议。
这是我差点走错的一步。 后来证明,那 18.3% 根本不是主要矛盾。真正的问题,藏在按天拆的曲线里。
五、把 500 行按天切开,事情才露出马脚
换一个角度:不去横向看漏斗,纵向看每天的到课率。
# 逐日到场曲线
curve = pd.Series(
    [df[f"day{i}_attend"].mean() for i in range(1, 8)],
    index=[f"Day{i}" for i in range(1, 8)]
)
print((curve * 100).round(1).to_string())
print("最大单日跌幅:", round((curve.shift(1) - curve).max() * 100, 1), "个百分点")

# 关键:把 Day2 → Day3 掉的人单独拎出来
lost_at_d3 = df[(df.day2_attend == 1) & (df.day3_attend == 0)]
print("\nDay3 流失人数:", len(lost_at_d3), "占总体",
      round(len(lost_at_d3) / len(df) * 100, 1), "%")

# 这批人里,有多少本来可能付费的(用同画像完课用户的付费率做参照)
base_pay = df[df.completed].paid.mean()
print("预估可挽回付费:", round(len(lost_at_d3) * base_pay * 0.5, 1), "人")
输出:
Day1    71.2
Day2    64.9
Day3    42.8
Day4    41.1
Day5    39.6
Day6    37.3
Day7    36.5
最大单日跌幅: 22.1 个百分点

Day3 流失人数: 108 人,占总体 21.7 %
预估可挽回付费: 9.9 人
Day2 到 Day3,一口气掉了 22 个百分点。前面 Day1→Day2 只掉 6 个点,Day3 之后基本平了。
这条曲线的形状特别典型:第一天尝鲜、第二天还行、第三天讲的东西突然变难,人就走了。我去翻了那天的课件——Day1 讲 Excel 基础操作,Day2 讲函数,Day3 直接跳到 Power Query 多维表关联。对一个写着「零基础入门」的活动来说,这个坡度确实陡了。
那 108 个人里,如果哪怕能留住一半、按完课用户的付费率折算,大概能多出 10 个付费用户——相当于把这期转化从 34 人拉到 44 人,提升 29%。而我要改的东西只是:把 Day3 的课程拆成两节,中间加一次带练。
不用多花一分钱预算。
六、顺手挖出来的第二个坑:辛普森悖论
接着我按渠道看了一遍。第一版结果是这样:
g = df.groupby("channel").agg(
    人数   = ("user_id", "count"),
    完课率 = ("completed", "mean"),
    付费率 = ("paid", "mean"),
    客单价 = ("pay_amount", lambda s: s[s > 0].mean()),
).round(3).sort_values("付费率", ascending=False)
print(g.to_string())
渠道 | 人数 | 完课率 | 付费率 | 客单价 |
|---|---|---|---|---|
朋友推荐 | 86 | 61.6% | 12.8% | ¥1,240 |
公众号 | 173 | 44.5% | 8.7% | ¥980 |
小红书 | 121 | 32.2% | 4.1% | ¥860 |
信息流 | 118 | 21.2% | 1.1% | ¥690 |
看到这张表,我差点当场写结论:「信息流渠道质量差,下期砍掉。」
但我多问了自己一句:这 118 个信息流用户里,老用户多还是新用户多?拆开看——
g2 = (df.groupby(["channel", "is_new"])
        .agg(人数=("user_id", "count"),
             完课率=("completed", "mean"),
             付费率=("paid", "mean"))
        .round(3))
print(g2.to_string())
渠道 | 用户类型 | 人数 | 完课率 | 付费率 |
|---|---|---|---|---|
信息流 | 新用户 | 112 | 19.8% | 0.9% |
信息流 | 老用户 | 6 | 50.0% | 16.7% |
朋友推荐 | 新用户 | 41 | 51.2% | 9.8% |
朋友推荐 | 老用户 | 45 | 71.1% | 15.6% |
信息流只有 6 个老用户,这 6 个人拖不起 118 人的盘子。真实情况是:哪怕是信息流带来的老用户,付费率也有 16.7%,比朋友推荐的老用户(15.6%)还高一点。
也就是说,差的根本不是渠道,是用户类型。我在投放时把信息流定向全设成了「兴趣人群 - 数据分析」,拉来的全是纯新人。
结论从「砍掉信息流」修正成「把信息流预算的 40% 挪去定向已有粉丝/线索池做再营销」。这两个动作的差别,一年下来是六位数的预算。
七、把最后那 200 条留言也喂进去
数据里还有一列我一直没管:churn_reason,流失用户临走前填的一句话。有效留言 203 条,长短不一:
「第三天听不懂了,跟不上」 「晚上临时加班,落了两节就放弃了」 「内容还行但跟我做电商的没啥关系」 「学会 pivot 表就够了,后面的用不上」
这种文本 pandas 处理不了,正好丢给 LLM:
import os, json, time
import requests
import pandas as pd

API_KEY = os.environ["DEEPSEEK_API_KEY"]
URL     = "https://api.deepseek.com/chat/completions"

SYSTEM = """你是运营数据标注员。请把用户留言归入且仅归入以下一个标签:
课程难度过高 / 时间冲突 / 缺乏提醒 / 内容不相关 / 目标已达成 / 其他
严格返回 JSON:{"tag": "标签", "reason": "不超过15字的依据"}"""

def tag_one(text: str) -> dict:
    payload = {
        "model": "deepseek-chat",
        "temperature": 0,
        "response_format": {"type": "json_object"},
        "messages": [
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": f"用户留言:{text}"},
        ],
    }
    r = requests.post(URL,
                      headers={"Authorization": f"Bearer {API_KEY}"},
                      json=payload, timeout=30)
    return json.loads(r.json()["choices"][0]["message"]["content"])

reasons = df.loc[(~df.completed) & df.churn_reason.notna(), "churn_reason"]
rows = []
for t in reasons.head(200):
    try:
        rows.append(tag_one(t))
    except Exception as e:
        rows.append({"tag": "其他", "reason": f"调用失败 {e}"})
    time.sleep(0.3)   # 简单限速

tags = pd.Series([r["tag"] for r in rows])
print((tags.value_counts(normalize=True) * 100).round(1).to_string())
跑完分布是这样:
标签 | 占比 |
|---|---|
课程难度过高 | 36.5% |
目标已达成 | 22.2% |
时间冲突 | 18.7% |
缺乏提醒 | 12.3% |
内容不相关 | 6.8% |
其他 | 3.5% |
「课程难度过高」36.5% 排第一——跟第四节 Day3 那个 22 个点的断崖对上了。两条完全独立的证据指向同一件事,这个结论就稳了。
有意思的是排第二的「目标已达成」,超过了五分之一。这批人不是被难走的,是提前学会了就跑了。他们的留言大多是「学会 XX 就够了」。这提示我中间缺一层进阶钩子——付费用来买「剩下的部分」,但我压根没说清楚「剩下的部分」是什么。
别尽信 AI 的打标。 我抽了 30 条人工复核,一致率 26/30,四条不一致的基本都是「我觉得跟不上」这种能同时归到难度和时间的模糊表述。做决策时我把这部分按比例拆算了,没有直接拿 36.5% 当铁证。
八、人和 AI 到底怎么分工
整个流程跑下来,我摸索出的协作节奏大概是这样:
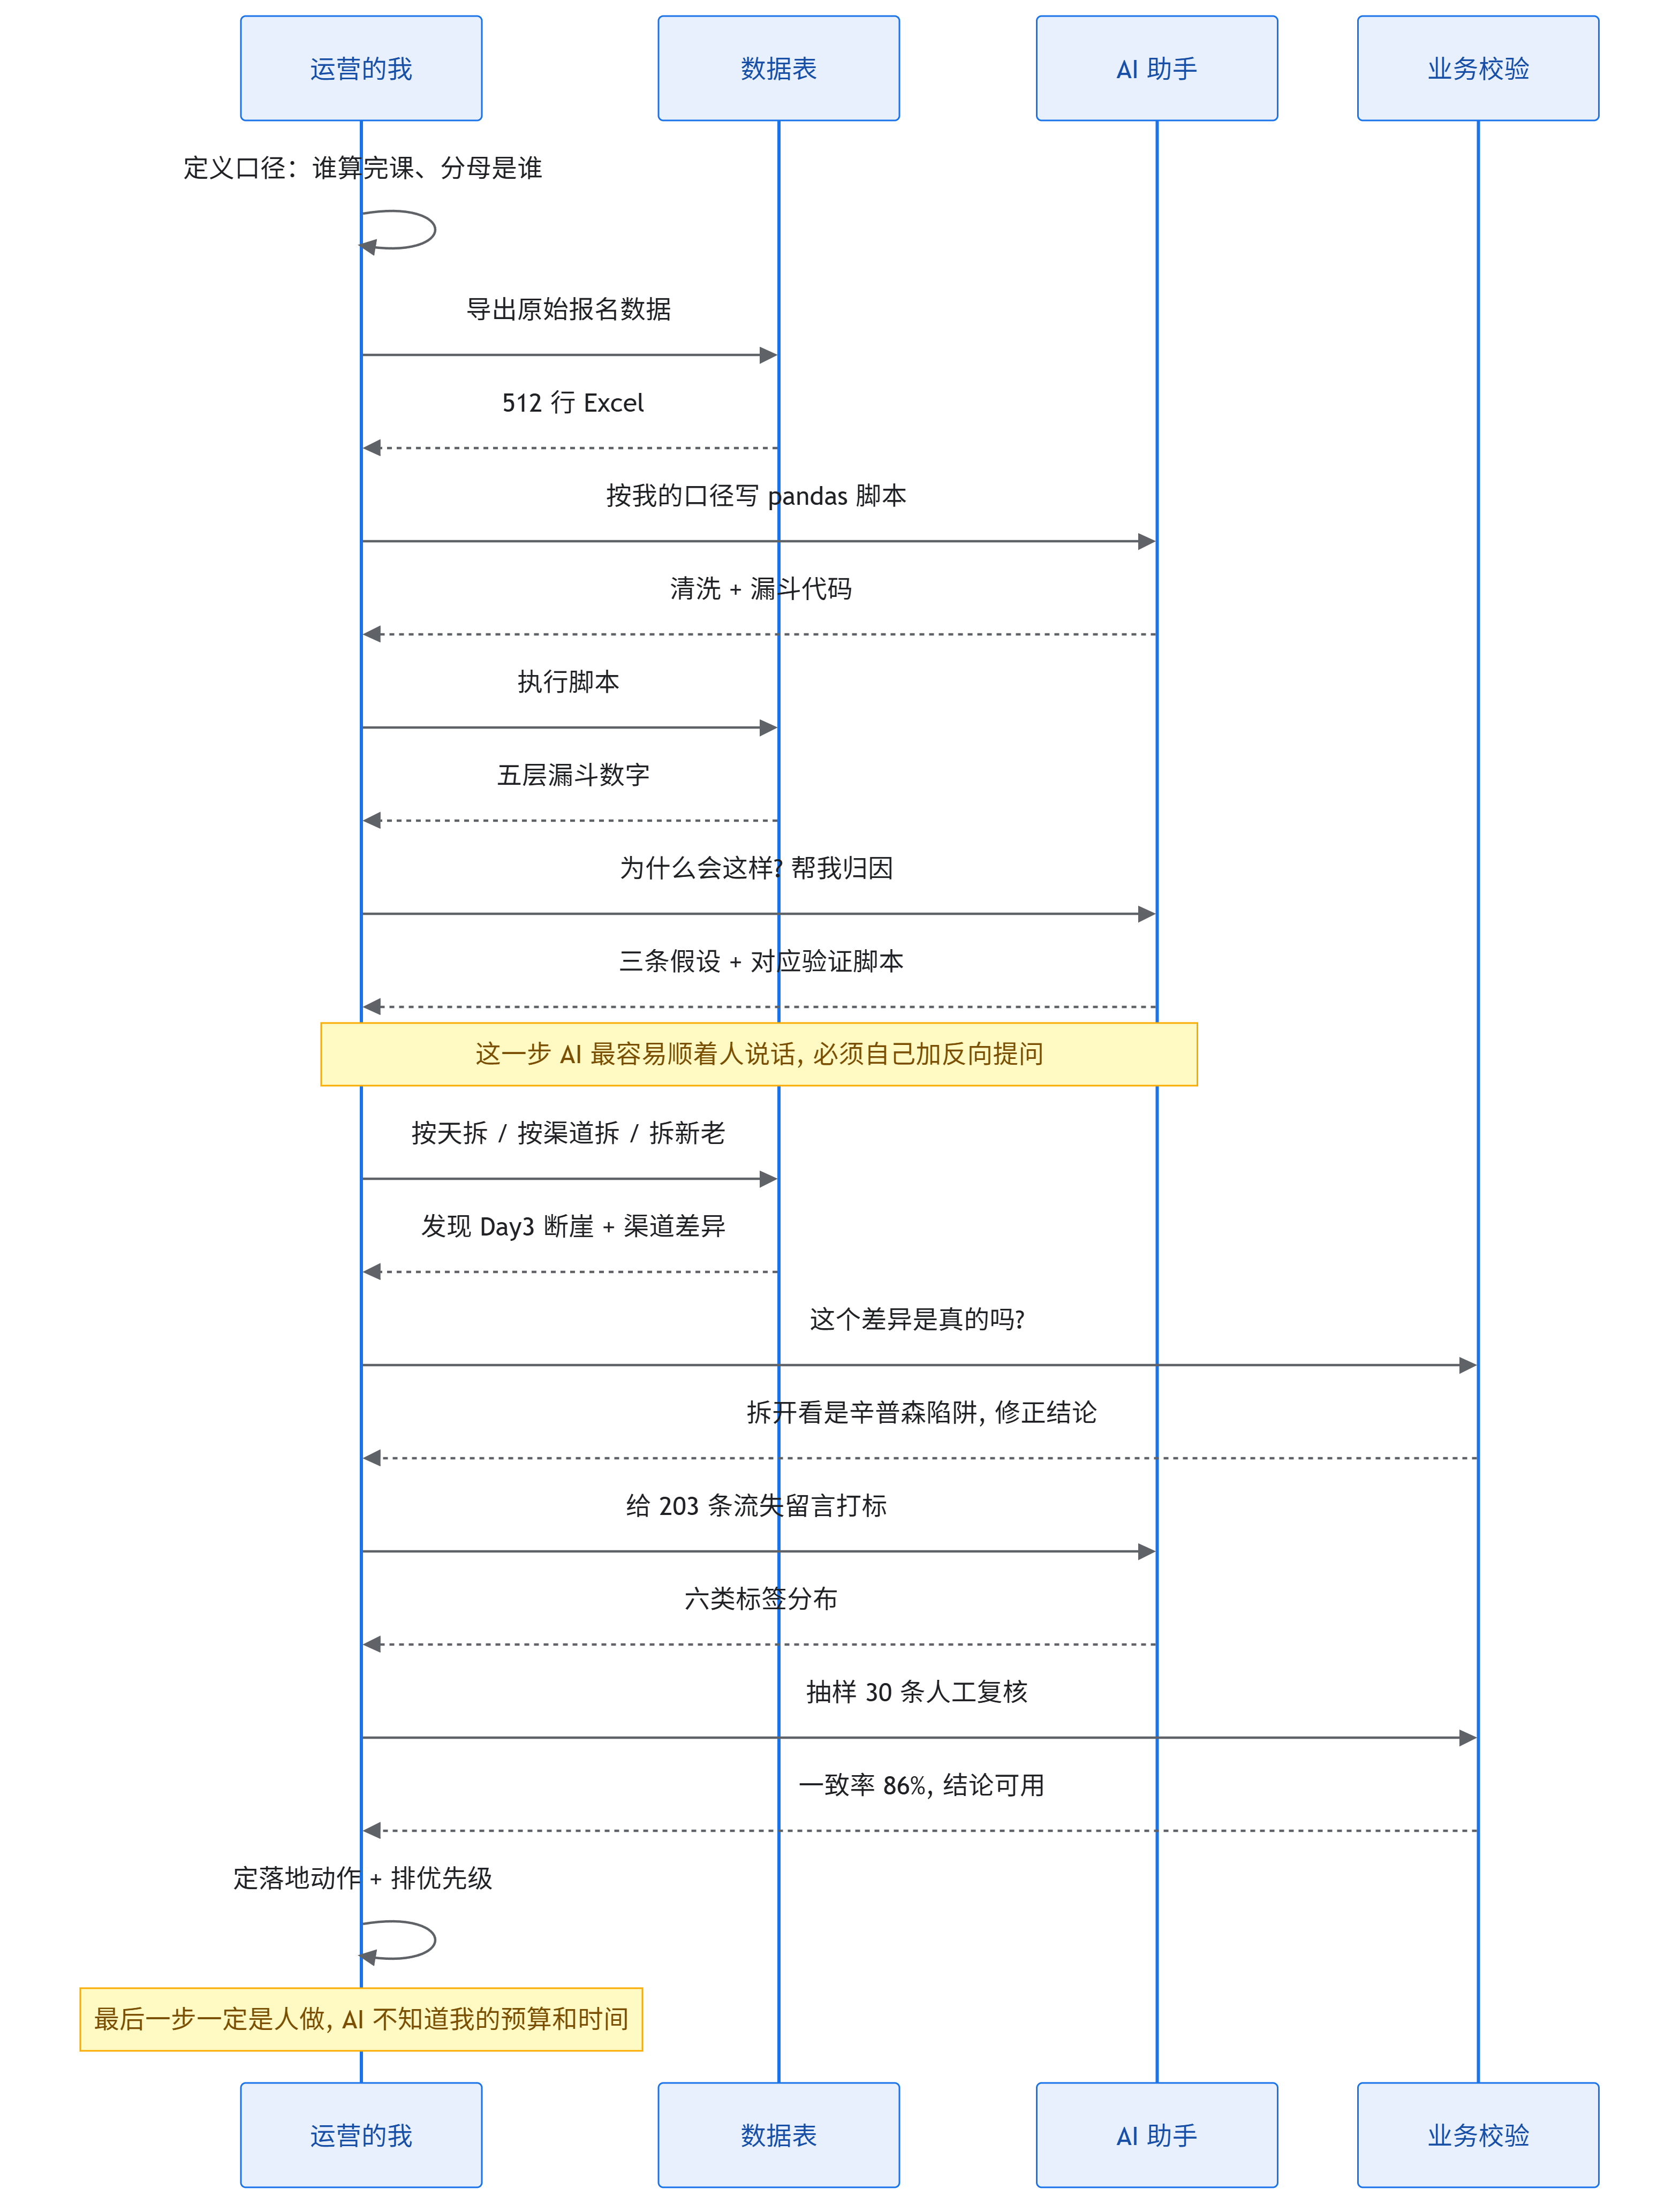
核心就一句话:AI 负责把「想到 A 就立刻能验证 A」的成本降到接近零,我负责决定要不要想 A。
以前验证一个想法要写 SQL、等数据同事排期,一个来回三天。现在我自己跑跑 pandas 十分钟出结果,一天能试七八个角度。试得多,撞到真东西的概率自然就上去了。
九、怎么判断一个差异值不值得信
这是我这趟最值钱的一条经验,单拎出来说。
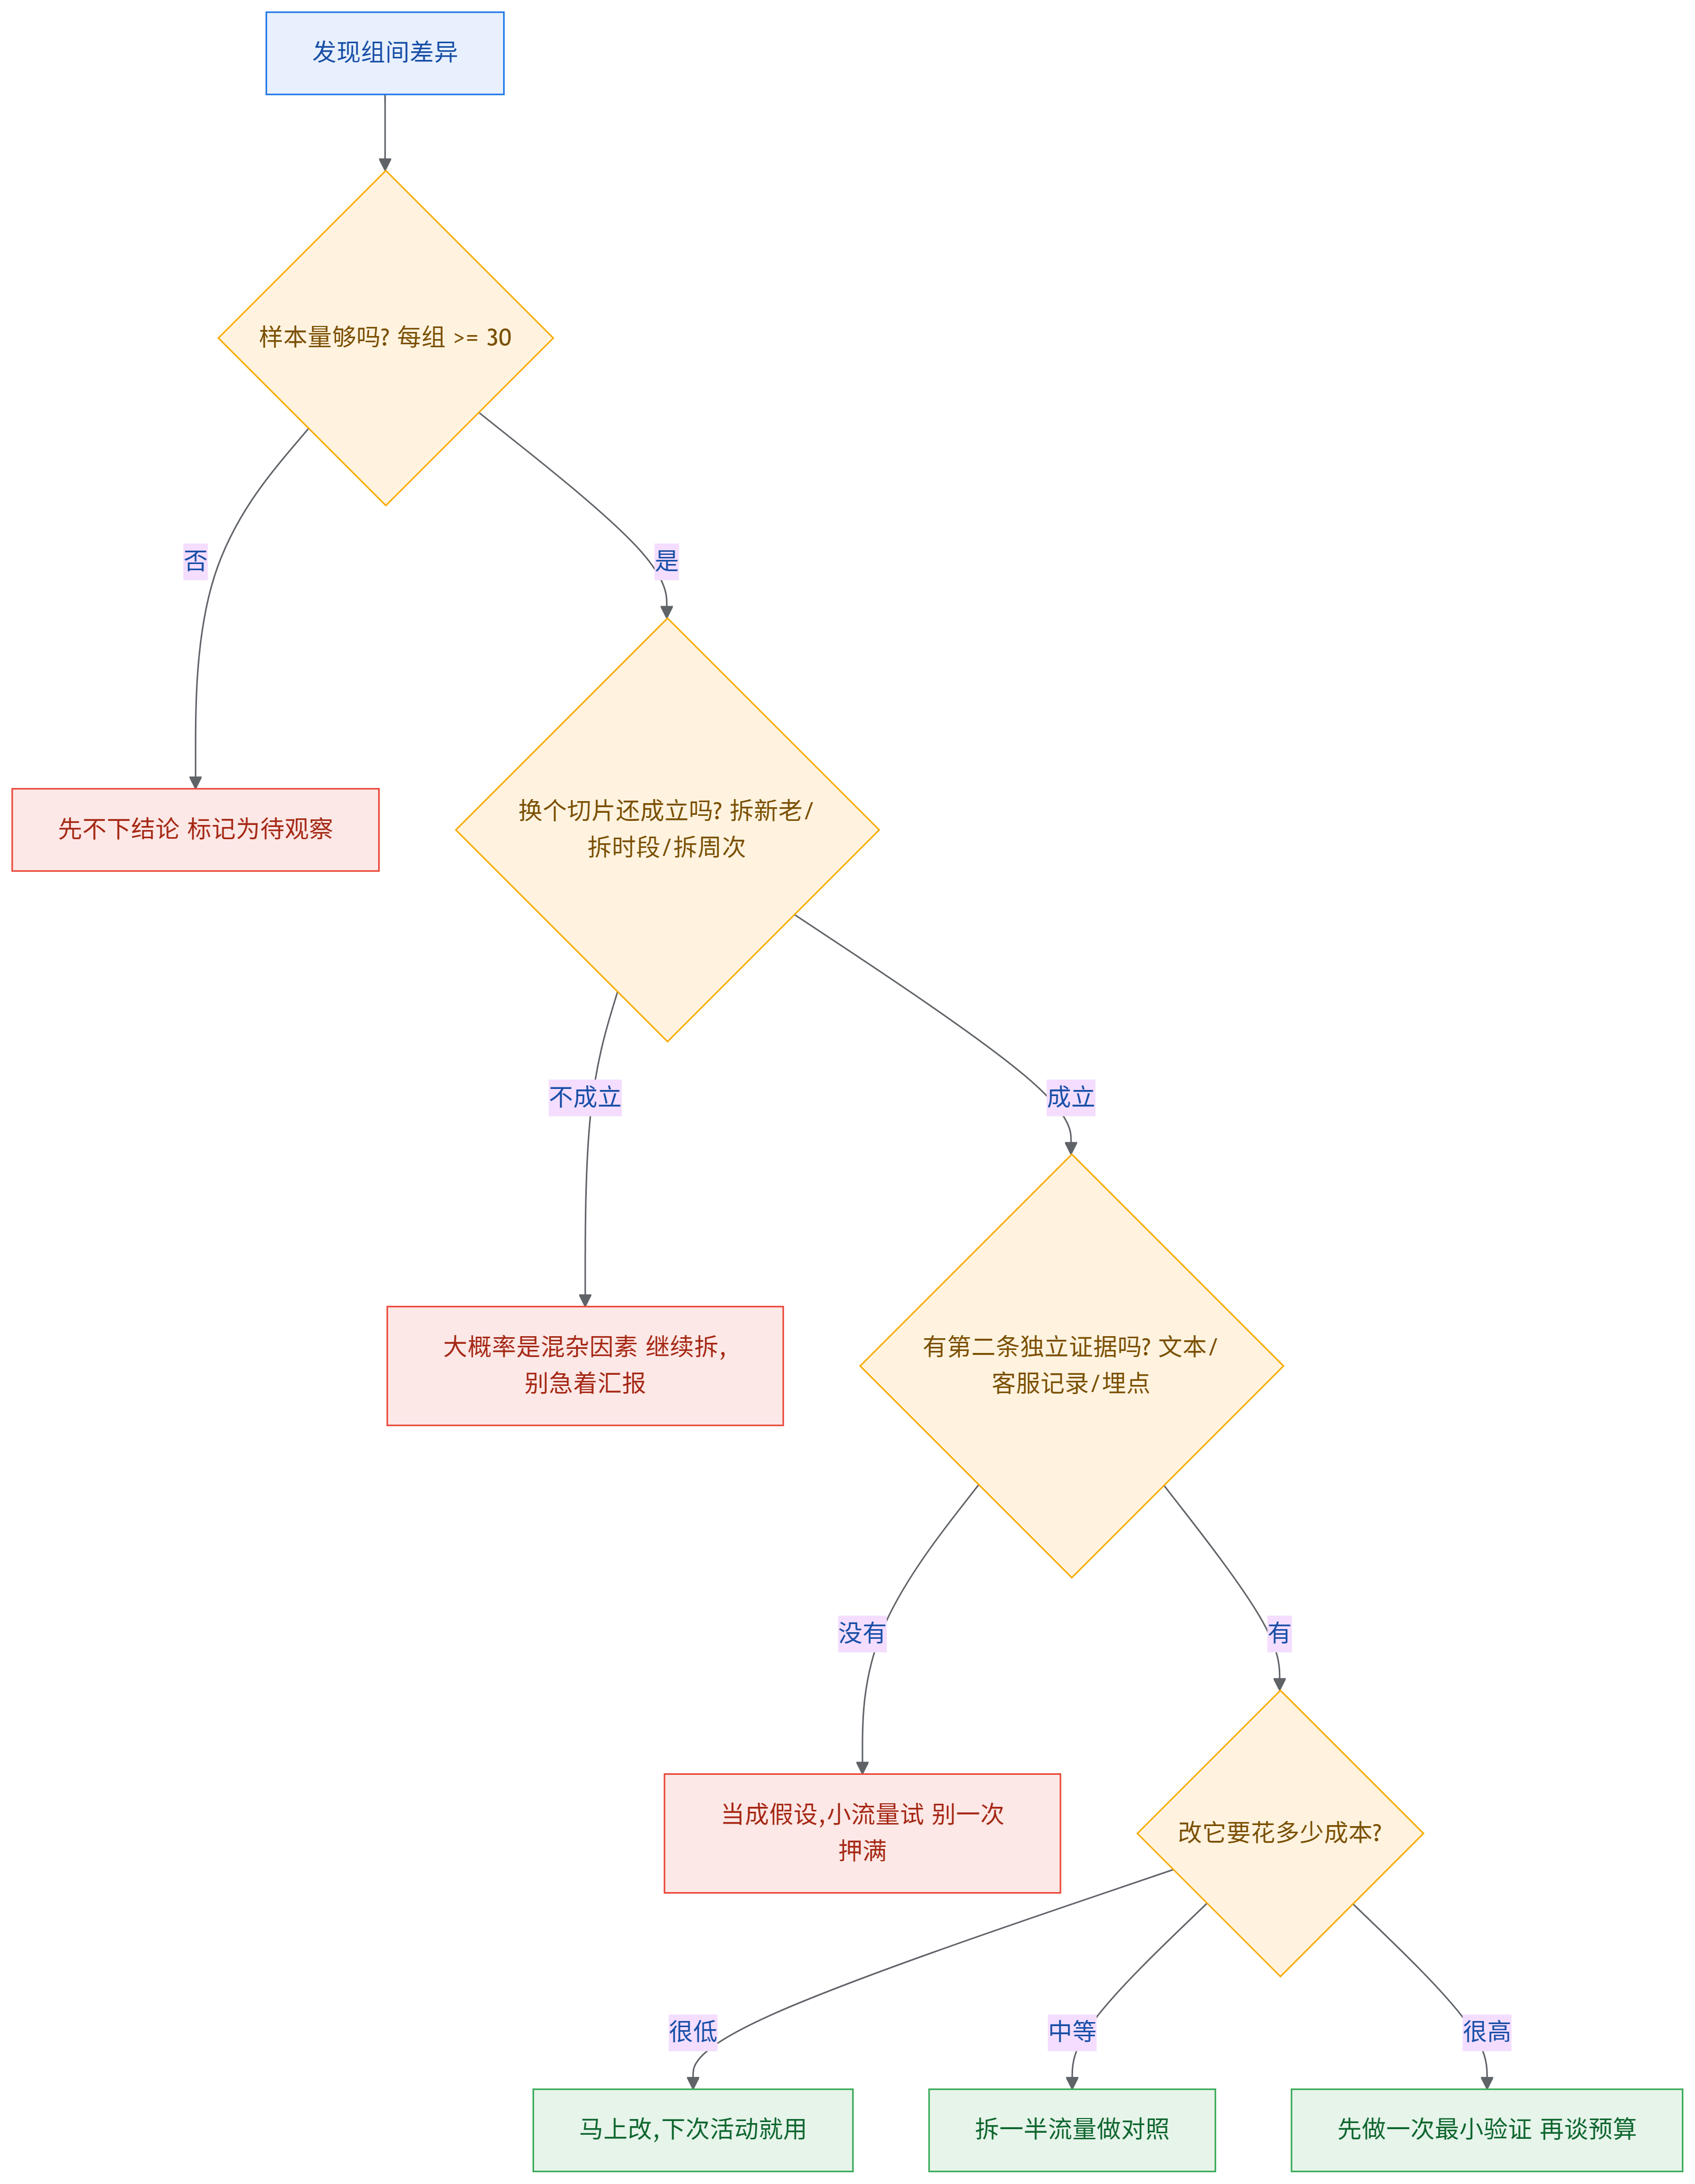
举个踩过的实例。我最早注意到「晚 8 点推送组」次日到课率 78%,「早 9 点推送组」只有 52%,兴奋得不行,觉得找到了万能钥匙。
然后我按上面的图走了一遍:
- 样本够吗? 晚 8 点组 341 人,早 9 点组 157 人,够了。
- 换个切片还成立吗? 拆渠道看——公众号里两个时段差 21 个点,小红书里差 26 个点,信息流里只差 4 个点。基本成立但不是全成立。
- 第二条证据? 有。留言里「缺乏提醒」那 12.3%,绝大多数是早 9 点组的,留言原话是「早上发的消息中午才看到」。
三条都过了,我才敢把这个结论写进复盘。执行时也没一刀切,先给新一期活动的 60% 用户改成了晚 8 点推送,剩下 40% 维持原样做对照。
结果:改推送那组次日到课率确实涨了 19 个点,对照组没变。这才算是闭环。
十、一个综合判断:这次到底该先动哪件事
三个发现摆在这儿:Day3 断崖(预估 +29% 转化)、渠道定向错配(预算重分配)、早 9 点推送(+19 个点次日到课)。三个都做,人不够。
我让 AI 帮我做了个简单的优先级估算:
# 粗略算一下每件事的“性价比”
items = pd.DataFrame([
    {"动作": "Day3 拆成两节 + 加带练", "预估影响人数": 108, "需改动天": 3, "成本元": 0},
    {"动作": "推送统一改晚8点",        "预估影响人数": 157, "需改动天": 1, "成本元": 0},
    {"动作": "信息流 40% 预算转再营销", "预估影响人数": 47,  "需改动天": 5, "成本元": 0},
])
items["影响/天"] = (items["预估影响人数"] / items["需改动天"]).round(1)
print(items.sort_values("影响/天", ascending=False).to_string(index=False))
排出来是:推时段 > Day3 改课 > 预算转移。
但最后我没完全按这个排。因为 Day3 改课虽然要 3 天,一旦改完每一期都能复用,是个资产;推时段改起来只要 1 小时,但天花板也就那样。所以我的实际排期是:Day3 改课优先,推时段第二周顺手做掉,预算转移放到下一次投放决策里。
这一步 AI 帮不了我。 它不知道我下周三要请假,也不知道教研同事手上还压着两门新课。
十一、第二期的结果
两个月后我们做了第二期,改动就是上面这些。对比:
指标 | 第一期(498 人) | 第二期(531 人) | 变化 |
|---|---|---|---|
Day1 到课率 | 71.2% | 73.8% | +2.6 |
Day3 到课率 | 42.8% | 61.4% | +18.6 |
完课率(≥5 天) | 37.3% | 58.1% | +20.8 |
付费转化率 | 6.8% | 11.4% | +4.6 |
付费人数 | 34 | 61 | +27 |
获客总成本 | ¥86,000 | ¥71,500 | -16.9% |
Day3 那条曲线没那么陡了,完课率涨了 20 个点,付费转化从 6.8% 提到 11.4%。而且因为砍了无效投放,预算反而省了小两万。
复盘会上我把这张表放上去的时候,老板没再问「这次比上次好在哪」。
十二、五个我认为最实在的经验
1. 先跟 AI 对齐口径,再让它干活。 我后来把口径写死在一个 prompt 开头,每次复用:
以下是本次分析的固定口径,任何回答都必须遵守:
- 完课 = 7 天中到课 >= 5 天
- 付费转化分母 = 去重后报名人数(不是到课人数)
- 流失 = 有报名但完课为否
- 任何结论必须给出计算该结论所需的代码或数字来源
- 如果我的假设缺少数据支撑,直接指出,不要顺着说
最后那句是灵魂。没有它,AI 会非常配合地论证你的每一个偏见。
2. 数字差异要跨切片验证。 单一维度上出现的差距,八成是某个隐藏变量在捣乱。老用户比例、时段、周次、设备,随便哪个都能制造假象。
3. 别让 AI 替你做最终决策。 它能算出「Day3 断崖最严重」,但算不出「教研老师这周没空」。最后的判断权必须留在自己手里。
4. 留对照。 任何改动都别一次性全铺。我这期留了 40% 的对照组,才敢在复盘会上说「这个提升是我改出来的」而不是「这个提升可能是运气」。
5. 把力气花在可复用资产上。 一次性的优化做完就归零,改课程结构、改 SOP、搭个能跑的脚本,这些是会复利的。
说实话,500 行数据其实很小。小到以前我压根懒得认真看,随手截个图往 PPT 里一贴,写两句「建议优化渠道结构」就交差了。
AI 在这件事上给我的最大帮助,不是替我写了那几段 pandas,也不是给 203 条留言打了标——是它把「多试一个角度」的成本压到了近乎为零。 我那天下午一口气试了十几种切法,最后撞到 Day3 那个断崖。要是按以前写 SQL 等排期的节奏,我大概率试两三个角度就收工了,然后得出一个「渠道不太行」的错误结论,顺手把信息流预算砍掉。
工具变了,但值钱的那部分从来没变:口径是不是你自己定的、有没有给结论找反证、改完之后留没留对照。
这三件事,AI 一件都替不了你。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号