不同场景的Agent流程定义和执行思路构建:Agent标准化定义、执行机制全流程实践25.1
原创
不同场景的Agent流程定义和执行思路构建:Agent标准化定义、执行机制全流程实践25.1
原创
未闻花名
发布于 2026-10-11 19:05:40
发布于 2026-10-11 19:05:40
一、前言
不得不感叹,智能体已经从概念噱头变成了各行各业的落地刚需。不管是日常办公自动化、智能客服答疑、数据分析复盘,还是复杂的科研推理、代码开发、业务决策,都能看到Agent的身影。很多朋友初学Agent时,都会陷入一个误区:以为Agent就是简单调用大模型接口,加上几句提示词就能实现智能自动化。
但真正落地项目时就会发现,简单的提示词调用完全无法适配复杂场景,经常出现逻辑混乱、任务中断、重复执行、输出无效等问题。核心原因就是缺少了标准化的流程定义和清晰的执行思路,不同场景下的Agent能力边界、执行逻辑、调度规则完全不同,混用模板只会导致项目落地失败。大模型Agent的底层逻辑,核心就是需要区分轻量交互、任务自动化、复杂推理、工具协同四大应用场景,要根据实际情境构建适配业务场景的智能Agent业务。
二、Agent核心基础
1. Agent核心定义
大模型Agent是基于大语言模型构建的自主智能执行体,核心能力是脱离人工持续干预,自主感知任务、拆解步骤、调用能力、迭代执行、输出结果并纠错优化。它区别于单纯被动应答的大模型对话,能够主动驱动任务落地,核心属性如下:
- 能力差异:普通大模型是“问什么答什么”的被动工具,Agent是“接到目标就自主做完”的主动执行者;
- 核心本质:以大模型作为决策大脑,搭配流程调度、工具调用、记忆存储、纠错迭代模块,实现任务全流程自动化闭环。
2. 核心组成模块
所有场景的Agent,底层都由五大核心模块构成,模块协同工作支撑完整流程,缺一不可,具体拆解如下:
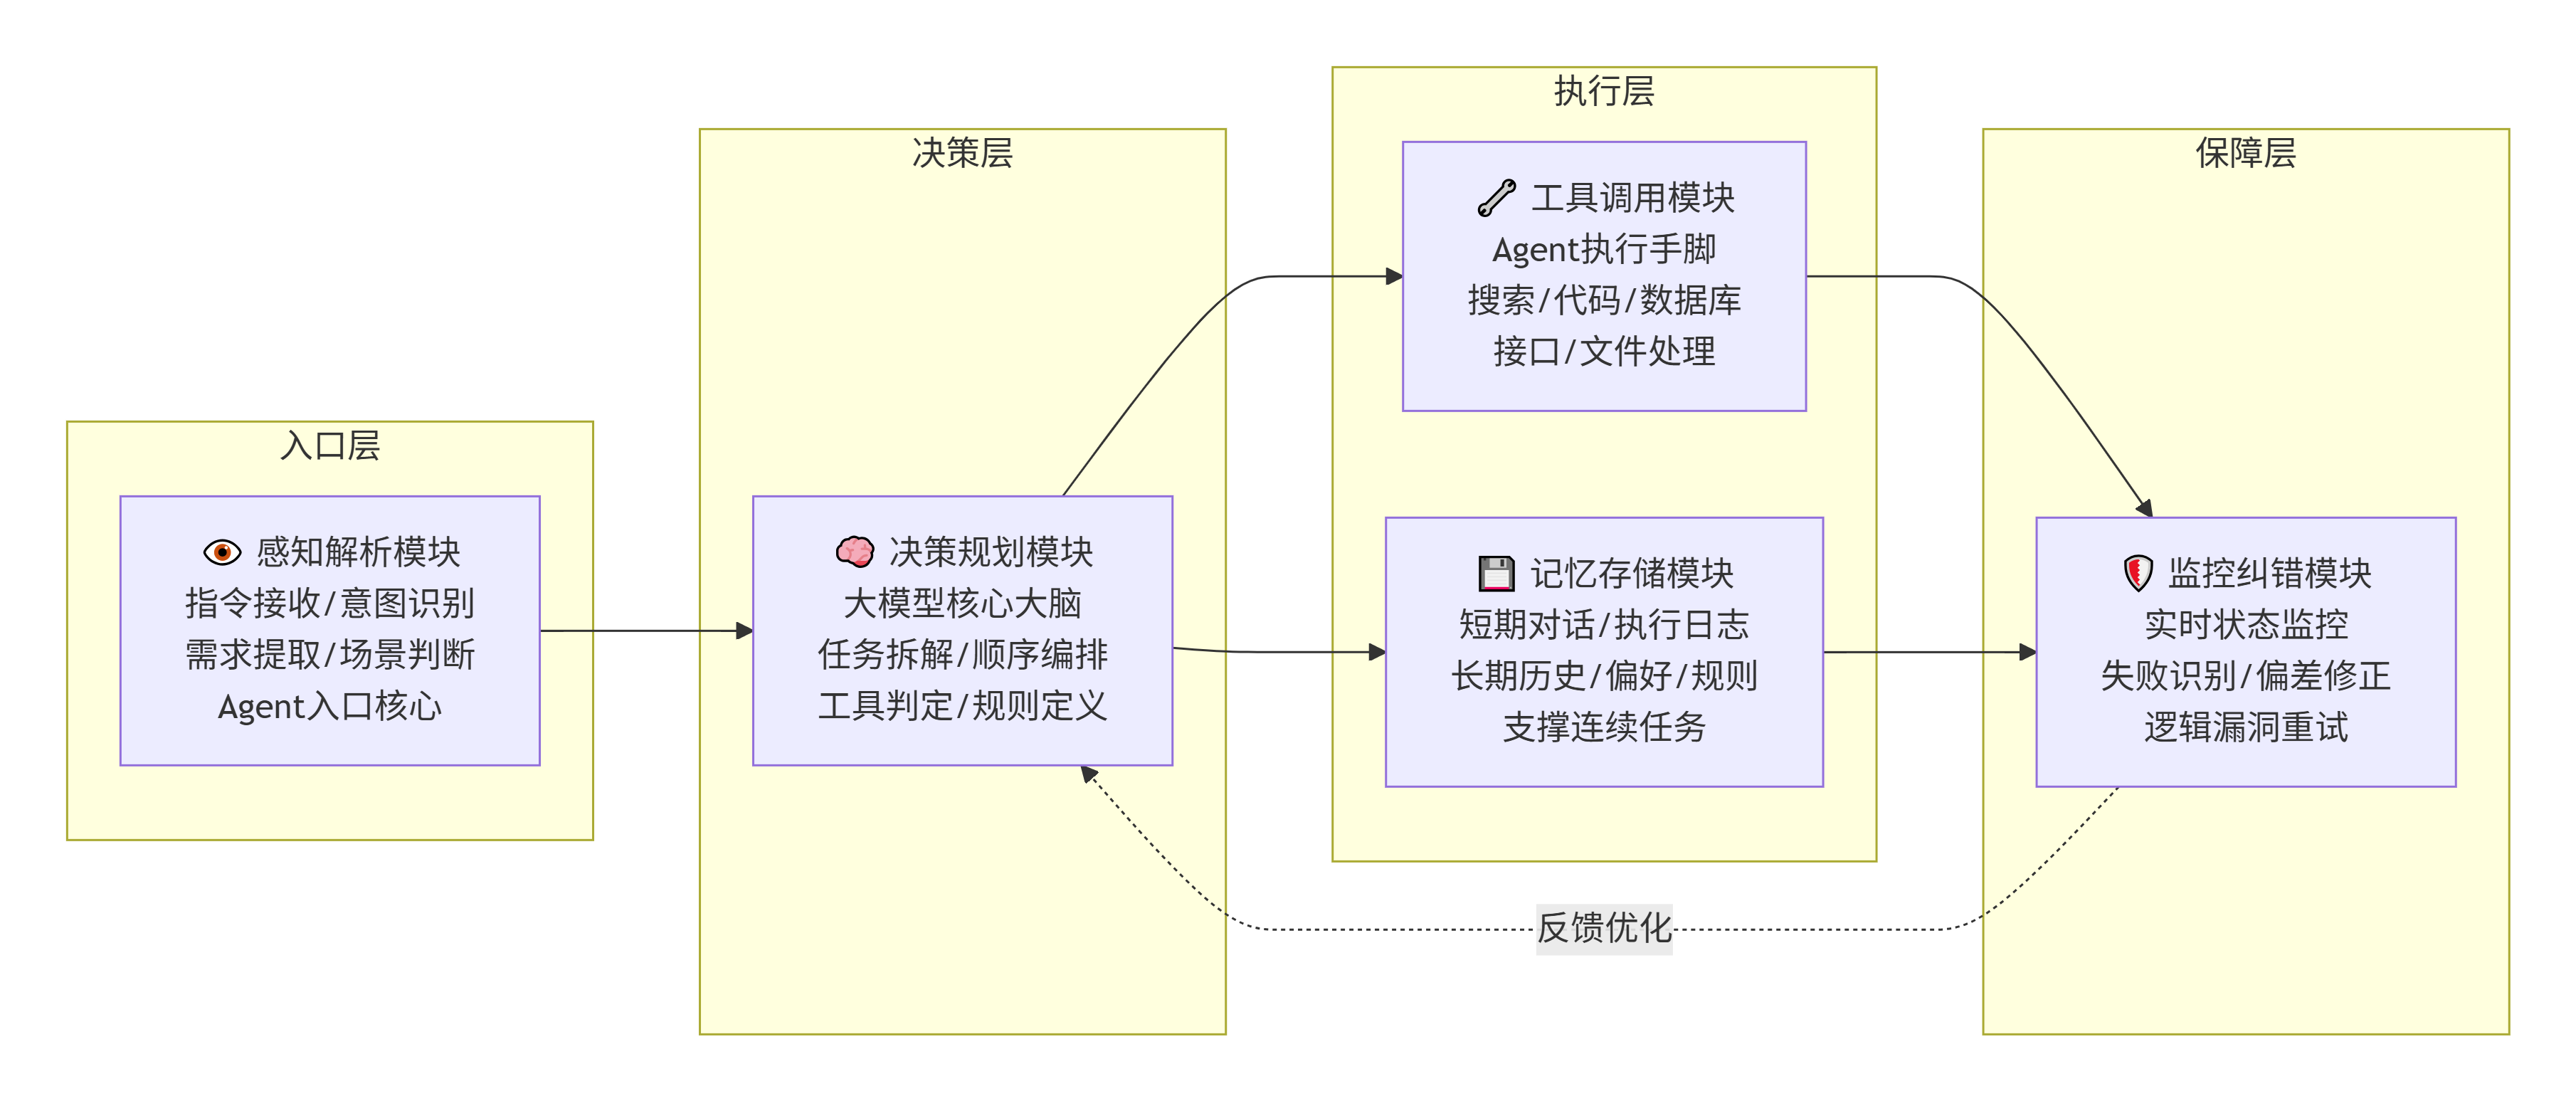
- 感知解析模块:负责接收用户自然语言指令、识别任务类型、提取核心需求、判断场景属性,是Agent的入口核心。该模块决定后续所有执行逻辑的方向,解析精度直接决定Agent最终效果。
- 决策规划模块:大模型核心大脑,负责将复杂总任务拆解为多个可执行的子任务,制定执行顺序、判定所需工具、定义执行规则,是Agent自主能力的核心。
- 工具调用模块:Agent的执行手脚,对接各类外部能力,包括搜索引擎、代码解释器、数据库、接口服务、文件处理工具等,弥补大模型实时性、实操性不足的短板。
- 记忆存储模块:分为短期记忆和长期记忆,短期存储当前任务对话上下文、执行日志,长期存储历史任务、用户偏好、业务规则,支撑连续任务执行和迭代优化。
- 监控纠错模块:实时监控子任务执行状态,识别执行失败、结果偏差、逻辑漏洞,自主进行重试、修正、终止任务,保障流程闭环稳定。
3. 通用执行流程
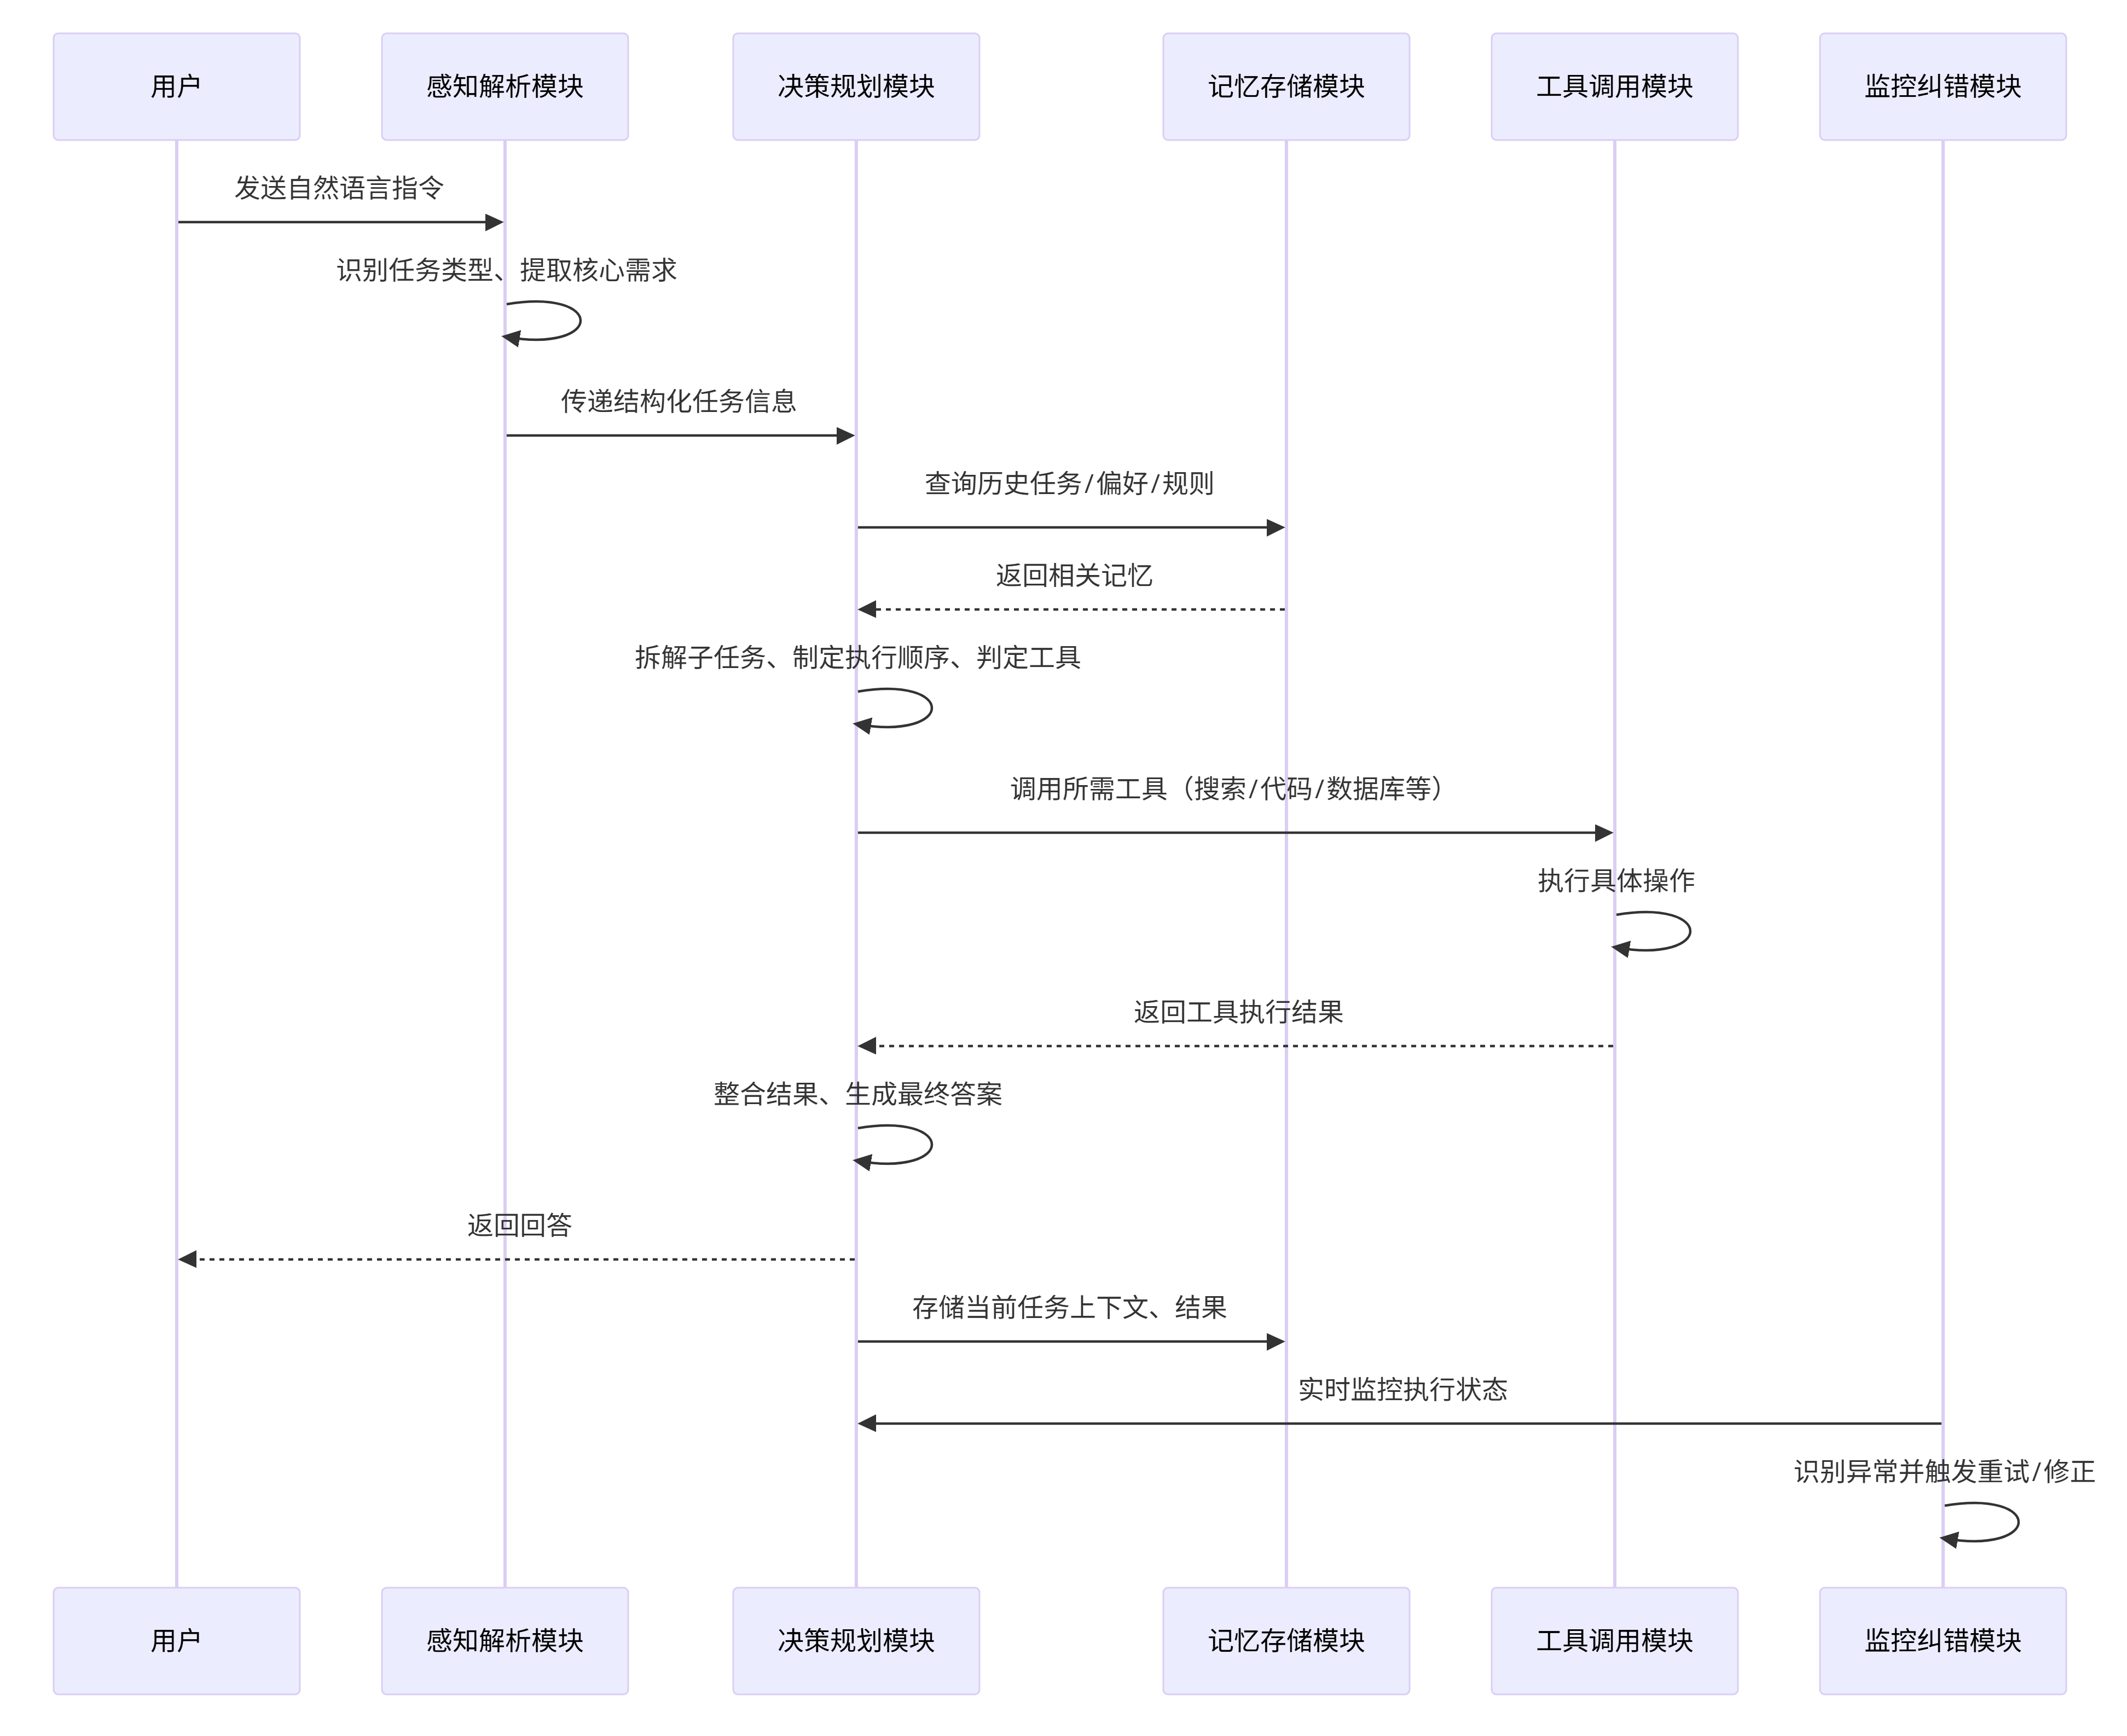
所有场景Agent都遵循一套基础通用流程,不同场景仅在流程细化规则、模块权重、执行逻辑上存在差异,通用流程分为五大核心步骤,层层闭环:

- 1. 需求接收与解析:接收用户输入,清洗无效信息,精准识别任务目标、场景类型、执行要求;
- 2. 任务拆解与规划:根据任务复杂度,拆解为有序子任务,匹配对应执行能力与工具;
- 3. 自主迭代执行:按规划顺序逐个子任务执行,按需调用工具、读取记忆信息;
- 4. 结果校验纠错:校验执行结果是否符合需求,不合格则自主迭代修正;
- 5. 结果整合输出:汇总所有子任务结果,结构化整理输出,同时存储执行日志与记忆信息。
4. 通用Agent示例
以下示例实践了一个大模型Agent通用基础框架的完整架构,包括标准化底层执行逻辑,统一多场景Agent运行规范,BaseAgent基类封装了Agent的五大核心能力:
- 任务解析:识别需求与场景;
- 任务规划:拆解为可执行子任务;
- 任务执行:逐个子任务调用大模型落地;
- 结果校验:检查执行结果是否合格;
- 记忆管理:区分短期记忆与长期记忆;
run方法串联全流程形成完整的"感知→规划→执行→校验"闭环,llm_invoke作为模拟接口,实际项目中替换为所需大模型API即可。
# 大模型Agent通用基础框架
import json
from typing import List, Dict

# 大模型调用接口
def llm_invoke(prompt: str) -> str:
    return f"【大模型推理结果】基于输入指令完成任务解析与规划:{prompt[:30]}..."

class BaseAgent:
    """Agent基础父类,封装通用能力"""
    def __init__(self):
        self.short_memory: List[Dict] = []  # 短期记忆:当前任务上下文
        self.long_memory: List[Dict] = []   # 长期记忆:历史任务数据
        self.task_status = "idle"           # 任务状态:idle/working/finish/error

    def parse_task(self, user_input: str) -> Dict:
        """1. 任务解析:识别需求、场景、任务类型"""
        self.task_status = "working"
        prompt = f"请解析用户任务,输出JSON格式:任务目标、场景类型、任务复杂度、所需工具\n用户指令:{user_input}"
        res = llm_invoke(prompt)
        self.short_memory.append({"type": "parse", "content": user_input, "result": res})
        return {"task_target": user_input, "scene_type": "通用场景", "complex": "普通"}

    def plan_task(self, parse_result: Dict) -> List[str]:
        """2. 任务规划:拆解子任务"""
        prompt = f"基于任务解析结果,拆解为可执行子任务,分点输出:{json.dumps(parse_result)}"
        res = llm_invoke(prompt)
        sub_tasks = [f"子任务{i+1}" for i in range(3)]
        self.short_memory.append({"type": "plan", "content": "任务拆解", "result": sub_tasks})
        return sub_tasks

    def execute_task(self, sub_tasks: List[str]) -> List[str]:
        """3. 任务执行:逐个子任务落地"""
        execute_results = []
        for task in sub_tasks:
            res = llm_invoke(f"执行子任务:{task}")
            execute_results.append(res)
        self.short_memory.append({"type": "execute", "content": "子任务执行", "result": execute_results})
        return execute_results

    def check_result(self, execute_results: List[str]) -> bool:
        """4. 结果校验纠错"""
        prompt = f"校验任务执行结果是否合格:{json.dumps(execute_results)}"
        res = llm_invoke(prompt)
        return True

    def run(self, user_input: str) -> str:
        """Agent全流程运行入口"""
        # 步骤1:解析任务
        parse_res = self.parse_task(user_input)
        # 步骤2:规划任务
        plan_res = self.plan_task(parse_res)
        # 步骤3:执行任务
        exec_res = self.execute_task(plan_res)
        # 步骤4:校验结果
        check_res = self.check_result(exec_res)
        # 步骤5:整合输出
        self.task_status = "finish"
        self.long_memory.append(self.short_memory.copy())
        return f"任务执行完成!执行结果:{exec_res}"

# 测试通用Agent
if __name__ == "__main__":
    agent = BaseAgent()
    result = agent.run("帮我整理本周工作周报,汇总核心工作、问题与下周计划")
    print(result)
三、轻量交互场景Agent
1. 场景核心特征
轻量交互场景是最基础、应用最广泛的Agent场景,涵盖日常问答、文案润色、简单答疑、短句创作、信息解读等需求。该场景的核心特点是任务单一、逻辑简单、无需多轮迭代、无需外部工具调用、执行链路短,具体场景特征拆解如下:
- 任务维度:单目标任务,无复杂子任务拆分,用户需求清晰明确;
- 工具依赖:零外部工具依赖,仅依靠大模型自身知识与推理能力即可完成;
- 执行链路:单次解析、单次执行、直接输出结果,无循环迭代;
- 纠错需求:极低,几乎不需要二次校验修正;
- 应用场景:文案改写、知识问答、话术生成、简单内容总结、文本纠错等。
2. 完整流程定义
轻量交互场景无需复杂调度,流程极简且闭环,全程无冗余步骤,可最大化保障响应速度,标准化完整流程:
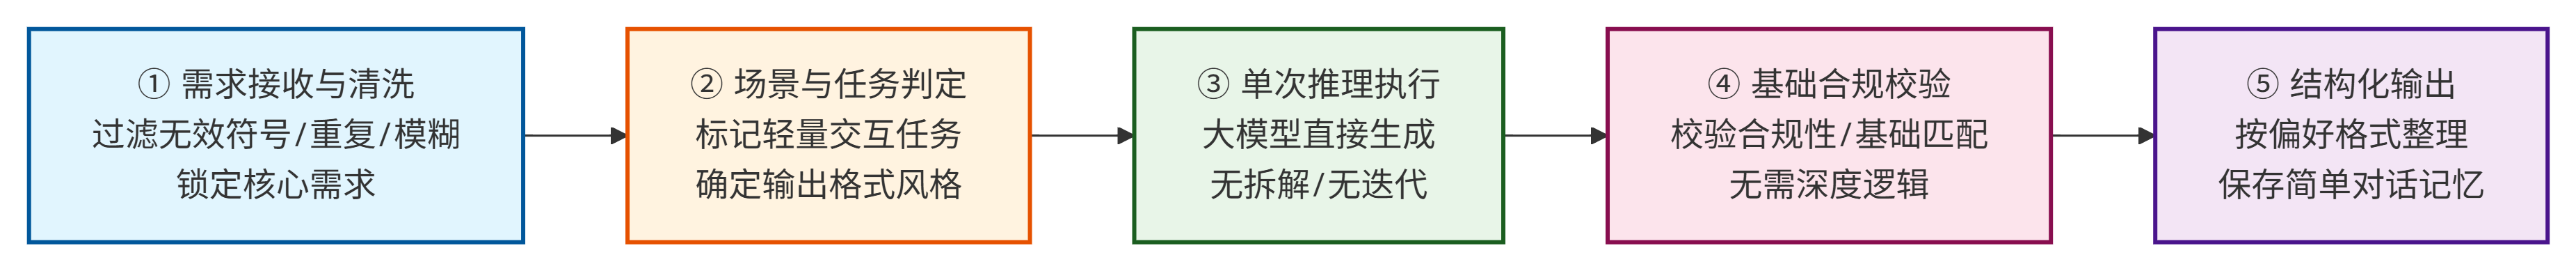
- 1. 需求接收与清洗:接收用户自然语言输入,过滤无效符号、重复语句、模糊表述,锁定核心需求。该场景下无需深度语义理解,仅需基础文本清洗,保障输入规范。
- 2. 场景与任务判定:快速判定为轻量交互任务,标记无需工具调用、无需多轮迭代,确定输出格式与风格要求。
- 3. 单次推理执行:大模型基于清洗后的需求,直接完成内容生成、解答、润色等操作,无需任务拆解。
- 4. 基础合规校验:仅校验内容合规性、是否匹配用户基础需求,无需深度逻辑校验。
- 5. 结构化输出:按照用户偏好格式(短句、段落、分点)整理结果,直接输出并保存简单对话记忆。
3. 核心执行思路
该场景Agent的核心执行思路是轻量化、高响应、极简链路,通过简化冗余流程换取极致的响应速度和稳定性:
- 简化任务规划:摒弃复杂子任务拆解逻辑,判定为轻量任务后,直接跳过规划环节,进入推理执行,减少耗时;
- 弱化工具依赖:全程不调用外部工具、数据库、接口,仅依托大模型原生能力,避免工具调用报错、超时等问题;
- 精简记忆存储:短期记忆仅保存当前对话上下文,长期记忆仅存储高频固定需求,减少存储开销,提升运行效率。
轻量交互Agent无需复杂架构优化,核心优化关键:
- 核心关键:提示词精准度,通过标准化提示词约束输出格式、风格、内容范围,即可实现优质效果;
- 注意要点:杜绝过度开发,不叠加多余的工具调度、迭代校验逻辑,保证极速响应。
4. 轻量交互Agent示例
基于通用BaseAgent框架定制的轻量交互场景Agent。LightInteractiveAgent通过方法重写对父类流程进行精简:
- parse_task 采用固定规则快速判定场景,跳过复杂推理;
- plan_task 不再拆解子任务,直接返回单任务;
- check_result 仅做基础合规校验;
run方法将完整链路缩减为"解析→执行→校验"三步,并替换为响应更快的llm_light_invoke。整体设计遵循"按需裁剪"原则,针对问答、文案、润色等简单场景去除冗余环节,在保证功能完整的前提下显著降低推理开销与响应延迟。
# 轻量交互场景Agent(问答/文案/润色专属)
from typing import Dict
from base_agent import BaseAgent

def llm_light_invoke(prompt: str) -> str:
    """轻量场景专属大模型调用,精简推理逻辑,提升响应速度"""
    return f"【轻量交互结果】已完成需求响应:{prompt[:40]}..."

class LightInteractiveAgent(BaseAgent):
    """轻量交互专属Agent,精简执行链路,适配简单问答、文案场景"""
    def parse_task(self, user_input: str) -> Dict:
        """重写任务解析:快速判定轻量场景,精简解析逻辑"""
        self.task_status = "working"
        # 轻量场景固定解析规则,无需复杂推理
        parse_result = {
            "task_target": user_input,
            "scene_type": "轻量交互",
            "complex": "简单",
            "need_tool": False,
            "need_iter": False
        }
        self.short_memory.append({"type": "parse", "result": parse_result})
        return parse_result

    def plan_task(self, parse_result: Dict):
        """重写任务规划:轻量任务无需拆解子任务,直接返回单任务"""
        return [parse_result["task_target"]]

    def check_result(self, execute_results) -> bool:
        """重写结果校验:仅合规性基础校验"""
        if len(execute_results) == 0:
            return False
        return True

    def run(self, user_input: str) -> str:
        """轻量化执行流程,缩减冗余步骤"""
        parse_res = self.parse_task(user_input)
        task = self.plan_task(parse_res)[0]
        exec_res = llm_light_invoke(task)
        self.check_result([exec_res])
        self.task_status = "finish"
        return f"✅ 轻量任务完成\n输出结果:{exec_res}"

# 场景测试
if __name__ == "__main__":
    agent = LightInteractiveAgent()
    # 测试文案润色场景
    print(agent.run("帮我润色这句话:今天工作很忙,收获很多,学到了很多知识"))
    # 测试知识问答场景
    print(agent.run("简单解释一下大模型Agent的核心作用"))
四、任务自动化场景Agent
1. 场景核心特征
任务自动化场景是企业落地最多的Agent场景,核心用于固定流程、重复化、标准化的批量任务处理,可替代人工重复操作,大幅提升办公与业务处理效率。常见场景包括周报自动生成、数据批量整理、文件解析、表单录入、日志汇总、邮件自动处理等,其核心特征区别于轻量交互场景:
- 任务维度:多步骤固定流程任务,需拆解标准化子任务,执行顺序固定;
- 工具依赖:轻度工具依赖,需对接文件处理、数据读取、格式转换等基础工具;
- 执行链路:多子任务有序执行,单轮迭代即可完成,无需自主决策调整流程;
- 纠错需求:中等,主要校验数据完整性、格式规范性;
- 核心特点:流程标准化、可复用、批量处理、低随机性、高准确率要求。
2. 完整流程定义
任务自动化场景必须遵循标准化、流程化、可复用的执行逻辑,固定核心流程链路,杜绝随机执行,从根源避免任务出错、结果不统一等问题,完整标准化流程:
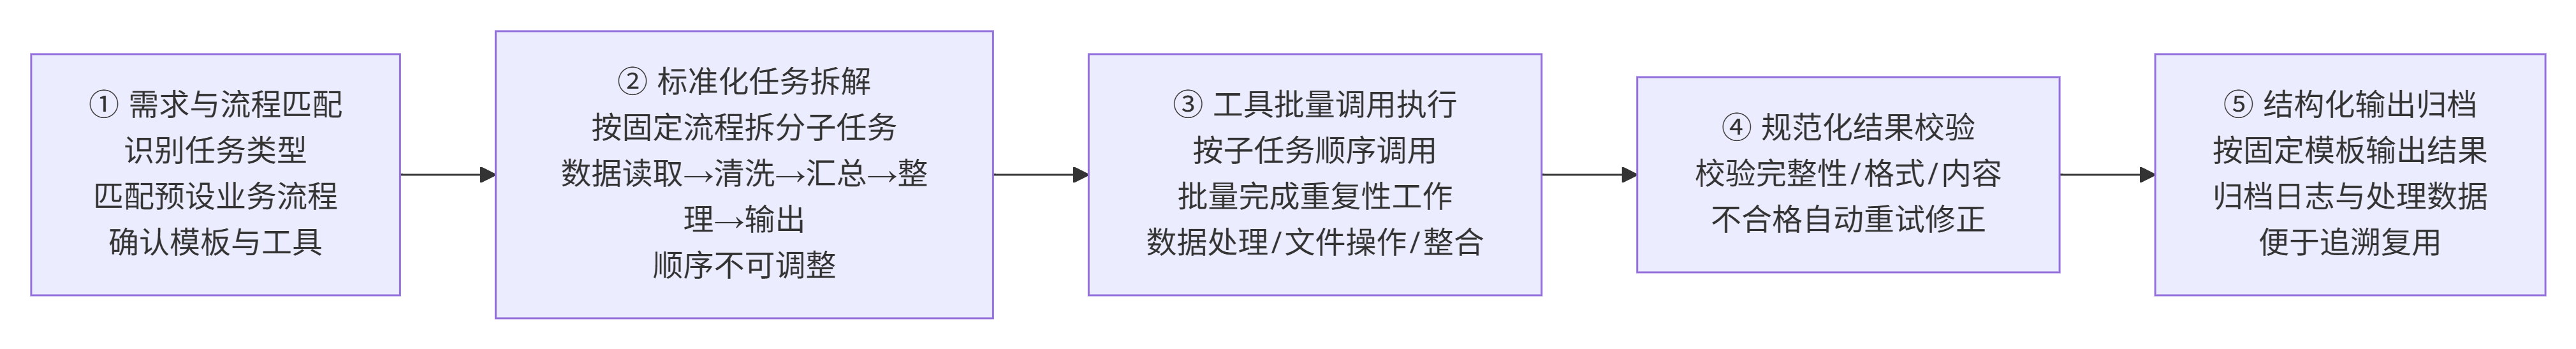
- 1. 需求与流程匹配:接收用户任务指令,识别任务类型,匹配预设的标准化业务流程,确认任务执行模板、输出规范、所需工具。
- 2. 标准化任务拆解:基于固定业务流程,拆解为固定顺序的子任务,例如数据读取→数据清洗→内容汇总→格式整理→结果输出,子任务顺序不可随意调整。
- 3. 工具批量调用执行:按子任务顺序,自动调用对应基础工具,批量完成数据处理、文件操作、内容整合等重复性工作。
- 4. 规范化结果校验:校验数据完整性、格式是否合规、内容是否缺失、是否符合业务标准,不合格则自动重试单次修正。
- 5. 结构化结果输出归档:按照固定模板输出任务结果,同时自动归档执行日志、处理后数据,方便后续追溯复用。
3. 核心执行思路
任务自动化Agent的核心执行思路是模板化流程驱动+标准化批量执行,核心是用固定业务流程约束Agent行为,规避大模型随机性带来的输出误差,保障任务稳定落地,具体四大核心思路:
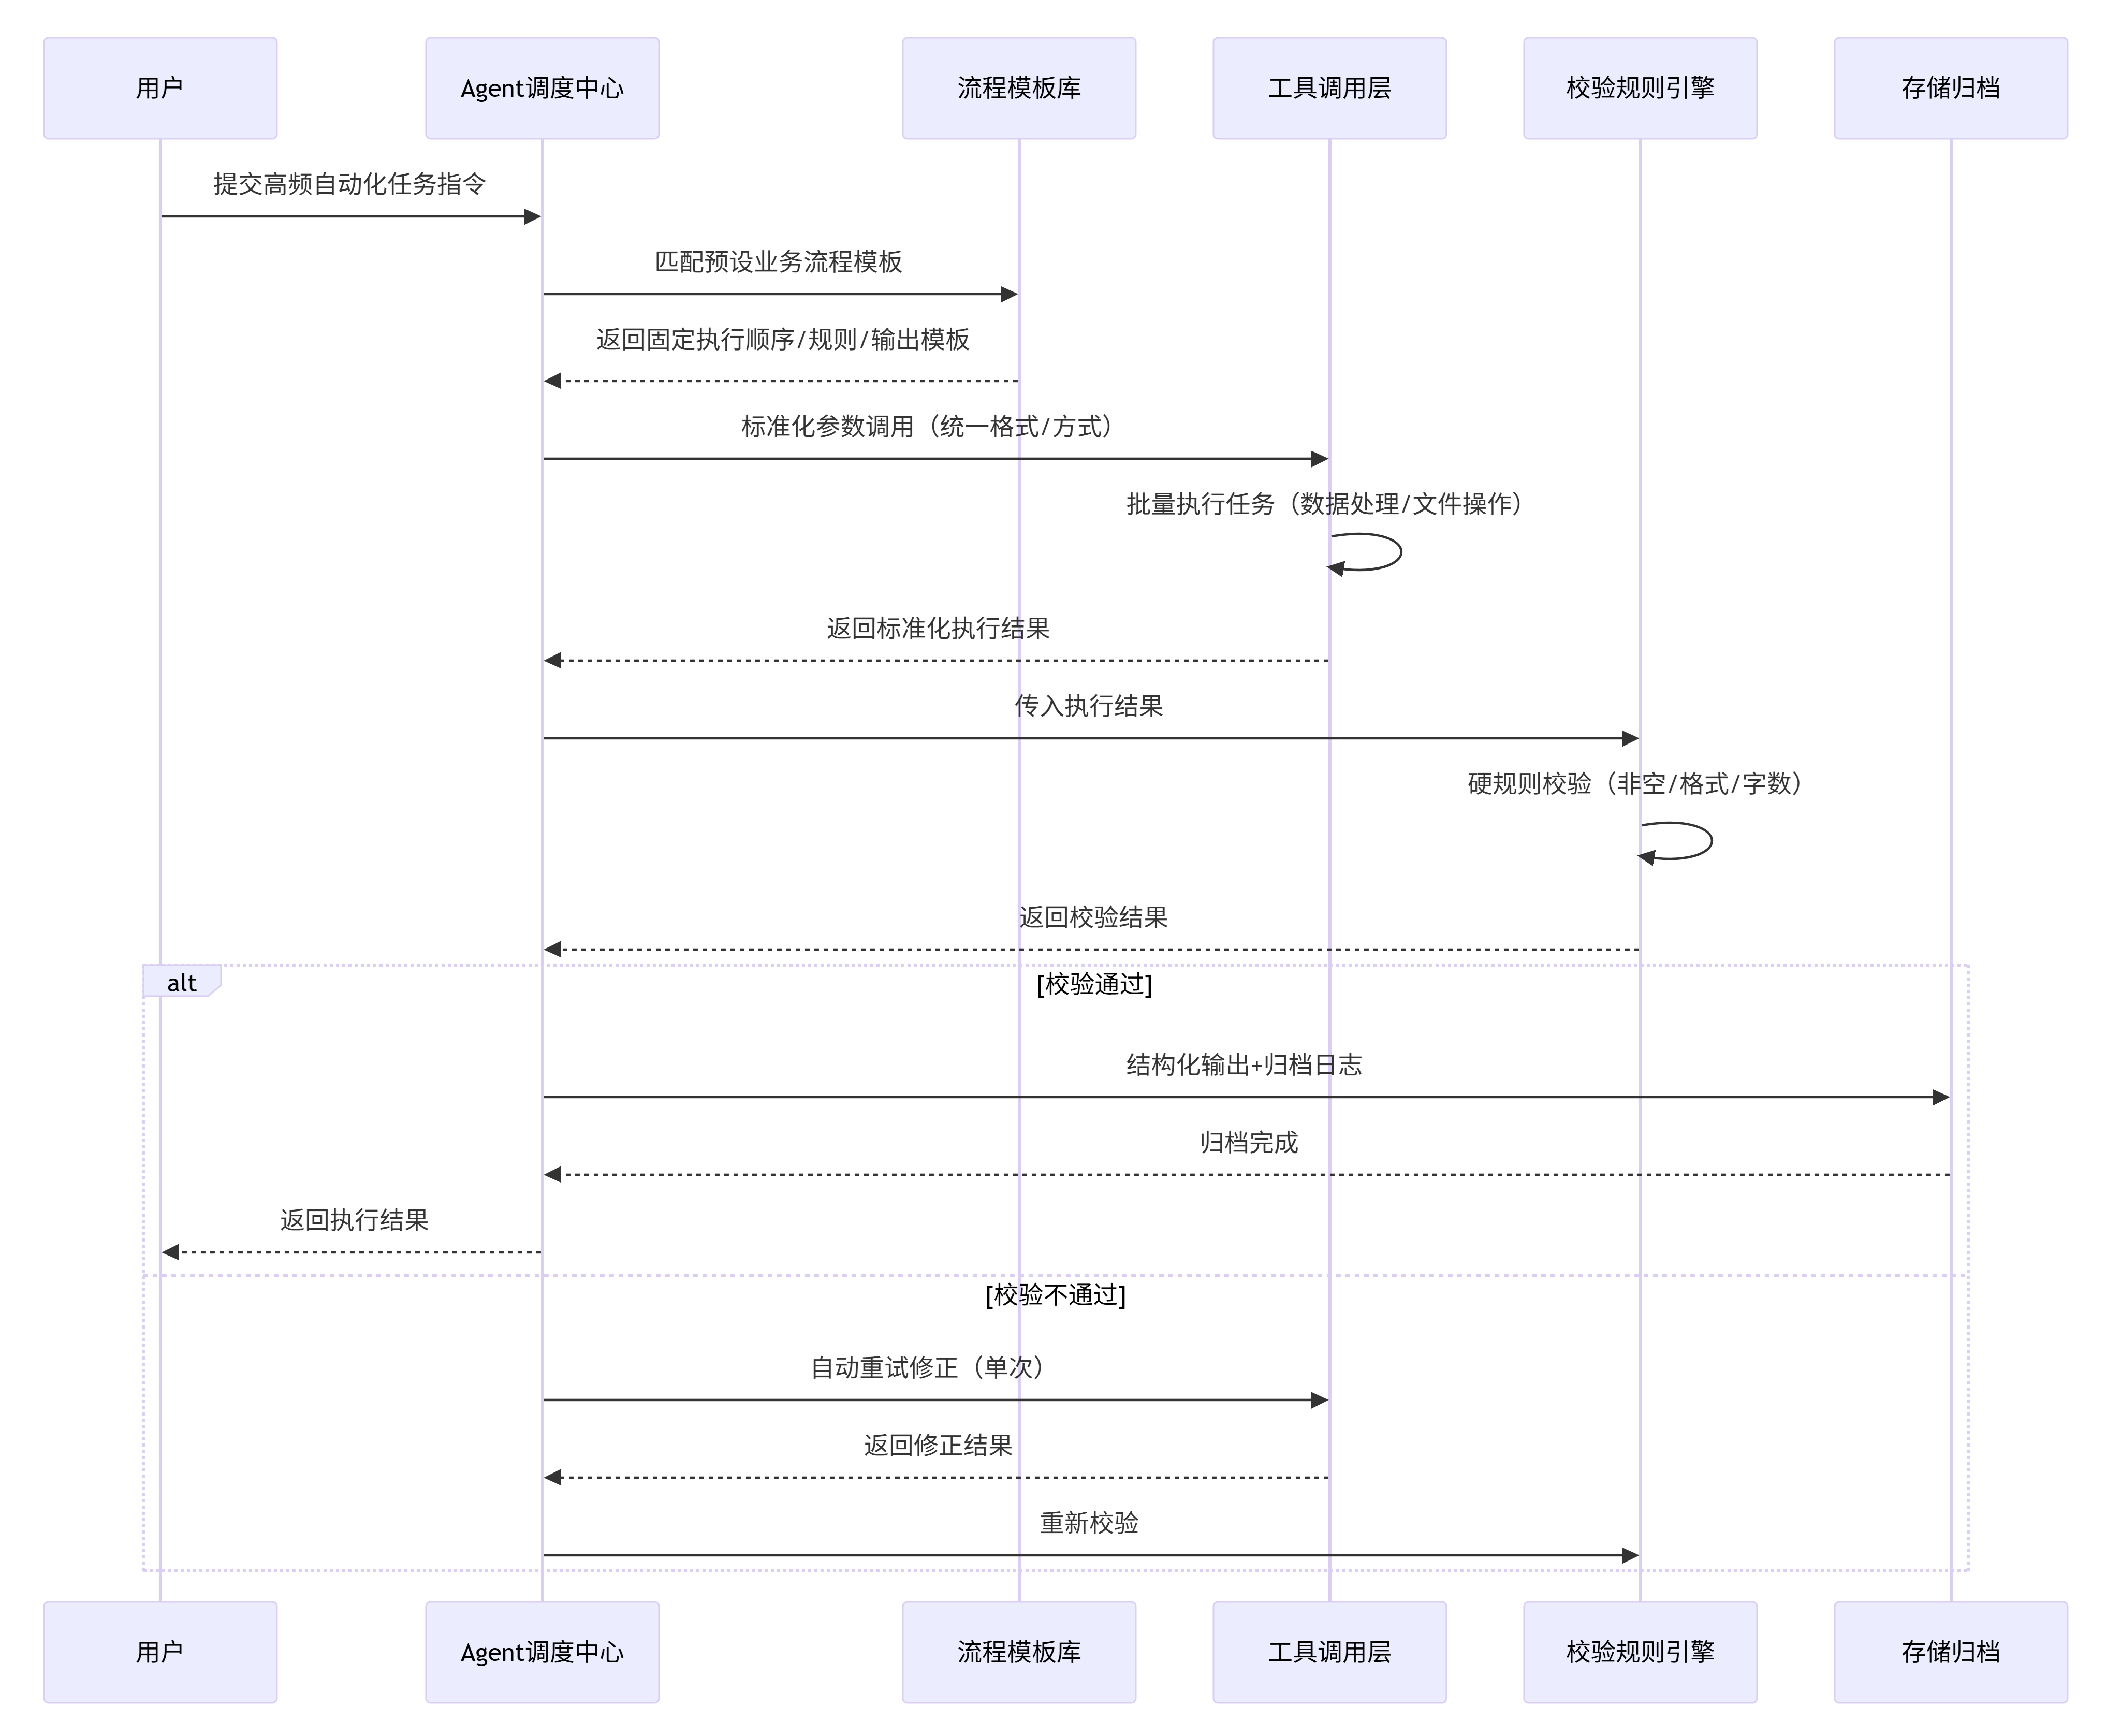
- 预设业务流程模板:针对高频自动化任务,提前固化子任务执行顺序、执行规则、输出模板,Agent无需自主规划流程,直接匹配模板执行,提升稳定性。
- 工具调用标准化:统一工具调用参数、调用方式、返回格式,避免工具调用参数错误、返回结果混乱的问题,保障执行链路顺畅。
- 结果校验规则化:摒弃大模型模糊校验,采用业务硬规则校验,例如“数据不能为空”“格式必须为表格”“字数符合要求”,精准把控输出质量。
- 批量高效执行:支持多数据、多文件批量处理,跳过人工干预环节,全程自动化闭环,提升任务处理效率。
4. 自动化Agent示例
基于通用BaseAgent框架定制的任务自动化场景Agent,以"周报自动生成"为典型应用。AutoTaskAgent针对固定流程批量任务做了专属适配:
- parse_task 识别场景并标记所需工具;
- plan_task 按周报生成流程拆解为数据读取、内容清洗、成果梳理、计划规划、模板整合五个固定子任务;
- execute_task 先调用get_weekly_work_data获取原始工作数据,再交由大模型整合生成;check_result 采用规则化校验,检查"工作内容、工作成果、存在问题、下周计划"四个核心模块是否齐全;
run方法内置校验失败自动重试机制,确保输出质量。整体设计体现了自动化场景下"固定流程 + 数据驱动 + 规则校验"的核心思路。
# 任务自动化场景Agent(周报自动生成专属)
from typing import List, Dict
from base_agent import BaseAgent

# 模拟工作数据接口(实际对接企业OA/日志系统)
def get_weekly_work_data() -> Dict:
    """获取本周工作原始数据"""
    return {
        "daily_work": ["完成项目需求开发", "参与需求评审会议", "修复线上bug", "整理技术文档"],
        "problems": ["部分需求变更频繁", "线上偶发性能问题"],
        "achievement": "完成核心模块迭代,系统稳定性提升20%",
        "next_plan": ["优化系统性能", "完成剩余需求开发", "学习新技术框架"]
    }

def llm_auto_invoke(prompt: str) -> str:
    """自动化场景大模型调用,固定输出风格"""
    return f"【自动化生成结果】{prompt[:50]}:内容规整,符合周报输出标准"

class AutoTaskAgent(BaseAgent):
    """任务自动化专属Agent,适配固定流程批量任务"""
    def parse_task(self, user_input: str) -> Dict:
        """解析自动化任务,匹配业务模板"""
        self.task_status = "working"
        parse_res = {
            "task_target": user_input,
            "scene_type": "任务自动化",
            "complex": "中等",
            "need_tool": True,
            "tool_list": ["数据读取工具", "内容整理工具"],
            "need_iter": True
        }
        self.short_memory.append({"type": "parse", "result": parse_res})
        return parse_res

    def plan_task(self, parse_result: Dict) -> List[str]:
        """固定流程任务拆解,周报生成专属子任务"""
        return [
            "读取本周工作原始数据",
            "清洗筛选有效工作内容",
            "梳理工作成果与现存问题",
            "规划下周工作计划",
            "按照标准周报模板整合内容"
        ]

    def execute_task(self, sub_tasks: List[str]) -> List[str]:
        """按固定流程执行自动化任务"""
        results = []
        # 步骤1:读取数据
        work_data = get_weekly_work_data()
        results.append(f"数据读取完成:{work_data}")
        # 步骤2-5:大模型整合生成周报
        prompt = f"基于以下数据生成标准工作周报:{work_data},分工作内容、工作成果、存在问题、下周计划四部分输出"
        results.append(llm_auto_invoke(prompt))
        self.short_memory.append({"type": "execute", "result": results})
        return results

    def check_result(self, execute_results: List[str]) -> bool:
        """自动化任务规则化校验"""
        key_check = ["工作内容", "工作成果", "存在问题", "下周计划"]
        result_str = str(execute_results)
        # 校验核心模块是否齐全
        for key in key_check:
            if key not in result_str:
                return False
        return True

    def run(self, user_input: str) -> str:
        """自动化任务专属执行链路"""
        parse_res = self.parse_task(user_input)
        plan_tasks = self.plan_task(parse_res)
        exec_res = self.execute_task(plan_tasks)
        # 校验失败则重试一次
        if not self.check_result(exec_res):
            exec_res = self.execute_task(plan_tasks)
        self.task_status = "finish"
        return f"✅ 自动化周报生成完成\n详细内容:{exec_res[-1]}"

# 场景测试
if __name__ == "__main__":
    agent = AutoTaskAgent()
    print(agent.run("自动生成本周工作周报"))
五、复杂推理场景Agent
1. 场景核心特征
复杂推理场景是体现Agent智能上限的核心场景,主打自主思考、多步推理、动态决策、逻辑迭代,适配科研分析、数学推理、方案设计、故障排查、逻辑论证等高难度、无固定流程任务。该场景落地难度最高,与前两类场景差异显著,核心特征:
- 任务维度:无固定流程的复杂非标准化任务,目标模糊、需要自主拆解多层级子任务;
- 工具依赖:中度依赖,按需调用搜索、计算、解析工具,辅助推理验证;
- 执行链路:多轮迭代推理、动态调整子任务、循环校验纠错,无固定执行顺序;
- 纠错需求:极高,需要每一步子任务推理完成后校验逻辑合理性,实时修正偏差;
- 核心特点:随机性强、决策自主、逻辑严谨、迭代优化、动态适配任务变化。
2. 完整流程定义
复杂推理场景无固定执行模板,无法套用标准化固定流程,核心依靠Agent自主决策、迭代推演,流程侧重动态规划、分步校验、层层递进、回溯纠错,完整标准化流程:
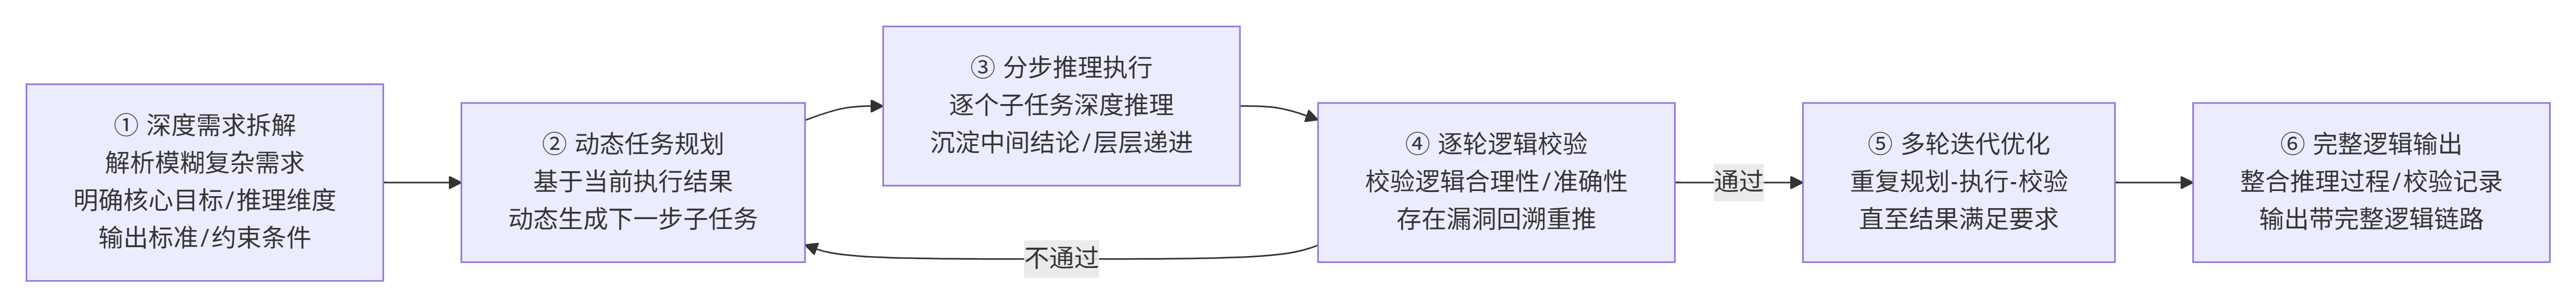
- 1. 深度需求拆解:深度解析模糊、复杂的用户需求,明确任务核心目标、推理维度、输出标准、约束条件,拆解为一级核心子任务。
- 2. 动态任务规划:基于当前执行结果,动态生成下一步子任务,实时调整执行逻辑、推理方向、工具调用策略,而非固定流程执行。
- 3. 分步推理执行:逐个子任务完成深度推理,每完成一步就沉淀中间结论,作为下一步推理的依据,层层递进推导。
- 4. 逐轮逻辑校验:每轮推理完成后,校验中间结论的逻辑合理性、准确性、完整性,存在漏洞则立即回溯重推。
- 5. 多轮迭代优化:重复规划-执行-校验流程,直至所有子任务完成、整体逻辑闭环、结果满足任务要求。
- 6. 完整逻辑输出:整合所有中间推理过程、校验记录、最终结论,输出带完整逻辑链路的结果,保障可追溯。
3. 核心执行思路
复杂推理Agent的核心执行思路是思维链迭代+动态决策+回溯纠错,完全模拟人类深度思考、分步求证、出错修正的思维方式,解决复杂无规则问题,核心四大执行思路:
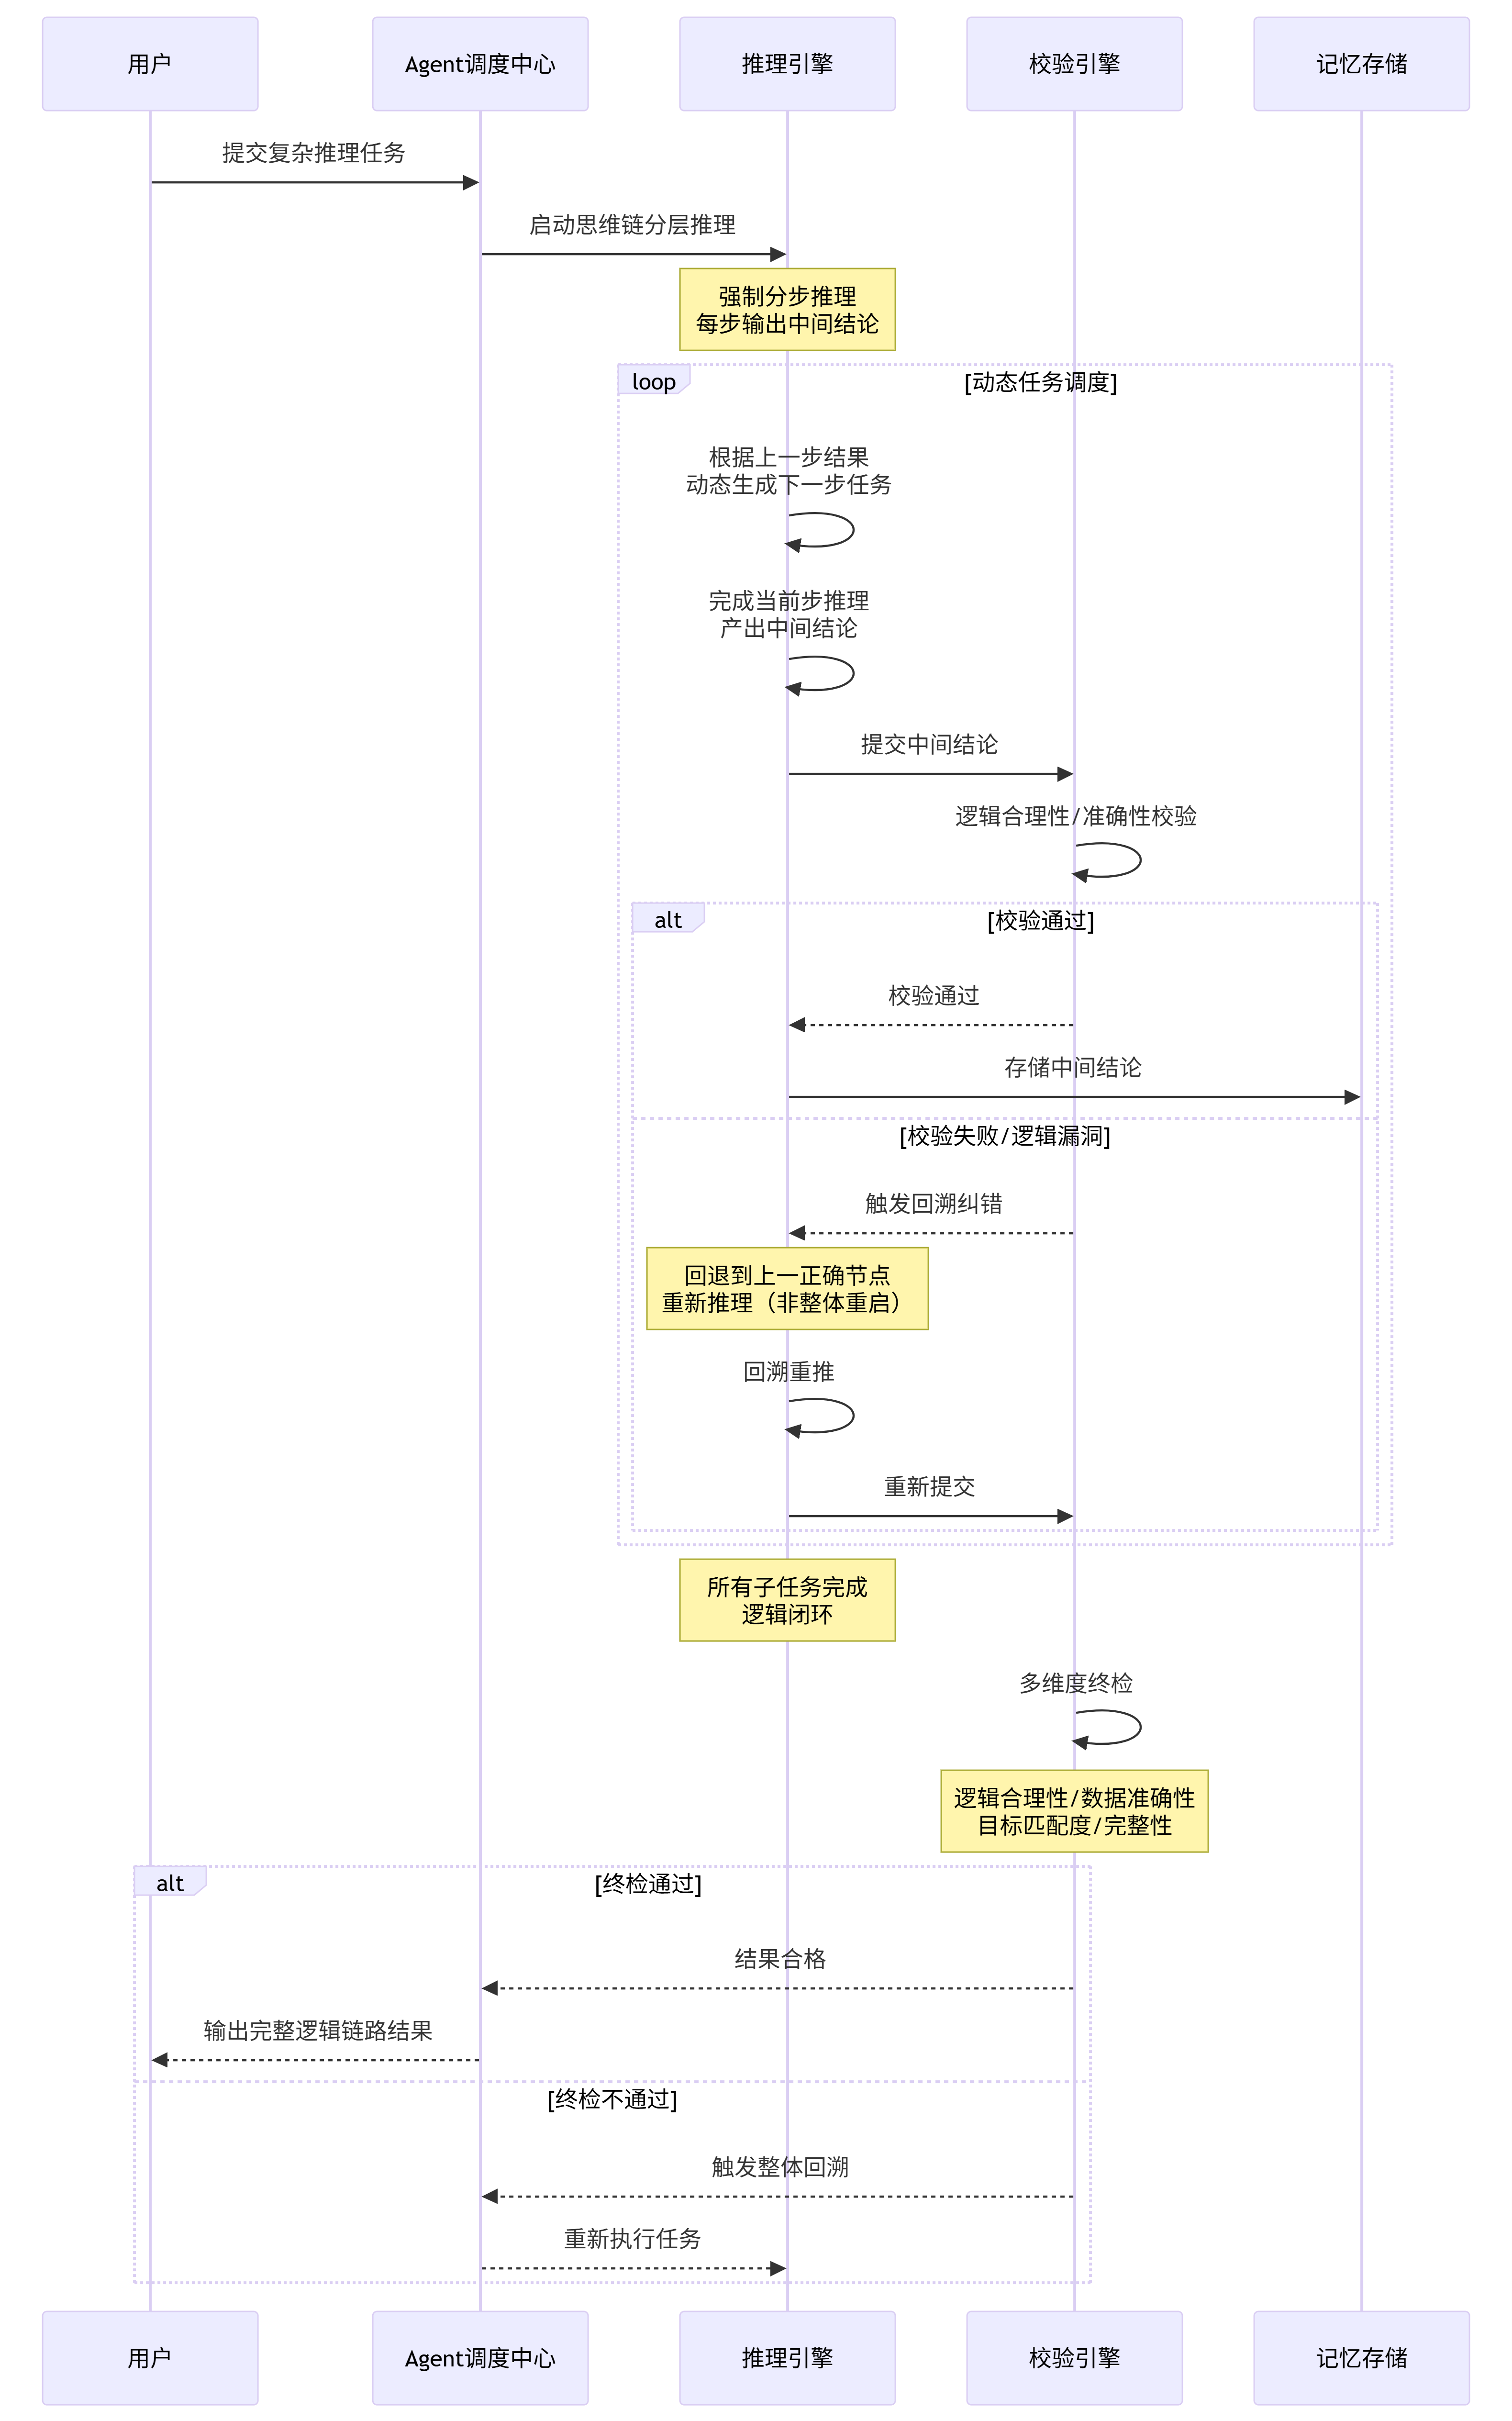
- 思维链分层推理:强制Agent分步输出推理过程,不直接给出最终结果,通过中间结论层层推导,避免一步推理导致的逻辑断层、结论错误。
- 动态任务调度:摒弃固定子任务顺序,根据上一步执行结果动态生成下一步任务,适配复杂、多变、无标准流程的推理任务。
- 回溯纠错机制:建立推理回溯逻辑,某一步推理出现逻辑漏洞、结论偏差时,回退到上一正确节点重新推理,而非整体重启任务。
- 多维度校验:从逻辑合理性、数据准确性、目标匹配度、完整性四个维度校验结果,保障复杂任务的输出质量。
4. 复杂场景Agent示例
基于通用BaseAgent框架定制的复杂推理场景Agent,支持迭代推理与回溯纠错:
- ReasonAgent 新增reason_history推理历史栈与max_iter最大迭代次数控制,防止死循环;
- plan_dynamic_task 基于上一轮结果动态生成下一步推理子任务,实现链式推导;
- check_reason_step 对每步结果进行逻辑校验,一旦发现"错误"或"逻辑漏洞",立即触发backtrack 回溯弹出错误步骤、回退到上一步结果,再重新推理;
run方法通过while循环串联"动态规划→单步推理→校验→回溯"的完整闭环,直到达到最大迭代次数或推理收敛。整体设计体现了复杂推理场景下"动态规划 + 迭代推进 + 回溯纠错"的核心思路。
# 复杂推理场景Agent(迭代推理+回溯纠错专属)
from typing import List, Dict
from base_agent import BaseAgent

def llm_reason_invoke(prompt: str) -> str:
    """复杂推理专属大模型调用,输出分步推理逻辑"""
    return f"【分步推理】{prompt[:60]}:已完成单步逻辑推导,结论合理"

class ReasonAgent(BaseAgent):
    """复杂推理专属Agent,支持动态规划、迭代推理、回溯纠错"""
    def __init__(self):
        super().__init__()
        self.reason_history = []  # 推理历史记录,用于回溯
        self.max_iter = 3         # 最大迭代次数,防止死循环

    def parse_task(self, user_input: str) -> Dict:
        """深度解析复杂推理任务"""
        self.task_status = "working"
        parse_res = {
            "task_target": user_input,
            "scene_type": "复杂推理",
            "complex": "高",
            "need_tool": True,
            "need_iter": True,
            "max_step": 5
        }
        self.short_memory.append({"type": "parse", "result": parse_res})
        return parse_res

    def plan_dynamic_task(self, last_result: str, iter_num: int) -> str:
        """动态规划下一步推理任务,基于上一轮结果生成"""
        if iter_num >= self.max_iter:
            return "结束推理,整合最终结论"
        prompt = f"基于上一轮推理结果:{last_result},生成下一步推理子任务"
        return llm_reason_invoke(prompt)

    def execute_reason(self, task: str) -> str:
        """单步推理执行"""
        res = llm_reason_invoke(f"执行推理任务:{task}")
        self.reason_history.append(res)
        return res

    def check_reason_step(self, step_result: str) -> bool:
        """单步推理逻辑校验"""
        # 简单规则校验,实际可扩展逻辑校验、数据校验
        if "错误" in step_result or "逻辑漏洞" in step_result:
            return False
        return True

    def backtrack(self):
        """推理回溯:删除错误步骤,返回上一步结果"""
        if len(self.reason_history) > 0:
            self.reason_history.pop()
        return self.reason_history[-1] if self.reason_history else ""

    def run(self, user_input: str) -> str:
        """复杂推理迭代执行链路"""
        self.reason_history = []
        self.parse_task(user_input)
        iter_num = 0
        current_result = ""

        # 多轮迭代推理
        while iter_num < self.max_iter:
            # 动态生成子任务
            next_task = self.plan_dynamic_task(current_result, iter_num)
            # 执行单步推理
            step_res = self.execute_reason(next_task)
            # 校验单步结果
            if not self.check_reason_step(step_res):
                current_result = self.backtrack()
                continue
            current_result = step_res
            iter_num += 1

        self.task_status = "finish"
        return f"✅ 复杂推理完成\n推理迭代次数:{iter_num}\n完整推理链路:{self.reason_history}\n最终结论:{current_result}"

# 场景测试
if __name__ == "__main__":
    agent = ReasonAgent()
    # 测试复杂分析推理场景
    print(agent.run("分析项目线上性能卡顿问题,推导核心成因并给出优化方案"))
六、工具协同场景Agent
1. 场景核心特征
工具协同场景是目前企业落地价值最高、综合能力最强的Agent场景,核心作用是弥补大模型原生能力短板,解决大模型实时信息滞后、无法实操、精准计算、联网及操作系统文件等缺陷,通过联动各类外部工具,实现任务全维度能力闭环,核心特征:
- 任务维度:跨能力复合任务,需要推理、计算、搜索、操作、生成多能力协同完成;
- 工具依赖:高度依赖,需联动搜索、代码解释器、数据库、API接口、文件系统、爬虫等多类工具;
- 执行链路:工具调用+模型推理交替执行,多轮工具调度、多轮推理迭代,链路最复杂;
- 纠错需求:高,需校验工具调用参数、返回结果、模型整合效果三重内容;
- 核心场景:实时信息查询、数据分析计算、代码开发调试、跨系统业务处理、智能调研等。
2. 完整流程定义
工具协同场景的核心运行逻辑是模型决策、工具执行、结果回流、二次推理、迭代优化的闭环循环,区别于单一推理、单一文本生成场景,实现AI思考+工具实操的深度联动,完整标准化流程:
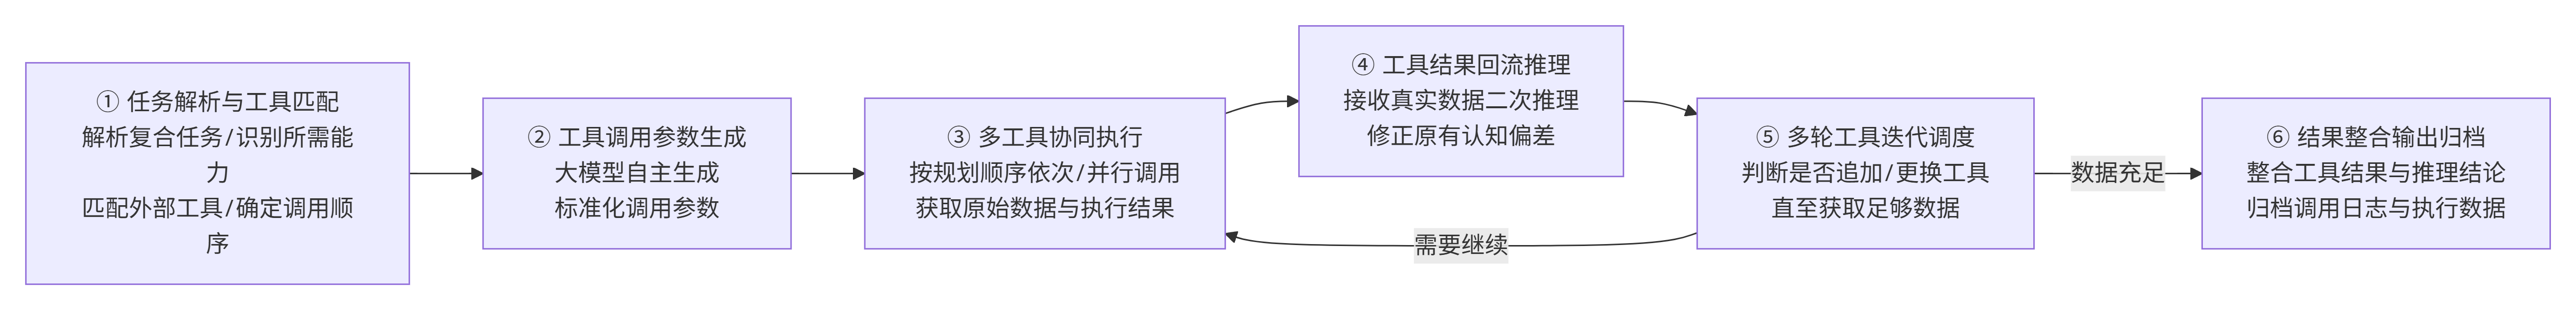
- 1. 任务解析与工具匹配:解析用户复合任务,识别任务所需能力,精准匹配所需外部工具,确定工具调用顺序、参数格式、调用时机。
- 2. 工具调用参数生成:大模型基于任务需求,自主生成标准化工具调用参数,规避参数格式错误、参数缺失问题。
- 3. 多工具协同执行:按照规划顺序,依次/并行调用各类工具,执行实操任务,获取工具返回的原始数据、执行结果。
- 4. 工具结果回流推理:大模型接收工具返回的真实数据,基于实时、真实数据进行二次推理、分析、整合,修正原有认知偏差。
- 5. 多轮工具迭代调度:根据首轮工具执行结果,判断是否需要追加工具调用、更换工具、补充参数,直至获取足够数据。
- 6. 结果整合输出归档:整合所有工具执行结果、模型推理结论,生成完整任务输出,归档工具调用日志与执行数据。
3. 核心执行思路
工具协同Agent的核心执行思路是模型大脑决策+工具手脚实操+数据闭环迭代,模型负责思考决策,工具负责落地执行,分工明确、协同联动,最大化发挥Agent综合能力,核心四大执行思路如下:
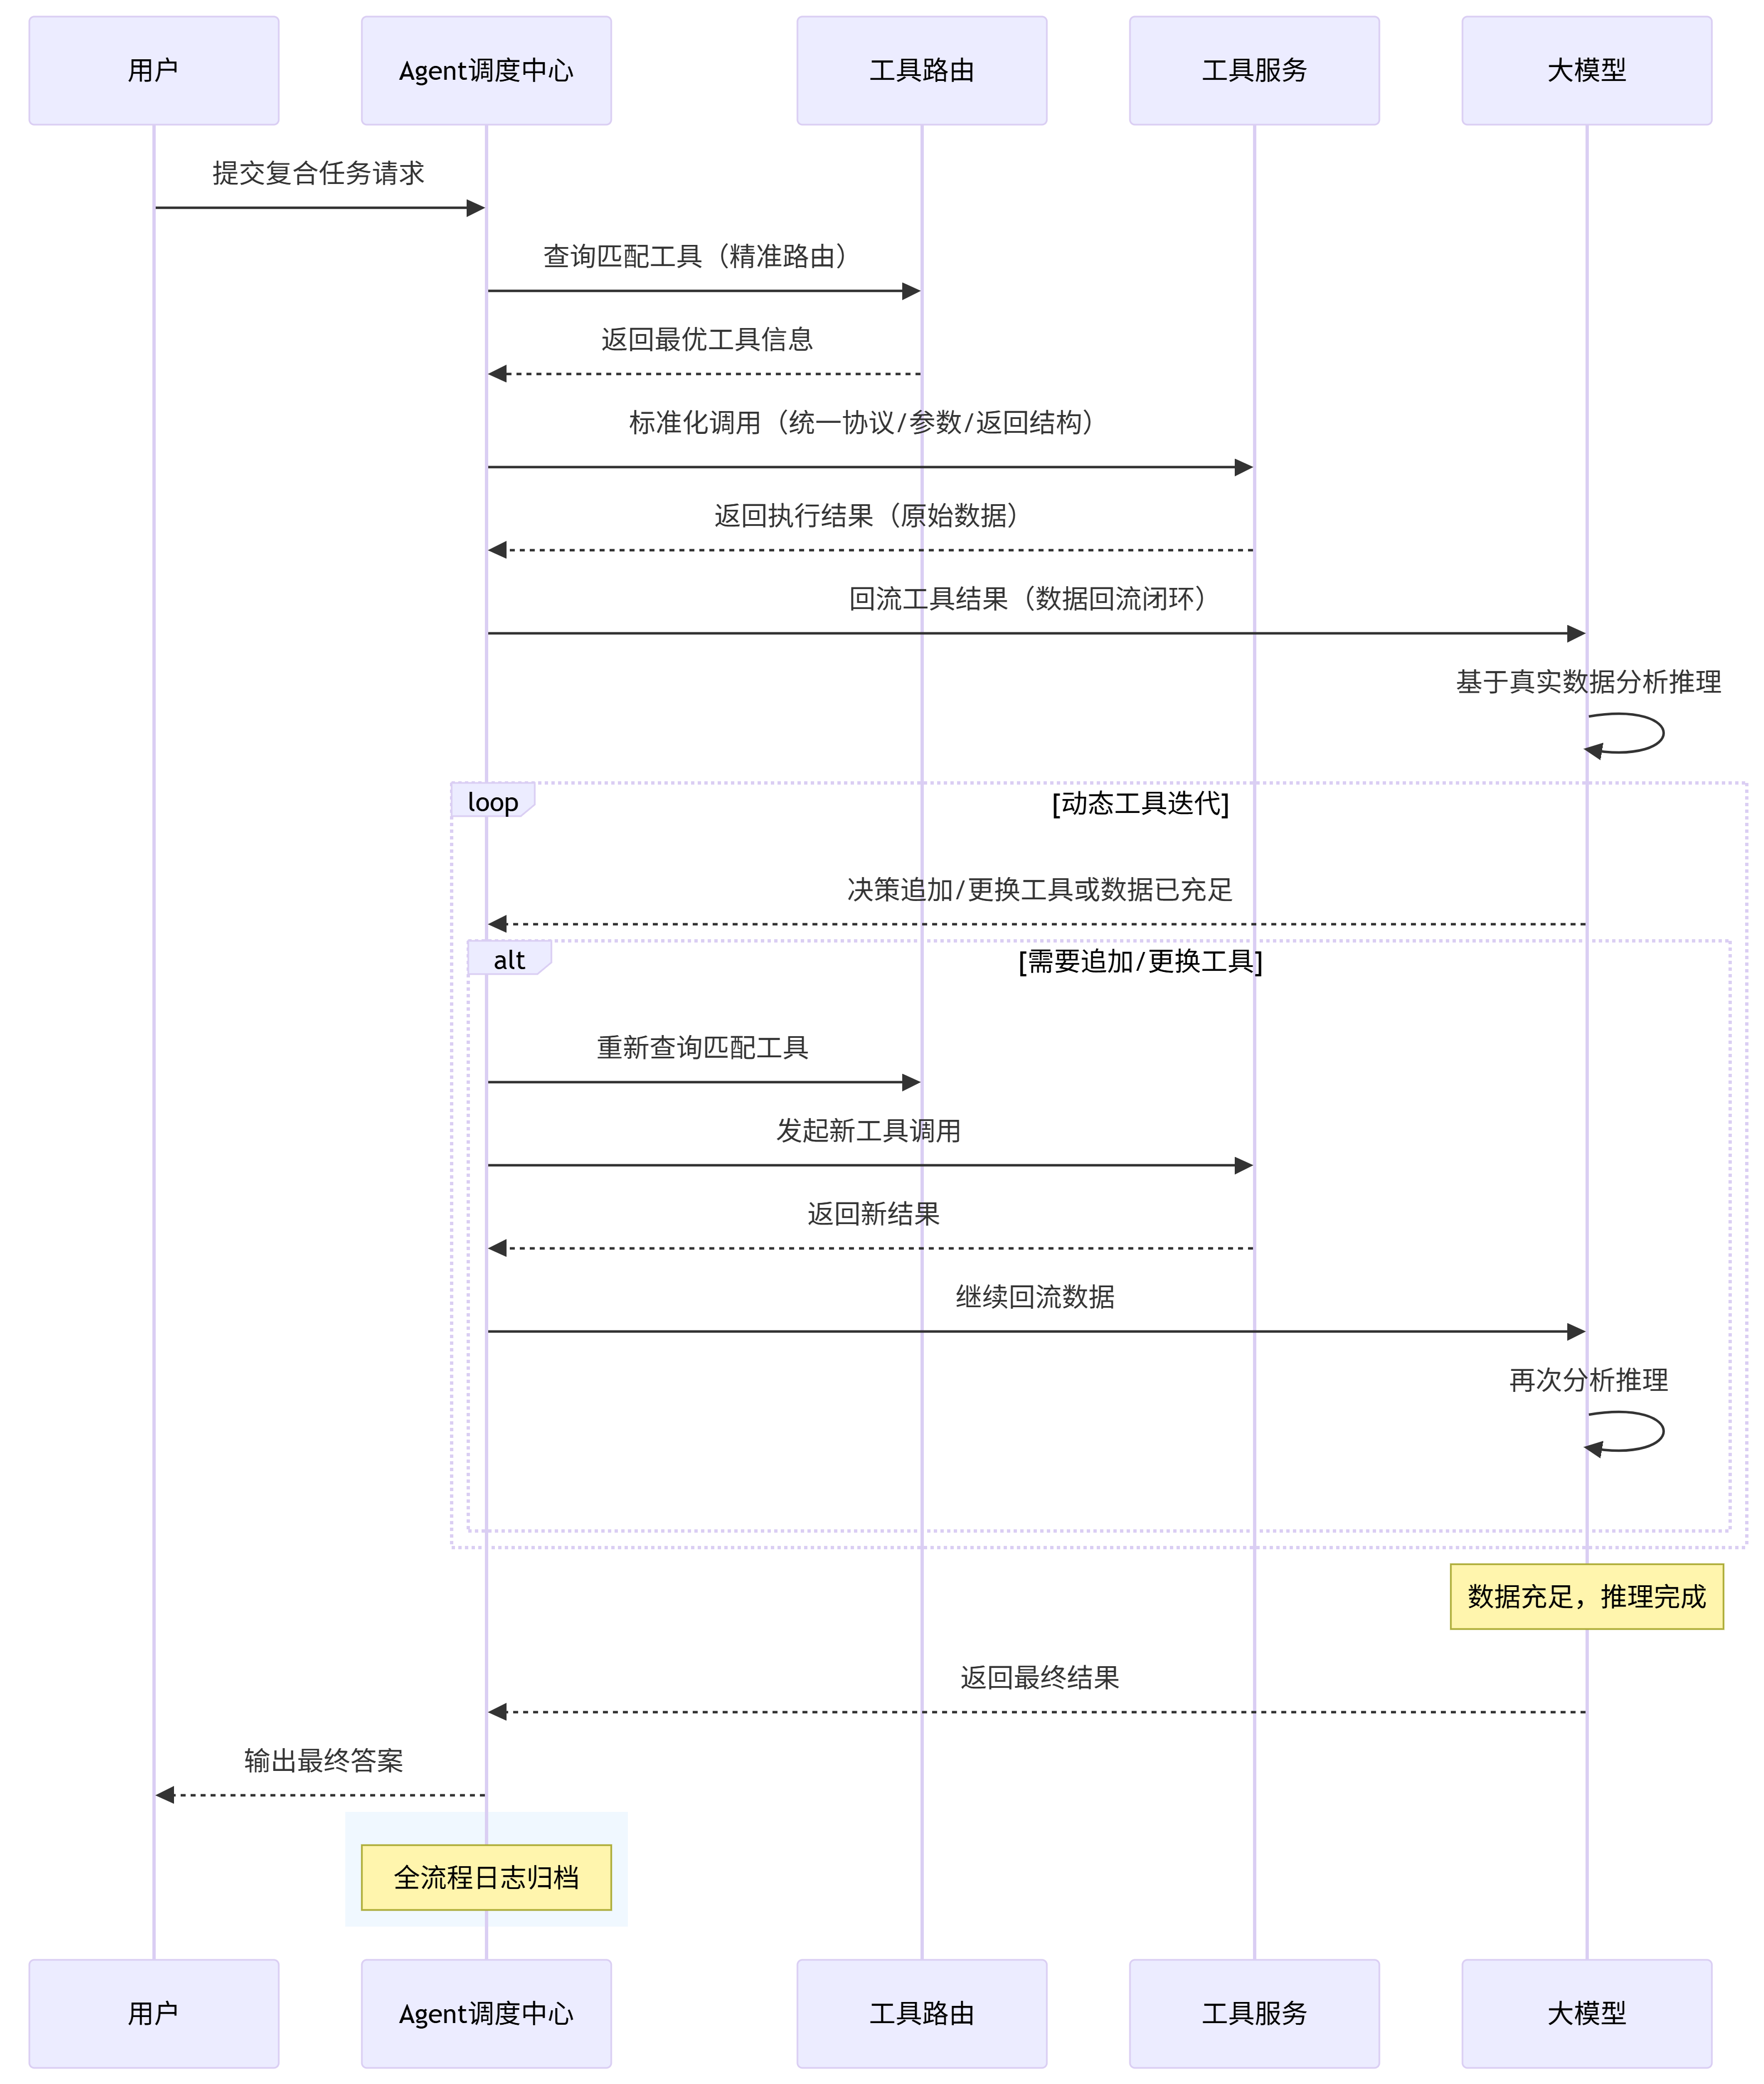
- 精准工具路由:建立工具能力标签库,Agent根据任务需求自动匹配最优工具,避免无效调用、错用工具,提升执行效率。
- 标准化工具调用:统一所有工具的调用协议、参数格式、返回结构,降低模型调用难度,减少调用报错。
- 数据回流闭环:工具执行结果必须回流至大模型,作为推理依据,实现“工具实操+模型思考”的深度协同,而非单纯工具调用。
- 动态工具迭代:支持根据执行结果动态调整工具调用策略,追加、终止、更换工具,适配复杂复合任务需求。
4. 工具协同Agent示例
基于通用BaseAgent框架定制的工具协同场景Agent,支持多工具联动调用:
- ToolCooperateAgent通过tools字典注册了SearchTool(联网搜索)、CalcTool(数据计算)、FileTool(文件处理)三类外部工具;
- plan_tool_task 按任务需求规划工具调用顺序与参数;
- execute_tool_task 依次调度各工具执行,并将工具返回结果回流至大模型进行二次整合推理,生成最终报告;
- 同时通过 tool_call_log 记录完整调用链路,便于审计与回溯。
整体设计体现了工具协同场景下"工具注册→流程编排→结果回流→整合输出"的核心思路。
# 工具协同场景Agent(多工具联动专属)
from typing import List, Dict
from base_agent import BaseAgent

# 模拟外部工具能力
class SearchTool:
    """联网搜索工具"""
    def search(self, keyword: str) -> str:
        return f"【搜索结果】关键词{keyword}:获取最新行业数据、政策信息、实时资讯"

class CalcTool:
    """数据计算工具"""
    def calc(self, formula: str) -> str:
        return f"【计算结果】公式{formula}:计算完成,数据准确无误"

class FileTool:
    """文件处理工具"""
    def save_file(self, content: str, file_name: str) -> str:
        return f"【文件操作】已将内容保存至{file_name}"

def llm_tool_invoke(prompt: str) -> str:
    """工具协同场景大模型推理"""
    return f"【工具协同推理】{prompt[:50]}:完成数据整合分析"

class ToolCooperateAgent(BaseAgent):
    """多工具协同专属Agent,支持多工具联动迭代"""
    def __init__(self):
        super().__init__()
        # 注册工具
        self.tools = {
            "search": SearchTool(),
            "calc": CalcTool(),
            "file": FileTool()
        }
        self.tool_call_log = []  # 工具调用日志

    def parse_task(self, user_input: str) -> Dict:
        """解析任务,匹配所需工具"""
        self.task_status = "working"
        parse_res = {
            "task_target": user_input,
            "scene_type": "工具协同",
            "complex": "高",
            "need_tool": True,
            "tool_list": ["search", "calc", "file"],
            "need_iter": True
        }
        self.short_memory.append({"type": "parse", "result": parse_res})
        return parse_res

    def plan_tool_task(self, parse_res: Dict) -> List[Dict]:
        """规划工具调用顺序与参数"""
        return [
            {"tool": "search", "param": "2026年大模型行业发展数据"},
            {"tool": "calc", "param": "行业增长率、市场规模核算"},
            {"tool": "file", "param": "行业分析报告保存"}
        ]

    def execute_tool_task(self, tool_tasks: List[Dict]) -> List[str]:
        """执行多工具协同任务"""
        tool_results = []
        for task in tool_tasks:
            tool_name = task["tool"]
            param = task["param"]
            # 调用对应工具
            if tool_name == "search":
                res = self.tools["search"].search(param)
            elif tool_name == "calc":
                res = self.tools["calc"].calc(param)
            elif tool_name == "file":
                res = self.tools["file"].save_file("行业分析内容", "2026大模型行业报告.md")
            else:
                res = "工具不存在"
            tool_results.append(res)
            self.tool_call_log.append({tool_name: param})
        # 工具结果回流推理
        llm_res = llm_tool_invoke(f"基于工具结果{tool_results},生成完整行业分析报告")
        tool_results.append(llm_res)
        return tool_results

    def check_result(self, execute_results: List[str]) -> bool:
        """校验工具协同执行结果"""
        if len(execute_results) < 3:
            return False
        return True

    def run(self, user_input: str) -> str:
        """工具协同全流程执行"""
        parse_res = self.parse_task(user_input)
        tool_tasks = self.plan_tool_task(parse_res)
        exec_res = self.execute_tool_task(tool_tasks)
        # 失败重试
        if not self.check_result(exec_res):
            exec_res = self.execute_tool_task(tool_tasks)
        self.task_status = "finish"
        return f"✅ 多工具协同任务完成\n工具调用日志:{self.tool_call_log}\n最终输出:{exec_res[-1]}"

# 场景测试
if __name__ == "__main__":
    agent = ToolCooperateAgent()
    print(agent.run("调研2026年大模型行业数据,核算市场规模,生成并保存行业分析报告"))
七、场景落地对比与选型
1. 四大场景核心对比
为方便快速匹配业务、精准选型落地,从任务复杂度、工具依赖、迭代次数、响应速度、落地成本、适用场景六大核心维度,对四大Agent场景进行全方位对比,清晰区分各场景能力边界与落地定位:
- 轻量交互场景:任务复杂度极低、无工具依赖、零迭代、响应速度最快、落地成本最低,适配简单问答、文案创作、文本处理等轻量需求,适合所有入门级落地场景。
- 任务自动化场景:任务复杂度中等、轻度工具依赖、单次迭代、响应速度快、落地成本低,适配固定流程批量任务,适合企业办公自动化、标准化业务处理。
- 复杂推理场景:任务复杂度高、中度工具依赖、多轮迭代、响应速度慢、落地成本中高,适配无固定流程的复杂分析、推理、设计类任务,适合科研、方案研发、故障排查场景。
- 工具协同场景:任务复杂度极高、高度工具依赖、多轮迭代、响应速度最慢、落地成本最高,适配跨工具、跨能力的复合任务,适合企业高阶智能化落地、数据调研、全流程业务赋能。
2. 落地选型核心原则
实际项目落地中,无需盲目追求复杂高阶Agent架构,坚持够用、适配、低成本、高稳定四大核心选型原则,拒绝过度开发、能力冗余,针对不同业务需求的落地选型建议:
- 简单文本、问答需求:优先选择轻量交互Agent,极简架构、极速响应,避免过度开发;
- 固定重复业务:优先选择任务自动化Agent,固化流程、批量执行,提升人工效率;
- 复杂分析推理需求:选择复杂推理Agent,依托迭代推理、回溯纠错,保障逻辑严谨性;
- 需要实时数据、实操操作的复合需求:选择工具协同Agent,多工具联动弥补大模型原生短板。
3. 应用实践经验记录
结合多场景Agent落地实战经验,总结四大高频踩坑问题与核心避坑要点,帮助减少试错成本、提升项目稳定性:
- 避免架构冗余:简单场景不用复杂迭代、工具调度架构,防止资源浪费、响应延迟;
- 避免流程固化:复杂推理、工具协同场景,禁止固定子任务流程,需保留动态决策能力;
- 避免无校验执行:所有自动化、推理场景必须配置校验机制,杜绝无效、错误结果输出;
- 避免工具滥用:无需工具的轻量场景,禁止强制调用工具,减少报错概率和耗时。
八、总结
Agent的落地核心从来不是复杂的代码架构,而是场景适配的流程定义和执行逻辑。所有Agent的智能表现,都来源于精准的场景匹配、标准化的流程调度、合理的工具协同、严谨的迭代纠错。轻量交互Agent主打高效简洁,解决基础文本需求;任务自动化Agent主打流程复用,替代人工重复劳动;复杂推理Agent主打逻辑严谨,解决高阶思考问题;工具协同Agent主打能力闭环,补齐大模型实操短板。
从应用趋势来看,未来的Agent会朝着场景专业化、流程标准化、工具生态化、决策自主化持续迭代。不再是通用模糊的智能体,而是垂直业务场景的专属智能执行者,具备更稳定的流程执行能力、更精准的工具调度能力、更智能的自主决策能力。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号