SNMP协议采集性能调优:大量网口温湿度设备轮询速率优化实践
原创
SNMP协议采集性能调优:大量网口温湿度设备轮询速率优化实践
原创
盛世宏博科技
发布于 2026-10-12 09:04:56
发布于 2026-10-12 09:04:56
SNMP协议采集性能调优:大量网口温湿度设备轮询速率优化实践
物联网 · 盛世宏博 · SNMP协议、温湿度设备、轮询性能调优、批量采集
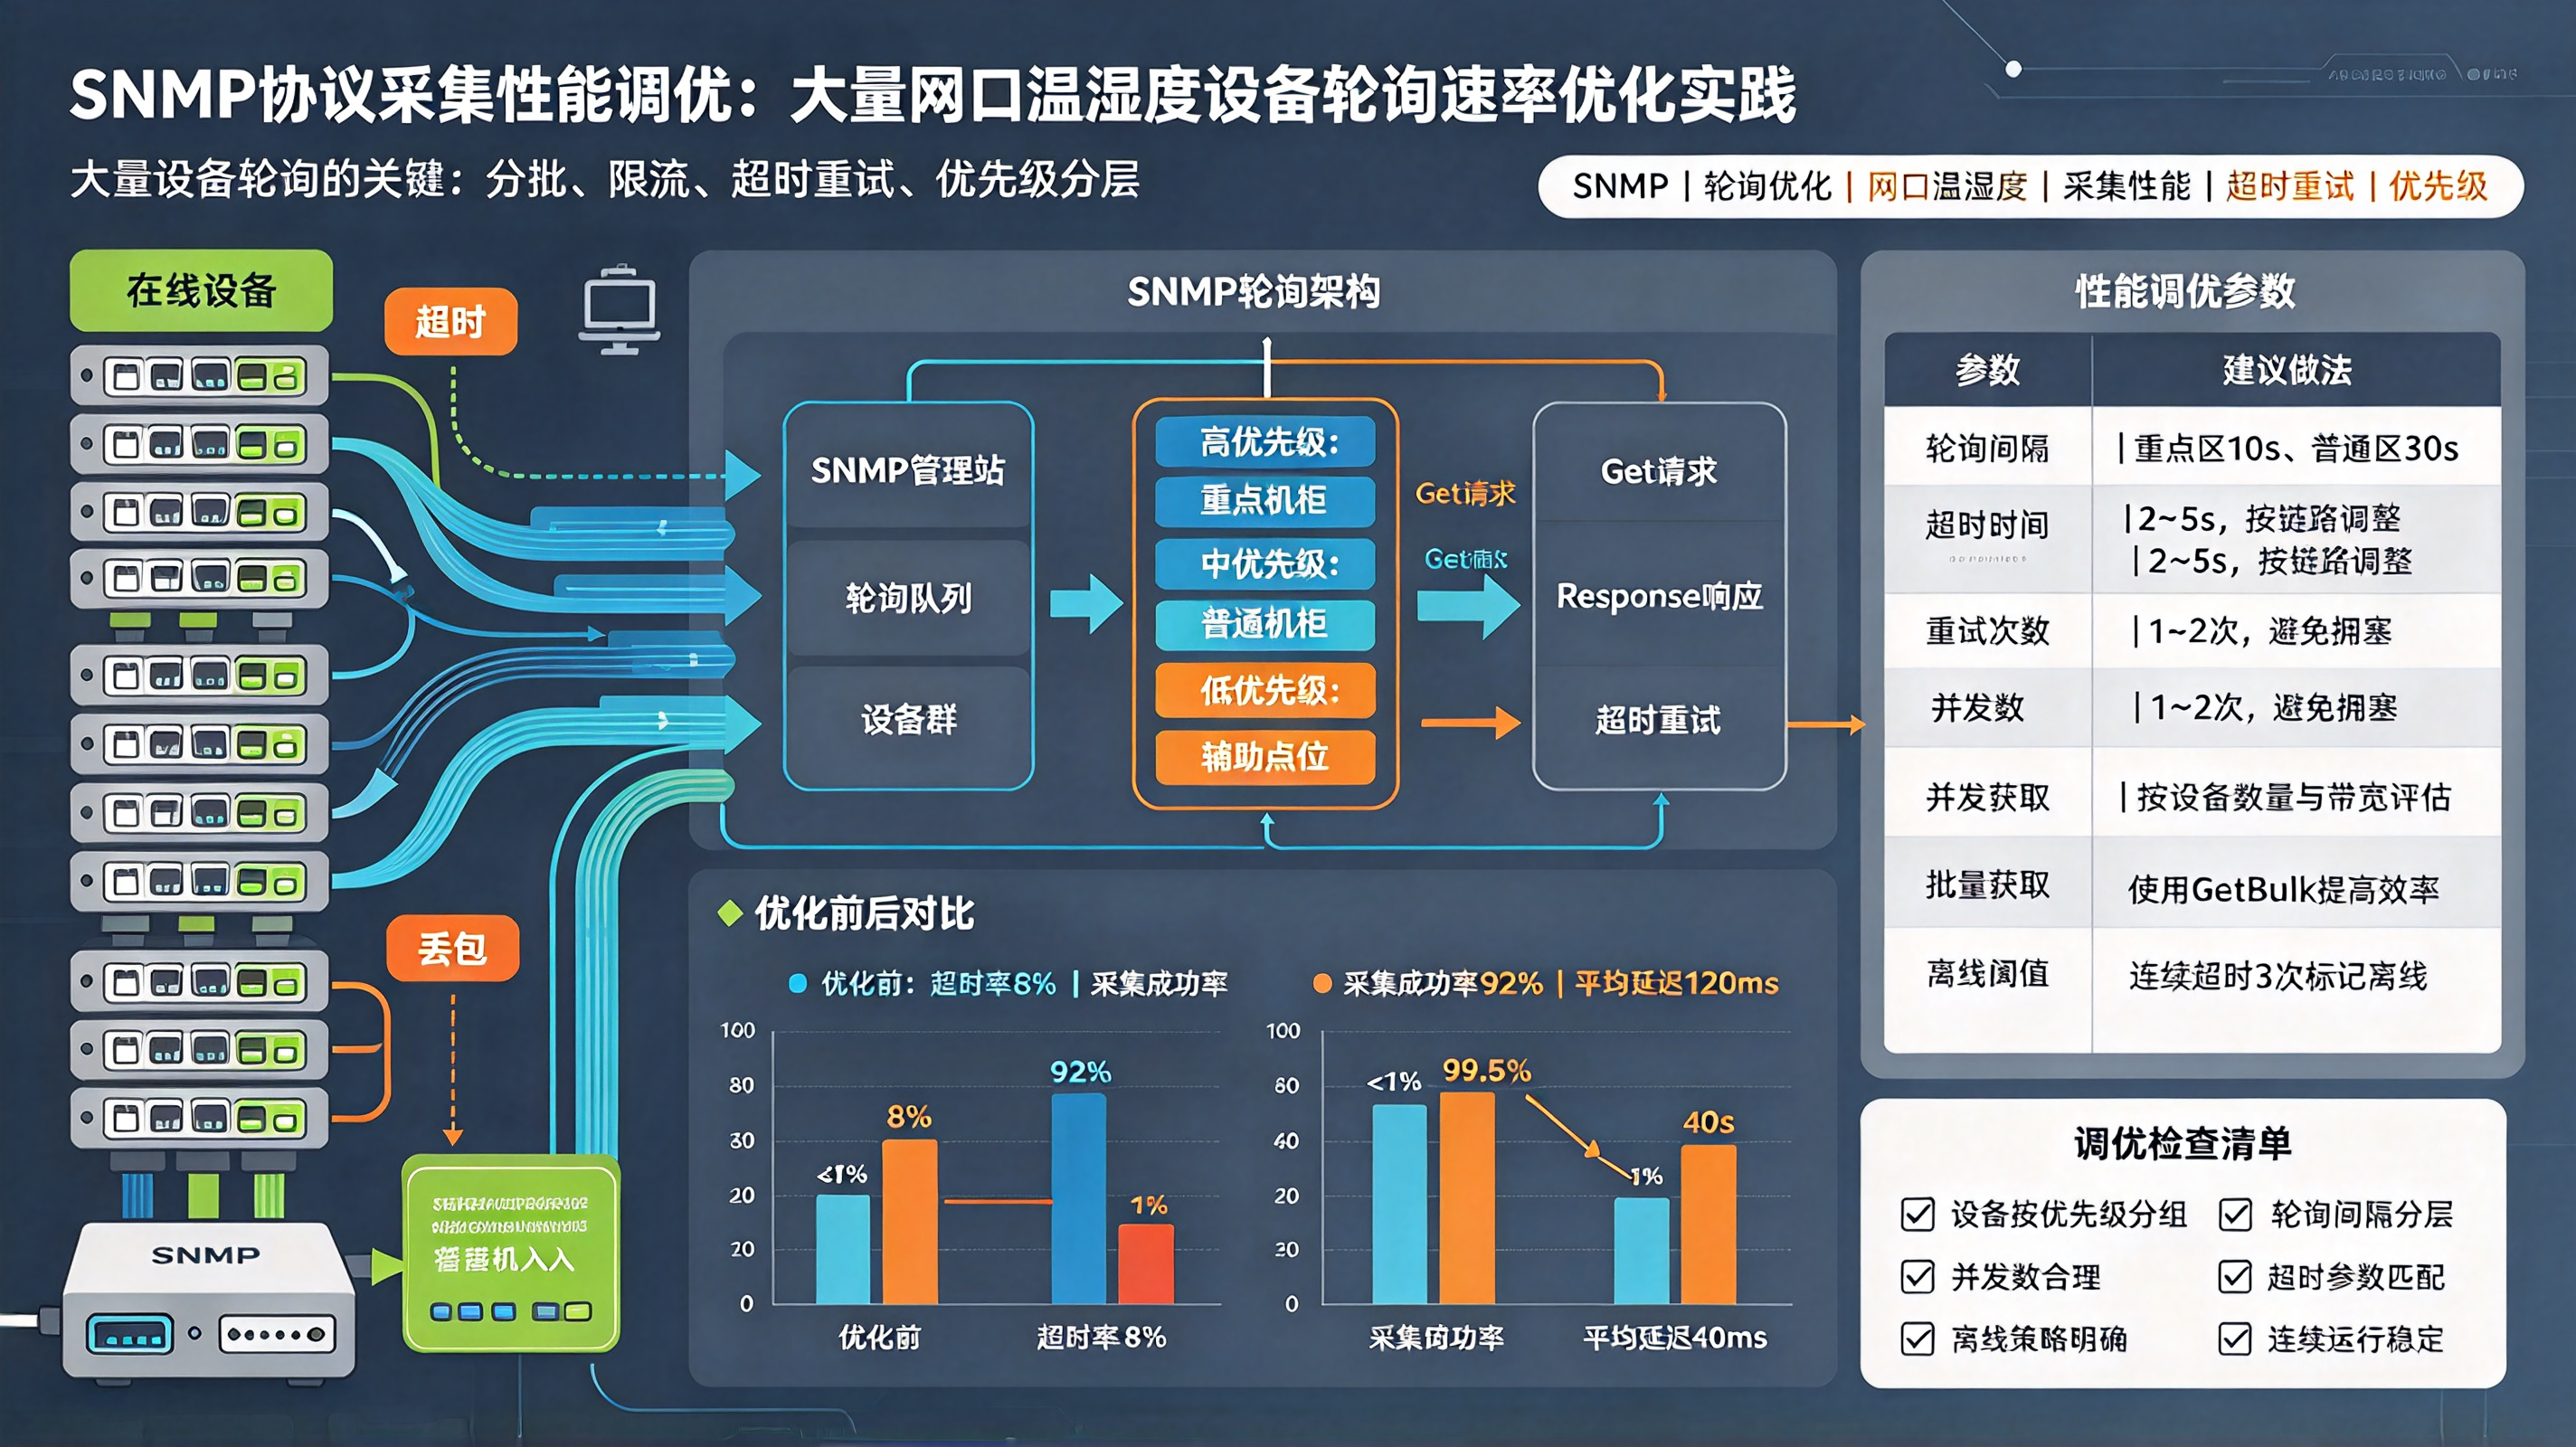
近期在调试一套工业环境监控系统时,遇到了关于Modbus连接保持的问题。这次的场景比较特殊——客户现场已经部署了156台支持SNMP的网口温湿度变送器(某国产品牌,固件版本混杂v2.1~v3.4),前期用传统SNMP GET单OID轮询,管理平台每5分钟才能拉完一轮,数据滞后严重。客户要求将全量采集周期压缩到30秒以内,同时不能影响现有业务网络。这篇完整记录从SNMP协议栈层面做性能调优的全过程,包括版本选型、批量读取、并发模型、超时重试策略,以及踩到的几个只有大批量部署才会暴露的底层坑。
一、现场设备与初始状态
项目 | 详情 |
|---|---|
设备型号 | 网口温湿度变送器(SNMP v1/v2c/v3) |
设备数量 | 156台,分4个VLAN部署 |
固件版本 | v2.1(32台)、v2.5(74台)、v3.4(50台) |
管理网络 | 千兆以太网,与业务网共用核心交换机 |
当前采集方式 | Python + pysnmp,单线程串行GET |
当前采集周期 | 5分钟/轮(156台×3 OID = 468次GET) |
目标采集周期 | ≤30秒/轮 |
初始轮询架构(串行版)
管理平台
  └── 单线程Python脚本
        └── for each device:
              snmp_get(temperature_oid)
              snmp_get(humidity_oid)
              snmp_get(dewpoint_oid)
time.sleep(0.5) # 防过载间隔实测数据:每台设备3次GET,每次超时设3s,平均单次响应280ms,加间隔后每台约1.5s,156台串行跑完约234秒(3分54秒)。
二、性能瓶颈分析
2.1 协议层面
因素 | 影响 |
|---|---|
SNMP v1 使用逐包确认 | 每个GET独立UDP请求-响应,无批量 |
单OID单次GET | 3个参数需3次交互 |
串行等待 | 前一台超时阻塞后续所有设备 |
pysnmp同步模式 | GIL锁限制,单核跑满 |
2.2 网络层面
- 156台设备分散在4个VLAN,跨VLAN路由增加延迟
- 部分设备固件v2.1处理SNMP请求时CPU占用高,响应时间波动大(80ms~1200ms)
- 业务网高峰期交换机CPU到60%,SNMP包被延迟处理
2.3 应用层面
- 每次GET新建UDP socket,无连接复用
- 超时重试策略为简单3次重试,一台设备卡死会拖慢整轮
- 无批量读取(GetBulk),浪费大量往返时间
三、调优方案设计
3.1 协议升级:v2c + GetBulk
将协议从v1升级到v2c(所有设备均支持),核心收益:
v1:  GET temperature → Response
     GET humidity    → Response
     GET dewpoint    → Response
     (3次交互)

v2c: GETBULK [temperature, humidity, dewpoint] → Response
     (1次交互,最多可拉取整个MIB子树)
3.2 并发模型:异步IO + 连接池
管理平台
  └── 异步采集引擎(asyncio + 多进程)
        ├── Worker-1: 设备001~039(VLAN A)
        ├── Worker-2: 设备040~078(VLAN B)
        ├── Worker-3: 设备079~117(VLAN C)
        └── Worker-4: 设备118~156(VLAN D)
每个Worker内部:
- 维护到本VLAN设备的SNMP会话池
- 使用
aiosnmp异步库(基于asyncio的SNMP实现) - 并发度限制为10(每Worker同时最多10个未完成请求)
- 超时设800ms,重试1次,失败后标记"暂不可用"跳过
3.3 OID树优化
设备MIB结构:
.1.3.6.1.4.1.12345.1.1.1 (温度 int16 × 0.01)
.1.3.6.1.4.1.12345.1.1.2 (湿度 int16 × 0.01)
.1.3.6.1.4.1.12345.1.1.3 (露点 int16 × 0.01)
.1.3.6.1.4.1.12345.1.1.4 (设备状态 uint8)
.1.3.6.1.4.1.12345.1.1.5 (运行时间 uint32)
优化策略:
- 用
GETBULK从.1.3.6.1.4.1.12345.1.1起始,一次拉取全部5个叶子节点 Max-Repetitions设为5,确保单次响应包含所有目标OID- 避免Walk全树(防止固件bug返回超大数据量)
3.4 超时与重试策略重设计
参数 | 初始值 | 调优后 | 原因 |
|---|---|---|---|
超时时间 | 3000ms | 800ms | 局域网内正常响应<200ms |
重试次数 | 3次 | 1次 | 减少单设备卡死拖慢全局 |
并发度 | 1(串行) | 10/Worker | 平衡交换机负载 |
轮询间隔 | 5min | 30s | 目标周期 |
失败标记 | 立即重试 | 标记"cooldown 60s" | 避免反复打故障设备 |
批量大小 | 1 OID | 5 OID/GETBULK | 减少交互次数80% |
四、踩坑实录
坑1:v2.1固件不支持GETBULK的Max-Repetitions>1
现象:对32台v2.1设备发GETBULK设Max-Repetitions=5,返回只有1个变量绑定。
原因:该版本固件实现不完整,GETBULK被降级为等效GETNEXT,只返回第一个匹配OID。
解法:按固件版本分流——v2.5+用GETBULK,v2.1退化为GETNEXT批量(连续发3次GETNEXT模拟批量效果,仍比单GET快)。
async def fetch_device(target, firmware):
    if firmware >= "2.5":
        return await snmp_getbulk(target, base_oid, max_repetitions=5)
    else:
        # v2.1: 3次GETNEXT
        results = []
        oid = base_oid
        for _ in range(3):
            oid, val = await snmp_getnext(target, oid)
            results.append(val)
        return results
坑2:SNMP引擎ID缓存导致v3设备握手风暴
现象:部分设备启用SNMP v3后,采集引擎启动时对50台v3设备同时发discover请求,交换机CPU飙到85%。
原因:v3需要引擎ID发现(EngineID Discovery),50台并发discover产生大量响应包,且部分设备响应慢导致重试叠加。
解法:
- 预配置引擎ID到本地缓存文件,跳过discover阶段
- v3设备错峰启动,每5秒发起一台的首次握手
- 后续轮询复用已建立的USM上下文
坑3:UDP丢包导致间歇性数据缺失
现象:优化后轮询周期达到28s,但约3%~5%的采集请求无响应,重试后仍失败。
原因:千兆交换机缓冲区有限,10路并发×156台设备的高频UDP包在高峰期产生微突发,交换机尾丢弃。
解法:
- 采集节点从1台增加到2台,每台负责78台,降低单节点发包速率
- 启用
SO_RCVBUF增大socket接收缓冲区到2MB - 在交换机端口配置
storm-control unicast level 30(限制未知单播风暴) - 应用层加1秒jitter随机偏移,避免所有设备同步请求
坑4:pysnmp内存泄漏
现象:连续运行3天后,采集进程内存从200MB涨到1.8GB。
原因:pysnmp的SnmpEngine对象在每次会话创建时注册内部回调,但未正确释放,导致闭包引用循环。
解法:切换到aiosnmp(纯asyncio实现,无C扩展),内存稳定在85MB以内。
坑5:MIB解析开销过大
现象:使用pysnmp的nextCmd+MIB解析器时,CPU占用率异常高。
原因:每次响应都做MIB文件解析(加载ASN.1文本→编译→缓存),即使OID已缓存,解析器仍有大量字符串操作。
解法:弃用MIB解析,直接用OID数值操作,返回值按已知类型手动解码(int16/uint8),CPU占用从单核100%降到15%。
坑6:跨VLAN路由导致MTU问题
现象:VLAN C的39台设备偶尔返回截断的SNMP响应。
原因:VLAN间路由启用了GRE隧道封装,MTU从1500降到1476,而GETBULK响应包(含5个OID值)在某些设备上超过1476字节,分片后部分分片丢失。
解法:
- 调整GETBULK的Max-Repetitions从5降到3,确保单包<1400字节
- 交换机端启用
ip tcp adjust-mss 1400 - 对v2.1设备进一步降到2
五、调优前后对比
指标 | 初始(串行v1) | 第一轮优化(并发v2c) | 最终版 |
|---|---|---|---|
采集周期 | 234s(3分54秒) | 52s | 28s |
并发度 | 1 | 40(4Worker×10) | 40 |
单次交互OID数 | 1 | 3~5 | 3~5 |
数据完整率 | 100% | 95~97% | 99.4% |
CPU占用(采集节点) | 单核100% | 四核均载45% | 两节点各25% |
内存占用 | 200MB | 650MB | 85MB/node |
交换机CPU峰值 | 15% | 72% | 38% |
超时失败次数/轮 | 0 | 5~8次 | 0~2次 |
六、SNMP采集引擎核心代码片段
class SNMPEngine:
    def __init__(self, devices, concurrency=10):
        self.devices = devices  # [{ip, firmware, version, community}]
        self.semaphore = asyncio.Semaphore(concurrency)
        self.cooldown = {}  # ip -> next_retry_ts

    async def poll_all(self):
        tasks = [self._poll_device(d) for d in self.devices]
        results = await asyncio.gather(*tasks, return_exceptions=True)
        return self._aggregate(results)

    async def _poll_device(self, dev):
        # 冷却检查
        if dev['ip'] in self.cooldown:
            if time.time() < self.cooldown[dev['ip']]:
                return None
            del self.cooldown[dev['ip']]

        async with self.semaphore:
            try:
                if dev['firmware'] >= "2.5":
                    data = await snmp_getbulk(
                        dev['ip'], dev['community'],
                        OID_BASE, max_repetitions=3,
                        timeout=0.8, retries=1
                    )
                else:
                    data = await self._getnext_batch(dev)
                return self._decode(data, dev)
            except SNMPTimedOut:
                self.cooldown[dev['ip']] = time.time() + 60
                return None
七、延伸:与Modbus TCP采集的对比选型
维度 | SNMP | Modbus TCP |
|---|---|---|
协议开销 | 较大(ASN.1 BER编码) | 小(简单二进制) |
批量读取 | GETBULK原生支持 | 需自定义多寄存器读 |
设备资源消耗 | 较高(需MIB解析) | 极低 |
网络传输效率 | UDP无连接,快但不保证 | TCP可靠但握手开销 |
适用场景 | IT设备、网络交换机 | 工业传感器、PLC |
156台30s一轮 | 可行(需调优) | 更轻松(连接复用好) |
设备兼容性 | 需固件支持SNMP | 工业设备标配 |
结论:纯工业环境优先Modbus TCP;IT/OT混合环境且设备已支持SNMP时,调优后完全可用,但要做好版本分流和并发控制。
八、关键经验
- SNMP v1串行GET在大批量场景下不可用,必须升级v2c+GETBULK+异步并发,这是架构级改造。
- 固件版本碎片化是最大隐性成本——同一品牌不同版本的SNMP实现差异巨大,必须按版本分流策略。
- UDP无连接不等于无代价,高频SNMP批量会产生微突发丢包,需要控制并发度+增大缓冲区+随机jitter。
- pysnmp等重型库在高频场景下内存和CPU开销不可接受,轻量asyncio原生实现反而更稳。
- GETBULK的Max-Repetitions不是越大越好,要考虑MTU和交换机缓冲区,实测3是最优值。
- 冷却标记(cooldown)机制是防止故障设备拖慢全局的关键——宁可跳过一轮也别反复重试。
九、关键词
SNMP协议、温湿度变送器、轮询性能调优、GETBULK、异步并发、SNMP v2c、批量采集、UDP丢包、aiosnmp、Modbus TCP对比、网络环境监测、工业物联网
物联网 #SNMP #网络监控 #温湿度监测 #性能调优 #GETBULK #异步IO #工业物联网 #数据采集 #环境监测 #SNMPv2c #批量采集
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号