领域模型进化:GRPO 强化学习与 Post-training Engineering
原创
领域模型进化:GRPO 强化学习与 Post-training Engineering
原创
老周聊架构
发布于 2026-10-12 18:20:41
发布于 2026-10-12 18:20:41
通用大模型(base model)是个通才。它在万亿 token 上做过 next-token prediction,把世界知识压缩进了权重,但你让它写一段符合你公司合规规范的代码、审一份你领域的合同、跑通你内部系统的 SQL,它大概率会给你一个"看起来像那么回事"但细节不对的东西。从 Llama、Qwen 这样的 base model 到一个能在你业务里真正干活的领域智能体,中间差的不是预训练,而是 post-training。
这一篇讲把通用大模型训成领域智能体最关键的一段训练技术链条:SFT 打底、RLHF/RLAIF 对齐偏好、再用 GRPO 这种新一代强化学习把模型推到领域能力的上限。我会重点拆 GRPO 的数学直觉,讲清楚它是怎么在省掉 critic 网络的前提下还能稳定做策略优化的,以及奖励信号到底怎么设计、训练稳定性怎么保、reward hacking 怎么防。这部分是领域模型进化真正的收束点,值得写深。
Post-training 全景:SFT 打底,RL 收口
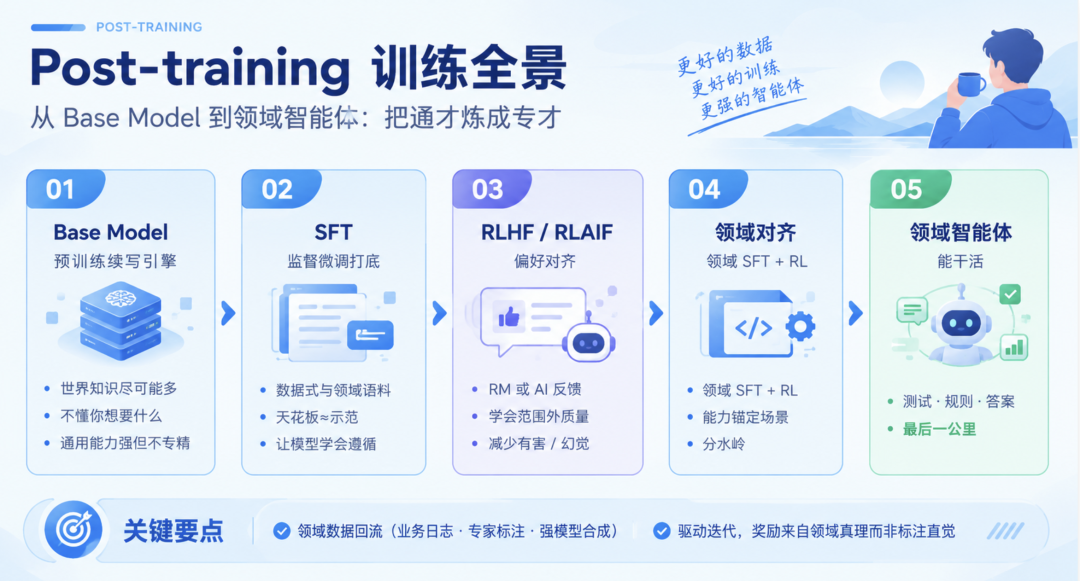
要理解 GRPO 为什么重要,得先把 post-training 的全景摆出来。一个能用的领域智能体,训练链路通常分几段。
Pre-training 给你的是续写引擎。 base model 学会的是"给定前面的 token,预测下一个 token"。它有无穷的世界知识,但它不知道你想要什么格式、不知道什么是"好答案"、不知道在你这个领域里"正确"的边界在哪里。它只是在做概率续写。
SFT(Supervised Fine-Tuning)把续写变成完成指令。 用一批高质量的 (prompt, response) 对去微调,模型从"续写"切换到"对话、遵循指令、产出指定格式"。这一阶段你可以把领域术语、领域推理风格、输出schema都喂进去。但 SFT 本质是模仿学习,它的最大似然目标决定了它的天花板就是数据集里最好的人类示范。它不会超越示范,更不会在无人示范的硬样本上自我纠错。这是 SFT 躲不开的天花板。
RLHF 把人类偏好变成可优化的信号。 先用人类偏好对比数据(同一个 prompt 的两个回答,标出哪个好)训练一个 reward model(RM);再用强化学习(经典做法是 PPO)去优化 policy,让它能拿到 RM 给的高分。这一步让模型学会了示范数据里没有的微妙质量:语气、帮助性、安全性、连贯度。Anthropic 的 Constitutional AI 把"人类标注"换成"模型按宪法自判",就是 RLAIF(RL from AI Feedback),成本更低、可规模化。
领域对齐是最后的收束点。 在通用 SFT + RLHF 之后,用领域数据再做一轮 SFT + 领域 RL,把能力锚定到具体场景:法律、医学、代码、金融、你公司的内部系统。这一步就是"领域智能体"和"通用聊天机器人"的分水岭。而领域 RL 用什么算法、奖励怎么来、怎么不训崩,正是 GRPO 要解决的。
为什么 SFT 不够,必须上 RL
SFT 的根本限制在于:它对训练样本里的 token 赋最大似然权重,对分布外(OOD)的硬样本没有显式的"试错到反馈"机制。模型学到的只是"在类似数据上该说什么",而不是"什么结果才是真的对"。
RL 的核心直觉是"从结果中学习"。先让模型采样出一批输出,再用奖励信号告诉它哪个好、哪个坏,梯度就朝好输出的方向推。对领域任务来说这特别关键,因为大量领域目标是可验证的:答案对不对、单测过没过、SQL 跑没跑通、合规规则违没违。这类目标 SFT 给不了"怎样能更好"的精细梯度,RL 可以。模型在采样中撞到一条能跑通的单测路径,奖励立刻给正反馈,这条路径的概率就被放大。这是纯模仿学不来的能力。
问题只剩一个:RL 里的"优势(advantage)"怎么估计。经典 PPO 用 critic 网络,代价很大。GRPO 换了一条更省的路。
PPO 的账本:为什么它贵
PPO 是 on-policy 的 policy gradient 方法,核心是 clipped surrogate objective:限制新策略相对旧策略的更新幅度别一次迈太大。但要让这个公式工作,PPO 必须估计每个时刻的 advantage:
A_t = r_t + γ·V(s_{t+1}) − V(s_t)这个 V(s) 是状态价值,由一个独立的 critic 网络来近似。critic 几乎和 policy 同架构、同参数量,因为它要处理同样规模的特征。训练时每次更新都要同时跑 policy 前向 + critic 前向、反向,显存和算力接近翻倍。这是大模型 RL 长期被诟病的工程痛点:你想训一个 70B 的 policy,还得再养一个 70B 的 critic。
更隐蔽的问题在 critic 本身会训不准。advantage 的误差会直接灌进 policy 梯度,value 网络一旦拟合不好,整条 RL 链路都不稳。很多 PPO 训 LLM 的失败,根因不是 policy 学不会,而是 critic 给出的 baseline 在抖。
GRPO 的核心机制:组内相对优势估计
GRPO(Group Relative Policy Optimization)来自 DeepSeekMath(2024)。它最漂亮的地方,是用一次采样组内对比,把 critic 彻底干掉了。
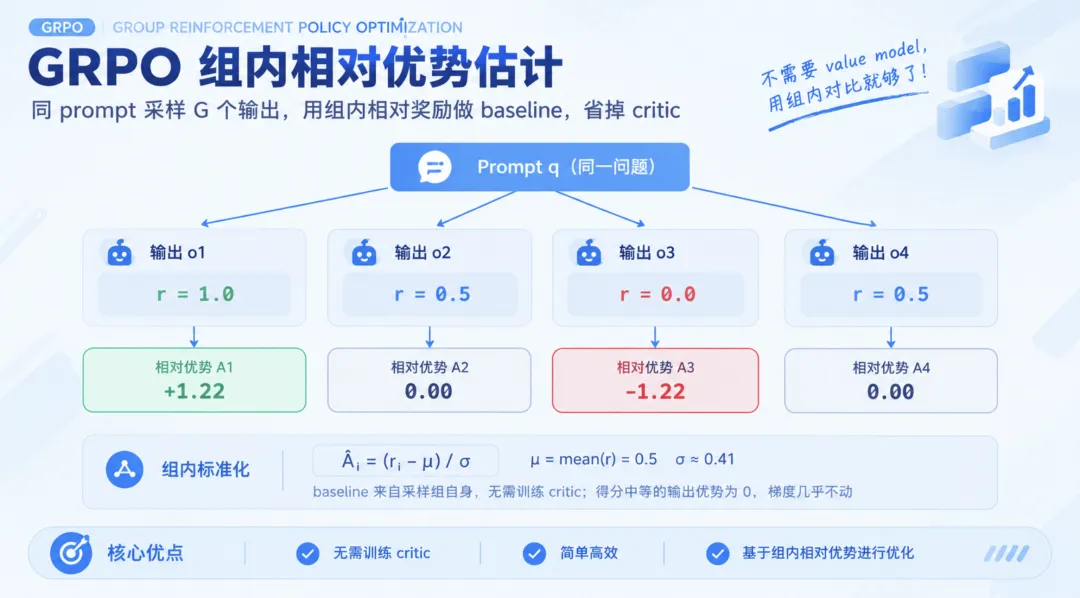
机制是这样的。对一个 prompt q,从旧策略 π_old 采样一组 G 个输出 {o_1, ..., o_G},分别用奖励函数算出奖励 {r_1, ..., r_G}。然后不训练任何价值网络,而是直接对这组奖励做组内标准化:
Â_i = (r_i − mean(r_1...r_G)) / std(r_1...r_G)这个 Â_i 就是输出 i 的相对优势,它对输出 i 内部的每个 token 共用(在 GRPO 里 advantage 是 output 级的,不是 token 级的)。
数学直觉有三层。第一层,baseline 不再是 value 网络,而是"同一 prompt 下这批采样输出的平均表现"。每个 prompt 的奖励尺度被自动归一化:难 prompt 大家分都低、易 prompt 大家分都高,但只要组内有相对差异,梯度就有方向。模型学到的不是"这个 prompt 该得多少分",而是"在相同请求下,哪种回答相对更优"。
第二层,这本质上是统计里的 within-subject contrast(组内对照):去掉了 prompt 之间的难度方差,只保留组内相对信号。对 LLM 尤其友好,因为不同 prompt 之间奖励绝对值差异巨大、又没有统一参考系,用绝对分数当 baseline 噪声极大,用组内对照就稳得多。
第三层,蒙特卡洛视角。G 个采样就是对当前策略在该 prompt 下行为分布的一次抽样估计。组内相对排名近似了这个分布的 pairwise preference,等价于用组内对比代替了 RM 的 pairwise 偏好学习。换句话说,GRPO 把"需要额外训练一个 RM 才能得到的相对偏好"直接用采样组近似出来了。
举一个具体的数字例子,把公式落到地上。假设一个数学 prompt,模型采样了 G=4 个输出,奖励函数(正确给 1、部分正确给 0.5、错误给 0)给出 r = 1.0, 0.5, 0.0, 0.5。组内均值 μ = 0.5,标准差 σ ≈ 0.408(用无偏估计),于是标准化优势分别是:
 = [ (1.0−0.5)/0.408, (0.5−0.5)/0.408, (0.0−0.5)/0.408, (0.5−0.5)/0.408 ]
= [ +1.22, 0.0, −1.22, 0.0 ]看清这里发生了什么。得分中等的输出(0.5)优势是 0,梯度对它几乎不动;满分输出被正向推、零分输出被负向压。模型学到的不是"数学题该得 0.5 分",而是"在相同这道题下,能算对的回答比算错的更值得提概率"。如果换一个 prompt 大家都算对(r = 1,1,1,1),μ=σ=1,标准化后全为 0,梯度为零,模型不在这种已经饱和的样本上浪费更新。这正是组内对照的妙处:它自动忽略"这个 prompt 本来就很难/很简单"的绝对信息,只关心相对好坏。
标准差这里还有一个工程选择。有些实现用把所有 G 个奖励减均值后直接除以标准差(如上),也有实现为了数值稳定或避免某个输出被极端放大,会用 G 个奖励相对均值的平均绝对偏差替代,或在分母加一个小常数。无论哪种,核心不变:advantage 是组内相对量,不是绝对量。
GRPO 目标函数拆解
把机制写成目标函数,一次性看清楚它的全部组成:
J_GRPO(θ) = E_{q~Q, {o_i}~π_old(·|q)} [ 1/G · Σ_i 1/|o_i| · Σ_t min(
        ρ_{i,t}(θ) · Â_i ,
        clip(ρ_{i,t}(θ), 1−ε, 1+ε) · Â_i
    ) ] − β · KL[ π_θ ‖ π_ref ]
其中概率比 ρ{i,t}(θ) = πθ(o{i,t} | q, o{i,<t}) / πold(o{i,t} | q, o_{i,<t})。
逐项拆。
内层 min + clip 是 PPO 的 clipped surrogate。 它限制新策略相对旧策略的更新幅度。当 ρ 往好处跑超过 1+ε,或者往坏处跑低于 1−ε 时,梯度被截断,防止一步迈太大把策略训崩。clip 区间通常取 ε≈0.2。GRPO 在这一点上完全继承自 PPO,稳定性来源之一就是这个。
乘以 Â_i 是梯度方向权重。 正优势的输出被提升概率,负优势的被压低。注意 advantage 是 output 级常量,所以它对所有 token 一视同仁地加权。
外层对 G 个输出、对输出内每个 token 求平均。 这里有个细节:1/|o_i| 做了长度归一。不加这个,长输出会因为 token 多而 dominate 梯度,模型会倾向于"写得长"而不是"写得好"。这是个很容易踩的坑,也是 reward hacking 的一个入口。
−β · KL 是锚。 π_ref 是冻结的参考模型,通常就是 SFT 之后的初始模型。KL 项像一个弹簧,把当前策略拉住,防止它为了刷奖励漂移到语义崩坏、格式乱掉、或退化成少量高奖励模板。这是 RLHF 里防 reward hacking 的正则核心。β 太大训不动,太小会漂,工程上常做成自适应。
最关键的一点再强调一遍:整个目标函数里没有 critic。advantage 由采样组即时算出,省掉的不只是半份显存,更是去掉了 value 网络那一路会抖的误差源。
GRPO 与 PPO 的本质差异
把两者的区别摊开看,不是"谁更好",而是"代价和适用面不同"。
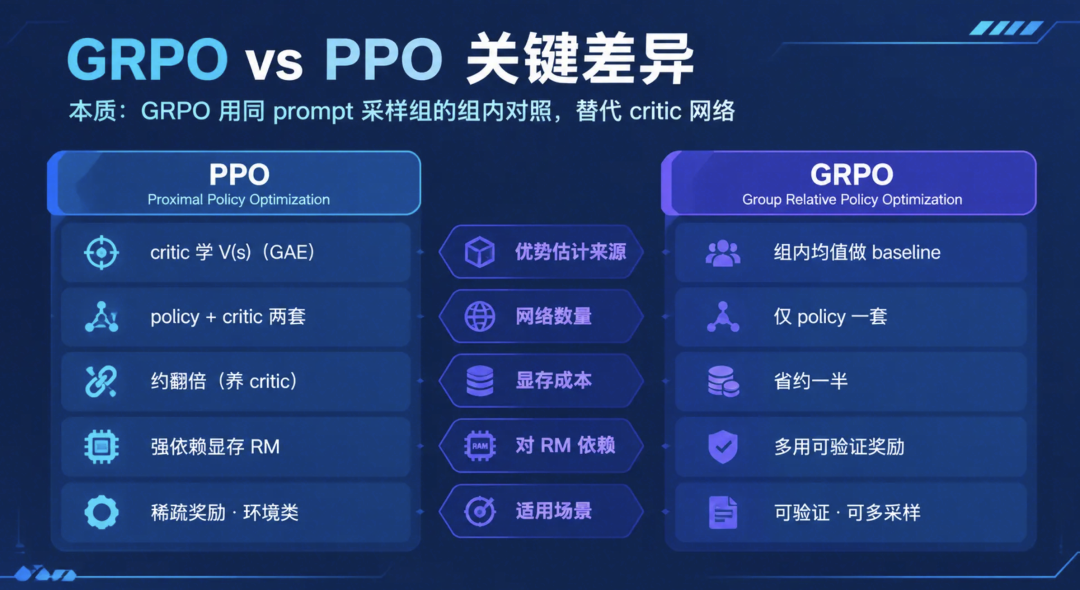
优势估计来源。 PPO 用一个训练出来的 critic 学 V(s),是参数化的、跨 prompt 共享的 baseline。GRPO 用同 prompt 的 G 个采样奖励的组内均值当 baseline,是无参数的、per-prompt 即时估计。前者泛化但需要训,后者省钱但每个 prompt 要多采样 G 次。
网络数量与成本。 PPO 同时养 policy + critic,显存和算力接近翻倍,且 critic 的前向反向都要占卡。GRPO 只需一套 policy 前向(采样时),reference 模型只在算 KL 时前向一次,且可以离线共享权重。实际训练里 GRPO 的显存占用大致是 PPO 的一半多一点,这对大模型 RL 是决定性优势。
对奖励模型的依赖。 两者都吃奖励信号。但 GRPO 在 DeepSeek-R1 之后常被用于 verifiable reward(可验证奖励):奖励来自规则而非易碎的 RM。这让它比"全靠 RM 打分的 PPO"稳得多,因为规则判据基于真相,不是代理。
适用场景。 GRPO 在"同一 prompt 能多采样、且能自动评分"的场景极顺:数学、代码、结构化 JSON、SQL、任何有参考答案或单测的任务。PPO 更适合奖励稀疏、需要把 credit 细分到细粒度状态的环境类任务(比如游戏、机器人控制),那种场景组内对照的 baseline 不如训出来的 critic 准。顺带提一句,RLOO、ReMax 等变体思想同源,都是用采样组内对比替代 critic,GRPO 是其中工程化最完整、用得最广的一个。
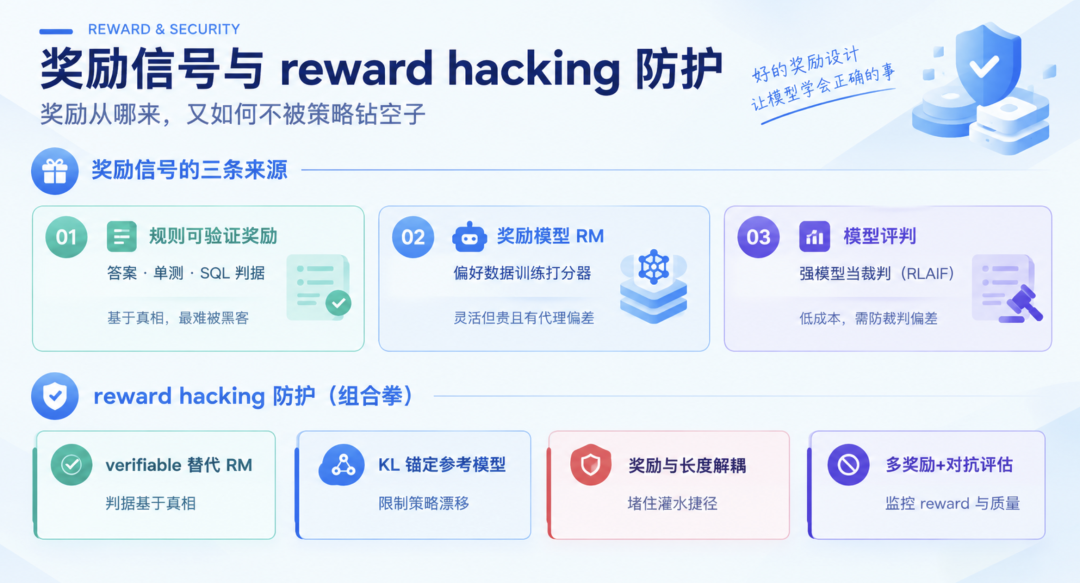
奖励信号设计:规则、模型评判、可验证奖励
GRPO 再省,也得有人告诉它"什么叫好"。奖励信号有三条主要来路。
Rule-based verifiable reward。 数学题判最终答案与参考答案相等,代码题判单测通过,SQL 题判执行结果。奖励是 0/1 或带部分分的离散信号。这是最干净的一类,几乎不可被 RM 式的黑客攻击,因为判据基于真相。领域智能体最该复制的就是这个范式:把你领域的真理(测试、编译、跑通、合规规则引擎)工程化地变成奖励。
Reward model(RM)。 从偏好数据训练的独立打分器,给出连续奖励。它灵活,能评判"语气好不好""有没有帮助"这类难以规则化的维度。但它贵,而且有代理偏差:RM 只是人类偏好的近似,模型能找到钻 RM 空子的输出(冗长、奉承、格式花哨)。
模型评判(model-as-judge)。 用更强的模型当裁判打 reward,是 RLAIF 的落地形态。成本比人类标注低,但要防裁判被一致性偏差、位置偏差、自我偏好带偏。实践中常用"多个裁判交叉 + 不确定时退回到人类"。
可验证奖励(RLVR)是 DeepSeek-R1 的关键。 它的大部分训练信号来自"答案对不对",只有少量格式和连贯性用规则补。这给了领域落地一条清晰的主线:先用规则把能验证的维度覆盖住,把验证不了的维度交给模型评判兜底,尽量压缩对易碎 RM 的依赖。
领域落地时,可验证奖励的设计要具体到业务。金融场景可以把"生成的对账单与核心系统导出一致"作为 reward;运维场景可以把"生成的 K8s YAML 能被集群校验通过且不影响现有服务"作为 reward;客服场景可以把"回复引用了知识库中的正确条目、且未承诺系统不支持的能力"作为 reward。这些判据本质都是"把领域真理写成可计算函数",是领域智能体能真正可靠的前提,比堆数据重要得多。
奖励黑客与防护
reward hacking 指的是:策略找到了在奖励函数上拿高分、但实际任务质量并不高的行为。它来源有三。一是 RM 作为不完美代理,模型赌 RM 的盲点。二是奖励塑形(reward shaping)引入的捷径,比如"回答越长分越高"时模型就疯狂灌水。三是格式规则被利用:R1 早期就观察到模型会把思考塞进特定 tag 来刷格式分,而不是真的在思考。
防护是组合拳。
用 verifiable reward 替代 model-based reward 是最硬的一招,判据基于真相,黑客空间天然被压小。
KL 惩罚锚定参考模型,限制策略漂移幅度,防止它为了刷分退化成少量高奖励模板。
奖励塑形要小心:避免可被单调 exploit 的连续分量,partial credit 必须设计成"正确动作才给"。比如代码题的奖励不要简单按"行数"给,而要按"通过的单测数 / 总行数"这样更抗 gaming 的指标。
多奖励融合 + 对抗式评估:定期用人类或强模型抽查"reward 与真实质量的相关系数",一旦发现脱钩就修 RM。这是监控层面的兜底。
把奖励与输出长度解耦,或者显式加长度惩罚,堵住"灌水"这条路。
领域数据构造与 reward modeling 实战
领域 SFT 数据来自三处:真实业务日志、专家标注、强模型合成(self-instruct 类)。质量远大于数量,一份干净的高难示范顶一万份噪声数据。
领域 reward 数据需要 (prompt, 多个候选输出, 优劣标注) 或 (prompt, 可验证判据)。领域判据往往要工程化:合规规则引擎、领域单测集、知识库一致性检查,这些都是把"领域真理"变成可计算奖励的硬功夫。
冷启动 SFT 在 RL 之前极其重要。先用高质量 SFT 把模型拉到"能产出可评分输出"的水平,否则采样组里全是垃圾,组内奖励方差没有意义,GRPO 的 baseline 也就失准了。R1 专门强调了 cold-start SFT 对稳定性和最终质量的作用。
课程式推进也值得做:先易后难,奖励信号从稠密(规则可判)逐步过渡到稀疏(需要模型评判),让策略在一个稳定的 baseline 上慢慢爬坡,而不是一上来就面对高方差的稀疏奖励。
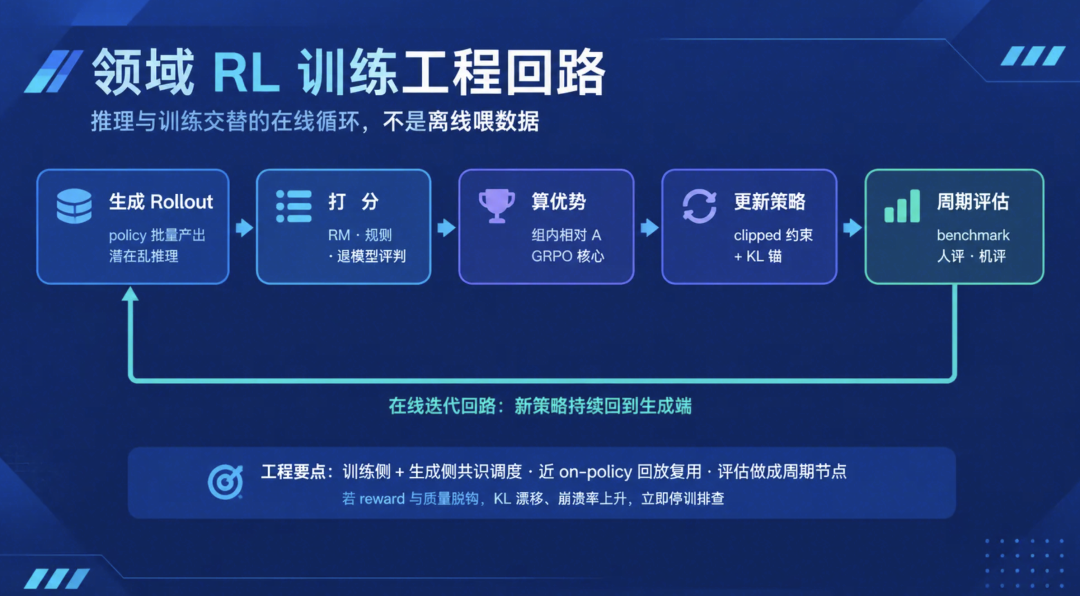
工程化:分布式训练、回放与评估闭环
GRPO 的训练和纯 SFT 完全不同,它是一个"推理与训练交替"的在线循环,不是离线喂数据。
训练回路长这样:用当前策略批量生成 rollout → 用 reward model / 规则 / 强模型打分 → 算组内相对优势 → 反向更新 policy → 用新策略再 rollout。这套 loop 对基础设施的要求比 SFT 高一个量级,因为它同时需要高吞吐推理(生成)和大规模训练(反向)。
分布式协同是难点。policy 训练侧用张量并行 + 数据并行 + 流水线并行(Megatron/DeepSpeed 式)。rollout 生成侧需要高吞吐推理引擎(vLLM、TensorRT-LLM 类)。两者必须协同调度,否则 GPU 在生成时饿着、在训练时闲着,利用率掉一半。麻烦的点在于:生成是吞吐优先的批处理,训练是显存优先的反向传播,两者对 batch 形状、显存布局、并行策略的要求都不一样。业界常见的做法是把训练和生成放在同一组 GPU 上时分复用,用一个调度器在"全量生成模式"和"反向训练模式"之间切换;或者物理分离成 inference cluster 和 train cluster,用队列流转 rollout。前者省卡但调度复杂,后者清晰但要多一倍机器。OpenRLHF、verl、NeMo-Aligner 是业界常见的对齐训练框架,本质都在解决这个"生成与训练两张皮"的调度问题。
回放(replay)要谨慎。严格 on-policy 的 GRPO/PPO 每步都要鲜采样,因为策略一更新,旧样本的分布就偏了。但工程上常保留一个轻量回放缓冲,用 importance sampling 修正分布偏移,复用高分样本以降低采样成本。代价是引入 off-policy 偏差,必须用重要性权重和截断来控制,否则优势估计会系统性失真。一个实用的折中是"近 on-policy":缓冲里的样本如果和当前策略的 KL 距离超过阈值就丢弃,这样既复用了高价值样本,又不会让分布偏太远。这也是为什么前面强调组内 baseline 要准,off-policy 修正一旦叠加在已经失真的 advantage 上,训练会迅速发散。
评估闭环不能省。训练 reward 曲线会骗你,它只反映"模型在骗奖励上越来越强"。必须建独立 eval set:领域 benchmark + 人类评委 + 模型评委三角交叉,持续追踪 reward 与真实质量的相关系数、KL 漂移量、输出长度变化、崩溃率。建议把评估做成训练循环里的周期任务,像 CI 一样卡点,一旦质量指标掉下来就停训排查。
稳定性要点。clip ε 别太大,0.2 是经验上稳的起点。KL β 要能自适应,太小漂、太大训不动。学习率要小,RL 对 lr 比 SFT 敏感。batch 内 prompt 难度要混合均匀,否则组内 baseline 失真,简单 prompt 的梯度会淹没难 prompt。
收束:领域模型进化的本质
把这一篇收一下。领域模型进化不是"再预训练一次"那么浪漫,它是一套 post-training 工程。SFT 打底,把格式和领域语料喂进去;RLHF/RLAIF 把泛化偏好对齐;GRPO 把"从结果中学习"的能力推到领域上限。真正拉开差距的,是把领域真理(测试、规则、答案)工程化地变成奖励信号,并用 verifiable reward、KL 锚、评估闭环三件套把 reward hacking 压住。
GRPO 的价值不只是"省掉 critic 省一半卡"。它把优势估计从"训一个会犯错的价值网络"变成了"同一 prompt 采一组、组内自比",这个思想转变让大模型 RL 从昂贵且脆弱,变得便宜且可大规模跑。对做领域智能体的人来说,这意味着你不必是 RL 理论专家,只要能把你领域的"对与错"工程化地写成可验证奖励,就有机会把通用大模型炼成你业务里真正能用的专家。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号