为什么需要 LangChain:从调 API 到搭应用的结构性鸿沟
原创
为什么需要 LangChain:从调 API 到搭应用的结构性鸿沟
原创
老周聊架构
发布于 2026-10-12 18:24:57
发布于 2026-10-12 18:24:57
很多工程师以为,接上 OpenAI 的 API、写个函数把问题丢进去、把回答吐出来,就算做了一个 AI 应用。我见过太多这样的"应用":上线当天跑得挺好,加个意图识别就改了三个文件,想接知识库发现原来的字符串拼接全得重写。问题不在于模型不够聪明,而在于从"调一次 API"到"搭一个应用"之间,隔着一片你原本没打算写的胶水代码。prompt 怎么拼、输出怎么解析成 JSON、超时怎么重试、多轮上下文怎么注回去、检索到的文档怎么塞进 prompt,这些事跟"让模型答得好"无关,却是每个 LLM 应用都躲不开的体力活。更糟的是它们各自很小,堆到一起迅速失控:一个 200 行客服脚本,改一处崩一片。这篇文章讲清楚一件事,LangChain 解决的不是"模型不够强",而是"应用不好搭"。
第一节:裸写 LLM 应用,其实就是一堆胶水代码
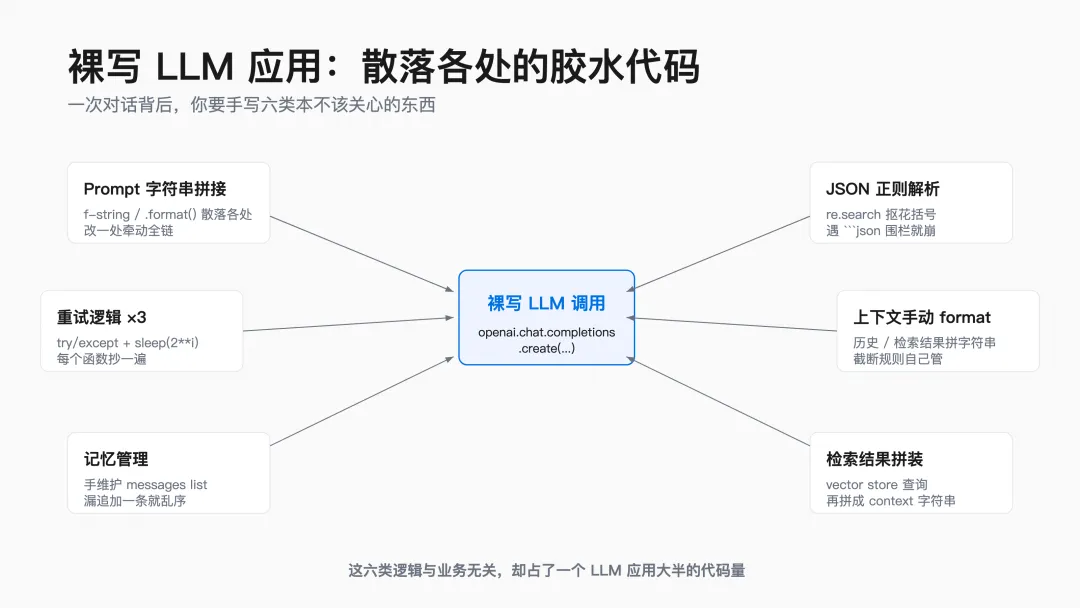
先说一个扎心的判断:**裸写 LLM 应用的本质,是用命令式代码手搓一个本该被抽象掉的"应用骨架"。** 你以为自己在写"智能",其实大部分篇幅在写"管道"。
把一次最简单的客服对话拆开看,业务无关的代码至少占六块。第一,prompt 模板拼接:系统提示、few-shot 示例、历史对话、用户问题,靠 f-string 和 .format() 拼成一段长文本,散在十几个地方。第二,输出解析:模型返回的是字符串,你想要 JSON,于是 re.search(r"\{.\*\}", text) 去抠花括号,再 json.loads,模型一旦在 JSON 外面多写了一句解释就直接炸。第三,重试与错误处理:429 限流、超时、内容过滤,每个调用点都得包一层 try/except 加指数退避,抄三遍是常态。第四,多步串联:识别意图之后还要据此再调一次模型,两次调用之间的数据怎么传,又是手写。第五,记忆注入:多轮对话的历史消息得自己维护一个 list,截断和摘要规则也得自己定。第六,检索拼装:RAG 场景下向量库的返回结果要手动拼成 context 字符串再喂回去。
这些事单看都很小,但叠加起来就是失控。因为每一块的写法都没有约定,全凭当时的手感,下一个接手的人改一条 prompt,可能连带把重试逻辑或解析正则一起弄坏。一个 200 行的脚本,真正"智能"的部分也许只有 20 行,剩下 180 行都是在伺候模型输入输出。
第二节:LangChain 解决的从来不是"让模型更聪明"
纠正一个最常见的误解。很多人听到 LangChain 就觉得它是个"让 AI 更强"的魔法框架,然后发现模型回答质量没提升,就觉得这玩意没用。这期待从根上就错了。
**LangChain 的价值不在任何一个组件,而在"统一接口 + 组合机制"这一层。** 它提供一组可组合的积木:PromptTemplate(提示模板)、ChatModel(统一模型接口)、OutputParser(输出解析)、Retriever(检索抽象)、Memory(记忆抽象)、Tool(工具调用抽象)。单个拎出来都不稀奇,PromptTemplate 无非就是个带占位符的格式化函数。真正的巧思是,所有这些积木都实现同一套 Runnable 接口,于是它们可以用管道符 | 串起来。
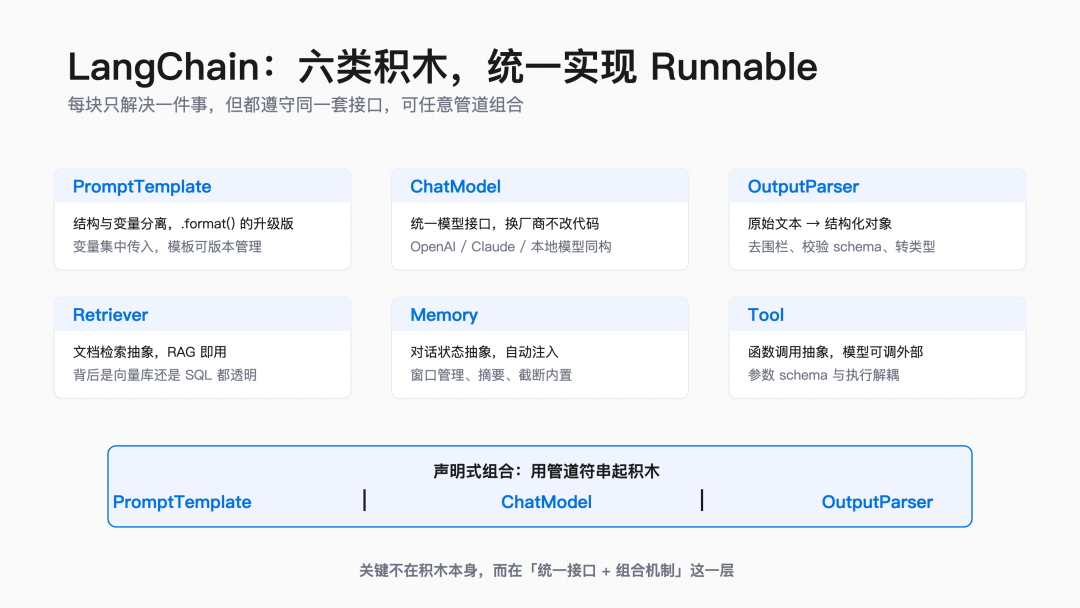
这正是 LCEL(LangChain Expression Language)的核心思想。一条链 prompt | model | parser 本身也是一个 Runnable,它可以被继续拼、被包裹、被复用。一旦所有组件都遵守同一个协议,横切关注点就能从"每次手写"变成"对链声明":重试用 .with\_retry(),兜底用 .with\_fallbacks(),流式用 .stream(),批处理用 .batch(),异步用 .ainvoke(),这些能力你一行都不用改业务代码就能获得。
我的看法是,LangChain 不是一个"更好用的模型包装器",它是一个"LLM 应用的操作系统"。它把"怎么把模型接进一个能跑、能改、能扩的系统"这件脏活,从你的业务代码里抽走了。模型还是那个模型,聪明程度没变,但围绕它的那层工程结构,从一团命令式乱麻变成了一张可声明的图。
第三节:最被低估的两块积木:PromptTemplate 与 OutputParser
在所有积木里,我认为最被低估的是 PromptTemplate 和 OutputParser。它们不性感,却是绝大多数"AI 应用故障"的爆发点。
裸写时,prompt 是一长串手工拼接的字符串,意图识别的示例、系统的口吻约束、当轮的上下文全混在一起。问题是它无法测试、无法版本化、无法复用。OutputParser 那边更惨:你以为拿到字符串就能用,其实模型会在 JSON 外面裹一层 `json 围栏,或者补一句"以下是结果",或者把字段名写错。用正则抠出来的东西还只是 dict,没有任何类型保障。
看一段裸写代码,感受下这些胶水有多刺眼。
import openai, json, re, time


def customer\_service(user\_msg, history):

    # 手写 prompt:系统提示 + few-shot + 历史 + 用户输入 全塞一个 f-string

    prompt = (

        "你是客服助手,只回答本店问题。\n"

        "示例:'我要退货' -> {\"intent\": \"return\"}\n"

        f"历史对话:{history}\n"

        f"用户:{user\_msg}\n只输出 JSON:"

    )


    # 重试:抄了三遍的 try/except + 指数退避

    for i in range(3):

        try:

            resp = openai.chat.completions.create(

                model="gpt-4o-mini",

                messages=[{"role": "user", "content": prompt}],

                timeout=10,

            )

            break

        except Exception:

            if i == 2:

                raise

            time.sleep(2 \*\* i)


    # 输出解析:用正则从文本里抠 JSON,遇围栏就崩

    text = resp.choices[0].message.content

    m = re.search(r"\{.\*\}", text, re.DOTALL)

    data = json.loads(m.group(0)) if m else {"intent": "unknown"}


    # 第二步:再拼一次 prompt,上下文全靠 format

    reply\_prompt = f"用户意图是 {data['intent']},请生成友好回复:{user\_msg}"

    reply = openai.chat.completions.create(

        model="gpt-4o-mini",

        messages=[{"role": "user", "content": reply\_prompt}],

    )

    return reply.choices[0].message.content
同样的意图,用 LangChain 写出来是这样。
from langchain\_core.prompts import ChatPromptTemplate

from langchain\_openai import ChatOpenAI

from langchain\_core.output\_parsers import JsonOutputParser

from langchain\_core.runnables import RunnablePassthrough


# prompt 是模板,结构与变量分离,可集中管理和测试

intent\_prompt = ChatPromptTemplate.from\_messages([

    ("system", "你是客服助手,只回答本店问题。示例:'我要退货' -> {{\"intent\": \"return\"}}"),

    ("human", "历史对话:{history}\n用户:{user\_msg}\n只输出 JSON,含 intent 字段。"),

])


llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

parser = JsonOutputParser()


# 链 = 模板 | 模型 | 解析器;重试是链的属性,不用抄

intent\_chain = (intent\_prompt | llm | parser).with\_retry(stop\_after\_attempt=3)


def customer\_service(user\_msg, history):

    intent = intent\_chain.invoke({"user\_msg": user\_msg, "history": history})["intent"]


    # 第二步也是一条声明式链,意图作为变量传入

    reply\_chain = (

        RunnablePassthrough.assign(intent=lambda x: intent)

        | ChatPromptTemplate.from\_template("用户意图 {intent},请生成友好回复:{user\_msg}")

        | llm

    )

    return reply\_chain.invoke({"user\_msg": user\_msg}).content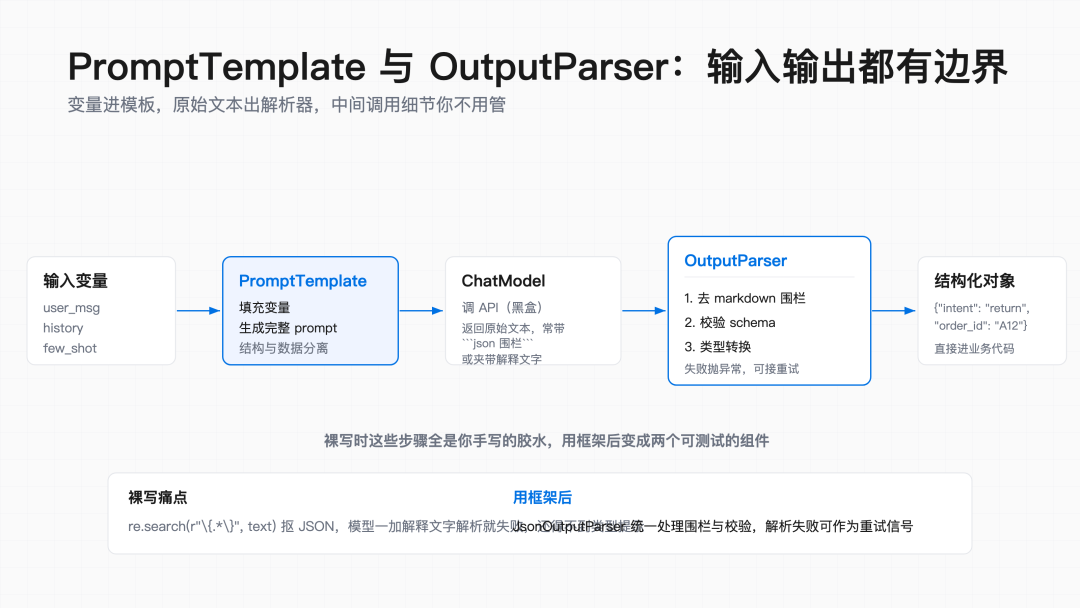
**OutputParser 这小块积木,把"文本变对象"的不确定性收进了边界内。** 它负责去 markdown 围栏、校验 schema、做类型转换,解析失败就抛异常,而这个异常正好能作为 .with\_retry() 的重试信号。裸写时这些步骤散落在函数体的各个角落,出了问题你甚至不知道是哪一步;用了框架,它们是两个独立、可单测的组件。
第四节:多步串联与记忆,裸写时是地狱,编排后可控
当应用从"一次调用"变成"一串调用",差距会被进一步放大。真实客服不是识别完意图就结束,它要分支:命中"退货"就去查订单,查回来再生成带上下文的回复;其他意图走直接回复。裸写时,这就是一层套一层的 if/else,每个分支里又各自拼 prompt、各自调模型、各自解析,链路一旦超过三步就没人敢动。
用编排的思路,这条多步流程是一张声明式的数据管道。
from langchain\_core.runnables import RunnableParallel, RunnablePassthrough


# 多步串联:意图分支 + 检索 + 生成,一条 LCEL 管道

# retriever 实现 Retriever 接口,背后是向量库还是 SQL 对链透明

answer\_chain = (

    RunnableParallel({

        "context": lambda x: retriever.invoke(x["query"]) if x["intent"] == "return" else "",

        "query": lambda x: x["query"],

        "intent": lambda x: x["intent"],

    })

    | ChatPromptTemplate.from\_template(

        "意图:{intent}\n检索上下文:{context}\n问题:{query}\n请回答:"

    )

    | llm

)


# 失败兜底:主模型挂了自动切备模型,无需手写 if

answer\_chain = answer\_chain.with\_fallbacks([backup\_llm\_chain])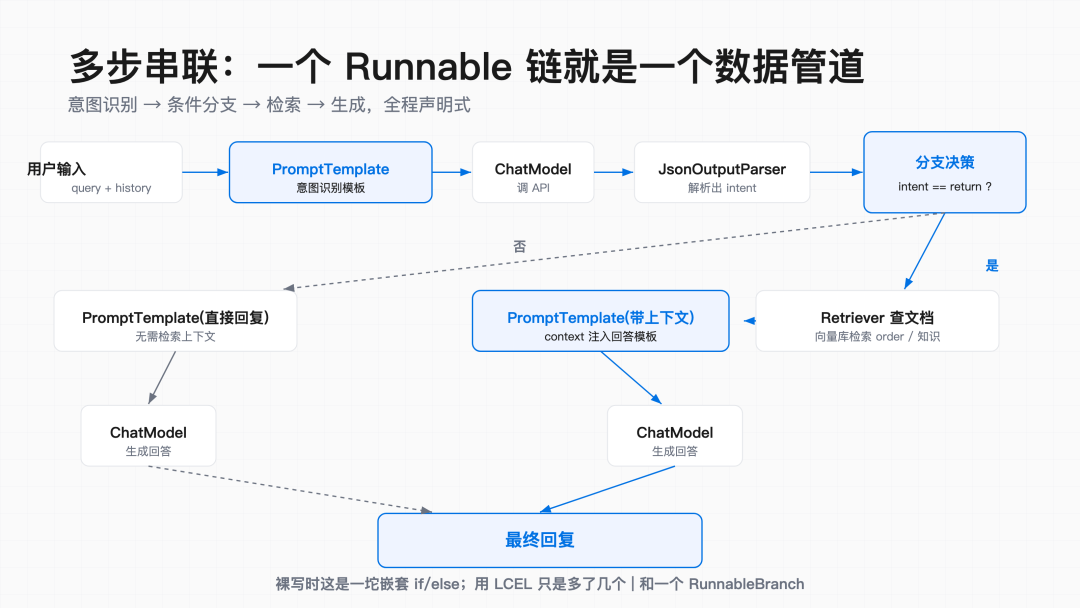
注意这里两个编排带来的红利。一是 RunnableParallel 把"并行准备多个输入字段"这件事标准化了,你不用手写字典组装和并发。二是 with\_fallbacks() 把"主链路失败时切到备用链路"做成了链的属性,而不是在每个调用点写 try/except 换模型。至于记忆,Memory 抽象帮你自动维护对话窗口、做截断和摘要,业务代码里不再出现"忘了把 assistant 消息 append 回 history"这类低级但致命的 bug。
**裸写多步链时你是在写流程控制,用编排时你是在描述数据流。** 前者每增加一个步骤都要重新理解整段控制逻辑,后者只是在管道里多接一个积木。这是可维护性的本质差别,不是代码行数的差别。
第五节:反例与反模式,那个 200 行客服脚本怎么烂掉的
最后用一组真实感很强的反模式收尾。这些写法我在生产代码里都见过,每一个都有代价。
- **prompt 硬编码散落** 把系统提示、示例、拼接逻辑写死在业务函数里。代价是改一个口吻要翻遍仓库,A/B 测试两套 prompt 几乎不可能,新人根本不知道哪段字符串才是最新的。
- **正则抠 JSON**
re.search(r"\{.\*\}", text)应付结构化输出。代价是模型一旦在 JSON 外多说一句、或多层嵌套出现第二个花括号对,解析就会截断或报错,而且没有任何类型校验兜住脏数据。 - **重试抄三遍** 每个 API 调用点都手写
try/except+time.sleep(2\*\*i)。代价是退避策略不一致,有的函数重试 3 次、有的根本没重试,限流时系统表现完全看运气。 - **记忆手维护** 自己持有一个 messages list,每次请求手动 append。代价是忘了追加 assistant 消息,模型下一轮就"失忆",而且上下文超限时没有统一的截断策略,长对话直接超 token 报错。
- **嵌套 if/else 串多步** 三步以上的编排全靠命令式分支。代价是流程固化在代码里,想加一个"先查知识库再决定要不要调工具"的分支,就得重构整段控制流。
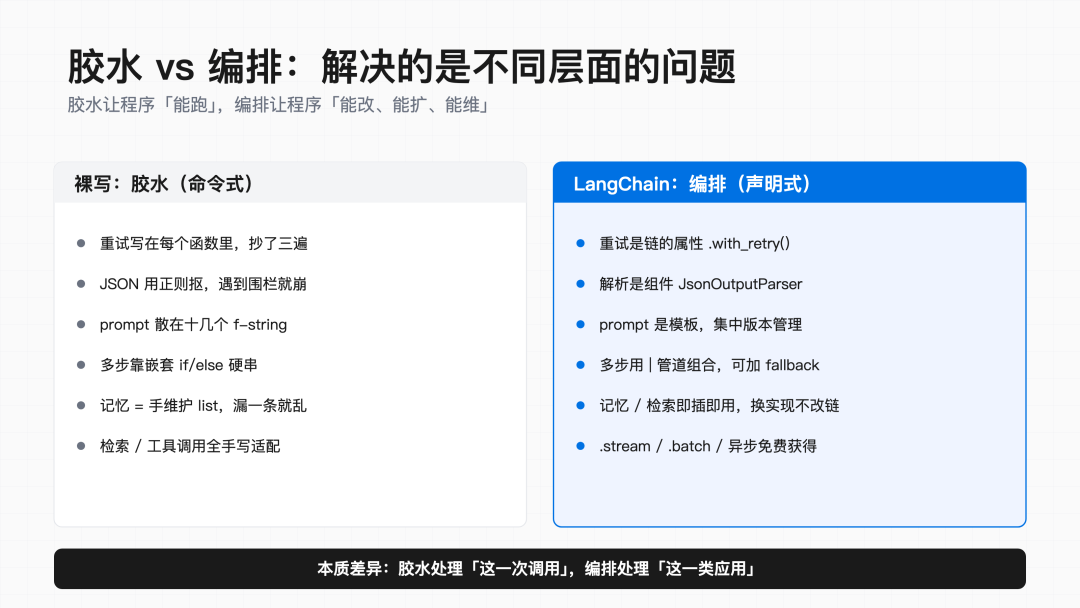
**这些反模式的共同特征是:把"应用骨架"当成了一次性的胶水,而非可复用的结构。** 它们能跑,但每一次需求变化都要付重构税。
说句公道话,我也要泼一盆冷水:LangChain 不是银弹,更不是每个场景都该上。如果你的需求只是"调一次 API 做分类然后返回",那直接 openai SDK 一行调用最清爽,套一层框架反而是负担。它版本演进快、抽象有学习成本,为一件小事引入整套体系是过度设计。我的判断标准是:**当你的应用同时踩中两个及以上特征——多步串联、结构化输出、记忆、检索、工具调用、多模型切换——LangChain 的编排价值才开始超过它的抽象开销。** 少于这个复杂度,裸写更诚实。
但一旦过了这条线,继续裸写就是在手工重造 LangChain 已经做好的轮子,而且重造出来的那个轮子还没有统一接口、没有 retry/fallback、没有流式批处理。这才是我建议认真看待 LangChain 的理由:不是它让模型变强,而是它把"从调 API 到搭应用"之间那道结构性鸿沟,填平了一大半。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号