6000 亿参数只激活 270 亿,Step 5 Preview 凭什么挤进全球开源前三
原创
6000 亿参数只激活 270 亿,Step 5 Preview 凭什么挤进全球开源前三
原创
叫我阿柒啊
发布于 2026-10-14 10:14:33
发布于 2026-10-14 10:14:33
一个模型,总参数堆到 6000 亿,真正干活时只唤醒 270 亿,却把成本压到了 Claude Opus 5 的八分之一,还在一周内登顶了 OpenRouter 热度榜
上周我注意到一个数据。全球开发者最常用的模型调用平台 OpenRouter 上,一个来自中国团队的新模型登上了 Trending 榜首,按 token 使用量排的日榜也冲到了全球第二。这个模型叫 Step 5 Preview,出自上海的阶跃星辰。
更早一点,9 月 20 日它正式发布时,全球权威评测榜单 Artificial Analysis 的综合智能指数给了它 44 分,在开源模型里排进全球前三。而那个榜的图表是全模型总榜,开源闭源都混在一起排。
一个发布不到一个月的模型,凭什么同时拿下开发者的钱包和口碑。我把它的底细扒了一遍。
PART 01|Step 5 Preview 到底是个什么东西
先交代出身。Step 5 Preview 是阶跃星辰的新一代旗舰基座模型,9 月 20 日发布,官方打算在 10 月 15 日开源完整权重。
基座模型的意思是,它是那种被各行各业拿来当底座、在上面搭应用的大家伙。而 Step 5 Preview 的定位,是一台可持续处理复杂任务的主力工作模型。
它瞄准的场景很明确,AI 编程、软件工程、专业知识工作、金融。这几个场景有个共同点,都需要长上下文、多轮工具调用、持续执行。换句话说,它不是那种聊两句天就完事的对话模型,是奔着帮你把一件复杂正事从头干到尾去的。
官方管这类任务叫 Agentic,智能体任务。让 AI 自己拆解步骤、自己调工具、自己一步步往下推,中间不太需要人盯着。Step 5 Preview 就是照着这个标准训的。
PART 02|把参数拆开看,6000 亿和 270 亿是怎么回事
很多人一看 6000 亿参数就头晕。其实这里藏着一个关键设计。
Step 5 Preview 用的是稀疏 MoE 架构。MoE 是混合专家的意思,你可以把它理解成一家大医院。医院有几百个科室,但你来看病,前台只把你分给最对口的那个或那几个科室,不会把全院专家都叫起来会诊。
6000 亿是这个医院的全部科室总量,专业覆盖面极广。270 亿是每个 token 真正被唤醒的科室,干活的人少,所以快,所以省。这就是它又大又便宜的秘密。
再看另外两个硬指标。
上下文窗口 100 万 token。上一篇文章我们聊过,上下文窗口就是 AI 的临时工作台。100 万 token 意味着它能一次性吞下上百份文档、一个中型代码库,或者几十轮的工具调用记录,而且全程不忘开头。
模态上,它原生支持文本和图片输入,输出文本。也就是说你既能丢给它文字,也能丢给它截图、图表、照片,让它一块儿理解。
我把它的核心参数整理成一张表。
参数 | 数值 |
|---|---|
架构 | 稀疏 MoE(混合专家) |
总参数量 | 600B(6000 亿) |
每 token 激活参数 | 约 27B(270 亿) |
上下文窗口 | 100 万 token |
输入模态 | 文本、图片 |
输出模态 | 文本 |
AA 综合智能指数 | 44 分(全球开源前三) |
单任务成本 | 约为 Claude Opus 5 的 1/8 |
PART 03|它真正的优势,是省钱这件事
如果只比聪明,Step 5 Preview 还不是天下第一。它真正下功夫的地方,是把智能和成本之间的平衡点往外推。
行业里管这个叫帕累托前沿。意思是花同样的钱,你能买到多强的 AI。前沿越往外拓,同样成本能拿到的能力就越多。
早期大模型卷能力,靠的是堆算力,你多烧一块钱算力,它就聪明一分。可当 AI 智能体开始处理越来越复杂的任务,这笔账就扛不住了。一个 Agent 任务动辄几十轮推理、几百万 token,成本滚起来吓人。
阶跃星辰的判断是,下一阶段的竞争核心,是提高计算转化为智能的效率。从 Step 3.5 Flash、Step 3.7 Flash 到 Step 5 Preview,连续三代模型都在啃这一件事。
结果是实打实的。单任务成本压到 Claude Opus 5 的八分之一,意味着很多过去因为太贵而不敢用顶级模型跑的任务,现在跑得起了。一个跑一夜的 Agent 项目,账单从几百美元变成几十美元,这是量变到质变的差别。
对普通用户和团队来说,这个优势比榜单上高两分更实在。模型强但用不起,等于没有。
PART 04|和顶尖模型比,它站在什么位置
比一定要横向比。
先看 Artificial Analysis 综合智能指数,44 分,全球开源前三。注意这个榜是全模型总榜,开源闭源一起排,也就是说这个成绩是放在 Claude、GPT 这些闭源巨头旁边比的,不是关起门来自娱自乐。
再看开发者的真金白银。OpenRouter 是全球开发者调用模型最集中的平台之一,Step 5 Preview 上周登顶 Trending 榜首,按 token 使用量的日榜排全球第二。开发者不看广告,看的是效果和价格,热度榜的排名比任何宣传都诚实。
成本维度,前面说过,单任务成本约为 Claude Opus 5 的 1/8。这是它最锋利的一张牌。
也要把话说完整。Step 5 Preview 目前还是 preview 版本,完整权重要到 10 月 15 日才开源,通过第三方平台调用的价格也在浮动。它的强项集中在编程、软件工程、专业知识工作和金融这类需要长链路推理的场景,在创意写作、闲聊这类任务上,它未必比那些专门调过对话体验的模型更讨喜。选模型这事,永远要看你的活儿是什么。
PART 05|它能帮你干点什么
落到具体的事上,Step 5 Preview 的用武之地很清晰。
写代码和改代码,尤其是跨文件、跨模块的大型工程任务。长上下文让它一次能装进整个代码库,不容易改着改着就忘了最初的约定。
专业研判和金融分析。读几十份研报、财报,交叉比对,给出有据可查的结论,这正是它被重点优化的方向。
长周期的项目规划和文档交付。从拆解任务、检索资料、分析数据,到产出文档和 PPT,一条链路跑下来,靠的就是多轮工具调用和持续执行的能力。
需要提醒一句。它是工具,不是裁判。它给的事实和数据,该核还得核。上一篇文章我们聊过幻觉,越强的模型编起瞎话来越像真的,这个坑对旗舰模型同样存在。
10 月 12 日起,Step 5 Preview 已接入腾讯 WorkBuddy(办公工作台),即日起至 10 月 25 日限时免费开放两周,深度研究、信息检索、数据分析、文档与 PPT 生成这些办公任务都能直接用上。旗舰模型平时是要花银子调的,这两周不收钱,想试的正好赶个热乎的。
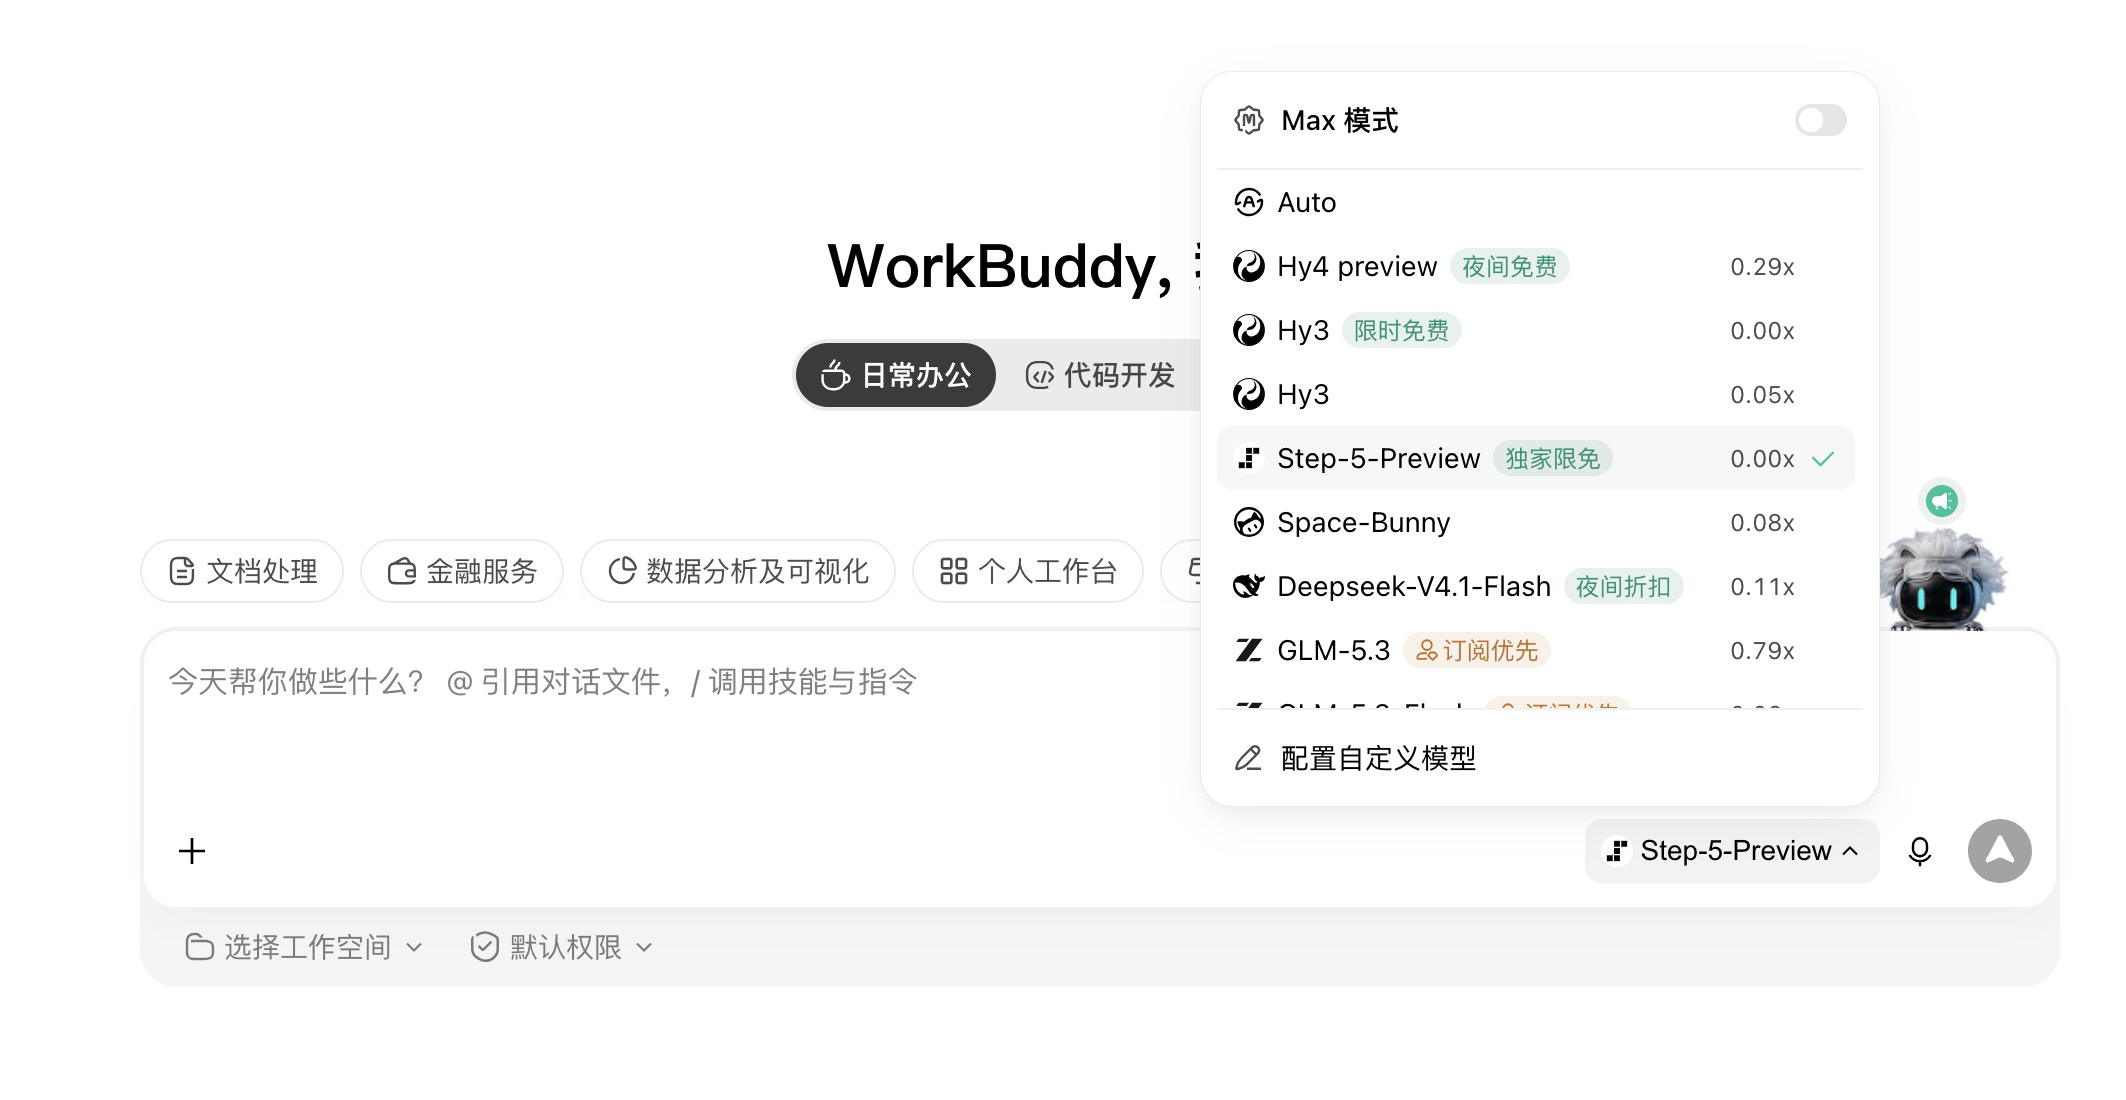
如果你现在就想试试,给你两个动作。
去 WorkBuddy 里挑一个你手头真实的复杂任务,别问它今天天气怎么样,直接丢一个需要多步骤的正活,看它能一口气做到哪一步。
同一个任务,记一下它大概消耗了多少轮次、跑了多久。两周限免期你手里攒下的这些一手体验,等以后自己掏钱买算力的时候,就是最值钱的参考。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号