LangGraph 写完了怎么对外提供服务?我用 FastAPI 把它包成了一套能上线的接口
原创
LangGraph 写完了怎么对外提供服务?我用 FastAPI 把它包成了一套能上线的接口
原创
大盘鸡拌面
发布于 2026-10-14 17:26:41
发布于 2026-10-14 17:26:41
先说个特别真实的情况。
LangGraph 的图在本地跑通那一刻,人是有点飘的——终端里 Agent 一步一步往下走,自动重试、暂停等人审批、断点还能接着跑,感觉这玩意儿明天就能上线。
然后你兴冲冲地把它丢进 FastAPI,写了第一个 /chat 接口,用 app.invoke() 同步调用。本地 curl 一下,通了。上线之后,第二个用户进来的请求直接卡死十几秒;想看 Agent 中间过程,只能干等它全部跑完才返回;服务一重启,正在跑的工单全部消失。
我第一次就是这么翻车的。问题不在于 LangGraph 不好用,而在于图和 API 是两套完全不同的运行假设。图默认是为"脚本里跑一次"设计的,而 API 面对的是并发、长连接、无状态部署和服务随时重启。这篇就讲怎么把这两套假设对上。
代码我按一个真实场景来写:电商售后工单 Agent 服务。用户提交工单,Agent 自动识别意图、查订单、给答复,金额超过 500 块挂起等人工审批,回答质量不合格自动重写。前端要能实时看到 Agent 每一步在干嘛。
一、先搞清楚:图放进 FastAPI 之后,哪几件事会崩
这一节不讲代码,讲清楚问题,后面你才知道每段代码在解决什么。
第一件事是阻塞。 LangGraph 的 invoke() 是同步方法。你在 async def 的接口里直接调用它,整个事件循环就被卡死了,uvicorn 在这期间一个请求都处理不了。这不是"慢一点"的问题,是第二个用户直接看到超时。正确做法是全程用 ainvoke() / astream(),让底层的 LLM 请求走真正的异步 IO。
但光用 ainvoke() 还不够。你的节点里如果有一行同步代码——比如 requests.get() 查物流、同步的 sqlite3 查询、某个老 SDK——它一样会堵住事件循环。这种节点我一般直接在里面 await anyio.to_thread.run_sync(...) 把它甩到线程池去,代价很小。
第二件事是流式。 HTTP 请求默认是"攒完了再一起给"。Agent 一次跑七八秒,用户盯着一个转圈的加载动画,体验上等于"这个系统坏了"。而且说实话,Agent 类产品让用户看到中间过程,本身就是信任感的一部分——他在看到"正在查询订单 SF12345"的时候,是能容忍等待的。这个必须做 SSE。
第三件事是状态。 图里的 checkpointer 用 MemorySaver 的时候,状态存在进程内存里。你本地单机跑没问题,一旦 uvicorn --workers 4 或者上 K8s 多副本,请求第一次打到 A 副本、第二次打到 B 副本,B 根本不认识这个 thread_id,对话直接断片。生产环境这玩意儿必须换成 Postgres 或者 Redis。
第四件事是"中断"怎么过 HTTP 这一关。 interrupt() 让图挂起这件事在脚本里很自然(脚本停在那儿等你输入),但在 API 里,请求早就返回了。你得设计成:第一次调用返回"我卡住了,需要审批",前端把审批卡片弹给人,人点完之后再发一个请求回来把结果喂进去。这中间可能隔了几个小时,服务重启过两次。
整个链路大概长这样:
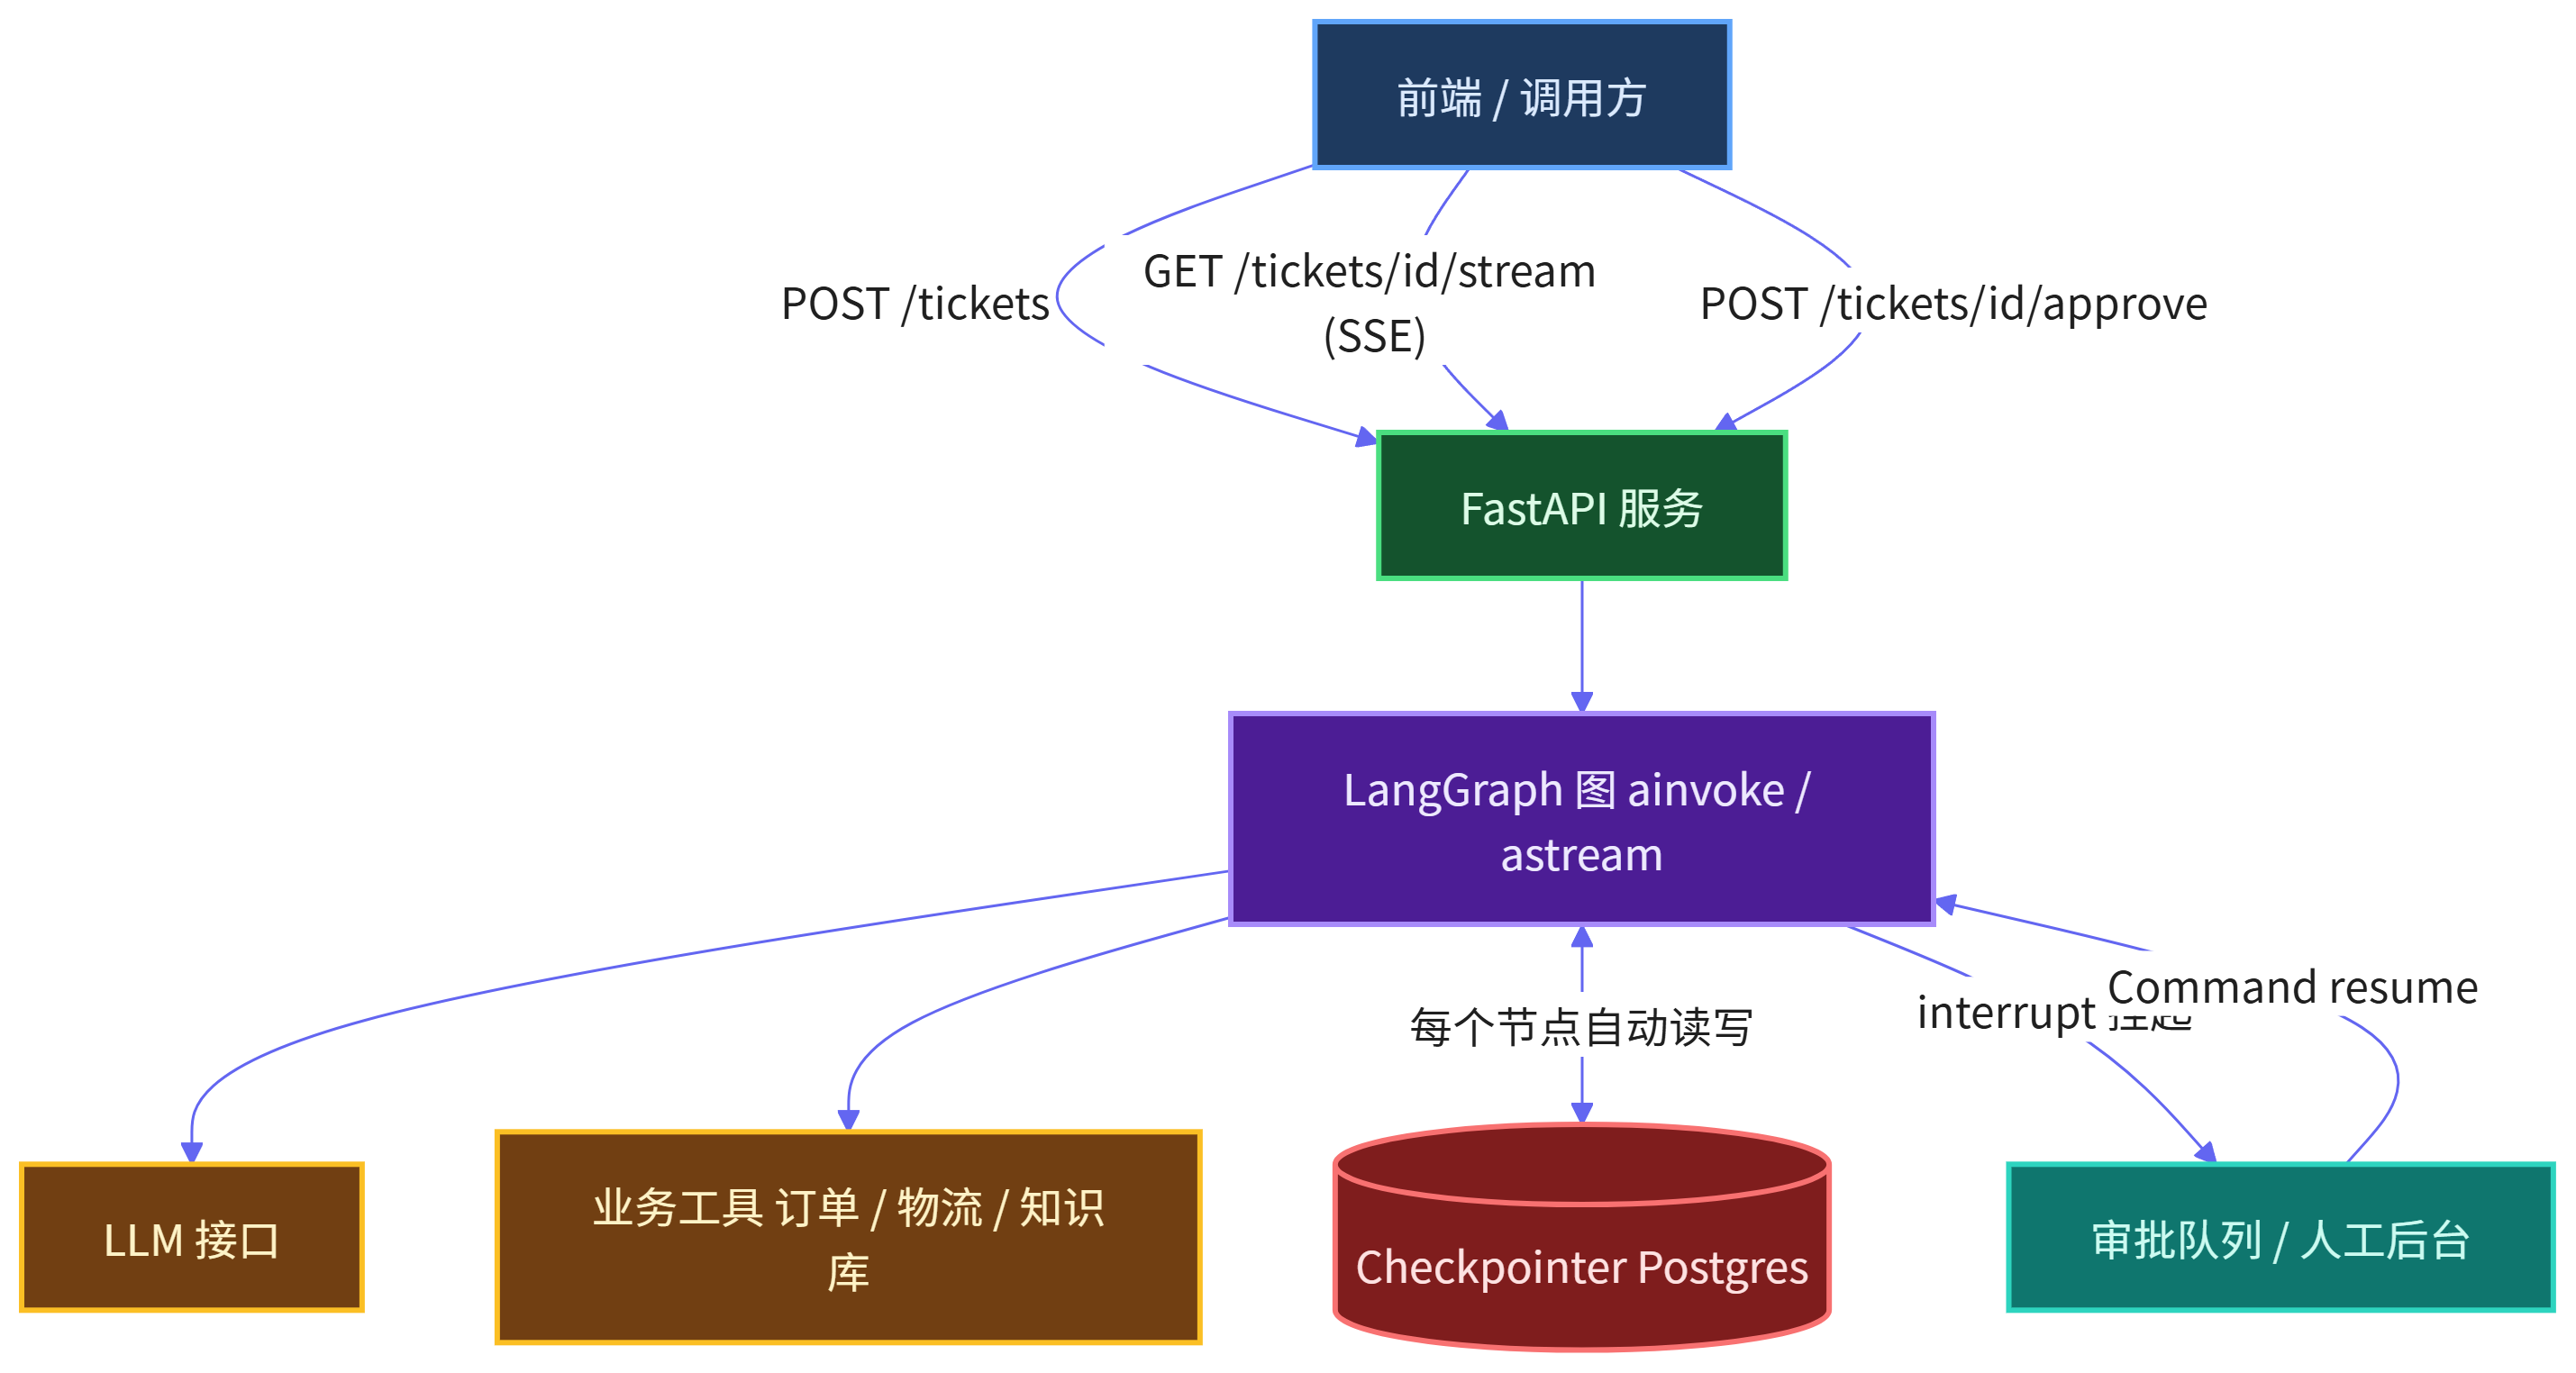
图里那个双向的 Checkpointer 箭头是重点。它是图和服务之间唯一的"记忆"通道,也是这套架构能不能水平扩展的关键。
二、服务骨架:图在什么时候编译,状态放哪
先解决最基础的一个问题:图和 checkpointer 千万别在每个请求里创建。
我见过有人图省事,把 builder.compile() 写在接口函数里面。这等于每个请求重新建一张图、重新连一次数据库,慢不说,连接池分分钟被打爆。正确做法是放在 FastAPI 的 lifespan 里,服务启动时建一次,挂到 app.state 上全局复用。
项目结构我是这么分的,不算规范但够清楚:
agent-service/
├── main.py          # FastAPI 入口,只管路由
├── graph.py         # 图的全部定义(State / 节点 / 边)
├── deps.py          # checkpointer、LLM 实例
└── schemas.py # Pydantic 请求响应模型graph.py 里定义一张售后工单的图。这里我写完整,后面几节都基于它:
# graph.py
from typing import TypedDict, Annotated
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langgraph.types import interrupt, StreamWriter, Command
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
import anyio

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)


class TicketState(TypedDict):
    messages: Annotated[list, add_messages]   # 追加历史,别覆盖
    intent: str                               # refund / logistics / consult
    amount: float                             # 退款金额
    retry_count: int                          # 重写次数,防死循环
    approved: bool                            # 人工审批结果
    final_answer: str


# ① 意图识别 + 抽金额
async def classify(state: TicketState) -> dict:
    text = state["messages"][-1].content
    prompt = f"把工单归到 refund/logistics/consult 之一,只输出一个词。\n工单:{text}"
    intent = (await llm.ainvoke(prompt)).content.strip().lower()
    if intent not in ("refund", "logistics", "consult"):
        intent = "consult"          # 兜底,别让图抛异常
    amount = 0.0
    for tok in text.replace("元", " ").split():
        try:
            amount = float(tok)
            break
        except ValueError:
            continue
    return {"intent": intent, "amount": amount}


# ② 退款:超过阈值就挂起等人
async def handle_refund(state: TicketState, writer: StreamWriter) -> dict:
    if state["amount"] > 500 and not state.get("approved"):
        writer({"step": "waiting_approval", "msg": "金额超阈值,已推送人工审批"})
        decision = interrupt({
            "reason": f"工单涉及 {state['amount']} 元退款,超过 500 元阈值",
            "amount": state["amount"],
        })
        return {"approved": bool(decision.get("approved"))}

    writer({"step": "refunding", "msg": "正在生成退款答复"})
    prompt = f"用户申请退款 {state['amount']} 元,给出专业、简短的客服回复。"
    return {"final_answer": (await llm.ainvoke(prompt)).content}


# ③ 物流查询(同步 SDK 用线程池包一层)
async def handle_logistics(state: TicketState) -> dict:
    order_id = extract_order_id(state["messages"][-1].content)
    tracking = await anyio.to_thread.run_sync(query_tracking_api, order_id)
    prompt = f"物流状态:{tracking}。用客服口吻向用户说明。"
    return {"final_answer": (await llm.ainvoke(prompt)).content}


# ④ 技术咨询
async def handle_consult(state: TicketState) -> dict:
    docs = await anyio.to_thread.run_sync(retrieve_kb, state["messages"][-1].content)
    prompt = f"参考资料:{docs}\n回答:{state['messages'][-1].content}"
    return {"final_answer": (await llm.ainvoke(prompt)).content}


# ⑤ 质检:不合格重写,超三次转人工
def quality_check(state: TicketState) -> str:
    ans = state.get("final_answer", "")
    if state["retry_count"] >= 3:
        return "to_human"
    if len(ans) < 15 or "不知道" in ans:
        return "regenerate"
    return "pass"


async def regenerate(state: TicketState) -> dict:
    prompt = f"上一版回答太简略,补充细节重写。原始问题:{state['messages'][0].content}"
    return {
        "final_answer": (await llm.ainvoke(prompt)).content,
        "retry_count": state["retry_count"] + 1,
    }


async def to_human(state: TicketState) -> dict:
    return {"final_answer": "已转交人工客服,预计 30 分钟内联系您。"}


def build_graph(checkpointer):
    b = StateGraph(TicketState)
    b.add_node("classify", classify)
    b.add_node("refund", handle_refund)
    b.add_node("logistics", handle_logistics)
    b.add_node("consult", handle_consult)
    b.add_node("regenerate", regenerate)
    b.add_node("human", to_human)

    b.add_edge(START, "classify")
    b.add_conditional_edges(
        "classify",
        lambda s: s["intent"],
        {"refund": "refund", "logistics": "logistics", "consult": "consult"},
    )
    # 三条线都汇到质检
    for n in ("refund", "logistics", "consult"):
        b.add_conditional_edges(
            n, quality_check,
            {"regenerate": n, "pass": END, "to_human": "human"},
        )
    b.add_edge("human", END)
    return b.compile(checkpointer=checkpointer)
注意 handle_refund 的第二个参数 writer——这是 LangGraph 自动注入的,不用你传,它配合 stream_mode="custom" 可以把自定义进度推给前端。还有 regenerate 那条边我指向了 n 本身(也就是重写完回到原来的业务节点),比回到 refund 更合理,因为咨询类工单重写完不该跳到退款节点去。
说明:
extract_order_id、query_tracking_api、retrieve_kb 是业务侧的伪函数,按你们自己的订单系统替换。
然后是 main.py 的骨架。这里最关键的就是 lifespan:
# main.py
from contextlib import asynccontextmanager
from fastapi import FastAPI, HTTPException
from fastapi.responses import StreamingResponse
from pydantic import BaseModel
from langgraph.checkpoint.sqlite.aio import AsyncSqliteSaver
from langgraph.types import Command
from graph import build_graph
import json, asyncio

@asynccontextmanager
async def lifespan(app: FastAPI):
    # 演示用 SQLite;生产换 AsyncPostgresSaver
    cp = AsyncSqliteSaver.from_conn_string("tickets.db")
    app.state.graph = build_graph(cp)
    app.state.locks = {}            # 每个会话一把锁,后面讲
    yield
    # 关服务时释放连接

app = FastAPI(title="售后工单 Agent 服务", lifespan=lifespan)


class TicketIn(BaseModel):
    user_id: str
    text: str

class ApproveIn(BaseModel):
    approved: bool
    comment: str | None = None


def cfg(thread_id: str):
    return {"configurable": {"thread_id": thread_id}}


def get_lock(app, thread_id: str) -> asyncio.Lock:
    return app.state.locks.setdefault(thread_id, asyncio.Lock())


@app.post("/tickets")
async def create_ticket(body: TicketIn):
    thread_id = f"{body.user_id}-{int(asyncio.get_running_loop().time() * 1000)}"
return {"thread_id": thread_id}thread_id 的设计有点讲究。我习惯用 用户ID + 某种区分符,这样同一个用户的多轮对话天然串起来,不同用户之间绝对不会互相污染。上面用时间戳是为了让同一个用户能开多个工单,如果你的业务是"一个用户一条对话线",直接用 user_id 当 thread_id 就行。
AsyncPostgresSaver 的导入路径各个版本变过(langgraph.checkpoint.postgres.aio 和独立的 langgraph-checkpoint-postgres 包都见过),装完包先去 site-packages 里确认一下实际路径,别照抄。生产环境还要在启动时调一次 await cp.setup() 建表。
三、流式:让前端看着 Agent 一步一步干活
这块是用户体验分水岭,也是我觉得最值得早做的一块。
FastAPI 里做流式就是 StreamingResponse + 一个异步生成器,协议用 SSE(text/event-stream)。格式极其简单,每帧就是 data: {json}\n\n。
LangGraph 的 astream 可以同时开好几种模式,我一般一次开三个:
def sse(event: str, data: dict) -> str:
    return f"event: {event}\ndata: {json.dumps(data, ensure_ascii=False)}\n\n"


@app.get("/tickets/{thread_id}/stream")
async def stream_ticket(thread_id: str, text: str):
    g = app.state.graph
    config = cfg(thread_id)

    async def gen():
        yield ": connected\n\n"        # 先占住连接,顺带防代理缓冲
        try:
            async for mode, chunk in g.astream(
                {"messages": [{"role": "user", "content": text}],
                 "retry_count": 0, "approved": False},
                config,
                stream_mode=["messages", "custom", "updates"],
            ):
                if mode == "messages":
                    token, meta = chunk
                    if token.content:
                        yield sse("token", {"text": token.content})
                elif mode == "custom":
                    # 节点里 writer({...}) 推出来的进度
                    yield sse("step", chunk)
                elif mode == "updates":
                    node = list(chunk.keys())[0]
                    yield sse("node_done", {"node": node})

            # 跑完之后检查一下是不是卡在人工审批了
            snap = await g.aget_state(config)
            for task in snap.tasks:
                if task.interrupts:
                    yield sse("need_approval", task.interrupts[0].value)
            yield sse("done", {"thread_id": thread_id})
        except Exception as e:
            yield sse("error", {"msg": str(e)})

    return StreamingResponse(
        gen(),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "X-Accel-Buffering": "no",   # 关键!否则 Nginx 会把流攒起来
        },
)三个模式分工很明确:messages 吐 LLM 的 token(做打字机效果)、custom 吐我自己定义的进度事件("正在查物流"这种)、updates 吐节点完成通知(前端画流程图用)。
X-Accel-Buffering: no 这个 header 我要单独说一句。本地测 SSE 一切正常,上了 Nginx 之后前端死活收不到数据、或者一次性全收到——十有八九是 Nginx 的 proxy_buffering 在攒缓冲区。加这个 header 是最省事的解法,改 Nginx 配置的 proxy_buffering off 也可以。这个坑我排查了大半天。
还有个前端的坑顺手提一下:浏览器原生的 EventSource 只支持 GET,不能带 body。上面我把 text 放 query 参数就是为了兼容它。如果你要 POST,前端得用 fetch 自己读 ReadableStream。
整条链路的时序是这样的:
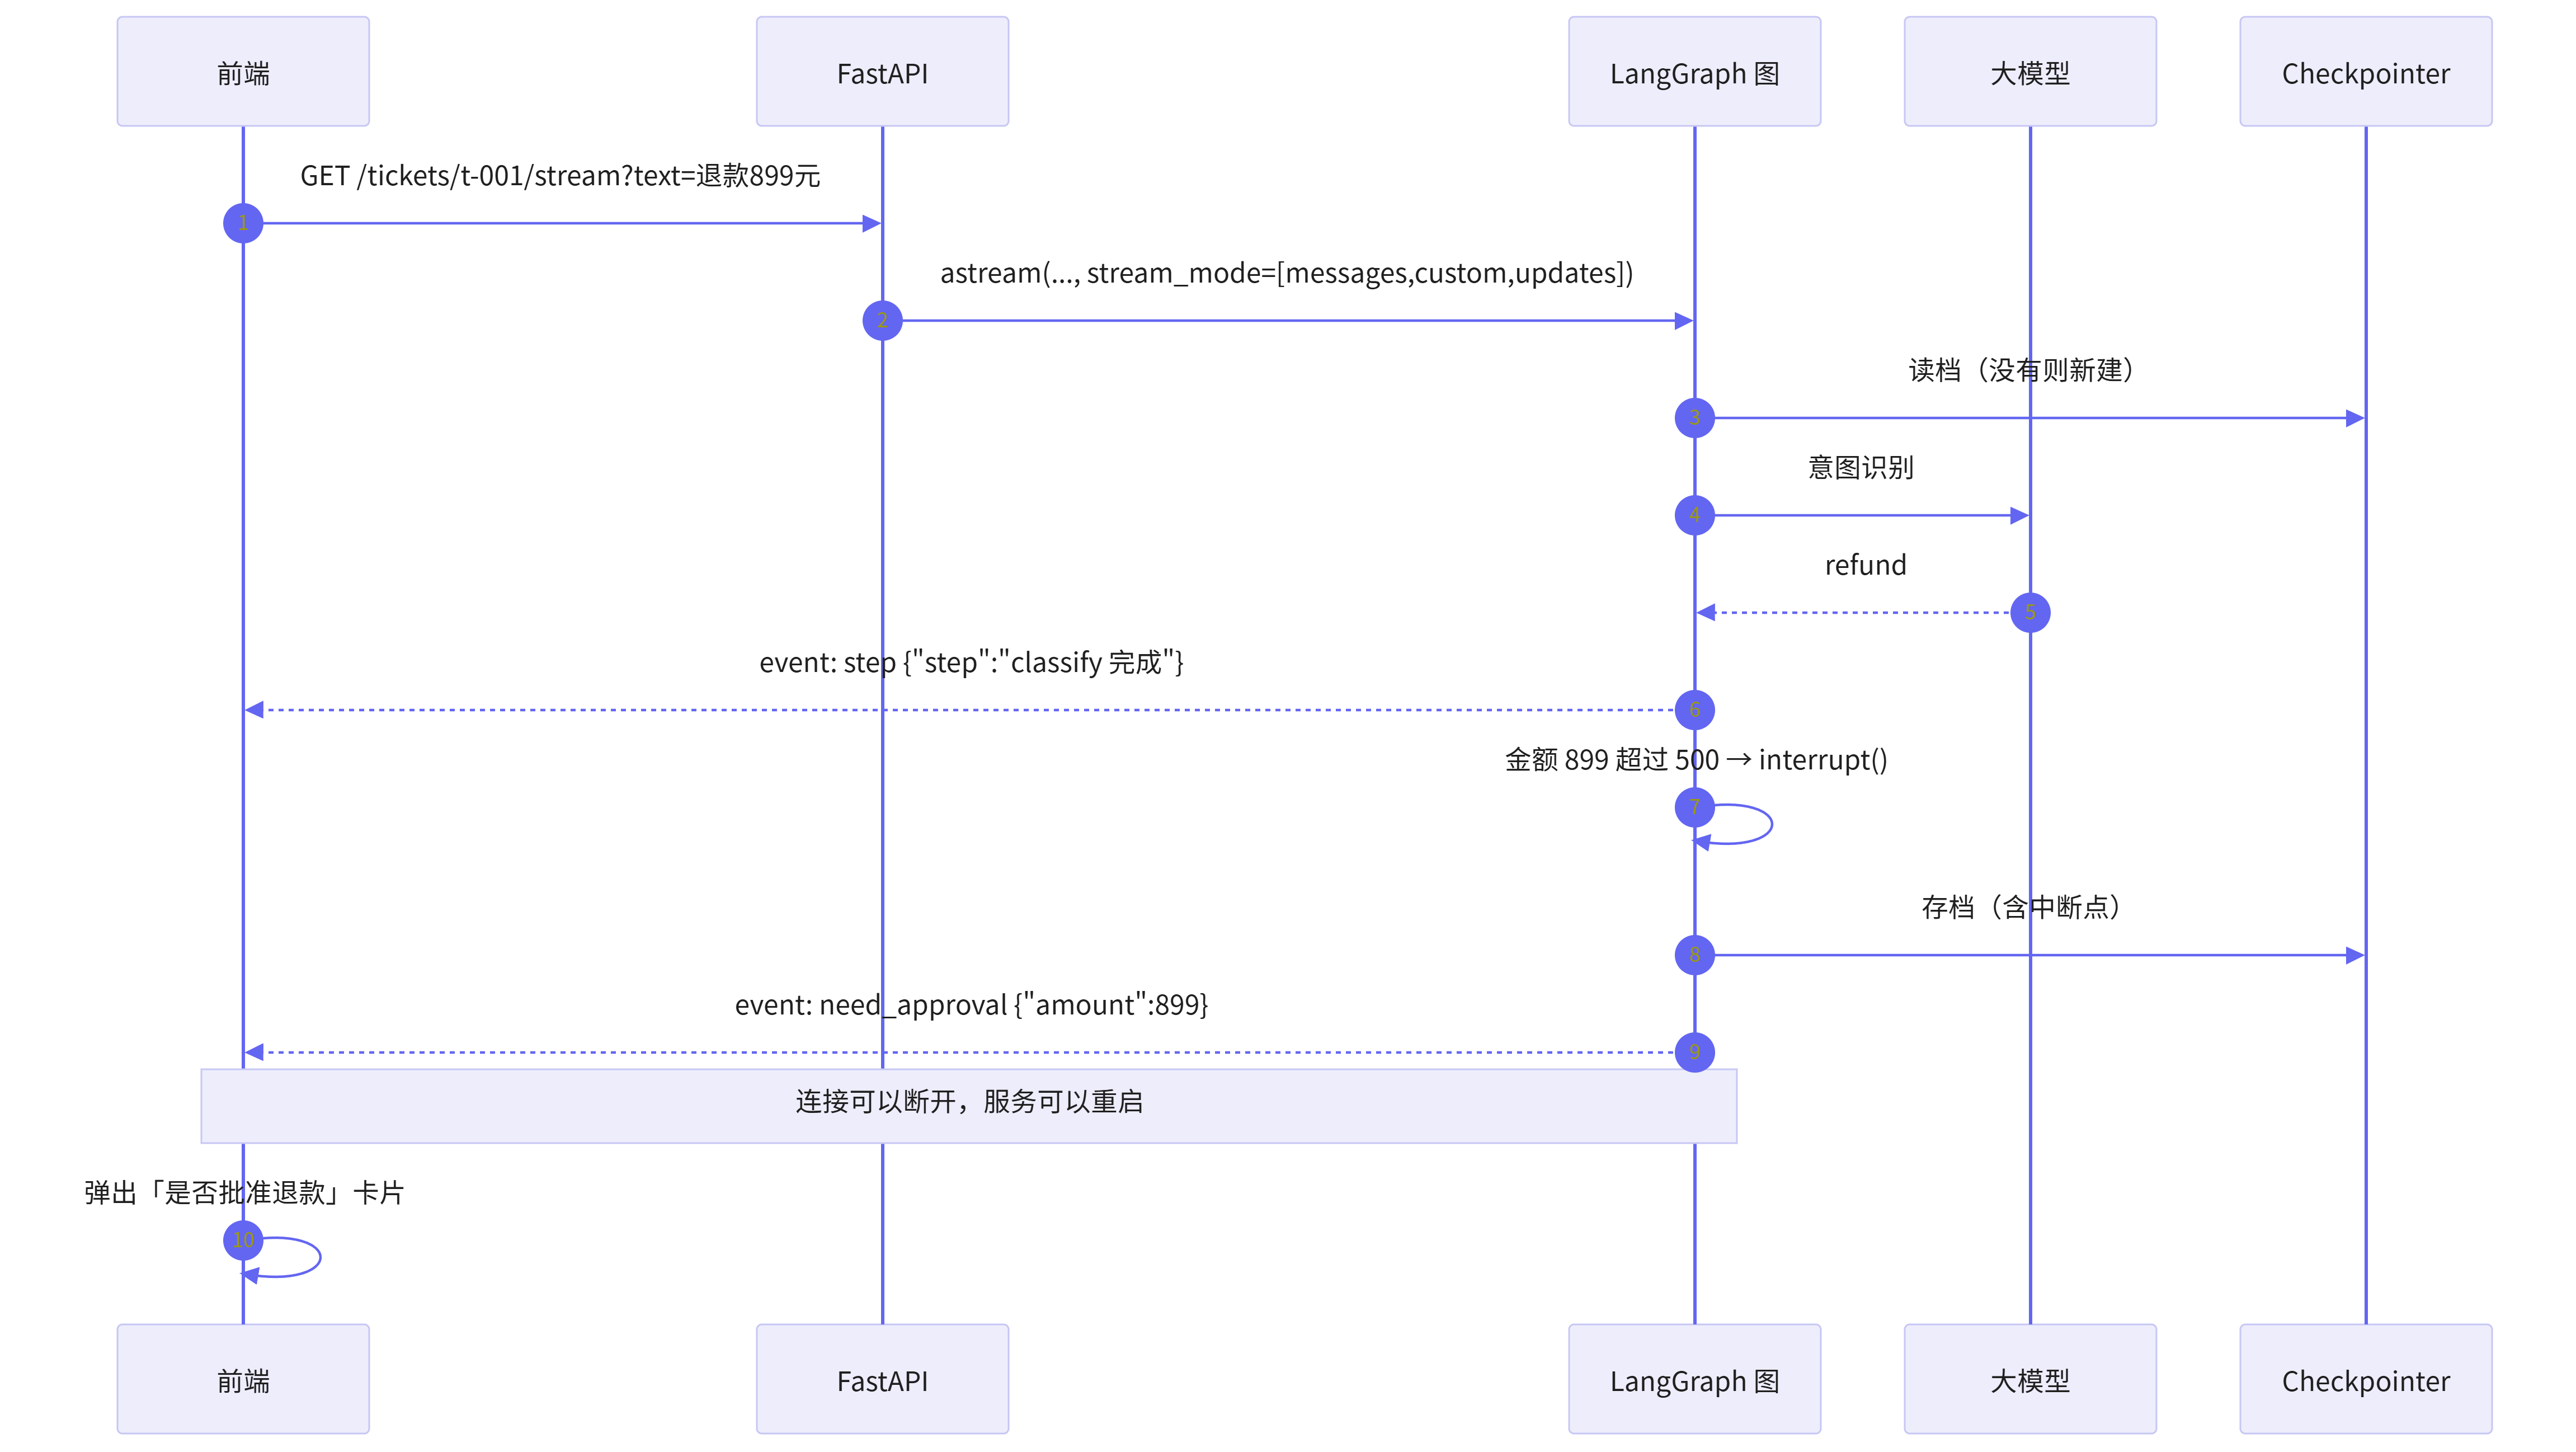
注意中间那句"连接可以断开"。SSE 只是为了让人看着舒服,它不承载状态。状态全在 Checkpointer 里,这就是后面断点续跑能成立的底气。
四、人工审批与断点续跑:一次请求变两次
interrupt() 挂起之后,图就停在那儿了。人要怎么把它唤醒?答案是再发一个请求,用 Command(resume=...) 把结果喂回去。
@app.post("/tickets/{thread_id}/approve")
async def approve(thread_id: str, body: ApproveIn):
    g = app.state.graph
    config = cfg(thread_id)

    # 先确认这个会话确实卡在审批上
    snap = await g.aget_state(config)
    if not snap.tasks or not any(t.interrupts for t in snap.tasks):
        raise HTTPException(409, "该工单当前不在审批等待中")

    result = await g.ainvoke(
        Command(resume={"approved": body.approved, "comment": body.comment}),
        config,
    )
    return {"final_answer": result.get("final_answer"), "approved": body.approved}
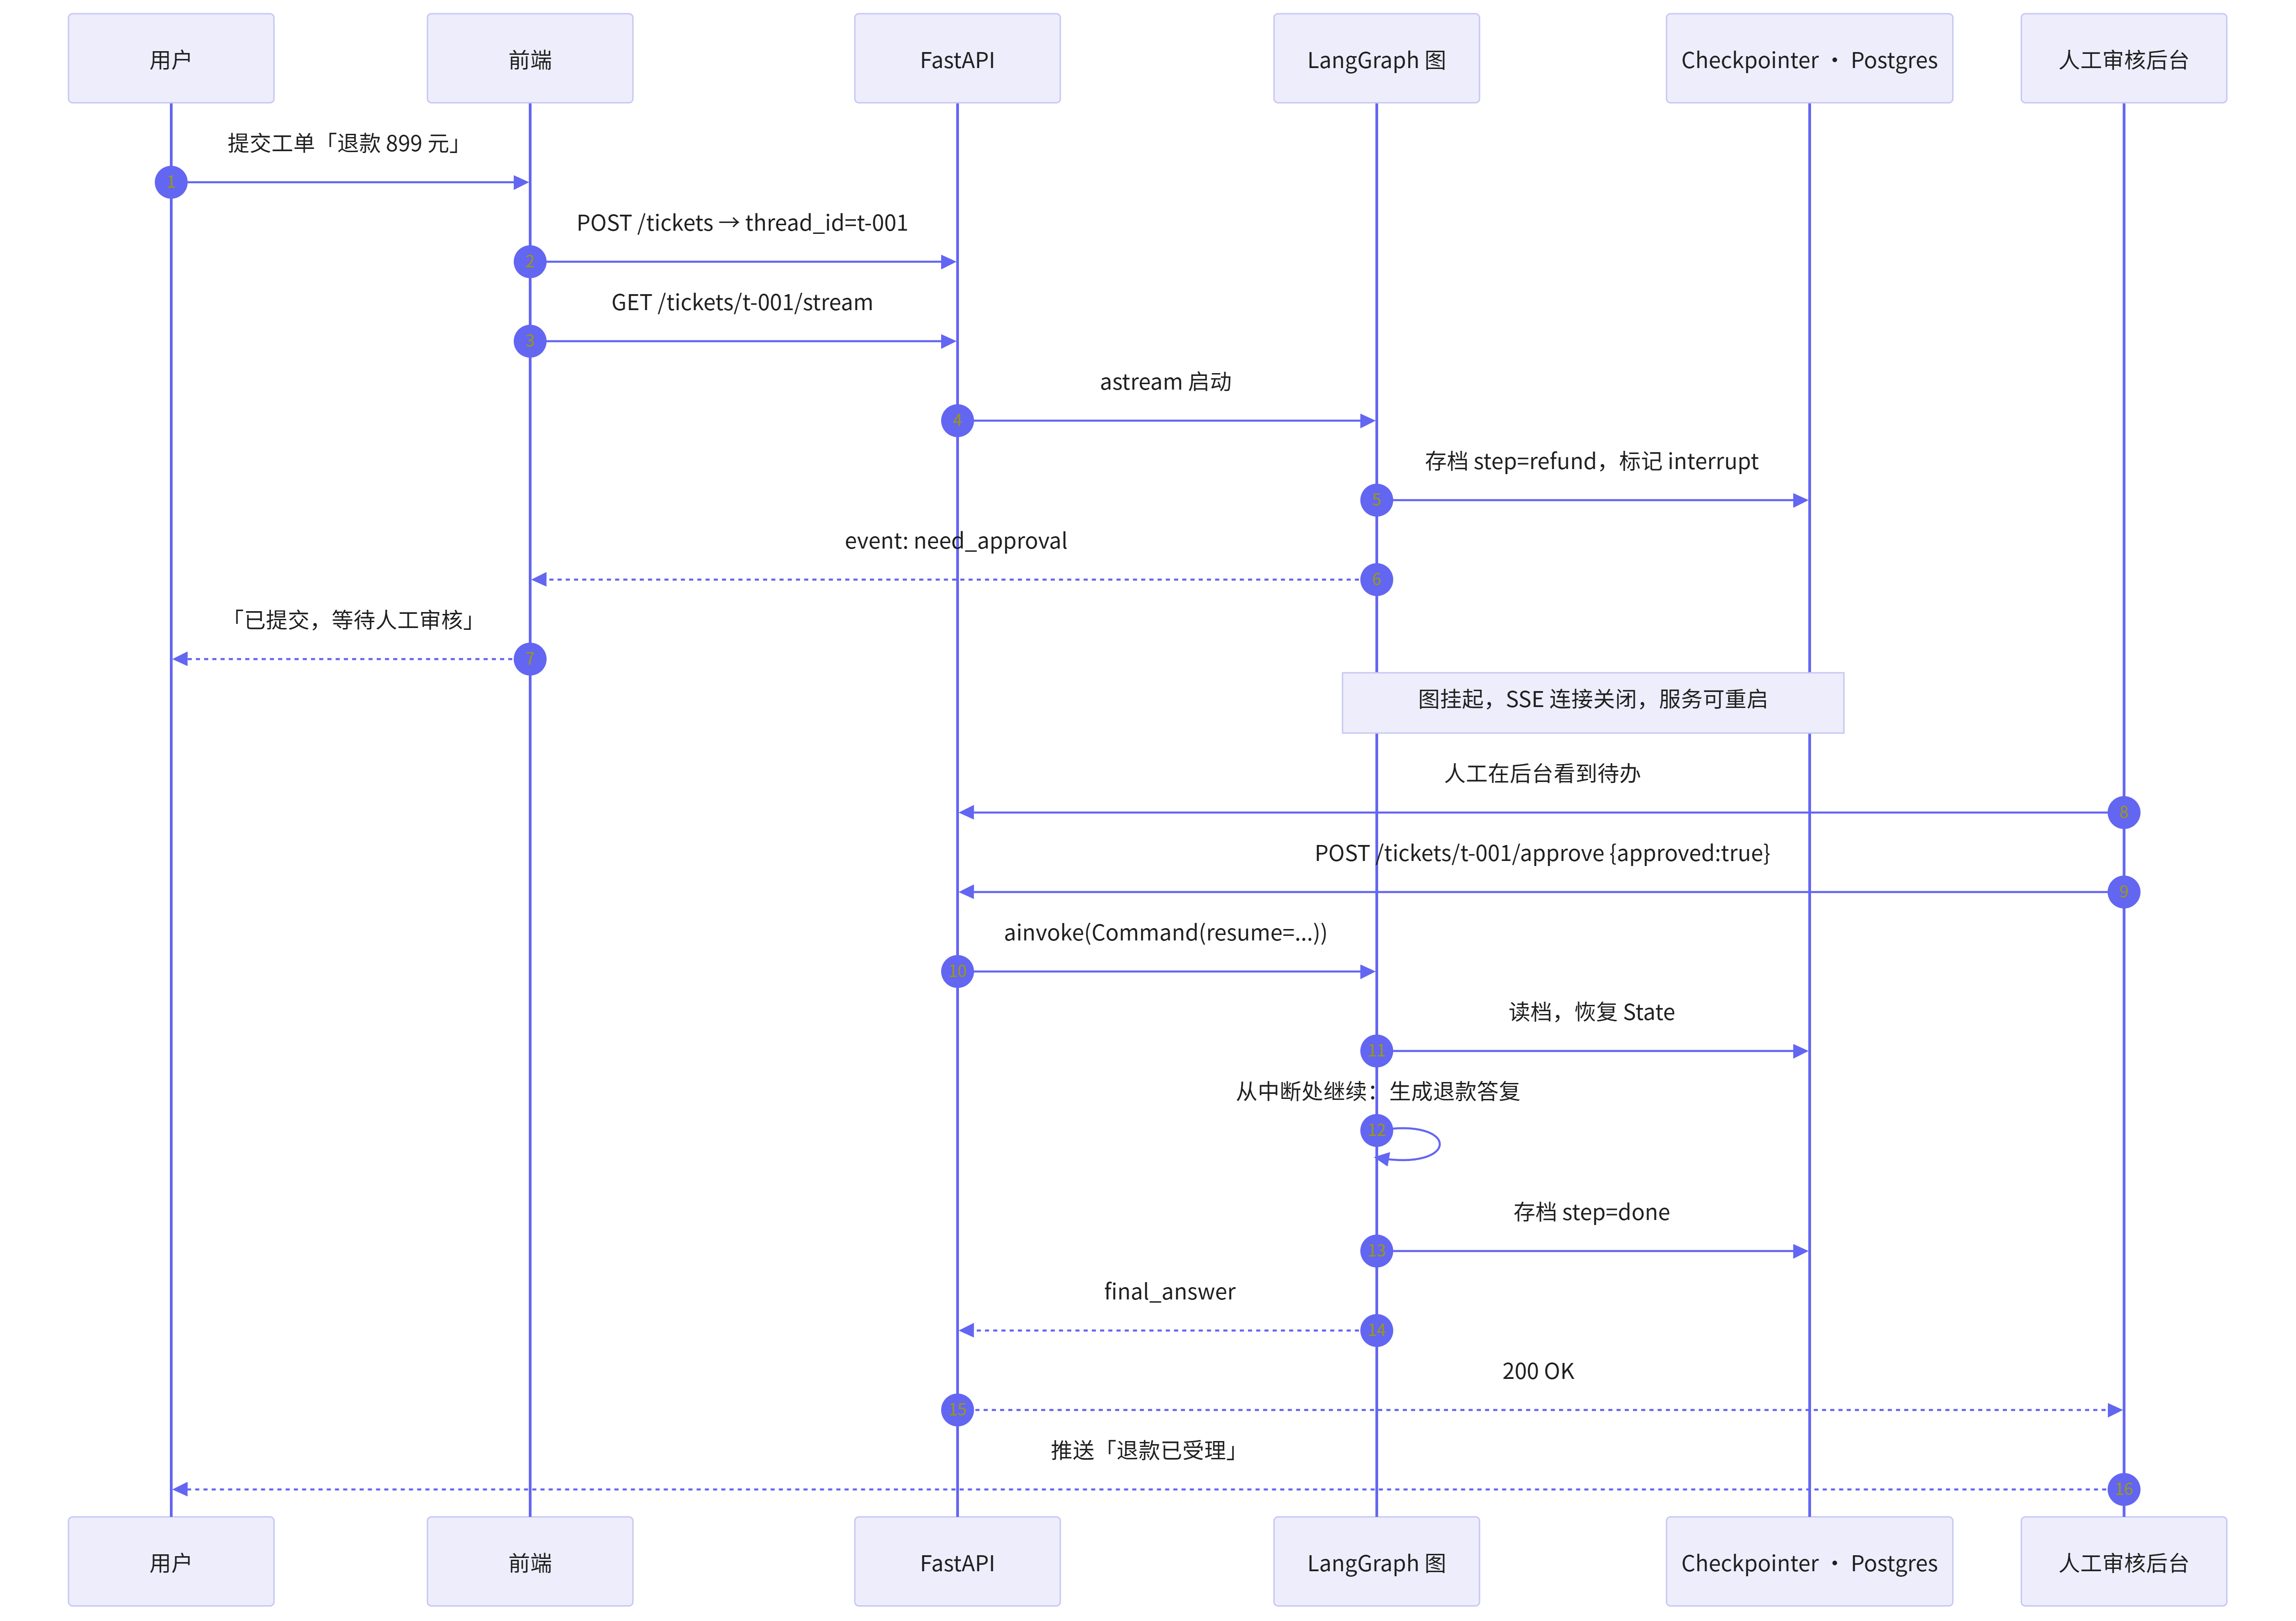
关键点有两个。一是 ainvoke 的第一个参数传的是 Command 而不是普通输入——这告诉框架"我不是新开一轮,我是接着上次的断点往下走"。二是 config 里的 thread_id 必须和之前完全一致,框架靠它去 Checkpointer 里找存档。
整个审批流程,把"人"这一环画进去会清楚很多:
顺带说个我觉得特别实用的接口——查当前状态。调试和做后台管理页面都靠它:
@app.get("/tickets/{thread_id}/state")
async def get_state(thread_id: str):
    snap = await app.state.graph.aget_state(cfg(thread_id))
    return {
        "values": snap.values,
        "next": snap.next,                       # 下一步要走哪些节点
        "waiting": bool(snap.tasks and any(t.interrupts for t in snap.tasks)),
}snap.next 是空的说明图跑完了;有值说明还在中途;配合 interrupts 就知道是"正常在跑"还是"卡着等审批"。后台运维页面拿这个字段一判断,所有工单的状态一目了然。
真要调试线上问题,aget_state_history(config) 能把这条会话的每一步存档全列出来,回退到任意一步改个参数重跑也行(LangGraph 的 time travel)。以前查 Agent 的 bug 只能加 print 重跑一遍,现在几分钟定位。
五、上线前必须处理的四件事
代码能跑不等于能上线。这几条是我踩完之后总结的,按重要性排。
1. 同一个会话别并发。 一个 thread_id 同时被两个请求 ainvoke,状态会打架。加把锁就行:
lock = get_lock(app, thread_id)
if lock.locked():
    raise HTTPException(429, "该会话正在处理中,请稍后再试")
async with lock:
    result = await g.ainvoke(Command(resume=...), config)
单机用 asyncio.Lock 够用;多副本部署得换成 Redis 分布式锁,不然锁了个寂寞。
2. Checkpointer 必须是外部存储。 前面提过,再强调一次:MemorySaver 只配待在开发环境。上 AsyncPostgresSaver,启动的时候调一次 setup() 建表,多个副本共享同一个库,谁接到请求都能接着跑。Redis 也可以,看你们运维更熟哪个。
3. 超时和兜底。 Agent 最怕的不是答错,是跑不完。我的做法是两个兜底都留着:State 里的 retry_count 到上限强制转人工(图内兜底),接口层再包一层超时(图外兜底)。LLM 那边也设 timeout,别让一次网络抖动把整个请求拖死。
4. 别用 --workers 1 硬扛。 有人为了让 MemorySaver 能用,干脆只起一个 worker。这等于放弃了并发能力,一个慢请求就把服务堵死。正确姿势就是换外部存储,然后该起几个 worker 起几个。
至于要不要用官方的 langgraph dev / LangGraph Platform 部署——我的看法是,如果你的服务就一个图、团队也不想维护后端,用官方那套挺省事,配个 langgraph.json 就完了。但现实里大多数情况是图要跟现有业务接口、权限体系、日志埋点缝在一起,那还是自己包 FastAPI 更灵活。这两条路不冲突,先想清楚你要的是"一个 Agent 服务"还是"业务系统里长了个 Agent 模块"。
回头看,LangGraph 和 FastAPI 这两边其实是在解决同一件事的不同半边:LangGraph 管的是"这件事该分几步、中间要不要停、停了怎么接着走",FastAPI 管的是"外面的人怎么触发它、怎么看到进展、服务挂了会不会丢"。
对不上的地方,基本都能归到三个词上——异步、流式、外部状态。把这三件事处理干净,剩下的就是普通后端开发的活儿:鉴权、限流、日志、监控。
如果你准备动手,建议按这个顺序来:先把图改成全 async 节点跑通,再接 SSE,再接 interrupt 审批回调,最后才换 Postgres checkpointer。每步都能单独验证,比一口气改完再 debug 舒服太多。
最直观的收益我给你个数:我们那个工单服务上线之后,客服侧的平均等待时间从原来的 40 多秒降到了 6 秒出头——不是因为 Agent 变快了,是因为用户能看到它在动了。流式输出这事,看着像锦上添花,实际是能不能用的分界线。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号