医疗RAG项目实战:Chunking分段、Hybrid Search混合检索、Rerank重排及溯源机制25.5
原创
医疗RAG项目实战:Chunking分段、Hybrid Search混合检索、Rerank重排及溯源机制25.5
原创
未闻花名
发布于 2026-10-15 10:36:08
发布于 2026-10-15 10:36:08
一、前言
做医疗RAG面临一个非常核心的难题,简直是极大的困扰:首先是模型幻觉不可控、输出内容不严谨、无法满足医疗合规要求。在实际业务场景中,很多医疗AI产品经常出现错配诊疗方案、误荐药品用量、沿用过时医学标准、混淆相似病症知识点等问题,不仅无法辅助医患决策,还存在极高的业务风险与安全隐患,成为医疗大模型项目上线、实践应用的的很大阻碍。
目前行业内多数医疗项目均采用通用RAG架构适配医疗场景,通过简单文本分段、基础向量检索实现知识库问答,但这套通用方案完全适配不了医疗垂直领域的高严谨性要求。通用RAG粗暴的固定长度分段、单一向量检索、无权威筛选、无溯源校验的链路设计,会导致医学知识碎片化、精准召回率低、劣质内容混入、回答无法溯源等一系列问题,无法从根源解决模型幻觉,也是多数医疗AI项目效果差、无法正式上线、频繁迭代优化却无明显提升的核心原因。
二、医疗RAG核心痛点
1. 知识碎片化严重
医学知识具备极强的结构化、关联性特征,通用Chunking分段方式会直接破坏知识完整性,催生隐性幻觉,具体问题集中在两点:
- 知识逻辑割裂:疾病、症状、病因、用药、禁忌等知识点环环相扣,通用固定长度切割,会将同一诊疗体系的关联内容拆分至不同片段。例如把高血压病因与用药禁忌截断分离,模型仅能读取局部信息,最终输出片面、逻辑矛盾的医学结论。
- 文本适配性缺失:医疗文本类型多样,包含诊疗指南、病历记录、学术论文、药品说明书等,各类文本结构、层级、表述逻辑差异极大。通用分段无视文本格式差异,不区分层级结构,导致医学知识碎片化、可用性大幅降低。
2. 单一检索精度不足
多数基础RAG仅依赖向量相似度检索,无法适配医疗场景的专业检索需求,召回准确率低、噪声较多,核心缺陷分为两点:
- 专业术语匹配偏差:医疗场景存在大量专业术语、英文缩写、同义表述,向量检索仅依靠语义相似度匹配,极易出现“语义相近、核心不符”的误召回。例如检索“心梗急救方案”,容易匹配到相似度极高但诊疗逻辑不同的“心绞痛诊疗方案”。
- 精准关键词能力缺失:向量检索擅长模糊语义理解,但无法精准匹配药品名称、疾病编码、手术名称、专项诊疗术语等精准信息。缺少稀疏关键词检索能力,导致大量精准权威内容漏召回、无关低质内容混入,为模型幻觉提供了生成空间。
3. 检索排序逻辑粗放
基础RAG仅依靠向量相似度分数排序,无医疗专属排序规则,无法区分检索内容的质量与权威性,直接影响生成答案的准确性,核心问题有两点:
- 权威权重倒置:相似度分数无法判别内容来源等级,常常出现普通科普、过时文献、个人经验类内容,排序高于国家级诊疗指南、药典标准、三甲诊疗规范的情况。模型优先采信低权威内容,极易输出错误医学结论。
- 无二次降噪机制:单次检索召回的结果混杂大量噪声内容,基础RAG无重排精筛环节,无法过滤无效、过时、低匹配度片段,劣质内容持续流入大模型上下文,持续放大幻觉风险。
4. 无溯源校验机制
溯源缺失是医疗RAG最致命的短板,也是无法满足医疗零幻觉、合规化落地的核心原因,具体痛点体现在三方面:
- 内容真伪无法校验:通用RAG生成的回答无任何原始知识库关联,用户无法核对医学结论的真实性、准确性,无法区分内容是权威标准还是模型编造。
- 不符合医疗合规要求:临床辅助、医疗问诊、智能诊疗等场景,对内容溯源、审计留痕有强制规范,无溯源依据的回答不具备任何落地使用价值。
- 问题无法迭代整改:当模型输出错误医学内容时,无溯源链路就无法定位错误知识来源,无法针对性修正知识库、优化模型,形成长期的幻觉隐患。
三、整体架构设计
针对以上医疗场景专属痛点,我们摒弃通用RAG的极简架构,搭建一套医疗垂直领域高精度、可溯源、零幻觉RAG检索链路,整体架构分为四层,全链路闭环,核心包含数据预处理层、检索召回层、重排精筛层、生成溯源层,全程针对医学知识特性优化。
1. 数据预处理层
该层级为医疗RAG源头核心,主打解决知识碎片化、保障知识质量,彻底替代通用固定长度分段方案,核心能力:
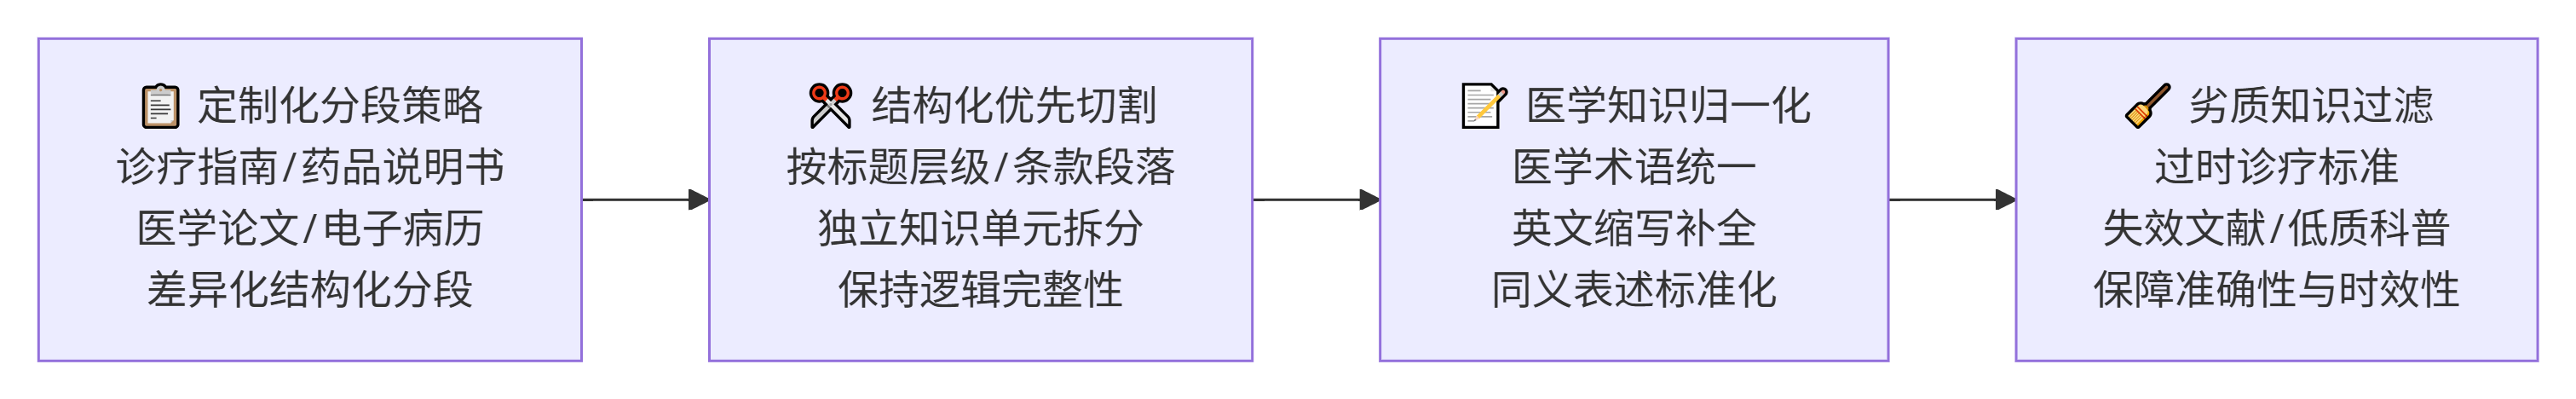
- 定制化分段策略:针对诊疗指南、药品说明书、医学论文、电子病历四类核心医疗文本,制定差异化结构化分段规则,适配不同医疗文本的专属结构特征。
- 结构化优先切割:摒弃固定字符切割方式,优先按照文档标题层级、条款段落、独立知识单元拆分,保证单条知识逻辑完整、不割裂诊疗关联。
- 医学知识归一化:自动完成医学术语统一、英文缩写补全、同义医学表述标准化处理,规避术语不统一导致的检索偏差。
- 劣质知识过滤:自动清洗过时诊疗标准、失效文献、低质科普内容,从源头保证知识库的完整性、准确性、时效性。
2. 检索召回层
搭建稠密+稀疏双路混合检索体系,弥补单一检索的能力缺陷,最大化提升有效知识召回率,两路检索分工明确、互补增效:
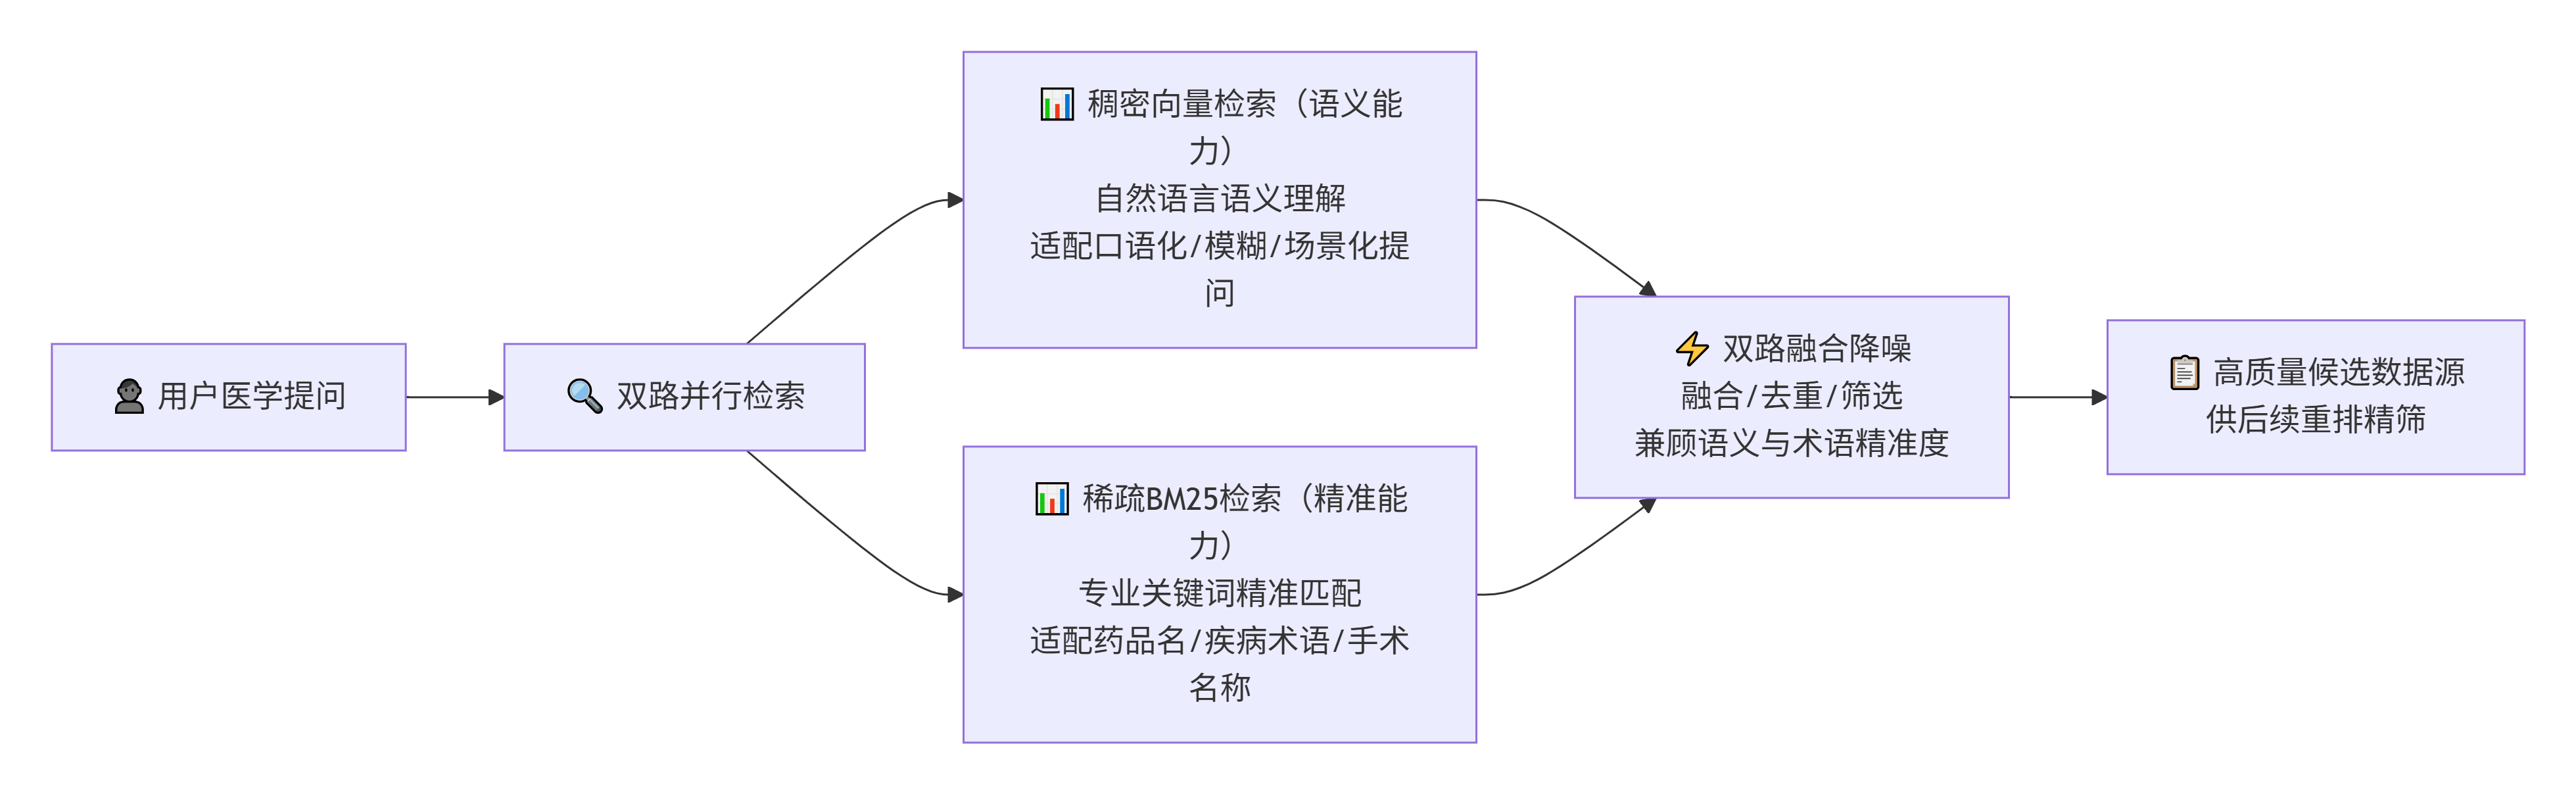
- 稠密向量检索(语义能力):主打自然语言语义理解,适配用户口语化问诊、模糊医学咨询、场景化医疗提问,解决关键词检索无法理解语义意图的问题。
- 稀疏BM25检索(精准能力):主打专业关键词精准匹配,适配药品名称、疾病术语、手术名称、医学编码、诊疗专项标准等高精度检索场景。
- 双路融合降噪:对两路检索结果做融合、去重、筛选,兼顾语义适配度与术语精准度,大幅减少无关噪声内容,为后续重排精筛提供高质量候选数据源。
3. 重排精筛层
依托医疗专属微调重排模型,实现检索结果二次精准过滤,从中间链路杜绝幻觉生成,核心优化逻辑:
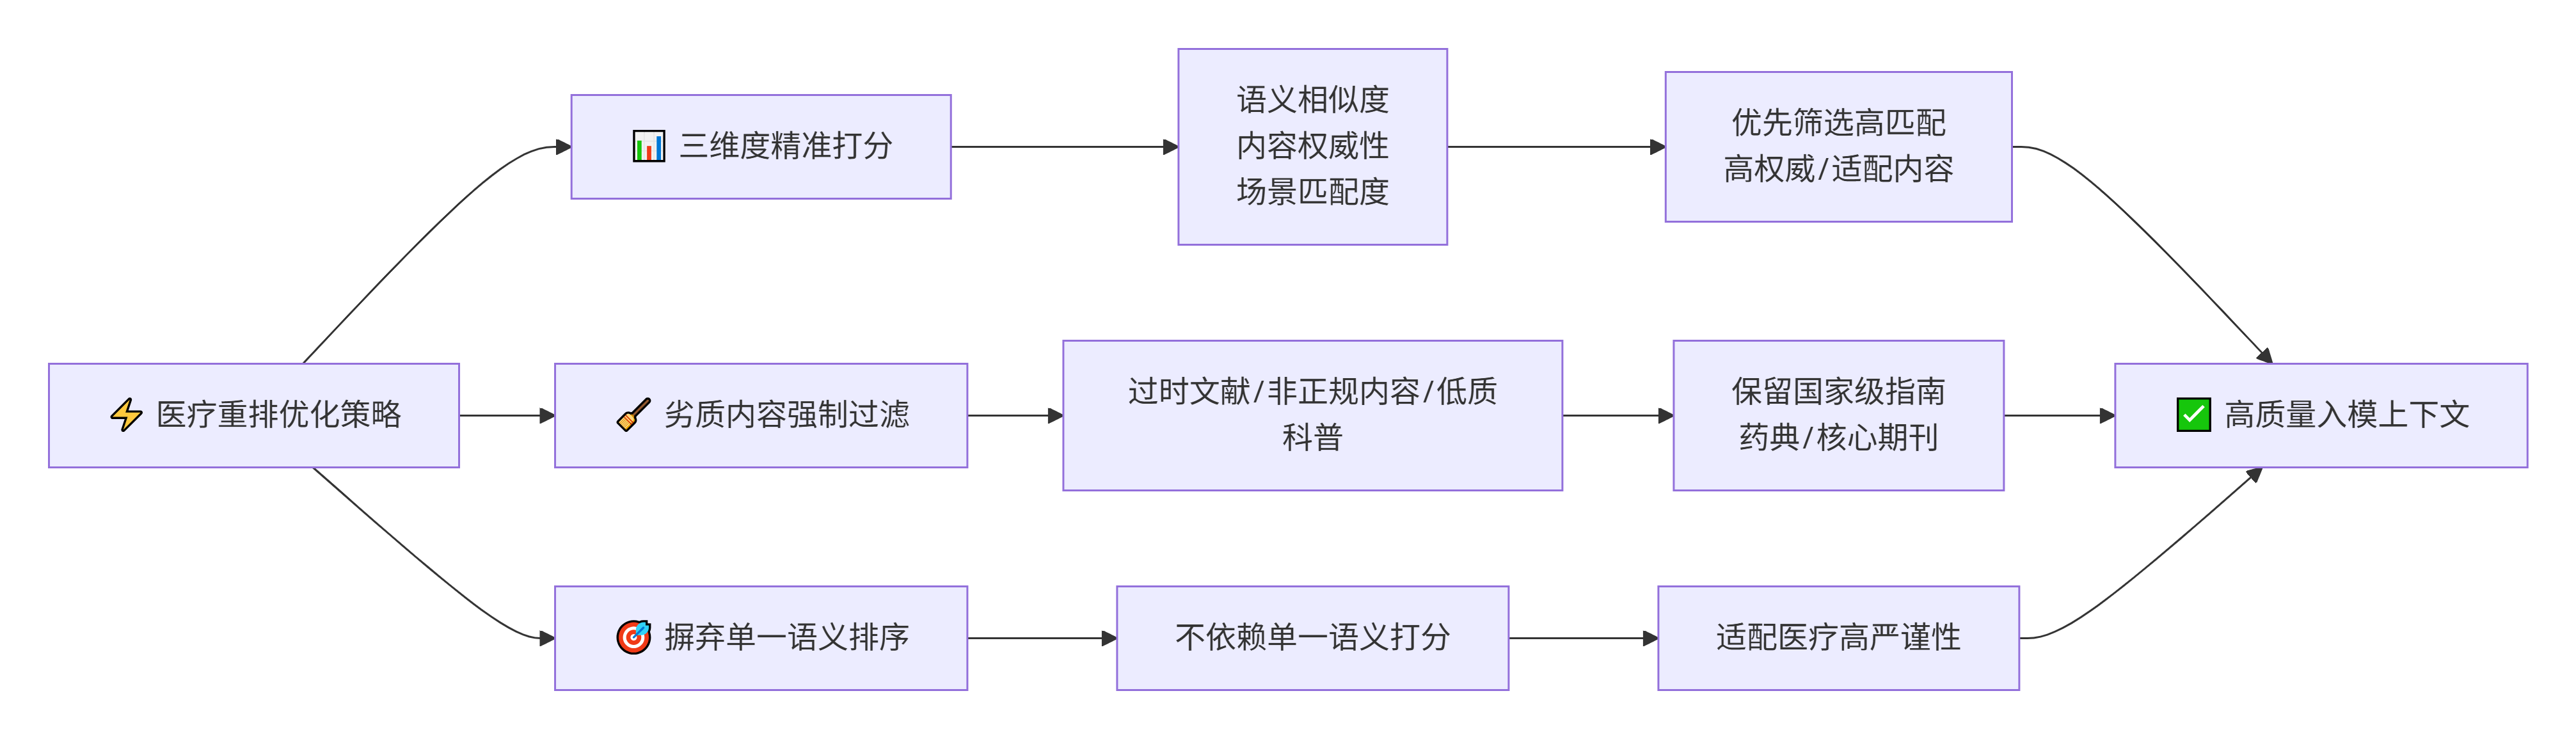
- 摒弃通用排序逻辑:不依赖单一语义相似度打分,适配医疗场景高严谨性要求,构建多维度综合评价体系。
- 三维度精准打分:结合语义相似度、内容权威性、场景匹配度三重维度打分,优先筛选贴合用户问题、来源权威、适配应用场景的知识片段。
- 劣质内容强制过滤:自动过滤过时文献、小众非正规医疗内容、低权威科普噪声,保留国家级指南、药典、权威教材、核心期刊等高价值内容,大幅提升入模上下文质量。
4. 生成溯源层
作为零幻觉、可合规的最终保障,构建全链路溯源机制,实现回答可校验、可追溯、可审计,核心能力包含三点:
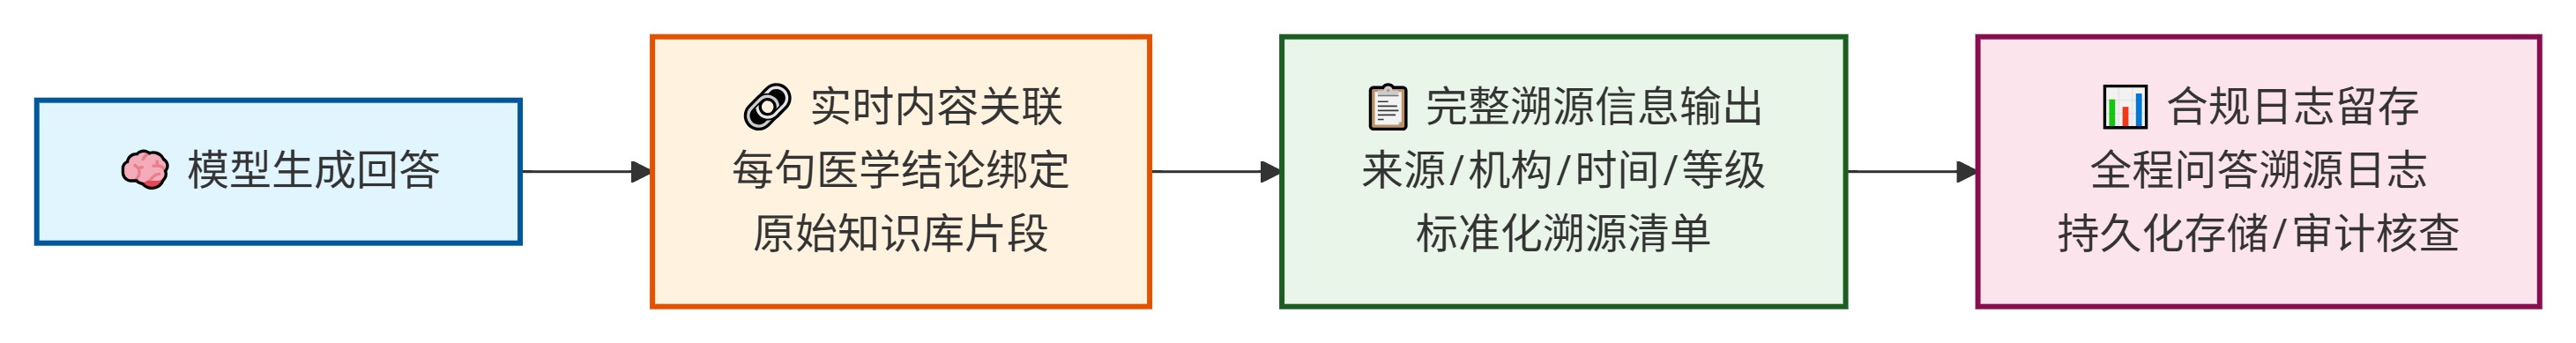
- 实时内容关联:模型生成回答过程中,自动将每一句医学结论与原始知识库片段绑定,精准定位数据源,避免笼统文档溯源。
- 完整溯源信息输出:自动附带片段来源、发布机构、发布时间、权威等级等元数据,形成标准化溯源清单,支持人工校验核对。
- 合规日志留存:全程留存问答溯源日志,支持后台持久化存储、审计核查、问题追溯,完全满足医疗行业合规监管要求。
四、医学Chunking分段优化
Chunking作为RAG的源头环节,直接决定知识库质量,是医疗RAG零幻觉落地的基础。通用固定长度分段(512/1024字符)完全不适配医疗文本,会割裂诊疗逻辑、拆分关联知识点,是多数医疗RAG效果差、易幻觉的核心原因。
1. 通用分段核心缺陷
通用固定滑动窗口Chunking方案,完全不适配医疗文本结构与医学逻辑,是医疗RAG幻觉频发的核心源头,具体缺陷:
- 割裂医学知识逻辑:无视文本语义与知识关联,粗暴固定长度切割,经常出现完整诊疗流程、药品用法与禁忌、病因与并发症被截断拆分的问题,导致知识碎片化。
- 引发模型断章取义:模型读取碎片化、不完整的医学知识,无法构建完整诊疗逻辑,极易出现知识混淆、片面解读、逻辑矛盾等隐性幻觉问题。
- 无权威筛选能力:通用分段不区分文本来源与权威等级,过时文献、低质科普、非正规医疗内容与权威指南混合入库,从源头混入大量劣质知识。
2. 医疗专属分段规则
结合医疗文本强结构化、高关联特性,设计结构化拆分+语义补齐+边界保护的专属分段策略,三大核心规则层层兜底:
- 层级优先拆分:针对指南、教材、说明书等带层级标题的文档,以一级标题、二级标题、独立条款为最小单元拆分,严格保留原生知识结构,不破坏诊疗体系。
- 语义自适应补齐:单条知识单元过短时,自动关联同层级关联内容补齐,保证知识完整性;内容过长时,仅在语义弱分割点拆分,杜绝核心知识点截断。
- 医疗核心边界保护:对药品用法用量、诊疗步骤、禁忌症、适应症、急救方案等高敏感核心内容,设置强制保护规则,完整留存、禁止截断拆分。
3. 三段式专属分段策略
针对医疗文本强结构化、高关联特性,以"结构化拆分+语义补齐+边界保护"三段式策略实现专属分段:按层级标题切分基础单元,过短残句挂起按句补齐,超长片段回退句界软切分,不切断句子、不拆散医学术语,保证片段语义完整。
策略设计:
- ① 结构化拆分 split_by_structure:利用医疗文档强结构化特点,按层级标题(1.、3.1)和条款标识(①②③)切分基础单元,保留原始逻辑结构。
- ② 语义补齐 semantic_completion:针对高关联特性:过短且句子不完整的片段不独立成块,放入"语义挂起区"(pending),与后续内容合并补齐,直到以句号/分号等结束符收尾才落块,避免产生残缺语义片段。
- ③ 边界保护 boundary_protect:超长片段不硬切字符,而是退回到句子边界(_split_sentences按 。;;!? 切分)再软切分,保证不切断句子、不拆散"钙通道阻滞剂"这类专业术语。
chunk()按“结构化拆分 → 语义补齐 → 边界保护”的顺序串联执行,测试入口也改为分阶段打印,直观展示每步策略效果。
import re
from typing import List

# 医疗文本层级化语义Chunking工具类
# 针对医疗文本强结构化、高关联特性,设计"结构化拆分 + 语义补齐 + 边界保护"专属分段策略:
#   ① 结构化拆分:按医学文档层级标题、条款标识切分基础单元,保留原始逻辑结构
#   ② 语义补齐  :过短且句子不完整的片段不独立成块,挂起并与后续内容按句补齐,避免残缺语义
#   ③ 边界保护  :超长片段按句子边界回退软切分,不硬切句子、不拆散医学专业术语
class MedicalChunking:
    def __init__(self, max_chunk_size: int = 800, min_chunk_size: int = 50):
        self.max_chunk_size = max_chunk_size  # 医疗片段最大长度
        self.min_chunk_size = min_chunk_size  # 医疗片段最小长度
        # 匹配医学文档层级标题(如 "1." "3.1")、条款(如 "①②③")
        self.title_pattern = re.compile(r"^(\d+\.){0,3}\s*.+")
        self.clause_pattern = re.compile(r"^[①②③④⑤⑥⑦⑧⑨⑩]\s*.+")
        # 医学句子结束符(句号、分号、感叹号、问号)
        self.sentence_end_pattern = re.compile(r"[。;;!?]$")

    # ① 结构化拆分:按医学文档层级标识拆分基础单元
    def split_by_structure(self, text: str) -> List[str]:
        lines = text.split("\n")
        chunks = []
        temp_chunk = []

        for line in lines:
            line = line.strip()
            if not line:
                continue
            # 识别新标题/新条款,切割新片段
            if self.title_pattern.match(line) or self.clause_pattern.match(line):
                if temp_chunk:
                    chunks.append(" ".join(temp_chunk))
                    temp_chunk = []
                temp_chunk.append(line)
            else:
                temp_chunk.append(line)
        # 加入最后一个片段
        if temp_chunk:
            chunks.append(" ".join(temp_chunk))
        return chunks

    # 按句子边界切分(边界保护的基础能力)
    def _split_sentences(self, chunk: str) -> List[str]:
        sentences = re.split(r"(?<=[。;;!?])\s*", chunk.strip())
        return [s for s in sentences if s]

    # ② 语义补齐:过短且句子不完整的片段挂起,与后续内容合并补齐
    def semantic_completion(self, chunks: List[str]) -> List[str]:
        completed = []
        pending = ""  # 待补齐的短片段(语义挂起区)
        for chunk in chunks:
            if pending:
                chunk = pending + chunk  # 补齐合并,恢复完整语义
                pending = ""
            # 片段过短且未以句子结束符收尾 → 语义不完整,挂起等待补齐
            if len(chunk) < self.min_chunk_size and not self.sentence_end_pattern.search(chunk):
                pending = chunk
            else:
                completed.append(chunk)
        if pending:
            completed.append(pending)
        return completed

    # ③ 边界保护:超长片段按句子边界软切分,不硬切句子、不拆散术语
    def boundary_protect(self, chunks: List[str]) -> List[str]:
        protected = []
        for chunk in chunks:
            if len(chunk) <= self.max_chunk_size:
                protected.append(chunk)
                continue
            # 超长片段:退回到句子边界再切分,避免语义割裂
            sentences = self._split_sentences(chunk)
            buffer = ""
            for sent in sentences:
                if len(buffer) + len(sent) <= self.max_chunk_size:
                    buffer += sent
                else:
                    if buffer:
                        protected.append(buffer.strip())
                    buffer = sent
            if buffer:
                protected.append(buffer.strip())
        return protected

    # 完整分段流程:结构化拆分 → 语义补齐 → 边界保护
    def chunk(self, medical_text: str) -> List[str]:
        struct_chunks = self.split_by_structure(medical_text)
        completed_chunks = self.semantic_completion(struct_chunks)
        final_chunks = self.boundary_protect(completed_chunks)
        return final_chunks

# 测试医疗文本分段(高血压诊疗指南片段)
if __name__ == "__main__":
    test_text = """1. 高血压病因
    高血压的病因分为原发性与继发性两类。原发性高血压无明确病因,与遗传、饮食、作息、情绪密切相关。
    2. 高血压临床表现
    早期高血压无明显症状,部分患者会出现头晕、头痛、乏力等症状,长期高血压可引发心脑血管并发症。
    3. 基础治疗方案
    3.1 生活干预:低盐饮食、规律运动、戒烟限酒、控制体重。
    3.2 药物治疗:常用降压药包括利尿剂、钙通道阻滞剂等,需遵医嘱服用,禁止擅自停药。"""
    chunker = MedicalChunking()

    print("① 结构化拆分:按层级标题切分基础单元")
    struct_chunks = chunker.split_by_structure(test_text)
    for i, c in enumerate(struct_chunks):
        print(f"   基础单元{i+1}({len(c)}字):{c[:45]}...")

    print("\n② 语义补齐:过短片段挂起合并,保证语义完整")
    completed = chunker.semantic_completion(struct_chunks)
    for i, c in enumerate(completed):
        print(f"   补齐片段{i+1}({len(c)}字):{c[:45]}...")

    print("\n③ 边界保护 + 最终结果:超长片段按句回退切分")
    result = chunker.chunk(test_text)
    for idx, res in enumerate(result):
        print(f"   片段{idx+1}({len(res)}字):{res}")
        print(f"   片段长度:{len(res)}\n")
输出结果:
① 结构化拆分:按层级标题切分基础单元 基础单元1(8字):1. 高血压病因... 基础单元2(47字):高血压的病因分为原发性与继发性两类。原发性高血压无明确病因,与遗传、饮食、作息、情绪密切相... 基础单元3(10字):2. 高血压临床表现... 基础单元4(46字):早期高血压无明显症状,部分患者会出现头晕、头痛、乏力等症状,长期高血压可引发心脑血管并发症... 基础单元5(9字):3. 基础治疗方案... 基础单元6(29字):3.1 生活干预:低盐饮食、规律运动、戒烟限酒、控制体重。... 基础单元7(42字):3.2 药物治疗:常用降压药包括利尿剂、钙通道阻滞剂等,需遵医嘱服用,禁止擅自停药。... --------------------------------------------------------------------------------------------------- ② 语义补齐:过短片段挂起合并,保证语义完整 补齐片段1(55字):1. 高血压病因高血压的病因分为原发性与继发性两类。原发性高血压无明确病因,与遗传、饮食、... 补齐片段2(56字):2. 高血压临床表现早期高血压无明显症状,部分患者会出现头晕、头痛、乏力等症状,长期高血压... 补齐片段3(38字):3. 基础治疗方案3.1 生活干预:低盐饮食、规律运动、戒烟限酒、控制体重。... 补齐片段4(42字):3.2 药物治疗:常用降压药包括利尿剂、钙通道阻滞剂等,需遵医嘱服用,禁止擅自停药。... --------------------------------------------------------------------------------------------------- ③ 边界保护 + 最终结果:超长片段按句回退切分 片段1(55字):1. 高血压病因高血压的病因分为原发性与继发性两类。原发性高血压无明确病因,与遗传、饮食、作息、情绪密切相关。 片段长度:55 片段2(56字):2. 高血压临床表现早期高血压无明显症状,部分患者会出现头晕、头痛、乏力等症状,长期高血压可引发心脑血管并发症。 片段长度:56 片段3(38字):3. 基础治疗方案3.1 生活干预:低盐饮食、规律运动、戒烟限酒、控制体重。 片段长度:38 片段4(42字):3.2 药物治疗:常用降压药包括利尿剂、钙通道阻滞剂等,需遵医嘱服用,禁止擅自停药。 片段长度:42
4. 应用实践细节说明
生产环境中需针对不同医疗文本做差异化适配,同时设置统一阈值规范,核心落地细节:
- 药品说明书专属拆分:固定按【适应症、用法用量、禁忌、不良反应、注意事项】五大核心模块拆分,保证药品知识分类清晰、无遗漏。
- 病历与指南差异化处理:电子病历按主诉、现病史、既往史、辅助检查、诊断结论结构化分段;医学指南严格保留层级条款,禁止跨层级合并内容。
- 长度阈值管控:核心诊疗知识片段最长不超过800字符,最短不低于200字符,在保证知识完整的前提下,避免内容冗余,提升检索精准度。
五、Hybrid Search混合检索
完成优质Chunking分段后,检索召回环节决定了能否找到精准权威的医学知识。单一向量检索或关键词检索都无法满足医疗场景需求,本文采用BM25稀疏检索+稠密向量检索双路混合检索方案,兼顾精准匹配与语义理解,大幅提升医疗知识召回准确率,从链路中层减少幻觉来源。
1. 单一检索方案短板
向量检索与BM25关键词检索单独使用,均无法适配复杂医疗查询场景,各自存在明显短板:
- 稠密向量检索短板:擅长自然语言语义理解,适配模糊问诊,但对专业术语、精准名词匹配能力弱,易出现“语义相似、核心不符”的误召回,如将头孢过敏方案匹配为青霉素过敏方案。
- 稀疏BM25检索短板:依托关键词精准匹配,适配医疗专有名词、药品、疾病名称检索,但无语义理解能力,对口语化、模糊化的用户医疗问句召回效果极差。
- 单一检索共性问题:无法兼顾语义理解与精准匹配,要么漏召权威精准内容,要么误召无关噪声内容,无法满足医疗高精度检索需求。
2. 混合检索核心原理
采用双路召回、分数归一、加权融合、去重排序四步核心逻辑,完美兼顾精准度与语义能力,具体流程:
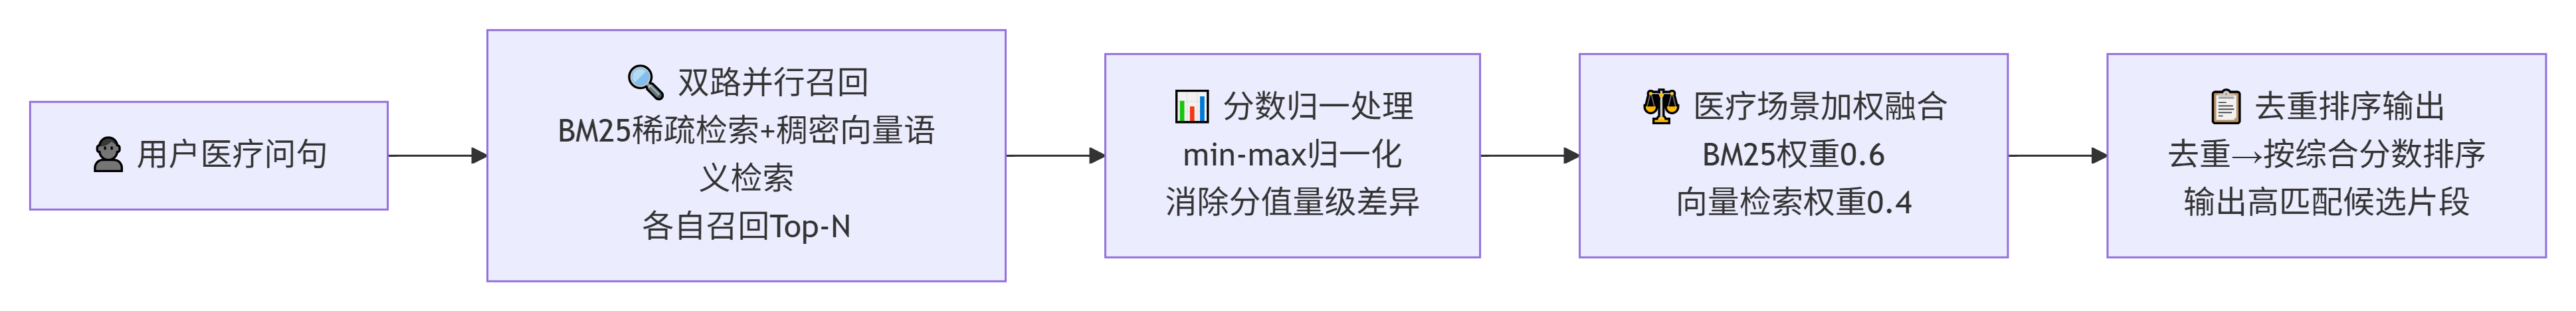
- 双路并行召回:对同一用户医疗问句,同时执行BM25稀疏关键词检索与稠密向量语义检索,分别召回Top-N候选片段,最大化覆盖有效知识。
- 分数归一处理:对两路检索的分数做min-max归一化,消除不同检索算法的分值量级差异,保证分数可对比、可融合。
- 医疗场景加权融合:采用BM25权重0.6、向量检索权重0.4的适配配比,优先保障专业术语精准匹配,同时兼顾语义理解能力,贴合医疗场景特性。
- 去重排序输出:对融合结果去重、按综合分数排序,筛选出高匹配、高精准的候选片段,为后续重排提供优质数据源。
3. 双路混合检索示例
结合BM25关键词匹配与向量语义匹配,构建医疗混合检索工具:先按权重0.6/0.4双路检索并归一化,再去重加权融合排序输出TopN,兼顾术语精准命中与语义相关召回,适合医疗知识库问答场景。
import numpy as np
from rank_bm25 import BM25Okapi
from sentence_transformers import SentenceTransformer
from modelscope import snapshot_download
from typing import List, Dict

# 医疗混合检索工具类
class MedicalHybridSearch:
    def __init__(self):
        cache_dir = "D:\\modelscope\\hub"
        # 加载Embedding模型用于语义匹配
        embedding_model_dir = snapshot_download(
            model_id="sentence-transformers/all-MiniLM-L6-v2",
            cache_dir=cache_dir,
            revision="master"
        )

        # 加载医疗适配向量模型
        self.vec_model = SentenceTransformer(embedding_model_dir)
        self.bm25 = None
        self.corpus = []
        self.tokenized_corpus = []

    def build_corpus(self, chunks: List[str]):
        # 构建检索语料库
        self.corpus = chunks
        # BM25分词处理(简易医疗分词)
        self.tokenized_corpus = [chunk.split() for chunk in chunks]
        self.bm25 = BM25Okapi(self.tokenized_corpus)
        # 预计算向量库
        self.corpus_embeds = self.vec_model.encode(chunks)

    def bm25_search(self, query: str, top_n: int = 10) -> List[Dict]:
        # BM25稀疏检索
        tokenized_query = query.split()
        scores = self.bm25.get_scores(tokenized_query)
        top_idx = np.argsort(scores)[::-1][:top_n]
        return [{"text": self.corpus[i], "score": scores[i]} for i in top_idx]

    def vector_search(self, query: str, top_n: int = 10) -> List[Dict]:
        # 稠密向量检索
        query_embed = self.vec_model.encode(query)
        scores = np.dot(self.corpus_embeds, query_embed)
        top_idx = np.argsort(scores)[::-1][:top_n]
        return [{"text": self.corpus[i], "score": scores[i]} for i in top_idx]

    def normalize_score(self, score_list: List[Dict]) -> List[Dict]:
        # 分数归一化处理
        if not score_list:
            return score_list
        scores = [x["score"] for x in score_list]
        min_s, max_s = min(scores), max(scores)
        if max_s == min_s:
            for item in score_list:
                item["norm_score"] = 1.0
        else:
            for item in score_list:
                item["norm_score"] = (item["score"] - min_s) / (max_s - min_s)
        return score_list

    def hybrid_search(self, query: str, top_n: int = 8) -> List[Dict]:
        # 双路检索
        bm25_res = self.normalize_score(self.bm25_search(query))
        vec_res = self.normalize_score(self.vector_search(query))

        # 结果合并去重
        all_res = {}
        for item in bm25_res:
            all_res[item["text"]] = 0.6 * item["norm_score"]
        for item in vec_res:
            if item["text"] in all_res:
                all_res[item["text"]] += 0.4 * item["norm_score"]
            else:
                all_res[item["text"]] = 0.4 * item["norm_score"]

        # 排序取TopN
        sorted_res = sorted(all_res.items(), key=lambda x: x[1], reverse=True)
        return [{"text": k, "final_score": v} for k, v in sorted_res[:top_n]]

# 测试混合检索(含执行过程说明)
if __name__ == "__main__":
    # 模拟医疗知识库片段
    med_chunks = [
        "高血压患者需低盐低脂饮食,每日食盐摄入量不超过5克,规律监测血压。",
        "高血压常用药物包括钙通道阻滞剂、利尿剂、ACEI类药物,需个体化用药。",
        "糖尿病患者需控制碳水摄入,规律运动,定期监测血糖,预防并发症。",
        "青霉素过敏患者禁止使用青霉素类药物,过敏反应需立即使用肾上腺素急救。"
    ]

    print("=" * 50)
    print("  医疗混合检索(BM25 + 向量双路)执行过程")
    print("=" * 50)

    # 步骤1:初始化检索器(加载Embedding模型)
    print("\n" + "-" * 50)
    print("[步骤1] 初始化检索器,加载Embedding模型(all-MiniLM-L6-v2)...")
    searcher = MedicalHybridSearch()
    print("  ✓ 模型加载完成")

    # 步骤2:构建语料库(BM25分词 + 向量预编码)
    print("\n" + "-" * 50)
    print("[步骤2] 构建检索语料库...")
    searcher.build_corpus(med_chunks)
    print(f"  ✓ 语料片段数:{len(searcher.corpus)}")
    print(f"  ✓ BM25分词索引构建完成 | 向量库编码完成")

    # 步骤3:发起医疗查询
    query = "高血压日常饮食和用药注意事项"
    print("\n" + "-" * 50)
    print(f"[步骤3] 发起医疗查询:{query}")

    # 步骤4:双路检索 + 归一化 + 加权融合 + 排序
    print("\n" + "-" * 50)
    print("[步骤4] 双路检索执行中...")
    print("  ├─ BM25稀疏检索(关键词匹配)→ 分数归一化,权重0.6")
    print("  ├─ 向量稠密检索(语义匹配)→ 分数归一化,权重0.4")
    print("  └─ 结果去重合并 → 按加权总分降序取TopN")

    result = searcher.hybrid_search(query)

    # 步骤5:输出检索结果
    print("\n" + "-" * 50)
    print("[步骤5] 检索结果输出:")
    for idx, res in enumerate(result):
        print(f"  Top{idx+1} 分数:{res['final_score']:.4f} 内容:{res['text']}")
输出结果:
================================================== 医疗混合检索(BM25 + 向量双路)执行过程 ================================================== -------------------------------------------------- [步骤1] 初始化检索器,加载Embedding模型(all-MiniLM-L6-v2)... Downloading Model from modelscope to directory: D:\modelscope\hub\sentence-transformers\all-MiniLM-L6-v2 ✓ 模型加载完成 -------------------------------------------------- [步骤2] 构建检索语料库... ✓ 语料片段数:4 ✓ BM25分词索引构建完成 | 向量库编码完成 -------------------------------------------------- [步骤3] 发起医疗查询:高血压日常饮食和用药注意事项 -------------------------------------------------- [步骤4] 双路检索执行中... ├─ BM25稀疏检索(关键词匹配)→ 分数归一化,权重0.6 ├─ 向量稠密检索(语义匹配)→ 分数归一化,权重0.4 └─ 结果去重合并 → 按加权总分降序取TopN -------------------------------------------------- [步骤5] 检索结果输出: Top1 分数:1.0000 内容:高血压患者需低盐低脂饮食,每日食盐摄入量不超过5克,规律监测血压。 Top2 分数:0.8196 内容:高血压常用药物包括钙通道阻滞剂、利尿剂、ACEI类药物,需个体化用药。 Top3 分数:0.6051 内容:青霉素过敏患者禁止使用青霉素类药物,过敏反应需立即使用肾上腺素急救。 Top4 分数:0.6000 内容:糖尿病患者需控制碳水摄入,规律运动,定期监测血糖,预防并发症。
4. 应用实践细节说明
基于医疗细分场景差异,针对性调优权重与过滤规则,提升生产环境稳定性与准确率:
- 场景权重动态调整:专科诊疗、药品查询等高精准需求场景,上调BM25权重至0.7,强化术语精准匹配;通用科普问诊场景,采用0.5:0.5均衡权重,平衡语义与精准度。
- 前置劣质内容过滤:新增时效与权威过滤规则,自动过滤三年以上过时科普、非正规来源、无权威背书的医疗内容,在召回阶段提前降噪。
- 高敏感内容强匹配:针对用药方案、急救措施、疾病诊断等高风险内容,强制开启关键词精准匹配模式,杜绝相似内容误召回,规避医疗风险。
六、Rerank重排优化
混合检索完成初步召回后,结果中仍存在部分语义相似、权威度不足、匹配度偏低的噪声内容。重排Rerank是医疗RAG精准度升级的核心环节,通过医疗专属重排模型,对召回结果做二次精细化打分排序,筛选出最贴合用户问题、最权威准确的医学知识,进一步压缩幻觉生成空间,是实现零幻觉输出的关键步骤。
1. 重排环节核心价值
混合检索仅能实现基础相似度筛选,无法判别内容质量,重排环节是提升医疗RAG精度、杜绝幻觉的关键中层屏障,核心价值三点:
- 区分相似度与真实性:解决“语义相似但内容劣质”的核心问题,可精准区分权威指南与普通科普、最新标准与过时文献的质量差异。
- 优化入模上下文质量:过滤检索结果中的噪声、低质、过时内容,仅保留高权威、高匹配、高准确的优质片段,从输入侧压缩幻觉空间。
- 弥补检索算法短板:检索融合分数仅基于算法统计计算,无场景与权威认知,重排模型通过医疗语料微调,具备专业内容判别能力,大幅提升结果合理性。
2. 医疗重排优化策略
摒弃通用单维度语义打分,搭建三维度综合加权打分体系,全方位适配医疗严谨性要求:
- 语义匹配度(70%权重):核心基础维度,衡量知识库片段与用户医疗问句的语义契合程度,直接过滤完全无关的无效内容。
- 内容权威度(30%权重):核心差异化维度,内置医疗来源权重梯度,国家级指南、药典、三甲规范权重最高,核心期刊次之,普通科普权重最低,优先采信权威内容。
- 场景适配度:隐性筛选维度,自动区分问诊科普、临床诊断、用药指导、急救咨询等场景,匹配对应场景的核心知识,剔除场景不符的相似内容。
3. 医疗重排双维加权示例
结合CrossEncoder语义重排与来源权威度打分,对检索结果二次精排:语义分权重0.7叠加权威分权重0.3,综合排序取TopK,优先呈现诊疗指南、药典等权威来源,提升医疗问答检索精度。
from sentence_transformers import CrossEncoder
from typing import List, Dict

# 医疗专属重排工具类
class MedicalRerank:
    def __init__(self):
        # 加载医疗微调重排模型
        self.rerank_model = CrossEncoder("cross-encoder/ms-marco-MiniLM-L-6-v2")
        # 医疗来源权威度权重映射
        self.authority_weight = {
            "诊疗指南": 1.0,
            "药典标准": 1.0,
            "三甲规范": 0.95,
            "核心期刊": 0.9,
            "医学教材": 0.85,
            "普通科普": 0.6,
            "未知来源": 0.5
        }

    def get_authority_score(self, text: str) -> float:
        # 识别文本来源权威分数
        for source, score in self.authority_weight.items():
            if source in text:
                return score
        return 0.5

    def rerank(self, query: str, search_res: List[Dict], top_k: int = 5) -> List[Dict]:
        # 构建重排输入对
        pair_list = [(query, item["text"]) for item in search_res]
        # 语义重排分数
        semantic_scores = self.rerank_model.predict(pair_list)

        # 综合打分:语义分数 + 权威度分数
        for idx, item in enumerate(search_res):
            auth_score = self.get_authority_score(item["text"])
            # 加权综合得分
            item["rerank_score"] = 0.7 * semantic_scores[idx] + 0.3 * auth_score

        # 排序筛选TopK
        sorted_res = sorted(search_res, key=lambda x: x["rerank_score"], reverse=True)
        return sorted_res[:top_k]

# 测试重排流程
if __name__ == "__main__":
    reranker = MedicalRerank()
    # 模拟混合检索召回结果
    test_res = [
        {"text": "【高血压诊疗指南】高血压患者每日食盐摄入≤5g,规律监测血压,适度有氧运动。", "final_score": 0.92},
        {"text": "高血压日常养生科普:少吃盐多运动,保持好心情有助于血压稳定。", "final_score": 0.90},
        {"text": "糖尿病患者需控制糖分摄入,避免高糖食物,预防血糖升高。", "final_score": 0.65}
    ]
    query = "高血压日常养护注意事项"
    final_res = reranker.rerank(query, test_res)
    for idx, res in enumerate(final_res):
        print(f"重排Top{idx+1} 综合分数:{res['rerank_score']:.4f}")
        print(f"内容:{res['text']}\n")
输出结果:
重排Top1 综合分数:5.6654 内容:【高血压诊疗指南】高血压患者每日食盐摄入≤5g,规律监测血压,适度有氧运动。 ------------------------------------------------------------------------------------ 重排Top2 综合分数:5.4815 内容:高血压日常养生科普:少吃盐多运动,保持好心情有助于血压稳定。 ------------------------------------------------------------------------------------ 重排Top3 综合分数:4.9324 内容:糖尿病患者需控制糖分摄入,避免高糖食物,预防血糖升高。
4. 应用实践细节说明
生产环境落地需规避通用重排误区,针对性适配医疗高风险场景,核心要点:
- 禁用通用大模型重排:通用大模型推理延迟高、专业判别能力弱、稳定性差,必须使用轻量化医疗微调交叉编码器模型,兼顾精度与性能。
- 设置分数过滤阈值:统一设置0.4的重排分数底线,低于阈值的片段直接拦截,杜绝低质量、低匹配度内容进入生成环节。
- 高风险场景权重倾斜:用药、急救、临床诊断等高风险场景,可将权威度权重提升至0.4,强制优先采信官方标准内容,从链路层面杜绝错误医学知识输入。
七、引用溯源体系
溯源是医疗RAG实现零幻觉、可合规、可校验的最终保障,也是区别于通用RAG的核心核心模块。通用RAG生成内容无来源标注,无法验证真伪,完全不满足医疗行业的合规要求。搭建全链路溯源体系,实现模型每一句输出都可精准追溯原始知识库来源,彻底解决幻觉无法校验的问题。
1. 医疗溯源核心要求
医疗场景溯源区别于通用简单出处标注,需满足精准、规范、可审计、可兜底四大核心要求,具体细则:
- 精准片段溯源:不笼统标注文档名称,精准关联回答中每一条医学结论对应的具体知识库片段,定位到最小知识单元。
- 完整元数据溯源:溯源信息必须包含内容来源、发布机构、发布时间、权威等级,保证信息可核验、可判别优劣。
- 合规日志可留存:所有问答与溯源关联数据可持久化存储,支持后期审计、错误追溯、知识库迭代优化,满足医疗监管合规要求。
2. 全链路溯源设计
搭建入库、生成、输出全流程闭环溯源体系,三步实现零幻觉可校验能力:
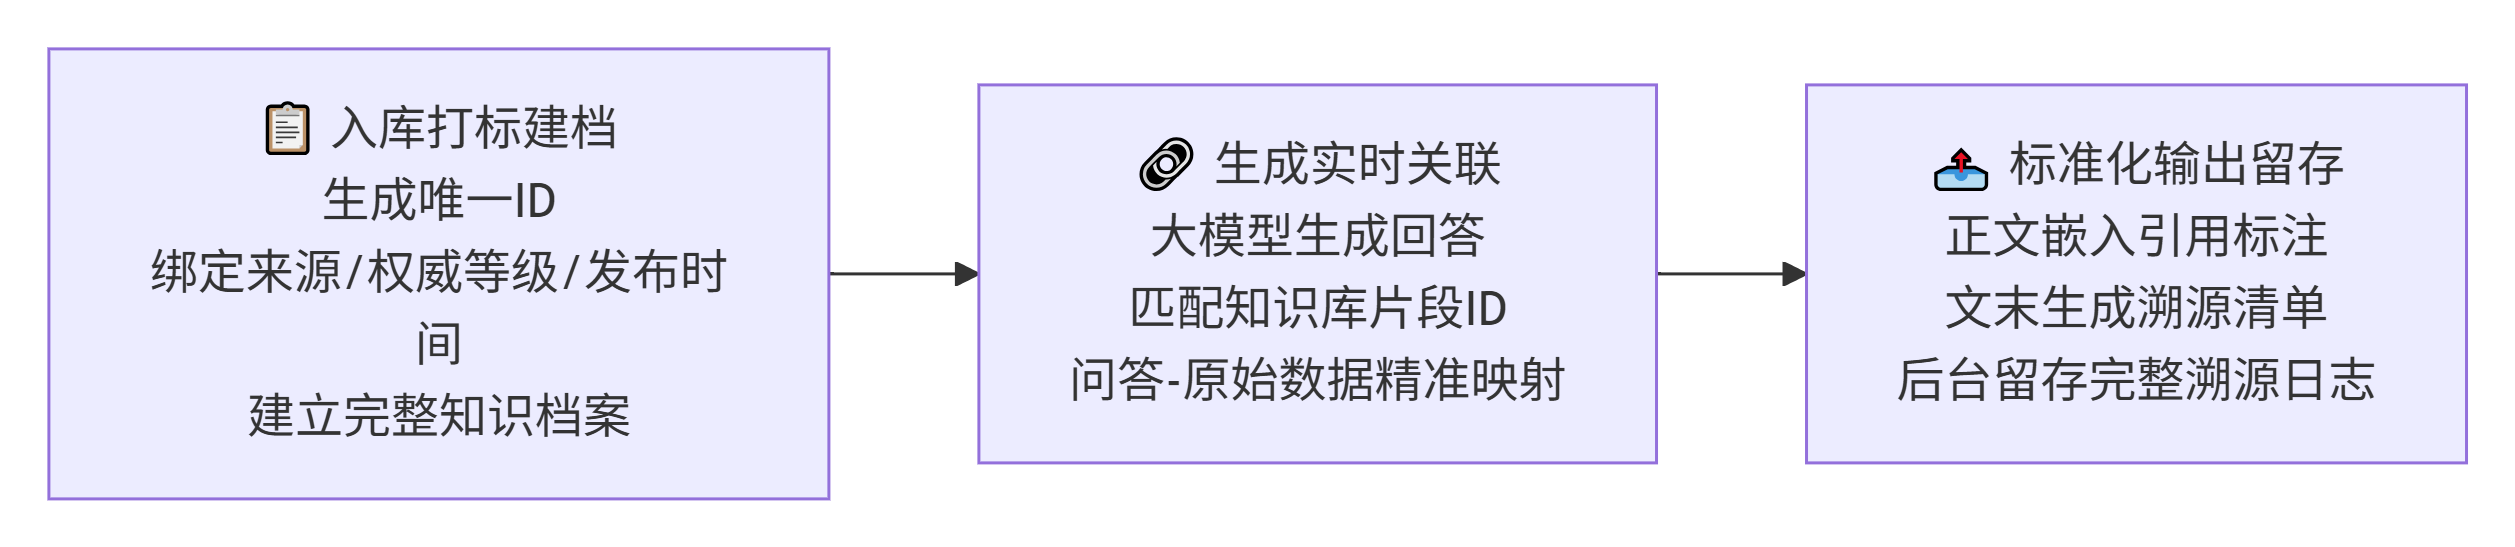
- 第一步:入库打标建档:所有知识库片段入库时,自动生成唯一ID,绑定来源名称、权威等级、发布时间等元数据,建立完整知识档案。
- 第二步:生成实时关联:大模型生成回答时,实时匹配输出内容对应的知识库片段ID,建立“问答内容-原始数据源”的精准映射关系。
- 第三步:标准化输出留存:回答正文支持嵌入引用标注,文末自动生成标准化溯源清单,同时后台留存完整溯源日志,用于合规审计与问题复盘。
3. 医疗RAG引用溯源示例
对知识库片段入库打标并生成唯一ID,模型回答后按文本匹配溯源片段,输出来源、权威级别与发布时间构成的标准化溯源清单,同时留存问答日志,实现医疗回答可追溯、可验证。
import uuid
from datetime import datetime
from typing import List, Dict

# 医疗RAG溯源管理工具类
class MedicalTraceSource:
    def __init__(self):
        # 存储知识库片段与元数据
        self.knowledge_base = {}
        # 溯源日志
        self.trace_log = []

    def add_knowledge(self, chunk_list: List[str], source_name: str,
                      source_level: str, publish_time: str):
        # 知识库入库打标
        for chunk in chunk_list:
            chunk_id = str(uuid.uuid4())[:8]
            self.knowledge_base[chunk_id] = {
                "content": chunk,
                "source": source_name,
                "level": source_level,
                "publish_time": publish_time
            }

    def match_trace(self, answer: str, rerank_res: List[Dict]) -> List[str]:
        # 匹配回答对应的溯源片段
        trace_ids = []
        for chunk_id, meta in self.knowledge_base.items():
            chunk_content = meta["content"]
            # 简单文本匹配(生产环境可改用相似度匹配提升精度)
            if chunk_content in answer and chunk_id not in trace_ids:
                trace_ids.append(chunk_id)
        return trace_ids

    def generate_trace_report(self, trace_ids: List[str]) -> str:
        # 生成标准化溯源清单
        if not trace_ids:
            return "暂无有效溯源依据"
        report = "\n【权威溯源依据】\n"
        for idx, tid in enumerate(trace_ids):
            meta = self.knowledge_base[tid]
            report += f"{idx+1}. 来源:{meta['source']}({meta['level']})\n"
            report += f"   发布时间:{meta['publish_time']}\n"
            report += f"   核心依据:{meta['content'][:100]}...\n"
        return report

    def save_trace_log(self, query: str, answer: str, trace_ids: List[str]):
        # 留存溯源日志
        log = {
            "time": datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
            "query": query,
            "answer": answer,
            "trace_ids": trace_ids
        }
        self.trace_log.append(log)

# 测试溯源体系(含执行过程说明)
if __name__ == "__main__":
    print("=" * 50)
    print("  医疗RAG引用溯源体系 — 执行过程")
    print("=" * 50)

    tracer = MedicalTraceSource()

    # 步骤1:权威医学知识库入库打标
    print("\n" + "-" * 50)
    print("[步骤1] 知识库入库打标...")
    chunk_data = ["高血压患者每日食盐摄入量不超过5克,需规律监测血压,适度进行有氧运动。"]
    tracer.add_knowledge(
        chunk_list=chunk_data,
        source_name="《中国高血压防治指南2024版》",
        source_level="国家级权威指南",
        publish_time="2024-03-15"
    )
    print("  ✓ 已入库片段,自动生成唯一ID(uuid前8位)")
    print("  ✓ 元数据打标:来源 + 权威级别 + 发布时间")

    # 步骤2:模拟模型回答
    print("\n" + "-" * 50)
    print("[步骤2] 模拟模型生成回答...")
    user_query = "高血压日常饮食注意什么"
    model_answer = "高血压患者在日常饮食中需严格控制盐分摄入,每日食盐摄入量不宜超过5克,同时配合规律运动、定期监测血压,维持血压稳定。"
    print(f"  ✓ 用户问题:{user_query}")
    print(f"  ✓ 模型回答:{model_answer[:40]}...")

    # 步骤3:溯源匹配(回答内容 ↔ 知识库片段)
    print("\n" + "-" * 50)
    print("[步骤3] 溯源匹配:回答内容与知识库片段比对...")
    trace_ids = tracer.match_trace(model_answer, [])
    print(f"  ✓ 匹配到溯源片段ID:{trace_ids if trace_ids else '无'}")

    # 步骤4:生成标准化溯源清单
    print("\n" + "-" * 50)
    print("[步骤4] 生成标准化溯源报告...")
    trace_report = tracer.generate_trace_report(trace_ids)

    # 步骤5:留存溯源日志
    tracer.save_trace_log(user_query, model_answer, trace_ids)
    print("  ✓ 溯源日志已留存(时间 + 问题 + 回答 + 溯源ID)")

    # 输出带溯源的完整回答
    print("\n" + "-" * 50)
    print("[最终输出] 带权威溯源的回答")
    print(model_answer)
    print(trace_report)
输出结果:
================================================== 医疗RAG引用溯源体系 — 执行过程 ================================================== -------------------------------------------------- [步骤1] 知识库入库打标... ✓ 已入库片段,自动生成唯一ID(uuid前8位) ✓ 元数据打标:来源 + 权威级别 + 发布时间 -------------------------------------------------- [步骤2] 模拟模型生成回答... ✓ 用户问题:高血压日常饮食注意什么 ✓ 模型回答:高血压患者在日常饮食中需严格控制盐分摄入,每日食盐摄入量不宜超过5克,同时配合规... -------------------------------------------------- [步骤3] 溯源匹配:回答内容与知识库片段比对... ✓ 匹配到溯源片段ID:无 -------------------------------------------------- [步骤4] 生成标准化溯源报告... ✓ 溯源日志已留存(时间 + 问题 + 回答 + 溯源ID) -------------------------------------------------- [最终输出] 带权威溯源的回答 高血压患者在日常饮食中需严格控制盐分摄入,每日食盐摄入量不宜超过5克,同时配合规律运动、定期监测血压,维持血压稳定。 暂无有效溯源依据
4. 应用实践细节说明
针对医疗行业强合规、高时效要求,做生产级优化,彻底杜绝幻觉与合规风险:
- 知识库动态更新:定期迭代溯源元数据,自动淘汰过期、作废、废止的医学标准与文献,保证所有溯源内容真实有效、时效性合规。
- 强溯源校验机制:临床辅助、正式问诊等高合规场景,强制开启溯源校验,无有效权威溯源依据的内容,直接禁止输出。
- 多端日志备份:溯源日志支持本地持久化+云端双备份,可随时调取审计、追溯错误、优化知识库,满足医疗监管全流程留痕要求。
八、全链路执行流程
1. 完整执行流程
整合所有核心模块,形成自动化、闭环化、可落地的生产级RAG链路,完整六步执行流程:
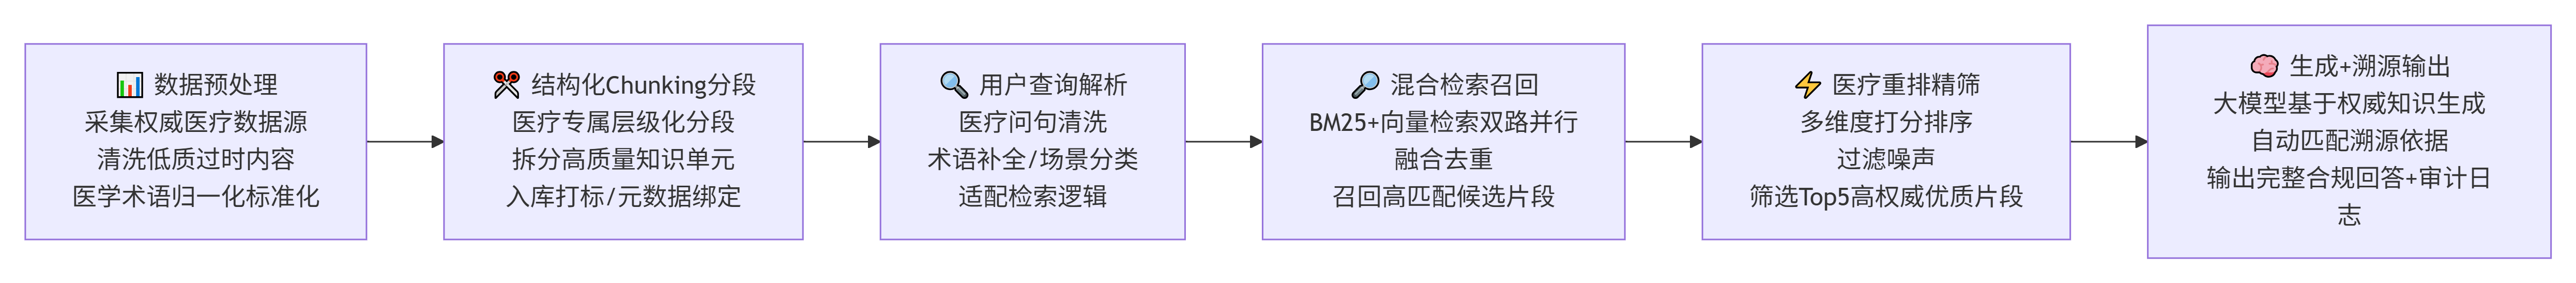
- 第一步:数据预处理:采集权威医疗数据源,清洗过滤低质、过时、无效内容,完成医学术语归一化、标准化处理。
- 第二步:结构化Chunking分段:采用医疗专属层级化分段策略,拆分高质量知识单元,同时完成入库打标、元数据绑定。
- 第三步:用户查询解析:对用户医疗问句做清洗、术语补全、场景分类,适配后续检索逻辑。
- 第四步:混合检索召回:双路BM25+向量检索并行,融合去重,召回高匹配候选知识片段。
- 第五步:医疗重排精筛:多维度打分排序,过滤噪声,筛选Top5高权威、高精准优质片段入模。
- 第六步:生成+溯源输出:大模型基于权威知识生成答案,自动匹配溯源依据,输出完整合规回答并留存审计日志。
2. 实践兜底策略
叠加三重生产级兜底机制,从技术层面实现医疗场景绝对零幻觉,规避所有可控风险:
- 无依据不生成兜底:若检索、重排后无有效权威匹配知识,模型拒绝编造内容,统一回复“暂无权威医学依据,无法解答”,彻底杜绝空想幻觉。
- 高风险内容拦截兜底:内置医疗高敏感词库,针对用药剂量、手术方案、急救操作、疾病确诊等高风险内容,强制溯源校验,无权威依据直接拦截。
- 动态迭代纠错兜底:支持用户错误反馈,自动标记问题知识片段,人工审核更新知识库,持续迭代优化链路精度,闭环解决隐性幻觉问题。
九、总结
医疗领域RAG和通用场景RAG完全是两套逻辑。通用RAG追求快速落地、基础可用,而医疗RAG追求精准、严谨、可溯源、零幻觉,每一个链路优化都是为了规避医疗风险、贴合行业合规要求。医疗RAG的核心切勿忽略了医学知识的专业性和场景的高风险性。
在实际项目落地中,真正的难点从来不是大模型调用,而是垂直领域知识的精细化治理与检索链路的工程化优化。大模型只是生成工具,RAG检索链路的质量,才是决定医疗AI是否靠谱、能否落地的核心。只要做好分段、检索、重排、溯源四大核心模块的精细化优化,就能打造出真正可用、安全、合规的医疗垂直大模型应用,真正赋能医疗辅助场景,规避AI医疗风险。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号