ooderAgent 实战:用户如是使用“devAgent” 实现实战功能开发
原创
ooderAgent 实战:用户如是使用“devAgent” 实现实战功能开发
原创
OneCode
发布于 2026-10-16 21:05:36
发布于 2026-10-16 21:05:36
一句话,给资金日报加一个钉钉推送用户如何用 devAgent 完成自然语言业务功能扩展
取材于一次真实会话记录(19:08 – 19:18,26 条正文消息 + 8 个流程事件节点)· 公司名称、人名、手机号均已脱敏
0. 场景:一句话说出来的需求
王工是「某网络科技公司」的业务同事,日常在智能体平台上处理资金日报、报销、挂账提醒等财务事务。有一天他想加一件事:
"能不能给某分公司的资金日报,每天推一次钉钉?"
他不会写代码,也不想走「提需求 → 排期 → 等开发」那条路。于是他打开平台,把这句话原样说了出来。
接下来十分钟里发生的,是一次完整的「自然语言 → 可执行口径」收敛过程。
1. 入口:一个对话页,九个业务入口
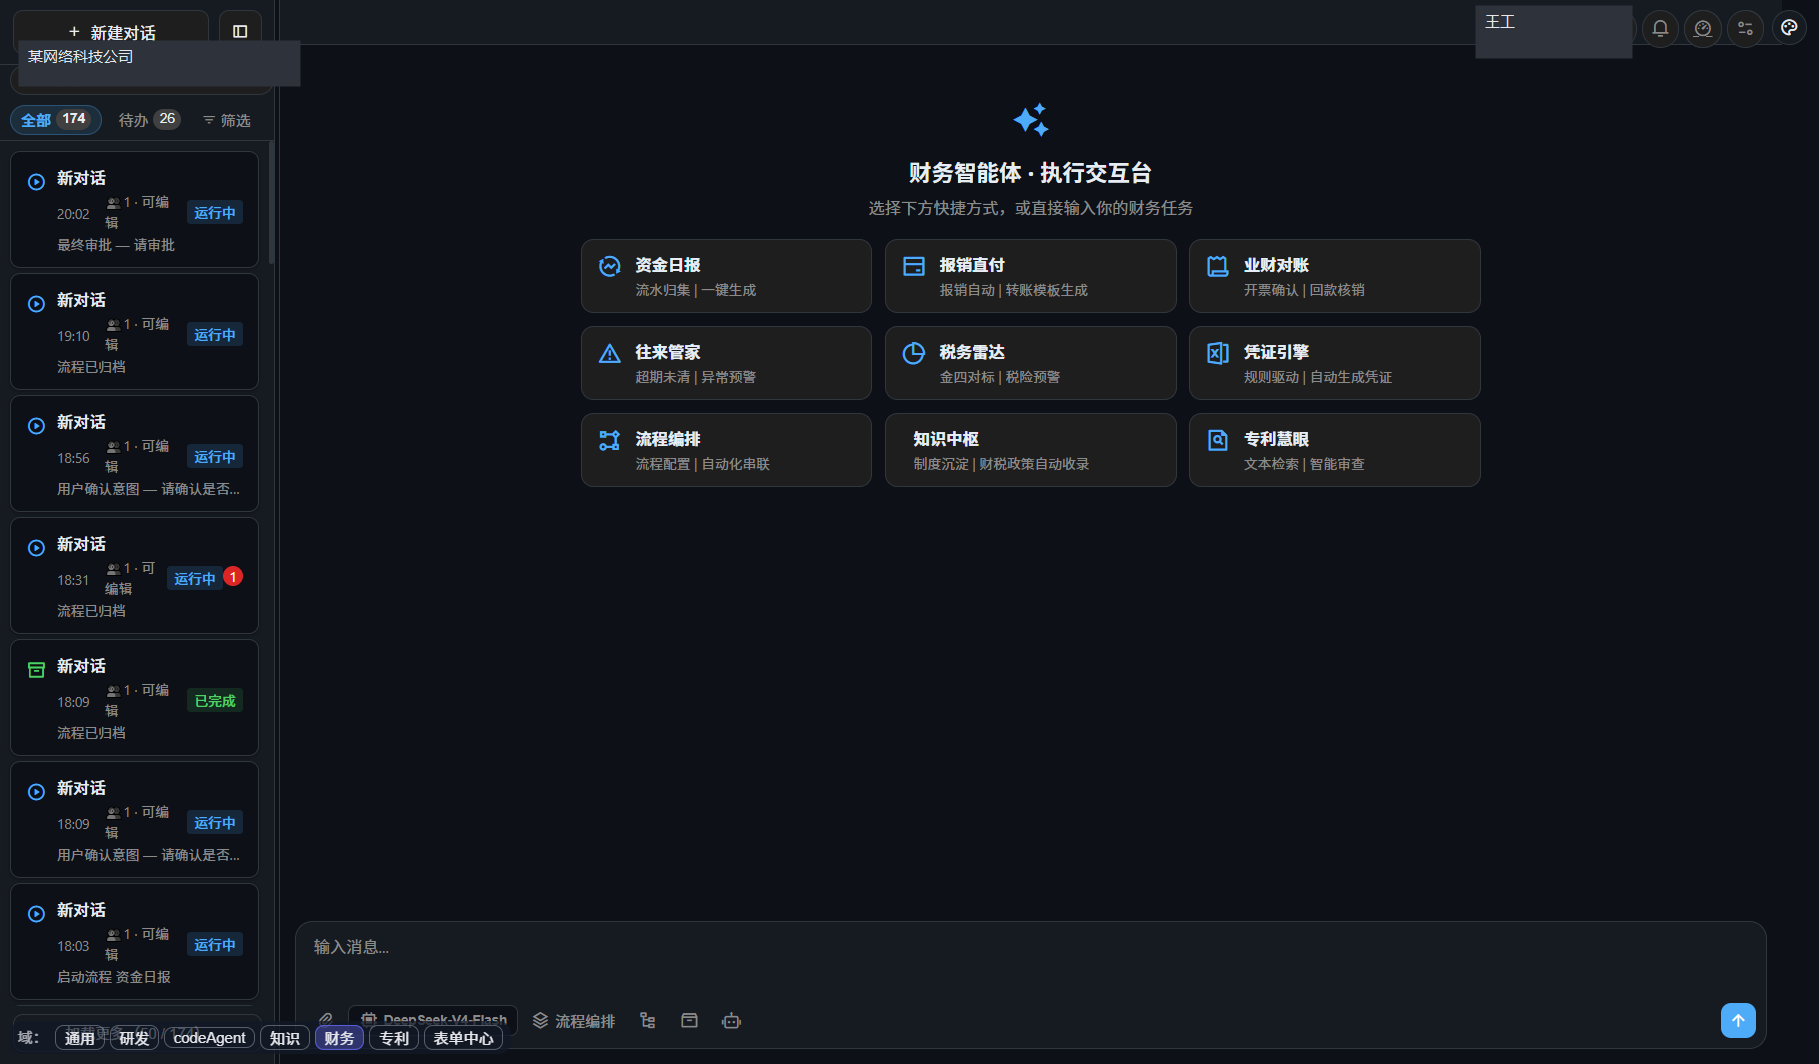
图 1 · 左侧是会话列表,中间是业务入口卡片
平台首页把业务能力直接铺成卡片:资金日报、报销直付、业财税账、往来账龄、税务雷达、凭证引擎、流程编排、知识中枢、专利慧眼。底部是领域切换:通用 / 研发 / codeAgent / 知识 / 财务 / 专利 / 表单中心。
用户可以点卡片,也可以像王工一样——直接在输入框里描述任务。本次实战从一个「新对话」开始。
2. 第 1 轮:先问"我能不能自己改"
王工的第一句是试探:
"我能自己更新钉钉的推送吗?"
devAgent 没有直接答"能 / 不能",而是先去知识库取证。页面上的工具链留下了完整痕迹:
search_knowledge(3ms) · kb_search · kb_get(1ms) · search_knowledge(4ms)
· list_knowledge_domains(1ms) · search_knowledge(5ms) · search_knowledge(5ms)
同一轮还附了一段 9967 字的思考过程。
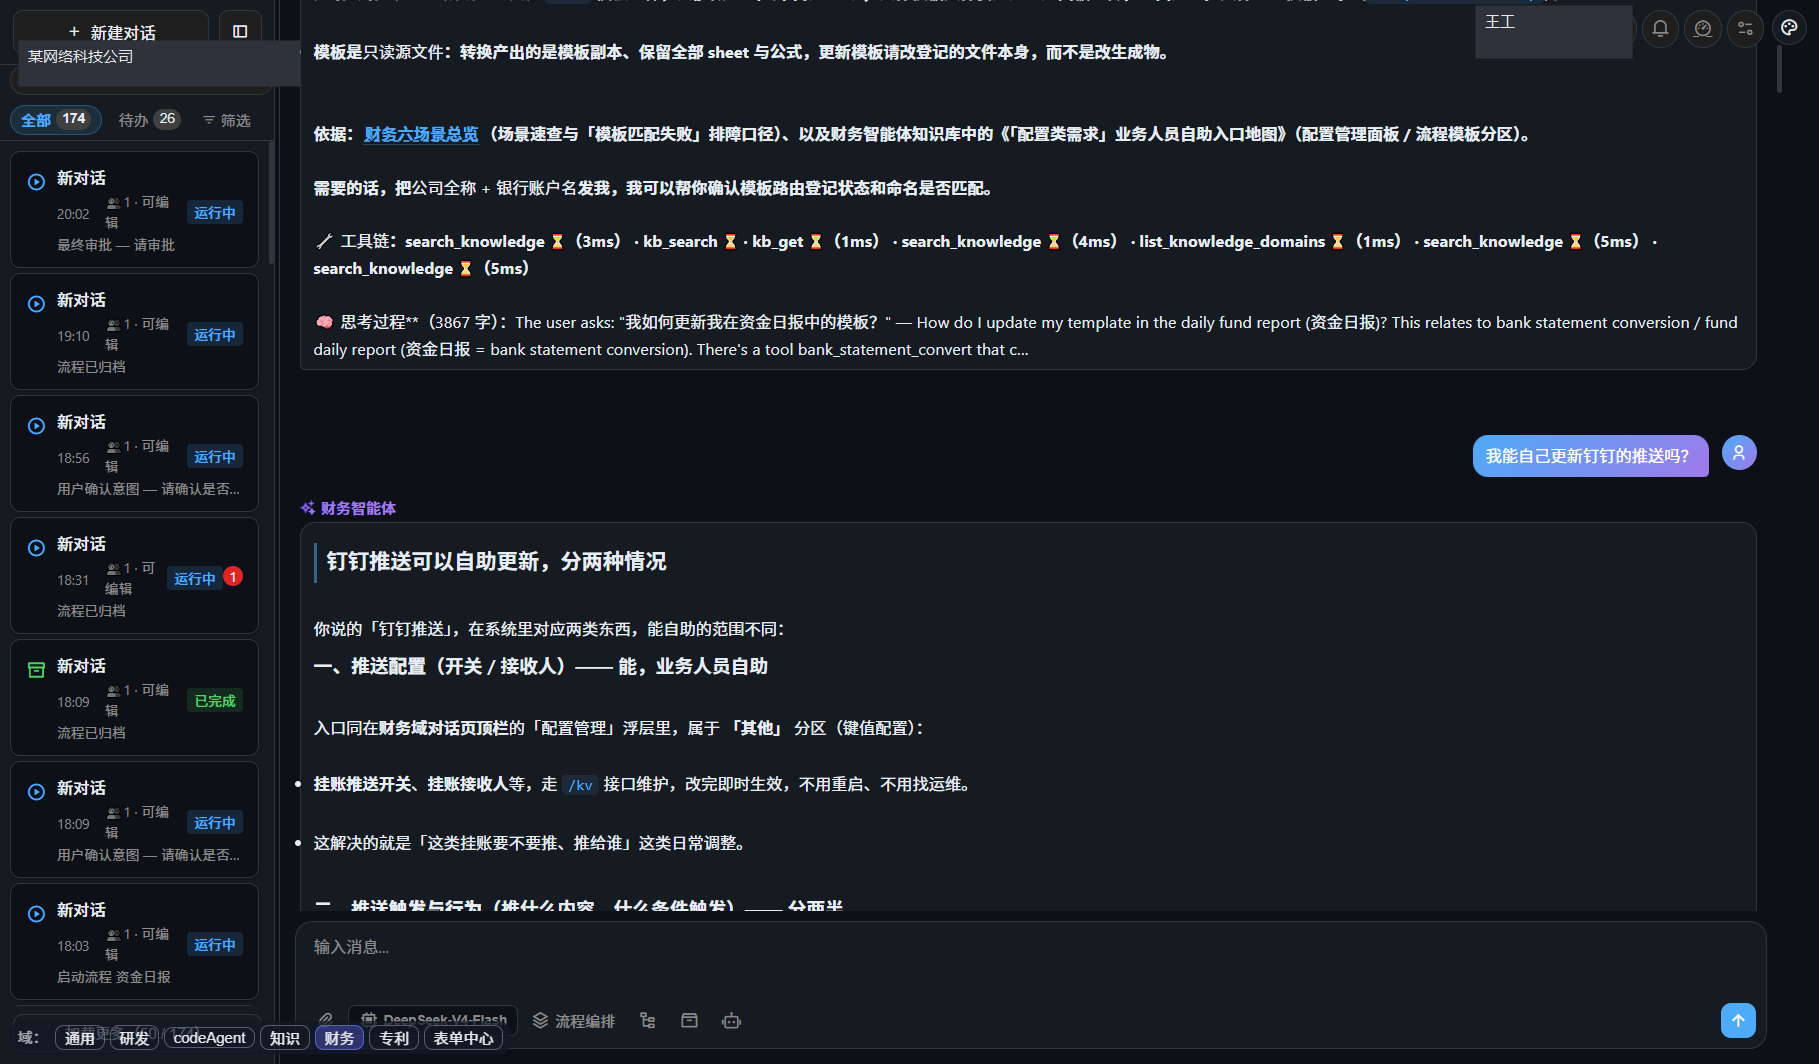
图 2 · 用户提问 / 工具链 / 思考过程 / agent 答复,四段式同屏
然后它把"钉钉推送"拆成两类,分别给出自助范围:
你想改的 | 能否自助 | 在哪改 |
|---|---|---|
挂账推送开关 / 接收人 | ✅ 能 | 顶栏「配置管理」→「其他」分区(/kv) |
钉钉 / 工作通知凭据、mock、连接测试 | ✅ 能 | 「配置管理」→「外部接入」(/integrations) |
报销入账通知报销人(内建链路) | ⚙️ 自动,无需配 | 无需操作 |
钉钉侧审批表单 / 节点模板 | ❌ 归属钉钉开放平台 | 钉钉开放平台 / 管理后台 |
注意它的回答结构——先分类、再给位置、最后给依据。这是"把知识库当事实来源"的写法,不是凭印象编。
3. 第 2 轮:需求成形,agent 先澄清而不是先动手
王工把诉求说全了:
"帮我设置一下,给王工每天推送一次,资金日报。"
(并补上了手机号 138****0000)
devAgent 没有顺着往下做,而是先把需求拆成两件事:
- 挂账提醒 → 已有"挂账推送开关 + 挂账接收人"键值 → 可自助
- 资金日报每天推送 → 口径与任务都需要新增
然后反问一句:
"你要的是「资金日报每日推送」,还是「挂账提醒推送」?"
这就是意图澄清。很多自动化失败,不是能力不够,而是需求没对齐。devAgent 在这里宁可多花一轮对话,也要把歧义挡在动手之前。
4. 第 3 轮:用户不满足于"教我怎么点"
王工选了 A(挂账提醒),devAgent 给出点面板的操作步骤。但他想要的不是操作说明:
"你为什么不能直接帮我设置完毕,每次都得我处理"
这是整场会话的转折点,也是价值最集中的一步。
它没有停在道歉,而是去读了实时配置——结果发现:这件事早就配好了。
配置项 | 实测值 | 结论 |
|---|---|---|
ledger-push.dingtalk.enabled | true | ✅ 挂账推送已开 |
ledger-push.dingtalk.mobiles | 138****0000, 189****5296 | ✅ 王工已在接收人名单 |
notice.default-mobiles | 138****0000, 189****5296 | ✅ 默认通知对象也包含他 |
钉钉 mock 开关 | dtMock = false | ✅ 真实发送,不是模拟 |
钉钉凭据 | AppKey / ProcessCode 已配置 | ✅ 通路具备 |
它同时纠正了自己上一轮的结论:
"我上一轮照着知识文档让你去手动填,其实白让你跑了。我刚查了实时配置,你要的东西本来就已经配好了。"
一句"我该先查了再说",替用户挡掉了一次无意义的操作。背后是一条独立的配置核验通道——get_system_config / platform_api_get 直接读运行时配置,而不是引用文档。
5. 第 4 轮:顺手纠正一个工程事实
配置查完,devAgent 又做了一次比对——把 8 个定时任务的真实 cron 拉出来:
任务 | 真实 cron | 人话 | 是否每天 |
|---|---|---|---|
bank-statement-mwf(资金日报) | 0 0 9 ? * MON,WED,FRI | 每周一、三、五 9:00 | ❌ 不是 |
ledger-aging-push(挂账推送) | 0 30 9 8 * ? | 每月 8 日 9:30 | ❌ 不是 |
reimburse-pay-daily(报销付款) | 0 30 9 * * ? | 每天 9:30 | ✅ |
voucher-fill-daily(凭证) | 0 30 8 * * ? | 每天 8:30 | ✅ |
用户说的是"每天",但现有任务里,"每天"这个节奏对不上挂账推送,也对不上资金日报。
这是一类很典型的价值——用户对系统的认知,与系统的真实行为之间存在偏差,agent 用实时数据把它纠正了。如果直接按用户口述去改,很容易换来"每天推、但内容几天没变"的噪音。
6. 第 5 轮:用户要"开发一个技能"
王工决定直接上需求:
"帮我开发一个,推送钉钉消息的技能部署上去,然后完成我的诉求。"

图 3 · 用户直接把诉求指向"开发一个技能"
7. 第 6 轮:能力盘点——先查清楚有什么,再决定写什么
这一轮是整个实战的技术高光。devAgent 没有立刻开工,而是先做了一次能力盘点。工具链完整暴露了三路取证:
tools_find(3ms) · tools_load(2ms) · get_system_config · tools_load(1ms)
· platform_api_get(5ms) · search_knowledge(3ms) · kb_search
· platform_api_get(3ms) · code_search(19ms) · platform_api_get(3ms) · platform_api_get(2ms)
伴随 10347 字思考过程。随后给出工程侧核查结论:
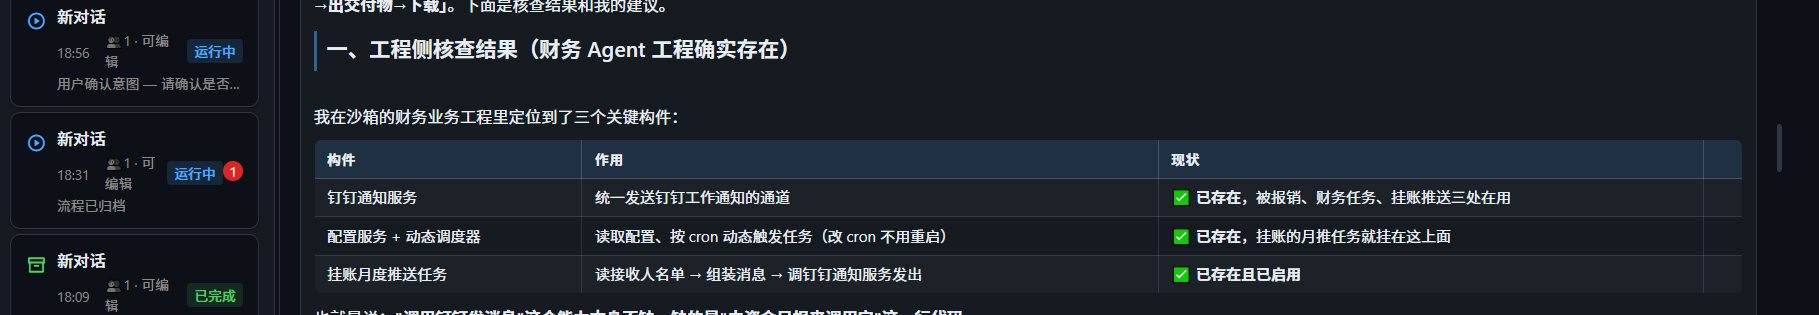
图 4 · 三个关键构件的核查结果:全部"已存在 / 已启用"
构件 | 作用 | 现状 |
|---|---|---|
钉钉通知服务 | 统一发送钉钉工作通知的通道 | ✅ 已存在,被报销、财务任务、挂账推送三处在用 |
配置服务 + 动态调度器 | 读取配置、按 cron 动态触发任务(改 cron 不用重启) | ✅ 已存在,挂账的月推任务就挂在这上面 |
挂账月度推送任务 | 读接收人名单 → 组装消息 → 调钉钉通知服务发出 | ✅ 已存在且已启用 |
结论一句话:
"「调用钉钉发消息」这个能力本身不缺,缺的是「由资金日报来调用它」这一行代码。"
这就是避免重复建设。一个听起来像"从零开发"的需求,经过工具、配置、代码三路核验之后,被精确降级为"接线需求"——工作量差了一个量级。
8. 第 7 轮:口径锁定,收敛成施工单
最后,需求被收敛成 6 条可施工口径:
项 | 值 |
|---|---|
推送公司 | 某分公司 |
接收人 | 王工 138****0000 |
内容形式 | A 纯文字摘要(收款合计 / 付款合计 / 笔数 / 项目 Top) |
推送时间 | 每天 9:30 |
资金日报跑批 | 改成每天 9:00(当日无新数据则跳过不推) |
通道 / 调度 | 复用已有钉钉通知服务 + 动态调度器 |
并给出可直接使用的 cron 表达式:
目标 | cron |
|---|---|
每日 9:30 推送 | 0 30 9 * * ? |
资金日报改每日 9:00 | 0 0 9 * * ? |
到这一步,用户嘴里的一句"每天推资金日报",已经变成一份开发同学能直接照单实施的施工单——公司、接收人、内容形态、时间、跑批节奏、复用通道,全部无歧义。
9. 技术原理:devAgent 是怎么做到的
9.1 五个动作,一条主线
自然语言 → 意图澄清 → 能力盘点 → 边界说明 → 口径锁定 → 交付9.2 三路取证,缺一不可
取证通道 | 真实工具 | 回答什么问题 |
|---|---|---|
知识层 | search_knowledge kb_search kb_get list_knowledge_domains | 业务口径、自助入口、排障口径 |
配置层 | get_system_config platform_api_get ctx_catalog | 现在到底是什么状态 |
工程层 | code_search sandbox_search_code sandbox_read_architecture sandbox_git_status | 能力在哪、有没有、怎么被调用 |
三层证据交叉之后才下结论。只用知识层会答错(第 4 轮就是活例子),只用工程层则看不懂业务语义。
9.3 工具是"动态装载"的,不是硬编码的
tools_find → tools_load先用 tools_find 找有没有合适的工具,命中后再 tools_load 装进当前会话。需要新能力时,用 skill_install 从平台技能库装配技能包;装配完成后,技能提供的工具即注册进本会话。
这意味着 agent 的能力边界是可扩展的——用户不需要知道有哪些工具,agent 自己去找、去装。
9.4 推理与执行分离
每一轮回答都能看到两个折叠块:「工具链」和「思考过程」。第 1 轮 9967 字,第 6 轮 10347 字。推理链、工具调用、最终答复三者可追溯。
9.5 会话是"事件化"的
节点 88(session:1 stream:13 tool:4 process:4 notice:15 phase:3
        activity:2 agent:42 human:3 artifact:1)
一次对话被拆成了 10 类事件:会话、流、工具、流程、通知、阶段、活动、智能体、人工、产物。这行数字就是"多智能体协同"最直白的证据——不是一个大模型在一个 prompt 里自言自语。
10. 多 Agent 协同架构
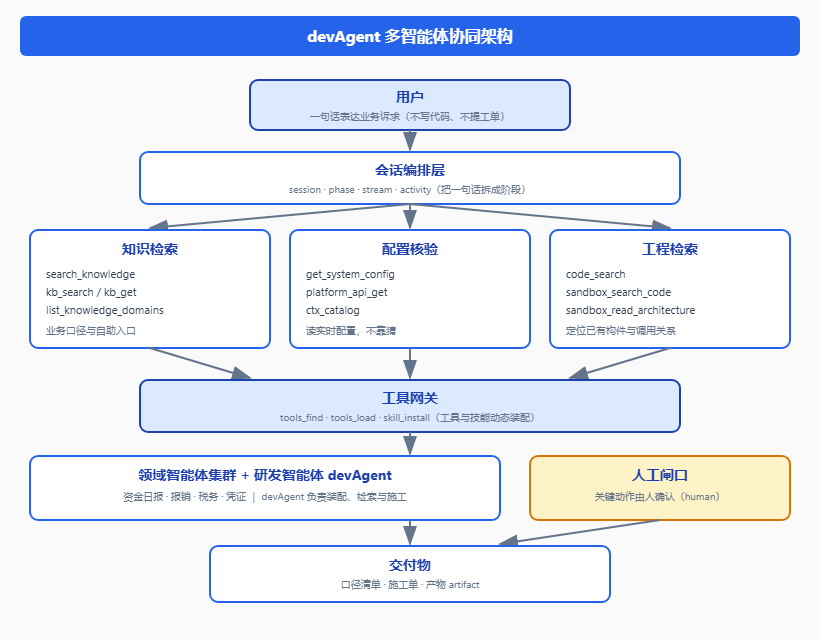
分层说明:
- 会话编排层:把一句话拆成 phase / activity / stream,决定下一步走哪条通道。
- 三条取证通道:知识检索 / 配置核验 / 工程检索——并行取证、交叉验证。
- 工具网关:tools_find / tools_load / skill_install 动态装配工具与技能。
- 智能体集群:业务域智能体(资金日报、报销、税务、凭证…)负责业务语义;研发智能体 devAgent 负责装配、检索与施工。
- 人工闸口:human:3 —— 关键动作交回给人确认,agent 不越权替人做决定。
- 交付物:口径清单、施工单、产物 artifact。
11. 本地模型部署:把"分支判断"下沉到一张消费级显卡
11.1 为什么这件事值得单独做
流程里大量的节点其实是结构化决策:
- 这条流水该路由到哪家公司的模板?
- 这张单子走审批还是退回?
- 这条消息该不该推送、推给谁?
用大模型做这类判断,代价是"生成式"的——要先写一段推理文本,再去解析、校验。而 System One 类模型的做法是:输入状态 + 一组预定义问题,直接输出各选项的概率分布,不生成任何文本,程序拿来就能用。
11.2 模型:Jev 与它的开源复刻 Laya
模型 | 来源 | 形态 | 单次延迟 | 显存 |
|---|---|---|---|---|
Jev | TypeSafe AI(2026-09-15 发布) | 闭源云端 API,$0.042 / 百万输入 token | 官方 70–500 ms,第三方实测 P50 236–276 ms | 0(云端) |
Laya multilingual | Convai Innovations(Apache-2.0) | 可本地自部署,mmBERT-base 322M | P50 7.4 ms | 1.25 GB(单分支) |
Laya english | 同上 | ModernBERT-large 421M | P50 13.4 ms | 同上 |
Laya Router(三分支全驻留) | 同上 | 自动语种分流 | 路由开销 +0.2 ms | 4.39 GB |
Laya 是非自回归双向编码器,支持 choice / score / boolean 三种问题原语,一次前向直接返回带校准概率的选项。官方实测:单题 T4 上 P50 32.8 ms;50 题批处理吞吐约 395 题/秒。
11.3 硬件:本文推荐的配置
部件 | 配置 | 承担什么 |
|---|---|---|
CPU | i7-14700K(8P + 12E / 28 线程) | 解析、转换、向量检索等服务侧负载 |
GPU | RTX 4060 Ti 16G(288 GB/s) | 承载全部模型推理 |
内存 | 64 GB | 多实例与向量索引常驻 |
存储 | 1 TB NVMe | 模型权重 + 向量库 + 模板文件 |
11.4 显存预算:一张 16 GB 卡装下三件套
组件 | 显存 |
|---|---|
bge-m3(F16,1024 维检索向量) | 1.13 GB |
Laya Router(中 / 英 / 类型化三分支) | 4.39 GB(锁定单分支仅 1.25 GB) |
7B 对话模型(Q4) | 约 4.5 GB |
CUDA / 上下文开销 | 1 – 2 GB |
合计 | 约 11 – 12 GB / 16 GB |
11.5 部署要点
# 1) 安装(需 >= 0.3.5)
pip install laya

# 2) 国内拉权重时配置镜像
export HF_ENDPOINT=https://hf-mirror.com

# 3) 只加载多语言分支(省显存:1.25 GB)
#    Agent(model=..., device="cuda", subfolder="multilingual")
配置项 | 建议 |
|---|---|
分支策略 | 单语种用 Agent 锁定单分支(1.25 GB);多语种用 Router(4.39 GB) |
问题原语 | choice / score / boolean,选项数 ≤ 20 |
中文阈值 | 中文置信度整体偏高,自动放行阈值建议提到 0.95 以上 |
冷启动 | 首条前向受 CUDA 初始化影响约 1.9 s,接流量前先空跑一条预热 |
与 bge-m3 共存 | 同一张 16 GB 卡可同时驻留 bge-m3 + Laya + 7B 对话模型 |
11.6 它在流程里怎么用
资金日报流程:
  [取数] → [模板路由] ─┬─ 分支判断(本地 Laya,约 10 ms)
                       │    choice:归属哪家公司 / 是否需要推送
                       └─ 概率 → 由流程代码决定走向
                                        ↓
[组装摘要] → [钉钉推送]模型只负责给"数",走哪条路由由代码决定——这也正是这类模型能直接嵌进 BPM 节点的原因:输出是结构化的,没有解析成本。
12. 复盘:这套协作方式改变了什么
环节 | 传统方式 | devAgent 方式 |
|---|---|---|
需求表达 | 写需求单 | 一句话 |
需求澄清 | 会后对齐 | 当场反问,一轮收敛 |
现状核验 | 翻文档、问人 | 实时读配置 + 检索代码 |
重复建设 | 容易踩坑 | 三路取证后精确降级 |
交付形态 | 口头 / 邮件 | 口径清单 + cron + 施工单 |
认知纠偏 | 靠经验 | 用真实 cron / 配置纠偏 |
一句话总结:用户只需要把业务语言说清楚;"查清楚、讲边界、锁口径"这三件事,交给 agent。
本文中出现的公司名、人名、手机号均已脱敏处理;截图中的对应字段已做掩码。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号