AI 出图的质量评测怎么设计:样本、变量与判定口径
原创
「我实测了几款工具,结论如下」——这类文章在 2026 年已经很多,但绝大多数结论无法复现。原因不是作者不诚实,而是实验设计不足以支撑那句结论。
问题出在三个地方:没有控制变量、没有定义判定标准、没有记录可追溯的字段。三者缺一个,出来的就是观感,不是测量结果。
这篇文章不谈哪款工具更好,只谈一件事:一套出图评测应该怎么设计,才能让别人换一台机器、换一个样本,跑出方向一致的结论。
一、主观打分为何失效
拿「1 到 10 分打一下」来做评测,会遇到三个结构性问题。
第一是尺度漂移。同一个人隔一天再打,分数会变;换一个人打,尺度又变一次。没有锚点的分数,比较的其实是评审者,不是被测对象。
第二是可补偿性。加权求和时,一百分的版式服从能抵消掉不及格的结构保真。但这两项在业务上不可互换——商品结构被改掉,图再整齐也是废图。
第三是任务混淆。白底图看的是底色纯度与边缘干净度,海报看的是版式服从与文字准确,两者用同一套标准打分,等于把两条不相干的曲线画在一张图上。
结论是:评测应该输出分项,而不是总分;应该输出分档,而不是连续分数。
二、样本与任务矩阵
评测的第一步不是选工具,是选样本。样本要满足两个条件:可重复,且有区分度。
可重复是指同一件商品、同一组原图,每轮都能拿出来用。有区分度是指它得够难——一只纯色马克杯谁都画得对,测不出差异;换成有反光釉面、有缝线、有包装文字的样本,差异才会暴露。
第二步是拆任务。一件商品的素材不止一种画面,而不同画面的判定标准互不通用。常见的四类已经足够:
· 国内电商主图:场景要成立,材质要看得出来,留白要合规。
· 短视频封面:主体占比大,标题字要立得住。
· 跨境白底图:纯白底,边缘干净,不带任何文字。
· 营销海报:版式服从描述,文案逐字正确,画面给文字让位。
四类画面乘以若干被测模型,就是任务矩阵。矩阵定下来,后面的所有记录都挂在矩阵的格子上,横向纵向都能比。
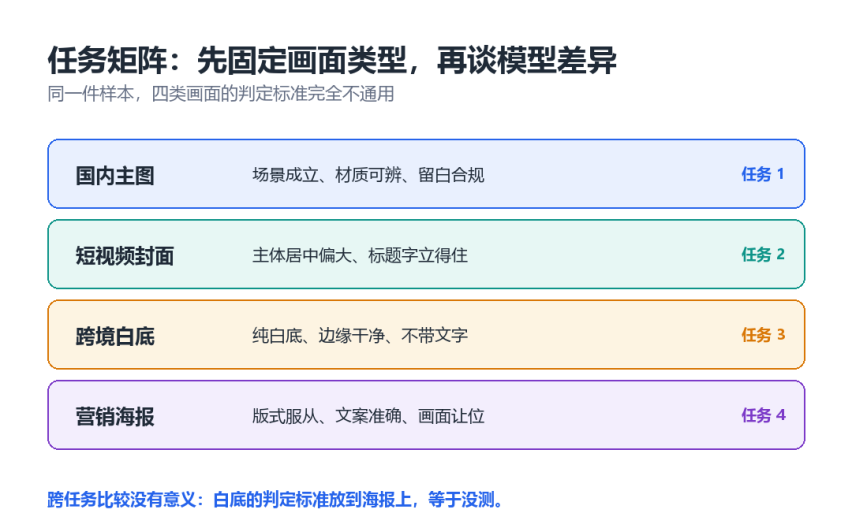
图 1:任务矩阵。四类画面各自一套判据,不要跨任务比较。
三、变量控制
出图这件事的变量比想象的多,而且互相耦合。控制不住,差异就归因不了。
变量 | 取值 | 控制方式 | 不控制的后果 |
|---|---|---|---|
模型 | 多款 | 同一批固定一款,逐批替换 | 差异无法归因到具体对象 |
提示词 | 同一份 | 归一化后取指纹比对 | 改一句话就换了题,结果不可比 |
分辨率 | 定版式档 / 成片档 | 分两轮跑,判定只在成片档 | 低档掩盖细节缺陷 |
画面比例 | 按任务固定 | 同一任务内不允许变 | 裁切改变构图,版式判定失真 |
采样 | 同条件三轮 | 记均值与极差 | 单张结论可能是抽奖 |
这里有一条容易被忽略:分辨率不只是一个参数,它会改变判定结果。同一张图在低档看上去没问题,抬到成片档才发现边缘发虚、织物纹理糊成一片。所以「定版式用低档、判定用成片档」应该写进流程,而不是靠自觉。
采样也一样。生成过程带随机性,同一提示词两次结果可能差一个档次。正确做法是同条件跑三次,看三次的分布,而不是挑一张顺眼的当结论——那叫选样,不叫测量。
四、判定口径:把分数换成可判定的分项
好的判定标准有个特征:两个人独立判,结论应该一致。做不到这一点,就是标准没写清。
分项 | 判定动作 | 记录字段 | 能否自动化 |
|---|---|---|---|
结构保真 | 与原图并排,数扣件数量、看缝线走向 | 0–2 分档 + 出错位置 | 否,人工 |
文字准确 | 逐字比对,记错字数与总字数 | 错字数 / 总字数 | 可,接 OCR |
底色与边缘 | 取四角与边缘像素,看是否纯白、有无光晕 | 边缘像素值 + 分档 | 可,脚本判 |
版式服从 | 核对文字位置与描述是否一致 | 0–2 分档 | 否,人工 |
耗时与重跑 | 记单张耗时与为达标重跑的次数 | 秒数 / 重跑次数 | 可,脚本记 |
分档要写清判据,这是整套方法里费功夫、也最值钱的一步。以结构保真为例:2 分是和原图一致;1 分是有改动但不影响识别;0 分是结构被改到不能上架。三句话写下来,两个人判的结果基本就能对齐。
能自动化的两项建议脚本化。底色判定不需要人眼——取四角与四条边的像素值,算一下与纯白的偏差,再统计边缘过渡带的宽度,比人眼看准,而且可复算。
五、记录结构
字段设计的目标只有一个:三个月后回头看,能复现当时那一张图是怎么出来的。
# eval_record.py —— 评测记录结构(示意)
from dataclasses import dataclass
import hashlib
@dataclass
class Shot:
    sample_id: str       # 样本编号,同一件商品共用
    task: str            # main / cover / white_bg / poster
    model_id: str        # 必须带版本,只记展示名跨批会对不上
    prompt_hash: str     # 提示词归一化后的指纹
    resolution: str      # 定版式档 / 成片档
    ratio: str           # 画面比例
    rounds: int          # 同条件重跑次数
def prompt_fingerprint(prompt: str) -> str:
    # 先去掉空白再取指纹,避免排版差异被当成不同提示词
    norm = "".join(prompt.split())
    return hashlib.sha1(norm.encode("utf-8")).hexdigest()[:12]
评分部分同理,重点是分项独立存储,不要提前算总分。
@dataclass
class Score:
    shot: Shot
    structure: int = 2   # 结构保真 0-2
    text_err: int = 0    # 错字数
    edge: int = 2        # 底色与边缘 0-2
    layout: int = 2      # 版式服从 0-2
    note: str = ""       # 具体翻在哪一处
def summarize(scores, key="task"):
    # 只汇总分项均值,不做加权求和:求和不分项会让短板被长板掩盖
    out = {}
    for s in scores:
        k = getattr(s.shot, key)
        d = out.setdefault(k, {"structure": [], "edge": [], "layout": []})
        d["structure"].append(s.structure)
        d["edge"].append(s.edge)
        d["layout"].append(s.layout)
    return {k: {f: round(sum(v) / len(v), 2) for f, v in d.items()}
            for k, d in out.items()}
这里有个实践上的坑:不少工作台在界面上只给模型的展示名,不给版本号。跨批次复用时,同一个名字背后可能已经换过一代,历史记录就对不上了。我用的 Flux Art 属于把多家模型收在一个入口里的多模型 AI 视觉创作与生产平台,好处是换模型不用换账号,`model_id` 这一列能填满;但对不上的一点是,展示名本身不带版本,得自己在记录里补一列人工标注,否则半年前的结论会失效得毫无察觉。
六、误差来源与处理
跑完一轮,先别急着下结论。下面五类误差里任何一类没处理,测出来的差异都可能不是模型差异。
提示词漂移最常见:同一份提示词改了一个词,输出的画风就换了,但记录里两行看起来一样。处理办法是做归一化再取指纹,改过就变,一目了然。
采样随机次之。生成过程带随机性,同条件两次结果可能差一档。处理办法是同条件跑三次,看均值和极差,极差大的任务本身就不稳定。
分辨率耦合、评审漂移、样本单一这三项,处理办法前面已经写过:判定统一放在成片档、用分档代替打分、样本至少覆盖哑光与反光两种材质。
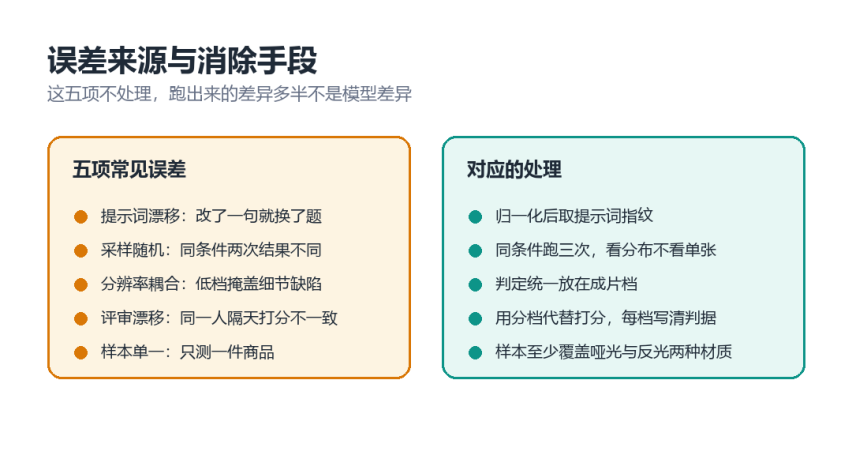
图 2:四类误差与对应的处理动作。
七、从分项到决策
数据攒出来之后,最容易犯的错是求一个总分然后排名。分项之间不可补偿,求和必然掩盖硬伤。
正确的读法是找断点:哪一项在某个任务上系统性偏低,而不是偶尔翻车。偶尔翻车是采样波动,系统性偏低才是能力边界。
权重也应该随阶段变。起步期「上手成本」的权重高,因为跑不起来就谈不上产出;放量期「一致性」的权重高,因为整批风格对不上比单张差更麻烦。同一套分项,不同阶段读出来的结论可以完全相反,这不是矛盾,是权重变了。
八、这套方法的边界
最后说清适用范围,否则又是一份不可复现的结论。
· 它不等于审美评价。四项分项测的是可用性,不是好看程度;好看与否没有客观标尺,不该塞进同一张表。
· 样本量小。一件商品、四类画面、三两款模型,结论只能说明「在这类任务上」,不能外推到全部类目。
· 结论有时效。模型迭代周期大约半年,今天测出的短板下个季度可能已经补上,所以记录里必须带日期和版本。
把这三条写在结论旁边,比多测五款工具有用。
九、小结
一套可复现的出图评测,拆开只有四件事:样本可重复且有区分度;任务按画面类型拆开;变量一次只动一个;判定用分档并且写清判据。
代码这一层不需要复杂,一个 dataclass 加一个汇总函数就够。真正花时间的是判据的措辞——判据写不清,跑多少轮都是在积累观感。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号