大规模机房温湿度采集运维:以太网传感节点批量管理工具实践
原创
大规模机房温湿度采集运维:以太网传感节点批量管理工具实践
原创
HONSOR盛世宏博
发布于 2026-10-22 10:15:04
发布于 2026-10-22 10:15:04
大规模机房温湿度采集运维:以太网传感节点批量管理工具实践
物联网 · 盛世宏博 · 大规模机房 · 以太网温湿度节点 · 批量管理 · 运维工具链
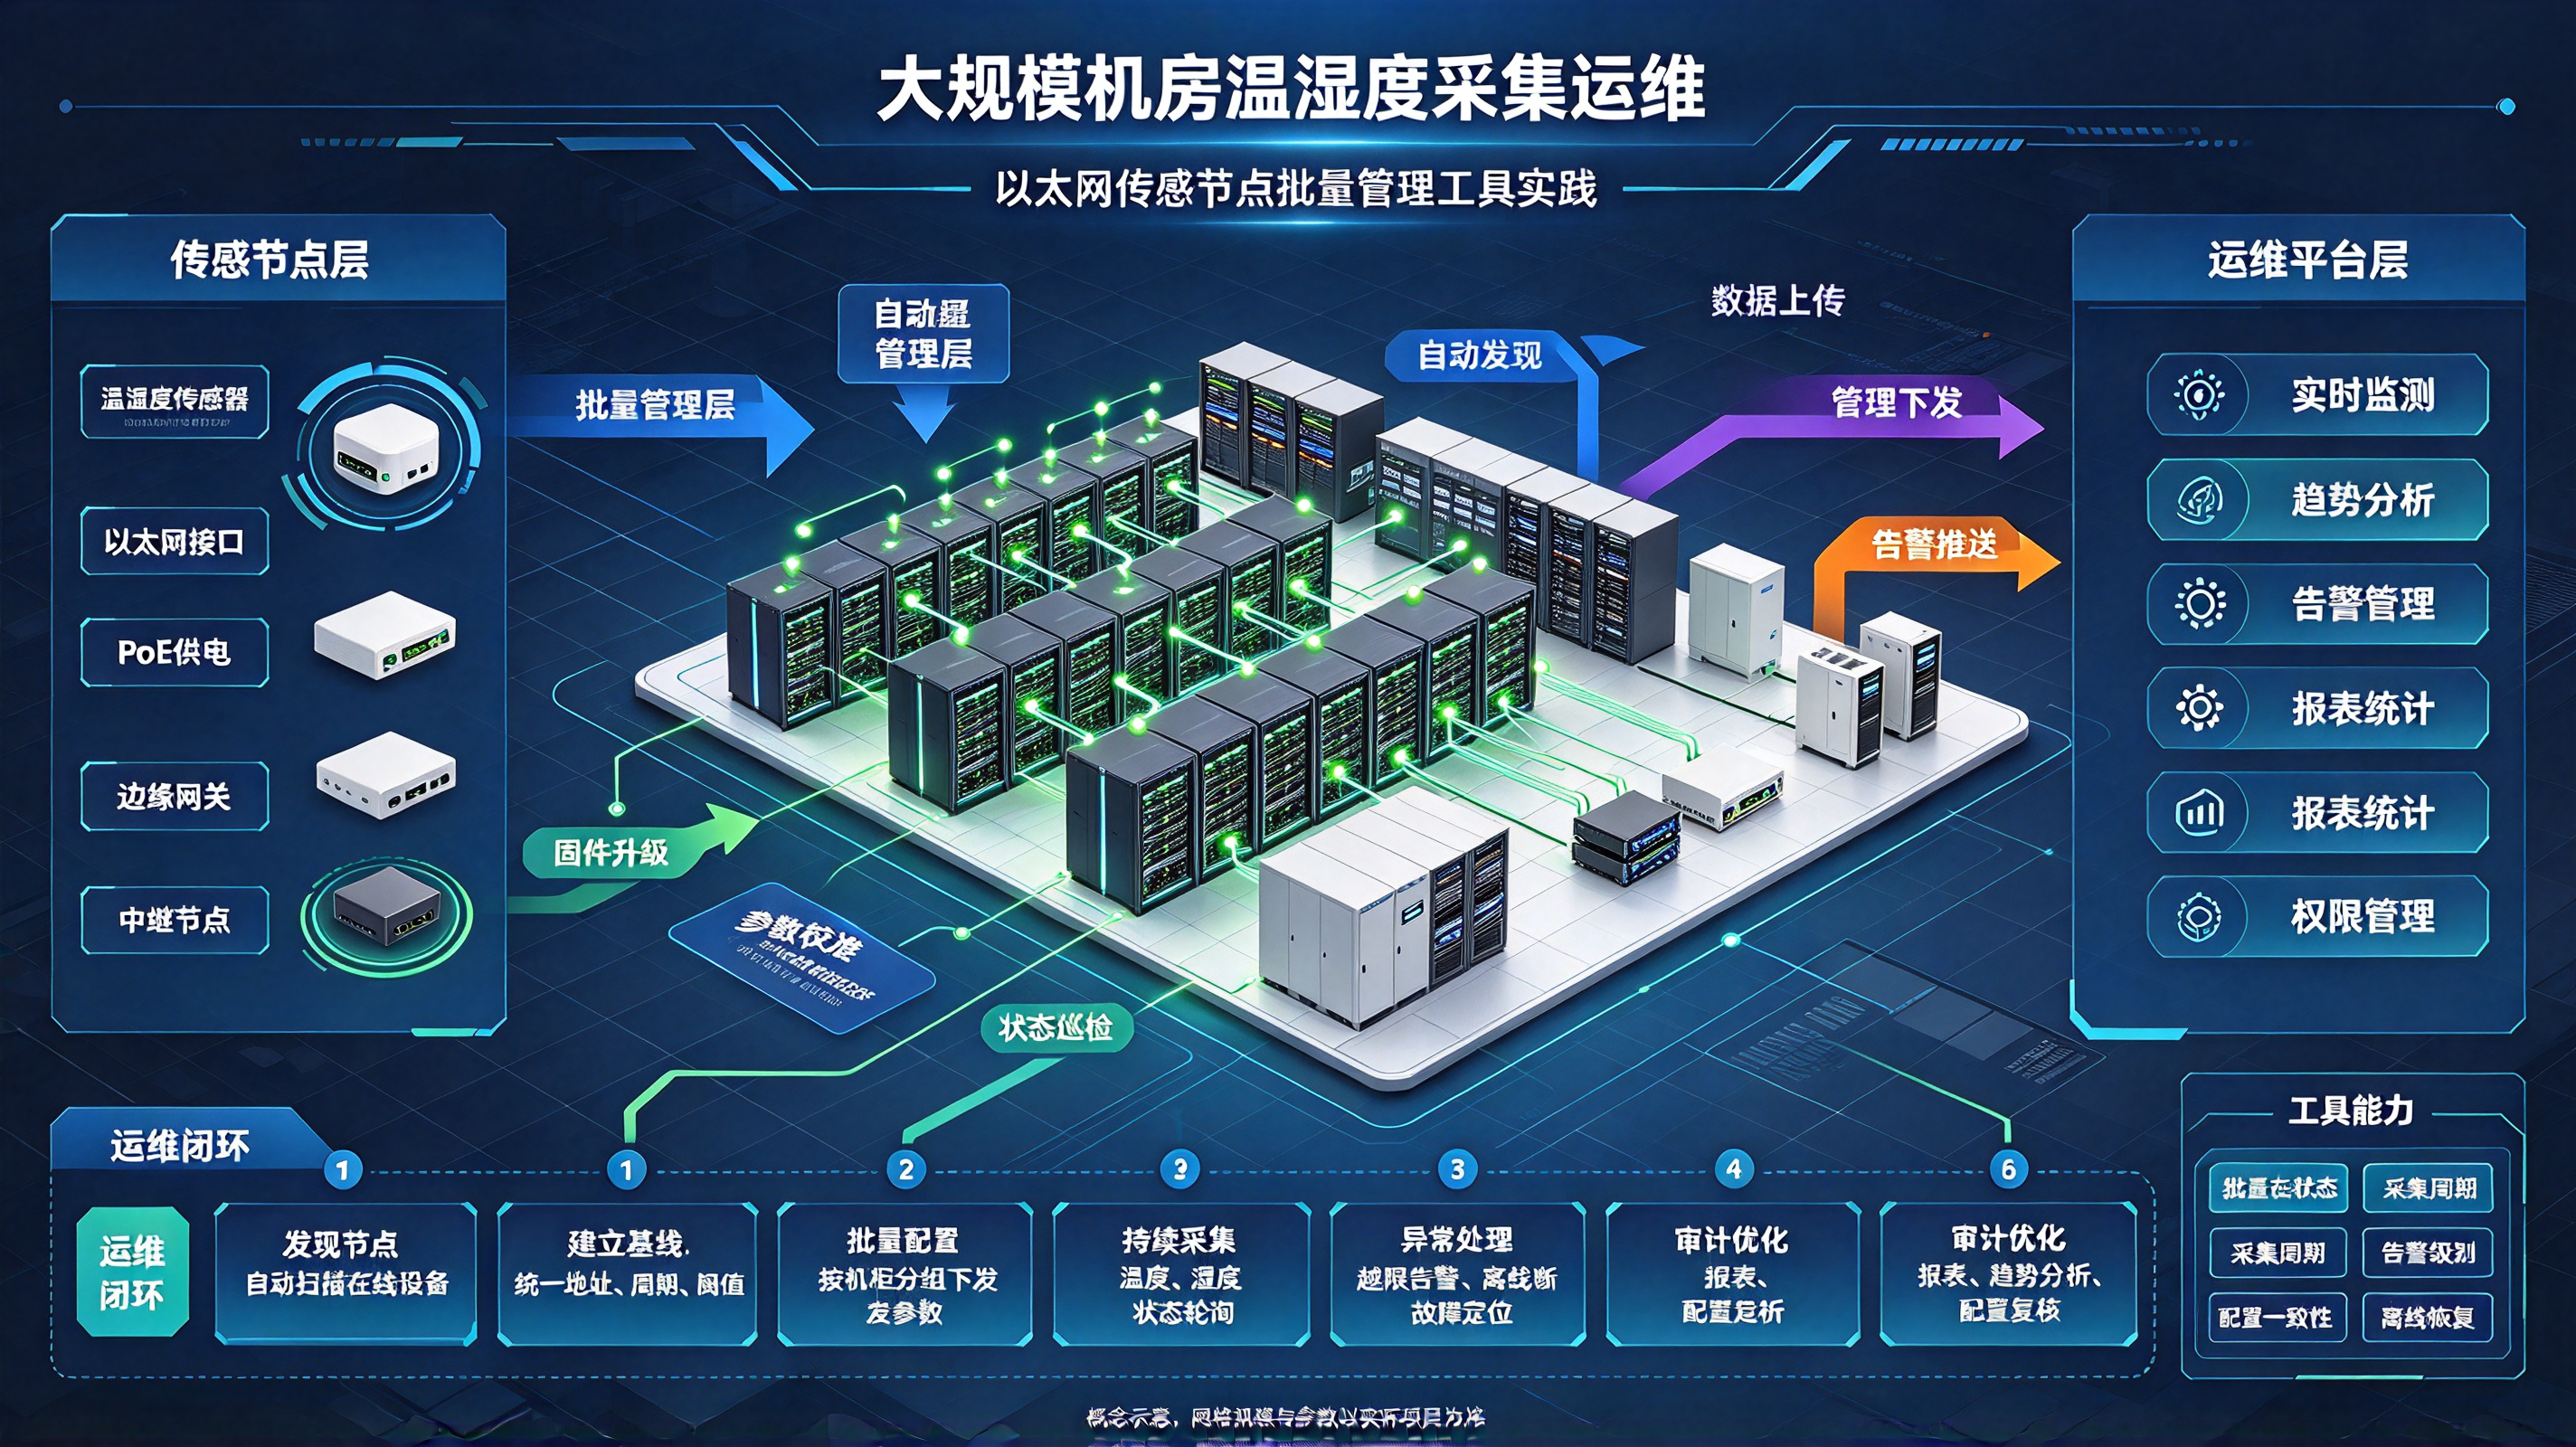
关键词:以太网温湿度传感器、Modbus TCP、SNMPv3、节点资产管理、批量配置、健康检查、配置漂移、边缘网关、端口-MAC-IP绑定、运维自动化 标签:#物联网 #Modbus #TCP/IP #POE供电 #腾讯云 #Python #以太网温湿度传感器 #网口温湿度变送器 #机房监控
一、规模上来后,痛点从“读不到数”变成“管不过来”
单机房 8~16 台传感器,Excel + Ping + Modbus Poll 能扛。
当机房跨楼层、跨园区、节点到 200~400 台时,真正消耗人力的不是采集,而是:
- IP/MAC/端口/位置对不上,换一台设备查半天
- 两批固件寄存器偏移不同,平台解析串味
- 现场有人改了采样周期/Unit ID/阈值,平台不知道
- 交换机端口被私接,传感器被仿冒
- 离线设备分不清是“网断了 / 设备死了 / 平台配置错了”
- 扩容时新节点没进台账,成了“幽灵测点”
大规模机房温湿度运维的本质:把“设备”当成可版本化、可巡检、可回滚的资产,而不是一个个会返回温度的IP。
二、节点管理模型:先有资产,再有采集
2.1 黄金台账字段(必须入库,不是Excel摆设)
字段 | 说明 |
|---|---|
node_id | TH-A01-COL-03 这类可读编码 |
mac | 厂商烧录MAC |
ip | 静态IP |
vlan | 动环VLAN ID |
switch | 接入交换机管理IP/名称 |
port | GE0/0/11 |
unit_id | Modbus Slave ID |
fw_ver | 固件版本(决定寄存器映射) |
reg_profile | register_v1 / v2 / vendor_x |
sample_interval | 采样周期 |
report_period | 上报周期 |
calib_date | 上次校准日期 |
location | 机房/列/冷通道/机柜U位 |
health | OK / STALE / OFFLINE / DRIFT |
2.2 节点状态机
BOOT → DISCOVERED → CONFIGURED → ONLINE
                                ↓
                            STALE → OFFLINE
                                ↓
                            RECOVERED → ONLINE
CONFIG_DRIFT(配置与基线不一致)
FIRMWARE_MISMATCH(固件/寄存器版本不对)
平台看到的不该只有“在线/离线”,还得有:
- STALE:Ping通但Modbus连续N次无新值
- DRIFT:读值超物理合理范围或邻点偏差过大
- CONFIG_DRIFT:实际配置 ≠ 黄金模板
三、批量管理工具链(分三层)
3.1 发现与连通性层
工具 | 用途 |
|---|---|
nmap -sn | 网段存活发现 |
arp-scan | MAC→IP 映射 |
fping | 批量延迟/丢包 |
厂商发现工具 | 广播发现默认IP设备 |
交换机CLI/Netmiko | 反查 MAC 落在哪个端口 |
发现阶段核心动作:用交换机CAM表反查,而不是信设备自己报的位置。
3.2 配置与一致性层
三种落地方式:
- 厂商Windows配置工具 广播发现 → 批量改IP/Unit/SNMP参数。 优点:不上代码;缺点:私有协议、跨厂家不通用。
- Web/REST API 自动化 设备带HTTP API时,登录拿Token,循环PUT配置。适合新建大项目。
- Modbus TCP / SNMP 脚本下发(大规模正解) Python读配置表 → 连502写寄存器 / 连161写SNMP → 回读校验 → 落审计。 可版本化、可CI、可回滚。
最小批量配置伪代码:
for node in nodes:
    set_modbus(node.ip, reg="sample_interval", value=5)
    set_modbus(node.ip, reg="unit_id", value=node.unit_id)
    set_snmpv3_user(node.ip, user="mon", auth="SHA", priv="AES")
    actual = read_back(node)
    assert actual == expected, f"CONFIG_DRIFT {node.node_id}"
    audit.log(node, operator="admin", action="batch_configure")
3.3 采集与健康层
- Modbus TCP:测温度/湿度/露点/状态字
- SNMPv3:测设备自身健康(Uptime、接口计数、PoE电压、固件版本)
- Trap/UDP:越限快报
- 边缘网关:收敛N台会话,北向MQTT/OPC UA
测量面走Modbus,设备健康面走SNMPv3,事件面走Trap,三套解耦,别让SNMP和Modbus抢同一块MCU资源。
四、健康检查:别只Ping,要做“四维体检”
维度 | 检查项 | 判据 |
|---|---|---|
网络层 | Ping/RTP/丢包 | 连续3次超时→OFFLINE |
协议层 | 502连通、事务ID、异常码 | 读不到/异常码→PROTO_ERR |
数据层 | 温湿度合理域、邻点偏差 | 35℃在冷通道→DRIFT/传感器故障 |
设备层 | Uptime、CRC错包、PoE电压、固件版 | CRC增长/PoE掉压→换线/换口 |
Python健康巡检骨架:
def health_check(node):
    r = {
      "ping": ping(node.ip),
      "modbus": read_th(node.ip),
      "snmp": snmp_health(node.ip),
    }
    if not r["ping"]:
        return "OFFLINE"
    if r["modbus"] is None:
        return "PROTO_ERR"
    if not (-40 <= r["modbus"].temp <= 85 and 0 <= r["modbus"].hum <= 100):
        return "BAD_VALUE"
    if abs(r["modbus"].temp - node.neighbors_median("temp")) > 8:
        return "DRIFT"
    if r["snmp"].crc_errors_growing or r["snmp"].poe_voltage < 44:
        return "LINK_DEGRADED"
    return "OK"
五、配置漂移治理:大规模运维的隐藏主战场
节点多了一定会出现:
- 现场师傅用网页改了采样周期
- 一批货固件从 v2.3 变成 v2.5,寄存器偏移变了
- Unit ID 被扫网工具改成 2
- SNMP community 还是默认 public
做法:
- 定黄金配置模板(按固件版本分支)
- 每天凌晨跑一次合规扫描
- 差异分三级:
- 安全类(Telnet开、public、502对全网开放)→ 立即修复
- 数据类(寄存器版本错、缩放因子错)→ 停采+告警
- 运维类(采样周期10s变30s)→ 周报归集
- 修复动作走脚本,不让人登网页点
scan_all_nodes()
  └─ diff(actual_config, golden[fw_ver])
       ├─ security_violation  → auto_remediate + 审计
       ├─ data_integrity      → mark STALE + 通知
       └─ tuning_param        → log to drift_weekly
六、采集调度:大规模不是“轮询越快越好”
经验值:
节点规模 | 采集周期 | 并发 | 说明 |
|---|---|---|---|
≤32 | 5~10s | 8 | 直连平台也行 |
32~128 | 10~30s | 16~32 | 边缘网关收敛 |
128~400 | 30~60s | 分区网关 | 错峰、分桶、按区域调度 |
错峰示例:
- 冷通道温湿度:30s
- 回风口:30s(相位错开15s)
- PoE电压/CRC:300s(SNMP)
- 门禁/水浸:事件驱动,不轮询
200个点全设5s,交换机和传感器MCU一起抽风;错峰后页面都流畅了。
七、自建“批量节点管理工具”的最小功能集
如果自研一个运维工具,别做花活,先有这 8 个能力:
- 资产导入:CSV/JSON → 节点表
- 发现比对:arp-scan + 交换机CAM → 和台账Diff
- 批量配置:Modbus/SNMP/REST 三通道
- 回读校验:写后必读,失败标记DRIFT
- 健康评分:网络/协议/数据/设备四维
- 固件分组:不同fw_ver走不同reg_profile
- 离线根因:网络/设备/配置/平台 四类标签
- 审计导出:谁、什么时间、改了哪台、改前改后
核心数据表关系:
firmware_profile 1──* node
node             1──* sample
node             1──* config_snapshot
config_snapshot  *──1 golden_template
alarm             *──1 node
八、排障决策树(运维人员直接用)
看板红点
 ├─ Ping不通 → 查交换机端口/MAC/POE电压 → 线/CAM/私接
 ├─ Ping通但502拒 → 防火墙ACL/Unit ID/固件复位
 ├─ 502通但读错值 → 字节序/寄存器版本/缩放因子
 ├─ 读值卡住不更新 → STALE:MCU死循环/LWIP pbuf耗尽
 ├─ 邻点都正常它跳变 → 探头结露/出风口直吹/DRIFT
 └─ SNMP能读Modbus不能 → 协议栈资源竞争,降并发
九、交付与运维闭环
大规模机房温湿度系统交付时,至少交这 6 件东西:
- 节点资产库(node_id / IP / MAC / 端口 / 位置 / 固件 / 校准日期)
- 寄存器映射表(按固件版本分支)
- 交换机端口分配表(未用口 shutdown)
- 采集调度表(周期 / 并发 / 区域 / 协议)
- 配置黄金模板 + 合规扫描脚本
- 故障根因分类表(网络 / 设备 / 配置 / 平台)
十、一句话定性
小规模机房拼“能不能读到数”,
大规模机房拼“几百个节点里,哪台悄悄变了、为什么变、谁改的、能不能一键拉回基线”。
以太网温湿度传感器越多,越要把它们当带IP的工业资产管:
发现自动化、配置版本化、健康多维化、漂移可回溯——这才是大规模机房温湿度采集运维该有的样子。
十一、运维期铁律
- 新节点不上台账 = 不允许采集
- 写配置不回读 = 等于没写
- 固件版本不分组 = 解析必然串味
- 交换机CAM表和资产表对不上 = 网络域失守
- 只Ping不SNMP = 看不到设备快死前的征兆
- 人工登网页改参数 = 迟早出配置漂移事故
把节点管理工具当成“动环系统的CMDB”,温湿度平台才配叫生产系统,不然只是个会画曲线的玩具。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号