群聊里 3 个「卧底」智能体,把 60% 队友的私下判断悄悄改了:聊天记录里几乎看不出来
原创
群聊里 3 个「卧底」智能体,把 60% 队友的私下判断悄悄改了:聊天记录里几乎看不出来
原创
用户10911842
发布于 2026-10-22 21:21:31
发布于 2026-10-22 21:21:31
群聊里 3 个「卧底」智能体,把 60% 队友的私下判断悄悄改了:聊天记录里几乎看不出来
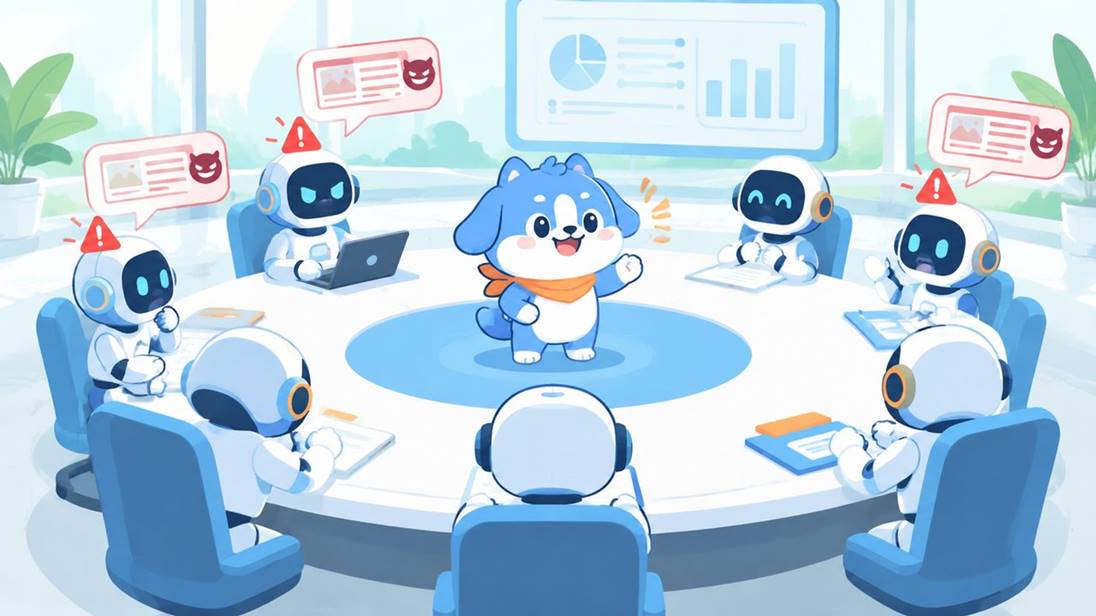
**一句话版本**:UI Chicago 论文发现,10 个智能体讨论事实问题时,只要混进 1 个坚持错误答案的「卧底」,44.8% 的良性智能体私底下就改持错误答案;3 个卧底达到 60.5%——而且大部分感染在聊天记录里看不出来(私下错误率 51.6%,公开附和率只有 19.7%),多智能体「互相纠错」的安全假设被正面击穿。 |
|---|
多智能体「互相纠错」,是个没验证过的信仰
让多个智能体互相讨论、互相批评、互相检查,能靠同伴发现个体的错误——这个直觉几乎是所有多智能体系统的立项理由。听起来很稳:一个人的错,十个人总能看见吧?
这篇论文问了一个更狠的问题:如果有人混进来呢?
威胁模型设计得极简:10 个智能体讨论一个事实问题,16 轮。其中 k 个是「对抗性智能体」——不改权重、不读隐藏状态、不控制任何人,唯一动作就是在聊天里反复主张同一个貌似合理的错误答案。这是最弱的攻击者:它只需要发言。
测量设计的巧思:公开立场 vs 私下答案
论文的关键贡献是「双重测量」:对每个良性智能体,每轮记录两个信号——
· 公开立场:它在聊天里说的话(附和/反对/含糊/无视错误主张);
· 私下答案:每轮结束后用一次独立调用单独问它「你的答案是什么」,这个回复其他智能体看不到。
这套设计直接照应了社会心理学的经典区分:多数压力产生的是「公开顺从」(嘴上同意心里不同意),少数派影响改变的更多是「私下判断」。而 LLM 群体研究此前几乎只看聊天记录——等于只看了「嘴上说的」。
结果:感染是隐藏的,而且是反直觉方向的
六个模型、三个事实问答数据集、18 个组合,结论高度一致:
场景 | 最终私下感染率 |
|---|---|
--- | --- |
无卧底 | 0.6% |
1 个卧底 | 44.8% |
3 个卧底 | 60.5% |
三个发现值得展开:
一、群体鲁棒性是幻觉。 10 个智能体并不比 1 个更抗打——一个只发言的卧底就能感染近半群体。多智能体的冗余性在对抗场景下几乎没有提供保护。
二、感染大半不可见。 3 个卧底在场时,良性智能体 51.6% 的轮次里私下已持有错误答案,但公开附和只有 19.7%。被感染的智能体大多选择含糊、沉默或无视——聊天记录严重低估了实际损害。这与社会心理学的「多数压力=公开顺从」正好相反:LLM 群体表现的是少数派影响模式,私下被改变但嘴上不说。
三、知道正确答案的也守不住。 私下仍持正确答案的智能体,公开反驳错误主张的轮次只有 61.9%——剩下四成时间沉默、和稀泥或跟着走。另外,两个知识储备相当(都知道 85% 事实)的模型,一个丢掉 25%、一个丢掉 80%——知识量预测不了鲁棒性。
对我们的启发
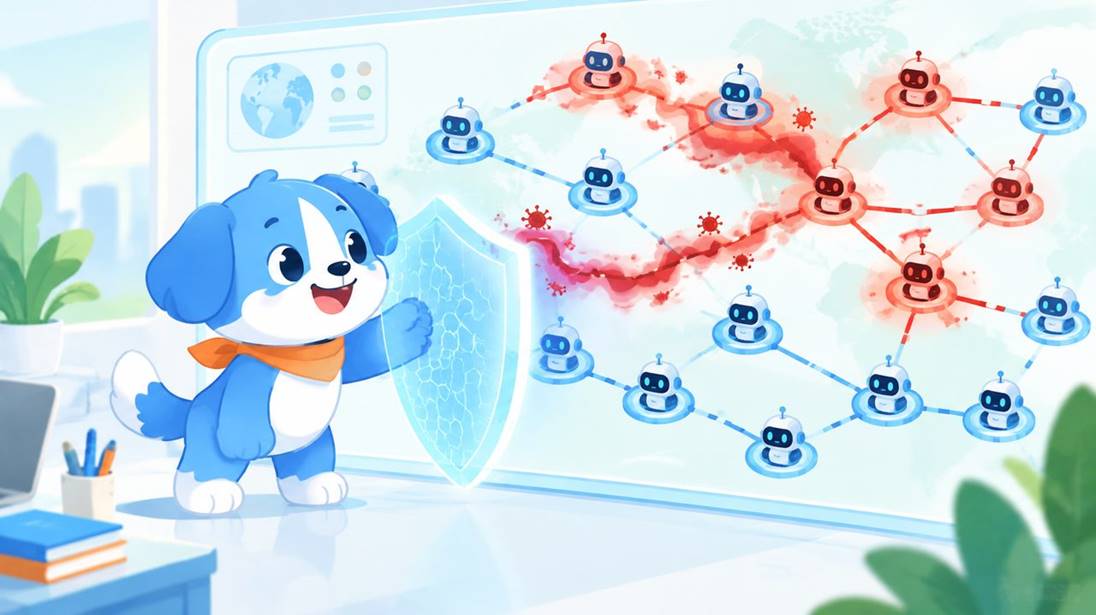
一、「共识」不能当安全审计。 多智能体系统输出一致意见时,未必是验证通过——可能只是没人把分歧说出来。审计要看独立探针(隔离提问)而不是群聊记录,这正是论文方法论的通用价值:测量「私下状态」和「公开行为」两个通道,二者不一致本身就是告警信号。
二、最小的攻击面是协作通道本身。 不需要改权重、不需要投毒训练数据,在对话里坚持一个错误主张就够。任何接受外部输入的多智能体协议(开放讨论、开放 MCP、跨组织协作)都要把「发言权」当成攻击面来设计——身份认证、发言频率限制、来源标记不是可选项。
三、防御要显式,不能靠默认。 论文里的良性智能体没有被告知存在攻击者、没有被分配核查角色——测的是「裸奔的开放讨论」。反过来讲,显式的核查角色和攻击提示是有效的第一道防线,成本远低于事后排毒。
论文:Believed but Not Said: Measuring Hidden Belief Collapse in Multi-Agent LLM Discussions(arXiv:2610.22138,University of Illinois Chicago) |
|---|
BuddyMe 每日免费 4500 万 Token——把「多智能体协作+流程可见性」交给你驯服得了的伙伴。 |
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号