删掉 EXIF 也藏不住:一张照片的拍摄点,是怎么被算到 2 米的
原创
删掉 EXIF 也藏不住:一张照片的拍摄点,是怎么被算到 2 米的
原创
大盘鸡拌面
发布于 2026-10-23 11:53:20
发布于 2026-10-23 11:53:20
先说个事
前阵子朋友发来一张照片。稻田,中间一条高架桥斜着穿过去,远处一排山,天色有点灰。没有路牌,没有车牌,没有店招,连根电线杆都没露脸。
他问:你猜这是哪儿。
我第一反应是看属性。EXIF 是空的。微信转过来的图,早就被压过一遍,坐标、机型、拍摄时间全没了。
第二反应是扔给视觉大模型。它很配合,回我一句「这看起来像中国南方的乡村地区」。
……行吧。这话我也能说。
真正把这件事做成的,是 GitHub 上一个叫 geo-sleuth 的项目,作者 Oldcircle,MIT 协议,三千多 star(数字一直在涨,你自己去看)。它本质上不是一个软件,而是一个 Agent Skill:给 Claude Code、Cursor、Codex、Gemini CLI 这类能跑 shell 命令的 AI 编程助手用的技能包。
先交代一句:朋友那张我最后没跑出来。他发的是压缩过的图,桥墩边缘糊成一片,远处山头还过曝了。这活儿对像素是有要求的,糊了就是糊了。
不过这一折腾,我把项目从头到尾读了一遍,反倒比拿到答案更有意思。
它干的事,一句话说完:不猜,去查。
一、它到底解决了什么问题
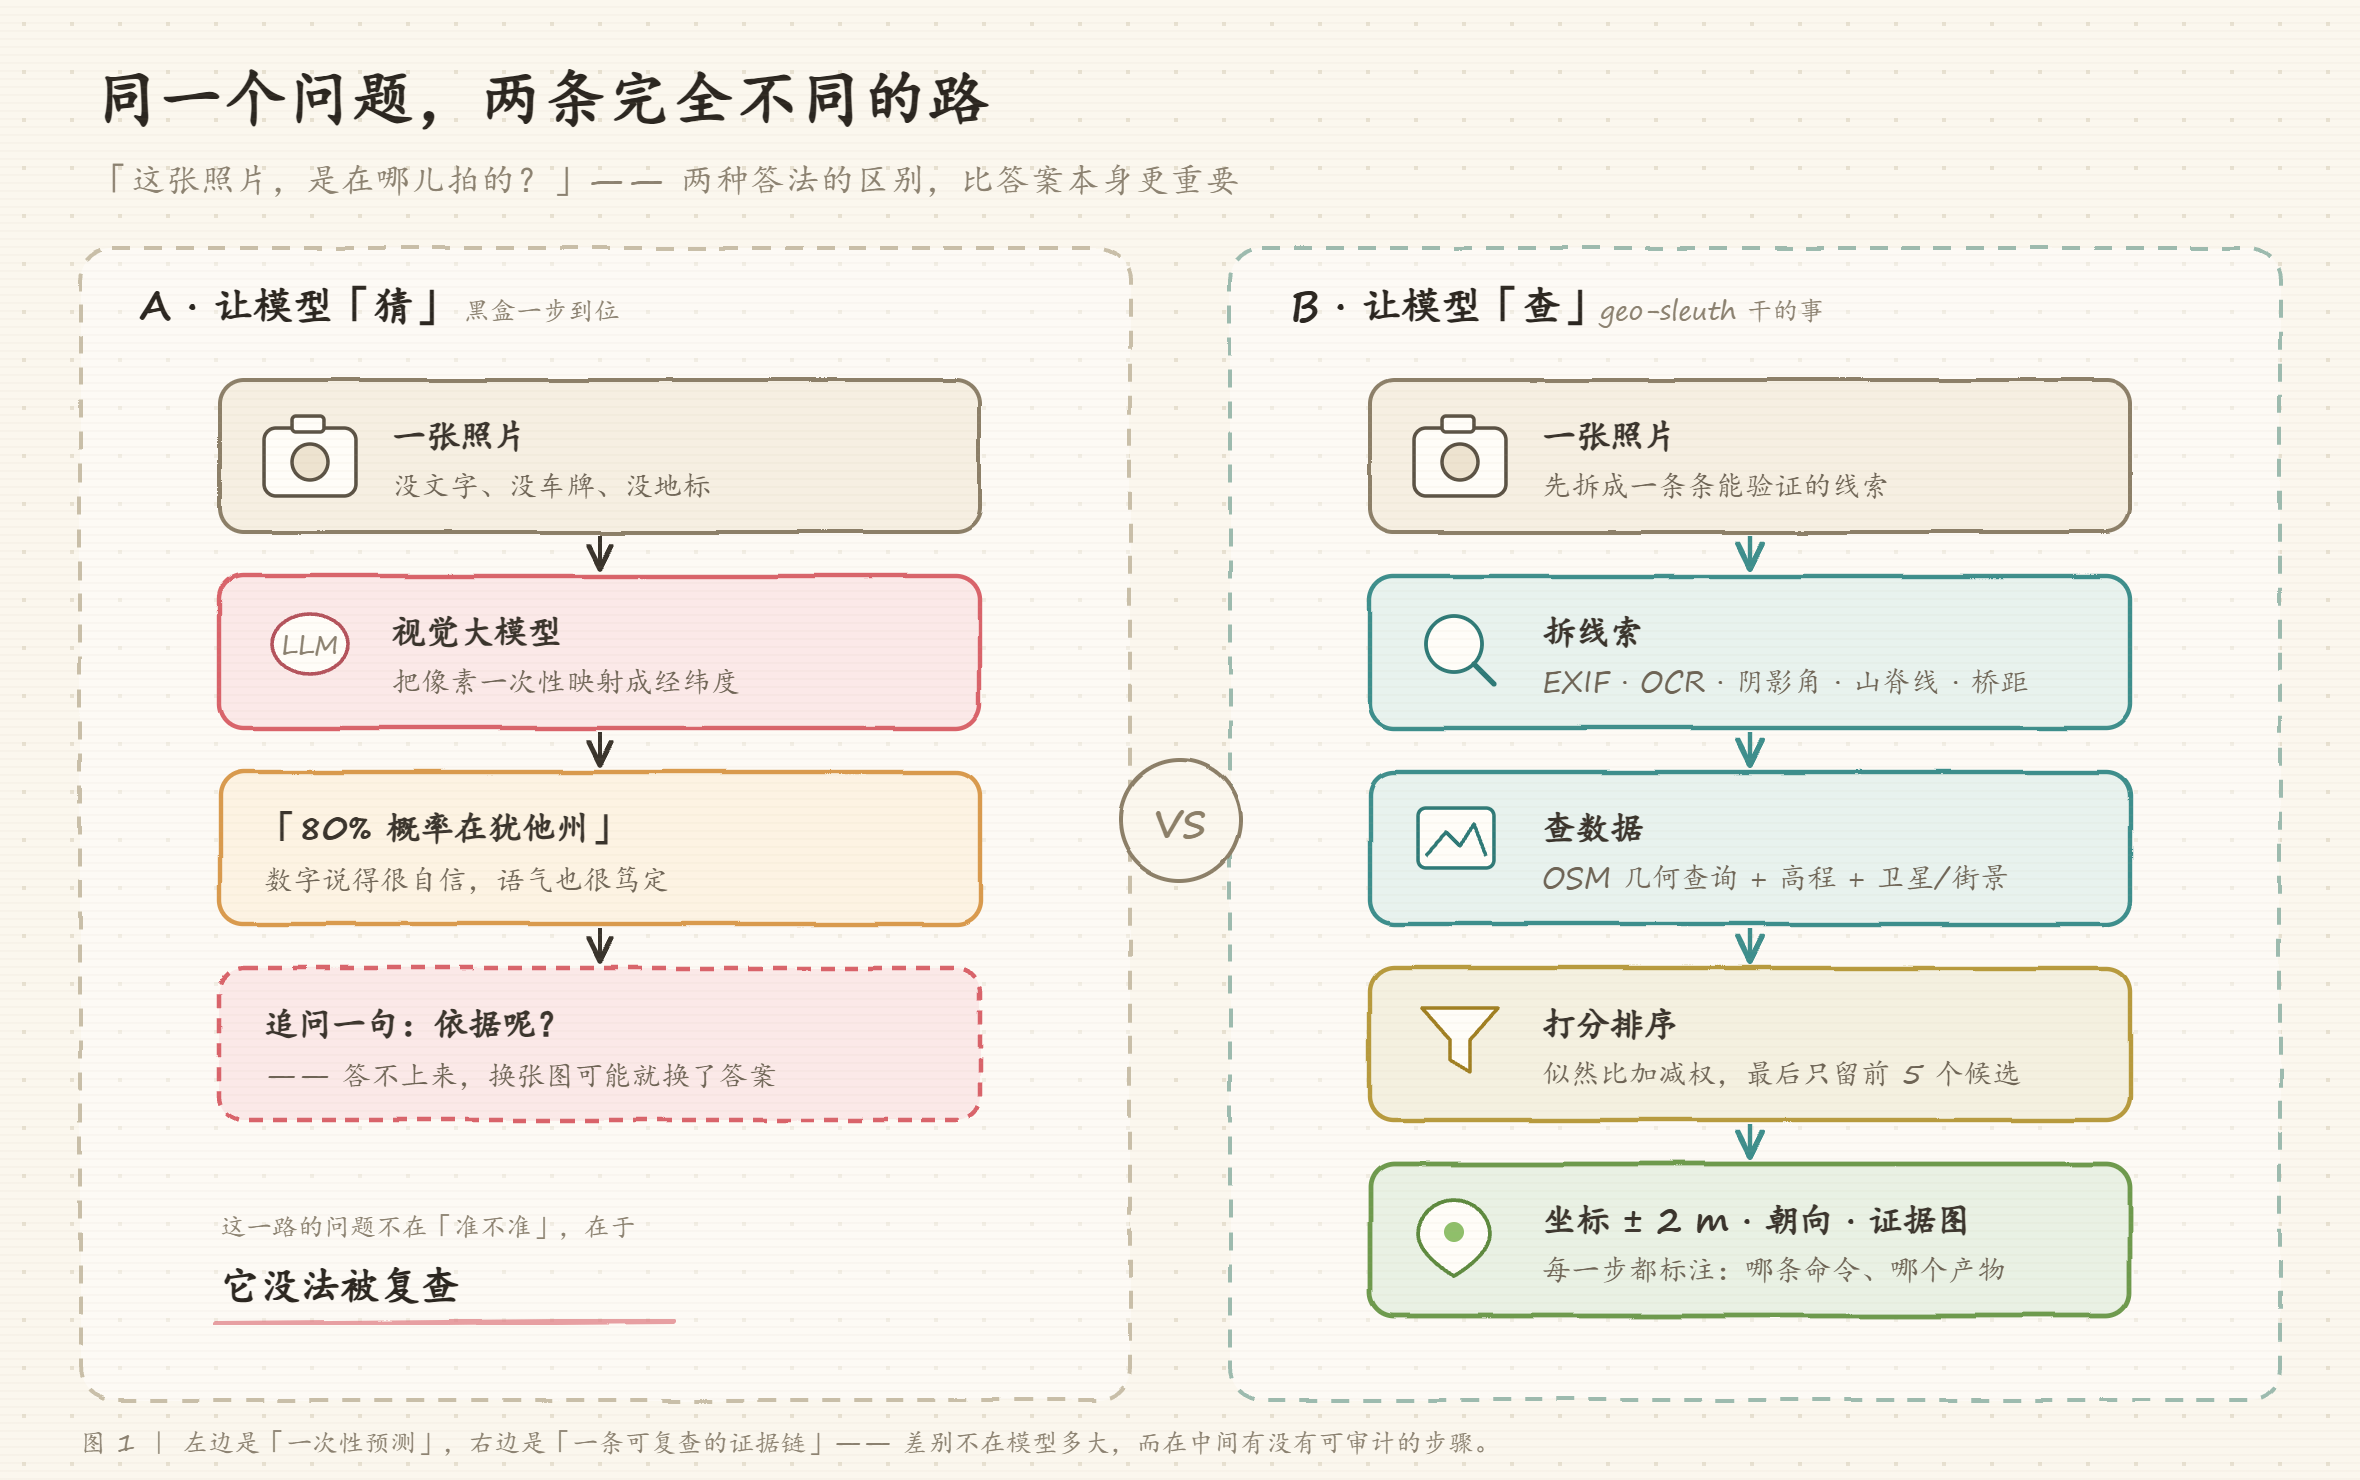
我们平时说的「AI 看图定位」,主流做法是把图片扔进一个视觉模型,模型直接吐一个经纬度。GeoSpy、GeoCLIP、EarthKit 基本都属于这一路。
好用是真挺好用。你扔一张时代广场,它秒回纽约。
问题也很明显,两个:
第一,它没法被复查。 你问它为什么是犹他州,它说不出来。你换一张同地点的照片,它可能给你另一个州。这种「一次性预测」,碰上要写报告、要复核、要担责任的场景,基本没法用。
第二,它遇到没特征的自然风光就瘫了。 没有文字、没有建筑、没有招牌,纯荒野加一条山脊线,视觉模型的先验知识直接失效。而偏偏这种照片,才是真正需要定位的那一类。
geo-sleuth 走的是完全相反的路:它不指望模型一眼看出来,而是把「定位」拆成一串可以执行的检查动作,每一步都产出文件,每个结论都能顺着文件倒查回去。
这个区别听起来有点抽象,我换个说法。
前者像算命先生看你一眼说「你今年犯小人」。后者像法医,先量伤口,再比对凶器,最后写一份你能拿去法庭的报告。
二、拆开看,是三层
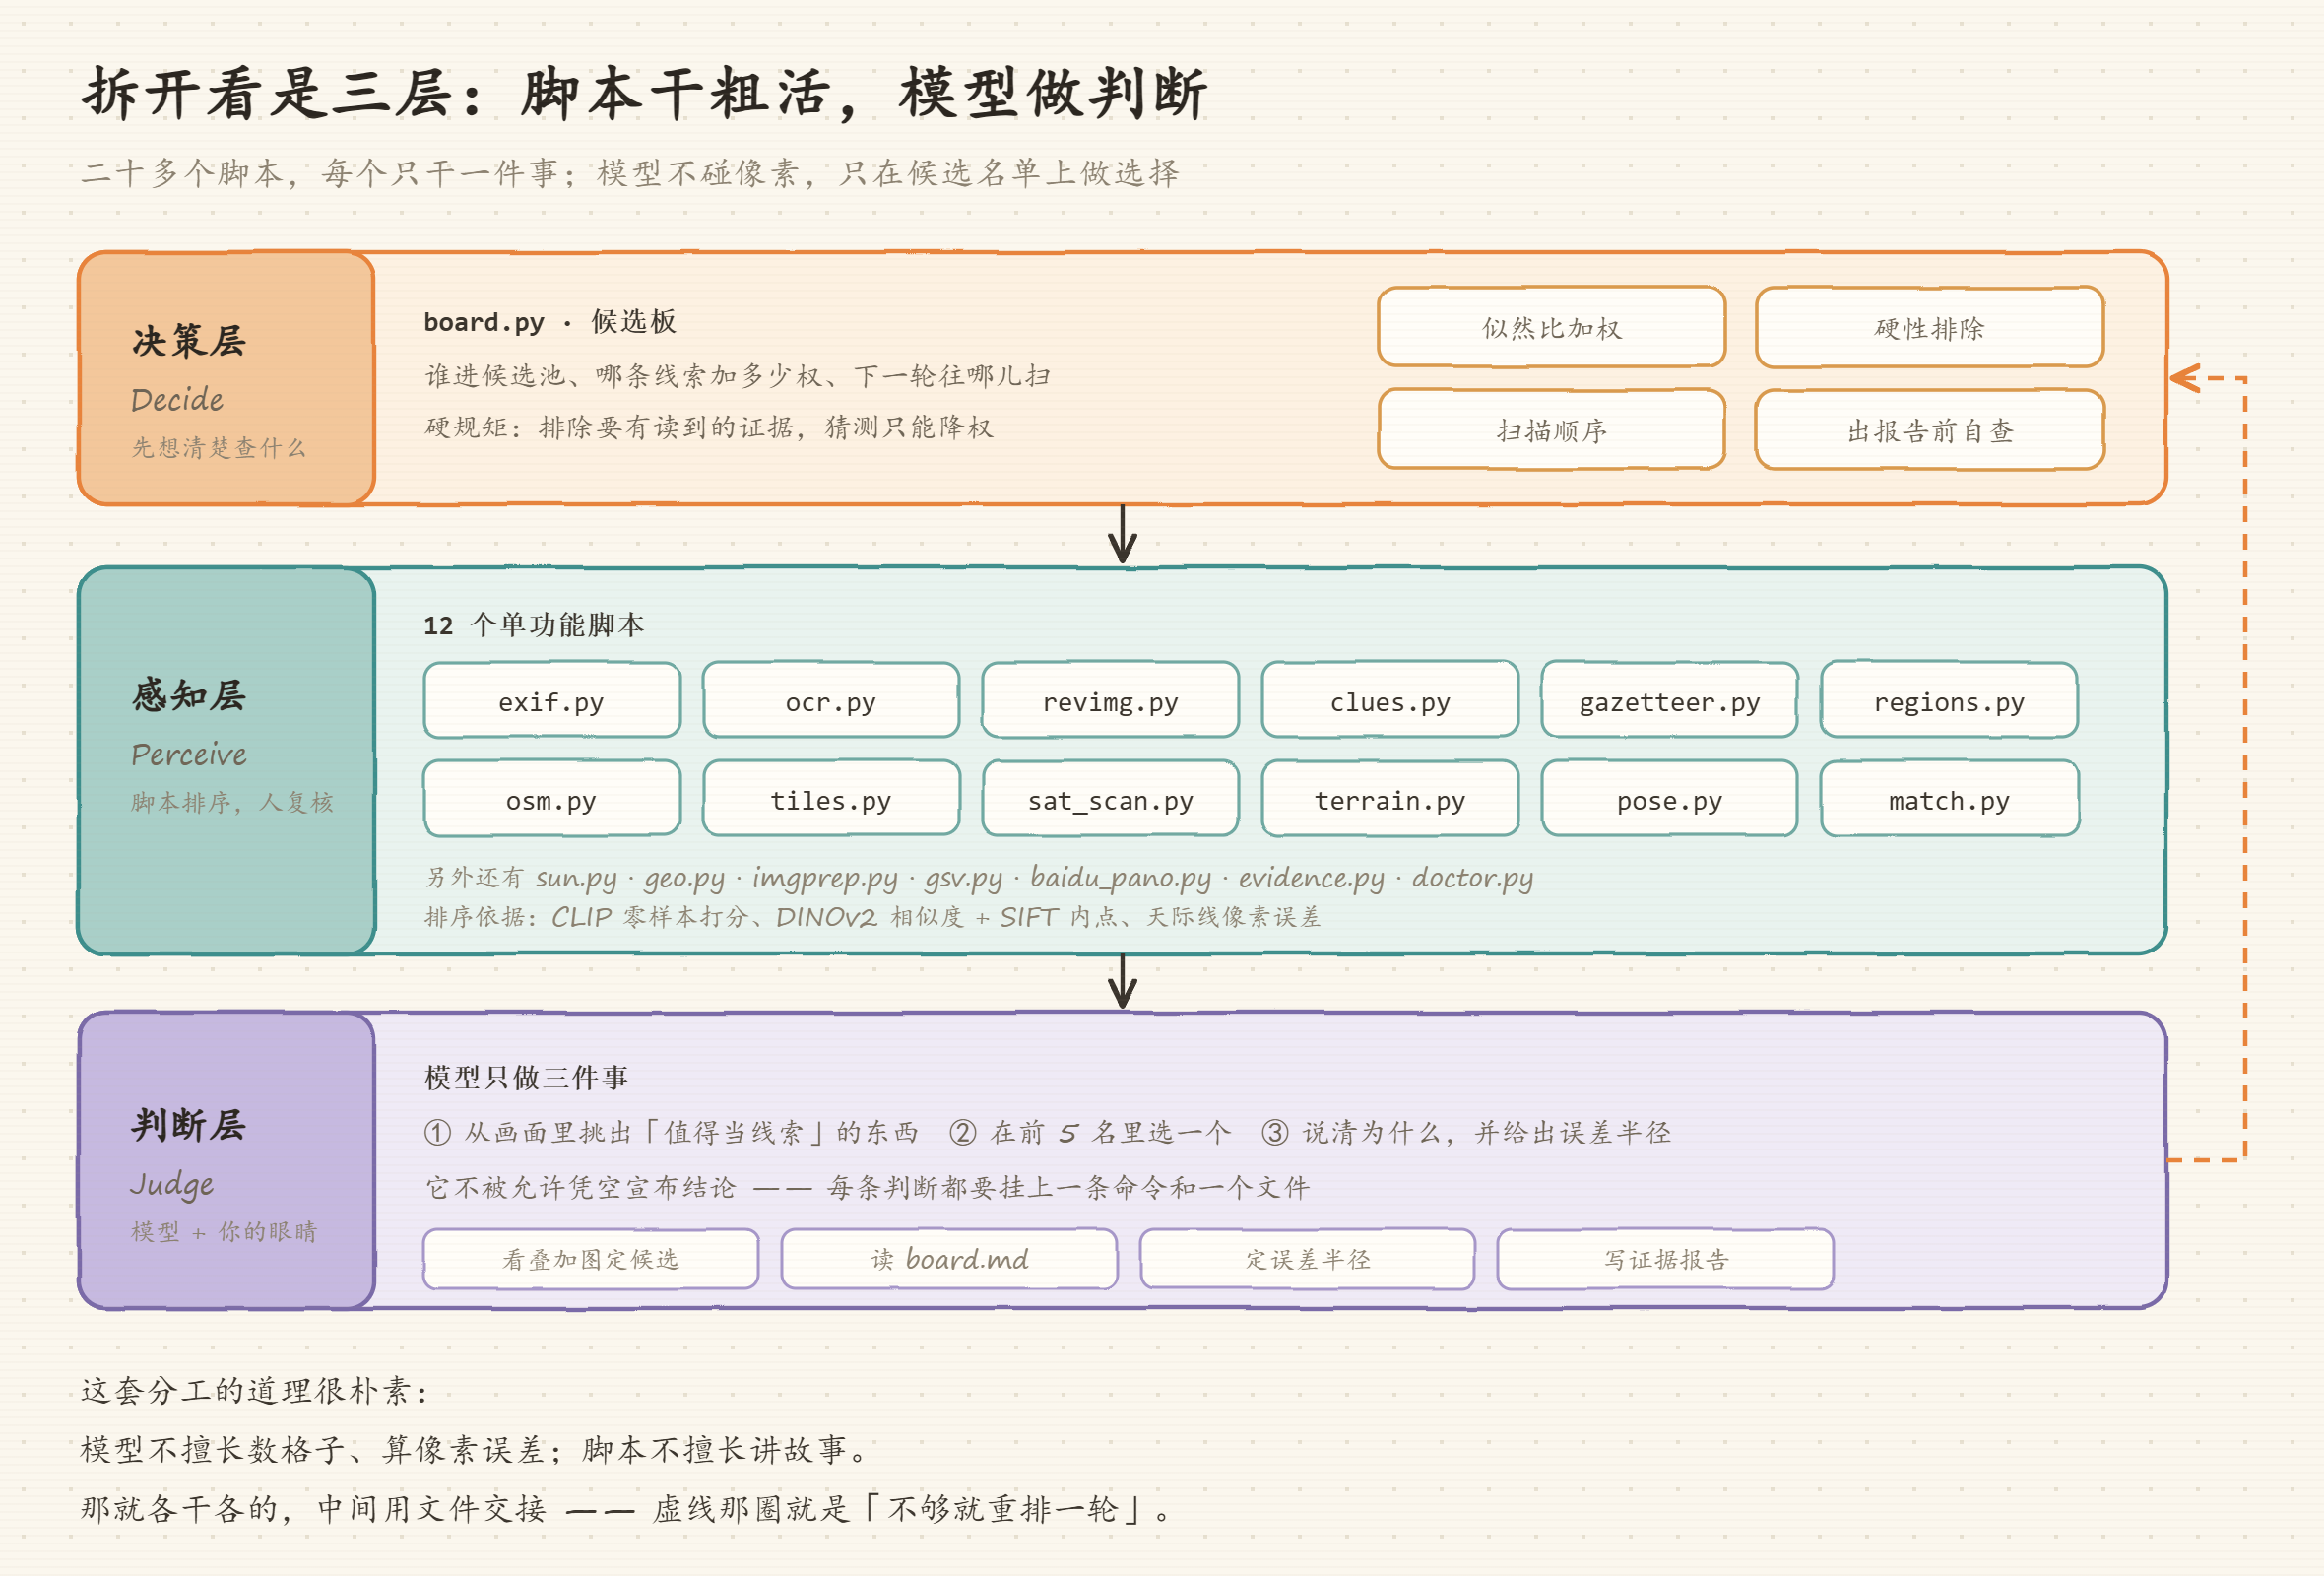
项目自己的文档里写得很清楚,整个东西分三层:决策、感知、判断。
我看完最服的一点,是它对「模型该干什么」的克制。
二十多个脚本,每个只干一件小事:读 EXIF 的、跑 OCR 的、查 Overpass 的、渲染天际线的、算相机位姿的。它们负责搜索、打分、排序。模型不碰像素,只做一件事:在排好序的前几名里挑一个,并说清为什么。
这里面有一条规则,我觉得是整个项目最有意思的地方:
排除一个候选,必须有「读到的证据」;观察和猜测,只能用来降低权重。
翻译成人话:你不能因为「这地方人多、有名、看着不像」就把候选划掉。要划掉,得拿出 EXIF 里的时间、路牌上的字、卫星图里的建成状态。而「我觉得像」这种话,最多只能让某个候选掉几分。
这条规则看着像洁癖,其实是整套方法能立住的地基。因为地理定位最容易翻车的地方,从来不是算错,是先有结论再找证据。
三、一张照片要走完的流水线
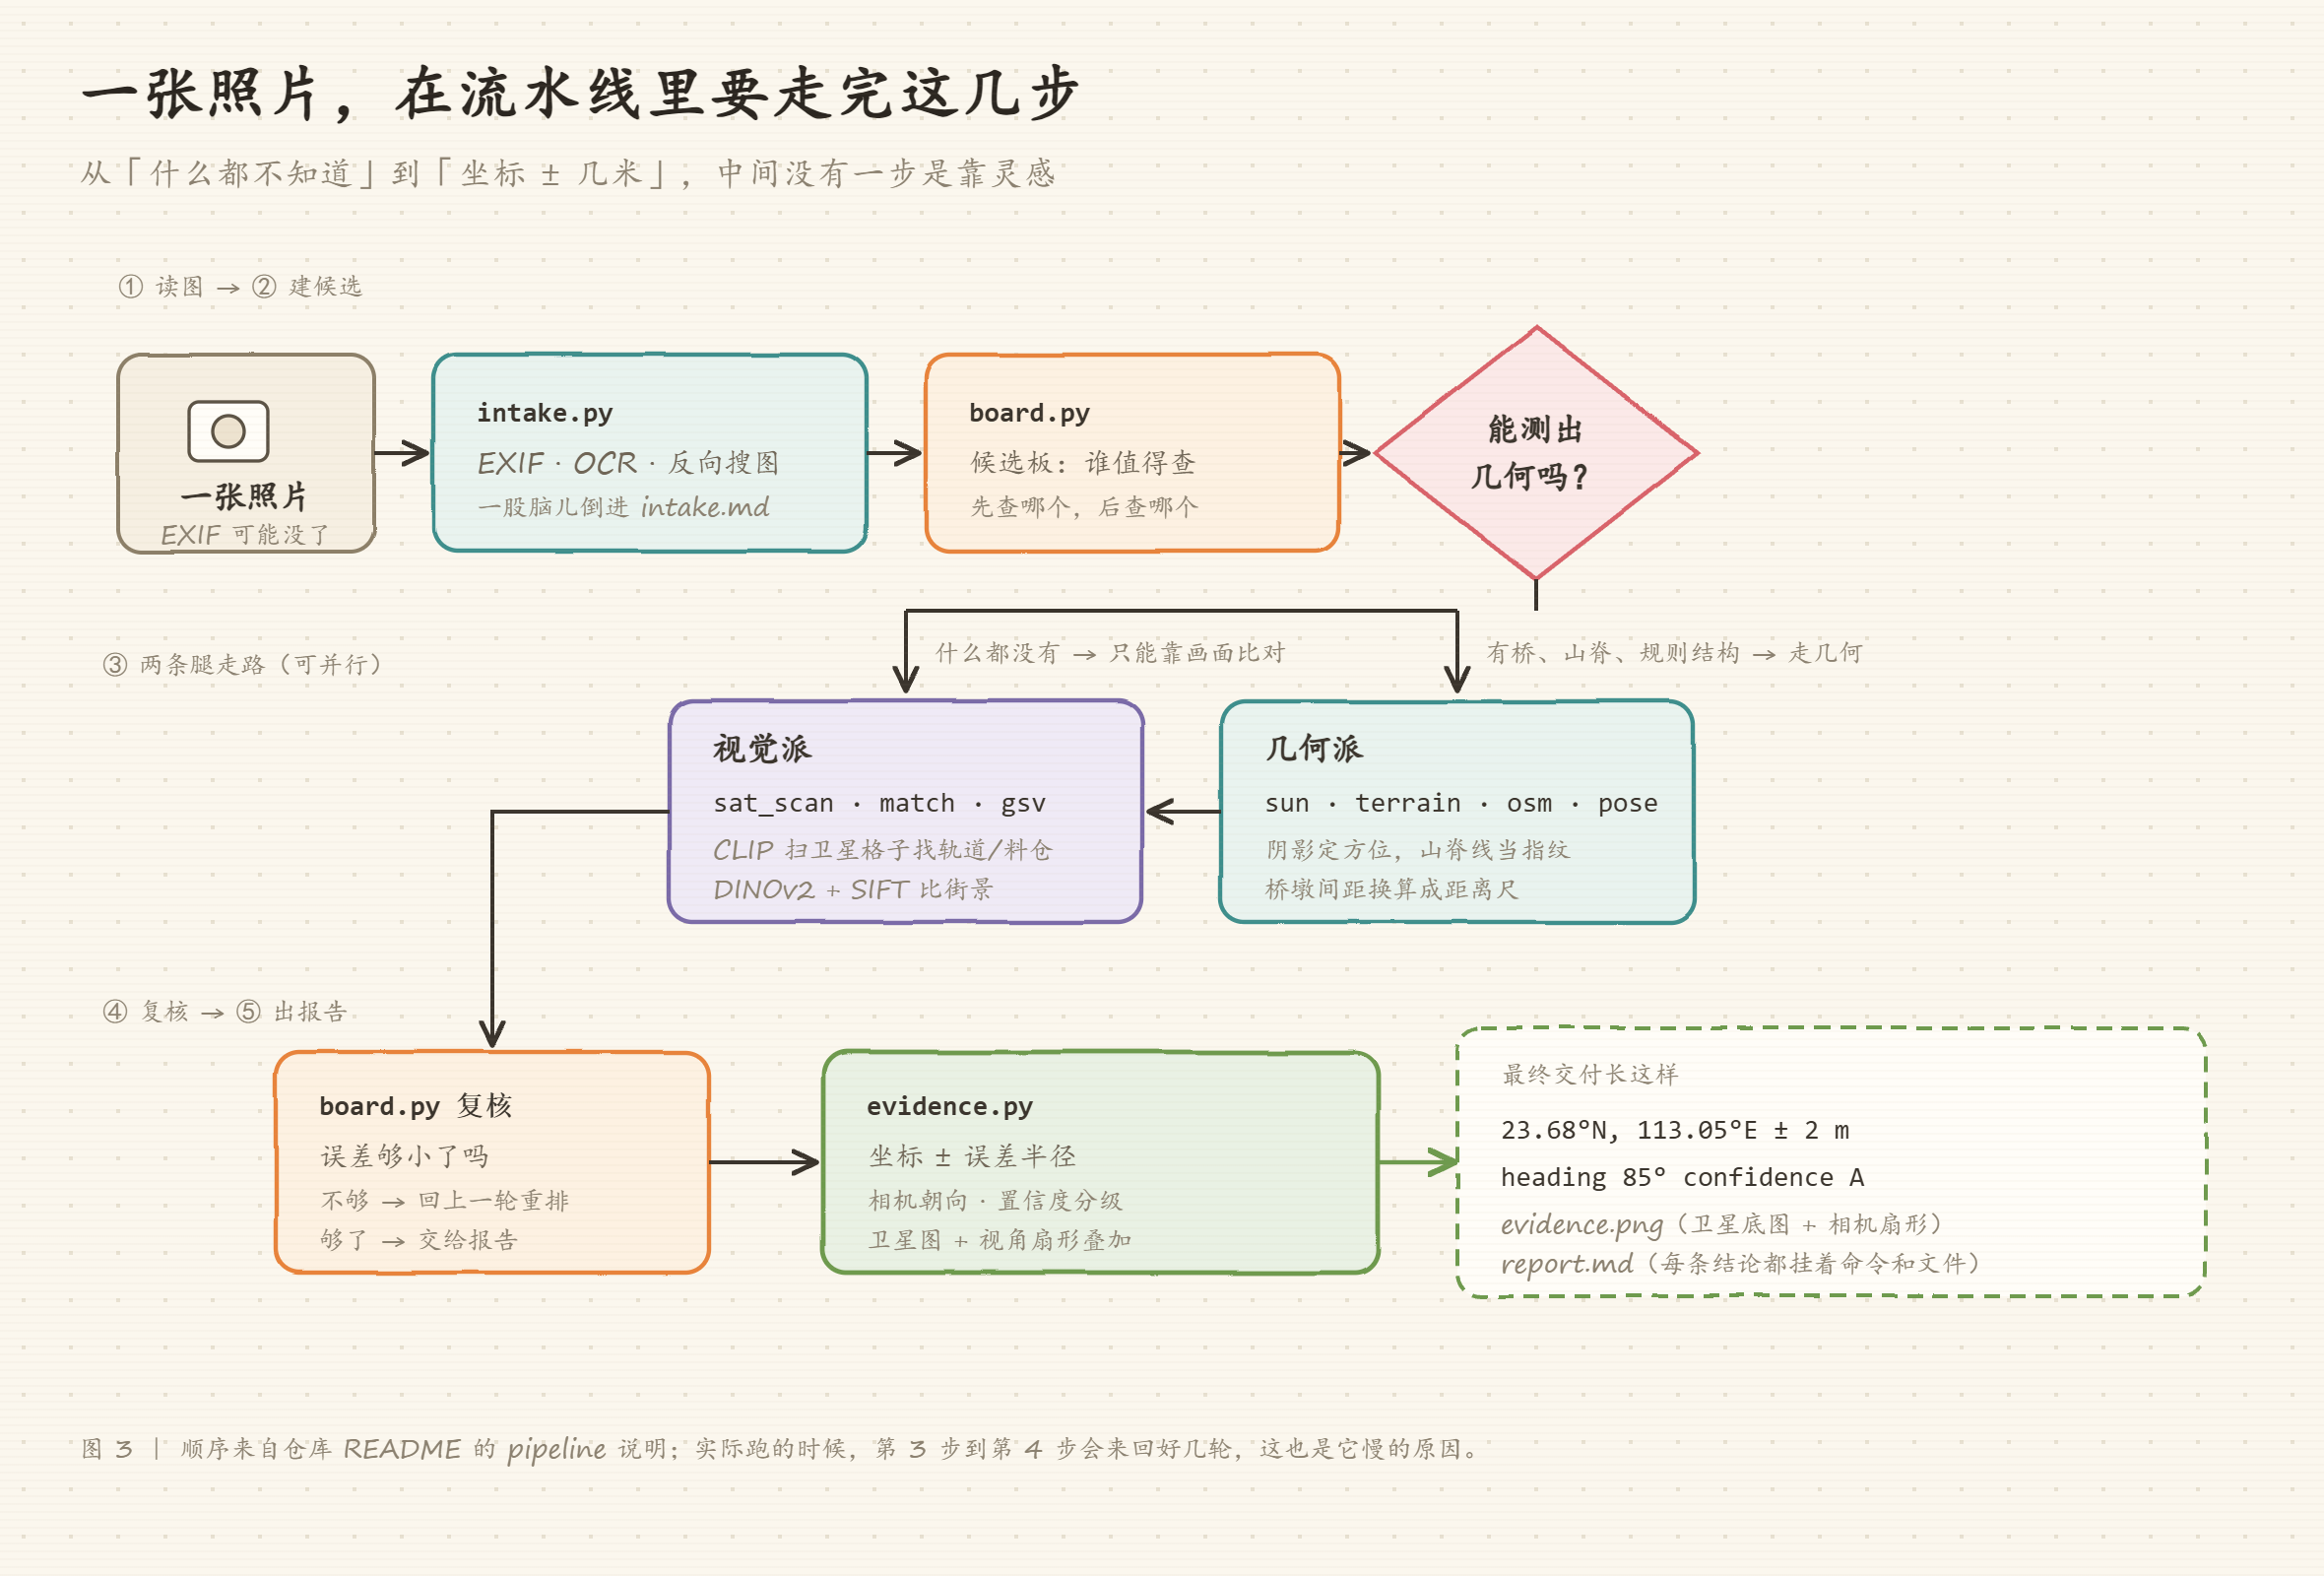
把三层摊平成时间线,大概是这么个顺序:
拆开说:
第一步,读图。 intake.py 一口气把能读的全读了:EXIF、OCR(整图 + 放大裁切 + 分块)、反向搜图(百度、Yandex)。读不到也没关系,它会把「读不到」这件事本身记下来。
第二步,建候选板。 board.py 把线索变成候选池,给每个候选算分、排序,然后告诉你下一步该往哪儿扫。这一步是纯脚本,没有模型参与。
第三步,分叉。 照片里如果有能测的几何——桥、铁轨、电线、规则的树列——就走几何派:用阴影反推方位(sun.py),用高程数据渲染山脊线做指纹比对(terrain.py),用 Overpass 查走廊和交汇(osm.py),最后解相机位姿(pose.py)。
如果没有能测的几何,就走视觉派:拿 CLIP 零样本扫卫星瓦片找特征物(sat_scan.py),拿 DINOv2 加 SIFT 比街景和全景(match.py、gsv.py、baidu_pano.py)。
第四步,复核。 回到 board.py,看误差够不够小。不够就重排一轮,够了才往下走。
第五步,出报告。 evidence.py 把卫星底图、相机视角扇形、对比网格拼成一张证据图,附上坐标、误差半径、朝向、置信度分级。
注意最后那点:它给你的不是一个光秃秃的坐标,是坐标 ± 误差半径。
这个细节很关键。「87 米以内」和「大概在青海」是两种完全不同的信息,前者能拿去干活,后者只能发朋友圈。
四、一次会话,时间线上是这样的
如果你用的是 Claude Code 这类 agent,整个交互过程大概是:
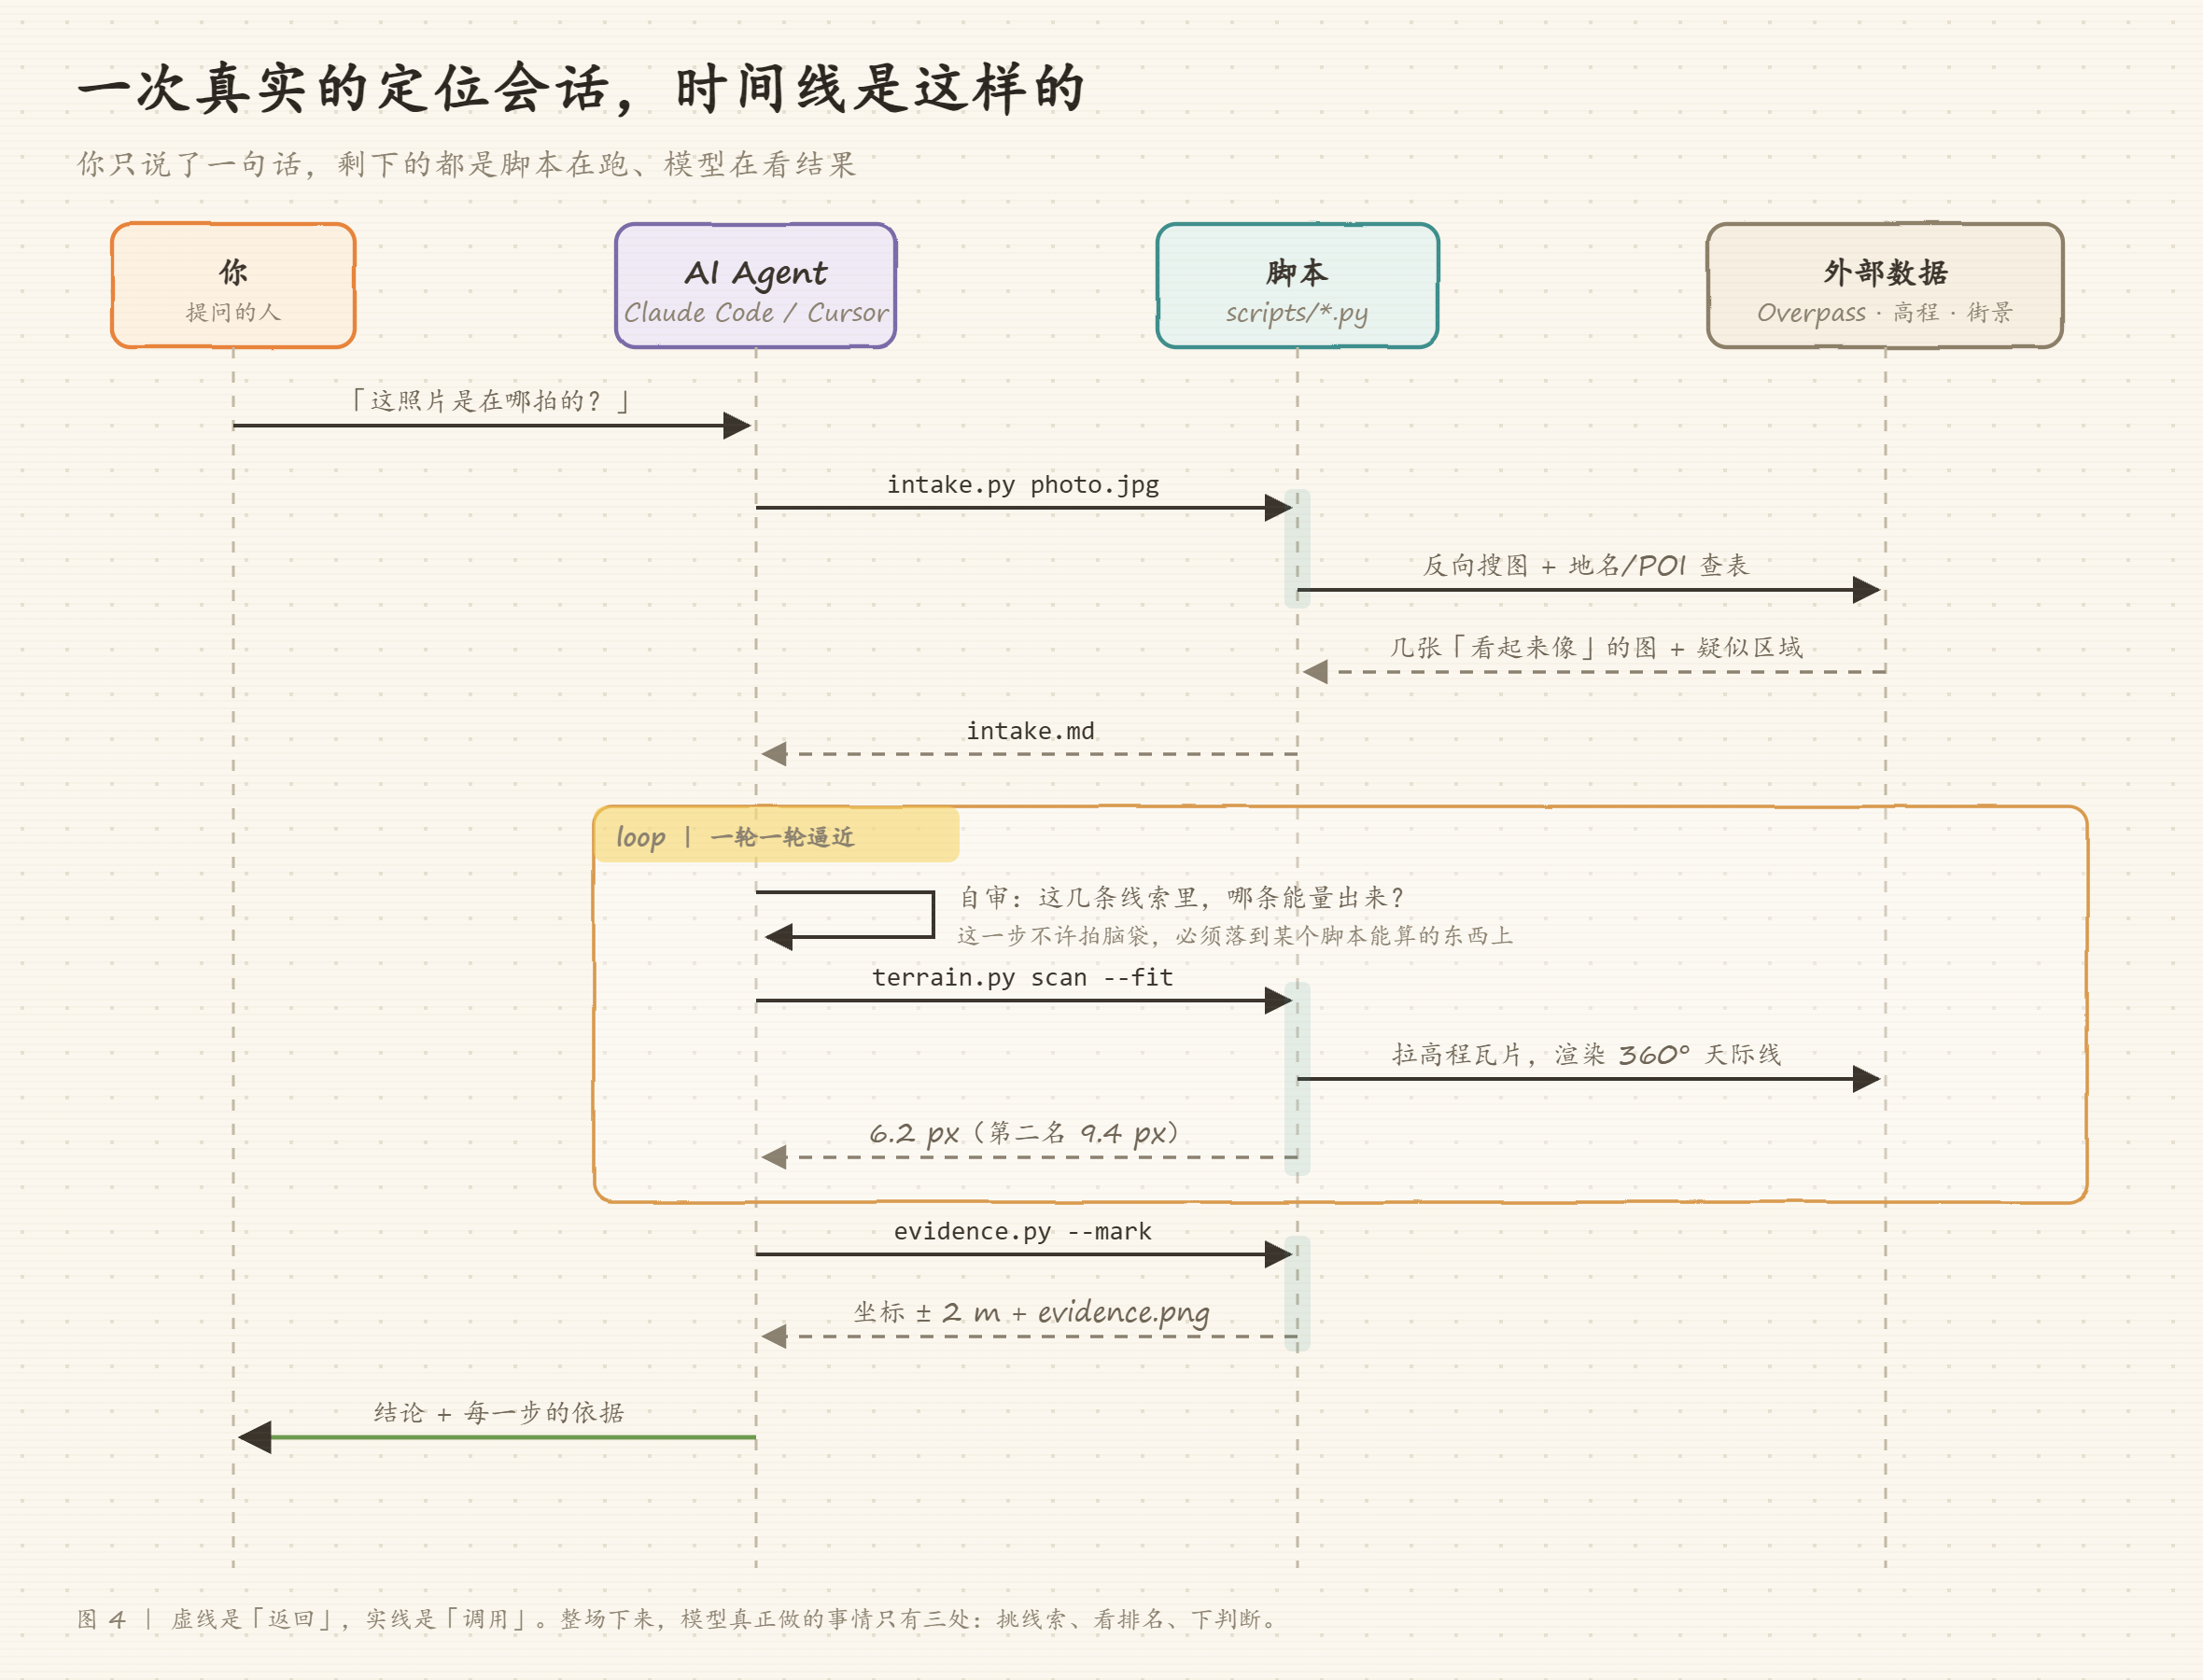
你只说了一句话,剩下全是它在跑。
有个细节我挺喜欢:中间那个「自审」的环节。模型要先把「哪条线索是能量出来的」想清楚,才能决定调哪个脚本。这一步不许拍脑袋,因为拍脑袋的结论落不到任何一个脚本上,落不到脚本上就没有文件,没有文件就没法写进报告。
约束本身就是设计。 你给模型留下的唯一出路,就是老老实实按流程走。
五、装起来,先别急着跑照片
安装比想象中简单,官方推荐用 skills CLI,一条命令六个 agent 一起装:
npx skills add Oldcircle/geo-sleuth -g \
  -a claude-code -a codex -a cursor \
  -a gemini-cli -a opencode -a github-copilot -y
不想用 CLI 也行,手动 clone 然后拷到 ~/.agents/skills/ 就行,这个目录 Codex、Cursor、Gemini CLI、OpenCode、Copilot 都认,一份顶五份。
装完第一件事不是跑照片,是自检:
# 本地环境检查:Python 版本、uv、依赖、浏览器
uv run skills/geo-sleuth/scripts/doctor.py

# 顺便探一下外网通不通(不会上传你的照片)
uv run skills/geo-sleuth/scripts/doctor.py --network

# 机器要接 CI 的话,直接出 JSON
uv run skills/geo-sleuth/scripts/doctor.py --json这里有个心理准备:第一次跑会下载模型,大概 2.4 GB。 DINOv2 和 CLIP 都是现下的,不是包里带的。你要是网速一般,先去泡杯茶。
然后是第一次真正跑图。建议先关掉联网部分,只跑本地能跑的:
uv run skills/geo-sleuth/scripts/intake.py photo.jpg \
--out-dir intake --no-rev--no-rev 的意思是跳过反向搜图。这样跑出来的 intake/intake.md 里,只有 EXIF、OCR 和线索提取的结果。你可以先看看这份文件,判断一下这张照片到底有没有救——如果连一条像样的线索都抠不出来,后面几步大概率是白跑。
顺便说几个容易踩的坑:
# Windows + NVIDIA 显卡,torch 要指定 CUDA 版本,不然会退回 CPU 慢十倍
uv run --find-links https://download.pytorch.org/whl/cu126/torch/ \
  skills/geo-sleuth/scripts/match.py rank --query photo.jpg --images cands/ --out ranked.json

# 没有独显,或者想省电,手动指定设备
GEO_DEVICE=cpu    # 或者 cuda / mps

# 反向搜图要浏览器,没装 Chrome 就补一个
uvx playwright install chromium
六、完整案例:27,335 座桥,怎么收到 2 米
下面这个案例来自仓库文档,我把它拆开讲一遍,命令都是照着 README 走的。
照片:广东清远,稻田中间一条高架桥,远处一排山。没有文字,没有车牌,没有任何可以直接读的东西。
① 先定方向:画面里最硬的结构是什么?
不是稻田,稻田全国都有。不是山,山没有独特形状就没法当指纹。是那座桥——它有连续的桥墩,有明确的走向,还有一段稳定的透视。
那就只查桥。这一步就把搜索空间从「整个中国」压到了「所有带桥属性的线要素」,27,335 个。
② 按几何条件初筛
桥墩间距、桥面走向、两侧有没有稻田。三条同时满足才留下。
171 个候选点位。
③ 沿桥布点,逐个渲染天际线
每个候选点沿着桥布一串采样相机,每个相机转一圈 360°,用高程数据把远处的山脊画成一条线,再跟照片里的山脊线比像素误差。
14,372 个相机位置。
④ 误差突然掉下去的那个点
最优点 6.2 px,第二名 9.4 px。
注意这里判断的不是「最像」,是「明显比别人像」。差距一拉开,基本就锁死了。最后落在 ± 2 米。
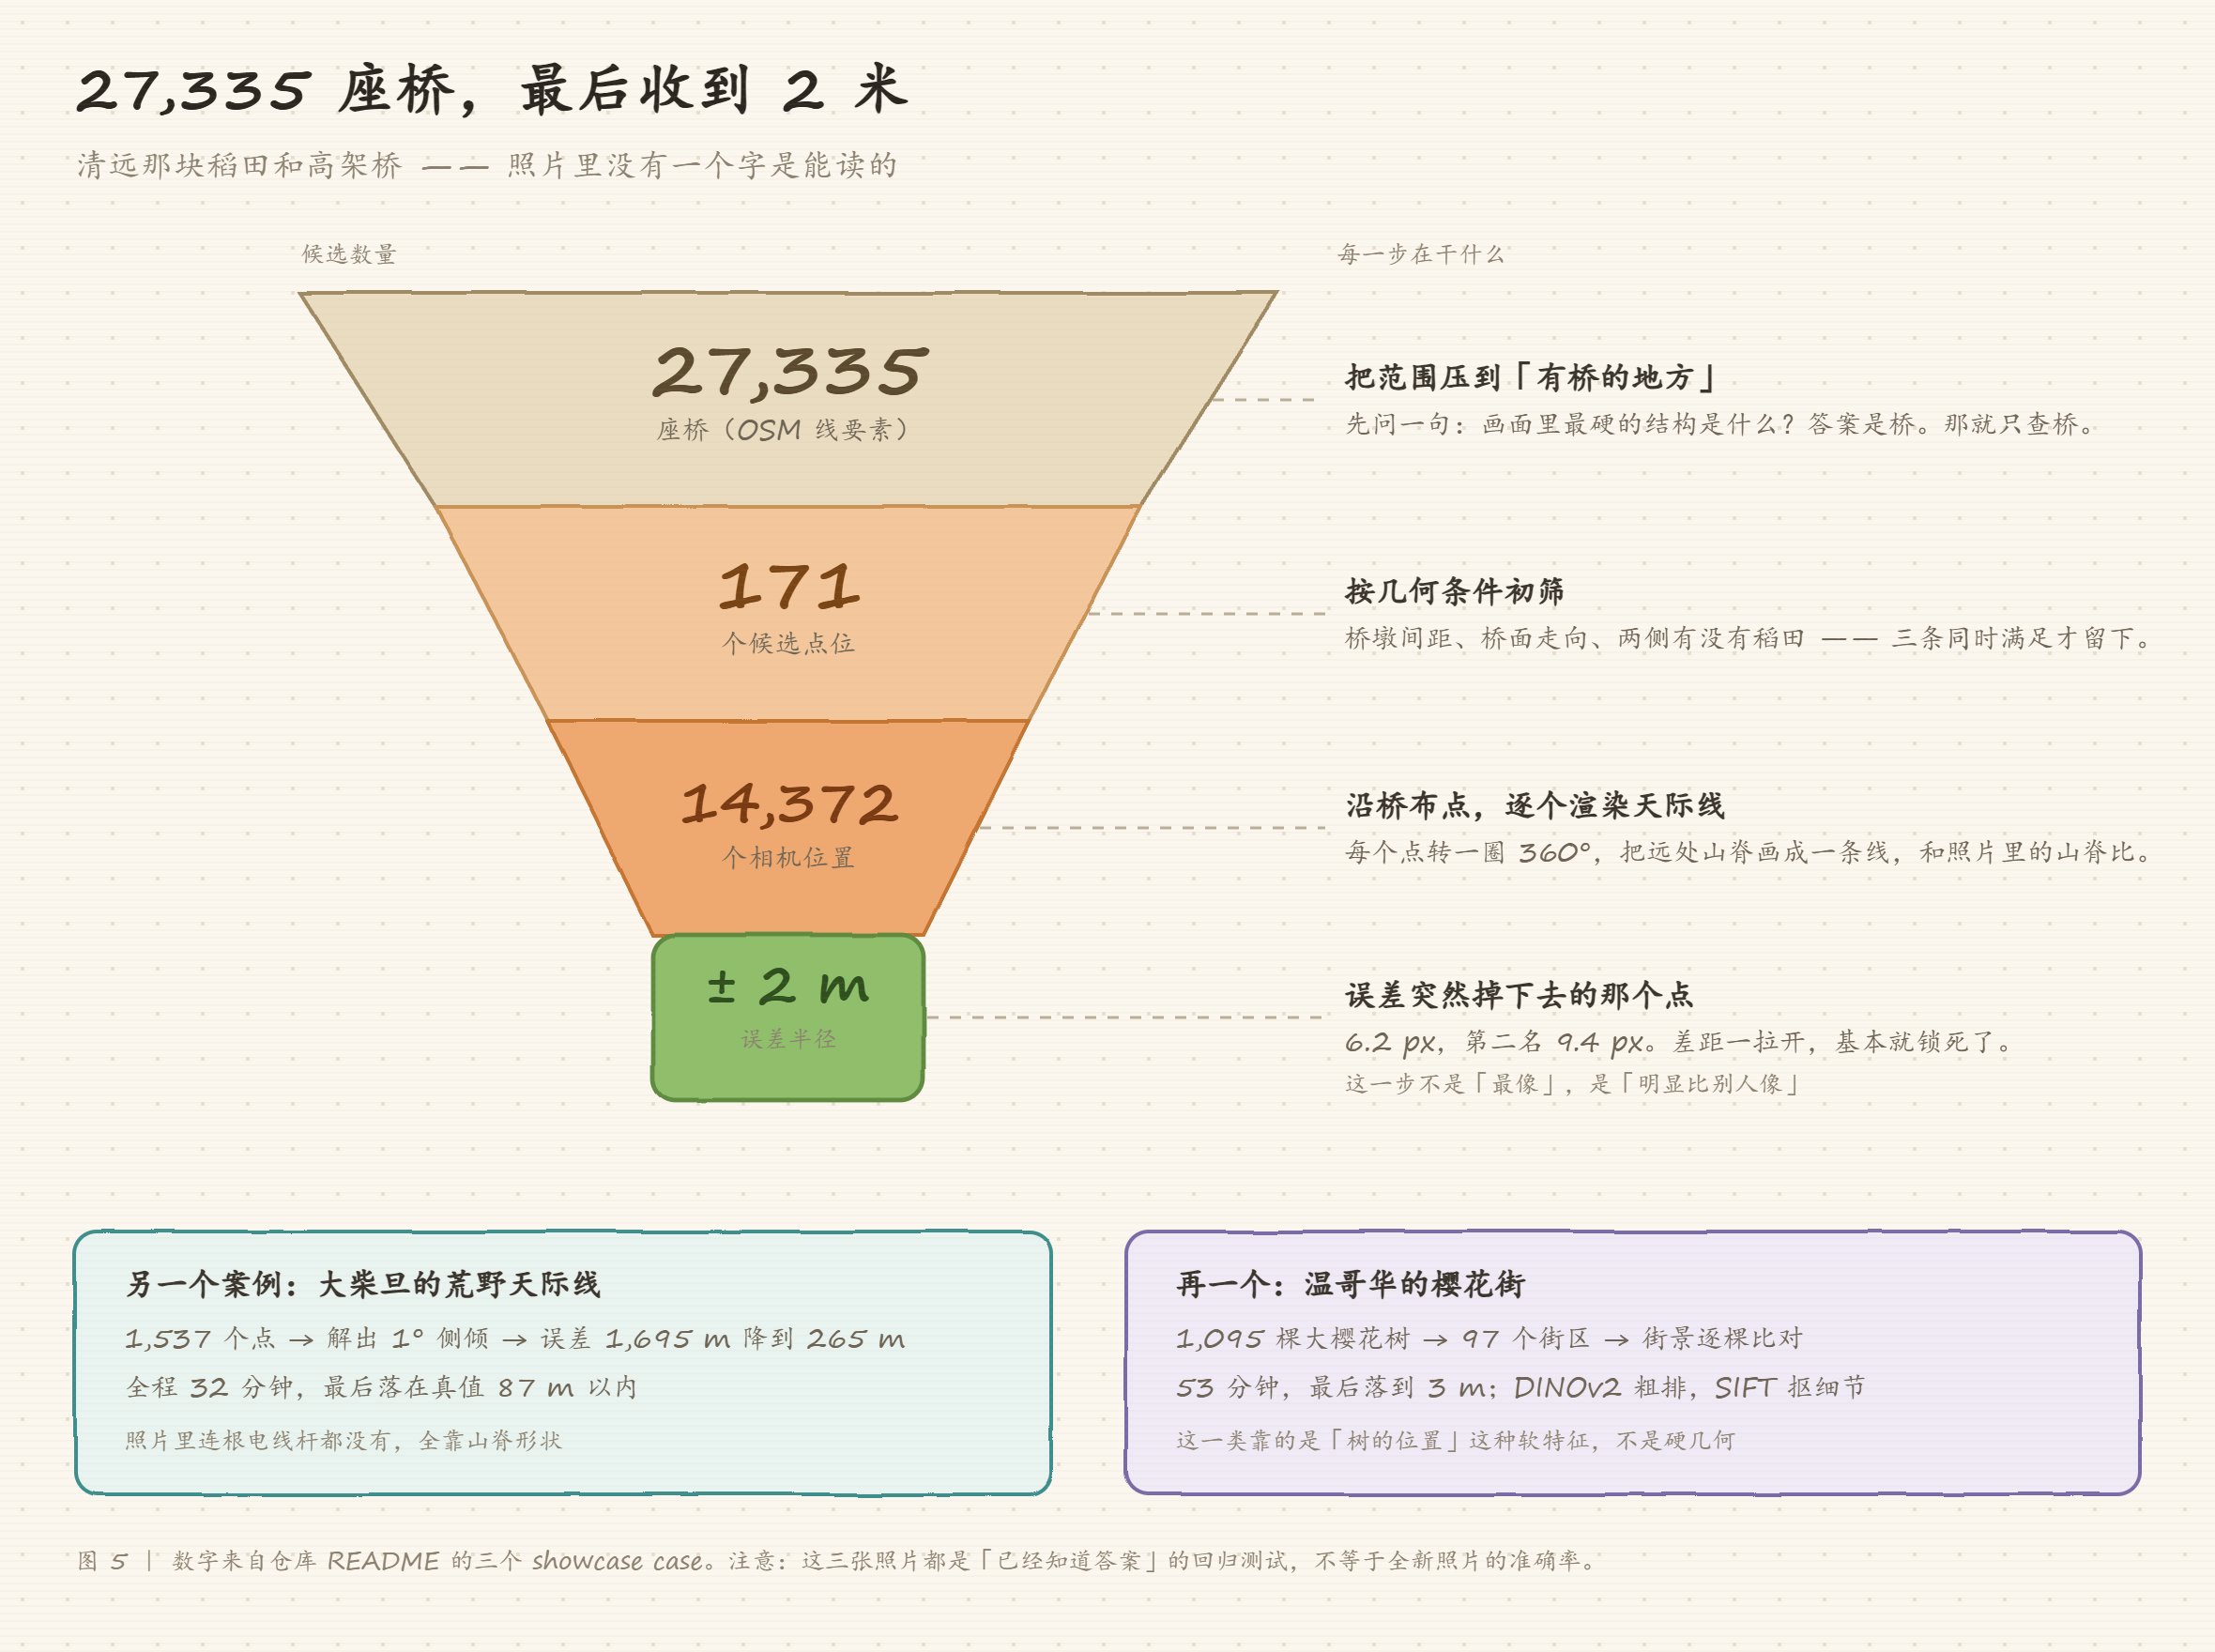
另外两个案例也贴在这儿,方便你判断它的能力边界:
- 大柴旦的荒野天际线:1,537 个候选点,中途解出相机有 1° 的侧倾,误差从 1,695 米掉到 265 米,全程 32 分钟,最后落在真值 87 米以内。
- 温哥华的樱花街:1,095 棵大樱花树,97 个街区,街景逐棵比对,53 分钟,落到 3 米。
一个靠硬几何,一个靠软特征。两条腿都走得通。
对应的命令大概长这样(参数以 --help 为准,这项目迭代挺快):
# 拉走廊:只查带桥属性的线要素
uv run skills/geo-sleuth/scripts/osm.py corridor \
  --bbox 23.4,112.8,23.9,113.3 \
  --tag "railway=bridge" \
  --out cands.json

# 沿候选点渲染天际线,允许 1° 的侧倾
uv run skills/geo-sleuth/scripts/terrain.py scan \
  --cands cands.json --photo photo.jpg --out scan/

# 拟合,把误差最小的一批挑出来
uv run skills/geo-sleuth/scripts/terrain.py fit \
  --scan scan/ --photo photo.jpg --roll-max 1 --out fit.json

# 出证据图 + 报告
uv run skills/geo-sleuth/scripts/evidence.py \
  --fit fit.json --photo photo.jpg --out evidence/
七、候选板:把「我觉得像」变成加减分
整套方法里,我觉得最值得抄的不是那些脚本,是 board.py 这张表。
它把每一条线索都明码标价:支持的加分,反对的减分,不算证据的记 0。
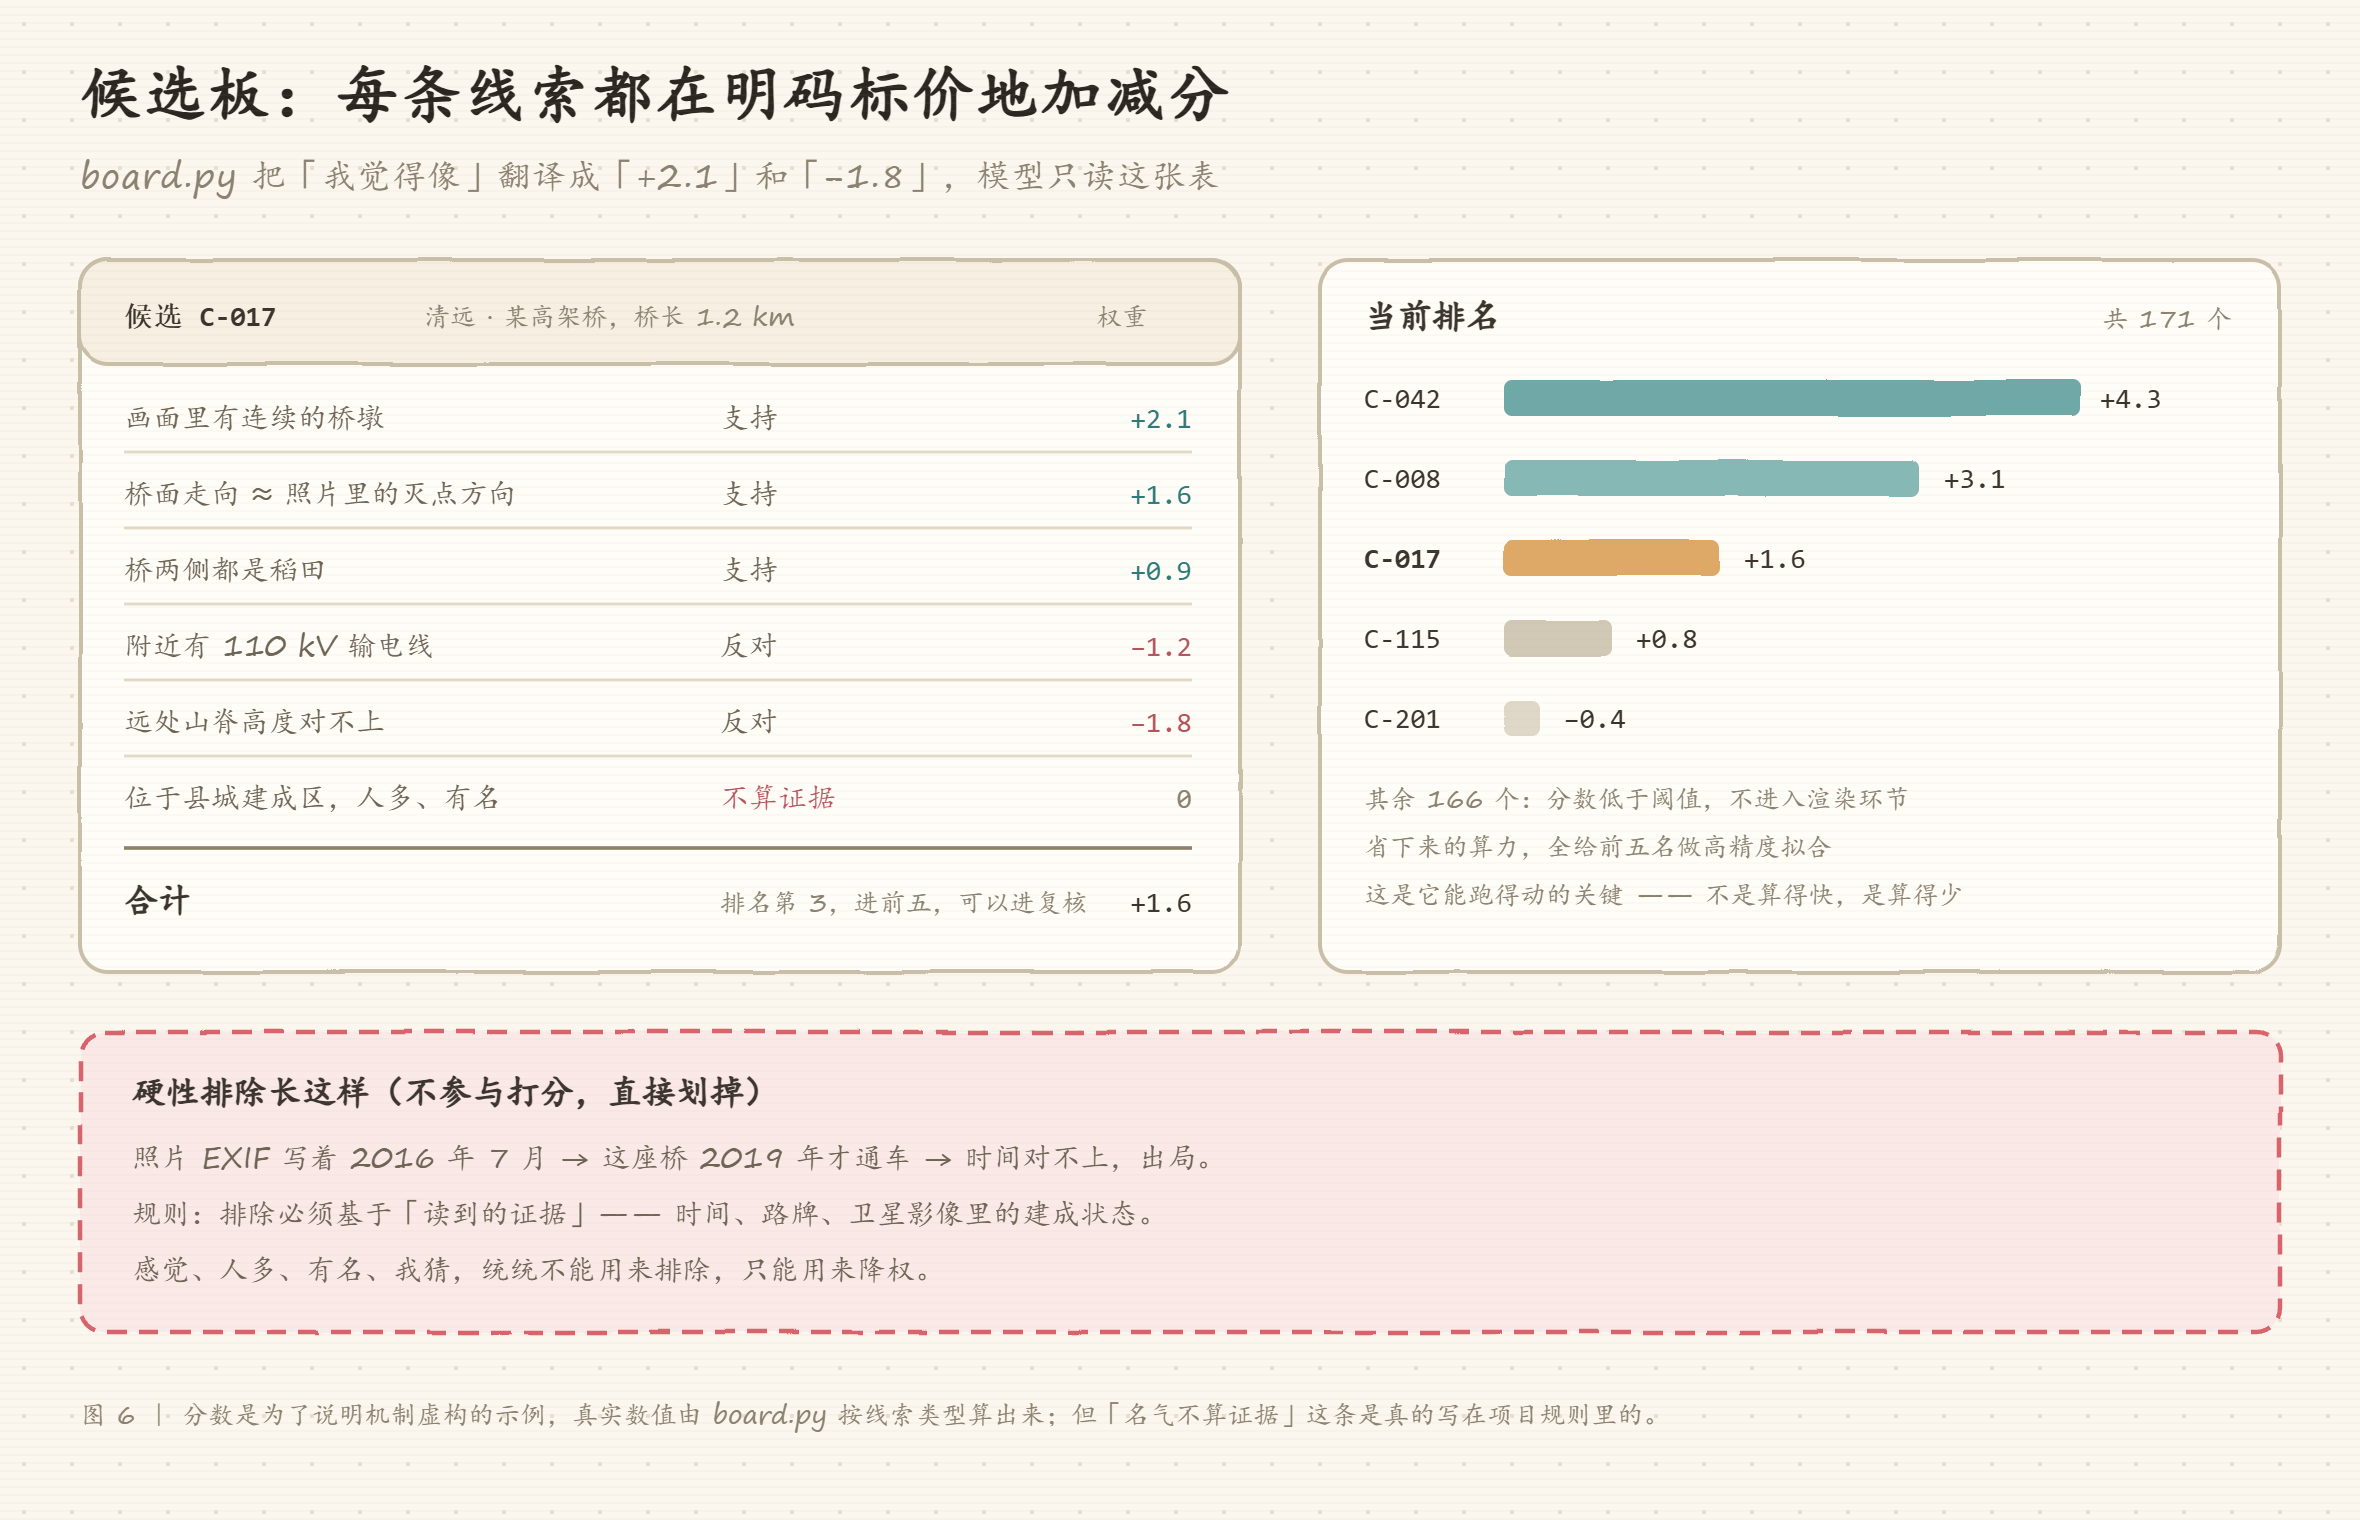
看第六行那个「位于县城建成区,人多、有名」,权重是 0。
这行字值得多看两眼。人在做地理推理的时候,最容易犯的错就是拿「知名度」当证据——「这么有名的景点,网上照片肯定多,所以应该在这儿」。这条逻辑链从头到尾都是错的,它跟拍摄点在哪没有任何因果关系。
项目直接把这类东西的权重钉死成 0。你可以说这是产品设计,我倒觉得更像一种态度。
八、几个能直接抄的代码片段
1. 用桥墩间距反推距离
这是整套方法里最朴素也最可靠的一招。已知桥墩实际间距、相机等效焦距、图上两个桥墩的像素间距,就能算出拍摄点到桥的距离:
def distance_from_pier_spacing(focal_35mm: float,
                               image_width_px: int,
                               spacing_m: float,
                               spacing_px: float) -> float:
    """
    针孔模型:d = D * f_px / p
    focal_35mm   : 35mm 等效焦距(EXIF 里常见)
    image_width_px: 照片像素宽度
    spacing_m    : 相邻桥墩的真实间距(米),可从 OSM 或常识估计
    spacing_px   : 照片里两个桥墩中心的像素距离
    """
    f_px = focal_35mm * image_width_px / 36.0   # 全画幅宽度 36mm
    return spacing_m * f_px / spacing_px


# 举例:24mm 等效、6000px 宽、桥墩间距 32m、图上量得 584px
print(distance_from_pier_spacing(24, 6000, 32, 584))   # ≈ 219.2 米
这个数出来,你就有了一圈半径 219 米的圆。再叠上阴影算出的方位角,两条约束一交,剩下的地方就不多了。
2. 似然比:为什么分数要相乘而不是相加
board.py 用的是似然比,不是简单打分。区别在于,似然比可以一层层乘下去,越乘越偏向一边:
def odds_after(prior_odds: float, likelihood_ratios: list[float]) -> float:
    """后验几率 = 先验几率 × 各线索似然比"""
    odds = prior_odds
    for lr in likelihood_ratios:
        odds *= lr
    return odds


# 先验:171 个候选里挑 1 个,1:170
prior = 1 / 170

# 线索:两侧有稻田(支持,LR=3.0);附近有高压线(反对,LR=0.6)
posterior = odds_after(prior, [3.0, 0.6])
print(f"后验几率 {posterior:.4f} → 约 1/{1/posterior:.1f}")
# 后验几率 0.0106 → 约 1/94.4
好消息是,一条强线索能把几率翻好几倍;坏消息是,一条反向线索也能给你打回原形。这比「加 3 分减 2 分」讲道理得多,因为它逼你想清楚:这条线索,到底能把概率提高多少倍?
3. 把候选板的结果抠出来做统计
board.py 的产出是 markdown 表格,人看得懂,脚本也好处理:
import re
import pathlib


def top_candidates(board_md: str, k: int = 5) -> list[tuple[str, float]]:
    """从 board.md 的表格里抠出候选编号和分数,按分数倒序取前 k 个"""
    rows = []
    for line in pathlib.Path(board_md).read_text(encoding="utf-8").splitlines():
        m = re.match(r"\|\s*(C-\d+)\s*\|.*?\|\s*([+-]?\d+\.\d+)\s*\|", line)
        if m:
            rows.append((m.group(1), float(m.group(2))))
    return sorted(rows, key=lambda x: -x[1])[:k]


for cid, score in top_candidates("board.md"):
    print(f"{cid}\t{score:+.2f}")
有了这个,你就可以把几十张照片的候选排名批量拉出来,看哪一类线索最常出现在前几名。这比一张张看报告有用得多。
4. 批量跑:把一堆照片排队处理
#!/usr/bin/env bash
set -euo pipefail

for img in photos/*.jpg; do
  name=$(basename "$img" .jpg)
  echo "=== 处理 $name ==="

  # 先读图,跳过反向搜图(省时间,也避免把照片传到第三方)
  uv run skills/geo-sleuth/scripts/intake.py "$img" \
    --out-dir "runs/$name/intake" --no-rev

  # 再按候选板给的顺序往下扫,具体参数看 --help
  uv run skills/geo-sleuth/scripts/board.py show \
    --intake "runs/$name/intake/intake.md" \
    --out "runs/$name/board.md"
done
九、它不灵的地方,得说清楚
夸完了,说说问题。不然你上手会骂人。
第一,慢。 文档里两个案例分别跑了 32 分钟和 53 分钟。这不是「点一下等三秒」的工具,这是「泡杯茶回来看看」的工具。它慢得有道理——几万个位置逐个渲染天际线,本来就不可能快——但你要是想随手查一张图,别用它。
第二,依赖数据覆盖。 OSM 稀疏的地方,走廊查不出来;没有高程数据的地方,天际线无从谈起;街景覆盖不到的地方,视觉派直接断腿。它在中国的效果,很大程度取决于那个区域有没有人认真画过 OSM。
第三,对照片质量敏感。 裁过、加了强滤镜、广角畸变没校正的照片,天际线对不齐,像素误差会虚高。项目后来加了 --roll-max 来解侧倾,就是为了对付手机拍照时的轻微倾斜,但畸变它是管不了的。
第四,它不能替你做判断。 脚本只负责排序,最后那一下还是得模型(或者你)来定。所以它给出的置信度分级,你得当真看,别看到坐标就直接用。
第五,工程门槛。 Python 3.10+、uv、能跑 shell 的 agent、2.4 GB 模型、可能的 CUDA 配置。这不是一个双击即用的软件。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号