几十个站点的批量任务,能不能只跑最后一步还随时停?
原创
几十个站点的批量任务,能不能只跑最后一步还随时停?
原创
小小码农爱奋斗
发布于 2026-11-01 10:48:53
发布于 2026-11-01 10:48:53
一、六十个站点跑到三十七个,用户想停停不下
四月份一位站长用户提了一个很具体的需求。他管着 60 个站点,文章都写好了,优化也做完了,只想跑最后一步发布。当时我们的批量执行是全流程重跑,从采集开始一步一步来,60 个站点全部走一遍要五个多小时,而他真正需要的只是最后那一步。他问能不能只点最后一步,我们当时的回答是不能。
第二件事发生在一周后。另一位用户跑 60 个站点的批量任务,跑到第 37 个的时候发现这批文章里有个站点名写错了,发出去全是错的标题。他想中止,界面上没有停止按钮,只能杀进程。进程一杀,前 36 个站点的执行状态全成了半截的,哪些成功哪些失败要靠翻日志才能对上,重启后也不知道该从第几个接着跑。
还有一件是测试时发现的。一批任务里第 3 个站点因为接口报错失败,后面的 57 个全部停在那里不动,一个失败堵死一整批。用户下午跑的批次,晚上回来一看还停在第 4 个,一晚上的时间窗口全废了。这三件事凑在一起,说明批量执行缺的不是执行能力,是部分执行、可中断、失败不阻断这三样工程能力。
二、批量执行是工作流,不是循环体
把这三个需求拆开看,本质是一回事。批量执行不是一个 for 循环挨个调接口,它是一个可编排的工作流,每个任务内部有四步,采集、写作、优化、发布,批量层面要回答三个问题,从哪一步开始跑、跑到一半怎么停、单个失败了其他还跑不跑。这三个问题每一个都不是循环体能天然回答的,都要单独的状态支撑。
直觉做法是加一个 break,用户点停就跳出循环。这条路的问题是循环体内部的一次执行是几分钟的长动作,break 只会在两次执行之间生效,当前正在跑的那个任务会跑完才停,用户等的那几分钟里以为停了,其实还在发。协作式中断的关键是中断点要密,密到步骤级,而不是任务级。
失败阻断的问题同源。循环体里一次调用抛异常,循环就断了,但业务上单个站点失败完全不该影响后面的站点。网络抖动、对方限流、单站配置错误,这些都是站点级的问题,批次级的流程不该被它们绑架。要的是失败记账后继续走,而不是失败即停。
三、两条路,一条改得浅,一条改得深
第一条路是在现有循环上打补丁。入口加一个起始步骤参数,点停的时候置一个标志位,失败的地方套个 try 继续。这条路两三天能上线,用户最基础的诉求都能覆盖。代价是状态是散的,起始步骤只影响入口那一跳,中断标志只在任务间检查,失败记录散在日志里,恢复执行要靠人对着日志数,用到第三个月就会有用户来问断点到底记在哪。
第二条路是把执行过程本身建成一个有状态的对象。批次有游标,记录当前跑到第几个任务的第几个步骤,中断有检查点,停下的时候现场完整落库,失败有独立台账,恢复执行从游标接着走。代价是开发量翻一倍,游标的持久化、中断的协作式检查、恢复时的幂等,每一处都要单独设计和测试,估了两周多。
我们选第二条。批量执行是这类工具的核心动作,用户一天要跑几十次,状态不清楚的代价每天都在付。打补丁那版我们内部先用过一周,断点恢复对着日志数任务的体验太差,数错一次就是重复发布,这个错我们犯不起。
四、步骤可选、随时可停、失败不阻断
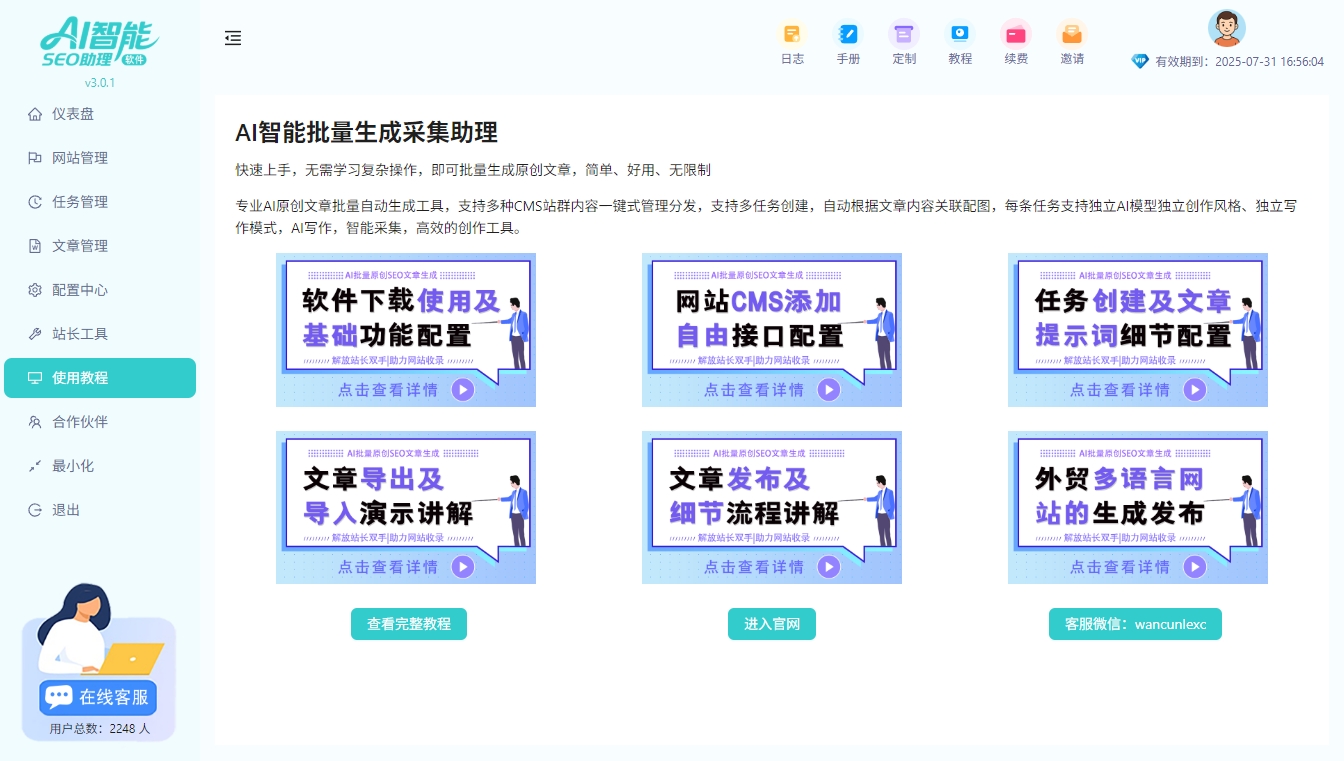
AI智能SEO助理 的批量执行允许只跑第四步,执行中随时停,停在中途的任务保留现场。执行入口的参数从一个开始按钮变成两个,一个批次,一个起始步骤,默认从第一步跑,也可以从采集、写作、优化、发布任意一步切入,只跑最后一步就是选第四步。步骤定义在配置里,四步的顺序和内容都是显式的,加步骤改配置,不动执行内核。
停止按钮是协作式中断。执行内核在每一步骤的开始检查一次中断标志,用户点停后,当前步骤跑完就落检查点,不强行掐断正在发的请求。检查点记的是双层游标,第几个任务、第几个步骤,恢复执行时从游标位置接着走,已完成步骤不重跑。用户看到的是点了停几十秒内就安静下来,后台该收的尾都收干净了。
失败不阻断是单任务级的 try 兜底,一个站点失败,记失败原因、跳过、继续下一个,批次跑完统一出一份失败清单。执行进度每两秒推一次,当前第几个任务、第几步、成功失败各多少,界面上是一条会动的进度条。执行记录整批落库,开始时间、结束时间、跑了哪些任务、每步的结果,事后可查可对账。
五、双层游标和中断检查的伪代码
执行状态收敛成一个批次执行记录。批次维度记起始步骤、当前游标、中断标志、进度快照,任务维度记每个任务的每步结果和失败原因。游标必须是双层的,只记任务下标会在恢复时重复执行当前任务的剩余步骤,只记步骤下标会在跨任务时迷路,两层各自管一段,缺一不可。
执行顺序按优先级加创建时间排,优先级高的站点先发,同优先级按提交先后。这个排序在执行开始时快照一次,执行中途改优先级不影响正在跑的批次,下一批才按新的排。快照这个决定是为了避免执行期间的排序抖动导致游标错位,宁可按旧顺序跑完,不给中途变化留空子。
恢复执行的入口复用同一个开始按钮,检测到有未完成的执行记录时,界面提示从断点继续还是从头再来,两个选项都给,用户自己选。这个提示不能省,有些场景用户就是想把整个批次重跑一遍,比如源数据整体更新过,强制断点恢复反而添乱。
六、三个坑,每个都付过学费
第一个坑是停不干净。协作式中断上线第一周,有用户反馈点了停止之后任务还在跑。查下来是中断标志只在任务之间检查,而单个任务的写作步骤要跑三分钟,这三分钟里标志位翻了用户也看不到变化。根因是检查点密度不够。改法是步骤内部再细分检查点,长步骤按三十秒粒度检查,正在进行的网络请求统一设十五秒超时,从点停到真正安静压到一分钟以内。
第二个坑是断点续跑重复发布。有用户从断点恢复后,发现当前任务又发了一遍,同一个站点出现两条内容。根因是第一版游标只记了任务下标,恢复时从当前任务的第一步重新跑,而这个任务的前几步其实已经跑完了。根因说到底是游标粒度没到步骤级。改法就是双层游标,任务下标加步骤下标,恢复时精确到步骤,这一步改完重复发布归零。
第三个坑是两个批次撞车。有用户对同一个账号同时开了两个批次,一个在采集一个在发布,对方接口直接限流,两个批次全挂。根因是执行内核没有账号维度的互斥,同账号的请求从两条线同时出去。改法是同账号的批次排队,后一个等前一个执行记录落库才启动,排队状态在界面上可见,不让用户以为自己的批次卡死了。
七、这层解决不了的事
这套执行内核管的是流程的可控,管不了业务本身的原子性。四个步骤之间没有事务,第三步优化做完、第四步发布失败,前三个步骤的成果不会回滚,恢复执行从第四步接着发,这是设计使然,不是缺陷。真正需要原子性的场景,比如发出去的内容必须和优化后的版本严格一致,那是单任务内部自己的事,批量层不背这个锅。
还有两类在这层射程之外。一类是已经发布出去的内容,中断只能停在没发的任务上,发出去的部分撤不回,要撤得走平台侧的撤回流程。另一类是对方平台的限流策略,我们能做的是排队和降速,对方把频率调多低、什么时间窗口收紧,我们只能适配,没法左右。
八、小结
这套可中断的批量执行在 AI智能SEO助理 里是站长们用得最重的功能,几十个站点一次点完。上线半年,日均执行批次四百多次,只跑第四步的批次占了六成,断点恢复用了三千多次,重复发布的投诉是零。当初提需求的那位站长后来成了用得最重的用户,他的原话是现在点一下就可以去泡茶了。
回头看,批量执行的难点从来不是把任务一个个跑完,而是把过程变成可描述的。双层游标描述跑到哪,检查点描述停在哪,失败台账描述谁出了问题,三样凑齐,批量这件事才从碰运气变成了可预期的工程。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号