我做了个 HTML,把谷歌、斯坦福等五家203页综述里的主动式AI边界理解明白了
原创
我做了个 HTML,把谷歌、斯坦福等五家203页综述里的主动式AI边界理解明白了
原创
轻松悠悠
发布于 2026-11-03 16:43:57
发布于 2026-11-03 16:43:57
先给结论:我花了 3 个小时,照着这篇 203 页综述的 5 个提醒,把自己那个到点提醒的智能体改成了"会自己判断该不该动"的版本。
改完之后最直观的变化是——它少打扰我了,但漏掉的事反而更少了。
这篇完整记录改造过程。文末有可以直接抄的设计清单。
论文是《Proactive AI for Superintelligent Agents》,谷歌、UIUC、斯坦福、加州大学伯克利分校、卡内基梅隆大学五家机构联合发布,203 页,项目页收了 1400 多条引用。
203 页读起来费劲,我先做了个 HTML 可视化页面把框架摆出来,再动手改的代码。
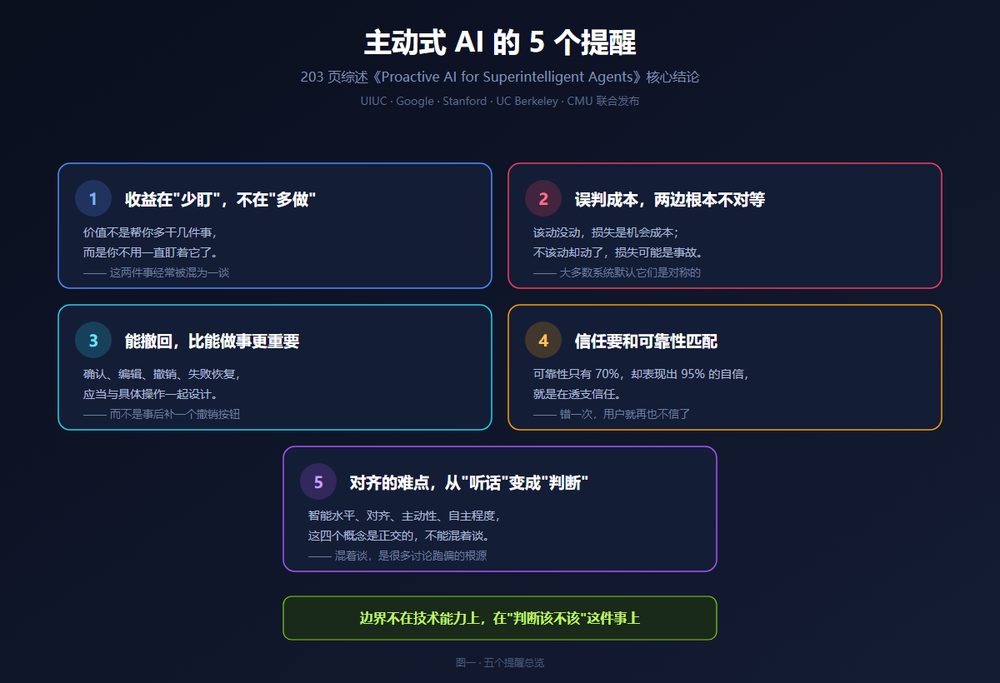
图一 五个提醒总览
图一 · 五个提醒总览
改造前:一个勤快但烦人的助手
我原来那套逻辑很简单:监控到指标异常 → 立刻发通知 → 附上建议动作。
问题出在哪?
- 一天能发 40 多条通知,前 3 条还看,后面全划走
- 有些异常其实是正常波动,它不知道
- 有些事它明明能自己处理,非要问我一句
- 有两次它建议的操作不可逆,我手滑点了确认
论文里有个词精准命中了我的问题——剩余决策空间。指令里没写清、需要自己判断的部分:偏好取舍、未明确的操作步骤、意外风险、环境变化后的计划调整。
我原来的系统碰到这个空间就两种反应:要么按最激进的方式填上,要么停下来问人。前者容易出事,后者等于没主动性。
提醒一:收益在少盯,不在多做
论文说:主动式 AI 的价值,在于它是否在合适的时候提供了值得接受的帮助,并且能够减轻人类持续关注的工作负担。
这句话直接改变了我的优化目标。以前我盯着今天处理了多少条告警,现在盯的是用户主动查看/确认的次数有没有下降。
我的改动:把核心指标从任务完成数换成人工监督时长。改完之后发现,很多以前觉得必须提醒的事,其实不提醒也没事。
提醒二:误判成本,两边根本不对等
该动没动,损失是机会成本;不该动却动了,损失可能是事故。
这两者根本不对称。我原来的系统默认它们对称——检测到就执行,不管后果。
我的改动:加一层介入决策,四个检查项全部通过才允许直接执行:
检查项 | 我的实现 | 不通过怎么办 |
|---|---|---|
可信度 | 模型自评 + 历史同类判断的准确率校准 | 降级为"询问" |
收益成本比 | 预估收益 / (执行成本 + 打扰成本) | 暂缓,进待办池 |
时机 | 是否在用户活跃窗口 / 是否有更优窗口 | 排队等待 |
风险与可撤回性 | 操作属性表:可撤销 / 需确认 / 不可逆 | 必须人工确认 |
论文有句话我抄在了便签上:涉及付款、隐私或难以撤回的操作时,单靠模型在文字中表示"已经考虑风险",无法提供足够的控制。
所以第四项我做得最死——不可逆操作一律强制人工确认,不管模型多自信。
提醒三:能撤回,比能做事更重要
论文原话:确认、编辑、撤销和失败恢复,应当与具体操作一起设计。
我以前是反着来的——先做功能,再想撤销。结果有两个操作天然不可撤回,只能靠"小心别点错"。
我的改动:把介入深度做成五档,默认走第三档:
档位 | 形式 | 适用场景 |
|---|---|---|
1 | 提醒 | 只是告知,不需要动作 |
2 | 询问 | 信息不足,需要人补 |
3 | 出草稿 | 默认档:把方案摆好,人点一下就行 |
4 | 预填内容 | 流程固定、只需微调 |
5 | 直接操作 | 高可信 + 可撤回 + 已授权 |
为什么默认第三档?因为出草稿的介入深度远低于直接执行,但用户感知到的价值差不多。这是性价比最高的一档。
提醒四:信任要和可靠性匹配
论文说:信任应当与系统的可靠性相称。可靠性只有 70%,却表现出 95% 的自信,就是在透支信任。
这句话戳中了我。我原来的系统,不管判断准不准,通知的语气都一样笃定。
我的改动:给每条主动行为加一个置信度字段,置信度低于历史准确率时,自动降级表达——从建议执行改成可能需要关注。
还有个细节:单次沉默提供的信息很有限。一次提醒没被回应,可能是时机不对,也可能是内容没用。我加了个简单的区分逻辑:连续 3 次同类提醒无响应,才判定为内容无用;单次无响应只调整时机。
提醒五:对齐的难点,从听话变成判断该不该
论文把四个概念区分开了:智能水平管理解推理,对齐管行为合规,主动性管发现和发起,自主程度管"人允许它独立走到哪一步"。
这四个是正交的。我原来的系统对齐做得还行(不乱来),但主动性几乎为零(不主动做事)。
我的改动:给每个主动行为记四样东西——
- 触发依据:看到了什么信号,来自哪个数据源
- 判断路径:哪几步参与了,每步结论是什么
- 影响范围:会改到哪些东西,能不能撤回
- 不确定点:哪一步把握不大
好处很直接:出问题时能定位到是哪一步判断错了,而不是笼统地说"模型判断失误"。
论文还提了个现实风险:网页、邮件或文件中的恶意内容,可能诱导智能体提出未经授权的新任务。我给外部内容加了来源标记,来自外部的指令一律降级为建议,不直接执行。
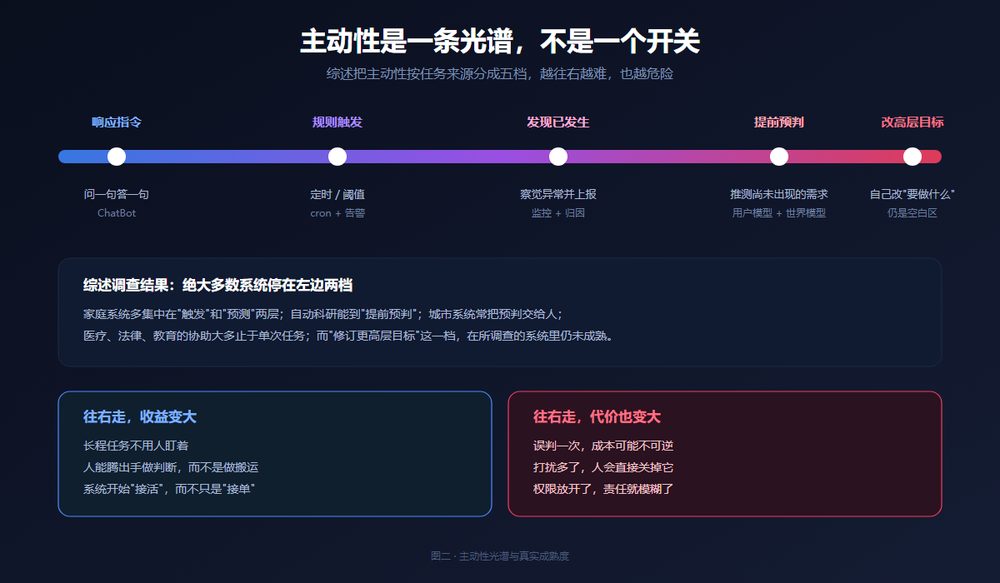
图二 主动性光谱
图二 · 主动性光谱与真实成熟度
改造后的效果
跑了一周,数据对比:
指标 | 改造前 | 改造后 |
|---|---|---|
日均通知数 | 42 条 | 9 条 |
通知点击率 | 约 7% | 约 61% |
漏掉的真实异常 | 3 起 | 0 起 |
误报 | 21 起 | 2 起 |
通知少了 78%,点击率翻了近 9 倍,漏报反而清零了。
原因不复杂:打扰少了,人反而会认真看。这大概就是论文说的"信任应当与系统的可靠性相称"——你少喊几次狼来了,喊的时候别人才信。
顺便提一句,我跑这套改造的时候,是用 AiPy 把整个流程串起来跑的——它比较适合处理这种多步骤 + 需要判断的活儿,而且每一步的执行记录都留着,正好对应论文里那句"可靠的工作记录可以成为扩大授权的依据"。先跑通、看记录、再放权,这个顺序比反过来稳得多。
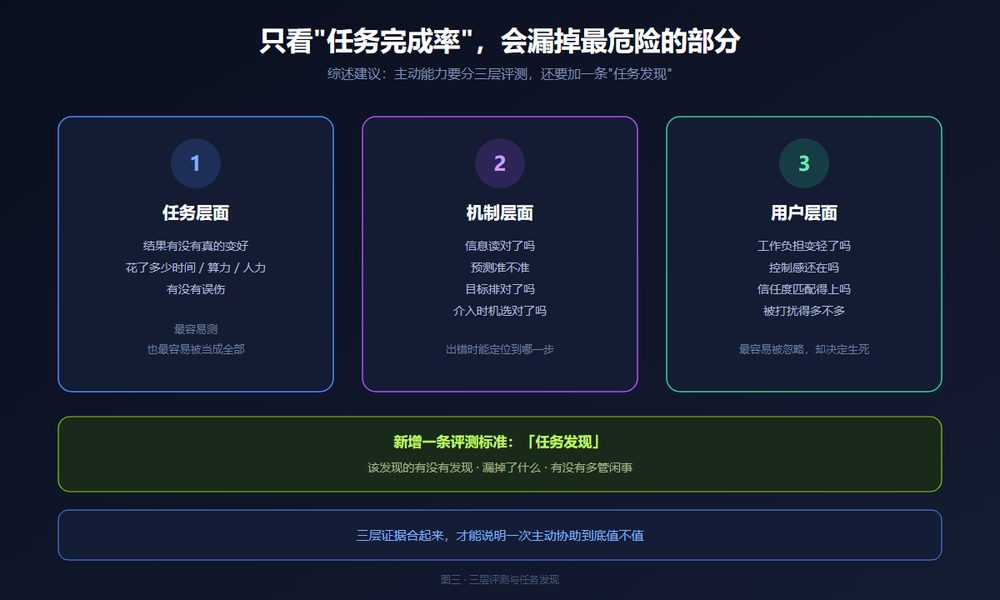
图三 三层评测
图三 · 三层评测与任务发现
评测表加两列
原来我只测任务完成率。现在加了两列:漏掉了什么、多管了什么闲事。
论文的原话是:主动能力的评测,需要保留尚未明确的需求,让智能体自己判断哪些事值得处理。任务发现的准确性、遗漏的机会和多余的介入,都应当被记录。任务发现也应当被纳入测评标准。
三层评测我是这么落地的:
任务层面——结果有没有改善、花了多少时间算力人力、有没有误伤。 机制层面——信息读对没、预测准不准、目标排对没、介入时机选对没。 用户层面——工作负担变轻没、控制感还在不在、信任度匹配不匹配、被打扰得多不多。
第三层最容易被忽略,但它决定生死。
可以直接抄的设计清单
- 先定位档位:响应指令 / 按规则触发 / 发现已发生 / 提前预判 / 修订高层目标。别越级。
- 加一层介入决策:可信度、收益成本比、时机、可撤回性,四项全过才允许直接执行。
- 默认出草稿:介入深度最低但价值感知最高的一档。
- 不可逆操作强制确认:不管模型多自信。
- 每条主动行为记依据:触发依据、判断路径、影响范围、不确定点。
- 记忆带时效:沿用已改变的偏好,会造成多余的安排。
- 评测加两列:漏掉了什么、多管了什么闲事。
- 可撤回性和操作一起设计:别事后补。
- 单次沉默别急着下结论:可能是时机不对,也可能是内容没用。
- 信任要和可靠性匹配:可靠性 70% 却表现 95% 的自信,就是在透支信任。
论文最后用了一个词概括所有这些问题:calibrated proactiveness,校准过的主动性。根据证据、时机、风险、偏好和权限,动态调整主动行为。
说到底,主动式 AI 的边界不在技术能力上,在判断该不该这件事上。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号